首页 文章 精选 留言 我的

精选列表

搜索[Rust编程],共10000篇文章
优秀的个人博客,低调大师

iOS编程中throttle的那些事

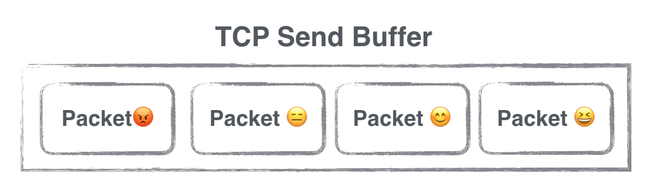
不知道大家对throttle这个单词是否看着眼熟,还是说对这个计算机基础概念有很清晰的了解了。今天就来聊聊和throttle相关的一些技术场景。 定义 我经常有一种感觉,对于英语这门语言的语感,会影响我们对于一些关键技术概念的理解。有时候在学习新技术知识的时候,我会先花一些时间去了解术语英文单词的各种语义,在形成强烈清晰的语感之后,再去深入具体的技术语境。throttle也算是个生僻的单词,至少在口语中毕竟少用到,先来看看词义: a device controlling the flow of fuel or power to an engine. 中文翻译是节流器,一种控制流量的设备。对应到我们计算机世界,可以理解成,一种控制数据或者事件流量大小的机制。这么说可能还是有些抽象,再来看看一些具体的技术场景加深理解。 场景一:GCD Background Queue 话说GCD几乎是iOS面试的必问题,也是个送分题:)。 我一般会机械式的先问:GCD有哪几种Queue?回答:串行Queue和并行Queue。 我继续问:Global Queue有哪几种优先级?回答:有几种吧,大概记得Default,Low,High吧。 我双眉一挑,进一步试探:不知道少侠有没有研究过DISPATCH_QUEUE_PRIORITY_BACKGROUND作何用?问完立即竖起耳朵,殷殷期盼萦绕于心的关键字。如果能听到「I/O Throttle 呀!」,我会瞬间觉得面试气氛被点亮了。 当然啦,答不出I/O Throttle并不能说明技术不扎实,但能答出来,至少表明对待技术是有好奇心的,加分! 官方文档如是说: Items dispatched to the queue run at background priority; the queue is scheduled for execution after all high priority queues have been scheduled and the system runs items on a thread whose priority is set for background status. Such a thread has the lowest priority and any disk I/O is throttled to minimize the impact on the system. 那Disk I/O Throttle做什么用呢?按照上面这段描述,Disk I/O会impact system performance。 理解Disk I/O的影响需要补充一些大学课本上的知识。一次磁盘读写操作涉及到的硬件资源主要有两个,CPU和磁盘。任务本身由CPU触发和调度,读操作发生时,CPU告知Disk去获取某个地址的数据,此时由于Disk的读操作存在寻址延迟,CPU是处于I/O wait状态,一直维持到Disk返回数据为止。处于I/O wait状态的CPU,此时并不能把这部分等待的时间用来处理其他任务,也就是说这一段等待的CPU时间被“浪费”了。而CPU是公共的系统资源,这部分资源的损耗自然会对系统的整体表现产生负面影响。即使Global Queue使用的是子线程,也会造成CPU资源的消耗。 如果把任务的Priority调整为DISPATCH_QUEUE_PRIORITY_BACKGROUND,那么这些任务中的I/O操作就被被控制,虽然具体的控制策略并没有官方文档描述(一种可能的策略是并发的Disk I/O变为串行的),但我们能确认的是,部分I/O操作的启动时间很有可能被适当延迟,把更多的CPU资源腾出来处理其他任务(比如说一些系统资源的调度任务),这样可以让我们的系统更加稳定高效。简而言之,对于重度磁盘I/O依赖的后台任务,如果对实时性要求不高,放到DISPATCH_QUEUE_PRIORITY_BACKGROUND Queue中是个好习惯,对系统更友好。 实际上I/O Throttle还分为好几种,有Disk I/O Throttle,Memory I/O Throttle,和Network I/O Throttle。语义类似只不过场景不同,继续往下看。 场景二:ASIHttpRequest Network Throttle 早几年读ASIHttpRequest源码的时候,读到过一段有意思的代码: - (void)handleNetworkEvent:(CFStreamEventType)type { //... [self performThrottling]; //... } 在AFNetworking中也有类似的代码: /** Throttles request bandwidth by limiting the packet size and adding a delay for each chunk read from the upload stream. When uploading over a 3G or EDGE connection, requests may fail with "request body stream exhausted". Setting a maximum packet size and delay according to the recommended values (`kAFUploadStream3GSuggestedPacketSize` and `kAFUploadStream3GSuggestedDelay`) lowers the risk of the input stream exceeding its allocated bandwidth. Unfortunately, there is no definite way to distinguish between a 3G, EDGE, or LTE connection over `NSURLConnection`. As such, it is not recommended that you throttle bandwidth based solely on network reachability. Instead, you should consider checking for the "request body stream exhausted" in a failure block, and then retrying the request with throttled bandwidth. @param numberOfBytes Maximum packet size, in number of bytes. The default packet size for an input stream is 16kb. @param delay Duration of delay each time a packet is read. By default, no delay is set. */ - (void)throttleBandwidthWithPacketSize:(NSUInteger)numberOfBytes delay:(NSTimeInterval)delay; 原谅我贴了一大段注释,这段英文描述对于加深我们对于一些网络行为的理解很有帮助。 这些知名的第三方网络框架都有对Newtork Throttle的支持,你可能会好奇,我们为什么要对自己发出的网络请求做流量控制,难道不应该尽可能最大限度的利用带宽吗? 此处需要科普一点TCP协议相关的知识。我们通过HTTP请求发送数据的时候,实际上数据是以Packet的形式存在于一个Send Buffer中的,应用层平时感知不到这个Buffer的存在。TCP提供可靠的传输,在弱网环境下,一个Packet一次传输失败的概率会升高,即使一次失败,TCP并不会马上认为请求失败了,而是会继续重试一段时间,同时TCP还保证Packet的有序传输,意味着前面的Packet如果不被ack,后面的Packet就会继续等待,如果我们一次往Send Buffer中写入大量的数据,那么在弱网环境下,排在后面的Packet失败的概率会变高,也就意味着我们HTTP请求失败的几率会变大,类似这样: 大部分时候在应用层写代码的时候,估计不少同学都意识不到Newtork Throttle这种机制的存在,在弱网环境下(丢包率高,带宽低,延迟高)一些HTTP请求(比如上传图片或者日志文件)失败率会激增,有些朋友会觉得这个我们也没办法,毕竟网络辣么差。其实,作为有追求的工程师,我们可以多做一点点,而且弱网下请求的成功率其实是个很值得深入研究的方向。针对弱网场景,我们可以启用Newtork Throttle机制,减小我们一次往Send Buffer中写入的数据量,或者延迟某些请求的发送时间,这样所有的请求在弱网环境下,都能「耐心一点,多等一会」,请求成功率自然也就适当提高啦。 那么,再看AFNetworking中的这个函数,是不是更能理解了呢? - (void)throttleBandwidthWithPacketSize:(NSUInteger)numberOfBytes delay:(NSTimeInterval)delay; Network Throttle体现了一句至理名言「慢即是快」。 场景三:Event Frequency Control 不知道大家在写UI的时候,有没有遇到过用户快速连续点击UIButton,产生多次Touch事件回调的场景。以前机器还没那么快的时候,我在用一些App的时候,时不时会遇到偶尔卡顿,多次点击一个Button,重复Push同一个Controller。有些工程师会在Button的点击事件里记录一个timestamp,然后判断每次点击的时间间隔,间隔过短就忽略,这也不失为一种解决办法。 再后来学习RxSwift的时候,看到: button.rx_tap .throttle(0.5, MainScheduler.instance) .subscribeNext { _ in print("Hello World") } .addDisposableTo(disposeBag) 终于有了优雅的书写方式。发现没有,throttle又出现了,这里throttle控制的是什么呢?不是disk读写,也不是network buffer,而是事件,把事件本身抽象成了一种Data,控制这种数据的流量或者产生频率,就解决了上面我们所说重复点击按钮的问题,so easy。 总结 当然还会有更多的场景,throttle其实是个基础的计算机知识。理解throttle相关的技术概念,需要在不同场景下去抽象出一个flow被节流的画面。现在,如果让你来解释一些具体的技术场景下,throttle是怎么回事,是不是可以信手拈来了: ) 作者:MrPeak杂货铺 来源:51CTO

优秀的个人博客,低调大师

主流编程语言的对比分析

最近做Android和IOS项目,由资深windows平台C++开发转型做移动平台,涉及到C++、Java、ObjectC三类语言的对比,本文将从面向对象语言三大特性&五大原则角度对比分析,总结沉淀下来(N年前做Java的时候就想干的事,现在总算动手了) 三大特性: 封装 封装:把客观事物封装成抽象的类,并且类可以把自己的数据和方法只让可信的类或者对象操作,对不可信的进行信息隐藏。类就是一个封装了数据以及操作这些数据的代码的逻辑实体。 继承 继承:指可以让某个类型的对象获得另一个类型的对象的属性的方法。 C++ Java ObjectC 多态 多态:指一个类实例的相同方法在不同情形有不同表现形式 C++ Java ObjectC 重载 C++ Java ObjectC 五大原则 单一职责原则 对类来说:类的功能要单一,不能包罗万象。 开放封闭原则 对模块来说:在扩展性方面应该是开放的而在更改性方面应该是封闭的。比如在设计解码模块时,要考虑ffmpeg软解、Android和IOS的硬解,在设计模块对外接口时,抽取其共性,搭好框架后,可以先实现软解,在后期再扩展硬解时,无需改变整体代码,即可方便扩展。这也是插件化思想的体现。 替换原则 对继承来说:子类应当可以替换父类并出现在父类能够出现的任何地方。即可通过替换原则验证父类设计是否合理,有无改进。 依赖倒置原则 依赖倒置原则是设计中解耦、减少依赖的核心方法。 举例:依赖倒置的典型时序图—-待补充 接口分离原则 模块间要通过抽象接口隔离开,而不是通过具体的类强耦合起来

优秀的个人博客,低调大师

浅谈多线程编程中的误区

虽然很多程序员可以对异步、GCD等等与线程相关的概念说的天花乱坠。但是实质上深挖本质的话,大多数人并不能很好的区分Race Condition,Atomic,Immutable对象在线程安全中真正起到的作用。 所以今天就以这篇文章来谈谈我所理解的线程安全。 首先就允许我从Immutable来开始整篇话题吧。 Immutable 最近几年,Immutable这个说法开始越来越流行。比如用过Swift的人都知道,Swift相较于Objective-C有一个比较明显的改动就是将结构体(Struct)和类型(Class)进行了分离。从某种方面来说,Swift将值类型和引用类型进行了明显的区分。为什么要这么做? 避免了引用类型在被作为参数传递后被他人持有后修改,从而引发比较难以排查的问题。 在某些程度上提供了一定的线程安全(因为多线程本身的问题很大程序

优秀的个人博客,低调大师

MapReduce编程实例之倒排索引 1

任务描述: 有一批电话清单,记录了用户A拨打给用户B的记录 做一个倒排索引,记录拨打给用户B所有的用户A、 example data: 13614004876 110 18940084808 10086 13342445911 10001 13614004876 120 18940084808 1008611 13342445911 110 15847985621 10000 code: <span style="font-size:14px;">package mrTest; import java.io.IOException; import java.util.Date; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import com.ibm.icu.text.SimpleDateFormat; public class daopaisuoyin { enum Counter{ LINESKIP, //出错的行 } public static class Map extends Mapper<Object, Text, Text, Text>{ public void map(Object key,Text value,Context context){ String line = value.toString(); try{ String[] lineSplit = line.split(" "); String newKey = lineSplit[0]; String newValue = lineSplit[1]; context.write(new Text(newKey), new Text(newValue)); }catch(Exception e){ context.getCounter(Counter.LINESKIP).increment(1); return; } } } public static class Reduce extends Reducer<Text, Text, Text, Text>{ public void reduce(Text key, Iterable<Text> values, Context context) throws IOException, InterruptedException{ String result = ""; for (Text value : values) { result += value.toString() + " # "; } context.write(key, new Text(result)); } } public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException { // TODO Auto-generated method stub Job job = new Job(new Configuration(), " 倒排索引 "); job.setJarByClass(daopaisuoyin.class); job.setNumReduceTasks(1); job.setOutputKeyClass(Text.class); job.setOutputValueClass(Text.class); job.setMapperClass(Map.class); job.setReducerClass(Reduce.class); FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); //记录时间 SimpleDateFormat sdf = new SimpleDateFormat(); Date start = new Date(); //开始时间 int result = job.waitForCompletion(true)? 0 : 1; //任务开始 Date end = new Date(); //结束时间 float time = (float)((end.getTime() - start.getTime()) / 60000.0); //任务开始到结束经历的时间 System.out.println("Job 开始的时间为:" + start); System.out.println("Job 结束的时间为:" + end); System.out.println("Job 经历的时间为:" + time + "分钟"); System.out.println("Job 的名字:" + job.getJobName()); System.out.println("Job 是否成功:" + job.isSuccessful() ); System.out.println("Job 输入的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_INPUT_RECORDS").getValue()); System.out.println("Job 输出的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_OUTPUT_RECORDS").getValue()); System.exit(result); //判断是否结束 } } </span> 结果显示:

优秀的个人博客,低调大师

MapReduce编程实例之数据去重

任务描述: 让原始数据中出现次数超过一次的数据在输出文件中只出现一次。 example data: 2015-3-1 a 2015-3-2 b 2015-3-3 c 2015-3-4 d 2015-3-5 e 2015-3-6 f 2015-3-7 g 2015-3-1 a 2015-3-2 b 2015-3-3 c 2015-3-4 d 2015-3-5 e 2015-3-6 f 2015-3-7 g 2015-3-1 a 2015-3-2 b 2015-3-3 c 2015-3-4 d 2015-3-5 e 2015-3-6 f 2015-3-7 g code: package mrTest; import java.io.IOException; import java.util.Date; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.NullWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import com.ibm.icu.text.SimpleDateFormat; public class shujuquchong { public static class Map extends Mapper<Object, Text, Text, NullWritable>{ public void map(Object key,Text value,Context context) throws IOException, InterruptedException{ context.write(value, NullWritable.get()); } } public static class Reduce extends Reducer< Text, NullWritable, Text, NullWritable>{ public void reduce(Text key, Iterable<NullWritable> values, Context context) throws IOException, InterruptedException{ context.write(key, NullWritable.get()); } } public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException { // TODO Auto-generated method stub Job job = new Job(new Configuration(), " 数据去重"); job.setJarByClass(shujuquchong.class); job.setNumReduceTasks(1); job.setOutputKeyClass(Text.class); job.setOutputValueClass(NullWritable.class); job.setMapperClass(Map.class); job.setReducerClass(Reduce.class); FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); //记录时间 SimpleDateFormat sdf = new SimpleDateFormat(); Date start = new Date(); //开始时间 int result = job.waitForCompletion(true)? 0 : 1; //任务开始 Date end = new Date(); //结束时间 float time = (float)((end.getTime() - start.getTime()) / 60000.0); //任务开始到结束经历的时间 System.out.println("Job 开始的时间为:" + start); System.out.println("Job 结束的时间为:" + end); System.out.println("Job 经历的时间为:" + time + "分钟"); System.out.println("Job 的名字:" + job.getJobName()); System.out.println("Job 是否成功:" + job.isSuccessful() ); System.out.println("Job 输入的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_INPUT_RECORDS").getValue()); System.out.println("Job 输出的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_OUTPUT_RECORDS").getValue()); System.out.println("Job 输入的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "REDUCE_INPUT_RECORDS").getValue()); System.out.println("Job 输出的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "REDUCE_OUTPUT_RECORDS").getValue()); System.exit(result); //判断是否结束 } } 结果展示:

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册