首页 文章 精选 留言 我的

精选列表

搜索[快直播],共10000篇文章
优秀的个人博客,低调大师

Something BIG Is Coming 百万token上下文提速近10倍,MiniMax M3的稀疏注意力凭什么这么快

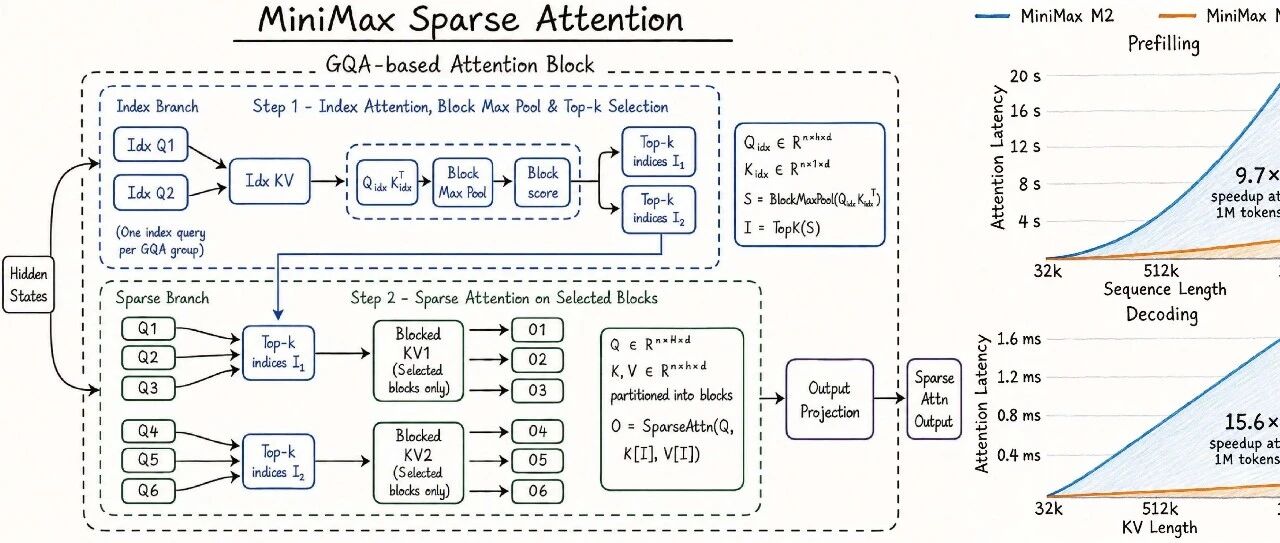
15.6倍。 这不是营销数字,是MiniMax M3在百万token解码阶段交出的成绩单。 2026年5月26日,MiniMax工程负责人Skyler Miao在社交平台甩出一张架构图,配文只有三个标签,MSA,OpenSource,M3。没发论文,没放仓库,甚至连具体发布日期都没提。但那张手绘风格的稀疏注意力架构图,足够让整个长上下文赛道炸锅。 因为这张图背后藏着的,是困扰大模型行业两年的核心命题,当上下文从4k扩展到100万token,注意力机制到底该怎么重写。 ![image](https://developer.qcloudimg.com/http-save/yehe-5421023/4062a3e5d7ea6a27569652fbb319abd9.png) image ## **一、先搞清楚问题在哪** 2023年,某团队在Llama-2-7B上尝试处理一份50k token的法律文档。 报错信息很直接,CUDA out of memory. Tried to allocate 64.00 GB。 单卡A100 80GB,瞬间爆显存。问题出在哪?Attention的显存复杂度是O(n²)。4k上下文时KV Cache大约2GB,到50k就飙升到300GB以上。 这还不是最绝望的。 真正让工程师头疼的是延迟。在64k上下文场景下,标准Softmax注意力会吞噬70%到80%的解码延迟。你模型再聪明,推理再深,光是在注意力计算上就得耗掉大半算力。 北京大学袁境阳博士在ACL 2025最佳论文里说得更直白,大部分注意力计算本身并不值得做。 Softmax是一个竞争性激活函数。归一化之后,权重天然呈现少数突出、多数衰减的分布。换句话说,Attention本来就会自发变稀疏。但传统密集注意力把所有Token对都算了一遍,然后扔掉绝大部分结果。 这就像你读完一百万字的书,发现真正记住的只有三句话。 ## **二、稀疏注意力的核心不是稀疏,是索引** 这是袁境阳博士在访谈里抛出的关键洞察。 稀疏注意力最关键的并不是如何变稀疏,而是如何选出应当被保留下来的那一小部分Token。 这一步几乎带有一种Oracle性质。如果你已经把密集注意力的分数都算出来了,那其实也就失去了稀疏的意义。所以整个研究的核心被重新定义,如何在不计算全部Attention的前提下,找到最重要的那些Token。 MiniMax MSA给出的答案是两阶段架构。 第一阶段叫Index Branch,索引分支。它用轻量级的索引查询对KV块进行Block Max Pool加Top-k选择,快速定位重要的KV块。每个GQA组只使用一个索引查询,维度从n'×h×d压缩到n'×1×d。 第二阶段叫Sparse Branch,稀疏分支。它只对选中的Top-k KV块执行完整注意力计算,大幅降低计算量。 用大白话说,先粗筛,再精算。 ## **三、为什么是两阶段而不是一阶段** 你可能会问,为什么不直接让索引分支同时承担选择和输出两件事。 袁境阳博士的解释很关键,压缩本身不是一个可逆过程,它是一种丢信息的操作。 你只能用它来判断哪些Block重要,但不能依赖它来恢复细节。如果直接把压缩结果当作注意力输出,模型将无法学习Token级别的精细关联。 所以MiniMax MSA的设计是,索引分支负责在哪里看,稀疏分支负责看什么。 两条分支分工明确,互不干扰。 ![image](https://developer.qcloudimg.com/http-save/yehe-5421023/b9f305417794d741ea0523f1811d5f5f.jpg) image ## **四、9.7倍和15.6倍是怎么来的** 看那张架构图右侧的性能曲线。 横轴是序列长度,从32k到512k再到1M。纵轴是注意力延迟。 蓝色线代表MiniMax M2,橙色线代表MiniMax M3。 M2的曲线呈指数级上升,到1M token时Prefill延迟接近20秒。M3的曲线几乎是一条水平线,从头到尾维持在2秒左右。 9.7倍加速就是这么来的。 更有意思的是Decoding阶段。M3的加速比达到15.6倍,比Prefill还要高。 原因在于内存带宽。解码阶段是内存受限的操作,每次生成一个新Token都需要访问整个KV Cache。MSA通过只加载选中的KV块,把内存访问量降到原来的十分之一左右。 算力省了,显存省了,延迟也省了。 ## **五、这玩意儿能训练吗** 这是过去两年稀疏注意力研究最大的坑。 大部分工作只在推理阶段生效。一旦回到训练,尤其是预训练阶段,稀疏结构就几乎没有办法成立。 因为训练需要梯度信号。如果你从一开始就把注意力剪得很稀疏,它根本无法知道哪些Token是重要的。它还没学会稀疏,就已经被迫稀疏了。 袁境阳博士在NSA论文里给出的解决方案是三分支架构,压缩,选择,滑动窗口。 压缩分支提供粗粒度的评分,引导模型逐步学会稀疏行为。选择分支负责精细计算。滑动窗口分支确保模型在训练早期不会因为稀疏导致学习断裂。 用他的话说,稀疏不是一个状态,而是一种可以被学习的结构。 MiniMax MSA的两阶段设计,本质上也是这个思路的延续。索引分支提供稳定的索引信号,稀疏分支在选中区域做完整计算。模型可以在预训练中自动探索应该保留哪些块、应该忽略哪些块。 ![image](https://developer.qcloudimg.com/http-save/yehe-5421023/74ea152709047f5d56abee3bcf709103.png) image ## **六、硬件对齐才是真加速** 算法设计得再漂亮,跑不起来也是白搭。 稀疏注意力的核心挑战不是减少计算量,而是减少访存。 如果你把计算量减少了,但为了找到那些散落的稀疏块导致I/O翻倍,那它永远不会比密集注意力更快。 Flash Attention的设计假设是密集、顺序、规则。每个Q Head都会访问完整的K-V序列,数据连续性强,硬件利用率很高。但稀疏注意力的特点是每个q所需要访问的k-v块并不是连续的,而是根据Index动态选择的。 MiniMax MSA的解决方案是让所有属于同一个GQA Group的Head,在一个解码步骤中共享同一组KV Block。只需要把这些Block加载一次到SRAM,然后所有Head都能基于它们做选择。 用算法统一选择,用硬件统一加载。 这才是从底层改变游戏规则的尝试。 ![image](https://developer.qcloudimg.com/http-save/yehe-5421023/552c2581ae748f0d927934970d37b715.jpg) image ## **七、MiniMax的技术演进路线** 把时间线拉长,MiniMax在注意力机制上的布局其实很清晰。 2025年6月,MiniMax-M1发布。全球首个开源权重大规模混合注意力推理模型,支持100万token上下文。核心是Lightning Attention,一种线性注意力变体,把历史信息压缩进固定大小的循环状态。 2025年12月,MiniMax-M2.1开源。引入Interleaved Thinking动态思考机制,提升Agent泛化能力。混合注意力机制结合了Lightning Attention、Softmax Attention和MoE。 2026年5月,M3预告。MSA稀疏注意力架构曝光,两阶段设计,9.7倍Prefill加速,15.6倍Decoding加速。 从Lightning Attention到MSA,MiniMax一直在探索高效注意力的不同路径。Lightning Attention走的是线性复杂度路线,MSA走的是稀疏化路线。两条路线殊途同归,目标都是解决长上下文的计算瓶颈。 ## **八、M3还没发,为什么值得期待** 截止目前,MiniMax还没有公布M3的具体发布日期、参数规模、开源仓库地址。 但几个信号值得注意。 第一,MiniMax有开源传统。M1和M2.1都已经在GitHub和HuggingFace上公开了完整权重和技术报告。如果M3延续这个策略,社区很快就能拿到真东西。 第二,MSA架构的设计有理论支撑。两阶段稀疏注意力不是拍脑袋想出来的,而是基于GQA、Block Max Pool、Top-k Selection这套经过验证的技术栈。北大NSA论文已经在27B模型上证明了稀疏注意力可以在不损失性能的前提下实现10倍以上加速。 第三,性能数据有参考价值。9.7倍和15.6倍是对比M2得出的,而M2本身已经支持1M token上下文。这意味着M3不是从零开始,而是在已有长上下文能力基础上的进一步优化。 ## **九、长上下文赛道的竞争逻辑变了** 过去两年,大模型竞争的主线是参数规模。谁家模型参数多,谁就赢。 但现在这个逻辑正在被重写。 当上下文从4k扩展到100万token,注意力机制的计算成本成为新的瓶颈。你模型再大,注意力算不过来也是白搭。 MiniMax MSA、DeepSeek NSA、还有各种稀疏注意力变体,本质上都在回答同一个问题,如何让模型把算力花在应该花的地方。 这个问题的答案,可能比参数规模更能决定下一轮竞争的胜负。 ## **十、写在最后** MiniMax M3还没发,但MSA架构图已经透露了足够多的信息。 两阶段稀疏注意力,索引分支加稀疏分支。9.7倍Prefill加速,15.6倍Decoding加速。基于GQA设计,硬件对齐优化。 这套架构能不能在正式发布后兑现预告里的承诺,还需要等技术报告、权重开源和第三方复现来验证。 但有一点可以确定,长上下文时代的注意力机制,正在从密集走向稀疏,从计算密集走向访存优化,从事后剪枝走向原生训练。 MiniMax押注了其中一条路。 这条路通向哪里,很快就能见分晓。

优秀的个人博客,低调大师

“快的那个,会被慢的拖死”,记不断奔跑、看着阿里云产品管控慢慢长大的那个人——尹书威

4月20日20:00-21:30,一场别开生面的技术大会—— “运维/Devops在线技术峰会”将在线举办。从网络基础架构实践和演进,到同城容灾架构剖析;从如何稳定、安全的使用云数据库,到企业如何在云上安全加固最佳实践;从阿里云专家理解的DevOps,到如何构建一个通用化的智能运维平台……不仅一一告诉你云上的运维重点在哪、运维人应该如何思考,也手把手教你如何做。同时,对于处于转型中的企业,我们也邀请了有代表性的互联网公司来分享他们的亲身体验。 阿里云运维/Devops在线技术峰会官网: https://yq.aliyun.com/activity/188 峰会统一报名链接: https://yq.aliyun.com/webinar/join/167 以下为文章正文: 她,从行业软件、共享软件、OA系统到联想网盘,再到阿里云,并扎在云计算领域

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册