首页 文章 精选 留言 我的

精选列表

搜索[AI运维],共10000篇文章
优秀的个人博客,低调大师

全新Linux+Python高端运维班-Linux grep正则表达式练习,及find命令

本周作业内容: 1、显示当前系统上root、fedora或user1用户的默认shell; 1 2 3 4 5 6 7 [root@liuhome] #grep-E"^(root|fedora|user1)\>"/etc/passwd|cut-d:-f1,7 root: /bin/bash user1: /bin/bash fedora: /bin/bash #本题使用扩展的正则表达式 #^:首行|:或者():将一个或者多个字符捆绑在一起当作一个整体来处理\>:表示词尾定锚定 #cut-d:f1,7表示用:号作为分隔符,截取第1字段和第7个字段.分别代表用户名和默认的登陆shell 2、找出/etc/rc.d/init.d/functions文件中某单词后面跟一组小括号的行,形如:hello(); 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 [root@liu/] #grep-E-o"[_[:alpha:]]+\(\)"/etc/rc.d/init.d/functions fstab_decode_str() checkpid() __readlink() __fgrep() __umount_loop() __umount_loopback_loop() __pids_var_run() __pids_pidof() daemon() killproc() pidfileofproc() pidofproc() status() echo_success() echo_failure() echo_passed() echo_warning() update_boot_stage() success() failure() passed() warning() action() strstr() confirm() get_numeric_dev() is_ignored_file() is_true() is_false() apply_sysctl() key_is_random() find_crypto_mount_point() init_crypto() #使用grep-E或者egrep扩展正则表达式,-o表示只匹配到符合的字符 #[_[:alpha:]]表示以_或者大小写字母开头的字符;+表示前面的字符出现一次或多次; #要匹配包含()的行,在过滤时需要对小括号进行转义:\(\) 3、使用echo命令输出一个绝对路径,使用grep取出其基名; 1 2 3 4 [root@liu/] #echo"/tmp/ljohn/useradd.sh"|grep-E-o"[^/]+$" useradd .sh [root@liu~] #echo"/tmp/ljohn/useradd.sh/"|grep-Eo"[^/]+/?$"|cut-d'/'-f1 useradd .sh #基名basename /tmp/ljohn/useradd.sh 1 2 3 4 [root@liu~] #basename/tmp/ljohn/useradd.sh useradd .sh [root@liu~] #basename/tmp/ljohn/useradd.sh/ useradd .sh 1 2 3 #这样可以看出第二种同basename命令。 #行尾的字符串[^/]除了/斜线的任意内容,+代表这个/至少出现1次 #$:表示行尾锚定 扩展:取出其路径名 1 2 3 4 5 6 7 8 9 [root@liu/] #echo"/tmp/ljohn/useradd.sh"|grep-E-o"^/.*/" /tmp/ljohn/ [root@liu~] #echo"/tmp/ljohn/useradd.sh"|grep-Eo"^/.*/"|grep-Eo"^/.*[^/]" /tmp/ljohn #目录名dirname/tmp/ljohn/useradd.sh [root@liu~] #dirname/tmp/ljohn/useradd.sh /tmp/ljohn [root@liu~] #dirname/tmp/ljohn/useradd.sh/ /tmp/ljohn 1 2 3 4 #这样可以看出第二种同dirname命令 #^/.*/表示以/开头,中间任意长度字符,以/结尾。 #.*:任意长度的任意字符 #[^/]:除了斜线的任意内容 4、找出ifconfig命令结果中的1-255之间数字; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 [root@liu/] #ifconfig|grep-E-o"\<([1-9]|[1-9][0-9]|1[0-9][0-9]|2[0-9][0-9])\>"|sort -n-u 5 8 19 20 29 30 31 38 39 41 42 45 64 100 127 128 137 150 164 168 192 255 #[1-9]表示1-9;[1-9][0-9]表示10-99;1[0-9][0-9]表示100-199;2[0-9][0-9])表示200-299 #使用-o参数表示只显示匹配到的字符; #sort-n-u按数字大小排序并去重; 5、挑战题:写一个模式,能匹配合理的IP地址; # A类地址范围:1.0.0.1—126.255.255.254 B类地址范围:128.0.0.1—191.255.255.254 # C类地址范围:192.0.0.1—223.255.255.254 D类地址范围:224.0.0.1—239.255.255.254 # E类地址范围:240.0.0.1—255.255.255.254 127.X.X.X是保留地址,用做循环测试用的 # 匹配范围为 1-255.0-255.0-255.1-254 1 2 3 [root@liu/] #ifconfig|grep-E-o"(2[0-5]{2}|1[0-9]{2}|[1-9][0-9]|[1-9])\.((2[0-5]{2}|1[0-9]{2}|[1-9][0-9]|[0-9])\.){2}\<(2[0-5][0-4]|1[0-9]{2}|[1-9][0-9]|[1-9])\>" 192.168.137.30 127.0.0.1 #此题参考http://ld0381.blog.51cto.com/3318114/1845601; http://2368360.blog.51cto.com/2358360/1846091 #详细解析: ^PATTERN$ 用于模式匹配整行 {2}表示前面字符正好出现两次 | 的意思是或者 ( )上面的括号不能少,是为了匹配括号中整体字符串,表达式中有几个()就表示有几个相应的匹配字符串 [0-4]表示0~4的任何一个数字 [0-9]表示0~9的任何一个数字 [1-9]的意思是1~9之间的任意一个数字 [1-9][0-9]的意思是10~99之间的任意一个数字 1[0-9]{2}的意思就是100~199之间的任意一个数字 2[0-4][0-9]的意思是200~249之间的任意一个数字 25[0-5]的意思是250~255之间的任意一个数字 \.的意思是.点要转义为普通字符 6、挑战题:写一个模式,能匹配出所有的邮件地址; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 [root@liu/] #cat/tmp/mail.txt 184694637@qq.com lshailkj@qq.com ljohnmail@foxmail.com foxmail@_cmd.cn ljohn@163.com lkjdas_ #@123_.com [root@liu/] #grep-E"^[[:alnum:]]+@[[:alnum:]]+\.[[:alnum:]]+$"/tmp/mail.txt 184694637@qq.com lshailkj@qq.com ljohnmail@foxmail.com ljohn@163.com #先创建了一个mail.txt的文件事先编辑了几个邮箱 #首先要了解邮箱的格式:数字字母@数字字母.数字字母 #[[:alnum:]]+表示任意数字或字母 7、查找/var目录下属主为root,且属组为mail的所有文件或目录; 1 2 3 4 5 [root@liu~] #find/var-userroot-groupmail-ls 2622964drwxrwxr-x2rootmail40969月415:35 /var/spool/mail 2620484-rw-------1rootmail23539月317:33 /var/spool/mail/root #find命令格式:find[OPTION]...[查找路径][查找条件][处理动作] #find命令实现对属主,数组的匹配,使用-user和-group来实现。 8、查找当前系统上没有属主或属组的文件; 1 2 3 4 5 6 7 8 9 10 11 [root@liu~] #find/-nouser-o-nogroup /home/mandirva /home/mandirva/ .gnome2 /home/mandirva/ .bashrc /home/mandirva/ .mozilla /home/mandirva/ .mozilla /plugins /home/mandirva/ .mozilla /extensions /home/mandirva/ .bash_logout /home/mandirva/ .bash_profile /var/spool/mail/mandirva #-nouser没有属主;-nogroup没有数组 进一步:查找当前系统上没有属主或属组,且最近3天内曾被访问过的文件或目录; 1 2 3 4 5 6 7 8 9 10 [root@liu~] #find/\(-nouser-o-nogroup\)-atime-3 find :“ /proc/3759/task/3759/fd/5 ”:没有那个文件或目录 find :“ /proc/3759/task/3759/fdinfo/5 ”:没有那个文件或目录 find :“ /proc/3759/fd/5 ”:没有那个文件或目录 find :“ /proc/3759/fdinfo/5 ”:没有那个文件或目录 /home/mandirva /home/mandirva/ .gnome2 /home/mandirva/ .mozilla /home/mandirva/ .mozilla /plugins /home/mandirva/ .mozilla /extensions 9、查找/etc目录下所有用户都有写权限的文件; 1 2 3 4 5 6 7 [root@liu~] #find/etc-perm-222 /etc/rc .d /rc1 .d /K73winbind /etc/rc .d /rc1 .d /K92iptables /etc/rc .d /rc1 .d /K99rngd /etc/rc .d /rc1 .d /K84wpa_supplicant /etc/rc .d /rc1 .d /K89portreserve ... #根据权限查找: -perm [+|-]MODE MODE: 精确权限匹配 +MODE:任何一类(u,g,o)对象的权限中只要能一位匹配即可; -MODE:每一类对象都必须同时拥有为其指定的权限标准; -222:表示每一个用户都有写权限。 10、查找/etc目录下大于1M,且类型为普通文件的所有文件; 1 2 3 4 [root@liu~] #find/etc/-typef-size+1M /etc/selinux/targeted/modules/active/policy .kern /etc/selinux/targeted/policy/policy .24 /etc/gconf/gconf .xml.defaults/%gconf-tree.xml #根据类型查找: -type TYPE: f: 普通文件 d: 目录文件 l: 符号链接文件 s:套接字文件 b: 块设备文件 c: 字符设备文件 p: 管道文件 #根据文件大小查找: -size [+|-]#UNIT 常用单位:k, M, G #UNIT: (#-1, #] -#UNIT:[0,#-1] +#UNIT:(#,oo) 11、查找/etc/init.d/目录下,所有用户都有执行权限,且其它用户有写权限的文件; 1 2 [root@liu~] #find/etc/init.d-perm-113-ls 6529140lrwxrwxrwx1rootroot112月122015 /etc/init .d->rc.d /init .d 12、查找/usr目录下不属于root、bin或hadoop的文件; 1 2 3 4 5 [root@liu~] #find/usr-not\(-userroot-o-userbin-o-userhadoop\)-ls 209568-rwsr-xr-x1abrtabrt670011月232013 /usr/libexec/abrt-action-install-debuginfo-to-abrt-cache 或者: [root@liu~] #find/usr-not-userroot-a-not-userbin-a-not-userhadoop-ls 209568-rwsr-xr-x1abrtabrt670011月232013 /usr/libexec/abrt-action-install-debuginfo-to-abrt-cache 13、查找/etc/目录下至少有一类用户没有写权限的文件; 1 2 3 4 5 [root@liu~] #find/etc-not-perm-222-ls 65280212drwxr-xr-x118rootroot122889月415:35 /etc 6528260-rw-r--r--1rootroot01月122010 /etc/exports 6619614drwxr-xr-x2rootroot40968月3023:52 /etc/glances 6620334-rw-r--r--1rootroot32881月182014 /etc/glances/glances .conf ... 14、查找/etc目录下最近一周内其内容被修改过,且不属于root或hadoop的文件; 创建一个文件并修改权限: 1 2 3 4 5 6 7 8 9 10 [root@liuetc] #cat>findtest.txt<<EOF >123123 >Hello!! >Howareyou! >EOF [root@liuetc] #chownliu.liufindtest.txt [root@liuetc] #ls-lfindtest.txt -rw-r--r--.1liuliu299月505:07findtest.txt [root@liuetc] #find/etc-mtime-7-not-userroot-not-userhadoop /etc/findtest .txt 本文转自 ljohnmail 51CTO博客,原文链接:http://blog.51cto.com/ljohn/1846386,如需转载请自行联系原作者

优秀的个人博客,低调大师

2016全新Linux+Python高端运维班-Linux grep命令及基本正则表达式

本周作业内容: 1、复制/etc/skel目录为/home/tuser1,要求/home/tuser1及其内部文件的属组和其它用户均没有任何访问权限。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 第一种方式: [root@liu/] #chmod-Rgo=---/home/tuser1 [root@liutuser1] #ls-l/home/tuser1/ 总用量4 -rw-------.1rootroot478月2500:01issue 第二种方式: [root@liu/] #rm-rf/home/tuser1/ [root@liu/] #cp-r/etc/skel//home/tuser1 [root@liu/] #chmod-Rg-rwx/home/tuser1/ [root@liu/] #chmod-Ro-rwx/home/tuser1/ [root@liu/] #ls-l/home/tuser1/ 总用量4 -rw-------.1rootroot478月2500:12issue [root@liu/] #ls-ld/home/tuser1/ drwx------.4rootroot40968月2500:12 /home/tuser1/ 2、编辑/etc/group文件,添加组hadoop。 1 2 3 4 5 6 7 第一种方式: [root@liu/] #echo"hadoop:x:3008:">>/etc/group 第二种方式: vim /etc/group 在最下面添加一行: hadoop:x:3009: 保存退出。 3、手动编辑/etc/passwd文件新增一行,添加用户hadoop,其基本组ID为hadoop组的id号;其家目录为/home/hadoop。 1 2 3 4 5 6 vim /etc/passwd 在最下面添加一行: hadoop:x:3008:3008:: /home/hadoop : /bin/bash 保存退出。 [root@liu/] #idhadoop uid=3008(hadoop)gid=3008(hadoop)组=3008(hadoop) 4、复制/etc/skel目录为/home/hadoop,要求修改hadoop目录的属组和其它用户没有任何访问权限。 1 2 3 4 5 6 7 8 9 10 11 12 [root@liu/] #cp-r/etc/skel//home/hadoop [root@liu/] #chmod-Rgo=---/home/hadoop [root@liu/] #ls-la/home/hadoop 总用量32 drwx------.4rootroot40968月2500:33. drwxr-xr-x.19rootroot40968月2500:33.. -rw-------.1rootroot188月2500:33.bash_logout -rw-------.1rootroot1768月2500:33.bash_profile -rw-------.1rootroot1248月2500:33.bashrc drwx------.2rootroot40968月2500:33.gnome2 -rw-------.1rootroot478月2500:33issue drwx------.4rootroot40968月2500:33.mozilla 5、修改/home/hadoop目录及其内部所有文件的属主为hadoop,属组为hadoop。知识点: 修改文件的属主:chown chown [OPTION]... [OWNER][:[GROUP]] FILE... 用法: OWNER OWNER:GROUP :GROUP Note: 命令中的冒号可用.替换; -R: 递归 chown [OPTION]... --reference=RFILE FILE... 1 2 3 [root@liu/] #chown-Rhadoop:hadoop/home/hadoop/ [root@liu/] #idhadoop uid=3008(hadoop)gid=3008(hadoop)组=3008(hadoop) 6、显示/proc/meminfo文件中以大写或小写S开头的行;用两种方式; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@liu/] #grep'^[Ss]'/proc/meminfo SwapCached:0kB SwapTotal:2097144kB SwapFree:2097144kB Shmem:3296kB Slab:46576kB SReclaimable:13148kB SUnreclaim:33428kB [root@liu/] #grep-i"^s"/proc/meminfo SwapCached:0kB SwapTotal:2097144kB SwapFree:2097144kB Shmem:3296kB Slab:46584kB SReclaimable:13160kB SUnreclaim:33424kB 7、显示/etc/passwd文件中其默认shell为非/sbin/nologin的用户;知识点: grep [OPTIONS] PATTERN [FILE...] 选项: --color=auto: 对匹配到的文本着色显示; -v: 显示不能够被pattern匹配到的行; -i: 忽略字符大小写; -o: 仅显示匹配到的字符串; -q: 静默模式,不输出任何信息; -A #:after, 后#行 -B #: before, 前#行 -C #:context, 前后各#行 -E:使用ERE; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 [root@liu/] #grep-v"/sbin/nologin"/etc/passwd|cut-d:-f1 root sync shutdown halt liu bash basher testbash centos useradd1 mageia slackware openstacks user1 user2 user3 hadoop 8、显示/etc/passwd文件中其默认shell为/bin/bash的用户; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 [root@liu/] #grep"/bin/bash"/etc/passwd|cut-d:-f1 root liu bash basher testbash centos useradd1 mageia openstacks user1 user2 user3 hadoop 9、找出/etc/passwd文件中的一位数或两位数;知识点: 基本正则表达式元字符: 字符匹配: .: 匹配任意单个字符; []: 匹配指定范围内的任意单个字符 [^]:匹配指定范围外的任意单个字符 [:digit:]、[:lower:]、[:upper:]、[:alpha:]、[:alnum:]、[:punct:]、[:space:] 匹配次数:用在要指定次数的字符后面,用于指定前面的字符要出现的次数; *:匹配前面的字符任意次; 例如: grep "x*y" abxy xay xxxxxxy 贪婪模式 .*:任意长度的任意字符; \?:匹配其前面的字符0或1次;即前面的可有可无; \+:匹配其前面的字符至少1次; \{m\}:匹配前面的字符m次; \{m,n\}:匹配前面的字符至少m次,至多n次; \{0,n\}:匹配前面的字符至多n次; \{m,\}:匹配前面的字符至少m次; 位置锚定: ^:行首锚定;用于模式的最左侧; $:行尾锚定;用于模式的最右侧; ^PATTERN$: 用于模式匹配整行; ^$: 空行; ^[[:space:]]*$ \< 或 \b:词首锚定;用于单词模式的左侧; \> 或 \b:词尾锚定;用于单词模式的右侧; \<PATTERN\>:匹配整个单词; 分组: \(\):将一个或多个字符捆绑在一起,当作一个整体进行处理; \(xy\)*ab 1 [root@liu/] #grep-E-o"\<[0-9]{1,2}\>"/etc/passwd 10、显示/boot/grub/grub.conf中以至少一个空白字符开头的行; 1 2 3 4 5 6 7 8 [root@liu/] #grep"^[[:space:]]\+"/boot/grub/grub.conf root(hd0,0) kernel /vmlinuz-2 .6.32-431.el6.i686ro root=UUID=3fcabd0f-e9fb-4618-918d-c9e004fe6a59rd_NO_LUKS KEYBOARDTYPE=pcKEYTABLE=usrd_NO_MDcrashkernel=autoLANG=zh_CN.UTF-8 rd_NO_LVMrd_NO_DMrhgbquiet initrd /initramfs-2 .6.32-431.el6.i686.img 11、显示/etc/rc.d/rc.sysinit文件中以#开头,后面跟至少一个空白字符,而后又有至少一个非空白字符的行; 1 2 3 4 5 6 7 8 9 10 11 12 13 [root@liu/] #grep"^#[[:space:]]\+[^[:space:]]\+"/etc/rc.d/rc.sysinit #/etc/rc.d/rc.sysinit-runonceatboottime #TakeninpartfromMiquelvanSmoorenburg'sbcheckrc. #CheckSELinuxstatus #Printatextbanner. #Onlyreadthisonce. #Initializehardware #Setdefaultaffinity #Loadotheruser-definedmodules #Loadmodules(forbackwardcompatibilitywithVARs) #Configurekernelparameters #Setthehostname. ... 12、打出netstat -tan命令执行结果中以‘LISTEN’,后或跟空白字符结尾的行; 1 2 3 4 5 6 7 8 9 10 11 12 13 [root@liu/] #netstat-tan|grep"LISTEN[[:space:]]\+$" tcp000.0.0.0:1110.0.0.0:*LISTEN tcp000.0.0.0:220.0.0.0:*LISTEN tcp00127.0.0.1:6310.0.0.0:*LISTEN tcp00127.0.0.1:250.0.0.0:*LISTEN tcp000.0.0.0:336610.0.0.0:*LISTEN tcp00:::36996:::*LISTEN tcp00:::111:::*LISTEN tcp00:::22:::*LISTEN tcp00::1:631:::*LISTEN tcp00::1:25:::*LISTEN 或者使用 egrep 命令 netstat -tan| egrep "LISTEN[[:space:]]+$" 13、添加用户bash, testbash, basher, nologin (此一个用户的shell为/sbin/nologin),而后找出当前系统上其用户名和默认shell相同的用户的信息; 1 2 3 4 5 6 7 8 9 10 [root@liu/] #useraddbash [root@liu/] #useraddtestbash [root@liu/] #useraddbasher [root@liu/] #useraddnologin-s/sbin/nologin [root@liu/] #grep"^\(\<[[:alpha:]]\+\>\).*\1$"/etc/passwd sync :x:5:0: sync : /sbin : /bin/sync shutdown :x:6:0: shutdown : /sbin : /sbin/shutdown halt:x:7:0:halt: /sbin : /sbin/halt bash :x:501:501:: /home/bash : /bin/bash nologin:x:504:504:: /home/nologin : /sbin/nologin 本文转自 ljohnmail 51CTO博客,原文链接:http://blog.51cto.com/ljohn/1843661,如需转载请自行联系原作者

优秀的个人博客,低调大师

foreman架构的引入1-foreman作为自动化运维工具为什么会如此强大

零基础学习Puppet自动化配置管理系列文档 在引入foreman之前,笔者曾经大幅度测试过puppet的另外一个生态圈前端软件,那就是KermIT(kermit.fr需要墙)。说实话基于KermIT这套架构还是相当不错的,尤其是在于mcollective的各种插件结合上做的很完美,可惜社区太不活跃,软件版本更新超慢,坑超多,最终还是放弃了。不过,他的架构还是值得借鉴的,对于那些想自己在puppet前端做UI的朋友可以多参考参考。 本文引入另外一个非常出色的前端管理工具Foreman,什么是foreman呢,官方是这样定义的:Foreman是一个物理和虚拟服务器的完整的生命周期管理工具(Foreman is a complete lifecycle management tool for physical and virtual servers)。 为什么要引入foreman作为配置管理工具的前端呢? 本文从以下几个方面入手进行剖析 1、foreman的架构 A Foreman installation will always contain a central foreman instance that is responsible for providing the Web based GUI, node configurations, initial host configuration files, etc. However, if the foreman installation supports unattended installations then other operations need to be performed to fully automate this process. The smart proxy manages remote services and is generally installed with all Foreman installations to allow for TFTP, DHCP, DNS, and Puppet, and the Puppet CA. 以上为官方的定义,我这里在根据日常使用的情况进行一些概括(以目前最新稳定版本1.5.2为例进行说明) foreman本身只是一个框架,通过smart-proxy代理各种应用程序完成各项功能。Foreman框架 foreman通过代理DNS、DHCP、TFTP完成了kickstart、cobbler、jumpstart等各种自动化安装系统工具的图形统一管理窗口,实现的结果是只需要在foreman上定制各种模板(pxe、ks),不同的模板还可以嵌套各种片段(snippet)达到统一、简化的目的。完成之后,便可以添加节点,关联定义的各种模板生成各种的pxe和ks文件实现自动化安装。Foreman版本发展线路图Foreman版本发展线路图 foreman通过代理puppet、puppet CA完成对puppet自动签名、puppet环境、class、变量、facter的管理。Foreman版本发展线路图Foreman版本发展线路图 foreman通过ENC和静态组管理class和node之间的关联。Foreman版本发展线路图 foreman通过puppet plugin,可以在UI上完成对节点puppet命令的触发动作,触发的方法可以借助puppetkick(已经被遗弃)、mcollective(借助sudo)、puppetssh(借助sshkey)、salt、customrun等各种工具实现。Foreman版本发展线路图 foreman可以收集所有节点运行puppet后的报告、执行情况。Foreman版本发展线路图 foreman还提供了各种搜索、报表等功能,能够更好的展现节点的运行状况。Foreman版本发展线路图 foreman除了管理裸机外还可以管理各种虚拟化软件,比如RHEV-M、EC2、VMWware和OpenStack等。Foreman版本发展线路图 foreman还可以和LDAP以及AD集成。 foreman还提供了强大了用户、权限管理入口,可以建立多个用户、多个用户组、还可以对权限进行角色的定义等。不同的权限用户在UI上所看到的功能以及主机是不一样的。Foreman版本发展线路图 foreman还提供了所有在UI上操作的Audits(审计)功能,这样可以保障所有用户的操作都有据可查。Foreman版本发展线路图 除此之外,还有其它很多功能。。。。 针对配置管理的不足之处:foreman和mcollective的结合并不是很好,它仅仅是借用了puppetkick的插件集成了mcollective的一条命令而已,这方面后期是否会有改进还需要等待。 2、foreman的版本蓝图 以下为foreman的版本发展线路图 Foreman版本发展线路图 从图中可以看出,foreman的发展是相当的迅速的,无论是版本更替上还是社区的活跃度上都是相当的良好。 本文转自凌激冰51CTO博客,原文链接:http://blog.51cto.com/dreamfire/1542171,如需转载请自行联系原作者

优秀的个人博客,低调大师

面试宝典_Python.运维开发.0004.用Python实现tail实时输出新增日志?

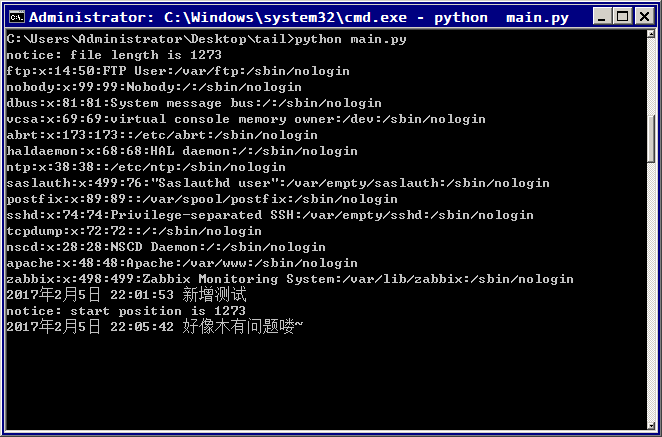
面试题目: 1. 用PYTHON实现tail -f功能,默认显示最后15行,实时输出新增行? 解题思路: 1. 此需求在很多场景中都有遇到,而且在各大群中也被讨论过,虽然有现成的模版如pyinotify等模块实现,但面试更想通过你的解题思路来判断这场面试,具体到tail需要实现2个功能,一个实时输出新增内容,一个默认输出前15行,前者直接循环打开文件读取,全局变量中记录上次读取的位置,下一次循环seek到上次的位置读取即可,而对于默认显示前15行的做法是假设一行1000个字节,循环读取,当文件总长度小于1000时则从开头开始读取分割行取出后10行即可,即使不够10行也没关系,当文件总长度大于等于1000时,如果分割后大于10行,则读取分割行取出后10行即可,如果小于10行则继续向前1000个读取,以此类推~ 具体实现: #!/usr/bin/envpython #-*-coding:utf-8-*- """ # #Authors:limanman #51CTOBG:http://xmdevops.blog.51cto.com/ #Purpose: # """ from__future__importabsolute_import #说明:导入公共模块 importos importsys importtime importchardet #说明:导入其它模块 # if__name__=='__main__': seekps=0; target='data.txt'; try: #指针跳到最后作为起读位置 withopen(target,'r+b')asf: f.seek(0,os.SEEK_END) seekps=f.tell() print'notice:filelengthis',seekps rest_lines=[] #默认读取15行 line_reads=15 #假设默认每行1000字节 line_bytes=1000 ''' 1.当f_length<line_bytes,就seek到0开始读取,读完break 2.当f_length>line_bytes,换行符数n表示n+1行 =>当n+1>=line_reads,取出其中前line_reads个元素 =>当n+1<line_reads,继续向前seek到count*line_reads位置读取 ''' count=1 whileTrue: ifseekps<=line_bytes*count: f.seek(0) rest_lines=f.read().split(os.linesep)[-line_reads:] break f.seek(-1*line_bytes*count,2) rest_lines=f.read().split(os.linesep) iflen(rest_lines)>=line_reads: rest_lines=rest_lines[-line_reads:] break else: count+=1 forlineinrest_lines: code=chardet.detect(line).get('encoding') line=line.decode(code).encode(sys.stdout.encoding) sys.stdout.write(''.join([line.strip(),os.linesep])) sys.stdout.flush() exceptException,e: print'notice:openfilewitherror({0})'.format(e) exit() print'notice:startpositionis',seekps whileTrue: try: withopen(target,'r+b')asf: f.seek(0,os.SEEK_END) #防止数据被意外截断 iff.tell()<seekps: f.seek(f.tell()) else: f.seek(seekps) whileTrue: line=f.readline() ifnotline.strip(): break code=chardet.detect(line).get('encoding') line=line.decode(code).encode(sys.stdout.encoding) sys.stdout.write(''.join([line.strip(),os.linesep])) sys.stdout.flush() seekps=f.tell() exceptException,e: print'notice:openfilewitherror({0})'.format(e) break time.sleep(0.1) 有图有像:


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册