首页 文章 精选 留言 我的

精选列表

搜索[Solon框架],共10000篇文章
优秀的个人博客,低调大师

Tokio 1.0 发布,Rust 异步编程框架

Tokio 1.0 稳定版本已发布,Tokio 是 Rust 的异步 runtime,可用于编写快速、可靠的网络应用。Tokio 还提供用于 TCP、UDP、计时器、多线程、工作窃取算法(work-stealing)调度等的 API。 Tokio 团队表示,虽然 Tokio 从四年前刚诞生起就一直在不断发展,不过出现真正的显著变化是在一年前,因为 Rust 在当时才正式支持 async/await。 示例代码 使用 Tokio 编写的基本 TCP echo 服务器: use tokio::net::TcpListener; use tokio::io::{AsyncReadExt, AsyncWriteExt}; #[tokio::main] async fn main() -> Result<(), Box<dyn std::error::Error>> { let mut listener = TcpListener::bind("127.0.0.1:8080").await?; loop { let (mut socket, _) = listener.accept().await?; tokio::spawn(async move { let mut buf = [0; 1024]; // In a loop, read data from the socket and write the data back. loop { let n = match socket.read(&mut buf).await { // socket closed Ok(n) if n == 0 => return, Ok(n) => n, Err(e) => { eprintln!("failed to read from socket; err = {:?}", e); return; } }; // Write the data back if let Err(e) = socket.write_all(&buf[0..n]).await { eprintln!("failed to write to socket; err = {:?}", e); return; } } }); } } 在发布公告中,Tokio 团队还介绍了 Tokio 的知名用户和案例。例如,Discord通过使用 Tokio 将长尾延迟 (Tail Latency) 降低了 5 倍;Fly.io使用 Tokio 后轻易满足了性能要求;AWS 的Lambda团队也使用 Tokio 实现了更可靠、更灵活的服务。 1.0 作为重要版本更新,Tokio 团队对其稳定性做出了保证,承诺会为 Rust 生态提供稳定的基础设施。Tokio 团队表示目前没有关于 Tokio 2.0 的计划,并承诺至少在 3 年内不发布 Tokio 2.0。他们计划为 1.0 提供至少 5 年的维护支持。 当然,稳定并不意味着 Tokio 停滞不前,Tokio 团队介绍了他们未来要完成的工作:推动 Stream trait 进入 Rust 标准库、实现 io_uring 接口、集成 tracing 以及完善Tokio 的整体生态。这里的生态就是 Tokio 团队所说的 Tokio stack。举个例子,Tokio 为标准基元 (standard primitives),如 socket 和定时器提供了 runtime 和异步API,但网络应用通常会使用更高级别的协议,如 HTTP 和 gRPC。因此 Tokio stack 会提供HTTP 的 Hyper 和 gRPC 的 Tonic 以满足需求。 最后,Tokio 团队表示随着 Tokio 的推出,他们会专注于开发 Tower,这是一套用于构建可靠客户端和服务器的可重用组件。 详情查看https://tokio.rs/blog/2020-12-tokio-1-0

优秀的个人博客,低调大师

前端框架 Bootstrap 5 Beta 1 发布

Bootstrap 5 Beta 1 现已发布。官方表示,该版本包含了许多新功能以及重大更改。此后,其将只对功能、bug 和文档进行微调。本次更新的一些重点内容如下: 添加了 RTL 支持。具体变化有: CSS dist 文件的新 RTL 版本,其中包括网格、Reboot、实用工具和标准捆绑包。可参阅目录页面以获取文件的完整列表。 新的 RTL 文档帮助入门。 五个新的 RTL 示例展示了新的 RTL CSS 的运行情况,并将 Album、Checkout、Carousel、Blog 和 Dashboard 示例转换为所有新的从右到左的等效项。 两个新的 cheatsheet kitchen sink页面 重命名逻辑属性类 将 Popper 更新到 v2.x,并对其工具提示和弹出窗口进行了一些小改动。 在数据属性中添加命名空间 "bs"。示例如下: <div class="dropdown"> <button class="btn btn-secondary dropdown-toggle" type="button" id="dropdownMenuButton" data-bs-toggle="dropdown" aria-expanded="false"> Dropdown button </button> <ul class="dropdown-menu" aria-labelledby="dropdownMenuButton"> <li><a class="dropdown-item" href="#">Action</a></li> <li><a class="dropdown-item" href="#">Another action</a></li> <li><a class="dropdown-item" href="#">Something else here</a></li> </ul> </div> 添加新的 toast positioning JavaScript 改进和错误修复 通过 state 选项更新了具有 pseudo-classes支持的实用程序 API 更多详情可查看:https://github.com/twbs/bootstrap/releases/tag/v5.0.0-beta1

优秀的个人博客,低调大师

gRPC 1.34.0 发布,高性能 RPC 框架

gRPC Core 的 1.34.0 版已经发布,详细的 gRPC 文档请参阅grpc.io,此版本包含改进和一些错误修复,下面列出了本次更新的一些重点内容: Core 使用环境变量“ GRPC_XDS_EXPERIMENTAL_SECURITY_SUPPORT”保护 xds 安全代码。(#24782) 添加对“ unix-abstract:” URI 的支持,以支持抽象的 unix 域套接字。(#24500) 解析未垂直的 SAN 字段时的增量索引。(#24601) 还原“revert”不推荐使用 GRPC_ARG_HTTP2_MIN_SENT_PING_INTERVAL_WITHOUT_DATA_MS“”。(#24518) xds:NACKING 时将状态代码设置为 INVALID_ARGUMENT。(#24516) 在 address_sorting.h 中包括 stddef.h。(#24514) xds:在 RouteMatch 中添加对 case_sensitive 选项的支持。(#24381) 删除 Android NDK r12b 的 TLS 解决方法。(#24283) C++ 修复 define = grpc_no_xds = true 构建。(#24503) 对 CreateCustomInsecureChannelWithInterceptorsFromFd 的实验支持和测试。(#24362) C# 修复了.NET 5 单文件应用程序中的 C#本机库加载(反向移植到 v1.34.x)。(#24853) 为特定于 Grpc.Core 的本机依赖项设置 RID。(#24766) 改进 PlatformApis 检查以检测 Unity。(#24714) 修复为在 .NET 5 或更高版本上不需要 libc-dev。(#24485) C#:通过将移动支持移至 Grpc.Core.Xamarin 软件包,使 Grpc.Core nuget 更简洁。(#24380) C#:不再支持 linux 和 macos 的 32 位运行时。(#24378) 优化更新 C#HelloworldXamarin 示例。(#24425) Objective-C 支持 grpc-core 和 grpc-cpp 的 swift 软件包管理器。(#24571) 将传输信息添加到 grpc-objc 用户代理中。(#24253) 升级 iOS 和 OSX 到最新版本。(#24282) PHP PHP:在 PECL 扩展中添加了对 PHP 8 的支持。(#24621) PHP:从 PECL 扩展中弃用 PHP 5 支持。(#24353) Python 使 setuptools 作为 grpcio_tools 的依赖项。(#24752) 停止 ctrl-c 为 AsyncIO 服务器生成的垃圾邮件日志。(#24718) 使运行时 Protos 可以使用众所周知的类型。(#24478) 将 Python 的 MACOSX_DEPLOYMENT_TARGET 升级到 10.10。(#24480) 使 Python 2 成为 Bazel 构建的可选依赖项。(#24407) Linux、macOS 支持预编译的 Python 3.9 轮子。(#24356) Ruby 将 Ruby 的 MACOSX_DEPLOYMENT_TARGET 升级到 10.10。(#24479) 详细更新信息:https://github.com/grpc/grpc/releases/tag/v1.34.0

优秀的个人博客,低调大师

Hadoop框架:HDFS高可用环境配置

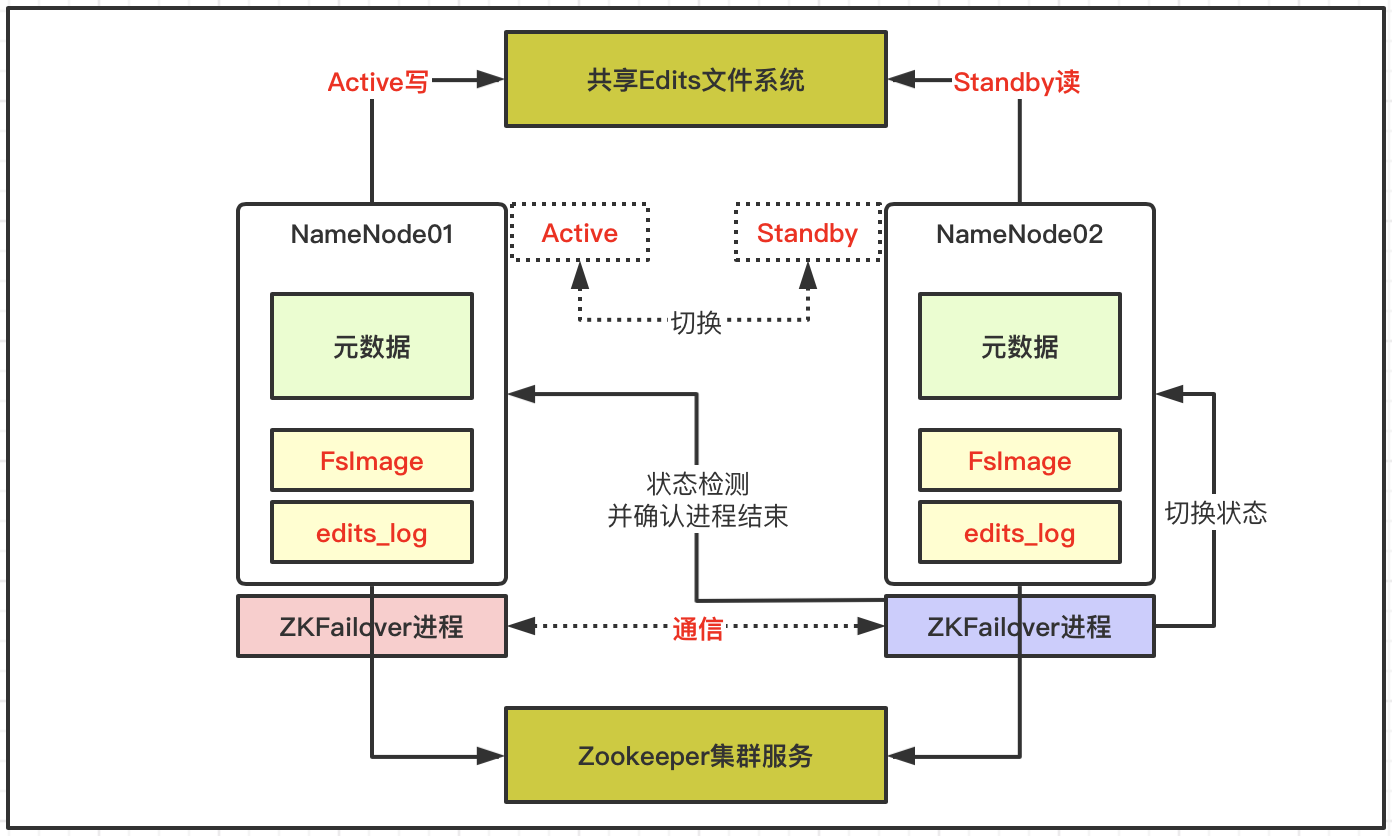
本文源码:GitHub·点这里 || GitEE·点这里 一、HDFS高可用 1、基础描述 在单点或者少数节点故障的情况下,集群还可以正常的提供服务,HDFS高可用机制可以通过配置Active/Standby两个NameNodes节点实现在集群中对NameNode的热备来消除单节点故障问题,如果单个节点出现故障,可通过该方式将NameNode快速切换到另外一个节点上。 2、机制详解 基于两个NameNode做高可用,依赖共享Edits文件和Zookeeper集群; 每个NameNode节点配置一个ZKfailover进程,负责监控所在NameNode节点状态; NameNode与ZooKeeper集群维护一个持久会话; 如果Active节点故障停机,ZooKeeper通知Standby状态的NameNode节点; 在ZKfailover进程检测并确认故障节点无法工作后; ZKfailover通知Standby状态的NameNode节点切换为Active状态继续服务; ZooKeeper在大数据体系中非常重要,协调不同组件的工作,维护并传递数据,例如上述高可用下自动故障转移就依赖于ZooKeeper组件。 二、HDFS高可用 1、整体配置 服务列表 HDFS文件 YARN调度 单服务 共享文件 Zk集群 hop01 DataNode NodeManager NameNode JournalNode ZK-hop01 hop02 DataNode NodeManager ResourceManager JournalNode ZK-hop02 hop03 DataNode NodeManager SecondaryNameNode JournalNode ZK-hop03 2、配置JournalNode 创建目录 [root@hop01 opt]# mkdir hopHA 拷贝Hadoop目录 cp -r /opt/hadoop2.7/ /opt/hopHA/ 配置core-site.xml <configuration> <!-- NameNode集群模式 --> <property> <name>fs.defaultFS</name> <value>hdfs://mycluster</value> </property> <!-- 指定hadoop运行时产生文件的存储目录 --> <property> <name>hadoop.tmp.dir</name> <value>/opt/hopHA/hadoop2.7/data/tmp</value> </property> </configuration> 配置hdfs-site.xml,添加内容如下 <!-- 分布式集群名称 --> <property> <name>dfs.nameservices</name> <value>mycluster</value> </property> <!-- 集群中NameNode节点 --> <property> <name>dfs.ha.namenodes.mycluster</name> <value>nn1,nn2</value> </property> <!-- NN1 RPC通信地址 --> <property> <name>dfs.namenode.rpc-address.mycluster.nn1</name> <value>hop01:9000</value> </property> <!-- NN2 RPC通信地址 --> <property> <name>dfs.namenode.rpc-address.mycluster.nn2</name> <value>hop02:9000</value> </property> <!-- NN1 Http通信地址 --> <property> <name>dfs.namenode.http-address.mycluster.nn1</name> <value>hop01:50070</value> </property> <!-- NN2 Http通信地址 --> <property> <name>dfs.namenode.http-address.mycluster.nn2</name> <value>hop02:50070</value> </property> <!-- 指定NameNode元数据在JournalNode上的存放位置 --> <property> <name>dfs.namenode.shared.edits.dir</name> <value>qjournal://hop01:8485;hop02:8485;hop03:8485/mycluster</value> </property> <!-- 配置隔离机制,即同一时刻只能有一台服务器对外响应 --> <property> <name>dfs.ha.fencing.methods</name> <value>sshfence</value> </property> <!-- 使用隔离机制时需要ssh无秘钥登录--> <property> <name>dfs.ha.fencing.ssh.private-key-files</name> <value>/root/.ssh/id_rsa</value> </property> <!-- 声明journalnode服务器存储目录--> <property> <name>dfs.journalnode.edits.dir</name> <value>/opt/hopHA/hadoop2.7/data/jn</value> </property> <!-- 关闭权限检查--> <property> <name>dfs.permissions.enable</name> <value>false</value> </property> <!-- 访问代理类失败自动切换实现方式--> <property> <name>dfs.client.failover.proxy.provider.mycluster</name> <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value> </property> 依次启动journalnode服务 [root@hop01 hadoop2.7]# pwd /opt/hopHA/hadoop2.7 [root@hop01 hadoop2.7]# sbin/hadoop-daemon.sh start journalnode 删除hopHA下数据 [root@hop01 hadoop2.7]# rm -rf data/ logs/ NN1格式化并启动NameNode [root@hop01 hadoop2.7]# pwd /opt/hopHA/hadoop2.7 bin/hdfs namenode -format sbin/hadoop-daemon.sh start namenode NN2同步NN1数据 [root@hop02 hadoop2.7]# bin/hdfs namenode -bootstrapStandby NN2启动NameNode [root@hop02 hadoop2.7]# sbin/hadoop-daemon.sh start namenode 查看当前状态 在NN1上启动全部DataNode [root@hop01 hadoop2.7]# sbin/hadoop-daemons.sh start datanode NN1切换为Active状态 [root@hop01 hadoop2.7]# bin/hdfs haadmin -transitionToActive nn1 [root@hop01 hadoop2.7]# bin/hdfs haadmin -getServiceState nn1 active 3、故障转移配置 配置hdfs-site.xml,新增内容如下,同步集群 <property> <name>dfs.ha.automatic-failover.enabled</name> <value>true</value> </property> 配置core-site.xml,新增内容如下,同步集群 <property> <name>ha.zookeeper.quorum</name> <value>hop01:2181,hop02:2181,hop03:2181</value> </property> 关闭全部HDFS服务 [root@hop01 hadoop2.7]# sbin/stop-dfs.sh 启动Zookeeper集群 /opt/zookeeper3.4/bin/zkServer.sh start hop01初始化HA在Zookeeper中状态 [root@hop01 hadoop2.7]# bin/hdfs zkfc -formatZK hop01启动HDFS服务 [root@hop01 hadoop2.7]# sbin/start-dfs.sh NameNode节点启动ZKFailover 这里hop01和hop02先启动的服务状态就是Active,这里先启动hop02。 [hadoop2.7]# sbin/hadoop-daemon.sh start zkfc 结束hop02的NameNode进程 kill -9 14422 等待一下查看hop01状态 [root@hop01 hadoop2.7]# bin/hdfs haadmin -getServiceState nn1 active 三、YARN高可用 1、基础描述 基本流程和思路与HDFS机制类似,依赖Zookeeper集群,当Active节点故障时,Standby节点会切换为Active状态持续服务。 2、配置详解 环境同样基于hop01和hop02来演示。 配置yarn-site.xml,同步集群下服务 <configuration> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <!--启用HA机制--> <property> <name>yarn.resourcemanager.ha.enabled</name> <value>true</value> </property> <!--声明Resourcemanager服务--> <property> <name>yarn.resourcemanager.cluster-id</name> <value>cluster-yarn01</value> </property> <property> <name>yarn.resourcemanager.ha.rm-ids</name> <value>rm1,rm2</value> </property> <property> <name>yarn.resourcemanager.hostname.rm1</name> <value>hop01</value> </property> <property> <name>yarn.resourcemanager.hostname.rm2</name> <value>hop02</value> </property> <!--Zookeeper集群的地址--> <property> <name>yarn.resourcemanager.zk-address</name> <value>hop01:2181,hop02:2181,hop03:2181</value> </property> <!--启用自动恢复机制--> <property> <name>yarn.resourcemanager.recovery.enabled</name> <value>true</value> </property> <!--指定状态存储Zookeeper集群--> <property> <name>yarn.resourcemanager.store.class</name> <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value> </property> </configuration> 重启journalnode节点 sbin/hadoop-daemon.sh start journalnode 在NN1服务格式化并启动 [root@hop01 hadoop2.7]# bin/hdfs namenode -format [root@hop01 hadoop2.7]# sbin/hadoop-daemon.sh start namenode NN2上同步NN1元数据 [root@hop02 hadoop2.7]# bin/hdfs namenode -bootstrapStandby 启动集群下DataNode [root@hop01 hadoop2.7]# sbin/hadoop-daemons.sh start datanode NN1设置为Active状态 先启动hop01即可,然后启动hop02。 [root@hop01 hadoop2.7]# sbin/hadoop-daemon.sh start zkfc hop01启动yarn [root@hop01 hadoop2.7]# sbin/start-yarn.sh hop02启动ResourceManager [root@hop02 hadoop2.7]# sbin/yarn-daemon.sh start resourcemanager 查看状态 [root@hop01 hadoop2.7]# bin/yarn rmadmin -getServiceState rm1 四、源代码地址 GitHub·地址 https://github.com/cicadasmile/big-data-parent GitEE·地址 https://gitee.com/cicadasmile/big-data-parent

优秀的个人博客,低调大师

spring框架入门之事务控制

1. 关于事务控制 事务是一系列的动作,它们综合在一起才是一个完整的工作单元,这些动作必须全部完成,如果有一个失败的话,那么事务就会回滚到最开始的状态,仿佛什么都没发生过一样。 1.1 spring中事务控制API PlatformTransactionManager 接口提供事务操作的方法,包含三个具体的操作 public interface PlatformTransactionManager extends TransactionManager { // 获取事务状态信息 TransactionStatus getTransaction(@Nullable TransactionDefinition var1) throws TransactionException; // 提交事务 void commit(TransactionStatus var1) throws TransactionException; // 回滚事务 void rollback(TransactionStatus var1) throws TransactionException; } 开发中常用的实现类: org.springframework.jdbc.datasource.DataSourceTransactionManager :使用Spring JDBC或iBatis进行持久化数据时使用 spring中事务控制接口的结构 1.1.2 TransactionDefinition 事务的定义信息对象,包含如下方法: 获取事务对象名称:String getName() 获取事务隔离级别:int getIsolationLevel() 获取事务传播行为:int getPropagationBehavior() 获取事务超时时间:int getTimeout() 获取事务是否只读:boolean isReadOnly() 1.1.3 TransactionStatus 描述了某个时间点上事务对象的状态信息,包含6个具体的操作: 刷新事务:void flush() 获取是否存在储存点:boolean hasSavepoint() 获取事务是否完成:boolean isCompleted() 获取事务是否为新的事物:boolean isNewTransaction() 获取事务是否回滚:boolean isRollbackOnly() 设置事务回滚:void set RollbackOnly() 1.2 事务的隔离级别 事务的隔离界别反映事务提交并发访问时的处理态度 1.2.1 事务隔离的级别 ① ISOLATION_DEFAULT 默认级别,由 DBA 默认的设置来决定隔离级别,归属下列某一种 ② ISOLATION_READ_UNCOMMITTED 就是一个事务可以读取另一个未提交事务的数据。会出现脏读、不可重复读、幻读(隔离级别最低,但并发性高) ③ ISOLATION_READ_COMMITTED 就是一个事务要等另一个事务提交后才能读取数据,解决脏读问题。会出现不可重复读、幻读问题(锁定正在读取的行,适用于大多数系统,Oracle默认级别) ④ ISOLATION_REPEATABLE_READ 就是在开始读取数据(事务开启)时,不再允许修改操作,解决不可重复读问题。会出现幻读问题(锁定所读的所有行,MYSQL默认级别) ⑤ ISOLATION_SERALZABLE 是最高的事务隔离级别,在该级别下,事务串行化顺序执行,可以避免脏读、不可重复读与幻读。但是这种事务隔离级别效率低下,比较耗数据库性能,一般不使用。(锁整表) 事务隔离级别由上到下依次提升,隔离级别越高,越能保证数据的完整性和一致性。但对数据库性能的消耗依次增加,并发执行效率依次下降。 大多数的数据库默认隔离级别为 Read Commited,比如 SqlServer、Oracle 少数数据库默认隔离级别为:Repeatable Read 比如:MySQL InnoDB 1.2.2 数据库读取时会出现的三种问题 ① Dirty reads:读脏数据。 也就是说,比如事务A的未提交(还依然缓存)的数据被事务B读走,如果事务A失败回滚,会导致事务B所读取的的数据是错误的。 ② non-repeatable reads:数据不可重复读。 比如事务A中两处读取数据price的值。在第一读的时候,price是100,然后事务B就把price的值改成 200;事务A再读一次,结果就发现,price竟然就变成200了,造成事务A数据混乱。 ③ phantom reads:幻象读数据。 这个和non-repeatable reads相似,也是同一个事务中多次读不一致的问题。但是 non-repeatable reads 的不一致是因为他所要取的数据值被改变了(比如price)而 phantom reads 所要读的数据的不一致却是他的条件数据集发生变化了。 比如:执行 Select account.id where account.name="Bruce*",第一次读去了6个符合条件的id;第二次读取的时候,由于事务B把一个帐号的名字由"dd"改成"Bruce1",结果取出来了7个数据。 不可重复读的重点是修改:同样的条件,两次读发现值不一样; 幻读的重点在于新增或者删除:同样的条件,两次读发现得到的记录数不一样 1.2.3 数据隔离级别和出现的问题之间的关联 Dirty reads non-repeatable reads phantom reads READ_UNCOMMITTED Y Y Y READ_COMMITTED N Y Y REPEATABLE_READ N N Y SERALZABLE N N N 1.3 事务的传播行为 REQUIRED:如果当前没有事务,就新建一个事务,如果已经存在一个事务中,加入到这个事务中。一般的选 择(默认值) SUPPORTS:支持当前事务,如果当前没有事务,就以非事务方式执行(没有事务) MANDATORY:使用当前的事务,如果当前没有事务,就抛出异常。 REQUERS_NEW:新建事务,如果当前在事务中,把当前事务挂起。 NOT_SUPPORTED:以非事务方式执行操作,如果当前存在事务,就把当前事务挂起。 NEVER:以非事务方式运行,如果当前存在事务,抛出异常。 NESTED:如果当前存在事务,则在嵌套事务内执行。如果当前没有事务,则执行REQUIRED类似的操作。 1.4 超时时间 指事务提交后最长可以等待的时间,超出时间则会自动失败。默认值是-1,没有时间限制。如果有,则以秒为单位进行设置。 1.5 是否为只读事务 读写型事务:增加、删除、修改时开启事务 只读型事务:执行查询时,也会开启事务 2. 基于xml的事务控制配置 2.1 配置步骤 配置事务管理器 配置事务的通知 此时我们需要导入事务的约束 tx名称空间和约束,同时也需要aop的使用 <tx:advice> 标签配置事务通知 id:给事务通知起一个唯一标识 transaction-manager:给事务通知提供一个事务管理器引用 配置AOP中的通用切入点表达式 建立事务通知和切入点表达式的对应关系 配置事务的属性是在事务的通知 <tx:advice> 标签的内部 2.2 配置事务的属性 isolation:用于指定事务的隔离级别。默认值是 DEFAULT,表示使用数据库的默认隔离级别。 propagation:用于指定事务的传播行为。默认值是 REQUIRED,表示一定会有事务,增删改的选择。查询方法可以选择 SUPPORTS。 read-only:用于指定事务是否只读。只有查询方法才能设置为 true。默认值是false,表示读写。 timeout:用于指定事务的超时时间,默认值是-1,表示永不超时。如果指定了数值,以秒为单位。 rollback-for:用于指定一个异常,当产生该异常时,事务回滚,产生其他异常时,事务不回滚。没有默认值。表示任何异常都回滚。 no-rollback-for:用于指定一个异常,当产生该异常时,事务不回滚,产生其他异常时事务回滚。没有默认值。表示任何异常都回滚。 代码示例: <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:tx="http://www.springframework.org/schema/tx" xmlns:aop="http://www.springframework.org/schema/aop" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/tx http://www.springframework.org/schema/tx/spring-tx.xsd http://www.springframework.org/schema/aop https://www.springframework.org/schema/aop/spring-aop.xsd"> <!-- 配置数据源 --> <bean id="dataSource" class="org.springframework.jdbc.datasource.DriverManagerDataSource"> <property name="driverClassName" value="com.mysql.jdbc.Driver"></property> <property name="url" value="jdbc:mysql://localhost:3306/base_crud"></property> <property name="username" value="root"></property> <property name="password" value="123456"></property> </bean> <!-- 1.配置事务管理器 --> <bean id="transactionManager" class="org.springframework.jdbc.datasource.DataSourceTransactionManager"> <property name="dataSource" ref="dataSource"></property> </bean> <!-- 2.配置事务通知 --> <tx:advice id="txAdvice" transaction-manager="transactionManager"> <tx:attributes> <tx:method name="*" propagation="REQUIRED" read-only="false"></tx:method> <tx:method name="get*" propagation="SUPPORTS" read-only="true"></tx:method> </tx:attributes> </tx:advice> <!-- 3.配置AOP --> <aop:config> <aop:pointcut id="pointcut" expression="execution(* cn.bruce.service.impl.*.*(..))"/> <!-- 4.建立事务通知和切入点表达式的对应关系 --> <aop:advisor advice-ref="txAdvice" pointcut-ref="pointcut"></aop:advisor> </aop:config> <!-- 配置dao --> <bean id="accountDao" class="cn.bruce.dao.impl.AccountDaoImpl"> <property name="dataSource" ref="dataSource"></property> </bean> <!-- 配置service --> <bean id="accountService" class="cn.bruce.service.impl.AccountServiceImpl"> <property name="accountDao" ref="accountDao"></property> </bean> </beans> 3. 基于注解的事务控制配置 3.1 配置步骤 ① 书写配置类 ② 将对象注入到IoC容器中管理 ③ 给业务添加事务注释,并指明事务属性 代码示例: ① 配置spring @Configuration// 声明为配置类 @ComponentScan("cn.bruce")// 声明需要扫描的包 @Import({JdbcConfig.class, TransactionConfig.class})// 导入其他配置类 @PropertySource("jdbcConfig.properties")// 导入配置文件 @EnableAspectJAutoProxy(proxyTargetClass = true)// 开启注解支持 @EnableTransactionManagement// 开启事务控制 public class SpringConfiguration { } ② 配置jdbc public class JdbcConfig { @Value("${jdbc.driver}") private String driver; @Value("${jdbc.url}") private String url; @Value("${jdbc.username}") private String username; @Value("${jdbc.password}") private String password; /** * 创建数据源对象 * @return */ @Bean("dataSource") public DataSource creatDataSource() { DriverManagerDataSource dataSource = new DriverManagerDataSource(); dataSource.setDriverClassName(driver); dataSource.setUrl(url); dataSource.setUsername(username); dataSource.setPassword(password); return dataSource; } /** * 创建JdbcTemplate * @param dataSource * @return */ @Bean(name = "jdbcTemplate") public JdbcTemplate creatJdbcTemplate(DataSource dataSource) { return new JdbcTemplate(dataSource); } } ③ 配置事务控制器 public class TransactionConfig { /** * 用于创建事务管理器对象 * @param dataSource * @return */ @Bean(name = "transactionManager") public PlatformTransactionManager creatTransactionManager(DataSource dataSource) { return new DataSourceTransactionManager(dataSource); } } ④ 通过 @Repository 和 @service 注解将Dao和Service层对象注入IoC容器 ⑤ 在业务层使用 @Transactional 注解进行事务配置 // 进行读写型事务配置 @Transactional(propagation = Propagation.REQUIRED, readOnly = false) @Override public void transfer(String sourceName, String targetName, Float money) { System.out.println("开始进行转账操作。。。"); Account source = accountDao.getAccountByName(sourceName); Account target = accountDao.getAccountByName(targetName); source.setMoney(source.getMoney() - money); target.setMoney(target.getMoney() + money); accountDao.updateAccount(source); int i = 1/0; accountDao.updateAccount(target); System.out.println("转账完成。。。"); } ⑥ 书写测试类进行测试 3.2 涉及到的注解 @Transactional 此注解相当于xml配置中的 <tx:attributes>****</tx:attributes> 用于进行事务的配置,其属性含义和xml中是一致的 此注解可是使用在接口、类和方法上: 出现在接口上,表示此接口所有的实现类都有事务支持 出现在类上,表示类所有的方法都有事务支持 出现在方法上,表示此方法有事务支持 以上三个位置的优先级:方法 > 类 > 接口

优秀的个人博客,低调大师

CakePHP 4.1.0 发布,PHP 快速开发框架

CakePHP 4.1.0 发布了,这是 4.1 系列的第一个稳定版本。 更新内容: ORM 中的公用表表达式(CTE) 支持 ORM 中的窗口功能 Query::orderAsc()和 Query::orderDesc()现在接受 Closure 作为其字段 debug()和Debugger::printVar()现在在 Web 上下文中发出 HTML,并在 CLI 上下文中发出 ANSI 样式的输出。循环结构和重复对象的输出要简单得多。循环对象仅转储一次,并使用引用 ID 指向完整值 CsrfProtectionMiddleware 现在可以创建具有相同 site 属性集的 cookie 日志消息现在可以包含 {foo} 样式的占位符。如果可用,这些占位符将替换为 $context 参数中的值 更新说明:https://bakery.cakephp.org/2020/07/04/cakephp_410_released.html

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册