首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

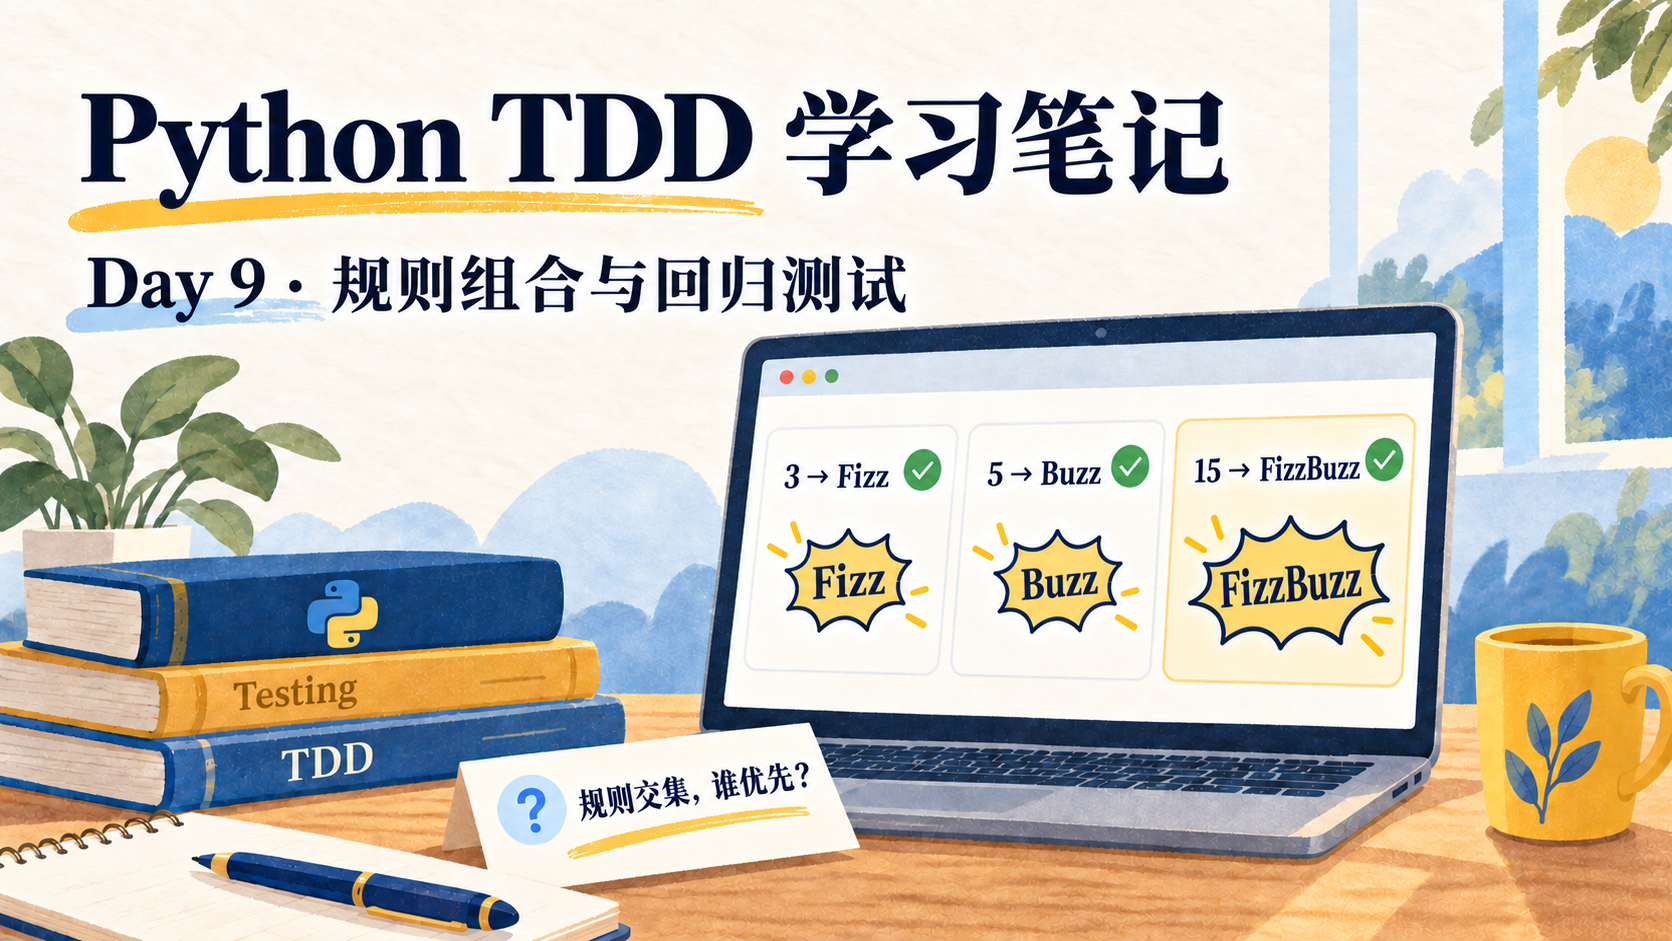
Python TDD 学习笔记 Day 09:规则组合与回归测试

昨天实现了普通数字转换与 Fizz,今天继续加入 Buzz 和 FizzBuzz。重点是一个常见问题:分别检查过两条规则,为什么还要检查它们同时成立的情况? ## 两条规则都通过,组合仍可能出错 加入“5 的倍数返回 Buzz”后,代码可以这样写: ```python if number % 3 == 0: return "Fizz" if number % 5 == 0: return "Buzz" ``` 输入 3 返回 Fizz,输入 5 返回 Buzz,看起来都正确。但输入 15 时,它先满足第一个条件,返回 Fizz 后调用立即结束,不会继续检查 5 的倍数。 完整需求却规定,3 与 5 的公倍数应该返回 FizzBuzz。问题出在规则交集:输入 15 同时满足两条条件,程序必须知道该采用什么结果。 ## 用测试把交集写清楚 今天先保留昨天六个案例,再加入 5、10、20。新案例在旧实现下失败,增加 Buzz 分支后,九个测试通过。 然后补上组合规则: ```python @pytest.mark.parametrize("number", [15, 30, 45]) def test_common_multiple_returns_fizzbuzz(number): assert fizzbuzz(number) == "FizzBuzz" ``` 这三个案例实际返回 Fizz,测试失败。它们揭示了前九个案例没有覆盖的问题:单独条件都符合预期,不代表交集也正确。 最终实现把组合情况放在前面: ```python def fizzbuzz(number): if number % 3 == 0 and number % 5 == 0: return "FizzBuzz" if number % 3 == 0: return "Fizz" if number % 5 == 0: return "Buzz" return str(number) ``` `and` 表示两边条件同时满足。先处理组合,再处理单独情况,最后才是普通转换。这符合本题约定,并不是所有程序都必须把条件最多的判断放在最前面。 ## 运费例子让我更容易理解 为了联系实际,课堂又用运费说明同一个问题。假设约定:普通订单满 100 元包邮,偏远地区无论金额多少都收 20 元。 如果先判断金额: ```python if total >= 100: return 0 if is_remote: return 20 ``` 偏远地区的 150 元订单就会错误地免运费。因为金额条件先命中,后面的地区条件没有机会执行。 按照这次约定,应先检查偏远地区: ```python def shipping_fee(total, is_remote): if is_remote: return 20 if total >= 100: return 0 return 10 ``` 最关键的案例就是: ```python assert shipping_fee(150, True) == 20 ``` 这是课堂说明规则优先级的简化片段,没有扩展修改 Day 07 的运费练习,也省略了原例中的输入校验。通过这个例子,我对“为什么要测试规则交集”理解得更清楚了。 ## 项目中先确认优先级,再排列代码 优惠叠加、权限组合、运费例外,都可能出现相同的问题。先单独测试每条规则,再选择有意义的交集场景。 例如,满额包邮遇到偏远地区,究竟谁优先,是业务约定,不能让代码碰巧写出的顺序替我们决定。 | 类别 | 本节测试输入 | 预期 | | --- | --- | --- | | 普通数字 | 1、2、4 | 数字字符串 | | 仅为 3 的倍数 | 3、6、9 | Fizz | | 仅为 5 的倍数 | 5、10、20 | Buzz | | 同时为两者倍数 | 15、30、45 | FizzBuzz | 调整组合判断后,原有案例仍然保留并重新运行,确认普通转换、Fizz、Buzz 没有被破坏。这就是本节的回归检查。 ## 本次验证 Day 09 的扩展代码保存在 `lessons/day09/`,Day 08 保留当时的学习版本。在项目根目录运行: ```bash uv run pytest lessons/day09 -v uv run pytest -v ``` 本篇整理时,Day 09 的 12 个测试和全项目 57 个测试均已通过。FizzBuzz 练习到这里结束,下一节按精简计划学习字符串计算器。 ## 今日收获 运费例子让我更清楚地理解了为什么要测试规则交集。满额包邮与偏远地区收费,单独检查都可能正确,但同时满足时,还需要明确哪条规则优先。由于 `return` 会结束函数,判断顺序也必须符合这个约定。以后遇到多条规则,我会留意它们同时成立的场景。

优秀的个人博客,低调大师

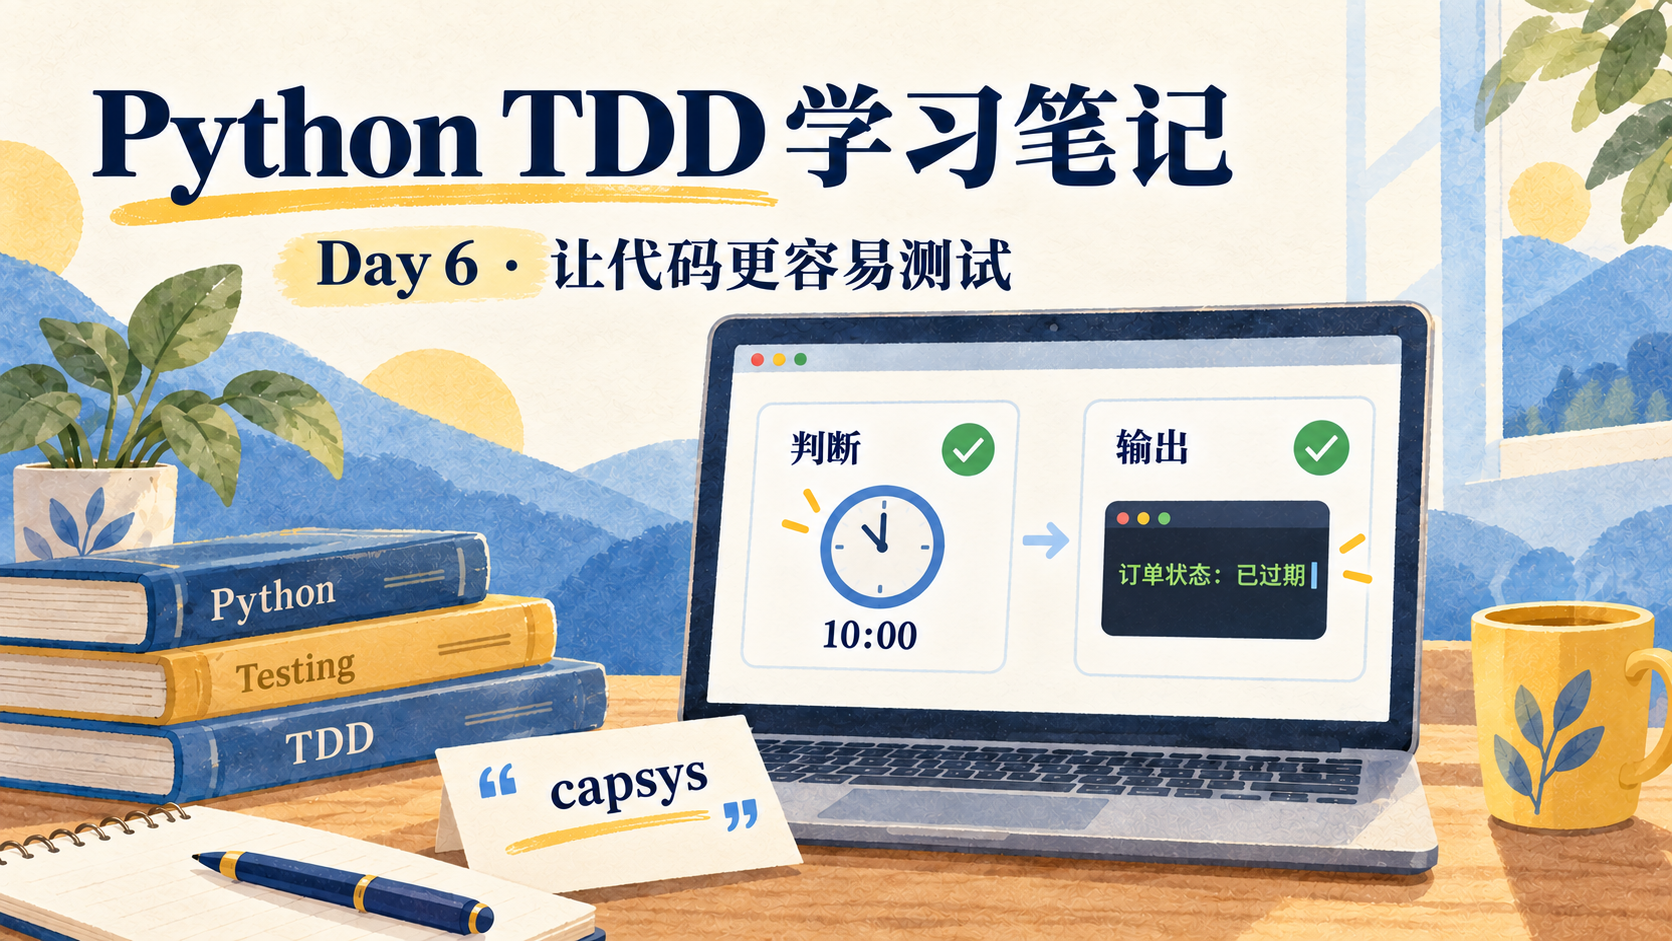
Python TDD 学习笔记 Day 06:让代码更容易测试

前几天主要学习怎样写测试。今天换个角度:代码怎样组织,才能让测试更简单、结果更稳定? 我们用“判断订单是否过期”练习,把获取时间、业务判断和打印结果分开。不过,学到最后,我的实际感受是:把打印的内容捕获下来,方便了文字对比,但对这么小的例子,拆开函数的好处并不明显。这也是今天需要说清楚的一点。 ## 先明确过期规则 本次约定:当前时间达到或超过截止时间,订单就算过期。 | 截止时间 | 当前时间 | 预期 | | --- | --- | --- | | 10:00 | 09:59 | 未过期 | | 10:00 | 10:00 | 已过期 | | 10:00 | 10:01 | 已过期 | 如果函数内部直接读系统时间,测试结果就会随运行时间改变。我们也不希望为了测试过期逻辑,真的等待一分钟,或修改电脑时间。 简单的办法是把“当前时间”作为输入: ```python def is_order_expired(expires_at, now): return now >= expires_at ``` 函数只根据传入的时间判断。`>=` 的结果本身就是布尔值,可以直接返回。 ## 用固定时间测试,不必等待 第一个测试检查超过截止时间的情况: ```python from datetime import datetime from order_expiry import is_order_expired def test_order_is_expired_after_deadline(): expires_at = datetime(2026, 10, 17, 10, 0) now = datetime(2026, 10, 17, 10, 1) assert is_order_expired(expires_at, now) is True ``` `datetime(年, 月, 日, 时, 分)` 创建一个具体时间。本节所有时间按同一时区理解,先不展开时区处理。 函数最初暂时返回 `False`,测试如预期失败;改成时间比较后通过。随后补上 09:59 和恰好 10:00 两个案例。 恰好到期的测试能防止以后有人把 `>=` 误改成 `>`;未到期的测试则防止“一直返回 True”这种实现蒙混过关。相同输入始终得到相同结果,测试不再依赖运行时的真实时间。 ## 实际程序从哪里取得时间 测试使用固定时间,实际运行依然使用真实时间,只是把获取动作放到调用处: ```python expires_at = datetime(2026, 10, 17, 10, 0) now = datetime.now() expired = is_order_expired(expires_at, now) ``` 业务规则保持一份,输入来源可以不同。这是今天最实用的经验:把会随环境变化的数据从外部传入,让判断函数只处理规则。 ## 返回结果与打印文字怎么分别测试 判断得到的是 `True` 或 `False`,向用户展示的则是“订单状态:已过期”等文字。练习中把显示写成一个函数: ```python def print_order_status(expired): status = "已过期" if expired else "未过期" print(f"订单状态:{status}") ``` `"已过期" if expired else "未过期"` 表示根据布尔值选择文字。实际程序先判断,再显示: ```python expired = is_order_expired(expires_at, now) print_order_status(expired) ``` 判断结果可以直接断言,但打印文字需要先捕获,才能自动对比。 ## capsys 接住打印内容 `capsys` 是 pytest 自带的 fixture,在测试参数中写上名字就能使用,不需要自己定义: ```python def test_print_expired_order_status(capsys): print_order_status(True) captured = capsys.readouterr() assert captured.out == "订单状态:已过期\n" ``` 执行显示函数后,`readouterr()` 读取捕获的内容;`captured.out` 是标准输出中的文字。末尾的 `\n` 来自 `print()` 默认添加的换行。 显示函数最初只有 `pass`,没有输出,测试因此失败。加入打印实现后通过,再补充传入 `False` 时应显示“未过期”的测试。 这解决了我提出的问题:“capsys 有什么作用,在什么地方用?”它常用于检查命令行程序的成功提示、状态文字或使用说明。若需求只关心计算结果,直接检查返回值即可,不必检查打印文字。 注意,`print()` 自身返回 `None`。不能用 `assert print("你好") == "你好"` 来检查它打印了什么。 ## 小程序一定要拆成多个函数吗 我在总结时说,感觉主要是方便文本对比,整体上没觉得有什么好处。 对当前例子,这个感受有道理:判断只有一行,打印也很简单,拆分反而增加了函数和文件。今天这样安排主要是为了分别演示返回值测试和输出测试,不能据此认为每句打印都必须抽成函数。 当同一条过期规则需要同时用于终端提示、网页显示和支付判断时,单独返回布尔值的函数更容易复用。修改显示文字时,也不必触动时间判断。简单脚本把打印保留在 `main()` 中同样合理。 实际项目中,先把业务规则与外部数据获取分清楚,再根据复用和维护需要决定拆分程度。 ## 本次验证 在项目根目录运行: ```bash uv run pytest lessons/day06 -v uv run python lessons/day06/demo.py ``` 第一条执行三个时间判断测试和两个输出测试;第二条读取本机真实时间并展示订单状态。演示脚本使用固定截止日期,状态随运行时间变化是正常的。 本篇整理时,Day 06 的 5 个测试和全项目 33 个测试均已通过。 ## 今日收获 今天我理解了,`capsys` 可以捕获程序打印的内容,方便与预期文字对比。对当前的小例子,拆分判断与打印的收益并不明显;当判断结果需要用于终端、网页或其他业务操作时,分开才更方便复用。把当前时间作为参数传入,也让测试可以直接检查固定场景。实际写代码时,应根据需要拆分,避免为了测试而把简单程序变复杂。

优秀的个人博客,低调大师

【阅读笔记】彩色转黑白Real-time Contrast Preserving Decolorization

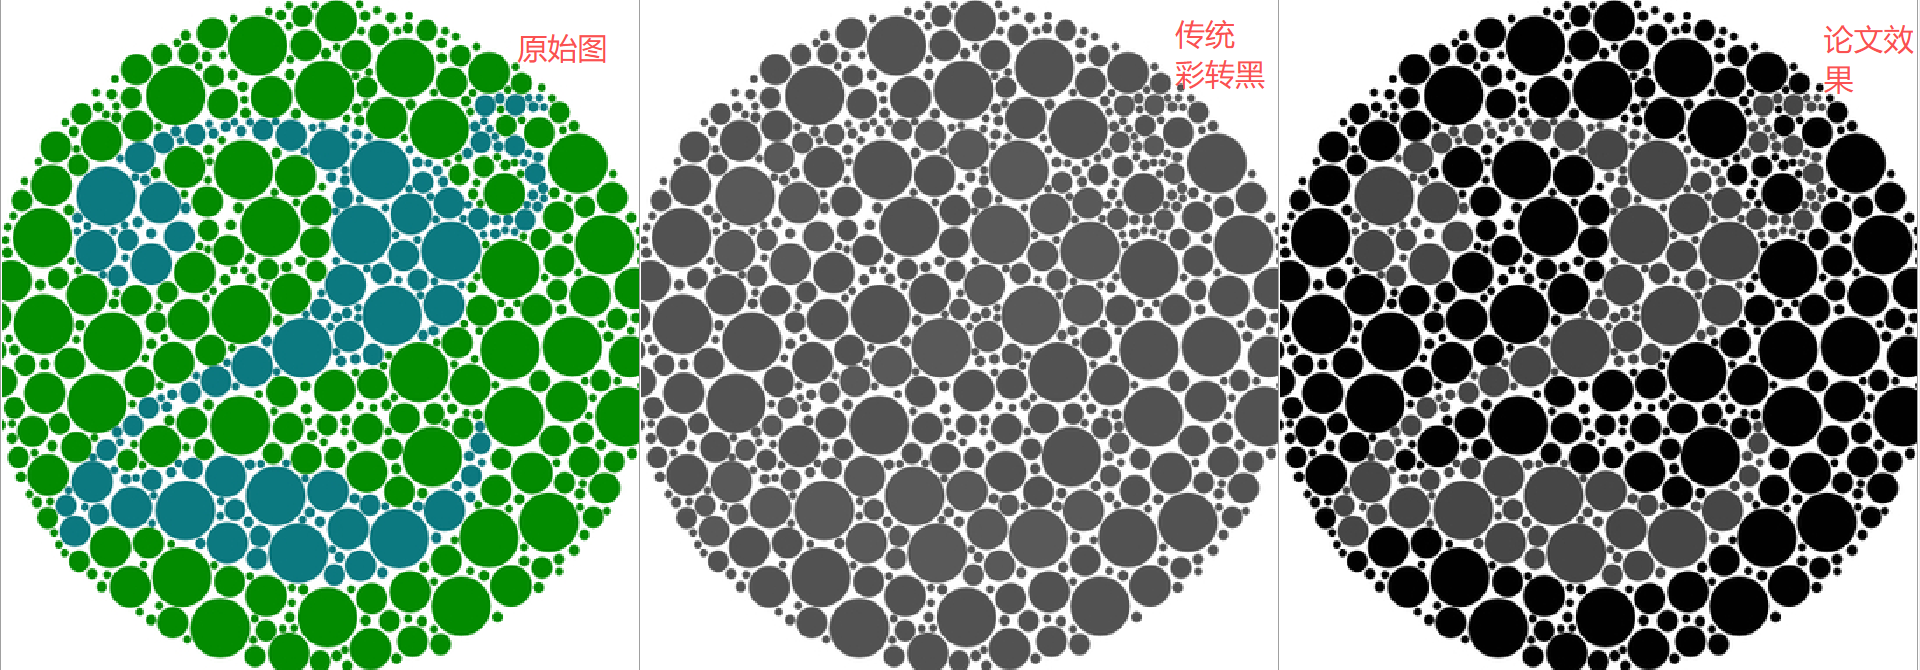
Real-time Contrast Preserving Decolorization ## 一、论文简述 传统固定权重灰度化方法在等亮度异色区域极易丢失视觉信息。Contrast Preserving Decolorization 算法通过最小化邻域像素灰度差值与原图色彩差异的误差,引入弱颜色序约束,在灰度映射过程中优先保留彩色图像固有的视觉对比度。 本文提出了一种非常快速而有效的脱色方法,可以最大限度地保持原有的色彩对比,将全局迭代优化简化为局部线性求解。同时兼顾视觉自然度,并且加速至实时运行。 ## 二、论文核心算法模型 设(g_x,g_y)为像素(x,y)灰度值;(\delta_{x,y}) 为像素之间**颜色差异度量**(基于CIELAB 空间的欧氏距离) 其中,\delta_{x,y}表示色彩对比度,公式如下 后续通过约束函数求取参数,公式不好写就不列举了,具体可以看文章。 ### 2.2 线性参数模型 因为提出的能量函数因涉及高斯混合模型而呈非凸性。尽管该优化问题在计算上可能较为耗时,作者对求值公式进行简化为线性模型,模型如下: 限制条件 $$ w_r \geq 0,w_g\geq 0,w_b\geq0\ w_r+w_g+w_b=1 $$ ### 2.3 参数搜索 迭代太慢了,直接用穷举法,再66组参数里循环选择出最适合的一组。3个权重系数均从0调到1,步进0.1 ### 2.4 下采样提速 为了减少运算,将处理图像下采样为64x64分辨率,然后计算参数 ## 三、评价指标CCPR **CCPR:Color Contrast Preserving Ratio 色彩对比度保留率** 为从对比度保留的角度对脱色算法进行定量评估,我们提出了一种新的评价指标。该指标基于以下发现:若颜色差异 \delta 小于阈值 \tau,则该差异在人眼视觉中几乎不可见 - \tau:人眼可感知对比度阈值; - CCPR 越接近 1,算法保留对比度能力越强。 其中,\Omega 包含所有相邻像素对及其原始色差\delta_{x,y}\geq \tau的集合,\lVert\Omega\rVert为\Omega中像素对的数量 论文结果如下: ![](https://developer.qcloudimg.com/http-save/yehe-4584394/87f8d8cde144283558ea31964e4f9045.png) ![](https://developer.qcloudimg.com/http-save/yehe-4584394/1482bef1068a853b14f219146d0ab3aa.png) ![](https://developer.qcloudimg.com/http-save/yehe-4584394/01b0eabaa71f14fcdb403e07069818a2.png) ---

优秀的个人博客,低调大师

ubuntu1804使用国内git源安装fastdfs的笔记

> fastdfs是中国人开发的分布式开源文件系统,C开发,用于存储图片、视频等文件非常高效,其他的不多说 ### 一、下载源码 [官方网站](https://github.com/happyfish100/fastdfs) 因为我是移动的网络,访问github几乎打不开,怎么办? 国内有个码云,经常会同步,于是试着搜了以下fastdfs,果然有哈 先访问:[https://gitee.com/fastdfs100](https://gitee.com/fastdfs100) 需要下载3个项目的文件 1. libfastcommon 依赖包文件 [https://gitee.com/fastdfs100/libfastcommon.git](https://gitee.com/fastdfs100/libfastcommon.git) 1. fastdfs 主源文件,[https://gitee.com/fastdfs100/fastdfs.git](https://gitee.com/fastdfs100/fastdfs.git) 1. fastdfs-nginx-module nginx的模块 [https://gitee.com/fastdfs100/fastdfs-nginx-module.git](https://gitee.com/fastdfs100/fastdfs-nginx-module.git) 速度很快哦 ### 二、编译安装 ### 三、配置启动 sudo service fdfs_storaged start

优秀的个人博客,低调大师

mac os 安装mongodb5.0.2数据库的笔记

下载地址:[https://www.mongodb.com/download-center/community?tck=docs_server](https://www.mongodb.com/download-center/community?tck=docs_server) 选择最新stable版本,系统选择mac 最新的是5.0.2 3、解压文件,移动合适的位置 tar -zxvf mongodb-linux-x86_64-mac-5.0.2.tgz mv mongodb-linux-x86_64-mac-5.0.2.tgz /usr/local/mongodb 4、写进环境变量 sudo vim ~.bash_profile ``` #末尾加上以下几行 export MONGODB_HOME=/usr/local/mongodb/ export PATH=$PATH:$MONGODB_HOME/bin 保存退出后,在输入 source . ``` 5、创建两个文件夹 sudo mkdir -p /data/mongo/{db,log} 修改权限 chown youruser /data/mongo 一个用来存数据,一个用来存日志 6、测试是否能运行 sudo mongod --dbpath /data/mongo/db --logpath /daga/mongo/log/27017.log --fork fork意思是以后台守护进程运行 7、用户创建和删除 在命令行使用mongo命令可以直接,登录本地数据 mongo # 创建一个系统用户,一个普通用户 use admin db.createUser( { user: "adminUser", pwd: "adminPass", roles: [ { role: "userAdminAnyDatabase", db: "admin" } ] } ) use foo db.createUser( { user: "simpleUser", pwd: "simplePass", roles: [ { role: "readWrite", db: "foo" }, { role: "read", db: "bar" } ] } ) 删除用户 db.dropUser() 修改密码 db.changeUserPassword("user", "newpassword") 现在有两种方式进行用户身份的验证 第一种 (类似 MySql) 客户端连接时,指定用户名,密码,db名称 mongo --port 27017 -u "adminUser" -p "adminPass" --authenticationDatabase "admin" 第二种 客户端连接后,再进行验证 mongo --port 27017 use admin db.auth("adminUser", "adminPass") // 输出 1 表示验证成功 如果是远程登录,建议用第二种,防止数据被人监听,泄露密码 8、强制关闭进程 ps aux | grep mongo 找到进程ID,然后强制删除 kill 9 -s pid 9、编写配置文件 ``` #日志文件位置 logpath=/data/mongo/log/27017.log # 以追加方式写入日志 logappend=true # 是否以守护进程方式运行 fork = true # 默认27017 port = 27027 # 数据库文件位置 dbpath=/data/mongo/db # 启用定期记录CPU利用率和 I/O 等待 cpu = true # 是否以安全认证方式运行,默认是不认证的非安全方式 #noauth = true auth = true # 详细记录输出 #verbose = true bind_ip = 0.0.0.0 # 最大链接数 maxConns = 100 # 防止插入脏数据 objcheck = true #pidfilepath:进程ID,没有指定则启动时候就没有PID文件 pidfilepath = /data/mongo/27017.pid 用vim把内容保存到/data/mongo/27027.conf 把端口信息带上,方便开启多少mongdb进程 ``` 10、用配置文件启动 sudo mongod --config /data/mongo/27017.conf 关闭进程 ps -ef | grep mongo kill -9 pid

优秀的个人博客,低调大师

新一代服务网关Gateway的实践笔记

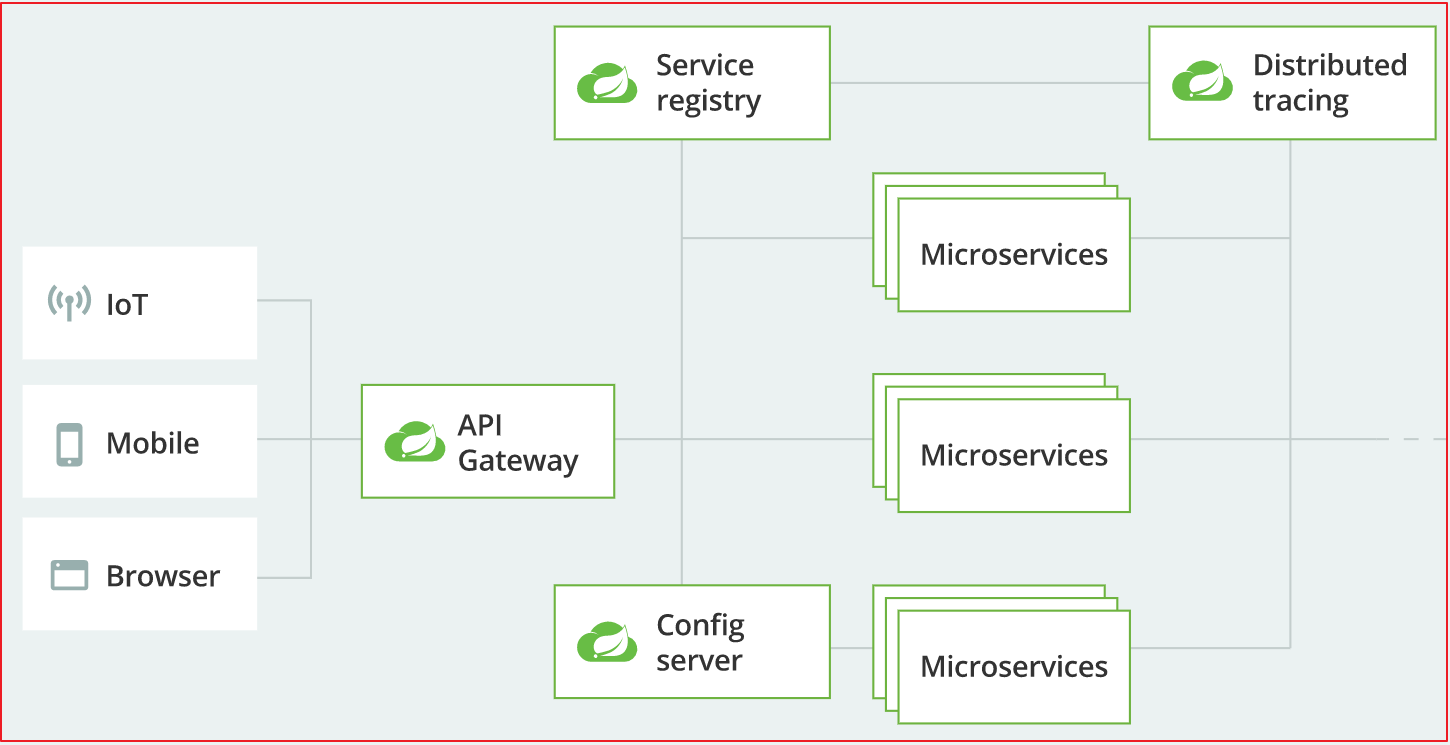
3、SpringCloud Gateway Spring Cloud Gateway 是Spring Cloud团队的一个全新项目,基于Spring 5.0、SpringBoot2.0、Project Reactor 等技术开发的网关。旨在为微服务架构提供一种简单有效统一的API路由管理方式。 Spring Cloud Gateway 作为SpringCloud生态系统中的网关,目标是替代Netflix Zuul。Gateway不仅提供统一路由方式,并且基于Filter链的方式提供网关的基本功能。例如:安全,监控/指标,和限流。 总结:微服务网关就是一个系统,通过暴露该微服务网关系统,方便我们进行相关的鉴权,安全控制,日志统一处理,易于监控,限流等相关功能。 实现微服务网关的技术有很多, nginx:Nginx (engine x) 是一个高性能的HTTP和反向代理web服务器,同时也提供了IMAP/POP3/SMTP服务 zuul :Zuul 是 Netflflix 出品的一个基于 JVM 路由和服务端的负载均衡器。 spring-cloud-gateway:是spring 出品的基于spring的网关项目,集成断路器,路径重写,性能比Zuul好。 我们使用gateway这个网关技术,无缝衔接到基于spring cloud的微服务开发中来。 gateway官网: https://spring.io/projects/spring-cloud-gateway 3.1 Gateway工作原理 我们在学习Gateway之前,先弄清楚Gateway的工作原理,后面使用它的各个功能时,就知道该如何使用了,工作流程图如下: Gateway的执行流程如下: 1:Gateway的客户端回向Spring Cloud Gateway发起请求,请求首先会被HttpWebHandlerAdapter进行提取组装成网关的上下文,然后网关的上下文会传递到DispatcherHandler。 2:DispatcherHandler是所有请求的分发处理器,DispatcherHandler主要负责分发请求对应的处理器,比如将请求分发到对应RoutePredicateHandlerMapping(路由断言处理器映射器)。 3:路由断言处理映射器主要用于路由的查找,以及找到路由后返回对应的FilteringWebHandler。 4:FilteringWebHandler主要负责组装Filter链表并调用Filter执行一系列Filter处理,然后把请求转到后端对应的代理服务处理,处理完毕后,将Response返回到Gateway客户端。 在Filter链中,通过虚线分割Filter的原因是,过滤器可以在转发请求之前处理或者接收到被代理服务的返回结果之后处理。所有的Pre类型的Filter执行完毕之后,才会转发请求到被代理的服务处理。被代理的服务把所有请求完毕之后,才会执行Post类型的过滤器。 3.2 Gateway路由 Gateway路由配置分为基于配置的静态路由设置和基于代码动态路由配置, 静态路由是指在application.yml中把路由信息配置好了,而动态路由则支持在代码中动态加载路由信息,更加灵活,我们接下来把这2种路由操作都实现一次。 3.2.1 业务说明 如上图: 1:用户所有请求以/order开始的请求,都路由到 hailtaxi-order服务 2:用户所有请求以/driver开始的请求,都路由到 hailtaxi-driver服务 3:用户所有请求以/pay开始的请求,都路由到 hailtaxi-pay服务 3.2.2 基于配置路由设置 如上图所示,正是Gateway静态路由配置: 1:用户所有请求以/order开始的请求,都路由到 hailtaxi-order服务 2:用户所有请求以/driver开始的请求,都路由到 hailtaxi-driver服务 3:用户所有请求以/pay开始的请求,都路由到 hailtaxi-pay服务 配置参数说明: routes:路由配置 - id:唯一标识符 uri:路由地址,可以是 lb://IP:端口 也可以是 lb://${spring.application.name} predicates:断言,是指路由条件 - Path=/driver/**:路由条件。Predicate 接受一个输入参数,返回一个布尔值结果。这里表示匹配所有以driver开始的请求。 filters:过滤器 - StripPrefix=1:真实路由的时候,去掉第1个路径,路径个数以/分割区分 测试url:http://localhost:8001/driver/info/1 3.2.3 基于代码路由配置 我们同样实现上面的功能,但这里基于代码方式实现。所有路由规则我们可以从数据库中读取并加载到程序中。基于代码的路由配置我们只需要创建RouteLocator并添加路由配置即可,代码如下: /*** * 路由配置 * @param builder * @return */ @Bean public RouteLocator routeLocator(RouteLocatorBuilder builder) { return builder.routes() .route("hailtaxi-driver", r -> r.path("/driver/**").uri("lb://hailtaxi-driver")) .route("hailtaxi-order", r -> r.path("/order/**").uri("lb://hailtaxi-order")) .route("hailtaxi-pay", r -> r.path("/pay/**").uri("lb://hailtaxi-pay")) .build(); } 在真实场景中,基于配置文件的方式更直观、简介,但代码的路由配置是更强大,可以实现很丰富的功能,可以把路由规则存在数据库中,每次直接从数据库中加载规则,这样的好处是可以动态刷新路由规则,通常应用于权限系统动态配置。 spring: cloud: gateway: #路由配置 routes: #唯一标识符 - id: hailtaxi-driver uri: lb://hailtaxi-driver #路由断言 predicates: - Path=/driver/** #唯一标识符 - id: hailtaxi-order uri: lb://hailtaxi-order #路由断言 predicates: - Path=/order/** #唯一标识符 - id: hailtaxi-pay uri: lb://hailtaxi-pay #路由断言 predicates: - Path=/pay/** 3.2.4 Gateway-Predicate 上面路由匹配规则中我们都用了- Path方式,其实就是路径匹配方式,除了路径匹配方式,Gateway还支持很多丰富的匹配方式,我们对这些方式分别进行讲解。 关于Predicate学习地址,可以参考官网: https://docs.spring.io/spring-cloud-gateway/docs/2.2.5.RELEASE/reference/html/#gateway-request-predicates-factories 或者: https://cloud.spring.io/spring-cloud-static/spring-cloud-gateway/2.1.1.RELEASE/single/spring-cloud-gateway.html#gateway-request-predicates-factories routes下面的属性含义如下: id:我们自定义的路由 ID,保持唯一 uri:目标服务地址 predicates:路由条件,Predicate 接受一个输入参数,返回一个布尔值结果。该属性包含多种默认方法来将 Predicate 组合成其他复杂的逻辑(比如:与,或,非) Predicate 来源于 Java 8,Predicate 接受一个输入参数,返回一个布尔值结果。该接口包含多种默认方法来将 Predicate 组合成其他复杂的逻辑(比如:与,或,非)。 在 Spring Cloud Gateway 中 Spring 利用 Predicate 的特性实现了各种路由匹配规则,通过 Header、请求参数等不同的条件来作为条件匹配到对应的路由。 下面的一张图(来自网络)总结了 Spring Cloud 内置的几种 Predicate 的实现: 我们在这里讲解几个断言匹配 方式。 Cookie: Gateway的Cookie匹配接收两个参数:一个是 Cookie name ,一个是正则表达式。路由规则就是通过获取对应的 Cookie name 值和正则表达式去匹配,如果匹配上就会执行路由,如果没有匹配上则不执行。如下配置: gateway: routes: - id: hailtaxi-driver uri: lb://hailtaxi-driver predicates: - Path=/driver/** - Cookie=username,itheima 这里表示请求携带了cookie为username的数据,并且值为itheima,就允许通过。 Header 匹配: Header 匹配 和 Cookie 匹配 一样,也是接收两个参数,一个 header 中属性名称和一个正则表达式,这个属性值和正则表达式匹配则执行。配置如下: gateway: routes: - id: hailtaxi-driver uri: lb://hailtaxi-driver predicates: - Path=/driver/** - Header=token,^(?!\d+$)[\da-zA-Z]+$ 上面的匹配规则,就是请求头要有token属性,并且值必须为数字和字母组合的正则表达式,例如携带token=19and30就可以通过访问。 请求方式匹配: 通过请求的方式是 POST、GET、PUT、DELETE 等进行路由。配置如下: gateway: routes: - id: hailtaxi-driver uri: lb://hailtaxi-driver predicates: - Path=/driver/** - Method=GET,POST 通过yml的完整代码如下(注释掉java的配置) server: port: 8001 spring: application: name: hailtaxi-gateway main: allow-bean-definition-overriding: true cloud: #Consul配置 consul: host: 127.0.0.1 port: 8500 discovery: #注册到Consul中的服务名字 service-name: ${spring.application.name} #注册的服务的实例 Id,最好不要重复,这里参考官网建议的方式 带随机数 默认:应用名:port #instance-id: ${spring.application.name}:${vcap.application.instance_id:${spring.application.i nstance_id:${random.value}}} # 自定义实例id为:应用名:ip:port instance-id: ${spring.application.name}:${spring.cloud.client.ip-address}:${server.port} prefer-ip-address: true # 开启服务注册 register: true # 开启服务发现 enabled: true #2 分钟之后健康检查未通过取消注册 health-check-critical-timeout: 2m #consul 健康检查的轮询周期 health-check-interval: 10s gateway: #路由配置 routes: #唯一标识符 - id: hailtaxi-driver uri: lb://hailtaxi-driver #路由断言 predicates: - Path=/driver/** - Cookie=username,itheima - Header=token,^(?!\d+$)[\da-zA-Z]+$ - Method=GET,POST #唯一标识符 - id: hailtaxi-order uri: lb://hailtaxi-order #路由断言 predicates: - Path=/order/** #唯一标识符 - id: hailtaxi-pay uri: lb://hailtaxi-pay #路由断言 predicates: - Path=/pay/** 3.2.5、断言源码剖析 拿Cookie断言来说,首先看它的体系结构 public class CookieRoutePredicateFactory extends AbstractRoutePredicateFactory<CookieRoutePredicateFactory.Config> { /** * Name key. */ public static final String NAME_KEY = "name"; /** * Regexp key. */ public static final String REGEXP_KEY = "regexp"; public CookieRoutePredicateFactory() { super(Config.class); } /* 通过shortcutFieldOrder方法设置Config配置类中的属性,需要根据具体的规则来设置 通过shortcutType方法获取具体规则,具体参看:org.springframework.cloud.gateway.support.ShortcutConfigurable.ShortcutType 规则包括以下几种: DEFAULT : 按照shortcutFieldOrder顺序依次赋值 */ @Override public List<String> shortcutFieldOrder() { return Arrays.asList(NAME_KEY, REGEXP_KEY); } @Override public Predicate<ServerWebExchange> apply(Config config) { return new GatewayPredicate() { @Override public boolean test(ServerWebExchange exchange) { List<HttpCookie> cookies = exchange.getRequest().getCookies() .get(config.name); if (cookies == null) { return false; } for (HttpCookie cookie : cookies) { if (cookie.getValue().matches(config.regexp)) { return true; } } return false; } @Override public String toString() { return String.format("Cookie: name=%s regexp=%s", config.name, config.regexp); } }; } /* 内部配置类是用来接收在配置文件中配置的参数的 routes: #唯一标识符 - id: hailtaxi-driver uri: lb://hailtaxi-driver #路由断言 predicates: - Cookie=username,itheima */ @Validated public static class Config { @NotEmpty private String name; @NotEmpty private String regexp; public String getName() { return name; } public Config setName(String name) { this.name = name; return this; } public String getRegexp() { return regexp; } public Config setRegexp(String regexp) { this.regexp = regexp; return this; } } } 尽管Spring Cloud Gateway已经包含了很多路由匹配规则,有时候我们需要开发自定义路由匹配规则来满足需求,下面简单的介绍一下如何自定义路由匹配规则。 案例 需求:转发带token的请求到hailtaxi-drvier服务中,这里定义请求带token是指包含某个请求头的请求,至于是什么请求头可以由配置指定 1、修改配置文件 gateway: #路由配置 routes: #唯一标识符 - id: hailtaxi-driver uri: lb://hailtaxi-driver #路由断言 predicates: # 自定义一个Token断言,如果请求包含Authorization的token信息则通过 - Token=Authorization 2、创建 RoutePredicateFactory 断言工厂默认命名规则必须按照"名称"+RoutePredicateFactory,如上TokenRoutePredicateFactory的断言名称为Token @Slf4j @Component // 要交给spring容器管理 public class TokenRoutePredicateFactory extends AbstractRoutePredicateFactory<TokenRoutePredicateFactory.Config> { public TokenRoutePredicateFactory() { super(Config.class); } public Predicate<ServerWebExchange> apply(Config config) { return exchange -> { // 打印配置文件参数值 String headerName = config.getHeaderName(); HttpHeaders headers = exchange.getRequest().getHeaders(); List<String> header = headers.get(headerName); log.info("Token Predicate headers:{}", header); // 断言返回的是boolean值 return header!=null && header.size()>0; }; } @Override public List<String> shortcutFieldOrder() { return Arrays.asList("headerName");//指定配置文件中加载到的配置信息应填充到Config的哪个属性上 } @Override public ShortcutType shortcutType() { return ShortcutType.DEFAULT; } @Data public static class Config { //static class private String headerName;//存储从配置文件中加载的配置 } } 启动测试:http://localhost:8001/driver/info/1 3.3 Gateway过滤器 Spring Cloud Gateway根据作用范围划分为GatewayFilter和GlobalFilter,二者区别如下: GatewayFilter : 需要通过spring.cloud.routes.filters 配置在具体路由下,只作用在当前路由上或通过spring.cloud.default-filters配置在全局,作用在所有路由上;gateway内置了多种过滤器工厂,配套的过滤器可以直接使用,如下图所示: GlobalFilter : 全局过滤器,不需要在配置文件中配置,作用在所有的路由上,最终通过GatewayFilterAdapter包装成GatewayFilterChain可识别的过滤器,它为请求业务以及路由的URI转换为真实业务服务的请求地址的核心过滤器,不需要配置,系统初始化时加载,并作用在每个路由上。 过滤器作为Gateway的重要功能。常用于请求鉴权、服务调用时长统计、修改请求或响应header、限流、去除路径等等。 关于Gateway过滤器的更多使用,大家可以参考官方地址: https://docs.spring.io/spring-cloud-gateway/docs/2.2.5.RELEASE/reference/html/#gatewayfilter-factories 或者: https://cloud.spring.io/spring-cloud-static/spring-cloud-gateway/2.1.1.RELEASE/single/spring-cloud-gateway.html#_gatewayfilter_factories 3.3.1 过滤器分类 默认过滤器:出厂自带,实现好了拿来就用,不需要实现 全局默认过滤器 局部默认过滤器 自定义过滤器:根据需求自己实现,实现后需配置,然后才能用哦。 全局过滤器:作用在所有路由上。 局部过滤器:配置在具体路由下,只作用在当前路由上。 默认过滤器十好几个,常见如下: 过滤器名称 说明 对应的类 父类 AddRequestHeader 对匹配上的请求加上Header AddRequestHeaderGatewayFilterFactory AbstractNameValueGatewayFilterFactory AddRequestParameters 对匹配上的请求路由 AddRequestHeaderGatewayFilterFactory AbstractNameValueGatewayFilterFactory AddResponseHeader 对从网关返回的响应添加Header AddResponseHeaderGatewayFilterFactory AbstractNameValueGatewayFilterFactory StripPrefix 对匹配上的请求路径去除前缀 StripPrefixGatewayFilterFactory AbstractGatewayFilterFactory 3.3.2 默认过滤器的使用 所谓默认过滤器就是系统自带的。有很多,这里简要说明几个:(通过java配置,注释掉yaml配置) 1)添加响应头 AddResponseHeaderGatewayFilterFactory 属于 GatewayFilter 对输出响应头设置属性,比如对输出的响应设置其头部属性名称为:X-Response-Default-MyName , 值为itheima 修改配置文件,配置如下: spring: cloud: gateway: # 配置全局默认过滤器 作用在所有路由上,也可单独为某个路由配置 default-filters: # 往响应过滤器中加入信息 - AddResponseHeader=X-Response-Default-MyName,itheima 请求http://localhost:8001/driver/info/1,响应数据添加了X-Response-Default-MyName: itheima,如下图: 2)前缀处理 在项目中做开发对接接口的时候,我们很多时候需要统一API路径,比如统一以/api开始的请求调用hailtaxi-driver服务,但真实服务接口地址又没有/api路径,我们可以使用Gateway的过滤器处理请求路径。 在gateway中可以通过配置路由的过滤器StripPrefix实现映射路径中的前缀处理,我们来使用一下该过滤器,再进一步做说明。 gateway: routes: - id: hailtaxi-driver uri: lb://hailtaxi-driver predicates: - Path=/api/driver/** filters: - StripPrefix=1 此处- StripPrefix=1表示真实请求地址是当前用户请求以/api开始的uri中去除第1个路径/api. 上面配置最终执行如下表: 配置 路由地址 访问地址 StripPrefix=1 http://localhost:8001/api/driver/info/2 http://localhost:18081/driver/info/2 StripPrefix=2 http://localhost:8001/api/suri/driver/info/2 http://localhost:18081/driver/info/2 有时候为了简化用户请求地址,比如用户请求http://localhost:8001/info/1我们想统一路由到http://localhost:18081/driver/info/1,可以使用PrefixPath过滤器增加前缀。 gateway: routes: - id: hailtaxi-driver uri: lb://hailtaxi-driver predicates: - Path=/** filters: - PrefixPath=/driver 上面配置最终执行如下表: 配置 路由地址 访问地址 - PrefixPath=/driver http://localhost:8001/info/2 http://localhost:18081/driver/info/2 3.3.3自定义GatewayFilter 1、实现GatewayFilter接口 GatewayFilter 一般作用在某一个路由上,需要实例化创建才能使用,局部过滤器需要实现接口GatewayFilter、Ordered。 创建com.itheima.filter.PayFilter代码如下: public class PayFilter implements GatewayFilter,Ordered { /*** * 过滤器执行拦截 * @param exchange * @param chain * @return */ @Override public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) { System.out.println("GatewayFilter拦截器执行---pre-----PayFilter"); return chain.filter(exchange).then(Mono.fromRunnable(()->{ System.out.println("GatewayFilter拦截器执行---post-----PayFilter"); })); } @Override public int getOrder() { return 0; } } 使用局部过滤器:(使用下面RouteLocator的时候,配置文件中的路由记得注释或删除) /*** * 路由配置 * @param builder * @return */ @Bean public RouteLocator routeLocator(RouteLocatorBuilder builder) { return builder.routes() .route("hailtaxi-driver", r -> r.path("/api/driver/**") .and().cookie("username","itheima") .and().header("token","123456") .filters(f->f.filter(new PayFilter()).addResponseHeader("X-Response-Default-MyName", "itheima") .addRequestHeader("myheader", "1234567") .stripPrefix(1) ) // .and().method(HttpMethod.POST) .uri("lb://hailtaxi-driver") //.filter(new PayFilter()) ) .route("hailtaxi-order", r -> r.path("/order/**").uri("lb://hailtaxi-order")) .route("hailtaxi-pay", r -> r.path("/pay/**").uri("lb://hailtaxi-pay")) .build(); } 为了更好看到效果,我们在RouterFilter添加System.out.println("GlobalFilter拦截器执行");再访问测试。 访问:http://localhost:8001/api/driver/info/1,注意使用postman发送请求时添加请求头,添加cookie。 2、继承GatewayFilterFactory 如果定义局部过滤器,想在配置文件中进行配置来使用,可以继承AbstractGatewayFilterFactory<T>抽象类或者AbstractNameValueGatewayFilterFactory 整个体系结构为: 这两个抽象类的区别就是前者接收一个参数(像StripPrefix和我们创建的这种),后者接收两个参数(像AddResponseHeader) 代码的编写可以参考:StripPrefixGatewayFilterFactory 和 AddRequestHeaderGatewayFilterFactory 过滤器工厂默认命名规则必须按照"名称"+GatewayFilterFactory`,如上StripPrefixGatewayFilterFactory的过滤器名称为StripPrefix 2.1、继承AbstractGatewayFilterFactory 需求: 在网关中统一支付方式,编写一个过滤器:PayMethodGatewayFilterFactory, 1、编写过滤器 @Slf4j @Component //一定要将其交给spring容器管理 public class PayMethodGatewayFilterFactory extends AbstractGatewayFilterFactory<PayMethodGatewayFilterFactory.Config> { public PayMethodGatewayFilterFactory() { super(Config.class); } @Override public GatewayFilter apply(Config config) { return (exchange, chain) -> { String paymethod = config.getPayMethod(); String msg = config.getMsg(); log.info("PayMethodGatewayFilterFactory 加载到的配置信息为:{}---{}",paymethod,msg); //将paymethod添加到请求头中 exchange.getRequest().mutate().header("paymethod",paymethod); return chain.filter(exchange); }; } @Override public List<String> shortcutFieldOrder() { return Arrays.asList("payMethod","msg");//指定从yml中提前出来的配置信息填充到配置类中哪个属性,按规则配置 } @Override public ShortcutType shortcutType() { return ShortcutType.DEFAULT;//默认规则 } /** * 加载从yml中提取出来的配置信息 */ @Data public static class Config { private String payMethod; private String msg; } } 2、配置文件中使用如下: gateway: #路由配置 routes: #唯一标识符 - id: hailtaxi-driver uri: lb://hailtaxi-driver #路由断言 predicates: - Path=/driver/** - Cookie=username,itheima - Header=token,^(?!\d+$)[\da-zA-Z]+$ - Method=GET,POST - Token=Authorization filters: - PayMethod=alipay,业务整合 再次测试,查看hailtaxi-driver 服务接收到请求后是否多了paymethod请求头信息 2.2、继承AbstractNameValueGatewayFilterFactory 直接查看AddRequestHeaderGatewayFilterFactory 源码,分析即可! 3.3.4 自定义GlobalFilter 定义全局过滤器需要实现GlobalFilter,Ordered接口: GlobalFilter:过滤器拦截处理方法 Ordered:过滤器也有多个,这里主要定义过滤器执行顺序,里面有个方法getOrder()会返回过滤器执行顺序,返回值越小,越靠前执行 需求: 我们创建全局过滤器并完成常见业务用户权限校验,如果请求中有带有一个名字为token的请求参数,则认为请求有效放行,如果没有则拦截提示授权无效。 创建全局过滤器:com.itheima.filter.RouterFilter,代码如下: @Component public class RouterFilter implements GlobalFilter,Ordered { /*** * 路由拦截 * @param exchange * @param chain * @return */ @Override public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) { log.info("RouterFilter----------------"); //获取请求参数 String token = exchange.getRequest().getQueryParams().getFirst("token"); //如果token为空,则表示没有登录 if(StringUtils.isEmpty(token)){ //没登录,状态设置403 exchange.getResponse().setStatusCode(HttpStatus.PAYLOAD_TOO_LARGE); //结束请求 return exchange.getResponse().setComplete(); } //放行 return chain.filter(exchange); } /*** * 拦截器顺序 * @return */ @Override public int getOrder() { return 0; } } 此时请求,我们不携带token参数,效果如下: 我们携带token参数则可以正常访问,效果如下: 3.4 跨域配置 出于浏览器的同源策略限制。同源策略(Sameoriginpolicy)是一种约定,它是浏览器最核心也最基本的安全功能,如果缺少了同源策略,则浏览器的正常功能可能都会受到影响。可以说Web是构建在同源策略基础之上的,浏览器只是针对同源策略的一种实现。同源策略会阻止一个域的javascript脚本和另外一个域的内容进行交互。所谓同源(即指在同一个域)就是两个页面具有相同的协议(protocol),主机(host)和端口号(port)。 在Spring Cloud Gateway中配置跨域是非常简单的,如下面application.yml所示: gateway: globalcors: corsConfigurations: '[/**]': allowedOrigins: "*" allowedMethods: - GET - POST - PUT 但如果涉及到Cookie跨域,上面的配置就不生效了,如果涉及到Cookie跨域,需要创建CorsWebFilter过滤器,代码如下: /** * 配置跨域 * @return */ @Bean public CorsWebFilter corsFilter() { CorsConfiguration config = new CorsConfiguration(); // cookie跨域 config.setAllowCredentials(Boolean.TRUE); config.addAllowedMethod("*"); config.addAllowedOrigin("*"); config.addAllowedHeader("*"); // 配置前端js允许访问的自定义响应头 config.addExposedHeader("Authorization"); UrlBasedCorsConfigurationSource source = new UrlBasedCorsConfigurationSource(new PathPatternParser()); source.registerCorsConfiguration("/**", config); return new CorsWebFilter(source); } 3.5 限流 网关可以做很多的事情,比如,限流,当我们的系统 被频繁的请求的时候,就有可能 将系统压垮,所以 为了解决这个问题,需要在每一个微服务中做限流操作,但是如果有了网关,那么就可以在网关系统做限流,因为所有的请求都需要先通过网关系统才能路由到微服务中。 3.5.1 漏桶算法讲解 漏桶算法是常见的限流算法之一,我们讲解一下漏桶算法: 1)所有的请求在处理之前都需要拿到一个可用的令牌才会被处理; 2)根据限流大小,设置按照一定的速率往桶里添加令牌; 3)桶设置最大的放置令牌限制,当桶满时、新添加的令牌就被丢弃或者拒绝; 4)请求达到后首先要获取令牌桶中的令牌,拿着令牌才可以进行其他的业务逻辑,处理完业务逻辑之后,将令牌直接删除; 5)令牌桶有最低限额,当桶中的令牌达到最低限额的时候,请求处理完之后将不会删除令牌,以此保证足够的限流 漏桶算法的实现,有很多技术,Guaua是其中之一,redis客户端也有其实现。 3.5.2 限流案例 spring cloud gateway 默认使用redis的RateLimter限流算法来实现,外面来简要实现一下: 1、引入依赖 首先需要引入redis的依赖: <!--redis--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis-reactive</artifactId> <version>2.2.1.RELEASE</version> </dependency> 同时不要忘记Redis配置: redis: host: 127.0.0.1 port: 6379 2、定义KeyResolver 在Application引导类中添加如下代码,KeyResolver用于计算某一个类型的限流的KEY也就是说,可以通过KeyResolver来指定限流的Key。 我们可以根据IP来限流,比如每个IP每秒钟只能请求一次,在GatewayApplication定义key的获取,获取客户端IP,将IP作为key,如下代码: /*** * IP限流 * @return */ @Bean(name="ipKeyResolver") public KeyResolver userKeyResolver() { return new KeyResolver() { @Override public Mono<String> resolve(ServerWebExchange exchange) { //获取远程客户端IP String hostName = exchange.getRequest().getRemoteAddress().getAddress().getHostAddress(); System.out.println("hostName:"+hostName); return Mono.just(hostName); } }; } 在路由中配置如下: gateway: #路由配置 routes: #唯一标识符 - id: hailtaxi-driver uri: lb://hailtaxi-driver #路由断言 predicates: - Path=/driver/** - Cookie=username,itheima - Header=token,^(?!\d+$)[\da-zA-Z]+$ - Method=GET,POST - Token=Authorization filters: - PayMethod=alipay,业务整合 - name: RequestRateLimiter #请求数限流 名字不能随便写 ,使用默认的facatory args: key-resolver: "#{@ipKeyResolver}" redis-rate-limiter.replenishRate: 1 redis-rate-limiter.burstCapacity: 1 参数说明: redis-rate-limiter.replenishRate是您希望允许用户每秒执行多少请求,而不会丢弃任何请求。这是令牌桶填充的速率 redis-rate-limiter.burstCapacity是指令牌桶的容量,允许在一秒钟内完成的最大请求数,将此值设置为零将阻止所有请求。 key-resolver: “#{@ipKeyResolver}” 用于通过SPEL表达式来指定使用哪一个KeyResolver. 如上配置: 表示 一秒内,允许 一个请求通过,令牌桶的填充速率也是一秒钟添加一个令牌。 最大突发状况 也只允许 一秒内有一次请求,可以根据业务来调整 。 我们请求http://localhost:8001/driver/info/1?token=aa执行测试,效果如下: 本文由传智教育博学谷 - 狂野架构师教研团队发布 转载请注明出处!

优秀的个人博客,低调大师

Angular 服务器端渲染的学习笔记(一)

2 --> 官网链接:https://angular.io/guide/universal Angular Universal, a technology that renders Angular applications on the server. Angular Universal 是一种将 Angular 应用渲染于服务器平台上的技术。 A normal Angular application executes in the browser, rendering pages in the DOM in response to user actions. 普通的 Angular 应用在浏览器里执行,响应用户动作,并以 DOM 的方式渲染页面。 Angular Universal executes on the server, generating static application pages that later get bootstrapped on the client. Angular Universal 执行在服务器端,生成静态的应用页面,该页面随后在客户端进行引导(bootstrap). This means that the application generally renders more quickly, giving users a chance to view the application layout before it becomes fully interactive. 服务器端渲染通常意味着应用程序的渲染速度更加快捷,允许用户在应用能够实现正常互动之前,就有机会一窥应用的布局。 google 有一篇专门讲 *** 技术的文章:https://developers.google.com/web/updates/2019/02/rendering-on-the-web You can easily prepare an app for server-side rendering using the Angular CLI. The CLI schematic @nguniversal/express-engine performs the required steps. 使用 Angular CLI,可以完成一个应用支持 *** 所需的准备工作,具体步骤通过 CLI Schematic 的 @nguniversal/express-engine 完成。 To create the server-side app module, app.server.module.ts, run the following CLI command. 为了创建面向服务器端渲染的 app module, 即 app.server.module.ts, 执行下列 CLI 指令: ng add @nguniversal/express-engine 该指令会创建下列的文件结构: To start rendering your app with Universal on your local system, use the following command. 本地使用 Universal 方式渲染应用的命令:npm run dev:*** 执行的是 package.json scripts 区块里定义的该命令: 如果遇到错误消息:An unhandled exception occurred: Cannot find module ‘@nguniversal/builders/package.json’Require stack: 先 npm install. 之后原始的错误消失。 A Node.js Express web server compiles HTML pages with Universal based on client requests. 一个 node.js express web 服务器,基于 Universal 编译 HTML 页面。 进行了很多编译动作: 整个 dist 文件夹和其子文件夹都是 npm run dev:*** 后自动生成的: 打开 http://localhost:4200/dashboard,看到了熟悉的 hero dashboard: Navigation via routerLinks works correctly because they use the native anchor () tags. 基于 routerLinks 的跳转可以正常工作,因为其使用原生的 a 标签。 使用 *** 的三大原因 Facilitate web crawlers through search engine optimization (SEO) 为了配合网络爬虫,实现搜索引擎优化。 Improve performance on mobile and low-powered devices 改善应用在移动端和低配设备上访问的性能。 Show the first page quickly with a first-contentful paint (FCP) 能够以 FCP 的方式,快速显示应用首页。 Google, Bing, Facebook, Twitter, and other social media sites rely on web crawlers to index your application content and make that content searchable on the web. 谷歌,Bing,Facebook 和其他社交媒体网站,都使用网络爬虫,为应用内容建立索引,以便让其内容能够在网络上被搜索到。 These web crawlers may be unable to navigate and index your highly interactive Angular application as a human user could do. 如果一个 Angular 应用具备高度的可交互性,那么网络爬虫可能很难像一个人类用户一样,采用导航的方式访问应用,并索引其内容。 Angular Universal can generate a static version of your app that is easily searchable, linkable, and navigable without JavaScript. Angular Universal 可以基于 Angular 应用,生成一个静态版本,易于被搜索,链接,以及不借助 JavaScript 进行导航。 Angular Universal Universal also makes a site preview available since each URL returns a fully rendered page. 同时也能让 site 预览成为可能,因为每个 url 返回的是完全渲染过后的页面。 Some devices don’t support JavaScript or execute JavaScript so poorly that the user experience is unacceptable. 有些设备不支持 JavaScript,或者支持程度很差,因此应用用户体验很难接受。 For these cases, you may require a server-rendered, no-JavaScript version of the app. 在这种情况下,我们需要一个服务器端渲染,不需要 JavaScript 也能运行的应用。 This version, however limited, may be the only practical alternative for people who otherwise couldn’t use the app at all. 这种版本的应用,虽然功能局限,但是总比完全不能用的版本好。 Show the first page quickly Displaying the first page quickly can be critical for user engagement. 为了确保用户体验,迅速显示应用首屏页面的能力至关重要。 Your app may have to launch faster to engage these users before they decide to do something else. With Angular Universal, you can generate landing pages for the app that look like the complete app. The pages are pure HTML, and can display even if JavaScript is disabled. 使用 Angular Universal,可以生成应用的初始页面,该页面和完整的应用相比外观上无区别,并且是纯粹的 HTML 代码,即使在 JavaScript 禁掉的浏览器上,也能正常显示。 The pages don’t handle browser events, but they do support navigation through the site using routerLink. 该页面不支持浏览器事件,但支持基于 routerLink 的 site 间导航。 In practice, you’ll serve a static version of the landing page to hold the user’s attention. 从操作层面说,我们可以提供应用初始页面的静态版本,以吸引用户的注意。

优秀的个人博客,低调大师

Rust学习笔记#1:一个猜谜游戏小项目

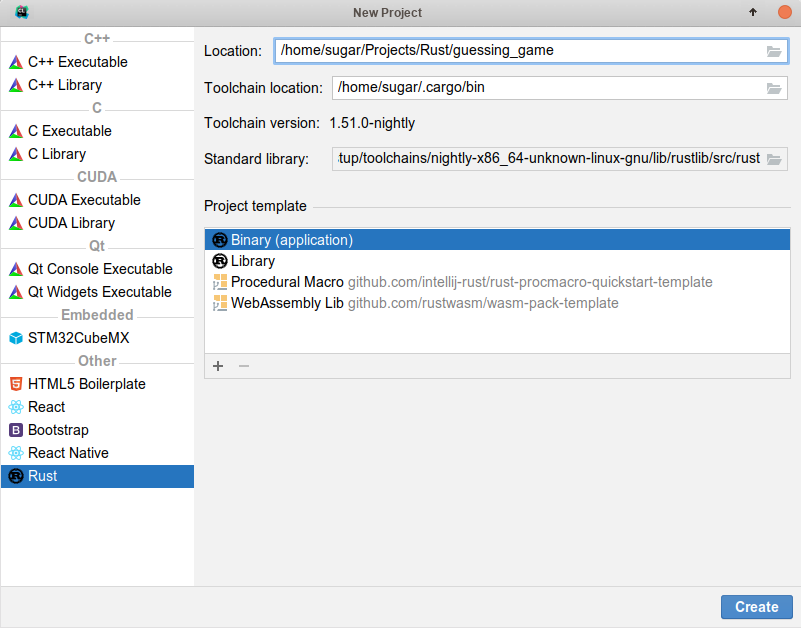
在深入探索Rust语法的细枝末节之前,先通过一个麻雀虽小但五脏俱全的小项目来整体把握Rust,这样可以避免迷失在细节的海洋中。我们可能会通过这个小项目一下子接触到很多新概念,但不必惊慌,我们只需浅尝辄止对这些概念有个印象即可。 《TRPL》(Rustaceans对《The Rust Programming Language》的爱称)中就给出了一个经典的猜谜游戏的例子,我们一起来学习它。 猜谜游戏:程序将会随机生成一个 1 到 100 之间的随机整数。接着它会请玩家猜一个数并输入,然后提示猜测是大了还是小了。如果猜对了,它会打印祝贺信息并退出。 Rust如何管理项目 并不是所有的代码都像hello_world.rs一样,一个文件就可以搞定。一个项目往往具有复杂的代码,我们需要一种机制来管理这种复杂性,将一个项目切分成若干小部分,每个部分再进行切分,层层抽象,直到达到人脑可以处理的规模。每种编程语言都有这样的机制,例如Java的package机制,Rust也不例外。 Rust用了两个概念来管理项目:一个是crate(项目),一个是mod(模块)。模块是用于在crate内部进行分层和封装的机制,模块内部可以包含模块。 crate:可以简单理解为一个项目,crate是Rust中的独立编译单元(compile unit),每个crate对应生成一个库或者可执行文件。作为对比,我们比较熟悉的C语言中,一个单独的.c文件和其所有的include文件组成一个编译单元,每个.c生成一个.o,然后将这些.o链接起来生成可执行文件。 mod:可以简单理解为命名空间。mod可以嵌套(注意crate之间不能出现循环引用),还可以控制内部元素的可见性。 说到可见性问题,在Rust中,元素默认都是私有的,用pub关键字修饰的才是公开的。公开和私有的访问权限规定如下: 如果一个元素是私有的,那么只有本模块内的元素以及它的子模块可以访问 如果一个元素是公开的,那么可以在本模块外的作用域访问它。 模块是一种抽象的概念,文件是承载这个概念的实体,但是模块和文件并不是简单的一一对应关系。在一个crate内部创建mod的方式有下面三种: 在一个rs文件中创建内嵌模块,直接使用mod关键字即可。 独立的一个rs文件就是一个模块,文件名即是模块名。 一个文件夹也可以创建一个模块,文件夹内部要有一个xxx.rs文件,这个文件是这个模块的入口。必须要在这个xxx.rs中声明其子模块,否则子模块无法被当成这个项目的源码进行编译。 新建项目 cargo不仅是Rust的包管理器,还可以用于创建项目。使用下列命令可以创建一个名为guessing_game的项目: cargo new guessing_game --bin 注意,后面的--bin意味着我们希望项目生成的是可执行程序,如果希望是library,则可以使用--lib选项。 以上为在命令行中手工创建项目,在Clion中可以点击File->New Project后如下图填写,然后点击Create按钮: 项目结构 我们可以使用tree .命令或者直接在Clion中查看当前的文件夹结构,如下图所示: src/main.rs:这是cargo自动生成的rs文件。还记得前面讲的crate和mod的概念吗?在这个项目中,guessing_game是crate,src文件夹是mod,main.rs是srcmod的入口。我们可以在srcmod中创建子模块,但注意,这些子模块都要在main.rs中声明,否则无法参与编译。 .gitignore:这是git忽略文件,不懂其作用的同学可以自行搜索。这里重点要说的是通过cargo new创建的项目天然就是一个git项目,这也印证了Rust对开源的拥护。 Cargo.toml:这是项目管理配置文件。TOML是一种非常简洁好用的配置文件格式,TOML是Tom's Obvious, Minimal Language的首字母缩写,这里的Tom是Github的联合创始人之一,感兴趣的同学可以进一步自行了解TOML配置文件的写法。 Cargo.lock:该文件包含项目依赖项的确切信息,由Cargo维护,我们无须关心它。 编译执行 在src/main.rs里cargo已经自动生成了输出Hello, world!的代码,我们来运行一下它看能否正常输出。 插一句题外话,在你日后漫长的Rust编码生涯中,你会发现,你将在处理编译错误上耗费大量的时间。还记得吗,Rust 的一大特色是保证内存安全,这保证了Rust代码只要运行起来就几乎不会发生内存错误,这么诱人的效果的背后的代价就是,我们要在编码时付出额外的努力。Rust为了保证内存安全设计了一套复杂的规则,这导致我们的代码一不留神就会编译不过。所以,在你日后经常用的一个操作就是检查能否编译通过,而不是直接编译,因为直接编译还要做代码优化等会相对费时。可以使用下列命令检查编译错误: cargo check 在Clion中需要新加一个Configuration来执行cargo check命令,如下图所示: 确保cargo check通过后,可以执行cargo build来执行编译。编译后会产生一个target文件夹,在target/debug下会有一个和crate同名的可执行文件。但一般为了方便,可以直接执行cargo run,这条命令等价于先编译后执行。下图是执行cargo run后Clion的控制台输出: 猜谜游戏 在完成了项目搭建后,接下来就要开始猜谜游戏的代码编写了,我将它们分成六部分:创建变量、输入、输出、错误处理、随机数生成、完整代码。 创建变量 使用let语句创建变量,需要注意的是,在Rust中,变量默认是不可变的,可以在变量名前使用mut来使得变量可变: let a = 5; // 不可变 let mut b = 10; // 可变 在上面的let语句中,我们并没有显示声明变量的类型,但这并不代表Rust是动态类型的,Rust仍然是静态类型的,只不过Rust有一个可以通过上下文推断类型的强大编译器。 输出 我们早已在hello_world.rs中见识过了最基本的输出方式: println!("Hello, world!"); 需要注意的是,这里的println!是一个宏,而非一个函数,println后面的感叹号就是宏的标志。Rust中的宏与C/C++中的宏是完全不一样的东西,简单说,可以把它理解为一种安全版的编译期语法扩展。这里之所以使用输出宏而非函数,是因为标准输出宏可以完成编译期格式检查,更加安全。 如果需要输出某个变量的值,可以使用占位符{},例如: let x = 0; let y = 10; println!("x = {} and y = {}", x, y); 其输出结果为: x = 0 and y = 10 输入 为了从控制台中获取用户的输入,需要使用标准库std::io。使用use语句将该库引入当前作用域: use std::io; 我们可以使用io库中的函数stdin: let mut guess = String::new(); // 创建一个字符串类型的可变变量 io::stdin().read_line(&mut guess).expect("Failed to read line"); stdin函数返回一个std::io::Stdin的实例,这代表终端标准输入句柄的类型。然后调用read_line方法,可以从标准输入中读取一行并存入到guess变量中去。&表示这是一个引用,这是一个复杂的特性,我们现在无须了解它。 读取用户输入后,我们需要判断用户是否正确输入了数字。String类型带有处理字符串处理的一些方法: let guess: u32 = guess.trim().parse().expect("Please type a number!"); 字符串的 parse 方法将字符串解析成数字。因为这个方法可以解析多种数字类型,因此需要告诉 Rust 具体的数字类型,这里通过 let guess: u32 指定。guess 后的冒号:告诉 Rust 我们指定了变量的类型。Rust 有一些内建的数字类型,u32 是一个无符号的 32 位整型。trim方法用于消除回车空格等符号。 错误处理 上一小节代码中还有一个expect没有分析,而这就涉及到Rust中的错误处理机制了。read_line的返回值类型是io::Result,它是Result类型在io模块的特化版本。Result是枚举类型,其成员为Ok和Err,Ok 成员表示操作成功,内部包含成功时产生的值。Err 成员则意味着操作失败,并且包含失败的前因后果。 Result类型的作用是编码错误处理信息。Result 类型像其他类型一样,拥有定义于其上的方法。io::Result的实例拥有expect方法。如果 io::Result 实例的值是 Err,expect 会导致程序崩溃,并打印参数传递给 expect 的信息。如果io::Result实例的值是 Ok,expect 会获取 Ok 中的值并返回。在本例中,这个值是用户输入到标准输入中的字节数。 随机数生成 猜谜游戏需要能够自动生成随机数。Rust标准库中尚未包含随机数功能,但我们可以通过引入外部crate来获得随机数功能。还记得Rust的官方开源仓库吗,那里可是有很多宝贝的。打开https://crates.io/,在搜索框中键入rand来搜索具有随机数功能的crate,出来的第一个结果就是我们需要的crate。 现在我们将这个库引入到我们的项目中。打开Cargo.toml,在[dependencies]下添加: [dependencies] rand = "0.8.3" [dependencies] 告诉 Cargo 本项目依赖了哪些外部 crate 及其版本。 下面使用rand库来产生随机数。首先,使用use语句引入rand,use rand::Rng;。然后调用下列函数产生一个1和100之间的数: let number = rand::thread_rng().gen_range(1..=100); 完整代码 猜谜游戏的完整代码如下。 use std::io; use std::cmp::Ordering; use rand::Rng; fn main() { println!("Guess the number!"); let secret_number = rand::thread_rng().gen_range(1..=100); loop { println!("Please input your guess."); let mut guess = String::new(); io::stdin().read_line(&mut guess) .expect("Failed to read line"); let guess: u32 = match guess.trim().parse() { Ok(num) => num, Err(_) => continue, }; println!("You guessed: {}", guess); match guess.cmp(&secret_number) { Ordering::Less => println!("Too small!"), Ordering::Greater => println!("Too big!"), Ordering::Equal => { println!("You win!"); break; } } } } 其中,涉及控制流操作的loop、match、continue、break等语法,大家应当能够望文生义。对于这个完整代码,大家能够阅读并知道每一行干了啥即可,不必纠结于语法细节。 猜谜游戏运行结果如下: 参考文献 《The Rust Programming Language》 《Rust编程之道》张汉东 《深入浅出Rust》范长春

优秀的个人博客,低调大师

JVM笔记九-GC收集器日志信息学习

在上一篇文章中,我们通过代码运行结果,查看到JVM的堆内存逻辑上分区是三部分,物理上分区是2部分,以及是新生代分区三部分,占比分布是8/1/1。而且我们还通过代码和堆JVM参数配置,制造出了OOM异常。下面我们就来分析GC回收器的日志信息。 先来看看,OOM后,GC详细日志信息: 编辑 编辑 新生区的伊甸园区GC日志分析 新生区的Eden区的GC,叫法:GC或者是YGC或者是MinorGC或者是轻GC 我们复制一条来分析: [GC (Allocation Failure①) [PSYoungGen: 1877K②->472K③(2048K④)] 3697⑤K->2835K⑥(7680K⑦), 0.0010223⑧ secs] [Times: user=0.00⑨ sys=0.00⑩, real=0.00 secs] 编辑 分段说明: :GC的类型; :YongGC前新生代的内存占用量 :YoungGC后新生代的内存占用量; :新生代总内存大小; :YoungGC前JVM堆内存占用量; :YoungGc后JVM堆内存使用量; :JVM堆内存总大小; :YoungGC耗时 :YoungGC用户耗时; :YoungGC系统耗时 :YoungGC实际耗时 年老代GC日志分析: 年老代GC的叫法:Full GC或者FGC或者MajorGC或者重GC 同样,我们拿出OOM之前的一条GC日志进行分析 [Full GC (Ergonomics①) [PSYoungGen②: 96K③->0K④ (2048K⑤)] [ParOldGen⑥: 5094K⑦->4007K⑧ (5632K⑨)] 5190K⑩->4007K十一 (7680K十二), [Metaspace十三: 3314K十四 ->3314K 十五(1056768K十六)], 0.0074234 secs十七] [Times: user=0.08十八 sys=0.01十九, real=0.01 secs二十]: 标志说明: :GC类型 :Young区 :GC前Young区内存占用 :GC后Young区内存占用 :Young区总大小 :Old区 :GC前Old区内存占用 :GC后Old区内存占用 :Old区总大小 :GC前堆内存占用 :GC后堆内存占用 :JVM堆内存总大小 :元空间区 :GC前占用内存 :GC后占用内存 :元空间总大小 :GC耗时 :用户耗时 :系统耗时 :实际耗时 如下图: 编辑 接下来,我们继续学习的是JVM垃圾回收的四种算法了。欢迎大家和凯哥(凯哥Java:kaigejava)继续一起学习:引用计数算法、复制算法、标记清除、标记压缩这四种算法。

优秀的个人博客,低调大师

dubbo-go源码笔记(一)Server端开启服务过程

导读 导读:随着微服务架构的流行,许多高性能 rpc 框架应运而生,由阿里开源的 dubbo 框架 go 语言版本的 dubbo-go 也成为了众多开发者不错的选择。本文将介绍 dubbo-go 框架的基本使用方法,以及从 export 调用链的角度进行 server 端源码导读,希望能引导读者进一步认识这款框架。下周将发表本文的姊妹篇:《从 client 端源码导读 dubbo-go 框架》。 序言 近日阅读了部分dubbo-go源码 https://github.com/dubbogo/dubbo-go 当拿到一款框架之后,一种不错的源码阅读方式大致如下:从运行最基础的helloworld demo 源码开始,再查看配置文件,开启各种依赖服务(比如zk、consul),开启服务端,再到通过client调用服务端,打印完整请求日志和回包。调用成功之后,再根据框架的设计模型,从配置文件解析开始,自顶向下递阅读整个框架的调用栈。 对于C/S模式的rpc请求来说,整个调用栈被拆成了client和server两部分,所以可以分别从server端的配置文件解析阅读到server端的监听启动,从client端的配置文件解析阅读到一次invoker Call 调用。这样一次完整请求就明晰了起来。 1. 运行官网提供的helloworld-demo 官方demo 1.1 dubbo-go 2.7版本 QuickStart 1. 开启一个go-server服务 将仓库clone 到本地 $ git clone https://github.com/dubbogo/dubbo-samples.git 进入dubbo目录 $ cd dubbo-samples/golang/helloworld/dubbo 进入目录后可看到四个文件夹,分别支持go和java的client以及server,我们尝试运行一个go的server 进入app子文件夹内,可以看到里面保存了go文件。 $ cd go-server/app sample文件结构: 可在go-server里面看到三个文件夹:app、assembly、profiles 其中app文件夹下保存go源码,assembly文件夹下保存可选的针对特定环境的build脚本,profiles下保存配置文件。对于dubbo-go框架,配置文件非常重要,没有文件将导致服务无法启动。 设置指向配置文件的环境变量 由于dubbo-go框架依赖配置文件启动,让框架定位到配置文件的方式就是通过环境变量来找。对于server端需要两个必须配置的环境变量:CONF_PROVIDER_FILE_PATH、APP_LOG_CONF_FILE,分别应该指向服务端配置文件、日志配置文件。 在sample里面,我们可以使用dev环境,即profiles/dev/log.yml profiles/dev/server.yml 两个文件。 在app/下,通过命令行中指定好这两个文件: $ export CONF_PROVIDER_FILE_PATH="../profiles/dev/server.yml" $ export APP_LOG_CONF_FILE="../profiles/dev/log.yml" 设置go代理并运行服务 $ go run . 如果提示timeout,则需要设置goproxy代理 $ export GOPROXY="http://goproxy.io" 再运行go run 即可开启服务 2. 运行zookeeper 安装zookeeper,并运行zkServer, 默认为2181端口 3. 运行go-client调用server服务 进入go-client的源码目录 $ cd go-client/app 同理,在/app下配置环境变量 $ export CONF_CONSUMER_FILE_PATH="../profiles/dev/client.yml" $ export APP_LOG_CONF_FILE="../profiles/dev/log.yml" 配置go代理 $ export GOPROXY="http://goproxy.io" 运行程序 $ go run . 即可在日志中找到打印出的请求结果 response result: &{A001 Alex Stocks 18 2020-10-28 14:52:49.131 +0800 CST} 同样,在运行的server中,也可以在日志中找到打印出的请求: req:[]interface {}{"A001"} rsp:main.User{Id:"A001", Name:"Alex Stocks", Age:18, Time:time.Time{...} 恭喜!一次基于dubbo-go的rpc调用成功。 4. 常见问题 当日志开始部分出现profiderInit和ConsumerInit均失败的日志。检查环境变量中配置路径是否正确,配置文件是否正确。 当日志中出现register失败的情况,一般为向注册中心注册失败,检查注册中心是否开启,检查配置文件中关于register的端口是否正确。 sample的默认开启端口为20000,确保启动前无占用 1.2 配置环境变量 export APP_LOG_CONF_FILE="../profiles/dev/log.yml" export CONF_CONSUMER_FILE_PATH="../profiles/dev/client.yml" 1.3 服务端源码 1. 目录结构 dubbo-go框架的example提供的目录如下: app/ 文件夹下存放源码,可以自己编写环境变量配置脚本buliddev.sh assembly/ 文件夹下存放不同平台的构建脚本 profiles/ 文件夹下存放不同环境的配置文件 target/ 文件夹下存放可执行文件 2. 关键源码 源码放置在app/文件夹下,主要包含server.go 和user.go 两个文件,顾名思义,server.go用于使用框架开启服务以及注册传输协议,user.go则定义了rpc-service结构体,以及传输协议的结构。 user.go func init() { config.SetProviderService(new(UserProvider)) // ------for hessian2------ hessian.RegisterPOJO(&User{}) } type User struct { Id string Name string Age int32 Time time.Time } type UserProvider struct { } func (u *UserProvider) GetUser(ctx context.Context, req []interface{}) (*User, error) { 可以看到,user.go中存在init函数,是服务端代码中最先被执行的部分。User为用户自定义的传输结构体,UserProvider为用户自定义的rpc_service。 包含一个rpc函数,GetUser。 当然,用户可以自定义其他的rpc功能函数。 在init函数中,调用config的SetProviderService函数,将当前rpc_service注册在框架config上。 可以查看dubbo官方文档提供的设计图 service层下面就是config层,用户服务会逐层向下注册,最终实现服务端的暴露。 rpc-service注册完毕之后,调用hessian接口注册传输结构体User。 至此init函数执行完毕 server.go // they are necessary: // export CONF_PROVIDER_FILE_PATH="xxx" // export APP_LOG_CONF_FILE="xxx" func main() { hessian.RegisterPOJO(&User{}) config.Load() initSignal() } func initSignal() { signals := make(chan os.Signal, 1) ... 之后执行main函数 main函数中只进行了两个操作,首先使用hessian注册组件将User结构体注册(与之前略有重复),从而可以在接下来使用getty打解包。 之后调用config.Load函数,该函数位于框架config/config_loader.go内,这个函数是整个框架服务的启动点,下面会详细讲这个函数内重要的配置处理过程。执行完Load()函数之后,配置文件会读入框架,之后根据配置文件的内容,将注册的service实现到配置结构里,再调用Export暴露给特定的registry,进而开启特定的service进行对应端口的tcp监听,成功启动并且暴露服务。 最终开启信号监听initSignal()优雅地结束一个服务的启动过程。 1.4 客户端源码 客户端包含client.go和user.go两个文件,其中user.go与服务端完全一致,不再赘述。 client.go // they are necessary: // export CONF_CONSUMER_FILE_PATH="xxx" // export APP_LOG_CONF_FILE="xxx" func main() { hessian.RegisterPOJO(&User{}) config.Load() time.Sleep(3e9) println("\n\n\nstart to test dubbo") user := &User{} err := userProvider.GetUser(context.TODO(), []interface{}{"A001"}, user) if err != nil { panic(err) } println("response result: %v\n", user) initSignal() } main函数和服务端也类似,首先将传输结构注册到hessian上,再调用config.Load()函数。在下文会介绍,客户端和服务端会根据配置类型执行config.Load()中特定的函数loadConsumerConfig()和loadProviderConfig(),从而达到“开启服务”、“调用服务”的目的。 加载完配置之后,还是通过实现服务,增加函数proxy,申请registry,reloadInvoker指向服务端ip等操作,重写了客户端实例userProvider的对应函数,这时再通过调用GetUser函数,可以直接通过invoker,调用到已经开启的服务端,实现rpc过程。 下面会从server端和client端两个角度,详细讲解服务启动、registry注册、调用过程: 1.5 自定义配置文件(非环境变量)方法 1.5.1 服务端自定义配置文件 var providerConfigStr = xxxxx// 配置文件内容,可以参考log 和 client 在这里你可以定义配置文件的获取方式,比如配置中心,本地文件读取 在config.Load()之前设置配置,例如: func main() { hessian.RegisterPOJO(&User{}) providerConfig := config.ProviderConfig{} yaml.Unmarshal([]byte(providerConfigStr), &providerConfig) config.SetProviderConfig(providerConfig) defaultServerConfig := dubbo.GetDefaultServerConfig() dubbo.SetServerConfig(defaultServerConfig) logger.SetLoggerLevel("warn") // info,warn config.Load() select { } } 1.5.2 客户端自定义配置文件 var consumerConfigStr = xxxxx// 配置文件内容,可以参考log 和 client 在这里你可以定义配置文件的获取方式,比如配置中心,本地文件读取 在config.Load()之前设置配置,例如: func main() { p := config.ConsumerConfig{} yaml.Unmarshal([]byte(consumerConfigStr), &p) config.SetConsumerConfig(p) defaultClientConfig := dubbo.GetDefaultClientConfig() dubbo.SetClientConf(defaultClientConfig) logger.SetLoggerLevel("warn") // info,warn config.Load() user := &User{} err := userProvider.GetUser(context.TODO(), []interface{}{"A001"}, user) if err != nil { log.Print(err) return } log.Print(user) } 2. server端: 服务暴露过程涉及到多次原始rpcService的封装、暴露,网上其他文章的图感觉太过笼统,我简要的绘制了一个用户定义服务的数据流图 2.1 加载配置 2.1.1 框架初始化 在加载配置之前,框架提供了很多已定义好的协议、工厂等组件,都会在对应模块init函数内注册到extension模块上,以供接下来配置文件中进行选用。 其中重要的有: 默认函数代理工厂 common/proxy/proxy_factory/default.go func init() { extension.SetProxyFactory("default", NewDefaultProxyFactory) } 他的作用是将原始rpc-service进行封装,形成proxy_invoker,更易于实现远程call调用,详情可见其invoke函数。 注册中心注册协议 registry/protocol/protocol.go func init() { extension.SetProtocol("registry", GetProtocol) } 他负责在将invoker暴露给对应注册中心,比如zk注册中心。 zookeeper注册协议 registry/zookeeper/zookeeper.go func init() { extension.SetRegistry("zookeeper", newZkRegistry) } 他合并了base_resiger,负责在服务暴露过程中,将服务注册在zookeeper注册器上,从而为调用者提供调用方法。 dubbo传输协议 protocol/dubbo/dubbo.go func init() { extension.SetProtocol(DUBBO, GetProtocol) } 他负责监听对应端口,将具体的服务暴露,并启动对应的事件handler,将远程调用的event事件传递到invoker内部,调用本地invoker并获得执行结果返回。 filter包装调用链协议 protocol/protocolwrapper/protocol_filter_wrapper.go func init() { extension.SetProtocol(FILTER, GetProtocol) } 他负责在服务暴露过程中,将代理invoker打包,通过配置好的filter形成调用链,并交付给dubbo协议进行暴露。 上述提前注册好的框架已实现的组件,在整个服务暴露调用链中都会用到,会根据配置取其所需。 2.1.2 配置文件 服务端需要的重要配置有三个字段:services、protocols、registries profiles/dev/server.yaml: registries : "demoZk": protocol: "zookeeper" timeout : "3s" address: "127.0.0.1:2181" services: "UserProvider": # 可以指定多个registry,使用逗号隔开;不指定默认向所有注册中心注册 registry: "demoZk" protocol : "dubbo" # 相当于dubbo.xml中的interface interface : "com.ikurento.user.UserProvider" loadbalance: "random" warmup: "100" cluster: "failover" methods: - name: "GetUser" retries: 1 loadbalance: "random" protocols: "dubbo": name: "dubbo" port: 20000 其中service指定了要暴露的rpc-service名("UserProvider),暴露的协议名("dubbo"),注册的协议名("demoZk"),暴露的服务所处的interface,负载均衡策略,集群失败策略,调用的方法等等。 其中中间服务的协议名需要和registries下的mapkey对应,暴露的协议名需要和protocols下的mapkey对应 可以看到上述例子中,使用了dubbo作为暴露协议,使用了zookeeper作为中间注册协议,并且给定了端口。如果zk需要设置用户名和密码,也可以在配置中写好。 2.1.3 配置文件的读入和检查 config/config_loader.go:: Load() 在上述example的main函数中,有config.Load()函数的直接调用,该函数执行细节如下: // Load Dubbo Init func Load() { // init router initRouter() // init the global event dispatcher extension.SetAndInitGlobalDispatcher(GetBaseConfig().EventDispatcherType) // start the metadata report if config set if err := startMetadataReport(GetApplicationConfig().MetadataType, GetBaseConfig().MetadataReportConfig); err != nil { logger.Errorf("Provider starts metadata report error, and the error is {%#v}", err) return } // reference config loadConsumerConfig() // service config loadProviderConfig() // init the shutdown callback GracefulShutdownInit() } 在本文中,我们重点关心loadConsumerConfig()和loadProviderConfig()两个函数 对于provider端,可以看到loadProviderConfig()函数代码如下: 前半部分是配置的读入和检查,进入for循环后,是单个service的暴露起始点。 前面提到,在配置文件中已经写好了要暴露的service的种种信息,比如服务名、interface名、method名等等。在图中for循环内,会将所有service的服务依次实现。 for循环的第一行,根据key调用GetProviderService函数,拿到注册的rpcService实例,这里对应上述提到的init函数中用户手动注册的自己实现的rpc-service实例: 这个对象也就成为了for循环中的rpcService变量,将这个对象注册通过Implement函数写到sys(ServiceConfig类型)上,设置好sys的key和协议组,最终调用了sys的Export方法。 此处对应流程图的部分: 至此,框架配置结构体已经拿到了所有service有关的配置,以及用户定义好的rpc-service实例,他触发了Export方法,旨在将自己的实例暴露出去。这是Export调用链的起始点。 2.2 原始service封装入proxy_invoker config/service_config.go :: Export() 接下来进入ServiceConfig.Export()函数: 这个函数进行了一些细碎的操作,比如为不同的协议分配随机端口,如果指定了多个中心注册协议,则会将服务通过多个中心注册协议的registryProtocol暴露出去,我们只关心对于一个注册协议是如何操作的。还有一些操作比如生成调用url和注册url,用于为暴露做准备。 2.2.1 首先通过配置生成对应registryUrl和serviceUrl registryUrl是用来向中心注册组件发起注册请求的,对于zookeeper的话,会传入其ip和端口号,以及附加的用户名密码等信息 这个regUrl目前只存有注册(zk)相关信息,后续会补写入ServiceIvk,即服务调用相关信息,里面包含了方法名,参数等... 2.2.2 对于一个注册协议,将传入的rpc-service实例注册在common.ServiceMap 这个Register函数将服务实例注册了两次,一次是以Interface为key写入接口服务组内,一次是以interface和proto为key写入特定的一个唯一的服务。 后续会从common.Map里面取出来这个实例。 2.2.3 获取默认代理工厂,将实例封装入代理invoker // 拿到一个proxyInvoker,这个invoker的url是传入的regUrl,这个地方将上面注册的service实例封装成了invoker // 这个GetProxyFactory返回的默认是common/proxy/proxy_factory/default.go // 这个默认工厂调用GetInvoker获得默认的proxyInvoker,保存了当前注册url invoker := extension.GetProxyFactory(providerConfig.ProxyFactory).GetInvoker(*regUrl) // 暴露出来 生成exporter,开启tcp监听 // 这里就该跳到registry/protocol/protocol.go registryProtocol 调用的Export,将当前proxyInvoker导出 exporter = c.cacheProtocol.Export(invoker) 这一步的GetProxyFactory("default")方法获取默认代理工厂,通过传入上述构造的regUrl,将url封装入代理invoker。 可以进入common/proxy/proxy_factory/default.go::ProxyInvoker.Invoke()函数里,看到对于common.Map取用为svc的部分,以及关于svc对应Method的实际调用Call的函数如下: 到这里,上面GetInvoker(*regUrl)返回的invoker即为proxy_invoker,他封装好了用户定义的rpc_service,并将具体的调用逻辑封装入了Invoke函数内。 为什么使用Proxy_invoker来调用? 我认为,通过这个proxy_invoke调用用户的功能函数,调用方式将更加抽象化,可以在代码中看到,通过ins和outs来定义入参和出参,将整个调用逻辑抽象化为invocation结构体,而将具体的函数名的选择,参数向下传递,reflect反射过程封装在invoke函数内,这样的设计更有利于之后远程调用。我认为这是dubbo Invoke调用链的设计思想。 至此,实现了图中对应的部分: 2.3 registry协议在zkRegistry上暴露上面的proxy_invoker 上面,我们执行到了exporter = c.cacheProtocol.Export(invoker) 这里的cacheProtocol为一层缓存设计,对应到原始的demo上,这里是默认实现好的registryProtocol registry/protocol/protocol.go:: Export() 这个函数内构造了多个EventListener,非常有java的设计感。 我们只关心服务暴露的过程,先忽略这些监听器。 2.3.1 获取注册url和服务url 2.3.2 获取注册中心实例zkRegistry 一层缓存操作,如果cache没有需要从common里面重新拿zkRegistry 2.3.3 zkRegistry调用Registry方法,在zookeeper上注册dubboPath 上述拿到了具体的zkRegistry实例,该实例的定义在 registry/zookeeper/registry.go 该结构体组合了registry.BaseRegistry结构,base结构定义了注册器基础的功能函数,比如Registry、Subscribe等,但在这些默认定义的函数内部,还是会调用facade层(zkRegistry层)的具体实现函数,这一设计模型能在保证已有功能函数不需要重复定义的同时,引入外层函数的实现,类似于结构体继承却又复用了代码。 这一设计模式我认为值得学习。 我们查看上述registry/protocol/protocol.go:: Export()函数,直接调用了: // 1. 通过zk注册器,调用Register()函数,将已有@root@rawurl注册到zk上 err := reg.Register(*registeredProviderUrl) 将已有RegistryUrl注册到了zkRegistry上。 这一步调用了baseRegistry的Register函数,进而调用zkRegister的DoRegister函数,进而调用: 在这个函数里,将对应root创造一个新的节点 并且写入具体node信息,node为url经过encode的结果,包含了服务端的调用方式。 这部分的代码较为复杂,具体可以看baseRegistry的 processURL()函数。 至此,将服务端调用url注册到了zookeeper上,而客户端如果想获取到这个url,只需要传入特定的dubboPath,向zk请求即可。目前client是可以获取到访问方式了,但服务端的特定服务还没有启动,还没有开启特定协议端口的监听,这也是registry/protocol/protocol.go:: Export()函数接下来要做的事情: 2.3.4 proxy_invoker 封装入wrapped_invoker,得到filter调用链 // invoker封装入warppedInvoker wrappedInvoker := newWrappedInvoker(invoker, providerUrl) // 经过为invoker增加filter调用链,再使用dubbo协议Export,开启service并且返回了Exporter 。 // export_1 cachedExporter = extension.GetProtocol(protocolwrapper.FILTER).Export(wrappedInvoker) 新建一个WrappedInvoker,用于之后链式调用 拿到提前实现并注册好的ProtocolFilterWrapper,调用Export方法,进一步暴露。 protocol/protocolwrapped/protocol_filter_wrapper.go:Export() protocol/protocolwrapped/protocol_filter_wrapper.go:buildInvokerChain 可见,根据配置的内容,通过链式调用的构造,层层将proxy_invoker包裹在调用链的最底部,最终返回一个调用链invoker。 对应图中部分: 至此,我们已经拿到filter调用链,期待将这个chain暴露到特定端口,用于相应请求事件 2.3.5 通过dubbo协议暴露wrapped_invoker protocol/protocolwrapped/protocol_filter_wrapper.go:Export() // 通过dubbo协议Export dubbo_protocol调用的 export_2 return pfw.protocol.Export(invoker) 回到上述Export函数的最后一行,调用了dubboProtocol的Export方法,将上述chain真正暴露。 该Export方法的具体实现在 protocol/dubbo/dubbo_protocol.go: Export() 这一函数做了两个事情:构造触发器、启动服务 将传入的Invoker调用chain进一步封装,封装成一个exporter,再将这个export放入map保存。注意!这里昂exporter放入了SetExporterMap中,在下面服务启动的时候,会以注册事件监听器的形式将这个exporter取出! 调用dubboProtocol的openServer方法,开启一个针对特定端口的监听 如上图所示,一个Session被传入,开启对应端口的事件监听。 至此构造出了exporter,完成图中部分: 2.4 注册触发动作 上述只是启动了服务,但还没有看到触发事件的细节,点进上面的s.newSession可以看到,dubbo协议为一个getty的session默认使用了如下配置 其中很重要的一个配置是EventListener,传入的是dubboServer的默认rpcHandler protocol/dubbo/listener.go:OnMessage() rpcHandler有一个实现好的OnMessage函数,根据getty的API,当client调用该端口时,会触发OnMessage // OnMessage notified when RPC server session got any message in connection func (h *RpcServerHandler) OnMessage(session getty.Session, pkg interface{}) { 这一函数实现了在getty session接收到rpc 调用后的一系列处理: 传入包的解析 根据请求包构造请求url 拿到对应请求key,找到要被调用的exporter 拿到对应的Invoker 构造invocation 调用 返回 整个被调过程一气呵成。实现了从getty.Session的调用事件,到经过层层封装的invoker的调用。 至此,一次rpc调用得以正确返回。 3. 小结 关于Invoker的层层封装 能把一次调用抽象成一次invoke,能把一个协议抽象成针对invoke的封装,能把针对一次invoke所做出的特定改变封装到invoke函数内部,可以降低模块之间的耦合性。层层封装逻辑更加清晰 关于URL的抽象 关于dubbo的统一化请求对象URL的极度抽象是我之前没有见过的... 我认为这样封装能保证请求参数列表的简化和一致。但我认为在开发的过程中,滥用极度抽象的接口可能造成...debug的困难?以及不知道哪些字段是当前已经封装好的,哪些字段是无用的。 关于协议的理解 之前理解的协议还是太过具体化了,而关于dubbo-go对于dubboProtocol的协议,我认为是基于getty的进一步封装,他定义了客户端和服务端,对于getty的session应该有哪些特定的操作,从而保证主调和被调的协议一致性,而这种保证也是一种协议的体现,是由dubbo协议来规范的。 如果你有任何疑问,欢迎钉钉扫码加入交流群【钉钉群号 23331795】: 作者简介 李志信 (GitHubID LaurenceLiZhixin),中山大学软件工程专业在校学生,擅长使用 Java/Go 语言,专注于云原生和微服务等技术方向。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册