数据源管理 | 分布式NoSQL系统,Cassandra集群管理
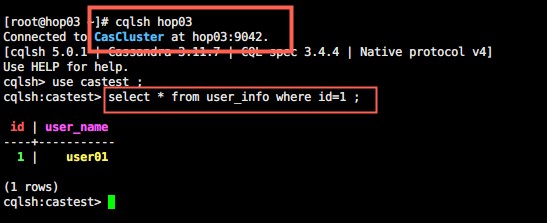
本文源码:GitHub·点这里 || GitEE·点这里 一、Cassandra简介 1、基础描述 Cassandra是一套开源分布式NoSQL数据库系统。它最初由Facebook开发,用于储存收件箱等简单格式数据,此后,由于Cassandra良好的可扩展性,逐渐发展成为了一种流行的分布式结构化数据存储方案。 2、特点分析 弹性可扩展性 Cassandra是高度可扩展的;它允许添加更多的硬件以适应更多的客户和更多的数据根据要求,可以根据业务的数据流量轻松扩展集群规模。 架构特点 Cassandra可以基于分布式运行,并采用了许多容错机制。由于去中心化无主的策略,所以没有单点故障。可以做到不停服滚动升级。这是因为Cassandra可以支持多个节点的临时失效(取决于群集大小),对群集的整体性能影响可以忽略不计。并且Cassandra提供多地域容灾。Cassandra允许将数据复制到其他数据中心,并在多个地域保留多副本,十分适用于不能承担故障的关键业务,必须持续提供服务的应用程序。 数据存储机制 Cassandra适应所有可能的数据格式,包括:结构化,半结构化和非结构化。可以根据业务的需要动态地适应变化的数据结构,并且通过在多个数据中心之间复制数据,可以灵活地在需要时分发数据。有许多案例证明Cassandra可以在金融,医疗,物联网等领域使用。 资源整合能力 Cassandra可以很容易的跟其他开源组件做集成,其中包括Hadoop,Spark,Kafka,Solr等系列组件,成为大数据业务处理里面重要的一个角色。 二、集群环境搭建 1、环境概览 jdk1.8 apache-cassandra-3.11.7-bin.tar.gz centos7 三台服务:hop01、hop02、hop03节点 2、安装包处理 tar -zxvf apache-cassandra-3.11.7-bin.tar.gz mv apache-cassandra-3.11.7 cassandra3.11 3、环境变量 [root@hop01 opt]# vim /etc/profile export CASSANDRA_HOME=/opt/cassandra3.11 export PATH=$PATH:$CASSANDRA_HOME/bin [root@hop01 opt]# source /etc/profile 4、创建目录 # 数据目录 mkdir -p /data/cassandra/data # 日志目录 mkdir -p /data/cassandra/log 5、集群配置 vim /opt/cassandra3.11/conf/cassandra.yaml # 配置集群名称 cluster_name: 'CasCluster' # 配置数据目录 data_file_directories: - /data/cassandra/data # 配置日志目录 commitlog_directory: /data/cassandra/log # 设置监听地址,当前服务IP listen_address: 192.168.72.132 # 配置RPC服务 start_rpc: true rpc_address: 192.168.72.132 # 配置集群节点 seed_provider: - class_name: org.apache.cassandra.locator.SimpleSeedProvider parameters: - seeds: "192.168.72.132,192.168.72.138,192.168.72.139" 将该配置分发到集群的每个节点,注意listen_address和rpc_address是节点自己的IP地址即可。 6、启动集群 # 集群下节点依次执行启动命令 cassandra -R # 查看节点状态 nodetool status 7、基础操作 进入命令行 cqlsh hop01 创建keyspace,并选择 CREATE KEYSPACE IF NOT EXISTS castest WITH REPLICATION = {'class': 'SimpleStrategy','replication_factor':3}; use castest ; 创建表,写入数据 CREATE TABLE user_info (id int, user_name varchar, PRIMARY KEY (id) ); INSERT INTO user_info (id,user_name) VALUES (1,'user01'); 查询数据 select * from user_info ; 基于其他服务查看数据,可以看到数据已经在集群间做了同步过程: 三、集成SpringBoot框架 1、核心依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> <version>${spring.boot.version}</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-cassandra</artifactId> <version>${spring.boot.version}</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-jpa</artifactId> <version>${spring.boot.version}</version> </dependency> 这里核心需要cassandra依赖和操作的API依赖。 2、核心配置 spring: data: cassandra: keyspace-name: castest contact-points: 192.168.72.138,192.168.72.132,192.168.72.139 port: 9042 cluster-name: CasCluster keyspace-name:类似关系型数据库的名称; contact-points:集群下节点的IP地址; port:默认端口; cluster-name:上述配置的集群名称; 3、基于Template命令 CassandraTemplate模板类,实现了一系列操作Cassandra数据库的基本方法,直接注入即可使用。 @Repository public class UserInfoTemplate { @Resource private CassandraTemplate cassandraTemplate ; // 查询全部数据 public List<UserInfo> getList (){ return cassandraTemplate.select("SELECT * FROM user_info",UserInfo.class) ; } // 添加数据 public UserInfo insert (UserInfo userInfo){ return cassandraTemplate.insert(userInfo) ; } // 根据主键查询 public UserInfo selectOneById (Integer id){ return cassandraTemplate.selectOneById(id,UserInfo.class) ; } // 修改数据 public UserInfo update (UserInfo userInfo){ return cassandraTemplate.update(userInfo) ; } // 删除数据 public Boolean deleteById (Integer id){ return cassandraTemplate.deleteById(id,UserInfo.class) ; } } 4、基于Repository接口 SpringBoot框架中定义的数据库访问核心接口。 接口实现 import com.cassand.cluster.entity.UserInfo; import org.springframework.data.repository.CrudRepository; public interface UserInfoRepository extends CrudRepository<UserInfo,Integer> { } 接口用法 @Service public class RepositoryService { @Resource private UserInfoRepository userInfoRepository ; // 保存 public UserInfo save (UserInfo userInfo){ return userInfoRepository.save(userInfo) ; } // 查询 public UserInfo getById (Integer id){ return userInfoRepository.findById(id).get() ; } // 修改 public UserInfo update (UserInfo userInfo){ // 主键ID存在的情况即为修改 return userInfoRepository.save(userInfo); } // 删除 public void deleteById (Integer id){ userInfoRepository.deleteById(id); } } 5、实体表结构 注意这里的注解是基于cassandra特定的一套。 import org.springframework.data.cassandra.core.mapping.Column; import org.springframework.data.cassandra.core.mapping.PrimaryKey; import org.springframework.data.cassandra.core.mapping.Table; @Table("user_info") public class UserInfo { public UserInfo(Integer id, String userName) { this.id = id; this.userName = userName; } @PrimaryKey private Integer id ; @Column(value = "user_name") private String userName ; } 四、源代码地址 GitHub·地址 https://github.com/cicadasmile/data-manage-parent GitEE·地址 https://gitee.com/cicadasmile/data-manage-parent