首页 文章 精选 留言 我的

精选列表

搜索[Skills],共2312篇文章
优秀的个人博客,低调大师

【HarmonyOS SDK Skills】 Push Kit自分类Skill 提升权益申请通过率

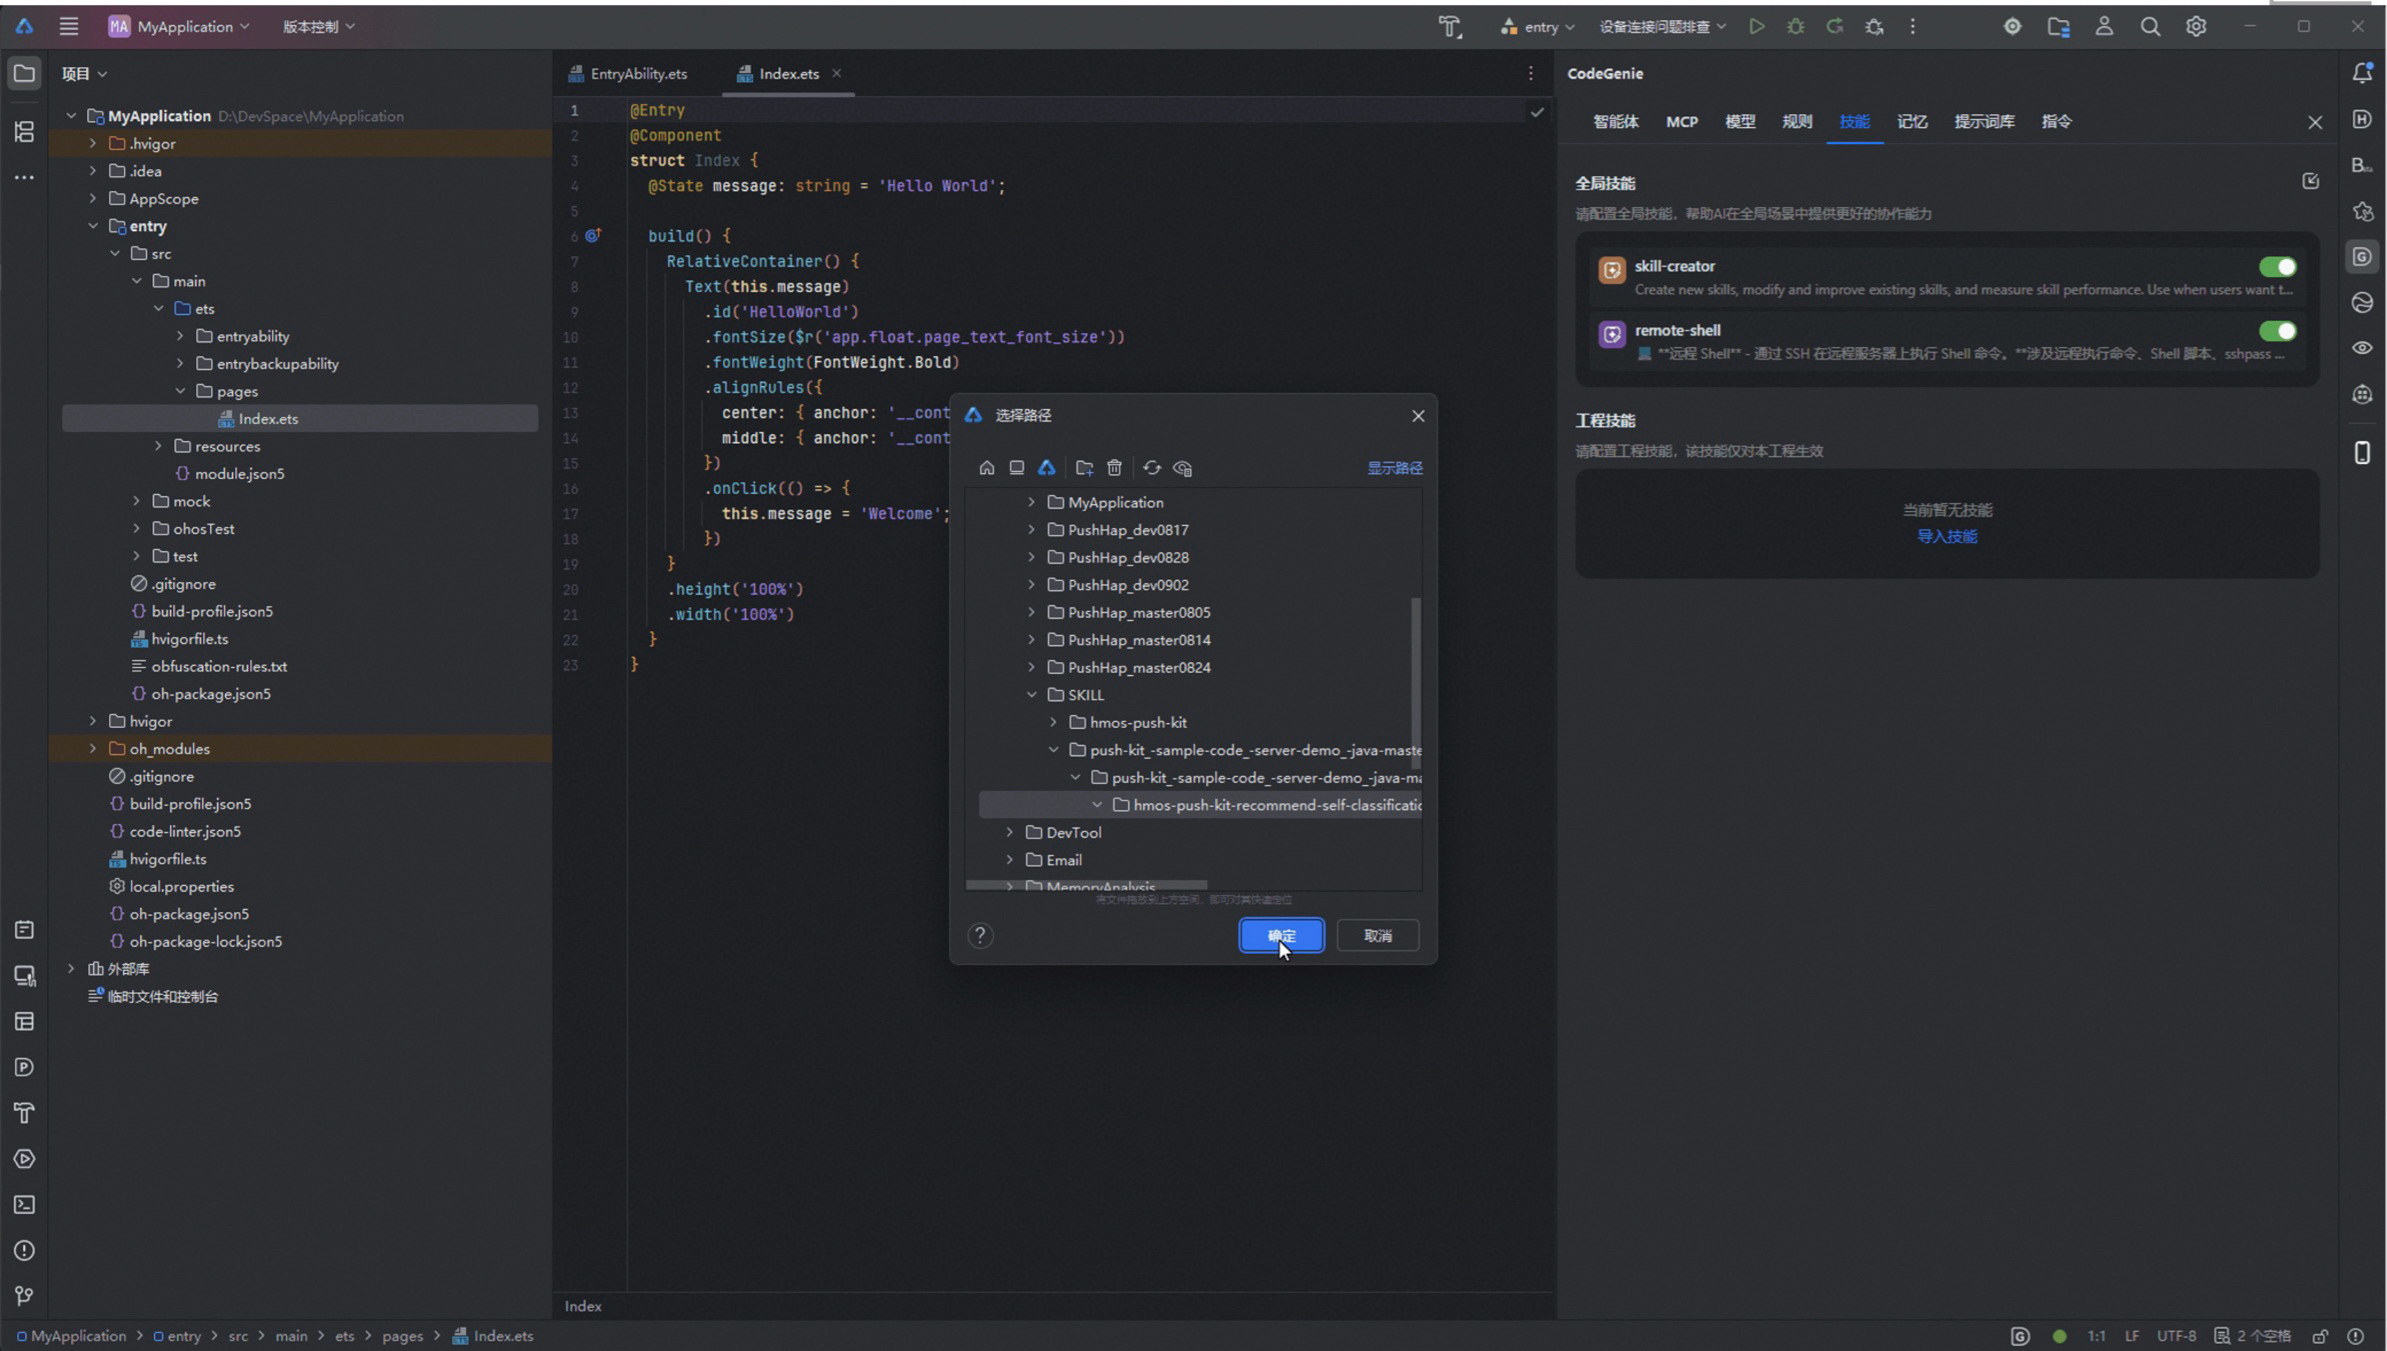
在消息推送体系中,通知消息分类直接影响用户的推送体验。服务通讯类、资讯营销类消息,在设备展示规则、频次限制上截然不同。HarmonyOS Push Kit 为了保障用户体验,会默认将所有消息归为营销类,而营销类消息每天每台设备最多仅能收到2条或5条提醒。对于需要高频推送服务提醒的应用(如 IM、出行、健康管理等),默认营销通道很难匹配真实业务诉求。此外,不同消息类别对标题、内容格式有不同要求,选错类别将被驳回。如何快速匹配最适合的自分类类别,亟需一个可靠的官方工具提升申请效率。 通知消息自分类权益推荐 Skill(hmos-push-kit-recommend-self-classification)正式推出。该能力结合 AI 大模型与鸿蒙推送分类知识库,可智能分析应用类型与推送场景,自动推荐最合适的自分类权益类别,有效降低申请驳回概率。 一、四大核心能力 智能推荐:结合应用类型和推送业务场景,自动推荐最佳分类类别; 错误规避:分析高频驳回原因,提前规避常见错误; 格式指导:提供各类消息的标题、内容格式规范; 申请指导:多业务场景并存时,提供清晰的类别选择建议。 二、两步接入,轻松申请 第一步:下载配置 Skill 从官方代码仓库【下载Skill】,并放置到 AI 编码工具(如 Deveco Code、Claude Code 等)的 Skill 配置目录下。 第二步:触发 Skill 获取推荐结果 向 AI 编码工具描述您的应用类型和推送场景,可通过关键词触发(如“帮我推荐 xxx 场景适配的 push 自分类”)或 Skill 名称触发(如“请使用 hmos-push-kit-recommend-self-classification 推荐自分类权益”)。Skill 分析后将输出推荐类别和申请材料清单。 三、提交申请 根据Skill推荐结果准备相应材料,在 AppGallery Connect 网站提交通知消息自分类权益申请。 四、智能推荐,提质增效 通知消息自分类权益推荐 Skill 为开发者带来三大核心价值: 1.精准匹配:AI 智能分析应用场景,推荐最合适的自分类类别,有效降低驳回率; 2.规避风险:提前识别常见驳回原因,避免因格式或类别错误导致申请失败; 3.高效申请:提供完整的申请材料清单与格式指导,一站式完成自分类权益筹备。 开发者仅需描述推送场景,Skill 即可自动返回推荐类别及申请材料清单。即刻体验该Skill,实现通知高效触达,告别驳回烦恼! (营销类型为默认权益,未申请或使用错误类别时默认走营销通道,建议开发者根据实际场景尽早申请自分类权益)

优秀的个人博客,低调大师

【HarmonyOS SDK Skills】AI 赋能 Push Kit 开发,鸿蒙应用推送能力接入

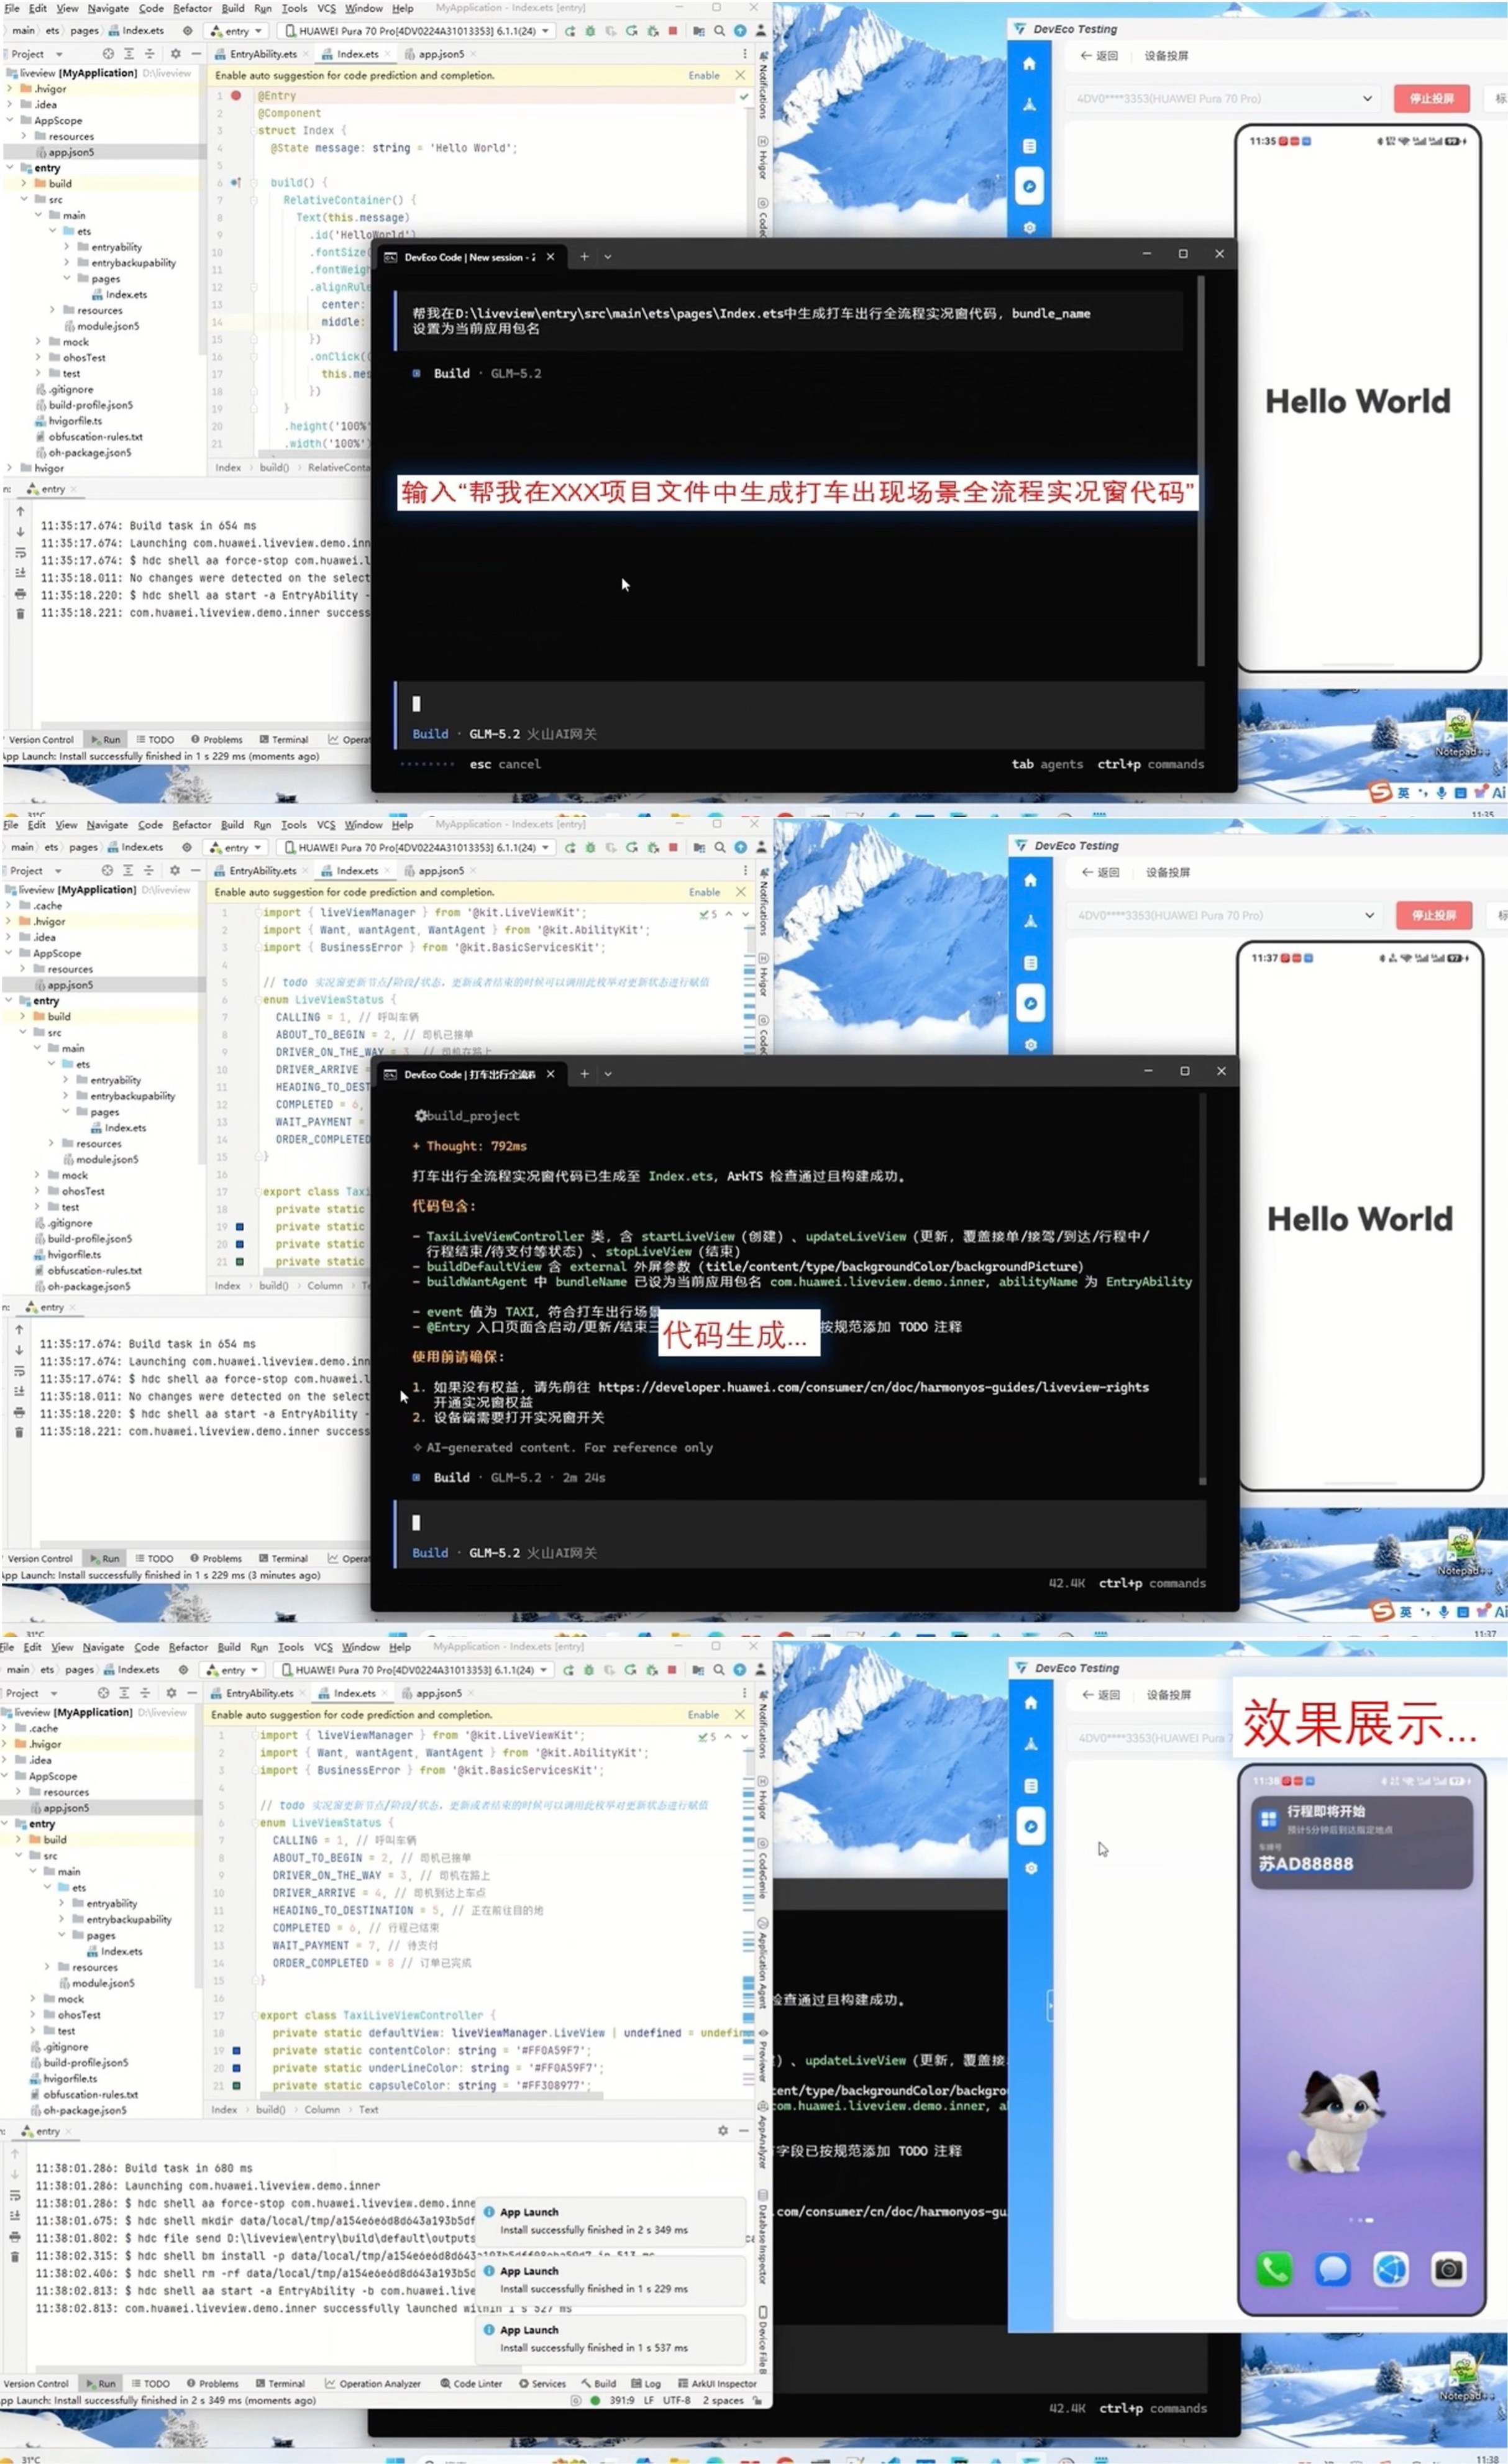
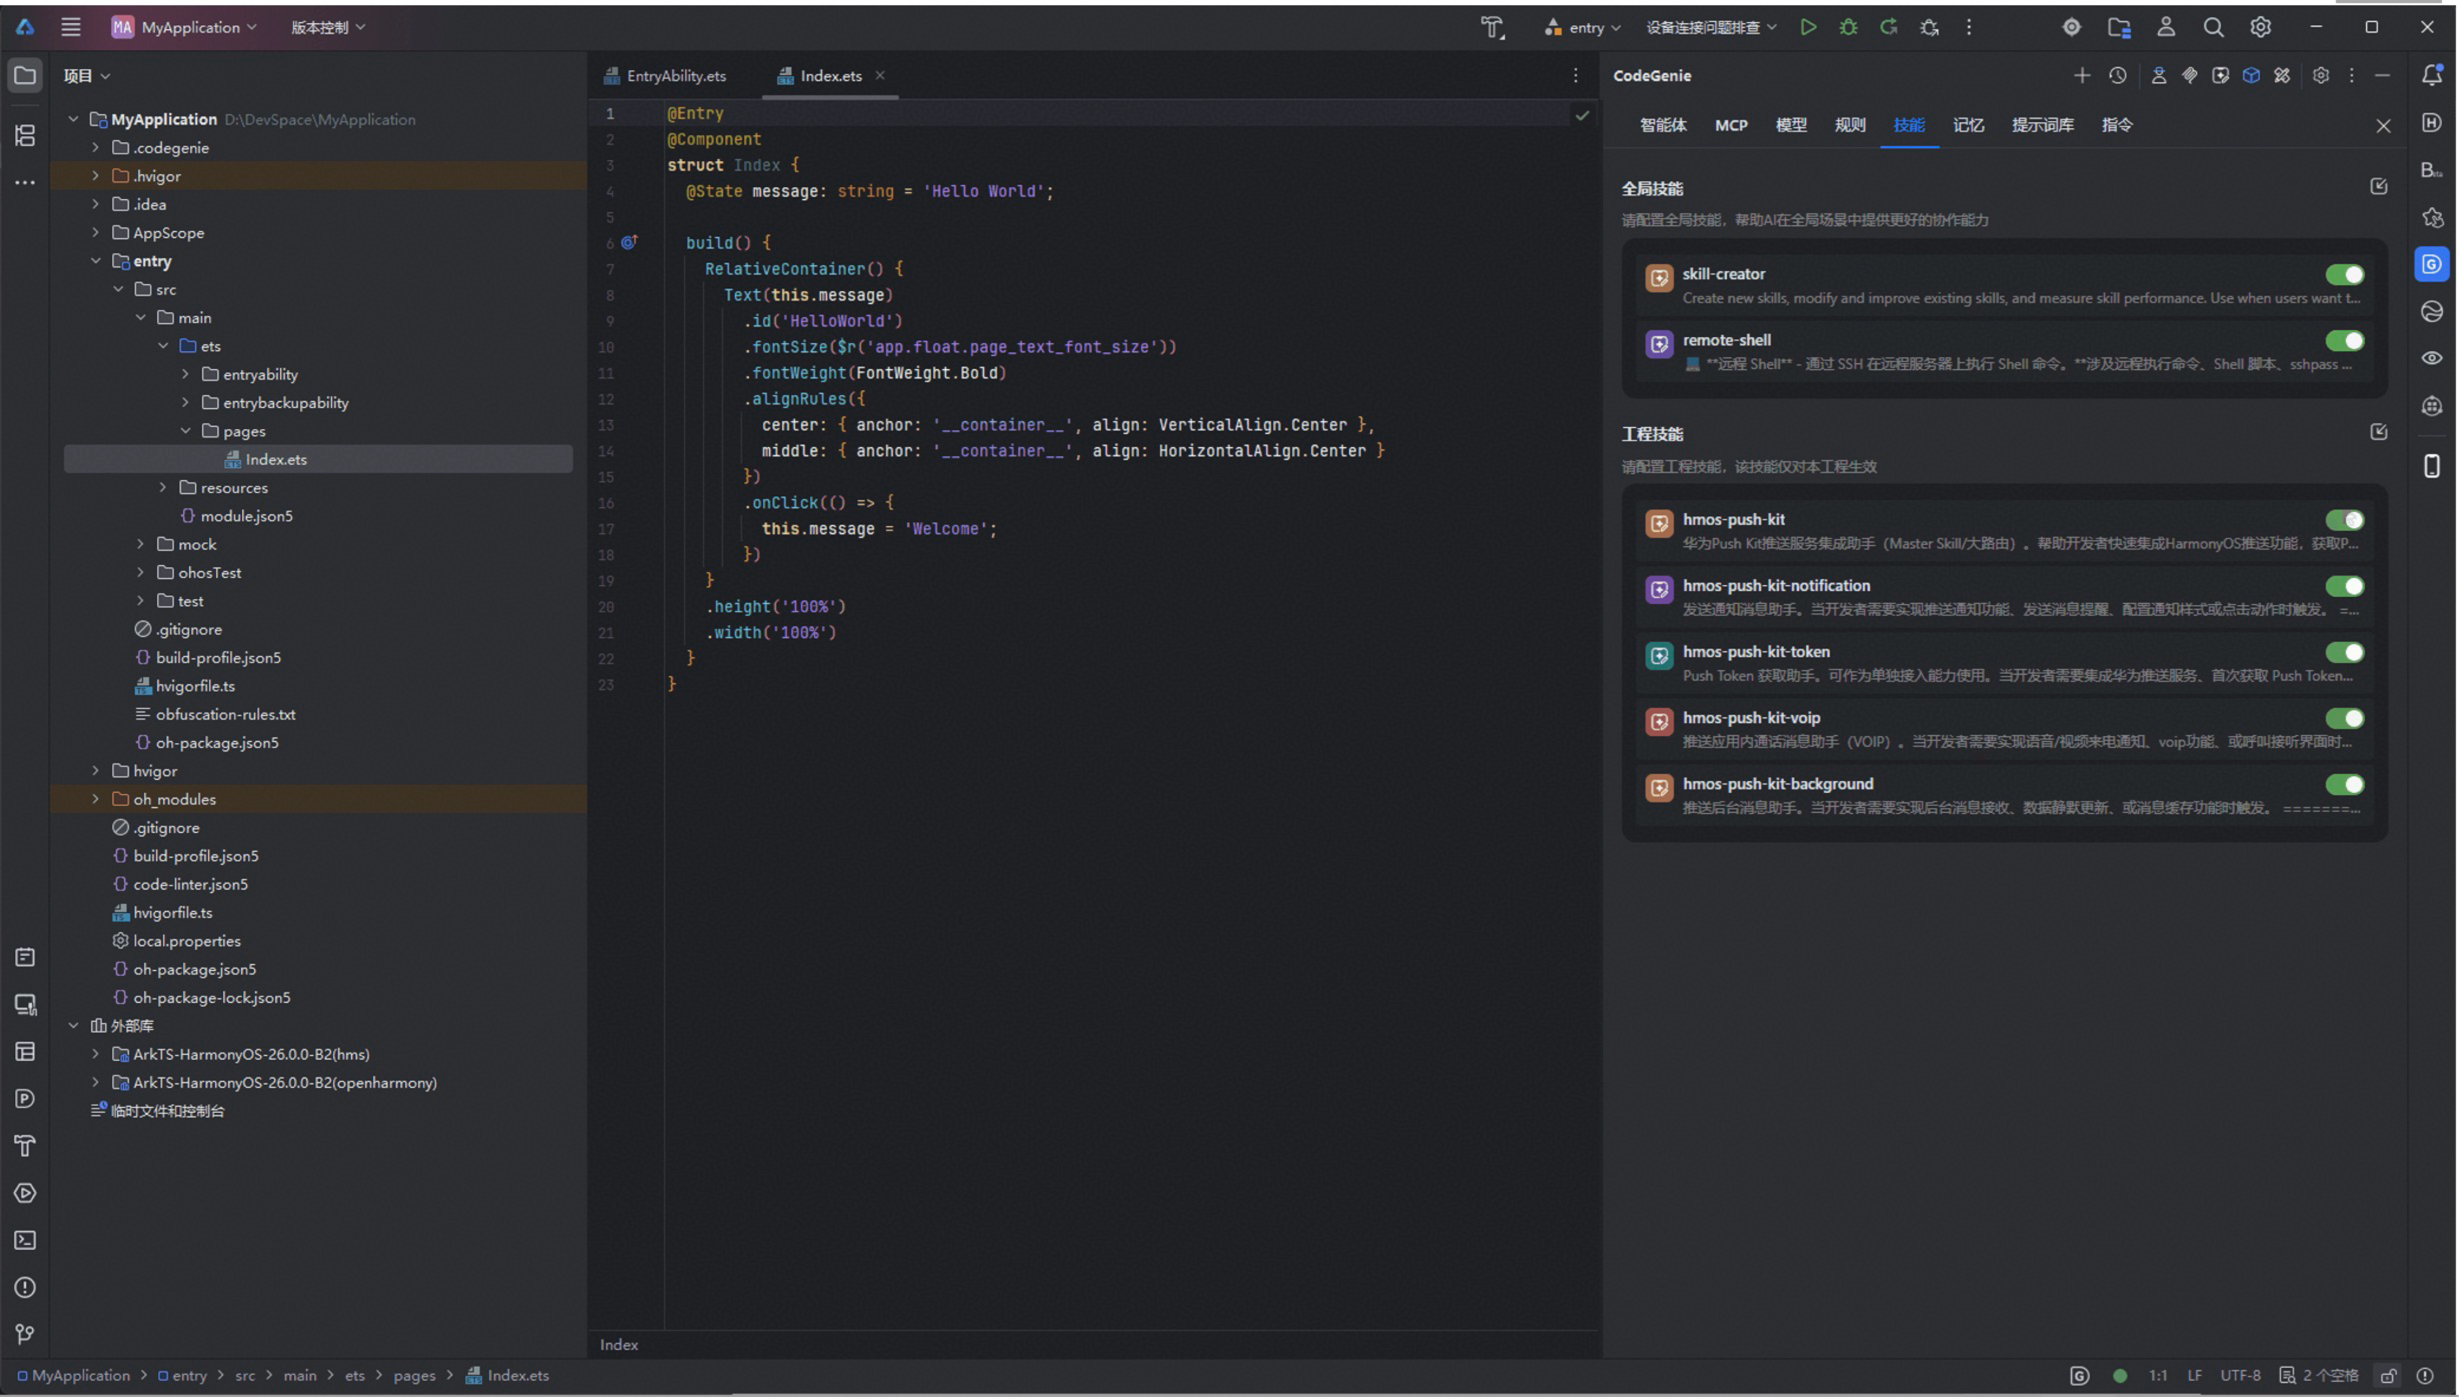
Push Kit(推送服务) 是 HarmonyOS SDK 为开发者提供的应用触达用户、激活留存、完善场景服务的核心开放能力。无论是通知提醒、后台消息还是应用内通话,精准的消息推送直接关系到用户体验与留存。针对不同场景的推送需求,开发者往往需要同时兼顾客户端代码实现、服务端多语言接口适配以及工程依赖配置等一系列繁杂事务。这就迫切需要一个效率提升工具,帮助他们快速接入 Push 功能。 正是为了解决这一痛点, Push Kit 场景化消息开发 Skill(hmos-push-kit)正式推出。它依托鸿蒙推送官方知识库与 AI 大模型能力,可自动完成客户端代码生成、服务端接口适配以及工程依赖配置,将推送接入流程简化为“一键式”自动化任务,帮助开发者告别手动编码与调试,让鸿蒙推送接入效率实现质的飞跃。 一、端云协同,一站式适配 客户端 Skill:自动生成推送通知消息、后台消息、应用内通话消息的 ArkTS 代码,同时自动配置工程依赖与权限。 服务端 Skill:自动生成服务端工程代码,实现 Push 场景化消息发送能力,支持Java 开发语言快速适配。 二、两步接入,轻松上手 第一步:下载安装 从官方开发者指南中提供的链接处【下载客户端Skill】,放置到 AI 编码工具(如 DevEco Code、OpenCode 等)的 Skill 配置目录下。(如下展示的是客户端Skill,服务端 Skill 下载安装步骤相同) 第二步:触发 Skill 在 AI 编码工具对话中描述您的推送场景需求(如“帮我接入 Push Kit ”),或直接输入 Skill 名称触发能力(如“请使用 hmos-push-kit 帮我接入推送服务 ”),AI 将自动为您生成完整、可直接编译运行的全套代码与配置文件。 三、提质增效,解锁开发新范式 Push Kit 场景化消息开发 Skill,聚焦开发者核心诉求,从效率、成本、质量三个维度全面优化推送开发体验: 1.效率飞跃:AI自动生成代码,告别手动配置依赖与调试; 2.成本优化:客户端与服务端双端覆盖,降低多语言技术栈适配成本。 3.标准可控:遵循鸿蒙官方开发规范,统一代码输出标准,有效减少各类异常问题。 AI 赋能鸿蒙应用推送开发,让手动配置自动化、让零散开发标准化、让高频需求轻量化。无需深耕底层原理,无需反复踩坑调试,一键解锁主要场景的鸿蒙推送能力,助力开发者高效完成功能落地,聚焦业务创新。 (部分能力处于持续迭代中,接入过程中如有疑问,可通过官方渠道咨询技术支持)

优秀的个人博客,低调大师

《WorkBuddy Skills 实战》第14招 一本书变成Skill

你有没有遇到过这种情况:手册里明明写着答案,但每次让模型回答跨章节问题时,它都要把整本书重新扫一遍。我是老李,一个在后台系统里折腾多年的工程师。团队最近在整理一本内部高并发运维手册,800 多页、几十万字。大家想让模型回答“线程池参数、数据库连接池参数、压测结论之间如何配套”这类问题时,发现每次都要加载大量无关章节,不仅烧 token,答案还经常把第三章和第九章的版本搞混。为什么现在要讲?因为长文档越来越多,上下文窗口再大也经不起整本乱塞。把查找成本前移,做成可查询的知识包,是当下非常划算的一件事。 ## 01、痛点 长文档和普通 FAQ 不一样。普通 FAQ 的问题短、答案短,直接检索就行。技术书、企业规范、内部手册的特点是:信息密度高、章节之间强依赖、版本关系复杂。比如《高并发系统运维手册》第六章讲线程池,第十二章讲连接池,附录 B 是压测报告,附录 D 是扩容公式。一个看似简单的问题“线程池最大线程数怎么配”,可能同时涉及这三处。 传统做法是把整本书或大段章节塞给模型,让它自己去翻。结果有几个明显问题: - 上下文占用高:几十万字全加载,可能占掉几十万 token。 - 定位慢:模型要在长上下文中反复跳转,容易漏掉附录里的关键约束。 - 容易串版本:如果手册修订过,旧章节和新章节对同一参数建议不一致,模型没有明确的版本边界,很容易张冠李戴。 - 费用高:每次问答都为大量无关内容付费。 - 安全风险:受控手册如果被全文复制到外部系统,版权和敏感信息都容易失控。 这些问题的共同根源,不是模型不够强,而是我们把“发现正确内容”这件事留到了每次提问时。 ## 02、是什么 我要介绍的方法,是把长文档转成一种可按需加载和查询的知识包。它和常见的全文摘要不同,也不是简单地把 PDF 切成小段再向量检索。知识包更像一个经过预处理的目录系统,每个目录节点后面跟着一个最小知识单元。知识单元里只保留回答某类问题必需的内容、前置条件、来源路径和校验规则。原始长文仍然留在受控仓库里,知识包不上传全文。 可以把知识包理解成一套“问题路由 + 最小上下文”结构。构建时,先扫描目录、章节标题、图表清单、代码块、参数表和版本修订记录,把它们抽象成索引。再按任务粒度拆分知识单元。比如“线程池最大线程数”是一个知识单元,“连接池等待时间”是另一个,“两者联动校验”是第三个。实际提问时,先走路由层,判断需要挂载哪几个知识单元,再加载这些单元,而不是加载整本书。 它的核心目标只有一个:把发现成本从在线阶段前移到离线阶段。 ## 03、为什么 上下文窗口不是无限大,也不应该成为垃圾桶。很多模型在长上下文中存在中间位置注意力下降的问题,无关内容越多,正确答案越容易被稀释。每次提问都重新翻目录和加载整本书,等于把所有查找负担都丢给在线推理。更糟的是,这种负担还按 token 计费。 结构化知识包能减少三样东西:加载量、串版本概率、重复劳动。以 800 页手册为例,原文可能有 40 万字以上,随便全量加载就是几十万 token;抽象成知识单元后,大多数问题只需要挂载三五个单元,每个单元几百到一两千字,整体加载量可以降低一两个数量级。 更重要的是,知识包把章节之间的依赖关系提前梳理好。比如“超时时间不能大于熔断时间”这种跨章节约束,如果只靠检索,可能同时召回第三章和第九章的冲突内容,模型还得自己判断谁优先级更高。而知识包可以在构建期就标注冲突和生效条件。 ## 04、架构 我把它分成五层。 - 原材料层:存放有权使用的原始文档、版本号、哈希、访问权限。可以放内部 Git 或对象存储,不允许直接对外。 - 解析层:用目录解析、章节切分、表格识别、代码块识别等步骤,把长文拆成带路径的结构化片段。比如“06-2 线程池核心参数”是一个片段。 - 语义层:对每个片段生成摘要、关键词、适用问题列表、前置依赖、冲突说明。例如该片段依赖“12-4 连接池等待时间”,并提示“与 09-3 网关超时建议存在历史冲突”。 - 知识单元层:把语义层产出打包成可加载的单元。每个单元包含:标题、问题特征、内容要点、原文指针、版本号、校验规则、禁止事项。 - 执行层:接收问题后先做路由匹配,再按依赖关系加载知识单元,最后生成回答并附来源。执行层里还有安全过滤,确保输出不夹带原文未授权片段。 关键设计是“指针 + 摘要 + 校验规则”代替“全文复制”。知识包里不存整章原文,只存最小要点和原文路径。这样即使知识包被误发出去,也不会直接泄露全书。 ## 05、实战 我拿一本团队有权内部使用的《高并发系统运维手册》做了实验。这本手册约 820 页,43 万字,有 12 个正文章节和 5 个附录。构建过程如下: 1. 先只用目录生成索引:把每个二级标题、三级标题、表格标题、代码块标题抽出来,形成 YAML 索引文件。 2. 对每个章节生成 3 到 5 条问题路由。比如“线程池最大线程数怎么设置”路由到 06-2、12-4、附录 B-3。 3. 给每个知识单元写校验规则。比如“如果连接池 maxActive 大于线程池最大线程数 × 2,则提示可能排队不够”。 4. 人工检查所有跨章节冲突,给冲突条目加优先级。比如“以第九章网关参数的 2025 年修订版为准,灰度发布时先调超时再调熔断”。 5. 本地运行一个最小执行链路,只允许加载知识单元索引,不上传原文。 然后我提了三个跨章节问题: 问题一:“第六章推荐的线程池最大线程数为 CPU 核数 × 2,第十二章建议数据库连接池 maxActive 控制在 50 以内,附录 B 的压测结论是否支持把线程池最大线程数调到 400?” 问题二:“第三章说接口超时时间要小于熔断时间,第九章的网关参数却给了一个相反的建议。灰度发布时,应该先调超时还是先调熔断?” 问题三:“如果第七章的限流阈值从 2000 QPS 上调到 5000 QPS,附录 D 的扩容公式是否仍然成立?是否需要重跑第八章的基准测试?” 这三个问题有一个共同点:答案都不在单独某一章里。传统整本加载时,模型要么漏掉附录 B,要么把第三章和第九章的冲突混在一起。使用知识包后,问题一先命中 06-2、12-4、附录 B-3 三个单元;问题二命中 03-2、09-3,以及一个人工标注的“冲突处理规则”单元;问题三命中 07-3、附录 D-1、08-2。三轮问答平均加载约 6000 token,而全册全量加载大约需要 45 万 token 以上。因为答案带出处,复查也容易。 ## 06、洞见 做这套东西的过程中,我最大的感受是:未来的知识管理不会只有检索。RAG 解决的是“从海量文档里找到一段话”,但它不太擅长表达“这段参数必须和那段参数一起看,且以某个版本为准”。稳定方法论更适合直接变成可调用能力。 比如一本数据库参数校验手册,不只应该被问“最大连接数多少合适”,还应该能被发布流水线调起来执行检查:读取候选配置,逐项校验,输出不合规项和修复建议。这个时候,手册就不再是一堆文本,而是一组带输入输出约束的可执行条目。 文档本身可能带来安全风险。外部下载的技术资料、企业规范、甚至 PDF 注释里,都可能夹带恶意指令。构建知识包时,不能把来源文档当作可信指令来执行。必须把“内容”和“操作”分开:内容可以作为参考文本加载;操作必须来自白名单规则。对内部文档也要做来源校验和版本锁定。 版权是另一条红线。自己有阅读权不等于有复制权和公开分发权。知识包最好只存摘要、指针和规则,不存全文;内部多人使用时,通过权限系统控制访问范围。公开分享时,只分享方法和索引结构,不分享受保护内容。 ## 07、行动 如果你也想动手,建议从低风险对象开始:个人技术笔记、内部接口规范、故障复盘手册。不要一上来就挑战 800 页的第三方书籍。 - 第一周,选一本自己有权使用的资料,只做目录和章节索引。 - 第二周,为每个章节写 3 条问题路由,记录哪些问题实际需要跨章节。 - 第三周,补充冲突规则和前置条件,形成最小知识单元。 - 第四周,加入安全基线:来源校验、指令白名单、输出过滤、访问日志。 - 每次使用后记录命中情况和 token 占用,持续迭代。 内部手册优先尝试,因为你们最清楚哪些章节总被反复查,哪些跨章节答案经常出错。 ## 08、小结 长文档知识化,难点从来不是“内容太多”,而是“发现正确内容的成本太高”。把整本书塞给模型,只是把困难后移。先做结构化,再按需加载,才能真正减少上下文浪费。知识包适合技术书、企业规范、内部手册这类低变化、强依赖、高复用的文档。与此同时,安全和版权必须放在构建流程前部,而不是事后补救。 ## 09、链接与概念说明 - 发现成本:在长上下文中定位并加载正确知识所消耗的 token、时间与注意力。 - 知识包:本文将长文档拆解为可加载、可查询、可组合的最小单元集合。 - RAG:检索增强生成,通过检索片段补充上下文,适合事实类问答。 - 提示注入:文档或外部内容中夹带恶意指令,诱使模型执行额外动作。 - 版本锁与哈希校验:确保知识单元指向的原文版本可追溯、可校验。 - 建议延伸阅读:OWASP 大模型应用安全项目(https://owasp.org/www-project-top-10-for-large-language-model-applications/);RAG 相关综述(https://arxiv.org/abs/2005.11401);腾讯云开发者社区(https://cloud.tencent.com/developer)。

优秀的个人博客,低调大师

基于Skills的接口自动化测试|新增知识图谱 + 增量代码生成

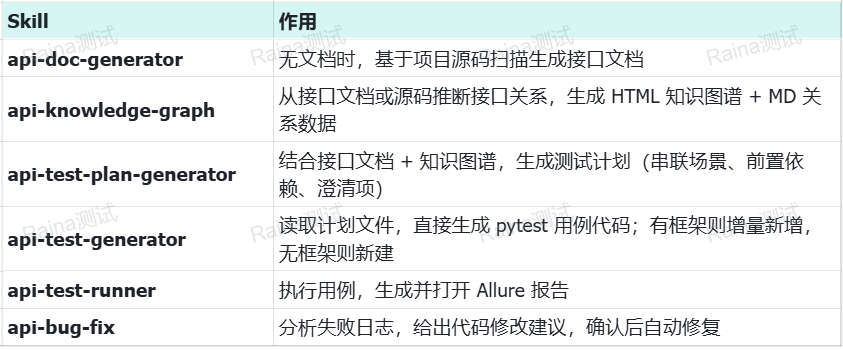
哈喽,我是 Raina~ 之前我们分享过一套 AI 驱动接口自动化 方案:基于 JSON 编排实现接口链路串联,代码框架封装在 Skill 里,比较适合代码基础薄弱、希望快速落地接口自动化的同学。 但在企业真实场景里,还有一类更普遍的需求: > 团队已经有自己搭建好的接口自动化框架,日常以增量方式新增接口用例,而不是每次从零生成一套工程。 这类同学往往不需要 Excel / JSON 编排那一套,而是希望 AI 能直接生成 pytest 用例代码,并且不破坏现有工程结构——在原有框架上「加文件、加用例」就行。 那么,能不能在原有方案基础上,补上「接口依赖可视化 + 增量代码生成」这两块能力? 针对这些新痛点,我AI驱动接口自动化方案做了一次重要升级,今天这篇给大家分享下思路和效果。 ## **一、核心作用:** - ✅ **新增知识图谱 Skill**:把接口依赖关系可视化,同时产出给 AI 读的 Markdown 关系数据 - ✅ **重构生成逻辑**:从 Excel / JSON 读取模式,改为直接生成 pytest 用例代码 - ✅ **新增 Bug 修复 Skill**:执行报错时,把日志丢给 AI,自动分析并给出修复方案 * ## 二、Skill介绍 整套方案现在由 6 个 Skill 串联: ![](https://developer.qcloudimg.com/http-save/audit-11663040/f4ce725beb7327c2d489a94f4ef0f84b.png) 执行流程: ```javascript text 接口文档(已有 / 代码扫描生成) → 知识图谱(HTML 可视化 + MD 关系数据) → 测试计划(md,含串联场景 / 前置依赖 / 待澄清项) → pytest 代码生成(增量写入现有框架 / 无框架则新建) → 执行 & Allure 报告 → (可选)Bug 修复 Skill ``` 以上 Skill 包已整理在【Raina的AI&测试实战圈】,Cursor、Claude Code 等 AI 工具均可导入使用。 * ## 三、案例实践流程 ### 1、生成接口文档(可选) 操作思路和之前方案一样:用 api-doc-generator 读取源码自动生成接口文档。先拉取项目代码到本地,把 Skill 放到项目目录下执行即可。 详细操作可参考往期文章《利用AI辅助接口自动化测试,90% 的人都卡在了第一步》,这里不重复展开。 ### 2、生成知识图谱 支持两种方式,一种是提供接口文档/swagger,第二种直接阅读项目源码进行生成 ### 案例一:基于接口文档进行生成 ![](https://developer.qcloudimg.com/http-save/audit-11663040/74f046aed0f966b44056e59d9a14572f.png) 输出结果 skill 会从接口文档或后端源码推断接口之间的关系,生成一份给人看的 HTML 知识图谱,以及一份给后续 AI 读的 Markdown 关系数据,如下: ![](https://developer.qcloudimg.com/http-save/audit-11663040/92b0a39203e3d207980afcd1c18c2b8f.png) 知识谱图html效果: ![](https://developer.qcloudimg.com/http-save/audit-11663040/efb009fd8085e3f48537ca2e685a7bb6.png) ### 案例二:检索代码生成知识图谱 执行skill ![](https://developer.qcloudimg.com/http-save/audit-11663040/393e5679bcc7c3e381ae6ea7b14692e6.png) 效果如下: ![](https://developer.qcloudimg.com/http-save/audit-11663040/e4044cb33ca1c5b82cb7857278a0217b.png) #### 知识图谱作用: 例如你点击一个工单的接口,它能够看到工单所关联的接口的关系、接口的参数,依赖、契约关系、消费、调用顺序等等。 有了这份接口知识图谱,我们就能快速查询任意接口和其他接口之间的关联关系。 还有一个很关键的用处:可以把图谱提供给 AI,让 AI 掌握接口之间的依赖关联,在接口自动化场景里,快速完成带接口依赖场景的脚本编排。 ![](https://developer.qcloudimg.com/http-save/audit-11663040/e9e4b6065ed17ab3f2fd414d607629ad.png) ## 3、测试计划生成 输入: ![](https://developer.qcloudimg.com/http-save/audit-11663040/f4cc8a57e28eac98a0d14575b5a5477e.png) 发送之后,AI会根据接口文档和知识谱图的内容做分析,并且输出一些问题,让你进行澄清,最后再生成一份计划文档(md文件) #### 生成效果: 第一部分是总览,例如我的这边只需要生成串联的方式,总共就有8条用例 ![](https://developer.qcloudimg.com/http-save/audit-11663040/7140a22484cffaf80bdcb11680b23c06.png) 前置依赖,哪些接口需要抽取出来做复用 ![](https://developer.qcloudimg.com/http-save/audit-11663040/ab8d56dc131269f1427b8068771b2470.png) 串联场景,这里内容太多,我就不全部都截图出来了 重点是看它的步骤,例如这个案例,从新增、查询、修改都进行了串联,且参数也进行了传递 ![](https://developer.qcloudimg.com/http-save/audit-11663040/f0f882287866c180e6d6ca73c1854aec.png) ## 4、代码生成 输入: ![](https://developer.qcloudimg.com/http-save/audit-11663040/d4c1cd17a352aa22dc86a2bbc073467e.png) 发送指令后,AI 会先检测当前工作区是否存在接口自动化代码框架: - 已有框架:自动分析现有项目结构,**在原有框架基础上新增代码**,不破坏原有工程 - 无框架:自动新建 `tests` 目录,直接生成全套自动化代码 默认会使用预设代码结构;如果有定制化需求,可以修改 Skill 内的模板结构 ![](https://developer.qcloudimg.com/http-save/audit-11663040/055d8b918289f5bb615843856ad0dad9.png) ## 5、代码执行&报告查看 执行代码 ![](https://developer.qcloudimg.com/http-save/audit-11663040/50d004060765d8834f1a94cfef97b726.png) 执行结果如下: ![](https://developer.qcloudimg.com/http-save/audit-11663040/187f1a6a7777fc65b2baaaa565dc1bc4.png) 且默认会启动allure报告,可以看到内部的操作逻辑和执行日志 ![](https://developer.qcloudimg.com/http-save/audit-11663040/3fe82d4063292d339a22fad6830477cb.png) ## 6、bug 修复skill 这里也提供了一个bug修复skill ![](https://developer.qcloudimg.com/http-save/audit-11663040/28cc97c151fc8cb20c48226db04570c0.png) 执行过程中如果出现报错,你可以直接把失败日志复制给 AI。AI 会分析报错原因,给出对应的代码修改建议;等你确认方案后,再对问题进行修复。 这里就不单独演示案例了,大家遇到 bug 可以直接上手实操体验这个 Skill。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册