首页 文章 精选 留言 我的

精选列表

搜索[Skills],共2403篇文章
优秀的个人博客,低调大师

《WorkBuddy Skills 实战》第11招 线上错误直接回源码

## 01、痛点 周末凌晨两点,告警群里突然弹出一条:支付服务错误率从 0.5% 跳到 3.2%。我迷迷糊糊打开监控面板,看到几条堆栈,第一反应是「本地跑一下」。可把代码拉下来后,环境变量对不上,依赖版本不一致,连用户触发的那条参数路径都模拟不出来。我是老李。这类场景我相信很多后端和运维都遇到过:线上出了错误,可我们手里的信息只有一张报警截图,真正要定位时,测试环境和生产之间隔着一层厚厚的纱。开发阶段的测试只能证明「代码在预设条件下能跑」,但真实用户带来的流量、数据分布和外部依赖,是任何预发环境都很难完全复刻的。结果就是,错误率上升后,团队要么靠猜,要么花大量时间翻日志、问用户、开遥远的调试会话。开发闭环在「生产反馈」这一步断了。这个断点不补上,后面再多的自动化测试和代码评审,也只能覆盖你提前想到的问题,覆盖不了用户实际踩到的坑。 ## 02、是什么 Sentry 是一个错误监控与性能追踪平台,它在应用里埋一个 SDK,生产环境一旦抛出异常,SDK 会采集错误类型、消息、堆栈、页面路径、用户标识、版本号、标签等信息,发送到 Sentry 服务端。服务端会按错误指纹把同一类错误聚合为一个 Issue,里面包含多次发生的 Event。每个 Event 就是一次具体发生的错误,带有时间、环境、设备、操作记录等上下文。Sentry 还有一个很关键的能力:它能把这些生产 Issue、Event 和错误上下文开放给研发侧的查询工具。于是我们可以做一件事:不再只盯着报警面板,而是直接从 Issue 出发,回到源码里看对应文件和行号。这个「从生产错误回到源码分析」的能力,就是本文要说的核心。它不是替代 CI,而是补上 CI 后面的空白。CI 在合并代码前回答「能不能构建、单测过不过」,而 Sentry 回答「用户真实运行时发生了什么」。两者不是二选一,而是前后两段路。有了 Sentry 以后,我们看到的不是一句「500 错误」,而是一条完整的证据链:哪个版本、哪个路径、哪个用户、在什么操作后、触发了哪个异常,堆栈指向哪一行。 ## 03、为什么 开发完成并不意味着反馈结束。我们写代码的时候,脑子里想的是理想路径、正常参数、合理时序。但生产环境不是这样。用户会输入很长的昵称,会连续双击按钮,会在弱网下重试,会在 A/B 测试里走到你没想到的分支。这些行为只有在真实运行时才会暴露出来。所以,生产可观测性不是「锦上添花」,而是开发闭环最后、也是最真实的一环。CI 告诉我们代码能不能过门禁,Sentry 告诉我们用户真实使用时发生了什么。二者的信息价值完全不同:一个来自机器预测的测试用例,一个来自真实世界的运行结果。很多时候,线上错误的根因并不在报错的那一行,而在更上游的状态变化。如果只看测试报告,我们根本意识不到需要回放用户路径。Sentry 的事件上下文,比如面包屑、请求头、标签和自定义参数,能帮我们重建「用户当时做了什么」。这就是为什么现在要讲:不少团队已经有 CI、有测试、甚至有完善的发布流水线,但上线后仍然靠用户反馈来发现问题,节奏慢、损失大。如果我们把生产观测主动接入日常分析,就能把发现和定位的周期从「天」缩短到「小时」甚至「分钟」。 ## 04、架构 整体上分成四层:采集层、聚合层、查询层、分析层。采集层由应用内的 SDK 完成,负责捕获异常,并把错误上下文发给 Sentry。聚合层在 Sentry 服务端,按指纹聚类生成 Issue,同时保留每一次 Event 的细节。查询层通常是一套 API 和只读令牌,研发侧工具可以通过它拉取最近 24 小时或指定时间范围的 Issue 列表、Top Issue、堆栈、影响版本、影响用户数等。分析层则是本地开发环境或诊断脚本,把堆栈中的文件路径、行号和版本信息,对应到源码仓库的具体提交。数据流很简单:用户操作触发异常 → SDK 上报 → Sentry 聚合为 Issue → 查询工具拉取 → 回到源码分析。需要特别强调的是权限边界。生产观测应当优先采用只读模式。也就是说,查询工具只读取 Issue 和 Event,不直接修改生产配置、不自动发公告、不自动回滚。自动观测和自动修改生产是两个风险等级:前者是「看」,后者是「动手」。看错了还在可接受范围,动错了可能直接扩大故障。所以我在公司里坚持:生产相关的自动化先做只读,把证据链完整地拉回来供人判断,等确认根因后再走发布流程修改。Sentry 的 API 支持细粒度令牌,建议只给查询权限,关闭所有写权限。这既降低误操作风险,也方便审计。 ## 05、实战 上周我们遇到一个真实案例。支付服务上线新版本后,错误率从 0.6% 升到 2.8%。我打开 Sentry,选择支付服务项目,时间范围切到最近 24 小时。面板上 Top Issue 是一个 NullPointerException,影响用户 3000 多个,错误集中在 /checkout 路径。继续点进 Issue 详情,堆栈指向 OrderService 的 142 行,看起来是优惠券对象为空导致。影响版本显示只在 v2.3.1 出现,上一版本没有。我把这个「release : v2.3.1」和「transaction : /checkout」记录下来。接着回到本地,切到对应提交。为了快速复现,我用 diagnosing-bugs 这个诊断脚本,把堆栈里出现的变量名、请求参数和用户标签喂进去,构造了一个空优惠券的请求。果然,本地服务在同样位置抛出了同样的异常。再看代码,发现问题出在昨天改的优惠券预加载逻辑:当用户从历史订单进入结算页时,优惠券信息可能还没有加载完成,Map 里取不到就返回了 null。定位后修掉,先在测试环境验证,再走发布。上线后继续看 Sentry,错误率回落到 0.7%,该 Issue 也不再增长。整个过程不到两小时。这个例子的关键不是工具多复杂,而是我们把生产 Issue、Event 和源码连了起来,没有靠猜。 ## 06、洞见 经过这次和之前多次线上错误排查,我最大的感受是:生产环境不是测试环境的放大版,而是用户行为的实时采样。测试用例是人写的,生产流量是用户创造的。人写的用例有边界,用户的动作没有边界。所以,任何想在测试环境穷尽线上问题的想法,本质上是徒劳。我们能做的,是让生产环境自己说话。Sentry 的价值就在于它把用户真实运行时发生了什么,用结构化的方式记录下来。堆栈、标签、面包屑、版本号,这些数据不是日志里的流水账,而是可以反向关联到源码的证据链。另一个洞见是:自动观测可以激进,自动修改必须保守。因为读取生产数据不会直接伤害生产,但自动修改生产可能带来次生故障。即使以后有了更聪明的自动化决策,也需要保留「人最终按下按钮」这个环节。生产的风险不是一条线,而是一张网。观测是网外的眼睛,修改是网内的手。眼睛可以多角度观察,手却不能乱伸。最后,开发闭环真正的终点不是代码合并,而是用户使用一段时间后没有产生新的严重错误。CI 只能证明过去的假设,Sentry 才能验证用户当下的运行结果。 ## 07、行动 如果你有线上服务,我建议现在就接入 Sentry,没有线上服务或者只是个人玩具项目,可以跳过,不用为了用而用。接入路径不复杂:第一步,在应用里初始化 SDK,配置 DSN、环境名和 release 标识。第二步,上传 Source Map,让堆栈从压缩后的行列号还原成源码对应位置。第三步,设置告警规则,比如错误率超过 2% 或影响用户数超过 200 就通知。第四步,创建只读 API Token,供本地查询工具使用。第五步,每天花 20 分钟看一遍 Top Issue,优先处理核心路径和付费用户相关的错误。第六步,遇到难复现的问题,配合 diagnosing-bugs 诊断脚本,把堆栈和上下文转成最小复现用例。不要一上来就搞自动化修改生产。先从只读查询开始,把证据链跑通。等团队熟悉了生产错误数据,再逐步延伸到性能分析、版本对比、用户路径回放。记住,生产观测的目的是缩短「发现-定位-修复-验证」的周期,而不是增加新的风险点。 ## 08、小结 上线后错误率上升不可怕,可怕的是没有反馈链路。Sentry 让生产 Issue、Event 和错误上下文回到源码分析,补上了开发闭环最后的一环。我们从痛点开始,看到测试和生产的差距;理解了 Sentry 是什么,它提供的不是简单报警,而是结构化的运行时证据;明白了为什么 CI 之外还需要生产可观测性;梳理了采集、聚合、查询、分析的四层架构;又通过一个支付服务错误率排查的实战,看到了从 Top Issue 到 Stack Trace 再到本地复现的完整路径。洞见部分的核心只有两句:生产环境是用户行为的实时采样;自动观测可以激进,自动修改必须保守。最后,行动清单也很简单:有线上服务就接入,没线上服务可以跳过。接入了就坚持看 Top Issue,把生产反馈当成日常开发的一部分。 ## 09、链接与概念说明 Sentry:开源的错误监控和性能追踪平台,支持多种语言 SDK。Issue:Sentry 中聚合后的错误组,同一类错误只会出现一个 Issue。Event:一次具体的错误发生记录,带有详细上下文。Stack Trace:错误发生时的调用栈,能定位到源码文件和行号。Error Rate:错误率,通常指错误请求数占总请求数的比例。Release:发布版本标识,用于对比哪个版本引入了错误。Breadcrumb:面包屑,记录错误发生前的用户操作和系统事件。Source Map:源码映射文件,能把压缩后的堆栈还原为源码位置。DSN:数据源名称,应用 SDK 上报数据的入口地址。只读令牌:仅允许查询、不允许修改的 API Token。诊断脚本 diagnosing-bugs:用于根据堆栈和上下文构造最小复现用例的本地工具。更多资料可以查看 Sentry 官方文档、各语言 SDK 接入指南,以及社区维护的源码映射上传方案。

优秀的个人博客,低调大师

《WorkBuddy Skills 实战》第16招 最近30天先问它

## 01、痛点 我是老李。最近团队在做技术选型调研,题目听起来很具体:最近一个月,智能体执行框架到底怎么发展?大家最近怎么用 WorkBuddy?我一开始没当回事,打开搜索引擎敲了几个关键词,结果第一页全是半年前的文章,还有两篇是去年的教程。点进去一看,功能名字都对不上。 后来我加上了“最近一个月”这些词,结果更让人头疼。有的平台不支持精确时间筛选;有的虽然支持,但只是按网页发布时间倒序,根本不管内容是不是真正反映了最近变化。更麻烦的是,社区里明明已经有人在讨论新功能和风险,普通搜索却几乎看不到。我浪费了半天,最后得出一个可能完全错误的结论:最近没什么值得关注的东西。 这就是痛点:研究最近一个月的话题、工具、人物和社区趋势时,普通搜索的排序逻辑是相关性和历史权重优先,它默认你要找的是相对稳定的知识。可最近30天的变化,恰恰是那些还没被沉淀、还没被搜索引擎加权的新信号。你搜得越多,越容易被旧信息带偏。 ## 02、是什么 last30days 是我给自己和团队定的一套研究方法。它不是一个单独的搜索框,而是一个组合策略。核心就一句话:研究最近一个月的话题、工具、人物和社区趋势时,不能只靠静态搜索,要把时间新鲜度、来源可信度和社区信号当成三个独立维度来排序。 时间新鲜度不是简单按时间倒序。很多时候一篇文章虽然是昨天发的,但内容只是把半年前的官方文档抄了一遍,这种信息时间上“新”,内容上并不新。last30days 里的时间维度,是指信息是否真正反映了最近30天内的变化,比如有没有提到新版本号、新功能名、新发布说明或新代码提交。 来源可信度是第二个维度。官方代码仓库的 release 页面、核心维护者发布的变更说明、官方文档站点,这些是一手来源,可信度最高;技术媒体、专业博客、经过验证的教程属于二手来源,可以参考;匿名转述、聊天截图、没有链接的“听说”,可信度最低,只能作为线索。 社区信号是第三个维度。讨论量、点赞、收藏、转发、复现报告、反对声音,这些都算社区信号。它的作用是帮助你发现哪些话题正在升温,但它不能单独作为事实依据。社区热度可能因为一次营销活动突然拉高,也可能因为某个标题党被大量转发,真相未必如此。 所以 last30days 的完整定义就是:在研究最近一个月变化时,把时间新鲜度、来源可信度、社区信号作为独立维度参与排序,最终用官方资料验证关键结论。 ## 03、为什么 为什么要这么麻烦?因为模型训练知识天然滞后。大模型能告诉你的,往往是训练截止日期之前已经沉淀下来的内容。最近一个月的新版本、新工具、新问题,模型不一定知道,或者只能给出过时答案。如果你问的是稳定概念,普通搜索没问题;但问题是,我们越来越多地需要判断“最近发生了什么变化”。 以 WorkBuddy 为例。假如上个月官方仓库合并了一个批量任务执行功能,文档只更新了一半,社区里有人分享了绕过限制的用法,同时有人指出权限控制有风险。这些信号都发生在最近30天。静态搜索找不到它们,大模型也不会主动告诉你。普通搜索可能返回三个月前的“新功能”教程,反而把你引到老版本上。 社区信号为什么重要?因为真正的前沿变化,往往先在社区出现。一个工具好不好用,一个版本有没有坑,官方文档可能要等几周才更新,但社区讨论可能第二天就出现了。只看官方资料会滞后,只看社区又容易被热度误导。所以必须把社区信号和时间、来源一起用。 还有一点:社区热度不等于事实。一个帖子点赞很多,可能只是观点犀利,不代表方案可用;一个工具突然有很多讨论,可能只是媒体集中报道,不代表它在生产环境里真的稳定。last30days 强调回官方验证,就是为了防止把热度当结论。 ## 04、架构 我把这套方法拆成五步。 第一步,确定主题和时间窗口。所有查询都显式限定最近30天,而不是依赖搜索引擎默认排序。可以把主题拆成子主题,比如“WorkBuddy 版本发布”“WorkBuddy 社区讨论”“WorkBuddy 与其他工具的对比”,分别设定最近30天。 第二步,多源采集。至少覆盖五类来源:官方代码仓库、文档站点、发布说明、技术社区和专业媒体,有时间再看社交平台和技术群聊。采集时记录每一条信息的发布时间、来源类型和链接。 第三步,独立打分。每条信息分别标注时间新鲜度、来源可信度、社区信号三个分数。时间新鲜度看是否在30天内产生或更新,是否提到具体新版本或新功能;来源可信度可以分官方一手、可信二手、匿名转述三档;社区信号看讨论量、复现报告、点赞收藏和反对声音。三档打分可以简单用高、中、低。 第四步,证据抽取。只保留能指向具体版本、具体功能、具体链接或具体复现步骤的信息。没有链接、没有版本号、没有复现步骤的“据说”,只能作为进一步排查的线索,不能进入证据池。 第五步,人工验证。形成初步趋势判断后,回到官方发布说明、代码提交记录和文档变更记录做最终确认。只有官方一手资料确认过的结论,才能写进研究结果。 流程可以用一句话表示:主题 → 时间窗口30天 → 多源采集 → 三维打分 → 证据抽取 → 官方验证。 这套架构不依赖任何特定工具,用表格和文档就能手动跑起来。关键是每个维度独立,不能混在一起模糊判断。 ## 05、实战 拿 WorkBuddy 举例。普通搜索:我输入“WorkBuddy 最新用法”,结果第一页有一条三个月前的教程,标题里写着“新功能上线”,实际上讲的是老版本。第二条是新闻稿,发布时间是上个月,但内容只是转载官网介绍,没有任何社区反馈。我把发布时间筛选到最近一个月,结果只剩下四条,其中两条是无关页面。整体看下来,我得出的结论是:最近没什么新东西。 换 last30days 方法。我先把查询分解成几个子主题:WorkBuddy 版本发布、WorkBuddy 社区讨论、WorkBuddy 与其他工具的对比。然后限制最近30天,分别去官方仓库的 release 页面、issues 列表、技术社区热榜、专业媒体和社交平台采集。 结果发现,官方仓库上个月合并了一个批量任务执行的功能,但文档只更新了一半;技术社区里有人分享了如何在现有项目里绕开限制调用这个功能,讨论热度很高,同时有两条回复指出这种用法在权限控制上有风险。这些信号普通搜索完全看不到。最后我回到官方 issue 和提交记录,确认批量任务功能确实已合并,但权限控制还在开发分支,没有进稳定版。 对比非常明显。普通搜索给我的是旧信息和“最近没什么变化”的错误印象;last30days 让我看到三个层次:官方已经合入但未完全文档化、社区已经在实验但存在风险、稳定版暂时不可用。这不是简单的结果差异,而是判断依据完全不同。 另一个例子是调研“最近一个月智能体执行框架怎么发展”。普通搜索会给你一堆半年或一年前的综述,而 last30days 会发现最近有两三个框架在快速迭代,某个曾经热门的框架反而停滞了。这种趋势判断,只有时间窗口和社区信号同时参与才能看清。 ## 06、洞见 很多人以为“会搜索”就是研究。其实真正的差距不在搜索词,而在排序逻辑。last30days 让我意识到,研究最近一个月的技术趋势,本质上不是找资料,而是做信号排序。时间、来源、证据、社区信号四个要素必须同时出现。 时间保证看到的是最新变化。来源保证信息不是编造。证据保证结论能落地。社区信号能帮你发现趋势,但社区热度不能当证据。热度会骗人,一个只有点赞没有复现的方案,很可能只是营销。 真正的研究智能体,不只是搜索,而是时间、来源、证据、社区信号的组合排序。这个排序必须可解释,每一步都有明确的输入和输出。不能只给一句“最近很火”,而要能指出火在哪里、谁在讨论、证据是什么、官方是否确认。 这也解释了为什么很多静态搜索做得再好,也替代不了专门针对近期的研究方法。静态搜索默认知识是稳定的,而近期研究要处理的是还不稳定的、正在形成中的信号。两类问题需要不同的判断标准。 ## 07、行动 建议所有带“最新、近期、最近30天”字样的研究任务,先跑 last30days,再回官方验证。具体可以这么做。 第一,建一个自己的最近30天研究模板,里面固定包含时间窗口、来源清单、打分表、证据记录和验证结论五个部分。每次调研都套用,避免遗漏维度。 第二,把官方代码仓库、文档站点、发布说明、核心维护者社交账号放进信任来源。看到任何二手转述,先标记为“待验证”。 第三,每次看到社区热度,无论点赞多高,先记下链接和讨论量,不要直接写进结论。等官方资料确认后再升级为事实。 第四,最后一定回到官方变更记录或文档确认。没有官方确认的“新功能”,只能写为“社区讨论中,未确认”。 适用场景包括:调研新工具、评估版本升级、判断某个技术热点的真伪、寻找替代方案、观察某个方向的竞争格局。凡是时间敏感的决策,都值得先跑一遍 last30days。 ## 08、小结 last30days 解决了最近30天趋势研究里的三个问题:旧信息干扰、热度信息失真、结论缺乏证据。它不复杂,核心是时间、来源、证据、社区信号四个维度组合排序。普通搜索适合查稳定知识,研究近期变化必须换一套方法。 真正能帮你做判断的,从来不是搜得快,而是排序准、证据硬。下次再遇到“最近一个月”之类的题目,先别急着敲关键词,先想想四个维度,再跑研究流程。 ## 09、链接与概念说明 Recency,也就是时间新鲜度,指信息产生或更新时间是否在最近30天内,是否反映了最新状态。不能只看网页发布时间,要看内容是否实质更新。 来源可信度,指信息发布方的官方程度和一手程度。官方发布说明、代码提交记录可信度最高,匿名转述最低。 社区信号,指讨论量、复现报告、点赞收藏、反对声音等。用于发现热度,但不能直接作为事实依据。 官方验证,指回到官方发布说明、文档、代码提交记录等一手资料确认关键结论。 last30days,本文所述研究方法,用于研究最近一个月的话题、工具、人物和社区趋势。可以用 RSS、GitHub Watch、技术社区热榜等工具辅助实现,也可以手动用表格完成。 建议进一步阅读时,优先选择官方变更记录和技术社区里有复现报告的内容,不要只收藏点赞高的帖子。

优秀的个人博客,低调大师

腾讯云OCR × WorkBuddy:发票批量报销自动化 Skills实践

财务部小红姐姐一脸愁容,边工作边给我抱怨道,真是服了,报销不早点弄,乱七八遭的发票,一搞这么多,哎~。 我偷偷看了一下她的桌面上:有几十封邮件,估计有上百张发票照片。 小红姐姐一边对着屏幕敲着数字,一边抱怨着但还是认真的干着。 突然,小红姐姐跑到我面前问道:“小草小草 ,上个月你给我弄的那个什么统计的skill,挺好用的,你能不能给我弄个扫描的呢”。 ## 1、拆解报销审核的三大痛点 ### 痛点1: 发票量大且乱七八糟 一般月度报销 100~200 张发票那是非常常见的,如果都让人工去打开图片、抄录金额、核对抬头,这样就算一张只花 2~5 分钟,那在月底的时候光录入可能就要半天,运气再不好一点,大家集中批量提交,那真是得加班加到天亮。 ### 痛点2: 各种版式且票种多样 增值税发票有专票、普票、电子票、通行费电子发票等多种的票种,每种票面的版式还可能不太一样,所以提交过来的资料就是五花八门的,比如**文字型 PDF、扫描图片型 PDF、手机翻拍照等 **。 ### 痛点3: 字段口径非常不一 当所有的数据都拿到手之后,真正的坑才刚开始:同一批报销里,有的金额带小数两位、有的又是整数;"价税合计"有的是写的小写、有的又是写的大写;还有就是个别的发票可能票面污损了,数字模糊可能看不清了都。 ## 2 基于 WorkBuddy 的演示 基于上述这3个痛点,我基于 WorkBuddy 使用 agentic-doc-parse-and-extract 技能,做了一批差旅报销发票的处理,这发票包括了 PDF 电子票、扫描件、翻拍照三种形态。 ### 2.1 发票报销技能包:`agentic-doc-parse-and-extract` 先说一下这个agentic-doc-parse-and-extract 技能,ADP 国内票据抽取**自动分类 + 全量抽取**一次完成,覆盖 **32 种常见票据类型**,其中 **11 种支持税局验真**(抽取的同时自动向**国家税务总局全国增值税发票查验平台**发起验真请求,结果以 `fpVerification` / `fpVerificationMsg` / `fpIsVoided` 三个字段直接返回在同一个 JSON 中,**无需二次调用,无需自行对接税局接口**)。 #### 那么如何如何使用? 首先我们需要确认技能已启用,在 WorkBuddy 等平台导入 `agentic-doc-parse-and-extract` 技能,可以直接使用提示词进行安装。 **配置腾讯云密钥** 在环境变量中设置: ```javascript export TENCENTCLOUD_SECRET_ID="你的SecretId" export TENCENTCLOUD_SECRET_KEY="你的SecretKey" ``` 密钥申请:[腾讯云 API 密钥管理](https://console.cloud.tencent.com/cam/capi)  OCR 服务购买:[腾讯云文字识别 OCR](https://buy.cloud.tencent.com/iai_ocr) 前置条件都有了后,我们只需要在WorkBuddy中,上传发票文件,并发送提示词:帮我把本地文件夹***内的票据识别并报销汇总。 我们加载的技能就会自动触发完整的流水线来进行操作了,下面可以看一下。 #### Step 1: 识别发票 当我们发送命令后后,WorkBuddy 自动进入处理流水线,首先这会对图片做方向归一化与清晰度的检测,然后再对多张发票**调用**腾讯云发票 OCR: 我们可以看到一些步骤: **1、**自动识别票种(专票/普票/电子票),对倾斜、翻转图片做方向归一化,PDF 自动抽取首页转图; **2、**发票进行 OCR识别,可以将全部字段(发票号码、金额、税额、价税合计、购销方等)结构化提取出来。 #### 3、全流程自动执行 整个 `agentic-doc-parse-and-extract`技能流水线包含以下的一些步骤,自动串联执行: |步骤|动作|结果摘要| | --- | --- | --- | |Step 0|发票预处理|全部通过清晰度检测,1 张翻拍照自动纠偏| |Step 1|OCR 并行识别|全部识别成功,提取发票全字段| |Step 2|字段标准化|金额/税额统一为两位小数,价税合计统一小写口径| |Step 3|汇总输出|自动生成报销汇总 Excel 与校验报告| #### 4、 输出报销单与汇总报告 技能最终输出标准化的报销汇总,包含报告元信息、逐票明细、汇总结果等。 以下为一个明细的输出json: ```javascript [ { "field_key": "vat_electronic_invoice_new", "field_name": "电子发票(普通发票)", "object_values": [ { "document_type": "vat_electronic_invoice_new", "pages": [0], "extraction_result": [ { "field_key": "vat_invoice_haoma_right_side", "field_name": "发票号码", "field_values": [{ "field_value": "254320000000********", "field_confidence": 0.99, "references": [] }] }, { "field_key": "vat_invoice_issue_date_print", "field_name": "开票日期", "field_values": [{ "field_value": "2025-04-16", "field_confidence": 0.99, "references": [] }] }, // ... 约 30 个普通字段(详见 examples/vat-electronic-invoice-new.json) { "field_key": "goods", "field_name": "项目详情", "table_values": [[ /* 8 个明细子字段 */ ]] }, { "field_key": "fpVerification", "field_name": "查验结果", "field_values": [{ "field_value": "查验成功发票一致", "confidence": 1.0 }] }, { "field_key": "fpVerificationMsg", "field_name": "查验报错信息", "field_values": [{ "field_value": "", "confidence": 1.0 }] }, { "field_key": "fpIsVoided", "field_name": "作废标志", "field_values": [{ "field_value": "N", "confidence": 1.0 }] } ], "metadata": { "confidence": 1.0 } } ] } ] ``` ## 3、OCR × Skill 封装 ### 3.1 腾讯云增值税发票识别 这个技能的核心是 OCR 能力,主要是采用了腾讯云 **VatInvoiceOCR**(增值税发票识别)接口: - **全票种支持**:增值税专用发票、普通发票、电子发票、通行费电子发票等,全字段返回(发票代码/号码、开票日期、金额、税额、价税合计、购销方信息、税率等); - **高精度**:票面字段识别准确率 >97%,远超手工录入; - **多形态兼容**:支持文字型 PDF、扫描图片型 PDF、手机翻拍照; - **结构化输出**:返回 JSON 字段级数据。 ### 3.2 Skill 封装的增值能力 在原有的 OCR API 基础上,`agentic-doc-parse-and-extract`技能还额外增加了以下的一些能力: |能力|说明| | --- | --- | |票种自动识别|根据票面特征自动判定专票/普票/电子票,选择对应解析路径| |图片预处理|方向归一化、纠偏、清晰度检测,翻拍照也能稳定识别| |字段标准化|将金额、税额统一为两位小数,价税合计统一小写口径| |勾稽规则引擎|内置五类校验规则:价税勾稽、税率、抬头、时间、重复票| |异常分级输出|区分" 通过"与" 需人工复核",报告简洁高效| |批量并行识别|多线程并发调用 OCR,10 张发票秒级完成| |汇总自动生成|**全球发票/收据抽取**自动识别并抽取发票号码、日期、金额、税费、明细等 10+ 关键字段,支持多语言和多币种发票抽取跨国结算账款自动化、费用报销管理**国内票据抽取**识别增值税发票、出租车票、火车票、飞机行程单、财政发票等30+常见票据,支持多页/多票识别及验真国内票据识别、国内发票验真**订单抽取**支持多种采购订单格式,抽取订单号、商品、数量、价格、物流信息等采购自动化、供应链集成**更多卡证抽取**ADP支持身份证、港澳台通行证、中国护照、银行卡、户口本、驾驶证、行驶证、车辆合格证、开户许可证、营业执照等 11 种中国常用证件开户审核、合规检查、证件信息批量录入**文档解析**将 PDF、图片、Office 文档转化为结构化数据,保留排版和层级关系长文档分析、合同审查、知识提取**自定义抽取**自主创建抽取应用,配置专属字段和识别逻辑,满足非标单据需求企业专属表单、行业定制单据| 当前skill也提供CLI 工具,一条命令即可完成各类票据图片/扫描件/PDF 的结构化字段抽取,输出标准 JSON。 总的来说,通过workbuddy结合skill,就可以完美的解决发票报销等自动化提取,在简单封装一下就可以生成 一个完美的工具了。
优秀的个人博客,低调大师

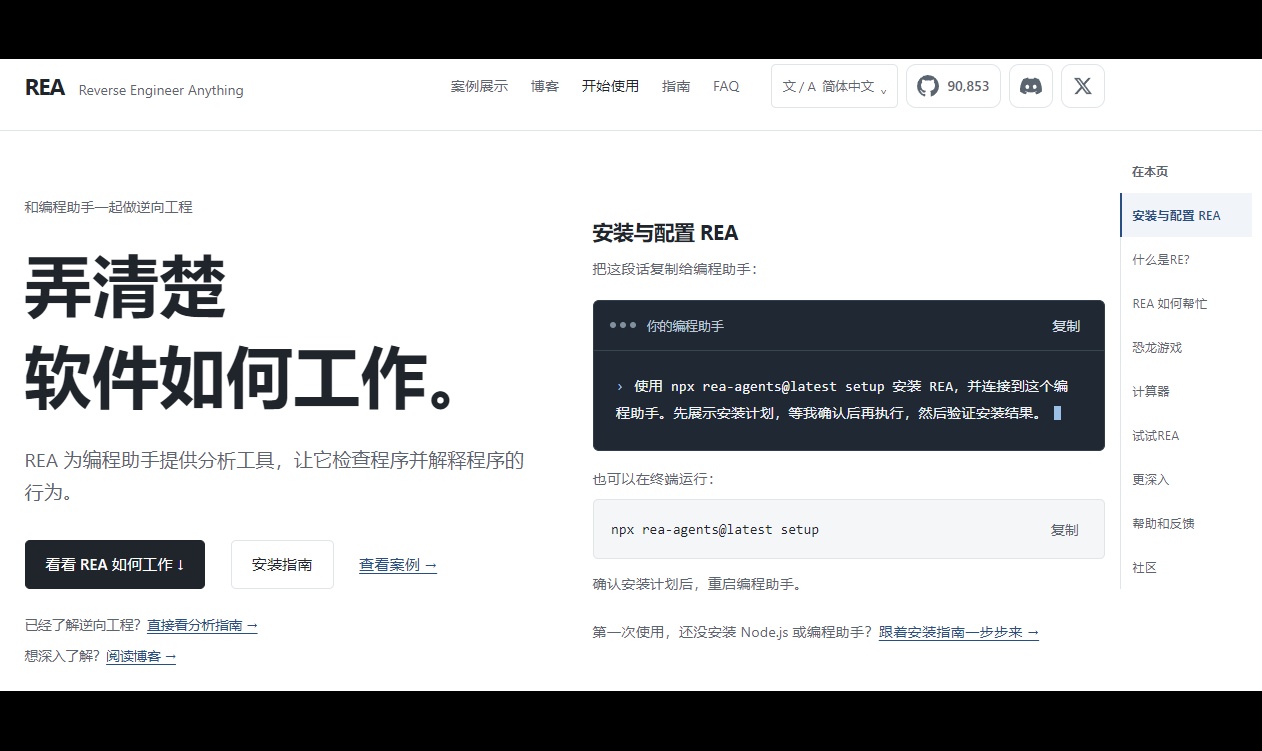
新skills:REA 给 AI Agent 装上一双“逆向之眼”

全文为解析该开源项目: [morluto/rea](https://github.com/morluto/rea) 官网:https://rea.tools/zh-CN/ ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-1051732/a5a053a1009d524308fabfc31ad09acf.png) ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-1051732/0cf9bdbfcd3d30b79eb0b2d893fb5681.png) ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-1051732/1adcca72fa4c4349146f3dd5dacf97f4.png) > ## 一、 TL;DR > 个人感觉 REA (Reverse Engineer Anything) 并不是那种常见的工具脚本,它更像是一个专门为 AI 准备的**“逆向工程操作系统”**。 > - **一句话定义**:通过 MCP 协议,让 AI 直接接管 Hopper、Ghidra 等顶级逆向引擎。 > - **核心逻辑**:不让 AI 靠“蒙”,而是靠“证据”(Evidence)。 > - **技术亮点**:TypeScript 写的核心,配上 Python/Swift 写的各类插件桥接。 > - **个人直观感受**:它把原本属于“大牛”的逆向门槛,直接拉低到了“提问”级别。 ## 二、 AI 逆向的“盲区”:光有脑子没手脚 以前让 AI 帮我分析二进制文件,它就像个**“读了万卷书却没出过门”**的书生。 你把文件名丢给它,它能根据名字猜功能;但你问它“这块内存怎么跳的”,它就开始一本正经地胡说八道。 传统的 RAG (检索增强生成) 面对混淆后的代码完全就是“盲人摸象”。 REA 的出现,相当于给 AI 装上了**“手术刀”和“显微镜”**。 “这说明 AI 逆向不再是玩‘文字接龙’,而是实打实地去‘搬砖’找证据。” ## 三、 架构拆解:不搞虚的,直接看它是怎么连的 REA 的架构非常直白,我翻了一下源码,它把复杂的事情分成了三个层次,就像剥洋葱一样: | 层次 | 目录位置 | 负责啥? | | :--- | :--- | :--- | | **心脏 (Domain)** | `src/domain/` | 定义什么是“证据”、什么是“分析目标”。 | | **大脑 (Application)** | `src/application/` | 规划任务,比如“先反编译函数,再看它的调用者”。 | | **四肢 (Providers)** | `src/hopper/`, `src/browser/` | 真正的干活人。去调 Hopper,去钩子浏览器。 | 在我的实战中,这种设计最爽的地方在于: 如果你觉得 Hopper 不好用,想换成 IDA,你只需要在“四肢”层换个接口就行,核心逻辑一点都不用动。 所有的“动作指令”都藏在 [toolContracts.ts](src/contracts/toolContracts.ts:L27) 里,Agent 就是通过这些指令来指挥外界的。 ## 四、 杀手锏:什么叫“证据工程”? REA 最让我服气的一点是它对**“证据”**的洁癖。 在 [evidence.ts](src/domain/evidence.ts:L114) 里,它给 Agent 返回的信息贴了三个标签: - **Observed (我亲眼看到的)**:比如从内存里直接读出来的字符串,最稳。 - **Derived (我算出来的)**:基于几个事实推出来的结论。 - **Inferred (我猜的)**:这就有点玄学了,准确率打个折。 源码里是这么写的(源码位置:[evidence.ts](src/domain/evidence.ts:L103-L121)): ```typescript const evidenceBaseSchema = z.object({ evidence_id: prefixedDigestSchema("ev"), // 每一条证据都有唯一的“指纹” confidence: z.enum(["observed", "derived", "inferred"]), // 靠不靠谱,一眼便知 limitations: z.array(z.string()), // 这里的坑一定要告诉 Agent // ... }); ``` 它甚至会强迫分析引擎说实话:“这段代码加壳了,我看不透”。 “这让 Agent 不再‘迷之自信’,而是学会了在看不清的时候求助。” ## 五、 适配艺术:怎么让那些“老古董”听 AI 的话? ### 1. Hopper 桥接:不打架的“单行道” Hopper 的 API 很傲娇,一次只能干一件事(单线程)。 REA 写了个 Python 桥接脚本 [hopper_bridge.py](bridge/hopper_bridge.py:L1-L6),用 Unix Socket 连起来。 就像是在繁忙的路口架了个红绿灯,让 AI 的指令乖乖排队,不至于把 Hopper 搞死锁。 ### 2. 浏览器分析:静态动态一把抓 现在的应用很多都是套壳的(Electron)。 REA 在 `src/browser/` 里玩了个**“动静结合”**: - 静态:扫你的 `package.json` 看看用了啥包。 - 动态:直接用 CDP (Chrome 调试协议) 监控你的 IPC 通信(进程间通话)。 “这相当于既看了你的简历,又监控了你的工位。” ## 六、 实战踩坑:别说我没提醒你 在我个人用 REA 瞎折腾的这几天里,有几个坑千万别踩: - **Token 烧得飞快**: 别一上来就让 Agent 读几千行的伪代码。 **个人心得**:先让它列个函数清单,像看目录一样,找准那个最可疑的再下手。 - **环境配置的“毒打”**: 尤其是 Ghidra,它对 Java 环境非常挑剔。 **避坑**:如果报错,先检查你的 `JAVA_HOME` 是不是设对路径了。 - **不要完全迷信 AI**: 如果 REA 返回的 `residual_unknowns` (残余未知项) 太多。 **对策**:说明这块地儿太硬,AI 啃不动。这时候得你自己手动开 Hopper 看看了。 ## 七、 总结:逆向也能“人人参与”? 个人感觉,REA 这类项目的意义,在于它打破了逆向工程的“黑盒”。 它把原本需要对着汇编代码死磕好几天的活,变成了一场 Agent 辅助下的“逻辑拼图”。 “谁能更好地利用这双‘逆向之眼’,谁就能在信息透明的时代拿到先机。” --- # 参考文献 1. [REA GitHub 仓库](https://github.com/morluto/rea) 2. [REA 官方展示案例 (Showcases)](https://rea.tools/showcase/) 3. [MCP (Model Context Protocol) 官方文档](https://modelcontextprotocol.io/) 4. [Evidence Engineering for LLM-based Agents](https://blog.hipw.cc/archives/afac2026)

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码