首页 文章 精选 留言 我的

精选列表

搜索[脚本自愈],共10014篇文章
优秀的个人博客,低调大师

vim设置python脚本自动补全

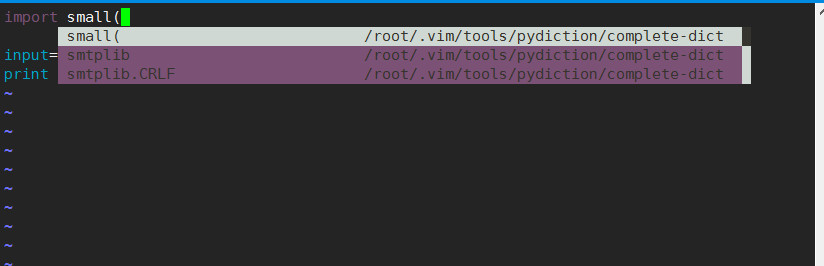
Linux VIM python 自动补全插件:pydiction Pydiction 可以是我们使用Tab键自动补全Python代码在Vim,是一款非常不错的插件。 Pydiction不需要安装,所有没有任何依赖包问题,Pydiction主要包含三个文件。 python_pydiction.vim -- Vim plugin that autocompletes Python code. complete-dict -- Dictionary ``file of Python keywords, modules, etc. pydiction.py -- Python script to add ``more words to complete-dict. 下载Pydiction mkdir ~/.vim mkidr ~/.vim``/bundle cd ~/.vim``/bundle #这里我们也可以自己下载好上传到linux系统中 git clone https:``//github``.com``/rkulla/pydiction``.git 配置Pydiction #- UNIX/LINUX/OSX: Put python_pydiction.vim in ~/.vim/after/ftplugin/ #- WINDOWS: Put python_pydiction.vim in C:\vim\vimfiles\ftplugin\ # Assuming you installed Vim to C:\vim\ cp -r ~/.vim``/bundle/pydiction/after/ ~/.vim 新建.vimrc文件 vim ~/.vimrc 在.vimrc文件添加如下配置: filetype plugin on let g:pydiction_location = ``'~/.vim/tools/pydiction/complete-dict' let g:pydiction_menu_height = 3 到此已经可以使用Tab键自动补全python代码了。 image

优秀的个人博客,低调大师

Robot Framework之python脚本调用

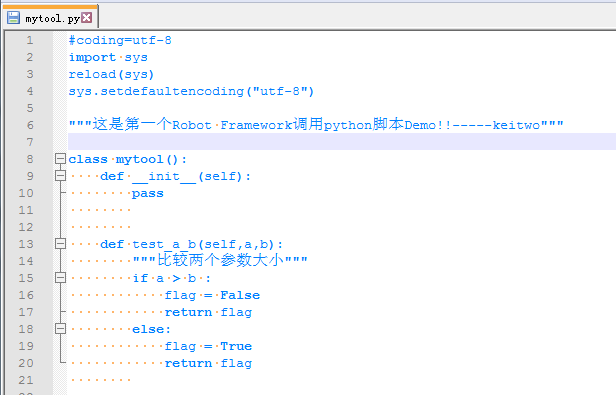
前言 喜欢使用RF的原因之一就是能自己定义关键字,这篇就简单说下如何创建系统关键字,先来个最简单的,求比较两个数的大小 一、建立库文件 假设python的安装路径在D:/下面(作者是放在D:\python\python27) 1、在D:\python\python27\Lib\site-packages\ 建立库文件文件夹 MyLibrary 2、在MyLibrary 内建立 mytool.py 文件和__init__.py 文件 如: 这个文件里面写自己需要穿件的关键字既方法,如下代码里面有一个比较两参数大小的方法,在Robot Framework 里面将以关键字的方式使用 mytool.py 如下模板,注意类名要与库文件夹名称一致 __init__.py 该文件中第一句,是导入deviceDriver.py文件中DeviceDriver类;第二句,创建DeviceDriver的派生类;第三句,把deviceDriver集成到robot framework! 二、在Robot Framework中导入库文件 1、库文件的导入: 选择套件名称,点击右边面包的Library 点击Library 2、点击右边的面板展示 输入库的名称 3.点击OK保存并查看导入的库文件 成功导入库文件 三、导入失败排查分析 1、若是做elenium web自动化测试,我们则需要导入selenium2library,以导入selenium2library为例,在弹窗内填写selenium2library点击OK按钮,RIDE则会自动去python目录下去搜寻库,若是不存在或者库有错,导入则不成功,如下图现在红色 导入失败显示 2、查看错误原因 查看 错误log 四、导入使用库文件 1、导入完成之后,我们可以在Ride中键盘按F5到Search Keywords , source选择我们刚刚导入的库,我们会在面板中看见我们库中所有的方法的介绍 库方法介绍 2、使用关键字 使用关键字 3、运行结果 运行结果 4、report报告: 报告目录 report报告 五、问题总结 以下自己遇到的一些问题的debug 1、尽量在文件的开头加上:# -- coding: utf-8 -- 因为python默认编码是ascii,所以如果代码中有(),或中文等等符号,会报错,提示编码不正确 2、如果写的代码里边有中文,尽量在文件开头加上以下3行代码 import sys reload(sys) sys.setdefaultencoding("utf-8") 3、如果在初始化函数中,定义了形参。则必须在导入库的时候,也要提供对应的参数。 不然会提示少给了变量的报错。 def __init__(self,a,b):pass 4、修改代码后,及时把对应的.pyc文件删除并且重启下robotframework 后,再导入。 5、如果还是有其他的报错,请点击Tools→View RIDE log ,查看并debug。

优秀的个人博客,低调大师

Elasticsearch批量导入数据脚本(python)

#!/usr/local/bin/python2.7 //确定你的python版本 from datetime import datetime from elasticsearch import Elasticsearch import elasticsearch.helpers import random import time es = Elasticsearch( "192.168.76.**:9200" ) //es的地址与端口 metrics = ['business.biz.real.bm.fileCount','business.biz.real.bm.contFailCount','business.biz.real.bm.updateCount','business.biz.real.bm.uInCount', 'business.biz.real.bm.uNotCount','business.biz.real.bm.downTime','business.biz.real.bm.ocrTime','business.biz.real.bm.elleTime', 'business.biz.real.bm.contTime','business.biz.real.bm.updateTime','business.biz.real.bm.contErrCount'] package = [] for i in range( 1 ): for j in metrics: now = datetime.now() timeStamp = time.time() timeNow = datetime.now().strftime("%Y-%m-%dT%H:%M:%S.000Z") row = { "@timestamp": timeNow, "endpoint" : "0"+str(random.randint(0, 9))+"0"+str(random.randint(0, 9))+"0"+str(random.randint(0, 9)), "metric" : j, "step" : 0, "timestamp" : long(timeStamp), "value" : int(1), "tags": "uid"+str(random.randint(0, 10000000)) } package.append( row ) actions = [ { '_op_type': 'index', '_index': "argus", '_type': "ibam_business_dynamic_metadata", '_source': d } for d in package ] elasticsearch.helpers.bulk( es, actions )

优秀的个人博客,低调大师

Python 发送HTML格式邮件脚本

coding: utf-8 import smtplib from email.mime.text import MIMEText #导入MIMEText类 HOST = "smtp.gmail.com" #定义smtp主机 SUBJECT = u"官网流量数据报表" #定义邮件主题 TO = "testmail@qq.com" #定义邮件收件人 FROM = "mymail@gmail.com" #定义邮件发件人 msg = MIMEText(""" #创建一个MIMEText对象,分别指定HTML内容、类型(文本或html)、字 #符编码 <table width="800" border="0" cellspacing="0" cellpadding="4"> <tr> <td bgcolor="#CECFAD" height="20" style="font-size:14px">*官网数据 <a href="monitor.domain.com">更多>></a></td> </tr> <tr> <td bgcolor="#EFEBDE" height="100" style="font-size:13px"> 1)日访问量:<font color=red>152433</font> 访问次数:23651 页面浏览量:45123 点击数:545122 数据流量:504Mb 2)状态码信息 500:105 404:3264 503:214 3)访客浏览器信息 IE:50% firefox:10% chrome:30% other:10% 4)页面信息 /index.php 42153 /view.php 21451 /login.php 5112 </td> </tr> </table>""","html","utf-8") msg['Subject'] = SUBJECT #邮件主题 msg['From']=FROM #邮件发件人,邮件头部可见 msg['To']=TO #邮件收件人,邮件头部可见 try: server = smtplib.SMTP() #创建一个SMTP()对象 server.connect(HOST,"25") #通过connect方法连接smtp主机 server.starttls() #启动安全传输模式 server.login("mymail@gmail.com","mypassword") #邮箱账号登录校验 server.sendmail(FROM, TO, msg.as_string()) #邮件发送 server.quit() #断开smtp连接 print "邮件发送成功!" except Exception, e: print "失败:"+str(e)

优秀的个人博客,低调大师

CentOS下mysql备份脚本(mysqldump)

#!/bin/bash #全备方式,一般在从机上执行,适用于小中型mysql数据库 #删除15天以前备份 #作者:fafu_li #时间:2015.08.10 source /etc/profile #加载系统环境变量 source ~/.bash_profile #加载用户环境变量 set -o nounset #引用未初始化变量时退出 #set -o errexit #执行shell命令遇到错误时退出 user="root" password="123456" host="localhost" port="3306" #需备份的数据库,数组 db=("test") #备份时加锁方式, #MyISAM为锁表--lock-all-tables, #InnoDB为锁行--single-transaction lock="--single-transaction" mysql_path="/usr/local/mysql" backup_path="${mysql_path}/backup" date=$(date +%Y-%m-%d_%H-%M-%S) day=15 backup_log="${mysql_path}/backup.log" #建立备份目录 if [ ! -e $backup_path ];then mkdir -p $backup_path fi #删除以前备份 find $backup_path -type f -mtime +$day -exec rm -rf {} \; > /dev/null 2>&1 echo "开始备份数据库:${db[*]}" #备份并压缩 backup_sql(){ dbname=$1 backup_name="${dbname}_${date}.sql" #-R备份存储过程,函数,触发器 mysqldump -h $host -P $port -u $user -p$password $lock --default-character-set=utf8 --flush-logs -R $dbname > $backup_path/$backup_name if [[ $? == 0 ]];then cd $backup_path tar zcpvf $backup_name.tar.gz $backup_name size=$(du $backup_name.tar.gz -sh | awk '{print $1}') rm -rf $backup_name echo "$date 备份 $dbname($size) 成功 " else cd $backup_path rm -rf $backup_name echo "$date 备份 $dbname 失败 " fi } #循环备份 length=${#db[@]} for (( i = 0; i < $length; i++ )); do backup_sql ${db[$i]} >> $backup_log 2>&1 done echo "备份结束,结果查看 $backup_log" du $backup_path/*$date* -sh | awk '{print "文件:" $2 ",大小:" $1}'

优秀的个人博客,低调大师

简单的hadoop启动脚本

1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 #!/bin/bash #ThenextlinesareforchkconfigonRedHatsystems. #chkconfig:359802 #description:StartsandstopshadoopServer #autor:516249940@qq.com #date:2017-03-06 #ThenextlinesareforchkconfigonSuSEsystems. #/etc/init.d/xxx # ###BEGININITINFO #Provides:xxx #Required-Start:$network$syslog #Required-Stop: #Default-Start:235 #Default-Stop:06 #Short-Description:StartsandstopshadoopServer #Description:StartsandstopshadoopServer ###ENDINITINFO HADOOP_SBIN= "/usr/local/hadoop/sbin" JAVA_ETC= "/etc/alternatives" case $1 in start) $HADOOP_SBIN /start-dfs .sh $HADOOP_SBIN /start-yarn .sh $HADOOP_SBIN /mr-jobhistory-daemon .shstarthistoryserver echo "thehadoopisok" ;; stop) $HADOOP_SBIN /mr-jobhistory-daemon .shstophistoryserver $HADOOP_SBIN /stop-yarn .sh $HADOOP_SBIN /stop-dfs .sh echo "thehadoopisstop" ;; restart|reload|force-reload) $HADOOP_SBIN /mr-jobhistory-daemon .shstophistoryserver $HADOOP_SBIN /stop-yarn .sh $HADOOP_SBIN /stop-dfs .sh echo "thehadoopisstop" sleep 3 $HADOOP_SBIN /start-dfs .sh $HADOOP_SBIN /start-yarn .sh $HADOOP_SBIN /mr-jobhistory-daemon .shstarthistoryserver echo "thehadoopisok" ;; status) #查看状态需要做的步骤 $JAVA_ETC /jps ;; *) echo "$0{start|stop|restart|status}" exit 4 ;; esac 本文转自 yanconggod 51CTO博客,原文链接:http://blog.51cto.com/yanconggod/1903568

优秀的个人博客,低调大师

cloudera manager 5.3完整卸载脚本

service cloudera-scm-agent stop service cloudera-scm-agent stop umount /var/run/cloudera-scm-agent/process umount /var/run/cloudera-scm-agent/process umount /var/run/cloudera-scm-agent/process rm -rf /usr/share/cmf /var/lib/cloudera* /var/cache/yum/x86_64/6/cloudera* /var/log/cloudera* /var/run/cloudera* /etc/cloudera* rpm -qa | grep cloudera for f in `rpm -qa | grep cloudera ` ; do rpm -e ${f} ; done for f in `rpm -qa | grep oracle-j2sdk1.7 ` ; do rpm -e ${f} ; done for f in `rpm -qa | grep enterprise-debuginfo ` ; do rpm -e ${f} ; done rm -rf /var/lib/hadoop-* /var/lib/impala /var/lib/solr /var/lib/zookeeper /var/lib/hue /var/lib/oozie /var/lib/pgsql /var/lib/sqoop2 /data/dfs/ /data/impala/ /data/yarn/ /dfs/ /impala/ /yarn/ /var/run/hadoop-*/ /var/run/hdfs-*/ /usr/bin/hadoop* /usr/bin/zookeeper* /usr/bin/hbase* /usr/bin/hive* /usr/bin/hdfs /usr/bin/mapred /usr/bin/yarn /usr/bin/sqoop* /usr/bin/oozie /etc/hadoop* /etc/zookeeper* /etc/hive* /etc/hue /etc/impala /etc/sqoop* /etc/oozie /etc/hbase* /etc/hcatalog rm -rf ` find /var/lib/alternatives/* ! -name "mta" ! -name "print" ! -name "zlibrary-ui" -mtime -3` rm -rf /etc/alternatives/* for u in hdfs mapred cloudera-scm hbase hue zookeeper oozie hive impala flume; do sudo kill $(ps -u $u -o pid=); done rm -rf /opt/cloudera/parcel-cache /opt/cloudera/parcels

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册