首页 文章 精选 留言 我的

精选列表

搜索[技术极客],共10008篇文章
优秀的个人博客,低调大师

简Mybatis之旅(一):CRUD

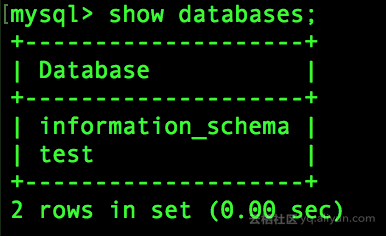
摘要 最近在研究mybatis框架,作为一个优秀ORM框架,mybatis很多优秀的设计思想值得借鉴。 mybatis的配置文件里,主要是config和mapper。config定义了全局参数:数据源类型(POOL, UNPOOLED, JNDI)、事务管理类型(默认为managed)、库url、账户信息和mapper文件路径。 config配置 // config.xml <configuration> <environments default="classfly"> <environment id="classfly"> <transactionManager type="JDBC"/> <dataSource type="POOLED"> <property name="driver" value="com.mysql.jdbc.Driver" /> <property name="url" value="jdbc:mysql://localhost:3306/test?characterEncoding=utf-8" /> <property name="username" value="yourusername" /> <property name="password" value="yourpassword" /> </dataSource> </environment> </environments> <mappers> <mapper resource="mapper/UserMapper.xml" /> </mappers> </configuration> DBNAME='test',是mybatis默认分配的库: mapper配置 首先我们要问自己以下三个问题: 为什么要配置mapper文件? 怎么配置mapper文件? mybatis如何解析mapper文件? mapper文件的作用 mapper文件提供一种持久化层与应用层的"通信协议",通过mysql关键字resultMap, parameterType等维护应用代码DO对象与持久化存储数据之间的关联关系。 mapper文件里定义了select, insert, update, delete四种常用的DML语句,并定义statement={mapper namespace}.{operation}实现在应用代码层执行调用DB操作。 配置mapper文件 这里先给出测试用例用到的mapper配置文件的关键部分: <!-- 代码清单-1 --> <mapper namespace="com.classfly.mapper.UserMapper"> <resultMap id="user" type="pojo.User"> <result column="user_id" property="userId" /> <result column="user_name" property="userName" /> <result column="password" property="password" /> <result column="age" property="age" /> </resultMap> <select id="query" resultMap="user"> SELECT * FROM user; </select> <insert id="insert" parameterType="pojo.User"> insert into user ( user_id, user_name, password, age) values ( #{userId}, #{userName}, #{password}, #{age} ) <selectKey resultType="pojo.User" keyProperty="id" order="AFTER"> select LAST_INSERT_ID() as id </selectKey> </insert> <update id="update" parameterType="pojo.User"> UPDATE user SET user_name = #{userName} , password = #{password} , age = #{age} WHERE user_id = #{userId} </update> <delete id="delete"> DELETE FROM user WHERE user_id = #{userId} </delete> </mapper> mapper namespace定义了DML语句的作用范围,那如果两个不同的mapper文件定义相同的namespace会发生什么?由于mysql保持namespace的全局唯一性,所以在解析mapper文件时mysql会抛异常提示开发者修改mapper文件以保持namespace的全局唯一性。 resultMap resultMap关键字将代码和持久化层的数据映射抽象出来,用户无需关心两者之间如何映射。 我们可以使用HashMap完成代码和持久化层的数据映射关系,不但缺乏通用型且代码层需要将对象转换成map结构。resultMap接受HashMap结构和JavaBean或者POJO对象,提供轻量级的参数映射方案。 resultMap有"别名"的功能,你无需每个DML都写一大串的映射语句,秉着"仅定义一次"的原则,我们可以这么做: // config.xml <typeAlias type="pojo.User" alias="User"/> // 用typeAlias的User别名替换了resultMap中的user <select id="query" resultType="User"> SELECT * FROM user ORDER BY id DESC </select> Now if only the world was always that simple! 当POJO类成员变量并未完全和Table列名"对齐"时,可通过定义resultMap的方式来实现mapper: <resultMap id="user" type="User"> <result property="userId" column="user_id" /> <result property="username" column="user_name"/> <result property="password" column="hashed_password"/> </resultMap> <select id="query" resultMap="user"> SELECT * FROM user ORDER BY id DESC </select> '#'和'$' 从"代码清单-1"里可以看出,#和$均可实现POJO字段和DB表列名的映射关系。#将参数部分用?替换,而$仅根据执行sql时通过POJO对象透传的值进行字符串替换,容易被注入恶意代码,不可取!如: select * from ${tableName} where name = #{name} 如果tableName='user; delete user; --',最终sql语句变为: select * from user; delete user; -- where name = #{name} 导致user整张表数据被删除。 mybatis如何解析mapper文件 To be continued... 测试用例 /** * Created by fujianbo on 2018/4/22. * * @author fujianbo * @date 2018/04/22 */ public class TestMybatis { @Test public void testQuery() { SqlSession sqlSession = buildMySqlEnv("config.xml"); List<User> userList = sqlSession.selectList("com.classfly.mapper.UserMapper.query"); for (User p : userList) { System.out.println(p); } } @Test public void testInsert() { SqlSession sqlSession = buildMySqlEnv("config.xml"); User user = new User(); user.setUserId(124L); user.setAge(26); user.setPassword("test_123"); user.setUserName("芸Rey"); if (sqlSession.insert("com.classfly.mapper.UserMapper.insert", user) > 0) { sqlSession.commit(); } } @Test public void testUpdate() { SqlSession sqlSession = buildMySqlEnv("config.xml"); User user = new User(); user.setUserId(124L); user.setAge(26); user.setUserName("芸Rey"); user.setPassword("test_modified"); if (sqlSession.update("com.classfly.mapper.UserMapper.update", user) > 0) { sqlSession.commit(); } } @Test public void testDelete() { SqlSession sqlSession = buildMySqlEnv("config.xml"); User user = new User(); user.setUserId(123L); if (sqlSession.update("com.classfly.mapper.UserMapper.delete", user) > 0) { sqlSession.commit(); } } private static SqlSession buildMySqlEnv(String resource) { try { return new SqlSessionFactoryBuilder() .build(org.apache.ibatis.io.Resources.getResourceAsStream(resource)) .openSession(); } catch (IOException e) { System.out.printf("Failed to build mysql environment!"); return null; } } } 代码链接实现

优秀的个人博客,低调大师

手机取名简史 快来学习下

上 今天跟大家聊聊手机名字的那些事儿,尝试从手机取名这个角度来探讨智能机行业的变革。 说起手机名字,大家可能会说出一大堆来,比如小米1,2,3……10,华为P1,2,6,7,10,苹果3,4,5,6,7。这些手机名字取得既简单又好记。 但是在功能机诺基亚和摩托罗拉称雄的时代,手机名字那是另一番场景。手机名字跟入网名字有点像,又“臭”又“长”。主要有三种取名方式: 一是纯数字型,比如诺基亚1110,3310,5700 二是字母加一串数字,比如诺基亚N97,摩托罗拉A1200,三星E1100 三是字母加单个数字,比如摩托罗拉刀锋系列v3 在这一阶段,手机取名字一般是按照产品高中低端、客户群体定位以及功能支持情况,加上厂商产品迭代型号,然后取名的。换句话说,这个阶段取名字的主体其实是厂商,凸出的是厂商品牌和某个系列,而非某个具体型号。 这个情况大家都差不多,国内外手机厂商一直沿用,直到iPhone的出现。iPhone的第一代命名为 iPhone,第二代为iPhone3G,第三代为iPhone3Gs,以此类推。 这个命名规则看似平平无奇,实际上暗藏玄机。首先,与功能机命名做了彻底区分。就像村里大家都叫赵铁柱,王二蛋、李狗剩,你突然叫梅长苏,自然给人一种与众不同的感觉。其次,命名更简单,容易记忆和传播。最后,产品有延续性。普通人都知道下一代手机叫什么名字,有一种期待感。 同期,国产手机并没有意识到这个问题,还是沿用老的命名规则,比如最初的神机中兴v880,华为C8500。当然,看到苹果取得的成就,国内外厂商还是比较眼热的,跟风命名也多,比如联想乐phone,庚phone。 不过跟风没有跟到点子上,直到小米的出现。单就命名来说,小米取名最切合苹果思路,第一代1,第二代1s,第三代2,等等。简单好记的名字,再加上极具性价比的价格配置,互联网的打法,使得小米迅速崛起。其他国产厂商一看,哟呵,原来应该这么玩。 接下来,一众国产厂商迅速跟进,先从命名开始,什么P1,d2,F1,x1,都有了。这时候大家都很忙,要学的师傅太多,一边要学苹果这个祖师爷,还要学习小米这个乔二代,另一边还要学习三星搞机海战术,难免会出错。 最典型的是华为ascend系列,也是华为p10系列的前身。华为本身的想法是打出ascend系列品牌来,ascend翻译过来是升高,寓意节节高升,又是a开头的字母,简直完美。唯一没考虑到的是,ascend这个名字太拗口。想象一下: 同事问你,你用什么手机? 你说,阿森得。 同事:啊什么得? 你:阿森得。 同事:什么森得? 你:阿森得。 同事:啊什么? 你:没什么,我没用手机,回头再聊。 这天就这么聊死了。 后来到了p10,就不提ascend了,直接叫p10了。不过,理工男的浪漫在于念念不忘,必有回响。ascend这么完美的名字肯定不能丢,于是这个ascend如今化身为华为�N腾,涵盖智能计算、AI芯片等业务,也算是物尽其用了。 下 除了华为,这个阶段还有些有意思的创新。别奇怪,从模仿到创新,这个我们很擅长。主要有以下几种: 一是粗粮派,这一派手机厂商主要学习小米品牌命名,典型代表小辣椒手机和红辣椒手机; 二是潮流派,这一派手机厂商理解的互联网就是潮流,于是手机取名字就贴向潮流热点,典型代表酷派大神; 三是新奇派,这一派手机厂商对互联网的理解就是新奇,越新奇越能吸引用户,典型代表360特供手机、联想乐檬、锤子手机; 创新归创新,但是结果不一定好。有句话:学我者生,似我者死。在手机这个赢家通吃的行业,学我者死,似我者也要死。以上几个流派,退的退,倒的倒,如今基本上已经销声匿迹。 到了库克执掌苹果的时代,他基本延续苹果此前命名。不过熟悉供应链管理的他,追求利益最大化,尽可能照顾更多的果粉,于是贴心的为他们增加了plus版和c/se廉价版。 国产厂商作为后学末进,看到前辈的变化,自然不甘人后,尽心尽力去学习。廉价版不用说,玩的透透的。plus版到了咱们这里,演化成plus和pro,名字不同,但是意义是一样的。 库克时代的苹果,相对来说,没什么引领性,颠覆性的创新,感觉是稳中求进。倒是在命名上创新不少,除了plus版和廉价版,到了第十代iPhone,创造性了引入了超大杯、大杯、中杯这种命名方法,简直石破天惊。 一众努力吆喝卖手机的厂商一看,还能这么玩?于是纷纷学习。把苹果当成师傅的华为率先推出p40 pro+,p40 pro,p40,超大杯、大杯、中杯给安排的明明白白。 小米不甘人后,推出小米10至尊纪念版、10pro版、10版、10青春版,不仅超大杯、大杯、中杯给安排的明明白白,连廉价版都给安排上了。顺便说下,小米至尊版叫Mi 10 Ultra ,而Ultra最先是用在三星手机上的。 纵观手机取名史,我们可以大略看到手机发展的变革: 一是,从以厂商为中心,转向以用户为中心,产品设计时,不再是我给用户什么,而是用户需要什么; 二是,由原来的品牌思维推动,转向爆款思维推动。即原来是从品牌整体进行建设,现在是通过打造爆款来推动品牌发展,但是需要注意的是,这并不意味着品牌意识变弱,反而是增强了; 总的来说,名字并非手机成败的决定性因素,大神手机没有让酷派成为大神,ascend没有让华为手机倒下,但是该倒闭还是倒闭,该成神依旧成神。诺基亚1110、摩托罗拉v3等名字照样是爆款,是全球历史销量最高的手机。 最关键的还是手机产品自身要过硬,赢得消费者的喜欢。当然,名字取得好听点,哪怕倒下了还能让人怀念下。 【责任编辑: 未丽燕 TEL:(010)68476606】

优秀的个人博客,低调大师

BM25 + 向量混合检索本地化落地:赣州同城 AI 获底层技术方案

生成式大模型驱动的同城本地流量竞争,已经从 POI 完善、内容铺量的表层运营,下沉至 RAG 检索召回底层。当前赣州大量实体商家陷入共性困境:完成 NAP 标准化、结构化 FAQ 搭建后,依然存在店名精确搜索漏召、本地口语化需求匹配失真、跨区县无效咨询泛滥、大模型难以主动引用商户信息等问题。

优秀的个人博客,低调大师

Python爬虫入门教程 59-100 python爬虫高级技术之验证码篇5-验证识别技术之二

@[toc] 图片比对 昨天的博客已经将图片存储到了本地,今天要做的第一件事情,就是需要在两张图片中进行比对,将图片缺口定位出来 缺口图片 完整图片 计算缺口坐标 对比两张图片的所有RBG像素点,得到不一样像素点的x值,即要移动的距离 def get_distance(self,cut_image,full_image): # print(cut_image.size) threshold = 50 for i in range(0,cut_image.size[0]): for j in range(0,cut_image.size[1]): pixel1 = cut_image.getpixel((i, j))

优秀的个人博客,低调大师

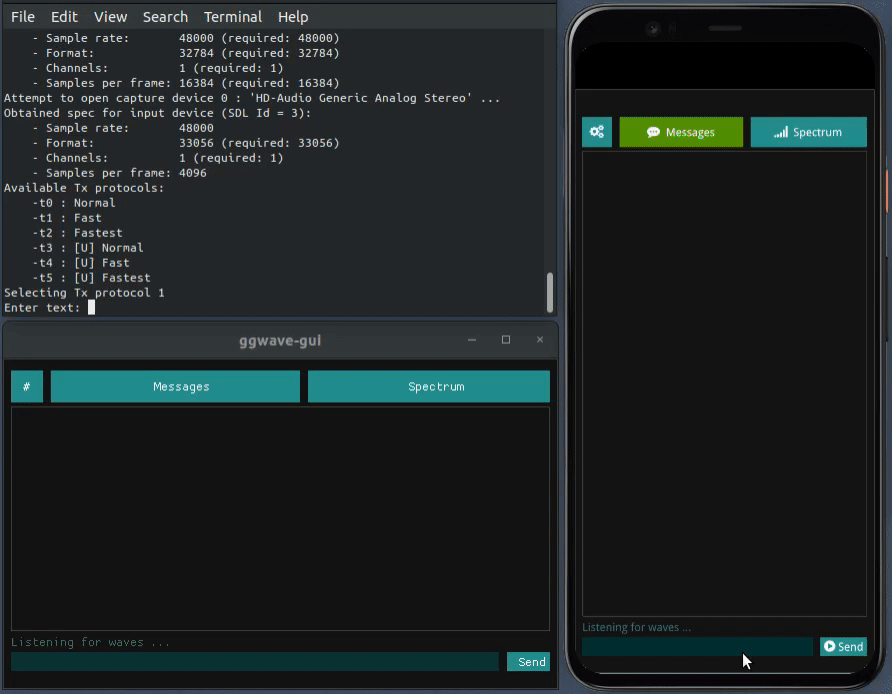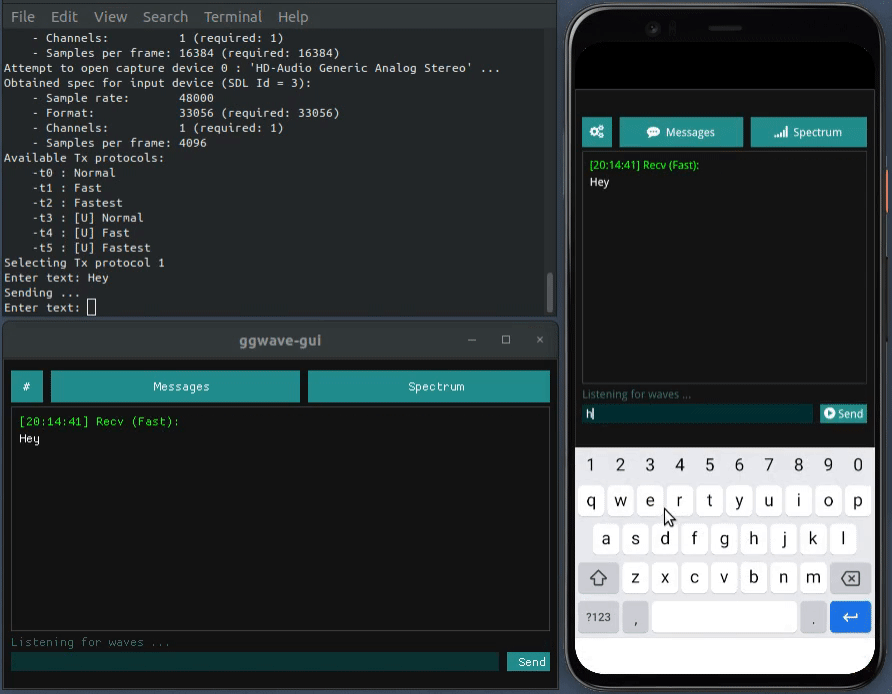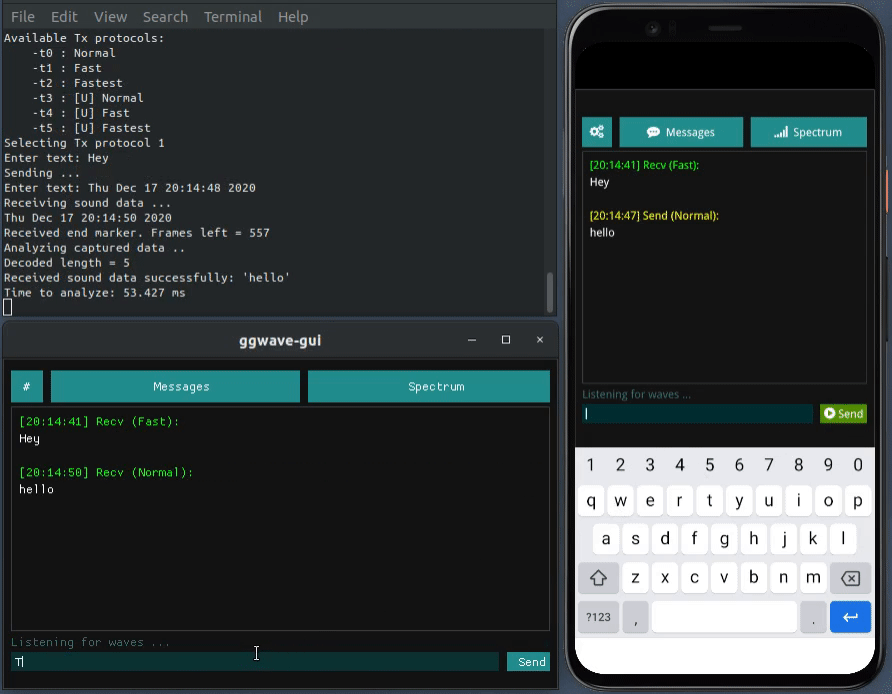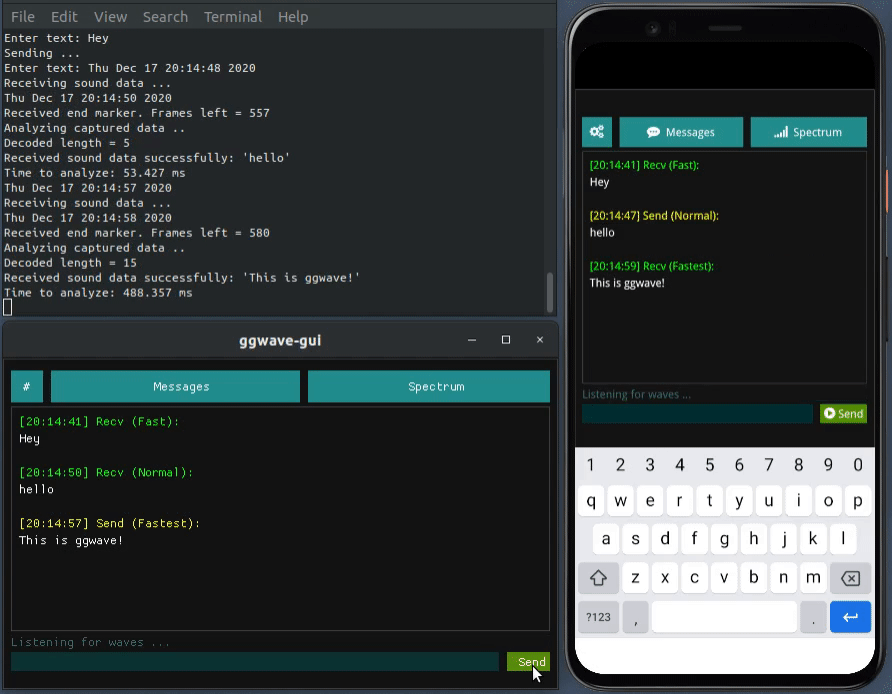
ggwave —— 简声音传输数据库

ggwave 是小型的声音传输数据 (data-over-sound) 库,用于生成和分析从音频设备(扬声器、麦克风等)播放和捕获的原始波形。只要提供用于音频样本排队和出队的回调,就可以自由使用任何音频后端(例如 PulseAudio、ALSA 等)。 该库支持使用声音在气隙设备之间传输少量数据。它实现了一个简单的基于 FSK 的传输协议,可以轻松集成到各种项目中。带宽速率在 8-16 字节/秒之间,具体取决于协议参数。纠错码 (ECC) 则用于提高解调稳定性。

优秀的个人博客,低调大师

简 Java 工作流概念入门

关于 Flowable 松哥已经更新了好几篇文章了,不过考虑到有的小伙伴可能还从来没接触过流程引擎,因此有一些基础的内容我再来和小伙伴们梳理一下。 1. 为什么需要工作流 松哥将之前的文章转发到朋友圈后,有小伙伴评论说一直不理解为什么需要工作流,今天我们就先来说说这个话题。 假设我有一个请假需求,流程如下: 请假可以提交给我的上司,上司可以选择批准或者拒绝,无论批准还是拒绝,都会给我一个通知。 这个流程比较简单,我们很容易想到解决方案,不用工作流也能解决,有一个专门的请假表,当 A 要请假的时候,就往请假表中添加一条记录,这条记录的内容包含了请假的天数、原因、请假的审批人 B 以及一个名为 status 的字段,这个 status 字段表示这个请假申请目前的状态(待审批、已批准还是已拒绝),然后 B 登录系统之后,在请假表中查询到了 A 的请假信息,然后选择批准,此时将 status 字段的值改一下就行了。 这个流程很简单,相信小伙伴们都能想到。 然而,这是一个非常简单的流程,对于这样的流程,一般来说也确实没有必要使用工作流,但是现实中,我们涉及到的工作流往往都是非常复杂的,我举个例子,就说报销审批吧,这个可能很多小伙伴都经历过。 小伙伴们看到,这个流程相对来说还是比较复杂的,此时你再用一个 status 字段去描述,就很难说的请到底是怎么回事了。每一步审批,都有可能批准也有可能拒绝,拒绝并不意味着流程结束,员工修改报销资料之后,还可以继续提交。此时如果还用 status 去描述,那么 status 将有 N 多个值去表示不同的情况,这个维护起来非常不便。 这就复杂了吗?非也非也,我们再来看一个生产笔记本电脑的例子,假设公司研发了一款新型笔记本电脑,整个研发到生产的流程可能是这样: 相比上面两个,这个就更复杂一些了,不仅有串行任务还有并行任务,如何去设计这样一个系统?单纯的通过状态字段去描述显然已经不够用了,此时我们就得考虑一种通用的、更易维护的方案来实现这样的系统了,这种通用的、易维护的方案,也就是工作流。 2. 三大工作流 一个比较早的工作流是 jBPM,这是一个由 Java 实现的企业级流程引擎,是 JBoss 公司开发的产品之一。 jBPM 的创建者是 Tom Baeyens,这个大佬后来离开了 JBoss,并加入到 Alfresco,并推出了基于 jBPM4 的开源工作流系统 Activiti,而 jBPM 则在后续的代码中完全放弃了 jBPM4 的代码。从这个过程中也能看出来,jBPM 在发展过程中,由于意见相左,后来变成了两个 jBPM 和 Activiti。 然而戏剧的是,Activiti5 没搞多久,从 Activiti 中又分出来一个 Camunda,Activiti 继续发展,又从中分出来一个 Flowable。。。 由于开发 jBPM、Activiti、Camunda 以及 Flowable 的人多多少少有一些关联性,让人不得不猜测意见相左拉一票人出来单干是他们的企业文化。 所以现在市面上主流的流程引擎就一共有三个: Activiti Flowable Camunda 这三个各有特点: Activiti 目前是侧重云,他目前的设计会向 Spring Cloud、Docker 这些去靠拢。 Flowable 核心思想还是在做一个功能丰富的流程引擎工具,除了最最基础的工作流,他还提供了很多其他的扩展点,我们可以基于 Flowable 实现出许多我们想要的功能(当然这也是小伙伴们觉得 Flowable 使用复杂的原因之一)。 Camunda 相对于前两个而言比较轻量级,Camunda 有一个比较有特色的功能就是他提供了一个小巧的编辑器,基于 bpmn.io 来实现的(松哥之前已经发文讲过了)。如果你的项目需求是做一个轻巧的、灵活的、定制性强的编辑器,工作流是嵌入式的,那么可以选择 Camunda。 如果仔细比较起这三个的差异,能列一个长长的表格,这个网上也有不少人都总结过了,松哥这里也就不啰嗦了。 3. 流程图 既然有三个不同的工作流,那么三个不同的工作流画出来的流程图是否都各不相同呢? 不是的。 工作流程图这块其实有一个统一的标准,那就是 BPMN。BPMN 全称是 Business Process Model and Notation,中文译作业务流程模型和标记法,这个中文太绕口了,还是简称 BPMN 吧。 这是一套图形化表示法,用图形来表示业务流程模型。BPMN 最初由业务流程管理倡议组织(BPMI, Business Process Management Initiative)开发,BPMI 于 2005 年与对象管理组织(OMG, Object Management Group)合并,并于 2011 年 1 月 OMG 发布 2.0 版本,同时改为现在的名称。 一句话,就是流程图这块有一个特别古老的规范,那就是 BPMN,而我们前面所说的无论是 Activiti、Flowable 还是 Camunda,都是支持这个规范的,所以呢,无论你使用哪一个流程引擎,都可以使用同一套流程图。 那么这个规范究竟都说了些什么事情呢? 我们以上面生产笔记本的流程图为例,来和小伙伴们做一个简单介绍: 从上图中可以看到,一个流程图中主要包含四方面的内容: 事件 连线 任务 网关 我们一个一个来说。 事件 首先在一个流程图中应该有开始事件和结束事件,也就是上图大家看到的两个圆圈。另外还有一些中间事件、边界事件等。举个中间定时事件的例子,比如用户下单之后,可以有一个中间定时事件,延迟 5 分钟发货。 连线 连线就是将事件、任务、网关等连在一起的线条,一般情况下就是普通连线,有的时候连线会有一些条件,例如松哥之前文章和大家分享的请假,如果经理同意请假申请,就走哪一个线条,如果经理不同意请假申请,就走哪一个线条。对应上图的笔记本生产,如果经理审批通过,就载入图纸准备生产,如果经理审批不通过,就重新设计。 任务 任务这块其实有很多分类。 如果细分大致上可以分为如下几种: 接收任务 在上面的流程图中,等待准备工作完成这一项就是一个接收任务。这个任务里并不需要额外做什么事情,流程到这一步就自动停下来了,需要人工去点一下,推动流程继续向下执行。 发送任务 这个一般用来把消息发送给外部参与者。 服务任务 这个一般由系统自动完成,其实说白了就是我们的一个自定义类,可以在一个自定义类里边完成想要做的事情。 脚本任务 一个自动化活动。当流程执行到脚本任务时,自动执行相应的脚本。 业务规则任务 BPMN2.0 新引入用来对接业务规则引擎,业务规则任务用于同步执行一个或多个规则。 用户任务 用于为那些需要由人工参与者完成的工作建模。 虽然细分类别很多,但是仔细看,其实这几种又可以归为两大类: 用户任务:表示人工要介入做的事情。比如同意与否,或者输入一些参数,要让人工完成任务,就需要一个表单系统,让人工输入数据,或者显示数据给人看,这也是为什么用户任务和表单系统结合在一起的原因,用户任务需要用户向引擎提交一个完成任务的动作,否则流程会暂停在这里等待。 服务任务:表示机器自动做的事情。调用服务的任务,这个服务可以是一个 Spring JavaBean,也可以是一个远程 REST 服务,流程会自动执行服务任务。 活动 活动可以算是一种特殊的任务。活动可以调用另外一个流程使之作为当前流程的子流程去运行。活动也可以分为用户活动、脚本活动等等。从显示上来说,活动比任务边框深一些。仅此而已。 网关 网关要是细分起来,也有很多不同类型的网关。 互斥网关 这种网关也叫排他性网关,我们之前请假流程中的那个网关,就是互斥网关。这种网关有且仅有一个有效出口。 相容网关 这种网关会有多个出口,只要条件满足,都会执行。 事件网关 事件网关是通过中间事件驱动,它在等待的事件发生后才会触发决策。基于事件的网关允许基于事件作出决策。 并行网关 并行网关一般是成对出现的,上面生产笔记本的那个流程中,生产屏幕、键盘等并行操作,就是通过并行网关来实现的。 好啦,这就是关于流程引擎的一些基本概念,捋顺了这些基本概念,在回过头看我们前面几篇关于流程引擎的文章,应该会有一些不一样的理解: Spring Boot 整合流程引擎 Flowable,so easy! SpringBoot+Vue+Flowable,模拟一个请假审批流程! 49张图带领小伙伴们体验一把 Flowable-UI Spring Security + Vue + Flowable 怎么玩?

优秀的个人博客,低调大师

Agileutil v0.0.18 发布,简 RPC

简介 Agileutil是一个Python3 RPC框架,client和server既可以直连,也可以通过Consul做服务注册发现。 特性 像本地函数一样调用 使用简单,用户只需要关注业务即可 HTTP/UDP/TCP 全协议支持 支持异步 async/await 安装 Python 版本 >= 3.6 pip install agileutil 快速开始 创建文件myservice.py from agileutil.rpc import rpc @rpc def hello(name): return 'hello ' + name 启动: agileutil --run myservice 详细介绍:https://gitee.com/lycclsltt/agileutil

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册