首页 文章 精选 留言 我的

精选列表

搜索[小程序·云开发],共10036篇文章
优秀的个人博客,低调大师

DLNA&UPnP开发笔记(2)

1. UPnP协议组成 UPnP协议中,定义了两个主要的组件,一个是设备(Device),一个是控制点(Control Point)。这就是为什么很多UPnP协议栈的SDK的接口代码一般都主要由Device和Control Point构成。设备是在网络中可见的对象,而控制点在网络中不可见。 一个UPnP的设备(Device)是不能直接访问和控制另一个UPnP的设备(Device)的,对设备的访问和控制都必须通过控制点(Control Point)来代为完成。而控制点对设备的控制则主要是由设备定义的“服务”(Service)来实现。 设备(Device)需要向网络中广播自己的信息,并提供设备描述和服务(Service)描述,并发送设备事件消息. 控制点(Control Point)则是搜索设备,并使用其提供的服务(Service)访问和控制设备,同时监听设备事件消息。 2. 典型的UPnP AV应用架构 如图所示是一种典型的UPnP AV应用架构,它来自《UPnP-av-AVArchitecture》。在一个典型的UPnP应用中,有三个主体,一个服务器(MediaServer),一个播放器(MediaRender),以及一个控制点(Control Point)。 服务器(MediaServer)主要负责提供多媒体文件的浏览和控制。 播放器(MediaRender)主要负责提供播放和渲染。 控制点(Control Point)则控制整个播放过程。 它们三个在物理上可以是同一个设备,当然,也可以在不同的设备上。 对应到UPnP协议组件的话,“MediaServer”和“MediaRnederer”都属于UPnP的Device。 “ContentDirectory”、“ConnectionManager”、“AVTransport”、“RenderingControl”这些都属于UPnP设备所提供的服务(Service),通过这些服务描述,Control Point就知道该如何访问和控制设备了。 3. UPnP的设备描述和服务描述 UPnP的设备(Device)是通过广播包来通知局域网中的控制点自己的设备信息和服务的,而这些设备信息和服务都必须根据UPnP协议规定的XML文档格式来编写,UPnP提供了标准的模板可以参考,具体的文档地址: http://upnp.org/sdcps-and-certification/standards/sdcps/ 由这些文档我们可以看到,UPnP官网为我们定义了12种设备,在每种设备的文档中详细地定义了设备描述XML如何编写,定义了每种设备需要实现哪些服务,每种服务的XML文档如何编写。 到这里,我们其实可以看到,实现一个上述的UPnP AV应用也并没有那么可怕,一切都是有章可循的,我们需要做的就是熟读协议所定义了一系列文档。 本文转自 Jhuster 51CTO博客,原文链接:http://blog.51cto.com/ticktick/1637727,如需转载请自行联系原作者

优秀的个人博客,低调大师

Elasticsearch: 权威指南 » 深入搜索 » 多字段搜索 » 多数字段 good

跨字段实体搜索 » 多数字段编辑 全文搜索被称作是召回率(Recall)与精确率(Precision)的战场:召回率——返回所有的相关文档;精确率——不返回无关文档。目的是在结果的第一页中为用户呈现最为相关的文档。 为了提高召回率的效果,我们扩大搜索范围——不仅返回与用户搜索词精确匹配的文档,还会返回我们认为与查询相关的所有文档。如果一个用户搜索 “quick brown box” ,一个包含词语fast foxes的文档被认为是非常合理的返回结果。 如果包含词语fast foxes的文档是能找到的唯一相关文档,那么它会出现在结果列表的最上面,但是,如果有 100 个文档都出现了词语quick brown fox,那么这个包含词语fast foxes的文档当然会被认为是次相关的,它可能处于返回结果列表更下面的某个地方。当包含了很多潜在匹配之后,我们需要将最匹配的几个置于结果列表的顶部。 提高全文相关性精度的常用方式是为同一文本建立多种方式的索引,每种方式都提供了一个不同的相关度信号signal。主字段会以尽可能多的形式的去匹配尽可能多的文档。举个例子,我们可以进行以下操作: 使用词干提取来索引jumps、jumping和jumped样的词,将jump作为它们的词根形式。这样即使用户搜索jumped,也还是能找到包含jumping的匹配的文档。 将同义词包括其中,如jump、leap和hop。 移除变音或口音词:如ésta、está和esta都会以无变音形式esta来索引。 尽管如此,如果我们有两个文档,其中一个包含词jumped,另一个包含词jumping,用户很可能期望前者能排的更高,因为它正好与输入的搜索条件一致。 为了达到目的,我们可以将相同的文本索引到其他字段从而提供更为精确的匹配。一个字段可能是为词干未提取过的版本,另一个字段可能是变音过的原始词,第三个可能使用shingles提供词语相似性信息。这些附加的字段可以看成提高每个文档的相关度评分的信号signals,能匹配字段的越多越好。 一个文档如果与广度匹配的主字段相匹配,那么它会出现在结果列表中。如果文档同时又与signal信号字段匹配,那么它会获得额外加分,系统会提升它在结果列表中的位置。 我们会在本书稍后对同义词、词相似性、部分匹配以及其他潜在的信号进行讨论,但这里只使用词干已提取(stemmed)和未提取(unstemmed)的字段作为简单例子来说明这种技术。 多字段映射编辑 首先要做的事情就是对我们的字段索引两次:一次使用词干模式以及一次非词干模式。为了做到这点,采用multifields来实现,已经在multifields有所介绍: DELETE /my_index PUT /my_index { "settings": { "number_of_shards": 1 }, "mappings": { "my_type": { "properties": { "title": { "type": "string", "analyzer": "english", "fields": { "std": { "type": "string", "analyzer": "standard" } } } } } } } 拷贝为 CURL 在 SENSE 中查看 参考被破坏的相关度. title字段使用english英语分析器来提取词干。 title.std字段使用standard标准分析器,所以没有词干提取。 接着索引一些文档: PUT /my_index/my_type/1 { "title": "My rabbit jumps" } PUT /my_index/my_type/2 { "title": "Jumping jack rabbits" } 拷贝为 CURL 在 SENSE 中查看 这里用一个简单match查询title标题字段是否包含jumping rabbits(跳跃的兔子): GET /my_index/_search { "query": { "match": { "title": "jumping rabbits" } } } 拷贝为 CURL 在 SENSE 中查看 因为有了english分析器,这个查询是在查找以jump和rabbit这两个被提取词的文档。两个文档的title字段都同时包括这两个词,所以两个文档得到的评分也相同: { "hits": [ { "_id": "1", "_score": 0.42039964, "_source": { "title": "My rabbit jumps" } }, { "_id": "2", "_score": 0.42039964, "_source": { "title": "Jumping jack rabbits" } } ] } 如果只是查询title.std字段,那么只有文档 2 是匹配的。尽管如此,如果同时查询两个字段,然后使用bool查询将评分结果合并,那么两个文档都是匹配的(title字段的作用),而且文档 2 的相关度评分更高(title.std字段的作用): GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 我们希望将所有匹配字段的评分合并起来,所以使用most_fields类型。这让multi_match查询用bool查询将两个字段语句包在里面,而不是使用dis_max查询。 { "hits": [ { "_id": "2", "_score": 0.8226396, "_source": { "title": "Jumping jack rabbits" } }, { "_id": "1", "_score": 0.10741998, "_source": { "title": "My rabbit jumps" } } ] } 文档 2 现在的评分要比文档 1 高。 用广度匹配字段title包括尽可能多的文档——以提升召回率——同时又使用字段title.std作为信号将相关度更高的文档置于结果顶部。 每个字段对于最终评分的贡献可以通过自定义值boost来控制。比如,使title字段更为重要,这样同时也降低了其他信号字段的作用: GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title^10", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 title字段的boost的值为10使它比title.std更重要。 https://www.elastic.co/guide/cn/elasticsearch/guide/current/most-fields.html

优秀的个人博客,低调大师

Android中<meta-data>的使用

在AndroidManifest.xml中。<meta-data>元素能够作为子元素,被包括在<activity>、<application> 、<service>和<receiver>元素中,但 不同的父元素。在应用时读取的方法也不同。 1 :在Activity的应用。 xml代码段: <activity...> <meta-data android:name="myMsg" android:value="hello my activity"></meta-data> </activity> java代码段: ActivityInfo info=this.getPackageManager() .getActivityInfo(getComponentName(), PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 2:在application的应用。 xml代码段: <application...> <meta-data android:value="hello my application" android:name="myMsg"></meta-data> </application> java代码段: ApplicationInfo appInfo = this.getPackageManager() .getApplicationInfo(getPackageName(), PackageManager.GET_META_DATA); String msg=appInfo.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 3:在service的应用。 xml代码段: <service android:name="MetaDataService"> <meta-data android:value="hello my service" android:name="myMsg"></meta-data> </service> java代码段: ComponentName cn=new ComponentName(this, MetaDataService.class); ServiceInfo info=this.getPackageManager() .getServiceInfo(cn, PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 4: 在receiver的应用。 xml代码段: <receiver android:name="MetaDataReceiver"> <meta-data android:value="hello my receiver" android:name="myMsg"></meta-data> <intent-filter> <action android:name="android.intent.action.PHONE_STATE"></action> </intent-filter> </receiver> java代码段: ComponentName cn=new ComponentName(context, MetaDataReceiver.class); ActivityInfo info=context.getPackageManager() .getReceiverInfo(cn, PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5113540.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MongoDB学习笔记(二)--Capped集合 &amp;&amp; GridFS存储文件

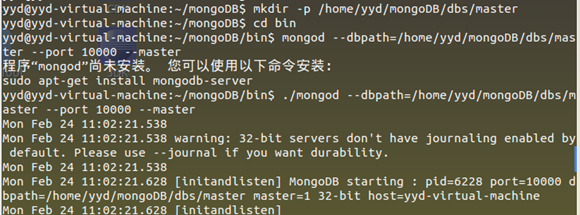
Capped集合 Capped集合的大小是固定的,如果空间都被用完了,新添加的对象会取代最旧的那个数据。 创建 使用了db.createCollection()方法创建了一个名字为mycapped,空间大小为100000的Capped Colletcion。 限制 如果需要限定Collection中对象的数量,就要设置max参数,如果到了限制的数量,就要移除一个最近的插入。 使用validate()查询mycapped2集合的使用的存储空间。 默认情况下,非Capped集合会在_id上创建索引,而Capped集合不会在_id上创建索引,如果需要在_id上创建索引就需要用到autoIndexID参数。 GridFS存储文件 GridFS存储文件时会分两个集合来存储: files 包含元数据对象。 chunks 包含其他一些相关信息的二进制块。 使用mongofiles put F:\MongoDB\mongodb\bin\bad.txt命令将bad.txt文件保存到了数据库中。 查看数据库中有哪些GridFS文件: 重命名本地的bad.txt文件为bad1.txt,将数据库中文件导出: GridFS的块由单独的集合来存储,默认情况下,使用fs.chunks集合来存储块。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3557578.html,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册