首页 文章 精选 留言 我的

精选列表

搜索[定位功能],共10011篇文章
优秀的个人博客,低调大师

Linux上性能异常定位以及性能监控

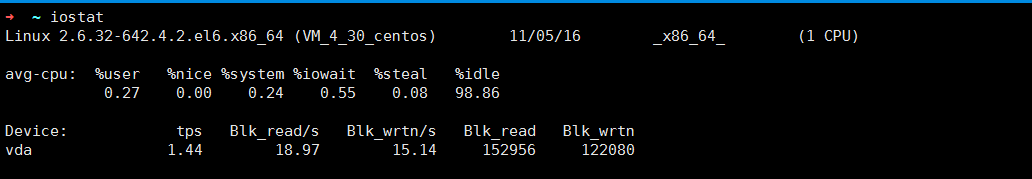
引言:大多数的服务都是跑在Linux上的,Linux现在也已经到了一个很广泛的应用,但是仍然会有很多问题出现,我们就来讨论下我们性能监控的指标,性能监控无非就是从I/O,内存,CPU,TCP连接数,网络,进程或者线程来出发,使用到的命令有iostat,vmstat,sar,mpstat,netstat,ss,iftop,free,pstree/ps,pidstat,top,(uptime)下面来进一步深入下吧. 一,磁盘I/O(iostat) 我们的机器上有很多的数据是存储在磁盘上的,我们读取的很多数据都是要和磁盘交互的,但是磁盘同时又是一个低速设备,很多时候会发生阻塞,所以磁盘I/O的监控很重要。我们使用iostat来诊断磁盘的情况。使用的机器是腾讯云主机。 tps:该设备每秒的传输次数,表示每秒多少个I/O请求 Blk_read/s:每秒从设备读取到的数据量 Blk_wrtn/s:每秒向设备写入的数据量 Blk_read:读取的总数据量 Blk_wrtn:写入的总数据量 %user:代表用户态进程使用CPU的负载 %nice:代表优先级进程使用的CPU负载 %system:代表内核态进程使用的CPU负载 %iowait:代表CPU等待I/O时,CPU的负载 %steal:代表被偷走的CPU负载情况,这个在虚拟化技术中会用到 %idle:代表空闲的所占用的CPU负载情况 iostat还有一个常用的参数选项-x,表示扩展的信息 rrqm/s:每秒这个设备相关的读取请求有多少被Merge(多个I/O合并的操作)了 wrqm/s:每秒这个设备相关的写入请求有多少被Merge了 r/s:每秒发送到设备的读请求数 w/s:每秒发送到设备的写请求数 rsec/s:每秒读取设备扇区的次数 wsec/s:每秒写入设备扇区的次数 avgrq-sz:平均请求扇区的大小 avgqu-sz:平均请求队列的长度 await:每一个I/O请求的处理的平均时间(等待时间) r_await:每一个读I/O请求的处理的平均时间 w_await:每一个写I/O请求的处理的平均时间 svctm:表示平均每次I/O操作的服务时间。如果svctm值和await值很接近,则表示I/O几乎没有等待,如果await的值远高于svctm的值,则表示I/O队列等待太长 %util:在统计的时间内总共有多少的时间用于处理I/O操作,即被消耗的CPU的百分比。例如统计时间间隔是1s,那么这个设备有0.65s在处理I/O,有0.35s处于空闲。那么这个设备的%util=0.65/1=65%,一般地,如果该参数是100%表示设备已经接近满负荷运行了(当然如果是多磁盘,即使%util是100%,因为磁盘的并发能力,所以磁盘使用未必就到了瓶颈) 二,内存(free) 在Linux系统中我们查看内存使用情况。使用free命令来查看 第一行的信息(我们可以认为从操作系统层面看待) total:总物理内存大小 used:已经分配的大小 free:没有被分配的大小 shared:共享内存的大小,主要用于IPC通信 buffers:用于块设备的缓冲 cached:用于文件内容缓冲,也就是缓存 "缓存"就是在内存中划分一块区域,作为进程和硬盘之间的缓冲区,进程将数据写入缓存中,当那些数据需要读取的时候,就直接去"高速路"缓存中读取,而不会去"土路"硬盘中读取,这样大大的加快性能 这里buffer实际上是存储了我们数据的元数据(包括目录名字,文件大小,文件存储块,修改时间,权限等),而cache则存放了我们最近读取过的文件。 第三行信息(我们可以认为从应用程序层面看待) 这里的-/+ buffers/cache分别为 -buffers/cache 和 +buffers/cache 两部分 -buffers/cache = used(第一行)-buffers-cached 实际上是当前程序上"真实使用"的"物理内存" +buffers/cache = buffers+cached 意思就是暂时"借给"系统作为"缓冲区"使用的内存大小 used=(+buffers/cached)+(-buffers/cached) 所以从应用程序层面看,可用内存=free memory+buffers+cached 详细信息我们可以通过下面这种方式查看. ~ cat /proc/meminfo MemTotal: 1020128 kB MemFree: 670772 kB Buffers: 97780 kB Cached: 100980 kB SwapCached: 0 kB Active: 164988 kB Inactive: 117296 kB Active(anon): 83536 kB Inactive(anon): 160 kB Active(file): 81452 kB Inactive(file): 117136 kB Unevictable: 0 kB Mlocked: 0 kB SwapTotal: 0 kB SwapFree: 0 kB Dirty: 92 kB Writeback: 0 kB AnonPages: 83504 kB Mapped: 17500 kB Shmem: 172 kB Slab: 46696 kB SReclaimable: 28652 kB SUnreclaim: 18044 kB KernelStack: 1744 kB PageTables: 2636 kB NFS_Unstable: 0 kB Bounce: 0 kB WritebackTmp: 0 kB CommitLimit: 510064 kB Committed_AS: 343800 kB VmallocTotal: 34359738367 kB VmallocUsed: 7112 kB VmallocChunk: 34359727304 kB HardwareCorrupted: 0 kB AnonHugePages: 36864 kB HugePages_Total: 0 HugePages_Free: 0 HugePages_Rsvd: 0 HugePages_Surp: 0 Hugepagesize: 2048 kB DirectMap4k: 8184 kB DirectMap2M: 1040384 kB 三,CPU(dstat,mpstat) 首先我们使用dstat命令来查看下我们的CPU情况,他能够实时的输出我们的信息, 每2秒输出一次,一共输出10次 cpu:hiq、siq分别为硬中断和软中断次数 system:int、csw分别为系统的中断次数(interrupt)和上下文切换次数(contextswitch)。 -c:表示只显示我们的CPU信息 -m:表示只显示我们的内存信息 -p:表示只显示我们的进程信息 -n:表示只显示我们的网络信息 我们想以什么为什么优先顺序查看,可以在后面加下列参数 mpstat %user 在internal时间段里,用户态的CPU时间(%),不包含nice值为负进程 (usr/total)*100%nice 在internal时间段里,nice值为负进程的CPU时间(%) (nice/total)*100%sys 在internal时间段里,内核时间(%) (system/total)*100%iowait 在internal时间段里,硬盘IO等待时间(%) (iowait/total)*100%irq 在internal时间段里,硬中断时间(%) (irq/total)*100%soft 在internal时间段里,软中断时间(%) (softirq/total)*100%idle 在internal时间段里,CPU除去等待磁盘IO操作外的因为任何原因而空闲的时间闲置时间(%) (idle/total)*100 四,TCP连接数(ss,netstat) ss是Socket Statistics的缩写,顾名思义ss命令就是用来获取sockets的信息,他可以显示和netstat类似的内容,但是他比netstat更快更高效,而且显示更为详细的有关TCP连接信息。当我们的sockets连接数非常大的时候,无论是我们使用netstat命令还是在内核中查看连接数cat /proc/net/tcp的时候都会很缓慢。 ss快速的原因就是他利用了TCP协议中的tcp_diag,tcp_diag是一个用于分析和统计的模块,他可以获取到Linux内核中的第一手信息,这个就确保了ss的高效性。 我们可以对netstat和ss做个对比,有图有真相嘛 netstat命令的时间显然比ss命令的时间慢多了 netstat命令 我们可以看到系统中守护进程的连接状态信息以及监听到的端口号 -t:表示TCP的连接 -u:表示UDP的连接 -n:表示以数字的形式显示信息 -p:表示显示监听的端口号 查看系统中守护进程的监听状态 我们可以看到State状态显示 ss命令 查看当前服务器的网络连接统计: ss -s 其他ss的用法和netstat用法相同 五,网络(iftop) 使用iftop -i eth0 使用Ctrl+c退出,退出显示 我们可以使用-i参数监听不同的网卡流量信息,在iftop的哪个界面我们可以使用按p来查看端口流量信息 六,进程信息(ps/pstree,top,pidstat) 我们使用pstree来查看下我们的进程树,所有的进程都是init进程的子进程 ps命令 查看具体的进程,比如MySQL进程我们可以使用ps aux mysqld或者ps -elf mysqld这种方式,这两种本质上没有什么区别,因为Linux继承的是Unix的一些思想,一个是Unix的Sys-v风格,一个是BSD的风格 我们可以详细的看到他的信息 pidstat命令 我们可以使用pidstat来查看每一个进程的pid的状态信息,以及他所占的CPU信息 六,综合显示(vmstat,top,sar) 我们看到内存,交换分区,I/O,CPU,以及进程上下文切换次数 top命令 在这个界面下: 按m按照内存使用大小排序显示 按P按照CPU使用大小排序显示 按M按照常驻留内存大小排序 按k表示杀死某个进程 sar命令 有时候我们可能需要统计下我们的Linux启动了多长时间,我们可以使用uptime命令来显示这个信息,top也可以显示 uptime命令 top命令显示

优秀的个人博客,低调大师

【JVM性能优化】 服务发生OOM故障定位方案

# 前提概要 > **对于JVM服务而言出现了OOM(Out Of Memory)问题,并且对其进行相关的解决是作为一个Java技术栈人员必备的实战能力。在此总结了一些相对通用的方案,希望能帮助到大家**。 # 分析原因 > **某Java服务出现了OOM,最常见的原因为:** 1. **有可能是内存分配确实过小,而正常业务使用了大量内存(正常现象)** 2. **某一个对象被频繁申请,却没有释放,内存不断泄漏,导致内存耗尽(内存泄漏、代码问题)** 3. **某一个资源被频繁申请,系统资源耗尽,例如:不断创建线程,不断发起网络连接(线程不断创建、代码问题)** # 排查方案 ## 确认是不是内存本身就分配过小 > 方法:**jmap -heap pid** ![](https://oscimg.oschina.net/oscnet/up-8b8232a1524532e6f0a90a14b72346a13ef.JPEG) 如上图,可以查看新生代,老生代堆内存的分配大小以及使用情况,看是否本身分配过小。 ## 找到最耗内存的对象 方法:**jmap -histo:live 10765 | more** ![](https://oscimg.oschina.net/oscnet/up-df235c4e79902b418866e650096ddf6b23a.JPEG) 如上图,输入命令后,会以表格的形式显示存活对象的信息,并按照所占内存大小排序: - **实例数** - **所占内存大小** - **类名** > **是不是很直观?对于实例数较多,占用内存大小较多的实例/类,相关的代码就要针对性review了。** 上图中占内存最多的对象是**RingBufferLogEvent**,共占用内存**18M**,属于正常使用范围。 如果发现某类对象占用内存很大(例如几个G),很可能是类对象创建太多,且一直未释放。例如: - **申请完资源后,未调用close()或dispose()释放资源** - **消费者消费速度慢(或停止消费了),而生产者不断往队列中投递任务,导致队列中任务累积过多** > **线上执行该命令会强制执行一次fullgc。另外还可以dump内存进行分析**。 # 确认是否是资源耗尽 ## 工具: - pstree - netstat **查看进程创建的线程数,以及网络连接数,如果资源耗尽,也可能出现OOM**。 这里介绍另一种方法,通过 ```` /proc/${PID}/fd /proc/${PID}/task ```` > **可以分别查看句柄详情和线程数。** 例如,某一台线上服务器的sshd进程PID是9339,查看 ```` ll /proc/9339/fd ll /proc/9339/task ```` 如上图,sshd共占用了四个句柄 - 0 -> 标准输入 - 1 -> 标准输出 - 2 -> 标准错误输出 - 3 -> socket(容易想到是监听端口) sshd只有一个主线程PID为9339,并没有多线程。 所以,只要 ```` ll /proc/${PID}/fd | wc -l ll /proc/${PID}/task | wc -l (效果等同pstree -p | wc -l) ```` 就能知道进程打开的句柄数和线程数。 ## Java内存溢出OOM JVM中常见的两个错误 - StackoverFlowError :栈溢出 - OutOfMemoryError: java heap space:堆溢出 除此之外,还有以下的错误 ```` java.lang.StackOverflowError java.lang.OutOfMemoryError:java heap space java.lang.OutOfMemoryError:GC overhead limit exceeeded java.lang.OutOfMemoryError:Direct buffer memory java.lang.OutOfMemoryError:unable to create new native thread java.lang.OutOfMemoryError:Metaspace ```` > **OutOfMemoryError和StackOverflowError是属于Error,不是Exception** ### StackoverFlowError > **堆栈溢出,我们有最简单的一个递归调用,就会造成堆栈溢出,也就是深度的方法调用栈一般是512K,不断的深度调用,直到栈被撑破** ```` public class StackOverflowErrorDemo { public static void main(String[] args) { stackOverflowError(); } /** * 栈一般是512K,不断的深度调用,直到栈被撑破 * Exception in thread "main" java.lang.StackOverflowError */ private static void stackOverflowError() { stackOverflowError(); } } ```` #### 运行结果 ```` Exception in thread "main" java.lang.StackOverflowError at com.moxi.interview.study.oom.StackOverflowErrorDemo.stackOverflowError(StackOverflowErrorDemo.java:17) ```` ### OutOfMemoryError:java heap space 创建了很多对象,导致堆空间不够存储 ```java public class JavaHeapSpaceDemo { public static void main(String[] args) { // 堆空间的大小 -Xms10m -Xmx10m // 创建一个 80M的字节数组 byte [] bytes = new byte[80 * 1024 * 1024]; } } ``` 我们创建一个80M的数组,会直接出现Java heap space ```` Exception in thread "main" java.lang.OutOfMemoryError: Java heap space ```` ### GC overhead limit exceeded > **GC回收时间过长时会抛出OutOfMemoryError,过长的定义是,超过了98%的时间用来做GC,并且回收了不到2%的堆内存** ![](https://oscimg.oschina.net/oscnet/up-49582f70e30b8a224246421d344d56e885c.png) 为了更快的达到效果,我们首先需要设置JVM启动参数 ```` -Xms10m -Xmx10m -XX:+PrintGCDetails -XX:MaxDirectMemorySize=5m ```` 异常出现的步骤就是,我们不断的像list中插入String对象,直到启动GC回收 ```java public class GCOverheadLimitDemo { public static void main(String[] args) { int i = 0; List list = new ArrayList<>(); try { while(true) { //1.6时intern()方法发现字符串常量池(存储永久代)没有就复制,物理拷贝 //1.7时intern()方法发现字符串常量池(存储堆)没有就在保存地址值映射实际堆内存对象 list.add(String.valueOf(++i).intern()); } } catch (Exception e) { System.out.println("***************i:" + i); e.printStackTrace(); throw e; } finally { } } } ``` #### 运行结果 ```` [Full GC (Ergonomics) [PSYoungGen: 2047K->2047K(2560K)] [ParOldGen: 7106K->7106K(7168K)] 9154K->9154K(9728K), [Metaspace: 3504K->3504K(1056768K)], 0.0311093 secs] [Times: user=0.13 sys=0.00, real=0.03 secs] [Full GC (Ergonomics) [PSYoungGen: 2047K->0K(2560K)] [ParOldGen: 7136K->667K(7168K)] 9184K->667K(9728K), [Metaspace: 3540K->3540K(1056768K)], 0.0058093 secs] [Times: user=0.00 sys=0.00, real=0.01 secs] Heap PSYoungGen total 2560K, used 114K [0x00000000ffd00000, 0x0000000100000000, 0x0000000100000000) eden space 2048K, 5% used [0x00000000ffd00000,0x00000000ffd1c878,0x00000000fff00000) from space 512K, 0% used [0x00000000fff80000,0x00000000fff80000,0x0000000100000000) to space 512K, 0% used [0x00000000fff00000,0x00000000fff00000,0x00000000fff80000) ParOldGen total 7168K, used 667K [0x00000000ff600000, 0x00000000ffd00000, 0x00000000ffd00000) object space 7168K, 9% used [0x00000000ff600000,0x00000000ff6a6ff8,0x00000000ffd00000) Metaspace used 3605K, capacity 4540K, committed 4864K, reserved 1056768K class space used 399K, capacity 428K, committed 512K, reserved 1048576K Exception in thread "main" java.lang.OutOfMemoryError: GC overhead limit exceeded at java.lang.Integer.toString(Integer.java:403) at java.lang.String.valueOf(String.java:3099) at com.moxi.interview.study.oom.GCOverheadLimitDemo.main(GCOverheadLimitDemo.java:18) ```` > **我们能够看到 多次Full GC,并没有清理出空间,在多次执行GC操作后,就抛出异常 GC overhead limit** ### Direct buffer memory > **Netty + NIO:这是由于NIO引起的** 1. **NIO程序的时候经常会使用ByteBuffer来读取或写入数据,这是一种基于通道(Channel)与缓冲区(Buffer)的I/O方式,它可以使用Native函数库直接分配堆外内存** 2. **然后通过一个存储在Java堆里面的DirectByteBuffer对象作为这块内存的引用进行操作。这样能在一些场景中显著提高性能,因为避免了在Java堆和Native堆中来回复制数据。** > **ByteBuffer.allocate(capability):第一种方式是分配JVM堆内存,属于GC管辖范围,由于需要拷贝所以速度相对较慢** > **ByteBuffer.allocteDirect(capability):第二种方式是分配OS本地内存,不属于GC管辖范围,由于不需要内存的拷贝,所以速度相对较快** **如果不断分配本地内存,堆内存很少使用,那么JVM就不需要执行GC,DirectByteBuffer对象就不会被回收,这时候堆内存充足,但本地内存可能已经使用光了,再次尝试分配本地内存就会出现OutOfMemoryError,那么程序就崩溃了**。 一句话说:本地内存不足,但是堆内存充足的时候,就会出现这个问题 我们使用 **-XX:MaxDirectMemorySize=5m** 配置能使用的堆外物理内存为5M ```` -Xms20m -Xmx20m -XX:+PrintGCDetails -XX:MaxDirectMemorySize=5m ```` 然后我们申请一个6M的空间 // 只设置了5M的物理内存使用,但是却分配 6M的空间 ByteBuffer bb = ByteBuffer.allocateDirect(6 * 1024 * 1024); 这个时候,运行就会出现问题了 配置的maxDirectMemory:5.0MB ```` [GC (System.gc()) [PSYoungGen: 2030K->488K(2560K)] 2030K->796K(9728K), 0.0008326 secs] [Times: user=0.00 sys=0.00, real=0.00 secs] [Full GC (System.gc()) [PSYoungGen: 488K->0K(2560K)] [ParOldGen: 308K->712K(7168K)] 796K->712K(9728K), [Metaspace: 3512K->3512K(1056768K)], 0.0052052 secs] [Times: user=0.09 sys=0.00, real=0.00 secs] Exception in thread "main" java.lang.OutOfMemoryError: Direct buffer memory at java.nio.Bits.reserveMemory(Bits.java:693) at java.nio.DirectByteBuffer. (DirectByteBuffer.java:123) at java.nio.ByteBuffer.allocateDirect(ByteBuffer.java:311) at com.moxi.interview.study.oom.DIrectBufferMemoryDemo.main(DIrectBufferMemoryDemo.java:19) ```` ### unable to create new native thread > **不能够创建更多的新的线程了,也就是说创建线程的上限达到了** 在高并发场景的时候,会应用到 > 高并发请求服务器时,经常会出现如下异常**java.lang.OutOfMemoryError:unable to create new native thread**,准确说该 **native thread** 异常与对应的平台有关 #### 导致原因: > **应用创建了太多线程,一个应用进程创建多个线程,超过系统承载极限** > 服务器并不允许你的应用程序创建这么多线程,Linux系统默认运行单个进程可以创建的线程为1024个,如果应用创建超过这个数量,就会报 **java.lang.OutOfMemoryError:unable to create new native thread** #### 解决方法 - 想办法降低你应用程序创建线程的数量,分析应用是否真的需要创建这么多线程,如果不是,改代码将线程数降到最低 - 对于有的应用,确实需要创建很多线程,**远超过linux系统默认1024个线程限制**,可以通过修改linux服务器配置,扩大linux默认限制 ```java public class UnableCreateNewThreadDemo { public static void main(String[] args) { for (int i = 0; ; i++) { System.out.println("************** i = " + i); new Thread(() -> { try { TimeUnit.SECONDS.sleep(Integer.MAX_VALUE); } catch (InterruptedException e) { e.printStackTrace(); } }, String.valueOf(i)).start(); } } } ``` 这个时候,就会出现下列的错误,线程数大概在 900多个 ```` Exception in thread "main" java.lang.OutOfMemoryError: unable to cerate new native thread ```` ##### 如何查看线程数 ```` ulimit -u ```` ### Metaspace > **元空间内存不足,Matespace元空间应用的是本地内存** **-XX:MetaspaceSize 的初始化大小为20M** #### 元空间是什么 > **元空间就是我们的方法区,存放的是类模板,类信息,常量池等** Metaspace是方法区HotSpot中的实现,它与持久代最大的区别在于:Metaspace并不在虚拟内存中,而是使用本地内存,也即在java8中,**class metadata(the virtual machines internal presentation of Java class),被存储在叫做Metaspace的native memory** > **永久代(java8后背元空间Metaspace取代了)存放了以下信息:** - 虚拟机加载的类信息 - 常量池 - 静态变量 - 即时编译后的代码 模拟Metaspace空间溢出,我们不断生成类 往元空间里灌输,类占据的空间总会超过Metaspace指定的空间大小 代码 在模拟异常生成时候,因为初始化的元空间为20M,因此我们使用JVM参数调整元空间的大小,为了更好的效果 ```` -XX:MetaspaceSize=8m -XX:MaxMetaspaceSize=8m ```` ### 代码如下: ```java public class MetaspaceOutOfMemoryDemo { // 静态类 static class OOMTest { } public static void main(final String[] args) { // 模拟计数多少次以后发生异常 int i =0; try { while (true) { i++; // 使用Spring的动态字节码技术 Enhancer enhancer = new Enhancer(); enhancer.setSuperclass(OOMTest.class); enhancer.setUseCache(false); enhancer.setCallback(new MethodInterceptor() { @Override public Object intercept(Object o, Method method, Object[] objects, MethodProxy methodProxy) throws Throwable { return methodProxy.invokeSuper(o, args); } }); } } catch (Exception e) { System.out.println("发生异常的次数:" + i); e.printStackTrace(); } finally { } } } ``` 会出现以下错误: 发生异常的次数: 201 ```` java.lang.OutOfMemoryError:Metaspace ```` ### 注意 - 在JDK1.7之前:永久代是方法区的实现,存放了运行时常量池、字符串常量池和静态变量等。 - 在JDK1.7:永久代是方法区的实现,将字符串常量池和静态变量等移出至堆内存。运行时常量池等剩下的还再永久代(方法区) 在JDK1.8及以后:永久代被元空间替代,相当于元空间实现方法区,此时字符串常量池和静态变量还在堆,运行时常量池还在方法区(元空间),元空间使用的是直接内存。 - -XX:MetaspaceSize=N//设置Metaspace的初始(和最小大小) - -XX:MaxMetaspaceSize=N//**设置Metaspace的最大大小 与永久代很大的不同就是,如果不指定大小的话,随着更多类的创建,虚拟机会耗尽所有可用的系统内存**。

优秀的个人博客,低调大师

10行命令60秒快速定位性能瓶颈

今天为大家翻译一篇来自Netflix技术博客的Linux Performance Analysis in 60,000 Milliseconds,作者是著名linux内核工程师&性能优化专家Brendan D. Gregg和Netflix性能团队。这篇文章会教你怎么用10个常用的linux工具在60秒内完成对性能问题的初步诊断。 当你登录到linux服务器处理性能问题的时候,最开始的一分钟你会做些啥? Netflix有大量的EC2云服务主机,也有很多检测和排查性能问题的工具。比如像云监控工具Atlas和实例分析工具Vector。这些工具帮我们解决了大部分性能问题,但有时候我们仍需要登录到服务器上运行一些标准的Linux性能排查工具。 综述 在这篇文章中,Netflix团队将展示如何用你随手可及的Linux命令行工具在60s内完成一次性能问题排查。通过以下10个命令,你可以在60秒内对系统的资源使用率和进程运行状况有个整体的了解。首先查看错误和饱和度指标,因为这两者都很容易理解,其次就是查看资源利用率。饱和度是指资源的负载是否超过了它所能承受的负载,这个指标可以反映出出任务队列长度情况或者是任务等待时间的情况。 uptime dmesg | tail vmstat 1 mpstat -P ALL 1 pidstat 1 iostat -xz 1 free -m sar -n DEV 1 sar -n TCP,ETCP 1 top 注意,有些命令需要安装sysstat包。这些命令暴露出来的数据可以帮你完成一次性能优化方法学的实践,这套方法学包括检查所有系统资源(cpu、内存、磁盘……)的使用率、饱和度和错误指标。这些命令也能让你检查所有的地方,通过排除法缩小排查范围,为后续分析指明方向。 文章接下来的部分会介绍这些命令,并给出实际的例子。关于这些命令更详细的介绍请参考相关手册。 1. uptime $ uptime 23:51:26 up 21:31, 1 user, load average: 30.02, 26.43, 19.02 uptime可以快速看到系统的平均负载情况。在Linux中,这些数字表示平均每秒钟处于运行态、可执行态和不可中断状态(通常是磁盘IO)的任务数量。这些数据可以让我们对整个系统资源有个整体的认识,但没有其他工具我们依旧没法理解根因,不过uptime依旧很值得快速瞄一眼。 那这三个数字究竟是什么含义呢!其实这三个数字分别表示1分钟、5分钟、15分钟内的平均负载情况,是通过过去某个时间窗口的数据通过指数衰减求和得到的。这三个数字可以让你了解到过去某段时间的负载状况。比如,如果你上线查性能问题,你看到load1远低于load15,那你可能已经错过这次性能问题了。 在上面的例子中,负载一直在增长,load1已经到30了,而load15只有19,这给了我们很重要的信息,有可能是CPU使用率高了,还得用vmstat和mpstat确认下,这两个命令我们会在3和4中介绍。 2. dmesg|tail $ dmesg | tail [1880957.563150] perl invoked oom-killer: gfp_mask=0x280da, order=0, oom_score_adj=0 [...] [1880957.563400] Out of memory: Kill process 18694 (perl) score 246 or sacrifice child [1880957.563408] Killed process 18694 (perl) total-vm:1972392kB, anon-rss:1953348kB, file-rss:0kB [2320864.954447] TCP: Possible SYN flooding on port 7001. Dropping request. Check SNMP counters. 如果有的话,这条命令将会展示系统最近的10条信息。 找出其中可能导致性能问题的错误。上面这个例子中包含一条因为oom导致进程被kill和tcp丢请求的信息。 不要跳过这步,dmesg非常值得查看。 3. vmstat 1 $ vmstat 1 procs ---------memory---------- ---swap-- -----io---- -system-- ------cpu----- r b swpd free buff cache si so bi bo in cs us sy id wa st 34 0 0 200889792 73708 591828 0 0 0 5 6 10 96 1 3 0 0 32 0 0 200889920 73708 591860 0 0 0 592 13284 4282 98 1 1 0 0 32 0 0 200890112 73708 591860 0 0 0 0 9501 2154 99 1 0 0 0 32 0 0 200889568 73712 591856 0 0 0 48 11900 2459 99 0 0 0 0 32 0 0 200890208 73712 591860 0 0 0 0 15898 4840 98 1 1 0 0 ^C vmstat是有个广泛存在于各类linux系统中的命令(几十年前为BSD所创造的),可以展出虚拟内存相关的概要信息,每一行都是服务器虚拟内存的关键统计信息。 后面的参数1表示每隔1秒输出一次。注意,输出的第一行是自系统启动以来的数据,而不是前一秒的,所以可以跳过第一行数据。 每列的含义 r: 正在运行和等待运行的进程数量。这个指标可以比load更好的揭示出CPU的负载情况,因为这里不包含I/O进程。如果r值大于CPU核数说明CPU已经饱和。 free: 空闲内存的容量(单位kB),如果数字多的数不清说明你还有很多空闲内存可用。在下文第7条中的free -m命令可以更直观看到空闲内存情况。 si,so: swap分区的换进和换出。如果数字不是0说明你内存已经不够了,开始使用swap分区了。 us,sy,id,wa,st: 这些是CPU平均使用时长的细致划分,分别是用户时长、系统时长(内核)、空闲时长、等待IO时长、被盗用时长(被其他访客或者Xen盗用,访客有自己独立的驱动域)。 对CPU时间(用户时长+系统时长)的细致划分可以确认CPU是否繁忙。如果等待IO时长搞定不变,说明磁盘IO是瓶颈。这也能解释为什么CPU是空闲的,因为任务都因为等待IO被阻塞掉了。所以你可以将等待I/O看作是CPU空闲的另一种形式,它提供了有关为什么它们是空闲的线索。 对于IO型的进程,系统时长非常重要,如果平均系统时长超过20%就很值得深入探究下了,这可能说明内核IO处理很低效。 上面的例子中,CPU几乎都被用户态所占用,平均CPU利用率也超过90%,这通常没什么大问题,还是重点关注下r这列数据吧。 4. mpstat -P ALL 1 $ mpstat -P ALL 1 Linux 3.13.0-49-generic (titanclusters-xxxxx) 07/14/2015 _x86_64_ (32 CPU) 07:38:49 PM CPU %usr %nice %sys %iowait %irq %soft %steal %guest %gnice %idle 07:38:50 PM all 98.47 0.00 0.75 0.00 0.00 0.00 0.00 0.00 0.00 0.78 07:38:50 PM 0 96.04 0.00 2.97 0.00 0.00 0.00 0.00 0.00 0.00 0.99 07:38:50 PM 1 97.00 0.00 1.00 0.00 0.00 0.00 0.00 0.00 0.00 2.00 07:38:50 PM 2 98.00 0.00 1.00 0.00 0.00 0.00 0.00 0.00 0.00 1.00 07:38:50 PM 3 96.97 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00 3.03 [...] 这个命令把每个CPU核的细致划分出来,从这份数据中可以看出CPU核心负载是否均衡,如果单个CPU核心出现热点说明有单线程的应用。 5. pidstat 1 $ pidstat 1 Linux 3.13.0-49-generic (titanclusters-xxxxx) 07/14/2015 _x86_64_ (32 CPU) 07:41:02 PM UID PID %usr %system %guest %CPU CPU Command 07:41:03 PM 0 9 0.00 0.94 0.00 0.94 1 rcuos/0 07:41:03 PM 0 4214 5.66 5.66 0.00 11.32 15 mesos-slave 07:41:03 PM 0 4354 0.94 0.94 0.00 1.89 8 java 07:41:03 PM 0 6521 1596.23 1.89 0.00 1598.11 27 java 07:41:03 PM 0 6564 1571.70 7.55 0.00 1579.25 28 java 07:41:03 PM 60004 60154 0.94 4.72 0.00 5.66 9 pidstat 07:41:03 PM UID PID %usr %system %guest %CPU CPU Command 07:41:04 PM 0 4214 6.00 2.00 0.00 8.00 15 mesos-slave 07:41:04 PM 0 6521 1590.00 1.00 0.00 1591.00 27 java 07:41:04 PM 0 6564 1573.00 10.00 0.00 1583.00 28 java 07:41:04 PM 108 6718 1.00 0.00 0.00 1.00 0 snmp-pass 07:41:04 PM 60004 60154 1.00 4.00 0.00 5.00 9 pidstat ^C pidstat有点像top命令关于每个进程的统计,和top命令不同的是它是滚动输出而不是清屏输出,这种模式可以很方便看过去的变化情况,也可以很方便的复制粘贴在你排查过程中。 上面的例子中,有两个java进程消耗了大量的CPU,1591%说明这个java进程占用了将近16个核心。 6. iostat -xz 1 $ iostat -xz 1 Linux 3.13.0-49-generic (titanclusters-xxxxx) 07/14/2015 _x86_64_ (32 CPU) avg-cpu: %user %nice %system %iowait %steal %idle 73.96 0.00 3.73 0.03 0.06 22.21 Device: rrqm/s wrqm/s r/s w/s rkB/s wkB/s avgrq-sz avgqu-sz await r_await w_await svctm %util xvda 0.00 0.23 0.21 0.18 4.52 2.08 34.37 0.00 9.98 13.80 5.42 2.44 0.09 xvdb 0.01 0.00 1.02 8.94 127.97 598.53 145.79 0.00 0.43 1.78 0.28 0.25 0.25 xvdc 0.01 0.00 1.02 8.86 127.79 595.94 146.50 0.00 0.45 1.82 0.30 0.27 0.26 dm-0 0.00 0.00 0.69 2.32 10.47 31.69 28.01 0.01 3.23 0.71 3.98 0.13 0.04 dm-1 0.00 0.00 0.00 0.94 0.01 3.78 8.00 0.33 345.84 0.04 346.81 0.01 0.00 dm-2 0.00 0.00 0.09 0.07 1.35 0.36 22.50 0.00 2.55 0.23 5.62 1.78 0.03 [...] ^C iostat是查看块设备负载和性能信息最好用的工具,可以查看以下信息: r/s, w/s, rkB/s, wkB/s: 设备每秒的读、写次数和读、写数据量(kB)。这些指标可以量化IO设备负载,有些性能问题可能就是因为负载过高导致的。 await: 等待IO的毫秒数。这是应用程序所感受到的时间,包括排队时间和等待时间。如果超过平均预期时间说明设备已饱和或者设备故障。 avgqu-sz: 设备的平均请求数。如果值大于1可能是设备已饱和(尽管设备通常可以并行操作请求,特别是位于多个后端磁盘前的虚拟设备)。 %util: 设备的使用率。这是设备真实忙碌的时间比例,展示了每秒设备实际工作的时间。超过60%可能导致设备性能降低,当然这也取决于设备自身。接近100%说明设备已经饱和了。 如果存储设备只是由多块磁盘组成的逻辑设备,100%的利用率也仅仅意味着100%的时间用来处理IO了,后端物理磁盘远远没有达到它们所能处理的性能极限。 请记住,磁盘I/O性能差不一定导致应用程序出问题。许多技术通常使用了异步I/O,这样应用程序就不会被阻塞也感受不到延迟(例如,预读和写Buffer)。 7. free -m $ free -m total used free shared buffers cached Mem: 245998 24545 221453 83 59 541 -/+ buffers/cache: 23944 222053 Swap: 0 0 0 最右边有两列buffers和cached buffers: 缓冲区,用于块设备IO。 cached: 内存页缓存,用在文件系统。 我们只需要检查下它们的大小是否接近于0,接近0可能导致更高的磁盘I/O(使用iostat进行确认)和更差的性能。上面的例子看起来很好,每一项都有很多兆。 “-/+ buffers/cache” 为已使用和空闲内存大小提供了明确的值。linux用空闲内存作为cache,如果应用需要更多内存也可以很快释放掉,所以cached部分的内存也应当包含在free列里,这一行数据就是这样,这里可能让人摸不着头脑,更详细内容可以查看这个网页linuxatemyram.com/。 如果linux系统用了ZFS会更让人迷惑,因为ZFS有自己的文件系统缓存,free -m 并不能反映出这些文件缓存的大小。所以可能出现看起来内存不足,但实际上可以按需从ZFS cache里释放一些内存。 8. sar -n DEV 1 $ sar -n DEV 1 Linux 3.13.0-49-generic (titanclusters-xxxxx) 07/14/2015 _x86_64_ (32 CPU) 12:16:48 AM IFACE rxpck/s txpck/s rxkB/s txkB/s rxcmp/s txcmp/s rxmcst/s %ifutil 12:16:49 AM eth0 18763.00 5032.00 20686.42 478.30 0.00 0.00 0.00 0.00 12:16:49 AM lo 14.00 14.00 1.36 1.36 0.00 0.00 0.00 0.00 12:16:49 AM docker0 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00 12:16:49 AM IFACE rxpck/s txpck/s rxkB/s txkB/s rxcmp/s txcmp/s rxmcst/s %ifutil 12:16:50 AM eth0 19763.00 5101.00 21999.10 482.56 0.00 0.00 0.00 0.00 12:16:50 AM lo 20.00 20.00 3.25 3.25 0.00 0.00 0.00 0.00 12:16:50 AM docker0 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00 ^C 这个命令可以查看网络吞吐量,rxkB/s和txkB/s,可以度量工作负载,也可以查看是否达到了限制。在上面的例子中,eth0接收达到了22MB/s,也就是176Ms/S(远低于1Gb/s的限制)。 这个版本也有个%ifutil来表示设备利用率(全双工的两个方向的最大值),我们用Brendan的nicstat也可以查看。就像使用nicstat一样,很难得到正确的结果,而且在本例中似乎不能正常工作(0.00)。 9. sar -n TCP,ETCP 1 $ sar -n TCP,ETCP 1 Linux 3.13.0-49-generic (titanclusters-xxxxx) 07/14/2015 _x86_64_ (32 CPU) 12:17:19 AM active/s passive/s iseg/s oseg/s 12:17:20 AM 1.00 0.00 10233.00 18846.00 12:17:19 AM atmptf/s estres/s retrans/s isegerr/s orsts/s 12:17:20 AM 0.00 0.00 0.00 0.00 0.00 12:17:20 AM active/s passive/s iseg/s oseg/s 12:17:21 AM 1.00 0.00 8359.00 6039.00 12:17:20 AM atmptf/s estres/s retrans/s isegerr/s orsts/s 12:17:21 AM 0.00 0.00 0.00 0.00 0.00 ^C 这个命令可以查看tcp指标数据,包括: active/s: 每秒钟本地发起的主动连接数(比如调用 connect())。 passive/s: 每秒钟收到的远程被动连接数(比如调用accept())。 retrans/s: 每秒钟tcp重传数。 主动和被动连接数通常可以作为服务器负载的粗略度量:新接受连接的数量(被动)和下游连接的数量(主动)。可以简单将active视为出,将passive视为入,但这并不完全正确(例如,localhost发起到localhost的连接)。 重传数可以看做是网络或者服务问题的一个信号,可能是网络不可靠(比如公网),或者是因为服务已经过载而导致的丢包。上面这个例子中每秒只有一个新建连接。 10. top $ top top - 00:15:40 up 21:56, 1 user, load average: 31.09, 29.87, 29.92 Tasks: 871 total, 1 running, 868 sleeping, 0 stopped, 2 zombie %Cpu(s): 96.8 us, 0.4 sy, 0.0 ni, 2.7 id, 0.1 wa, 0.0 hi, 0.0 si, 0.0 st KiB Mem: 25190241+total, 24921688 used, 22698073+free, 60448 buffers KiB Swap: 0 total, 0 used, 0 free. 554208 cached Mem PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND 20248 root 20 0 0.227t 0.012t 18748 S 3090 5.2 29812:58 java 4213 root 20 0 2722544 64640 44232 S 23.5 0.0 233:35.37 mesos-slave 66128 titancl+ 20 0 24344 2332 1172 R 1.0 0.0 0:00.07 top 5235 root 20 0 38.227g 547004 49996 S 0.7 0.2 2:02.74 java 4299 root 20 0 20.015g 2.682g 16836 S 0.3 1.1 33:14.42 java 1 root 20 0 33620 2920 1496 S 0.0 0.0 0:03.82 init 2 root 20 0 0 0 0 S 0.0 0.0 0:00.02 kthreadd 3 root 20 0 0 0 0 S 0.0 0.0 0:05.35 ksoftirqd/0 5 root 0 -20 0 0 0 S 0.0 0.0 0:00.00 kworker/0:0H 6 root 20 0 0 0 0 S 0.0 0.0 0:06.94 kworker/u256:0 8 root 20 0 0 0 0 S 0.0 0.0 2:38.05 rcu_sched top命令中包含很多我们前面已经提到过的指标,可以方便地运行它来查看指标的变化。 top的一个缺点是,top不像vmstat和pidstat等提供滚动输出的工具一样,它看不到之前的数据。如果你没有足够快地暂停输出(Ctrl-S暂停,Ctrl-Q继续),屏幕上的数据就会被清除,你很难截取到证据。 后续分析 还有很多命令行工具和方法可以深入挖掘,参见Brendan的Linux性能工具指南,里面列出了超过40种工具,包含了观测、基准测试、调优、静态性能调优、概要分析和追踪。

优秀的个人博客,低调大师

利用Wrap Shell Script定位Android Native内存泄漏

前提条件 Android版本为8.0以上 环境配置 cd到/src/main目录下,新建shell目录,同时shell目录下配置与libs目录下相同平台的目录,如下app下的层级结构,可看到shell/lib下具有与libs下相同的平台目录结构 ── AndroidManifest.xml ├── java ├── libs │ ├── arm64-v8a │ └── armeabi-v7a ├── main.iml ├── res └── shell └── lib ├── arm64-v8a └── armeabi-v7a 分别在shell/lib/目录下建立一个wrap.sh脚本文件,编辑wrap.sh文件并写入如下内容 #!/system/bin/sh LIBC_DEBUG_MALLOC

优秀的个人博客,低调大师

Kubernetes 应用故障的一些定位方法

常备工作 准备一个工具镜像 其中包含 nslookup, ping, curl, 甚至是 ab、siege 等常用工具以及一个顺手的 Shell。一言不合就可以用静态 Pod 的方式将其运行到 Kubernetes 之中进行内部诊断。 sysctl -a | grep forwarding 你猜这是干啥的? 服务状态查询 各个 Kubernetes 组件的状态检查。可以使用 Ansible 之类的工具进行快速查询。 Service 不通 这里我们首先假设 Pod 工作正常 目前我们的应用均采用的是 NodePort 模式对外提供服务: 逻辑:Service 将 符合其选择器的 Pod 暴露的端口 从 各个 Node 的同一端 口暴露出来对外进行监听。 技术:Kube-proxy 通过网络插件,一般利用 Iptables vxLan 等乌七八糟的蜜汁技术,完成对外服务负载均衡,并分发给各个 Pod 的内部 IP 的相应端口。 前面我们假设 Pod 是正常工作的,因此,这里只考虑 Service 的情况。 通过上面的陈述我们能看到大致的一些要素,下面从内向外进行列表: Pod 能够正常工作 见后文 Service 的选择器能够正确的找到 Pod 这里我们可以使用kubectl describe svc panic-service命令,查看输出内容的endpoint一节内容,如果其中有 Pod 地址,也就说明选择器和 Pod 的标签是匹配的。如果为空,则需要对服务或者 Pod Controller 的定义进行排查。 Proxy 的工作状态 首先可以使用systemctl -l Kube-proxy来查看服务状况。 还可以使用其他 Node 的同一端口测试访问,看是否单一节点的故障。 DNS 工作状态 Kubectl 查看 DNS 各个 Pod 的存活状态。 利用上面提到的工具 Pod 尝试解析服务。失败了其实也没啥办法,删 DNS Pod 重启吧。 端口是否定义正确 看 Pod 的端口是否能够正确侦听,是否符合服务定义。例如 Service 定义了到 Pod 8080 端口的访问,而 Pod 开放的却是 80,这样的情况跟标签无法匹配一样,是很常见的问题。 说完了服务,我们来说说 Pod 两个顺手的命令: kubectl get po -o wide | grep -v Running kubectl describe po unhealthy 一般来说,一个行为端正的 Pod,应该是以 Running 状态持续运行的。在进入 Running 之前,大致有调度、创建、初始化等几个环节,如果正常运行之后出了故障,会发生重启。如果在启动容器内进程时出现问题,则会进入 CrashLoopBackOff 的状态。 除了 Running/Complet 以及 CrashLoopBackOff: 这几种情况其实不同,不过随性写到这,就不深究了,首先是 describe 一下。 Pod 启动有几个条件: 有符合要求的节点供其运行 Taint 隔离的节点,要求 Pod 有显式声明对该种 Taint 的容错能力,才可以在其上运行。 节点和 Pod 的亲和性定义 Node Selector 的定义 符合其需求的资源 CPU 和 内存的 request limit 定义 可能存在的第三方资源需求定义 加载卷(nfs gluster ceph 等)/Secret/Configmap 的定义 镜像必须存在,可 Pull 调度部分一般来说查看 Pod 定义,和节点的 Describe 进行匹配即可,Describe 内容中也会明确说出无合适 Pod。 资源部分 CPU 和内存的 Describe 结果也会很明显。 存储部分,往往就需要更复杂的排查: 首先看看是不是每个 Node 都如此。 是否安装了对应的客户端驱动。 对分布式存储的访问网络是否可用。 存储服务容量是否足够分配。 是否能够成功的手工 Mount。 至于对 ConfigMap 和 Secret 的依赖,很简单,Kubectl 查询即可。 CrashLoopBackOff 以及 Restart 大于 1 这种情况一般来说属于业务内部的问题,可以通过 kubectl logs -f 命令进行查看,目前经验比较多的非业务情况是: 对于 Kubernetes API 进行访问的应用,经常会是因为RBAC 权限不足导致无法启动 依赖的 Service 无法访问。 本文转自中文社区- Kubernetes Informer 详解

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册