首页 文章 精选 留言 我的

精选列表

搜索[云客服],共10000篇文章
优秀的个人博客,低调大师

关于接口可维护性的一些建议 | 京东技术团队

作者:D瓜哥 在做新需求开发或者相关系统的维护更新时,尤其是涉及到不同系统的接口调用时,在可维护性方面,总感觉有很多地方差强人意。一些零星思考,抛砖引玉,希望引发更多的思考和讨论。总结了大概有如下几条建议: 在接口注释中加入接口文档链接 将调用接口处写上被调用接口文档链接 将接口源代码发布到私服仓库 对于状态值常量,优先在接口参数类或者返回值类中定义 如果使用 Map 对象作为传输载体,要提供 Key 值定义常量 针对 Map 返回值,可以考虑使用将 Map 转化成对象 尽可能简化接口依赖 只传递必要字段,尽量避免大而全的接口 将接口的参数和返回值原始数据打印到日志中 将 RPC 接口的类名及方法打印到日志中 核心思想:以人为本,就近原则,触手可及 下面,D瓜哥对每一条建议做一个详细说明。 1. 在接口注释中加入接口文档链接 在做接口开发时,无论是对自有接口的升级改造,还是针对外部接口的从头接入,都涉及到接口文档。不同之处是,前者的工作重点是书写或者更新接口文档;而后者是根据接口文档开发合适的接入代码。但是,经常遇到的一个麻烦是,找不到接口文档。在组内需要找老同事询问;如果是跨部门,还需要两层甚至三层的进行转接,非常麻烦。 D瓜哥认为,在这种情况下,为了方便大家维护,最好的办法就是将接口文档链接直接放在代码注释中,这样后续维护的人员,直接就可以点击链接直达接口文档,简单方便高效。如果是新建的接口,就可以先创建一个空文档,把链接放在注释中,后续再书写文档内容。如果是维护已有接口,可以在维护时,将缺失的链接加入到注释中,自己方便,也方便其他人进行后续的维护更新。这样,在循序渐进的过程中,逐步就可以把文档链接补充到代码中,方便维护代码,也同步更新文档。 2. 将调用接口处写上被调用接口文档链接 在调用其他系统的接口时,没有接口文档,几乎寸步难行。在第一次接入接口时,绝大多数情况下,都是参考着接口文档做接入工作。但是,目前的情况时,接入时参考文档,参考完就随手把文档给“扔了”。后续如果还需要做进一步升级维护,还需要到处找接口文档;另外,交互的系统难免有一些 Bug,在和其他系统维护人员对接处理 Bug 时,只有接口没有文档,对方可能也需要去找文档链接。无形中,很多时间都浪费在了找文档的过程中。 D瓜哥最近尝试了一个实践,就是在接口调用的地方,把接口文档链接当做注释加入到代码中。这样,无论是后续维护升级,还是沟通协调处理问题,都非常方便。别人问接口是什么,连接口+文档都可以一把复制就搞定。 经过最近一段时间的实践情况来看,这个处理非常方便,是一个非常值得推广的实践。再插一句,也可以像一条建议一样,可以在维护代码时,不断把已接入的接口文档加入到调用接口的地方,循序渐进,方便后续人维护升级。 3. 将接口源代码发布到私服仓库 接口文档链接在注释中,在构建结果中就不复存在了。所以,为了方便接口使用方可以在接口中查询到对应的接口文档,就需要把源码也发布到私服仓库中。 这里只说明一下 Java 的相关处理办法。如果使用 Maven 作为构建工具的话,默认是不会将源代码发布到私服仓库中的。关于如何将源代码发布到,在 升级 Maven 插件:将源码发布到私服仓库 中已经做过相关介绍,这里就不再赘述。 除了将源码发布到私服仓库,另外,还建议编译构建时,保持方法的原始参数命名。这个也可以通过配置 Maven 插件来完成,具体配置见: 升级 Maven 插件:字节码文件包含原始参数名称。 4. 对于状态值常量,优先在接口参数类或者返回值类中定义 在做接口开发时,很多数据都有一个状态值,比如订单状态,再比如接口状态等等。目前的一个情况时,这些状态值大部分书写在文档中,在接入接口时,需要接入方自定义这些状态值。这就有些繁琐了,而且状态定义也不明确,甚至有可能遗漏一些重要的状态值。有些懒省事,直接在代码中硬编码一个魔法值,后续维护的跟还需要根据上下文反推这个值的含义,非常不利于维护。 D瓜哥个人觉得,有两个处理办法: 如果状态值不是很多,优先在接口参数类或者返回值类中定义。 如果状态值很多,可以考虑单独抽取成一个常量类或者枚举类。 这样使用的时候,触手可及。不需要到处去找。 5. 如果使用 Map 对象作为传输载体,要提供 Key 值定义常量 有些系统可能考虑方便增加字段,选择使用 Map 作为数据载体。自己开发的时候很爽,但是给接口接入却非常不友好。接入方从 Map 中获取数据时,要么自己定义 Key 值;要么直接使用魔法值硬编码在代码中。使用前者方案,就需要在各个接入方都需要自定义一套;使用后者,初期是省事了,后来维护的人员就懵逼了。这都无形中增加了很多维护成本。 D瓜哥觉得一个方案更优,那就是直接由接口提供方来定义这些可以取值的 Key 值常量。这样,任何接入方都可以直接使用这些常量。 6. 针对 Map 返回值,可以考虑使用将 Map 转化成对象 针对 Map 的处理,即使按照 如果使用 Map 对象作为传输载体,要提供 Key 值定义常量 推荐的做法,定义了相关的 Key,在取值时,也略有麻烦,需要不断的 map.get(KEY)。一个更简单的方法是自定义一个类型,使用工具将 Map 对象转化成自定义类型的对象。这样就可以直接使用方法调用来取值。 在 Java 中,可以直接使用 Jackson 来完成这个转换工作。工具类代码如下: import com.fasterxml.jackson.databind.DeserializationFeature; import com.fasterxml.jackson.databind.ObjectMapper; import lombok.extern.slf4j.Slf4j; import org.apache.commons.collections.CollectionUtils; import java.util.*;java /** * Map 工具类 * * @author D瓜哥 · https://www.diguage.com */ @Slf4j public class MapUtils { private static final ObjectMapper MAPPER = new ObjectMapper(); static { MAPPER.configure(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES, false); } /** * 将 Map 转换成指定类型的对象 * * @author D瓜哥 · https://www.diguage.com */ public static <T> T convertToObject(Map<String, Object> data, Class<T> clazz) { try { T result = MAPPER.convertValue(data, MAPPER.getTypeFactory().constructType(clazz)); if (log.isInfoEnabled()) { log.info("converted {} to a {} object: {}", JsonUtils.toJson(data), clazz.getSimpleName(), JsonUtils.toJson(result)); } return result; } catch (Exception e) { log.error("converting failed! data: {}, class: {}", JsonUtils.toJson(data), clazz.getSimpleName(), e); } return null; } /** * 将 Map 转换成指定类型的对象 * * @author D瓜哥 · https://www.diguage.com */ public static <T> List<T> convertToObjects(List<Map<String, Object>> datas, Class<T> clazz) { if (CollectionUtils.isEmpty(datas) || Objects.isNull(clazz)) { return Collections.emptyList(); } List<T> result = new ArrayList<>(datas.size()); if (CollectionUtils.isNotEmpty(datas)) { for (Map<String, Object> data : datas) { T t = convertToObject(data, clazz); result.add(t); } } return result; } } 7. 尽可能简化接口依赖 现在,很多对外暴露接口的定义是,接口定义放在一个模块中;模型定义在一个模块中;有些工具类又定义在一个模块中。接口依赖模型模块;模型模块又依赖工具类模块;而工具类依赖了一大堆外部依赖。个人觉得这是一个非常不好的实践。会导致很多不必要的依赖被间接引入到了接口使用方的系统中,无形中增加很多维护成本。 D瓜哥推荐的一个实践是:将接口和模型定义放在一个模块中,对外暴露也只需要这一个模块即可。接口使用方只需要引入这一个依赖。避免引入很多无用的其他外部依赖。如果模型需要依赖一些公共的父类,可以考虑将这些单独定义在一个模块中,这个模块只保存多个系统依赖的公共类,并且剔除掉一些工具类的定义,这样就可以保证接口依赖的纯净性。如果其他系统需要工具类,让其明确去引入,而不是被动依赖。 对于前面 对于状态值常量,优先在接口参数类或者返回值类中定义 中提到了“如果状态值很多,可以考虑单独抽取成一个常量类或者枚举类。” 这里存在一种情况需要特别说明,状态值的定义需要在本系统的业务模块的代码中使用,可以将接口的依赖加入到改业务模块的依赖中,而不是反过来。为什么会这样的操作?一个核心思想是保持对外暴露接口的纯净性。这样既可以减少状态定义的重复性,又可以减少接口的外部依赖。 8. 只传递必要字段,尽量避免大而全的接口 观察很多系统,尤其是一些以业务为核心的系统的对外暴露接口,很多接口是大而全的接口,一个接口就可以把指定数据的所有信息全部返回出去。这样,很多字段需要去识别,也要在众多字段中区筛选出来符合自己要求的数据,无形中浪费了很多心智,不利于维护。 D瓜哥认为,在做接口开发时,一定要做一个“吝啬的守财奴”。把数据当做财富一样守护,对外只提供必要的数据,做到“够用就行”。 这一点不仅仅是维护上的考虑,还有数据传输效率的点。在其他条件相同的情况下,更小的数据,无论是机器处理效率,还是传输效率,都会更快更高。 关于传输效率上的一些思考,结合 Hessian、Msgpack 和 JSON 实例对比 以及 “Hessian 协议解释与实战” 等文章来看,有几个原则值得重视的: 优先使用 boolean 型; boolean 型满足不了,次优选择 int 整型数据;再次可以考虑 long 型; 日期优先使用内置的日期类型(含 Java Time API 类型),而不是格式化成字符串。 对于以上类型不满足,则选择使用字符串。 集合类型,链表优先使用 ArrayList,也可以考虑使用 Iterator;哈希优先使用 HashMap; 以上情况都不符合要求才选择自定义对象。 9. 将接口的参数和返回值原始数据打印到日志中 据观察,一些开发人员没有将接口,尤其是 RPC 接口的参数及返回值打印到日志中。这对定位问题非常不利。说的更直白一点,非常不利于甩锅。当出了问题,不能第一时间就凭借参数及返回值顺利甩锅。可能导致自己花很多时间去排查问题,最后发现是自己依赖的其他系统的问题。 所以,一定要谨记,将接口的参数和返回值原始数据打印到日志中。D瓜哥凭借这个实践,在一些客诉及反馈中,顺利脱身,实现完美甩锅。 10. 将 RPC 接口的类名及方法打印到日志中 D瓜哥也在尝试一个实践:将 RPC 接口的类名和方法,再加上参数或者返回结果,同时打印到日志中。 这里为什么和上面的 将接口的参数和返回值原始数据打印到日志中 单独列出来?因为,在这个实践中,强调的是 “RPC 接口”。相对来说, RPC 接口存在更多容易出错的问题,经常需要脱离系统去单独测试 RPC 接口的可用性。把类名就方法名可以更方便在出现问题时,就可以及时根据日志中的信息,去单独测试 RPC 的可用性。 11. 核心思想:以人为本,就近原则,触手可及 洋洋洒洒总结了这么几条建议。这里做一个总结。 对于可维护性建议的一个核心思想就是:以人为本,就近原则,触手可及。通常来说,人都是有一定的惰性的。如果把饭端到眼前,相信任何正常人无法抗拒美食的诱惑。而这里提到的一些可维护性的点,就是尽可能照顾人“懒”的特性,在第一次时,就把该做的工作做到位,减少后续人员不必要的麻烦,让人可以“合法偷懒”。 加油!争取让更多人可以更好地偷懒。💪🏻💪🏻💪🏻

优秀的个人博客,低调大师

以数据思维和技能提升数据应用测试实践 | 京东技术团队

作者:京东零售 周雪梅 以数据思维和技能提高测试覆盖率和效率。数据应用测试,功能测试主要聚焦在数据流向(输入和输出)。 一、背景 数据质量组当前主要承接黄金眼和商智中的供应链模块,商智包括PC(品牌版:商家端,运营端)和M端。各模块的产品特征和测试范围和策略的通用模式如下图所示,图中灰色部分是待建设中。 从图中可见,产品的数据流向主要包括业务数据、模型数据、后台应用、前台应用四个模块,更细一点数据流向包括以下几步 应用离线(T+1)和实时(大促控制台当日和实时库存)数据加工到app层表中,然后推到ck中; 用户在前台操作确定查询条件后查询,前台会将该查询请求到后台,后台解析出指标维度,查询ck后同步指标结果给前台,然后给用户展示。 二、测试策略 测试策略,首先聚焦在从0到1的测试场景,后面会针对一些特殊场景进行单独的介绍。 1、模型数据 模型数据的测试前提是了解到数据安全和数据时效(特别是deadline时间),策略主要包括探测、功能测试、监控。 探测主要采用自动化的方式,按模式校验输出html的报告。当前完成了分区连续性探测、NULL占比、统计变量、枚举字段的分布三种模式,后续计划加上环比,以及包含部门、金额、数量等供应链涉及的关键字的特殊校验; 1)分区连续性探测识别:分区总数、结束和开始时间的天数差距去识别分区类型,来判断分区是否连续 2)最近三个dt的总数环比(环比差距0.1会自动标红) 3)最近三个dt的NULL占比和环比(NULL环比差距0.1会自动标红) 4)最近三个dt的统计值情况 功能测试主要采用手工和自动化的方式,自动化主要是针对通用的数据属性测试,手工主要是针对业务属性和非通用数据属性的测试。 监控待建设,后续的计划是把探测和功能测试沉淀的自动化沉淀为任务进行频次监控 2、后台测试 后台测试的测试范围主要集中在功能(指标维度的准确性)、性能和安全。 功能(指标维度的准确性),采用手工和自动化回归的方式进行。自动化是依托九数和deeptest平台建设的,流水线的方式自动生成deeptest支持的用例进行回归测试。未来规划是提升接口验证的覆盖率和适应场景。 安全,把安全的测试点建设到后台的功能测试中,权限内可查非权限内不可查。 性能 3、前台测试 前台测试聚焦在数据的输入输出和其他。输入指前台的请求入参是否准确;输出是指前台样式展示和数据取值(即后台接口返回的key和前台展示的映射关系)。其他是指页面兼容性和资源权限等。 1)前台输入测试,现状是采用手工+录制识别的方式验证请求入参是否准确。录制识别的方式采用chrome插件MeterSphere JMX Recorder录制前台请求并导出为jmx文件,录制的方式建议每次改变一个查询条件触发后台查询。对导出的jmx文件进行识别转换为df,利用窗口函数去验证这一请求和上一次请求的不同之处是否只有1处。下面两图分别为文件解析后的df对象和检测入参变化的结果(rank非1的变化数大于等于2就需要细化查看是否有问题,其中变化项change_value,变化数change_n,请求的顺序rank),执行命令#python test_web_input.py jmx文件(autotest-data/公共/前端) 2)前台输出测试范围主要包括页面样式展示、数据映射等。当前在持续建设用例模板。 样式展示主要是文本和数值的展示样式,主要采用人工验证沉淀期望结果,然后自动化回归,采用的cypress(支持接口mock)可视化的测试。当前的建设是梳理包括的数据样式的模式,通过mock的方式快速返回样式下的多场景,如下图可见,接口为输入项,选择接口中包括的样式范围,输出需要多少种测试场景能覆盖所有的样式场景。 数据映射是后台接口中数据和前台展示数据的映射关系正确,主要采用人工验证沉淀期望结果,然后自动化回归,采用的cypress可视化的测试。 3)前台的其它测试,兼容和权限 兼容是浏览器或者手机版本的兼容性测试; 权限包括菜单和数据权限 4、技改 数据应用的技改指数值未变,架构升级。 4.1数据技改 测试方案是新表和老表数据对比结果是否一致,采用的方式有两种,1)hivesql的join;2)差集为空 4.2后台技改 测试方案是新老应用的接口数据是否一致,采用的方式是接口测试。选择入参列表,循环遍历新老接口,对接口返回转换为df,df对比是否一致 三、测试沉淀 自动化沉淀到中coding中,里面包含了数据、后台和前台三个模块。

优秀的个人博客,低调大师

在Bamboo上怎么使用iOS的单元测试 | 京东技术团队

作者:京东零售吴滔 本教程将使用北汽登录模块为例,一步一步和大家一起搭建单元测试用例,并在Bamboo上跑起来,最终测试结果和代码覆盖率会Bamboo上汇总。 模块名称:BQLoginModule,是通过iBiu创建的一个模块工程 一 建立单元测试Bundle ProductName: BQLoginTests 二 测试代码编写 1 配置文件同步 如果我们要在测试代码使用我们在Pod里的类,需要同步 Targets Support Files/Pods-BQLoginTests/Pods-BQLoginTests.debug.xcconfig 文件的内容到 Targets Support Files/Pods-BQLoginUITests/Pods-BQLoginUITests.debug.xcconfig,直接内容copy就成了,只是每次用iBiu安装过后都要做这个操作,后续使用脚本实现同步: 2 测试代码编写 具体的编写我这里就过多介绍了,网上教程一大篇,这里就不多说了,如果没有做性能测试,这里可以把自动生成的 testPerformanceExample 屏蔽掉。 三 运行单元测试 用 command+u,或者菜单(product->test)执行,就能获得结果 结果在这里看: 完成以上操作,基本的单元测试就OK了 下面我们用命令行来跑下单元测试,首先进入工程目录: cd BQLoginModule/Example 执行如下命令: xcodebuild test -UseModernBuildSystem=NO -configuration=Debug -workspace './BQLoginModule.xcworkspace' -scheme "BQLoginModule_Example" -destination 'platform=iOS Simulator,name=iPhone 8,OS=13.2.2' 请大家注意将 workspace/scheme /模拟器信息 修改为自己工程对应信息,就可以看到结果 四 代码覆盖率 1 单元覆盖率 在XCode打开覆盖率统计,我们只打开我们的库做代码覆盖就成了,Xcode 12.4在如下地方: 在Pod里面BQLoginModule设置 BuildSettings 查找 "cov" ,把 以下2项都设置为YES; 然后我们跑下单元测试,就可以看到覆盖率结果了: 2 Bamboo报告 因为我们需要在Bamboo上汇总覆盖率报告,这里我们使用iBiu的一个高级特性:用 Podfile.custom 文件加载通用cocoapods的外网库来使用,具体见图: 这里我们引入2个库: OCMock(单元测试必备的Mock库) XcodeCoverage(覆盖率统计的库) 加入这个文件后,需要使用 iBou重新安装下组件 做如下设置: 这个命令主要是生成XcodeCoverage的环境依赖 env.sh 我们打开文件看下,文件路径如下 env.sh内容如下: 这里 OBJECT_FILE_DIR_normal 和 SRCROOT指向的是我们Example工程,我们是需要对Pods里的BQLoginModule里的代码做单元覆盖,这2个环境变量修改如下: export OBJECT_FILE_DIR_normal ="/Users/cdwutao3/Library/Developer/Xcode/DerivedData/BQLoginModule-fvrzeicgcswucwfgjqweugauzxia/Build/Intermediates.noindex/Pods.build/Debug-iphonesimulator/BQLoginModule.build/Objects-normal" export SRCROOT="/Users/cdwutao3/Desktop/ut/BQLoginModule/BQLoginModule/Classes" 然后在Pods/XcodeCoverage目录新建 xmlout目录,并运行命令: ./getcov -x -s -o xmlout 可以得到如下结果: 还可以查看哪些代码没被覆盖,和Bamboo结果对齐: 完成以上步骤,就完成了本地用命令号完成单元测试的所有步骤,下面我们接着来看要在Bamboo上输出报告需要怎么做。 五 Bamboo操作 1 创建应用 这里要确保对应库和依赖的库 ,给 xn_testdev_ci账号开权限 2 新建流水线 选择 “从零开始创建” 3 配置流水线 基础信息里面的选择如下 需要用到以下四个原子: “下载代码”--大家可先配置使用“下载代码-iBiu”这个原子,我用这个一直使用不成功,所以直接用“下载代码”来手动配置: “自定义脚本”--因为现在iOS的单元测试还没有对应的原子操作,所有我们通过自己写脚本来完成: “单元测试”--你没看错,就是用java的单元测试原子,我们输出的结果和这个原子匹配,所以选他就成了 “GCC代码覆盖率” 其中“单元测试”和“代码覆盖率”的路径是可以修改的,这个可以根据自己的实际路径修改 4 自定义脚本 说明: 1 下载代码和配置iBiu都是自己的命令行来做的,但是需要开始配置下git用户信息 2 开始我用命令行写全部命令,但是Bamboo的命令行规则会导致一些的shell指令的失效,所以我采用把 shell命令 写到文件上传到git仓库,然后执行的方式来完成 3 结果转换会还会用到 ocunit2junit 和 xcpretty 这2个命令,如果这2个命令出错,请联系Bamboo同事协助安装下 4 大家在写shell命令时,不知道文件是否生成,可以多用 ls 来看目录下的文件 5 重点: 为了手动安装iBiu配置,请将本机 ~/Library/Application Support/iBiu/BQLoginModule/下的2个文件 spec_sources 和 pod_setup 上传到git,我是copy到 Example/BQLoginModule/Resource目录下然后上传到git仓库,这个目录可以修改,然后修改对应shell 命令的目录就成了 iBiu建的git仓库默认会过滤一些内容,修改 BQLoginModule 工程目录下的 .gitignore 文件,需要上传xcworkspacedata内容 代码覆盖率设置,XcodeCoverage的说明强调了不要用于AppStore的工程,为了避免线上事故,我们通过命令来设置,不直接在工程里设置: 所以修改xcode的构建命令新加 GCC_INSTRUMENT_PROGRAM_FLOW_ARCS=YES GCC_GENERATE_TEST_COVERAGE_FILES=YES,命令如下: xcodebuild -UseModernBuildSystem=NO -enableCodeCoverage=YES -configuration=Debug GCC_INSTRUMENT_PROGRAM_FLOW_ARCS=YES GCC_GENERATE_TEST_COVERAGE_FILES=YES -workspace "./${moduleName}.xcworkspace" -scheme "${moduleName}_Example" -destination 'platform=iOS Simulator,name=iPhone 8,OS=13.2.2' test 5 Bamboo结果 覆盖率下载地址: 六 脚本汇集 1 本地脚本 以BQLoginModule为例,最终本地脚本命令如下,大家可以重新找到本地目录执行查看效果: git clone --depth=1 https://git.jd.com/BQMobileshop/BQLoginModule.git cd BQLoginModule/Example pod update pwd moduleName="BQLoginModule" testName="BQLoginTests" biu -pod install ./ ls ls ./Pods rm -f "./Pods/Target Support Files/Pods-${testName}/Pods-${testName}.debug.xcconfig" cp -f "./Pods/Target Support Files/Pods-${moduleName}_Example/Pods-${moduleName}_Example.debug.xcconfig" "./Pods/Target Support Files/Pods-${testName}/Pods-${testName}.debug.xcconfig" cat "./Pods/Target Support Files/Pods-${testName}/Pods-${testName}.debug.xcconfig" xcodebuild clean -workspace "./${moduleName}.xcworkspace" -scheme "${moduleName}_Example" xcodebuild -UseModernBuildSystem=NO -enableCodeCoverage=YES -configuration=Debug GCC_INSTRUMENT_PROGRAM_FLOW_ARCS=YES GCC_GENERATE_TEST_COVERAGE_FILES=YES -workspace "./${moduleName}.xcworkspace" -scheme "${moduleName}_Example" -destination 'platform=iOS Simulator,name=iPhone 8,OS=13.2.2' test > utlogfile.txt cat utlogfile.txt |grep ".xcresult" > utlogpath.txt logStr=$(cat ./utlogpath.txt) logPath=${logStr:1} if [ -z "$logPath" ]; then exit 1 fi sed "s/${moduleName}.build\/Debug-iphonesimulator\/${moduleName}_Example.build/Pods.build\/Debug-iphonesimulator\/${moduleName}.build/g" ./Pods/XcodeCoverage/env.sh> cov_env1.txt sed "s/${moduleName}\/Example/${moduleName}\/${moduleName}\/Classes/g" ./cov_env1.txt > cov_env2.txt cp -f ./Pods/XcodeCoverage/env.sh ./Pods/XcodeCoverage/env_bak.sh rm -f ./Pods/XcodeCoverage/env.sh cp ./cov_env2.txt ./Pods/XcodeCoverage/env.sh cat "./utlogfile.txt"|ocunit2junit ls test-reports cp ./cov_env2.txt ./Pods/XcodeCoverage/env.sh mkdir xmlout ./Pods/XcodeCoverage/getcov -x -o xmlout ls ./xmlout/lcov cat "./utlogfile.txt"|xcpretty -t -r html --output testresult/testresult.html ls te 2 Bamboo脚本 Bamboo脚本分成2部分,一个是在Bamboo上执行的脚本 rm -fr "/Users/admin/Library/Application Support/iBiu/BQLoginModule" mkdir "/Users/admin/Library/Application Support/iBiu/BQLoginModule" rm -fr ./BQLoginModule git clone --depth=1 https://git.jd.com/BQMobileshop/BQLoginModule.git cd BQLoginModule/Example cp "./BQLoginModule/Resource/spec_sources" "/Users/admin/Library/Application Support/iBiu/BQLoginModule" cp "./BQLoginModule/Resource/pod_setup" "/Users/admin/Library/Application Support/iBiu/BQLoginModule" ls "/Users/admin/Library/Application Support/iBiu/BQLoginModule" biu -pod install ./ sh UT.sh 脚本剩下部分写入 UT.sh,放在BQLoginModule/Example目录下, 然后上传到git仓库来执行,大家做的时候注意修改变量名称: pwd moduleName="BQLoginModule" testName="BQLoginTests" ls ./Pods rm -f "./Pods/Target Support Files/Pods-${testName}/Pods-${testName}.debug.xcconfig" cp -f "./Pods/Target Support Files/Pods-${moduleName}_Example/Pods-${moduleName}_Example.debug.xcconfig" "./Pods/Target Support Files/Pods-${testName}/Pods-${testName}.debug.xcconfig" cat "./Pods/Target Support Files/Pods-${testName}/Pods-${testName}.debug.xcconfig" xcodebuild clean -workspace "./${moduleName}.xcworkspace" -scheme "${moduleName}_Example" xcodebuild -UseModernBuildSystem=NO -enableCodeCoverage=YES -configuration=Debug GCC_INSTRUMENT_PROGRAM_FLOW_ARCS=YES GCC_GENERATE_TEST_COVERAGE_FILES=YES -workspace "./${moduleName}.xcworkspace" -scheme "${moduleName}_Example" -destination 'platform=iOS Simulator,name=iPhone 8,OS=13.2.2' test > utlogfile.txt cat utlogfile.txt |grep ".xcresult" > utlogpath.txt logStr=$(cat ./utlogpath.txt) logPath=${logStr:1} if [ -z "$logPath" ]; then exit 1 fi sed "s/${moduleName}.build\/Debug-iphonesimulator\/${moduleName}_Example.build/Pods.build\/Debug-iphonesimulator\/${moduleName}.build/g" ./Pods/XcodeCoverage/env.sh> cov_env1.txt sed "s/${moduleName}\/Example/${moduleName}\/${moduleName}\/Classes/g" ./cov_env1.txt > cov_env2.txt cp -f ./Pods/XcodeCoverage/env.sh ./Pods/XcodeCoverage/env_bak.sh rm -f ./Pods/XcodeCoverage/env.sh cp ./cov_env2.txt ./Pods/XcodeCoverage/env.sh cat "./utlogfile.txt"|ocunit2junit ls test-reports cp ./cov_env2.txt ./Pods/XcodeCoverage/env.sh mkdir xmlout ./Pods/XcodeCoverage/getcov -x -o xmlout ls ./xmlout/lcov cat "./utlogfile.txt"|xcpretty -t -r html --output testresult/testresult.html ls test 七 错误速查 这里汇集了在写脚本时的一些错误,方便大家查看 1 不能在测试工程引用自己的代码 请参看 二--1 ”配置文件同步“ 解决 2 在Bamboo上的Pods文件夹,没有拉到iBiu的其他配置信息 请参看 五--4 ”自定义脚本“的重点 1 来解决 3 “No coverage data in result bundle” 请参看 五--4 ”自定义脚本”的重点 2 来解决 4 使用命令行跑单元测试时,一直提示不能找到模拟器 -destination 'platform=iOS Simulator,name=iPhone 8,OS=13.2.2' 改为 -destination 'id=xxxxxxxxxx' 这种格式,id为屏幕提示 5 Bamboo Shell里提示 “未设置原子执行条件” 因为Bamboo的Shell对字符拼接,变量的处理有限制,所以一部分shell命令最好放在文件执行 6 在本地测试时,Pods/XXXXModule的设置项在每次iBiu安装后都会重置 请注意手动修改,或者直接使用脚本运行 7 在本地测试时,代码覆盖率只包含了一部分源码文件,不是全部 请清空 ~/Library/Developer/Xcode/DerivedData 目录再测试一次 8 在Bamboo上发现有些库拉不下来 请确保 对应 库给xn_testdev_ci开了权限 9 覆盖率文件生成不了 请确保XXXTests的版本信息和主工程的XXXXModule_Example的版本信息一致

优秀的个人博客,低调大师

关于并发编程与线程安全的思考与实践 | 京东技术团队

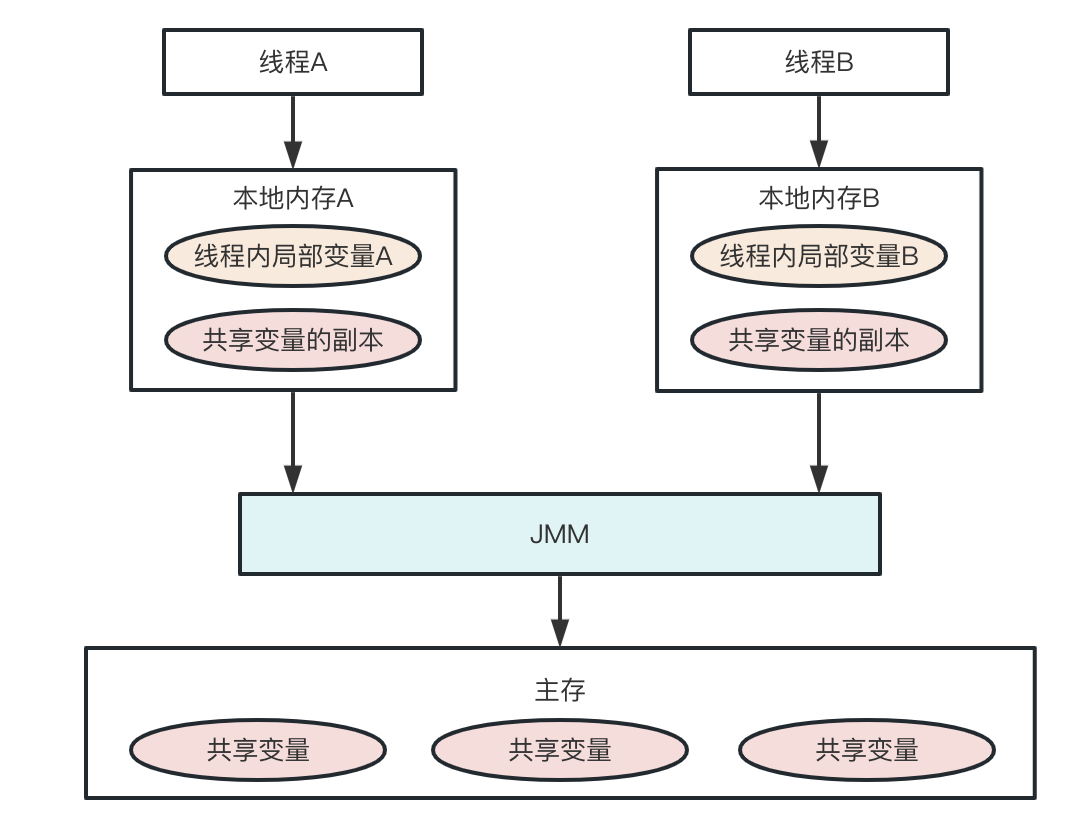
作者:京东健康 张娜 一、并发编程的意义与挑战 并发编程的意义是充分的利用处理器的每一个核,以达到最高的处理性能,可以让程序运行的更快。而处理器也为了提高计算速率,作出了一系列优化,比如: 1、硬件升级:为平衡CPU 内高速存储器和内存之间数量级的速率差,提升整体性能,引入了多级高速缓存的传统硬件内存架构来解决,带来的问题是,数据同时存在于高速缓存和主内存中,需要解决缓存一致性问题。 2、处理器优化:主要包含,编译器重排序、指令级重排序、内存系统重排序。通过单线程语义、指令级并行重叠执行、缓存区加载存储3种级别的重排序,减少执行指令,从而提高整体运行速度。带来的问题是,多线程环境里,编译器和CPU指令无法识别多个线程之间存在的数据依赖性,影响程序执行结果。 并发编程的好处是巨大的,然而要编写一个线程安全并且执行高效的代码,需要管理可变共享状态的操作访问,考虑内存一致性、处理器优化、指令重排序问题。比如我们使用多线程对同一个对象的值进行操作时会出现值被更改、值不同步的情况,得到的结果和理论值可能会天差地别,此时该对象就不是线程安全的。而当多个线程访问某个数据时,不管运行时环境采用何种调度方式或者这些线程如何交替执行,这个计算逻辑始终都表现出正确的行为,那么称这个对象是线程安全的。因此如何在并发编程中保证线程安全是一个容易忽略的问题,也是一个不小的挑战。 所以,为什么会有线程安全的问题,首先要明白两个关键问题: 1、线程之间是如何通信的,即线程之间以何种机制来交换信息。 2、线程之间是如何同步的,即程序如何控制不同线程间的发生顺序。 二、Java并发编程 Java并发采用了共享内存模型,Java线程之间的通信总是隐式进行的,整个通信过程对程序员完全透明。 2.1 Java内存模型 为了平衡程序员对内存可见性尽可能高(对编译器和处理的约束就多)和提高计算性能(尽可能少约束编译器处理器)之间的关系,JAVA定义了Java内存模型(Java Memory Model,JMM),约定只要不改变程序执行结果,编译器和处理器怎么优化都行。所以,JMM主要解决的问题是,通过制定线程间通信规范,提供内存可见性保证。 JMM结构如下图所示:  以此看来,线程内创建的局部变量、方法定义参数等只在线程内使用不会有并发问题,对于共享变量,JMM规定了一个线程如何和何时可以看到由其他线程修改过后的共享变量的值,以及在必须时如何同步的访问共享变量。 为控制工作内存和主内存的交互,定义了以下规范: •所有的变量都存储在主内存(Main Memory)中。 •每个线程都有一个私有的本地内存(Local Memory),本地内存中存储了该线程以读/写共享变量的拷贝副本。 •线程对变量的所有操作都必须在本地内存中进行,而不能直接读写主内存。 •不同的线程之间无法直接访问对方本地内存中的变量。 具体实现上定义了八种操作: 1.lock:作用于主内存,把变量标识为线程独占状态。 2.unlock:作用于主内存,解除独占状态。 3.read:作用主内存,把一个变量的值从主内存传输到线程的工作内存。 4.load:作用于工作内存,把read操作传过来的变量值放入工作内存的变量副本中。 5.use:作用工作内存,把工作内存当中的一个变量值传给执行引擎。 6.assign:作用工作内存,把一个从执行引擎接收到的值赋值给工作内存的变量。 7.store:作用于工作内存的变量,把工作内存的一个变量的值传送到主内存中。 8.write:作用于主内存的变量,把store操作传来的变量的值放入主内存的变量中。 这些操作都满足以下原则: •不允许read和load、store和write操作之一单独出现。 •对一个变量执行unlock操作之前,必须先把此变量同步到主内存中(执行store和write操作)。 2.2 Java中的并发关键字 Java基于以上规则提供了volatile、synchronized等关键字来保证线程安全,基本原理是从限制处理器优化和使用内存屏障两方面解决并发问题。如果是变量级别,使用volatile声明任何类型变量,同基本数据类型变量、引用类型变量一样具备原子性;如果应用场景需要一个更大范围的原子性保证,需要使用同步块技术。Java内存模型提供了lock和unlock操作来满足这种需求。虚拟机提供了字节码指令monitorenter和monitorexist来隐式地使用这两个操作,这两个字节码指令反映到Java代码中就是同步块-synchronized关键字。 这两个字的作用:volatile仅保证对单个volatile变量的读/写具有原子性,而锁的互斥执行的特性可以确保整个临界区代码的执行具有原子性。在功能上,锁比volatile更强大,在可伸缩性和执行性能上,volatile更有优势。 2.3 Java中的并发容器与工具类 2.3.1 CopyOnWriteArrayList CopyOnWriteArrayList在操作元素时会加可重入锁,一次来保证写操作是线程安全的,但是每次添加删除元素就需要复制一份新数组,对空间有较大的浪费。 public E get(int index) { return get(getArray(), index); } public boolean add(E e) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len + 1); newElements[len] = e; setArray(newElements); return true; } finally { lock.unlock(); } } 2.3.2 Collections.synchronizedList(new ArrayList<>()); 这种方式是在 List的操作外包加了一层synchronize同步控制。需要注意的是在遍历List是还得再手动做整体的同步控制。 public void add(int index, E element) { // SynchronizedList 就是在 List的操作外包加了一层synchronize同步控制 synchronized (mutex) {list.add(index, element);} } public E remove(int index) { synchronized (mutex) {return list.remove(index);} } 2.3.3 ConcurrentLinkedQueue 通过循环CAS操作非阻塞的给队列添加节点, public boolean offer(E e) { checkNotNull(e); final Node<E> newNode = new Node<E>(e); for (Node<E> t = tail, p = t;;) { Node<E> q = p.next; if (q == null) { // p是尾节点,CAS 将p的next指向newNode. if (p.casNext(null, newNode)) { if (p != t) //tail指向真正尾节点 casTail(t, newNode); return true; } } else if (p == q) // 说明p节点和p的next节点都等于空,表示这个队列刚初始化,正准备添加节点,所以返回head节点 p = (t != (t = tail)) ? t : head; else // 向后查找尾节点 p = (p != t && t != (t = tail)) ? t : q; } } 三、线上案例 3.1 问题发现 在互联网医院医生端,医生打开问诊IM聊天页,需要加载几十个功能按钮。在2022年12月抗疫期间,QPS全天都很高,高峰时是平日的12倍,偶现报警提示按钮显示不全,问题出现概率大概在百万分之一。 3.2 排查问题的详细过程 医生问诊IM页面的加载属于业务黄金流程,上面的每一个按钮就是一个业务线的入口,所以处在核心逻辑的上的报警均使用自定义报警,该类报警不设置收敛,无论何种异常包括按钮个数异常就会立即报警。 1. 根据报警信息,开始排查,却发现以下问题: (1)没有异常日志:顺着异常日志的logId排查,过程中竟然没有异常日志,按钮莫名其妙的变少了。 (2)不能复现:在预发环境,使用相同入参,接口正常返回,无法复现。 2. 代码分析,缩小异常范围: 医生问诊IM按钮处理分组进行: // 多个线程结果集合 List<DoctorDiagImButtonInfoDTO> multiButtonList = new ArrayList<>(); // 多线程并行处理 Future<List<DoctorDiagImButtonInfoDTO>> multiButtonFuture = joyThreadPoolTaskExecutor.submit(() -> { List<DoctorDiagImButtonInfoDTO> multiButtonListTemp = new ArrayList<>(); buttonTypes.forEach(buttonType -> { multiButtonListTemp.add(appButtonInfoMap.get(buttonType)); }); multiButtonList.addAll(multiButtonListTemp); return multiButtonListTemp; }); 3. 增加日志线上观察 由于并发场景容易引发子线程失败的情况,对各子线程分支增加必要节点日志上线后观察: (1)发生异常的请求处理过程中,所有子线程正常处理完成 (2)按钮缺少个数随机等于子线程中处理的按钮个数 (3)初步判断是ArrayList并发addAll操作异常 4. 模拟复现 使用ArrayList源码模拟复现问题: (1)ArrayList源码分析: public boolean addAll(Collection<? extends E> c) { Object[] a = c.toArray(); int numNew = a.length; ensureCapacityInternal(size + numNew); // Increments modCount //以当前size为起点,向数组中追加本次新增对象 System.arraycopy(a, 0, elementData, size, numNew); //更新全局变量size的值,和上一步是非原子操作,引发并发问题的根源 size += numNew; return numNew != 0; } private void ensureCapacityInternal(int minCapacity) { if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity); } ensureExplicitCapacity(minCapacity); } private void ensureExplicitCapacity(int minCapacity) { modCount++; // overflow-conscious code if (minCapacity - elementData.length > 0) grow(minCapacity); } private void grow(int minCapacity) { // overflow-conscious code int oldCapacity = elementData.length; int newCapacity = oldCapacity + (oldCapacity >> 1); if (newCapacity - minCapacity < 0) newCapacity = minCapacity; if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); // minCapacity is usually close to size, so this is a win: elementData = Arrays.copyOf(elementData, newCapacity); } (2) 理论分析 在ArrayList的add操作中,变更size和增加数据操作,不是原子操作。  (3)问题复现 复制源码创建自定义类,为方便复现并发问题,增加停顿 public boolean addAll(Collection<? extends E> c) { Object[] a = c.toArray(); int numNew = a.length; //第1次停顿,获取当前size try { Thread.sleep(1000*timeout1); } catch (InterruptedException e) { e.printStackTrace(); } ensureCapacityInternal(size + numNew); // Increments modCount //第2次停顿,等待copy try { Thread.sleep(1000*timeout2); } catch (InterruptedException e) { e.printStackTrace(); } System.arraycopy(a, 0, elementData, size, numNew); //第3次停顿,等待size+= try { Thread.sleep(1000*timeout3); } catch (InterruptedException e) { e.printStackTrace(); } size += numNew; return numNew != 0; }  3.3 解决问题 使用线程安全工具 Collections.synchronizedList 创建 ArrayList : List<DoctorDiagImButtonInfoDTO> multiButtonList = Collections.synchronizedList(new ArrayList<>()); 上线观察后正常。 3.4 总结反思 使用多线程处理问题已经变得很普遍,但是对于多线程共同操作的对象必须使用线程安全的类。 另外,还要搞清楚几个灵魂问题: (1)JMM的灵魂:Happens-before 原则 (2)并发工具类的灵魂:volatile变量的读/写 和 CAS 

优秀的个人博客,低调大师

springboot升级过程中踩坑定位分析记录 | 京东技术团队

作者:京东零售李文龙 1.背景 “ 俗话说:为了修复一个小bug而引入了一个更大bug ” 因所负责的系统使用的spring框架版本5.1.5.RELEASE在线上出过一个偶发的小事故,最后定位为spring-context中的一个bug导致的。 为了修复此bug进行了spring版本的升级,最终定的版本为收银台团队使用的版本5.2.12.RELEASE,对应的springboot版本为2.2.12.RELEASE。 选择这个版本的原因是: 1.有团队经过了长时间的线上验证 2.修复了5.1.5.RELEASE对应的bug 2.升级上线 升级相关版本后在预发环境进行了验证,暂未遇到关于框架的问题。本以为安全升级完成,在上线过程中发现在APP中无法访问,此时还未挂载流量。 日志中分析是某些参数未解析到,后在nginx日志中查到相关请求,使用postman模拟请求可以正常使用。 3.分析验证定位原因 1.临时修复 在代码一致的情况下,唯一的可能就只能是线上与预发配置不同,经对比分析得出是某个过滤器的顺序在线上未配置,按照预发的配置后可正常使用。我们暂且称修改的这两个过滤器为M和A, 其中默认情况下执行顺序为M->A,顺序修改为A->M后正常,其两者作用大致为: M : 通用过滤器,解析url中的参数至parameterMap中,并初始化读取了body中的inputstream进行了byte数组的缓存,用于解决重复读取流问题 A: 特定处理器,先是查询parameter中的参数,然后逻辑处理后再设置一些特殊参数。 2.为何需要改过滤器顺序 经查未升级前过滤器的顺序与升级后过滤器顺序一致,为何升级spring框架后需要修改配置。此时猜测可能是spring在升级过程中修改了一部分代码, 但未有头绪,只能先调转方向分析为什么postman和浏览器中的swagger可以正常使用 3.分析nginx日志 前端请求与postman请求的nginx日志进行了分析得出了原因,对比日志如下: postman : POST /shop/bpaas/floor?client&clientVersion&ip=111.202.149.19&gfid=getShopMainFloor&body= 前端 : POST /shop/bpaas/floor HTTP/1.0" 200 634 "-" "api" "0.94" 0.008 0.007 client&clientVersion&ip=111.202.149.17&gfid=getShopMainFloor&body= 经过以上对比发现虽然postman使用了post请求,但数据还是放置在url中,在经过系统的一个内置过滤器M时将url中的参数解析到了parameterMap中,后续过滤器可以使用 request.getParameter获取到,注意此方法是解决问题的关键,此时还未意识到。 4.升级前后框架是否有大的修改 因升级的版本是升级了一个小版本号,所以不好对比升级的buglist,只能慢慢进行分析,后在分析过滤器时发现升级spring后过滤器个数由11个减少到了10个,减少了那一个为: org.springframework.web.filter.HiddenHttpMethodFilter 此过虑器的作用是在浏览器不支持PUT、DELETE、PATCH等method时,可以在form表单中使用隐藏的_method参数支持这几种method。好像跟参数解析没有任何关系, 继续分析升级版本中 (由2.1.3.RELEASE->2.2.12.RELEASE)是否修改了此过滤器的一些内容,后在2.2.0.M5的release notes中发现HiddenHttpMethodFilter相关的: “ Disable auto-configuration of HiddenHttpMethodFilter by default ” github上对应的版本release notes: https://github.com/spring-projects/spring-boot/releases/tag/v2.2.0.M5 也就是说升级后HiddenHttpMethodFilter默认配置由enable修改为了disable,如果再修改回去是不是可以修复参数解析的问题呢? 5.添加过滤器enable配置 因bug修复列表中有对应的issues,所以找到了此过滤器对应的配置: -Dspring.mvc.hiddenmethod.filter.enabled=true 添加后可以正常使用,证明是此过滤器中在某种条件下不可缺少。 6.未升级spring版本时disable验证 在确认未升级版本的spring支持此参数的情况下,添加了以上参数,将默认的启动修改成了禁用,经验证:在不代码修改的情况下,无此过滤器时参数无法解析。证明了上步的猜测。 7.深入源码分析 此时需要分析HiddenHttpMethodFilter过滤器中是否有特殊操作,源码如下: protected void doFilterInternal(HttpServletRequest request, HttpServletResponse response, FilterChain filterChain) throws ServletException, IOException { HttpServletRequest requestToUse = request; if ("POST".equals(request.getMethod()) && request.getAttribute(WebUtils.ERROR_EXCEPTION_ATTRIBUTE) == null) { String paramValue = request.getParameter(this.methodParam); if (StringUtils.hasLength(paramValue)) { String method = paramValue.toUpperCase(Locale.ENGLISH); if (ALLOWED_METHODS.contains(method)) { requestToUse = new HttpMethodRequestWrapper(request, method); } } } filterChain.doFilter(requestToUse, response); } 分析以上源码可以发现,有且只有一种可能,就是request.getParameter可能是解决问题的是关键。 8.大胆猜测 分析后源码猜测,第一步中的修改顺序有可能是A中有调用getParameter,所以顺序调整为A->M后,相当于间接使用了HiddenHttpMethodFilter。 9.开始验证 在不使用HiddenHttpMethodFilter的情况下,如果在过滤器原有顺序不修改的情况下,只要在M执行前调用了request.getParameter,理论上可以正常为使用。所以在debug情况下 利用工具在M过滤器调用前先行执行request.getParameter,发现的确可以正常使用。 10.分析过滤器 先前简述了M的功能,主要是包装了request,后读源码时发现,如果是post请求,读取body体中的数据后并未解析body中的参数至parameterMap中,而代码中的其它过滤器都是 通过request.getParameter获取的数据,重写后的代码: public String getParameter(String name) { if ( this.parameterMap.containsKey(name) ) return this.parameterMap.get(name); else { return super.getParameter(name); } } 在经过request包装后,先是从paremeterMap中获取数据,此时map肯定是没有数据,只能从父类获取,而父类获取时会解析parameter,解析时使用到了inputStream,但M过滤器 的在初始化时解析了输入流,此时tomcat内部使用内部的request获取stream时将获取到空数据,即无法从parameter中获取到body体中的数据。 而如果在调用M前调用了request.getParameter,tomcat内部将提前于M解析parameter,可以保证后续可获取到相关参数。 4. 修复方案 既然得出了结论,那么升级spring版本后修复此bug可选择的方案就比较多了,主要有: 1. 启用HiddenHttpMethodFilter,添加对应的参数,保证升级前后过滤器个数与顺序一致 2. 调整理过滤器A与M的顺序,保证M在A之前执行即可。 3. 修改过滤器M内部的逻辑,不在初始化的时候解析body,或是在解析body后将参数重新放置到parameterMap中。  此文是笔者按照分析流程进行简单验证,分析验证过程中难免有遗漏之处,如有错误遗漏还烦请各位指出共同进步。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册