首页 文章 精选 留言 我的

精选列表

搜索[企业级虚拟化平台],共10000篇文章
优秀的个人博客,低调大师

RDC如何打造支撑百万用户的分布式代码托管平台

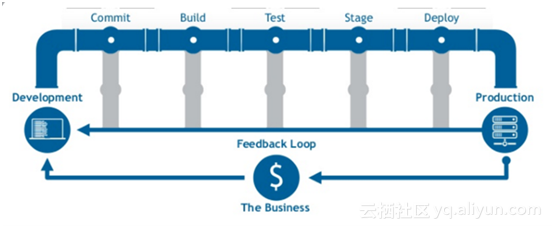
一、背景介绍 毋庸置疑,代码是DevOps流程的起点,是所有研发流程的基础;代码托管为代码“保驾护航”,确保代码的安全性、可用性,同时提供围绕代码的一些基础服务,如MR、Issues等等。 阿里巴巴集团GitLab是基于GitLab社区版8.3版本开发,目前支撑全集团数万规模的研发团队,累计创建数十万项目,日请求量千万级别,存储TB级别,早已超过了GitLab社区版承诺的单机上限能力,且增长速度迅猛。 面对这种情况,顺理成章的做法就是——扩容。然而非常不幸,GitLab的设计没有遵守Heroku推崇的“The Twelve-Factor App”的第四条:“把后端服务当作附加资源”(即对应用程序而言,不管是数据库、消息队列还是缓存等,都应该是附加资源,通过一个url或是其他存储在配置中的服务定位来获取数据;部署应可以按需加载或卸载资源)

优秀的个人博客,低调大师

大规模深度学习优化技术在PAI平台中的应用及实践

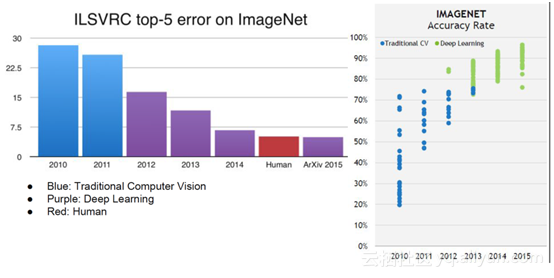
1. 前言 自2012年Deep Learning的代表模型AlexNet在ImageNet大赛中力压亚军,以超过10个百分点的绝对优势夺得头筹之后,依托于建模技术的进步、硬件计算能力的提升、优化技术的进步以及海量数据的累积,Deep Learning在语音、图像以及文本等多个领域不断推进,相较于传统作法取得了显著的效果提升。 工业界和学术界也先后推出了用于Deep Learning建模用途的开源工具和框架,包括Caffe、Theano、Torch、MXNet、TensorFlow、Chainer、CNTK等等。其中MXNet、TensorFlow以及CNTK均对于训练过程提供了多机分布式支持,在相当大程度上解放了DL建模同学的生产力。 但是,DL领域的建模技术突飞猛进,模型复杂度也不断增加。从模型的深度来看,以图像识别领域为例,1

优秀的个人博客,低调大师

在Mac平台上安装配置ELK时的一些总结

一、前言 大数据处理是流行的一些表现,在不断壮大的数据处理中,怎么样处理数据才是我们继续做好开发的正道。本文章来自网络,不敢原创,但是也有很大借鉴。 二、MAC安装ELK 首先是安装elasticsearch,这个很简单: brew install elasticsearch 但是这里就遇到了问题,我的java是1.6的,而elasticsearch需要1.7以下版本,所以还需要安装java 1.7而要安装java 1.7,用简单的brew又不行,还需要先安装cask,所以最后的步骤就变成了这样: brew install brew-cask brew update brew cask install caskroom/versions/java7 java -version 可以看到java版本已经是1.7了。接下来: brew install elasticsearch elasticsearch --version 证明elasticsearch已经安装好了。以后要启动或者停止elasticsearch服务就执行以下命令: brew services start elasticsearch brew services stop elasticsearch 下面安装logstash: brew install logstash logstash --version logstash已经安装好了。然后安装kibana,kibana的安装不用brew,直接下载解压之后,进到解压目录里: ./kibana 接下来是配置logstash,在这里我遇到了大麻烦。从头说起,先要建立一个logstash的conf文件,以便于后期调试: mkdir logstash cd logstash 生成一个logstash.conf文件,在这里我们准备处理apache的log input { file { path => "/private/var/log/apache2/www.myserver.com-access_log" start_position => beginning ignore_older => 0 sincedb_path => "/dev/null" } } filter { grok { match => { "message" => "%{IPORHOST:clientip} - %{USER:auth} \[%{HTTPDATE:timestamp}\] \"(?:%{WORD:verb} %{NOTSPACE:request}(?: HTTP/%{NUMBER:httpversion})?|%{DATA:rawrequest})\" %{NUMBER:response} (?:%{NUMBER:bytes}|-)"} } date { match => [ "timestamp" , "dd/MMM/YYYY:HH:mm:ss +0800" ] } } output { elasticsearch {} stdout {} } 为了这个配置文件,费了很大精力,网上很多教程都和我的实际情况不相符合。关键点说明如下:start_position => beginning告诉logstash从我的log文件的头部开始往下找,不要从半中间开始。ignore_older => 0告诉logstash不要管我的log有多古老,一律处理,否则logstash缺省会从今天开始,就不管老日志了。sincedb_path => "/dev/null"这句话也很关键,特别是当你需要反复调试的时候,因为logstash会记住它上次处理到哪儿了,如果没有这句话的话,你再想处理同一个log文件就麻烦了,logstash会拒绝处理。现在有了这句话,就是强迫logstash忘记它上次处理的结果,从头再开始处理一遍。 filter下面的grok里面的match,网上教程一般是这么写的: match => { "message" => "%{COMBINEDAPACHELOG}" } 但是当我这么写的时候,总是处理不了我的log,我的log其实就长这个样子: 127.0.0.1 - - [02/May/2016:22:11:28 +0800] "GET /assets/aa927304/css/font-awesome.min.css HTTP/1.1" 200 27466 查源代码,官方是这么写的: COMMONAPACHELOG %{IPORHOST:clientip} %{USER:ident} %{USER:auth} \[%{HTTPDATE:timestamp}\] "(?:%{WORD:verb} %{NOTSPACE:request}(?: HTTP/%{NUMBER:httpversion})?|%{DATA:rawrequest})" %{NUMBER:response} (?:%{NUMBER:bytes}|-) COMBINEDAPACHELOG %{COMMONAPACHELOG} %{QS:referrer} %{QS:agent} 后面的combined引用前面的common,而问题就出在这个USER:ident上。 我在https://grokdebug.herokuapp.com/反复验证,最后发现只要把这个USER:ident改成-就行了,所以就有了我上面的写法。 接下来用了一个date filter,这是因为如果不用这个date filter的话,它会把处理log的时间认为是用户访问网页的时间来产生表格,这样在kibana里看上去怪怪的,所以加这么一个filter,但就是加这么一个简单的filter,也出现了问题,处理失败,因为网上的教程里一般都是这么写的: date { match => [ "timestamp" , "dd/MMM/YYYY:HH:mm:ss Z" ] } 区别就在最后一个Z上,我的时区字符串是+0800,怎么也匹配不上这个Z,索性一怒之下直接用+0800代替,也就过关了。 过程中不停地访问如下网址验证elasticsearch的结果:http://localhost:9200/logstas... 注意URL中那个时间,一开始的时候我们就用处理日志的时间访问就可以,但当加上date filter后就不一样了,如果你还用当前日期的话,会一无所得,改成log里的时间才会看到结果,因为index日期变了。 然后就是你需要一遍一遍地清空elasticsearch里的数据,进行调试: curl -XDELETE 'http://localhost:9200/_all' 清空完了以后你再执行logstash,就把新数据又灌进去了: logstash agent -f ~/logstash/logstash.conf 最后,通过kibana窗口观察你的结果:http://localhost:5601 一开始是在setting页面,要你指定访问的index,这里就用缺省的logstash-*就行了,然后就是页面右上角有个时间限制,把它改成Year to date,否则有可能什么数据也看不到。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册