首页 文章 精选 留言 我的

精选列表

搜索[文旅营销和支付],共10000篇文章
优秀的个人博客,低调大师

Android下如何计算要显示的字符串所占的宽度和高度

查询了google发现在android一下有几种方法可以做到,但是经过实际测试发现下面这种方法是最准确的 Rect bounds = new Rect(); String text = "Hello World"; TextPaint paint; paint = findViewById(R.id.hello_world).getPaint(); paint.getTextBounds(text, 0, text.length(), bounds); int width = bounds.width(); Paint pFont = new Paint(); Rect rect = new Rect(); pFont.getTextBounds("豆", 0, 1, rect); Log.v(TAG, "height:"+rect.height()+"width:"+rect.width()); 本文转自java豆子博客园博客,原文链接:http://www.cnblogs.com/error404/archive/2013/01/25/2876888.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

LogStash实践日志分析二:收集数据、入库、数据分析和kibana展示

1、原始数据源服务器,从日志拉取数据,并转化为utf8编码,增加ip地址,保存到Redis中,上配置如下: [plain]view plaincopy input{ file{ path=>"/tmp/123server.log" codec=>json{ charset=>"GBK" } start_position=>"beginning" sincedb_path=>"/dev/null" type=>"activitysun" } } filter{ date{ match=>["timestamp","UNIX"] remove_field=>["time"] } #ruby{ #code=>"event.timestamp.time.localtime" #} mutate{ #somepcnohost replace=>{"host"=>"192.168.10.11"} } } output{ #stdout{ #codec=>plain{ #charset=>"UTF-8" #} #} file{ path=>"/tmp/logstash.log" codec=>json{ charset=>"UTF-8" } } redis{ host=>["192.168.10.18"] port=> 16378 data_type=>"list" key=>"123server" codec=>json{ charset=>"UTF-8" } } } 采用如下命令启动 [plain]view plaincopy /data/logstash-2.3.4/bin/logstash-factivitylog.conf 2、收集服务器,从redis拉取数据,放入elasticsearch,时间做一下处理,方便分析。配置如下: [plain]view plaincopy input{ redis{ host=>["192.168.10.18"] port=>26378 data_type=>"list" key=>"123server" codec=>json{ charset=>"UTF-8" } #type=>"activitysun" } } filter{ ruby{ code=>"event['daytag']=event.timestamp.time.localtime.strftime('%Y.%m.%d')" } } output{ elasticsearch{ hosts=>["127.0.0.1:19200"] index=>"%{type}-%{daytag}" #index=>"%{type}-%{+yyyy.MM.dd}" } } 3、kibana展示 filebeat.yml filebeat.prospectors: - input_type: log paths: - /log/123.log #- /home/haoren/data/filebeat-5.0.2-linux-x86_64/test.log encoding: gbk symlinks: true include_lines: ['\[.*?统计\]','\[.*?结算\]'] document_type: pchannelserver fields_under_root: true fields: host: 192.168.10.15 processors: - drop_fields: #fields: ["beat.hostname", "beat.name", "beat.version", "input_type", "beat"] fields: ["input_type", "beat", "offset", "source"] output.redis: enabled: true hosts: ["192.168.10.18"] password: "8841c09BAD52E63067C4DA" port: 15377 datatype: list key: "filebeat" db: 0 output.file: enabled: true path: "/tmp/filebeat" output.console: enabled: false 本文转自 chengxuyonghu 51CTO博客,原文链接:http://blog.51cto.com/6226001001/1894117,如需转载请自行联系原作者
优秀的个人博客,低调大师

再聊负载均衡SLB的主备可用区和高可用部署最佳实践

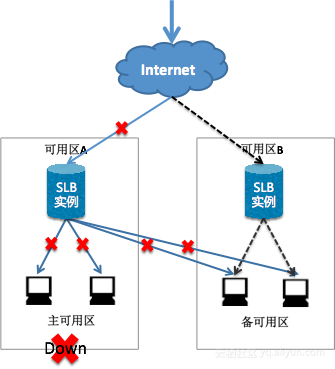
1.概述 阿里云负载均衡SLB的主备可用区提供了多个层级的高可用,可阅读《负载均衡SLB高可用的四个层次》。但很多用户常常在下单选购时,对可用区的选择感到困惑。到底如何选择SLB的主备可用区,如何搭配不同可用区的ECS,来构建高可靠应用系统呢?客官请听下文分解。 首先,我们要搞清楚一个事实,负载均衡SLB的可用区设计的初衷,是用来抵御可用区(机房)级别的重大灾情的,比如机房整体掉电,机房出口光缆中断等,即当某个可用区整体不可用时,备可用区才派上用场,也就是说只在上述情况下,SLB的主备可用区才会发生倒换。而并非用户的某个实例出现故障,就会自动发生主备倒换的,这是一个很典型的误区。 图注:当可用区A整体不可用时,SLB才会发生主备倒换 那么主备可用区应该如何选择比较合适呢?对于SLB的主可用而言,主要看用户的ECS主要分布在那个可用区,SL

优秀的个人博客,低调大师

mysql-proxy主从服务架构下读写分离和负载均衡实现及原理

假设已经配置好mysql的主从架构 主服务器:192.168.3.189 从服务器:192.168.3.104 我们的目的就是实现读取操作由192.168.3.104服务器响应,写的操作由192.168.3.189响应 首先安装mysql-proxy 1、从mysql官网上下载最新版的mysql-proxy:http://dev.mysql.com/downloads/mysql-proxy/ 2、在本地的/opt/software/ (你可以换成自己的目录)解压下载的压缩文件 解压后能看到 bin、lib、include、libexc、share几个文件夹 并把bin目录添加到系统环境变量中去(在/etc/profile 文件最后添加:export PATH=$PATH:/opt/software/mysql-proxy-0.8.3-linux-glibc2.3-x86-32bit/bin) 然后source /etc/profile 让刚才设置的环境变量生效 3、在命令行下输入mysql-proxy --help 能看到帮助信息说明安装成功了 4、启动mysql-proxy服务 mysql-proxy --keepalive --proxy-read-only-backend-addresses=192.168.3.104:3306 --proxy-backend-addresses=192.168.3.189:3306 --proxy-lua-script=/opt/software/mysql-proxy-0.8.3-linux-glibc2.3-x86-32bit/share/doc/mysql-proxy/rw-splitting.lua --log-file=/opt/software/mysql-proxy-0.8.3-linux-glibc2.3-x86-32bit/var/mysql-proxy.log --keepalive 网上解释说有时候mysql-porxy会崩溃,这个参数能让mysql-proxy崩溃后自动重启 --proxy-read-only-backend-addresses 配置只读服务器 --proxy-backend-addresses 配置可读可写服务器(主服务器master) --proxy-lua-script 配置读写分离的lua脚本,这个脚本就在mysql-proxy解压后的share目录里面 --log-file 日志文件 这样mysql-proxy就启动了,如果想让mysql-proxy在后台运行只需要添加--daemon 参数就行了,连接mysql-proxy的命令是 mysql -h192.168.3.189 -P4040 -utest -p123456 那么mysql-proxy是如何进行读写分离的呢,关键就在读写分离的lua脚本rw-splitting.lua 为了解释读写分离的原理,打开rw-splitting.lua脚本,该脚本中有几个关键的地方,我们分别来看 1、配置 1 2 3 4 5 6 7 8 9 [plain]viewplaincopy if notproxy.global.config.rwsplit then proxy.global.config.rwsplit={ min_idle_connections=1,--设置每个服务器所拥有的最大连接池数量(我也不知道为啥命名为min),实际的最大连接数会比这个值大1,也就是在这个配置条件下,实际上每个服务器所能拥有的最大连接数是2 max_idle_connections=1,--这个配置有啥做用还不知道 is_debug= true --开启调试模式 } end 2、connect_server() 每次客户端连接myql-proxy的时候都会运行一次这个函数,然后返回一个mysql连接给客户端 首先明确一件是mysql-proxy所拥有最大的连接数是确定的,假设有n台服务器,min_idle_connections=2,那么所拥有的最大连接数量就是:n*(2+1) 函数首先会判断主服务器连接数是否达到最大值,如果没有,就创建一个连接主服务器的连接,并返回; 如果主服务器连接数已满,遍历每个从服务器,看从服务器连接是否达到最大值,如果没有,就创建一个,并返回; 如果所有服务器连接数都达到最大值,就返回主服务器创建的第一个连接 3、read_query() 每次客户端做sql查询的时候都会调用这个函数,这个函数把sql传到某个服务器,得到结果后返回给客户端 那么如何做读写分离呢?在函数内有这么一个判断 1 2 [plain]viewplaincopy if stmt.token_name== "TK_SQL_SELECT" then 这个语句的作用就是判断sql语句是不是以SELECT开始的,也就是判断是否是查询,如果是查询的话,接下来会有这么个语句 1 2 3 [plain]viewplaincopy local backend_ndx=lb.idle_ro() lb.idle_ro()是通过 local lb=require( "proxy.balance" )引入的balance.lua文件 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 [plain]viewplaincopy function idle_ro() local max_conns=-1 local max_conns_ndx=0 for i=1, #proxy.global.backendsdo local s=proxy.global.backends[i] local conns=s.pool. users [proxy.connection.client.username] --pickaslave which hassomeidlingconnections <spanstyle= "color:#ff0000;" > if s. type ==proxy.BACKEND_TYPE_ROand s.state~=proxy.BACKEND_STATE_DOWNand conns.cur_idle_connections>0 then if max_conns==-1or s.connected_clients<max_conns then max_conns=s.connected_clients max_conns_ndx=i end end< /span > end return max_conns_ndx end 这个函数的作用就是选择使用哪个读服务器,并返回服务器的index:max_conns_ndx 如何选择服务器呢? 它通过循环遍历所有服务器,然后选出一个客户端连接(s.connected_clients)最少的服务器,这样在一定程度上实现负载均衡 本文转自 转身撞墙角 51CTO博客,原文链接:http://blog.51cto.com/chentianwang/1709296

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册