首页 文章 精选 留言 我的

精选列表

搜索[物联网平台],共10000篇文章
优秀的个人博客,低调大师

【云栖号案例 | 互联网 】万师傅大数据体系实践案例

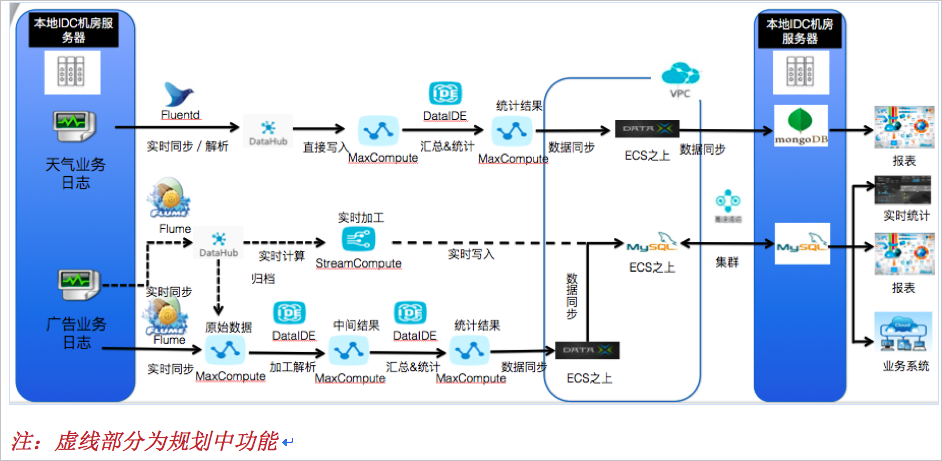
云栖号案例库:【点击查看更多上云案例】不知道怎么上云?看云栖号案例库,了解不同行业不同发展阶段的上云方案,助力你上云决策! 整体架构 每当我在思考技术选型方案的时候,翻翻阿里云的官网,总能找到我想要的东西。于是,我们的大数据体系就变成了这样,如图: 离线 2.1 选型原则 团队成员,大都是Hive方向或是算法方向出身。为追求上手简单、专注数据的分析和挖掘、减少不必要的学习成本和费用成本,使用了阿里云MaxCompute。 2.2 数据采集 数据源共包含三类: (1)关系型数据库中的数据;(2)服务器上的日志文件;(3)前端埋点日志; 采集方式如图: 关系型数据库中的数据,使用dataworks中的“数据集成”功能,定时离线同步到MaxCompute中;其他两类数据,以及关系型数据库的Binlog,直接使用了万能的“日志服务SLS”。WebTracking支持直接收集HTML、H5、iOS和 Android的日志;Logtail支持收集服务器上的日志文件,以及关系型数据库的Binlog。数据都收集过来之后,再定时将数据投递到MaxCompute中;如上两个步骤,完成了三类数据的收集。比业界常见的Flume+Kafka、Kettle、Logstash等方式,上手更快、维护更简单。 2.3 数据仓库 2.3.1 分层 数据仓库的分层模型,大体的思路和网上烂大街的数仓分层原则相似,总体分ODS、DW、RPT三层。具体实践的过程中,根据我们的实际情况,慢慢形成了我们自己的风格。 ODS层,大部分是和数据源中的数据一模一样的,也有极少部分经过了简单的ETL、或者只截取了与统计有关的字段。数据已采用了其他备份方式,所以这里不再需要使用MaxCompute做冷备。 DW层是最核心的数据仓库层。由于公司技术正在朝着微服务转型,系统、数据库拆分得越来越细,对数据的统计分析很不利。所以我们依靠数据仓库层,将相关的数据放到一起,便于上层的开发、更有利于日常的临时数据需求的快速响应。数据仓库层的数据结构,不会随着微服务系统和数据的拆分而变化,让系统拆分对于这套离线数据分析的影响终结在这一层,不渗透到更上层。 RPT层的具体做法,市面上有很多种。根据我们的实际情况,决定采用按业务划分的方式。曾经我们也尝试过按数据产品划分,但是时间长了,出现了几个严重的问题。首先,不同数据产品中对于相同指标的定义混乱,导致各个部门对于数据没有一个统一的概念。其次,技术上的系统拆分的影响范围,随着数据产品的增多而大面积扩大,极易出现修改遗漏的现象。 2.3.2 DATAWORKS 配套MaxCompute一起使用的Dataworks,是一个全能型的可视化工具,集成了几乎一切我们使用MaxCompute时所需要配套的功能,也解决了很多开源产品中无法解决的痛点,例如:可视化调度、智能监控告警、数据权限控制等。 实际使用时,我们的数据在MaxCompute中的流转,全部是通过MaxCompute SQL节点和机器学习节点进行的。定时依赖+调度依赖+跨周期依赖,也让方案的设计变得更灵活。 业务流程是按实际业务模块划分、没有按照数据产品划分,这样可以解决“找任务难”、“不同团队对相同指标的定义不一致”等问题。当某个业务有变更时,可以快速定位到需要配合修改的任务都有哪些,有效地避免了遗漏。 技术文档的同步更新一直是业界难以解决的痛点,数据字典也不例外。按照业务模块划分了之后,有新增指标时,更容易发现是否已有相同或相似的指标,即使数据字典更新不及时也不会有大影响。 实时 3.1 选型原则 团队初始成员均为Java出身,并且我们当前没有、未来也不准备拥有自己的Hadoop集群。综合考虑,采用了阿里开源的JStorm作为核心的流式计算引擎,同时也在尝试业界最新的Flink,为未来做准备。至于没有使用阿里云商业版的“实时计算”,完全是出于成本考虑,在我们的场景下,自建JStorm集群的成本会远低于使用“实时计算”。 与核心的流式计算引擎相配套的中间件及数据存储,使用的全部都是阿里云的产品,开箱即用、省去运维烦恼。 3.2 实践 3.2.1 消息队列 消息队列类的产品,主要使用了“日志服务SLS”和“消息队列RocketMQ”两种。 “日志服务SLS”这款产品,大于等于开源组合ELK,不仅有日志采集、搜索引擎、分析展示,还有消息队列、监控告警等功能,价格也很合理。尤其,这几个功能的组合,可以轻松实现业务日志告警、nginx监控等等使用传统方式要开发很久的需求。如果单纯作为消息队列使用,还可以关闭索引,以节省费用。 “消息队列RocketMQ”的使用,主要看中了“定时延时消息”这一功能,可以实现很多定时延时任务的需求场景。 3.2.2 缓存 Redis,不需要过多介绍。 3.2.3 数据库 阿里云包含了非常多的数据库类产品,根据我们的实际需求,主要使用了以下几款: (1)RDS for MYSQL,与MYSQL一致,不需要过多介绍;(2)PolarDb,阿里云自研的云原生数据库,与RDS价格一致。对于我们使用者来说,它是一个可以支持更高读并发、单实例容量更大的MYSQL。可以帮助我们建立离线数据中心,也解决了“所有数据库的查询都要先经过Redis缓存”的问题,节省了少量Redis的费用;(3)TableStore,这款产品的初衷应该是想要对标开源的HBase,主要用于单一索引、庞大数据量、单条或小范围检索、高并发、低延时的查询场景。在单条查询时,性能几乎可以媲美Redis,而且也拥有TTL功能。被我们大量使用在用户画像、幂等校验等场景中;其他产品,例如DRDS、AnalyticDb,或MongoDb、Elasticsearch等,由于目前的场景不需要,所以没有投入使用。 数据展示 4.1 选型原则 前端产品的选型原则很简单,由于我们的团队没有专门的前端开发,所以只能选择阿里云的产品、或者免费的、可对接的开源产品。 4.2 实践 阿里云的可视化产品主要有两个:QuickBI和DataV。我们都有使用。 QuickBI主要用于日常的数据展示、分析,帮助运营、产品等部门进行决策; DataV主要用于“非交互式”的数据展示场景,例如展会、大屏等。 云栖号案例库:【点击查看更多上云案例】不知道怎么上云?看云栖号案例库,了解不同行业不同发展阶段的上云方案,助力你上云决策!

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册