首页 文章 精选 留言 我的

精选列表

搜索[Python版本],共10000篇文章
优秀的个人博客,低调大师

机器学习决策树ID3算法,手把手教你用Python实现

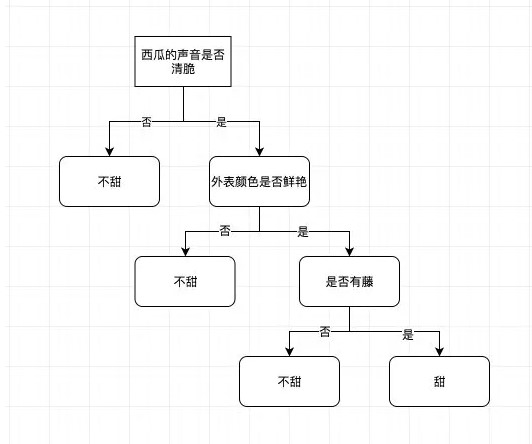
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 决策树的定义 决策树是我本人非常喜欢的机器学习模型,非常直观容易理解,并且和数据结构的结合很紧密。我们学习的门槛也很低,相比于那些动辄一堆公式的模型来说,实在是简单得多。 其实我们生活当中经常在用决策树,只是我们自己没有发现。决策树的本质就是一堆if-else的组合,举个经典的例子,比如我们去小摊子上买西瓜。水果摊的小贩都是怎么做的?拿起西瓜翻滚一圈,看一眼,然后伸手一拍,就知道西瓜甜不甜。我们把这些动作相关的因素去除,把核心本质提取出来,基本上是这么三条: 西瓜表面的颜色,颜色鲜艳的往往比较甜 西瓜拍打的声音,声音清脆的往往比较甜 西瓜是否有瓜藤,有藤的往往比较甜 这三条显然不是平等的,因为拍打的声音是最重要的,可能其次表面颜色,最后是瓜藤。所以我们挑选的时候,肯定也是先听声音,然后看瓜藤,最后看颜色。我们把其中的逻辑抽象出来然后整理一下,变成一棵树结构,于是这就成了决策树。 这个决策树本质上做的还是分类的工作,将西瓜分成了甜的和不甜的。也就是说决策树是一个树形的分类器,这个也是决策树的基本定义。另外从图中我们还有一个启示,在这个问题当中,决策树的特征都是离散值,而不是连续值。也就是说决策树可以接受像是类别、标识这样非数值型的特征,而逻辑回归这些模型则不太行。 如果你对这些细节还理解不深刻也没有关系,我们可以先放一放,至少我们明白了决策树的大概结构以及工作原理。 对于每一条数据来说,它分类的过程其实就是在决策树上遍历的过程。每到一个中间节点都会面临一次判断,根据判断的结果选择下一个子树。而树上的叶子节点代表一种分类,当数据到了叶子节点,这个叶子节点的值就代表它的分类结果。 决策树的训练 明白了决策树的结构和工作原理之后,下面就是训练的过程了。 在理清楚原理之前,我们先来看下数据。我们根据上面决策树的结构,很容易发现,训练数据应该是这样的表格: 那么最后我们想要实现什么效果呢?当然是得到的准确率越高越好,而根据决策树的原理,树上的每一个叶子节点代表一个分类。那么我们显然希望最后到达叶子节点的数据尽可能纯粹,举个例子,如果一个叶子节点代表甜,那么我们肯定希望根据树结构被划归到这里的数据尽可能都是甜的,不甜的比例尽可能低。 那么我们怎么实现这一点呢?这就需要我们在越顶层提取规则的时候,越选择一些区分度大的特征作为切分的依据。所谓区分度大的特征,也就是能够将数据很好分开的特征。这是明显的贪心做法,使用这样的方法,我们只可以保证在尽可能高层取得尽可能好的分类结果,但是并不能保证这样得到的模型是最优的。生成最优的决策树本质上也是一个NP问题,我们当前的做法可以保证在尽量短的时间内获得一个足够优秀的解,但是没办法保证是最优解。 回到问题本身,我们想要用区分度大的特征来进行数据划分。要做到这一点的前提就是首先定义区分度这个概念,将它量化,这样我们才好进行选择。否则总不能凭感觉去衡量区分度,好在这个区分度还是很好解决的,我们只需要再一次引入信息熵的概念就可以了。 信息熵与信息增益 信息熵这个词很令人费解,它英文原文是information entropy,其实一样难以理解。因为entropy本身是物理学和热力学当中的概念,用来衡量物体分散的不均匀程度。也就是说熵越大,说明物体分散得程度越大,可以简单理解成越散乱。比如我们把房间里一盒整理好的乒乓球打翻,那么里面的乒乓球显然会散乱到房间的各个地方,这个散乱的过程可以理解成熵增大的过程。 信息熵也是一样的含义,用来衡量一份信息的散乱程度。熵越大,说明信息越杂乱无章,否则说明信息越有调理。信息熵出自大名鼎鼎的信息学巨著《信息论》,它的作者就是赫赫有名的香农。但是这个词并不是香农原创,据说是计算机之父冯诺依曼取的,他去这个名字的含义也很简单,因为大家都不明白这个词究竟是什么意思。 之前我们曾经在介绍交叉熵的时候详细解释过这个概念,我们来简单回顾一下。对于一个事件X来说,假设它发生的概率是P(X),那么这个事件本身的信息量就是: 比如说世界杯中国队夺冠的概率是1/128,那么我们需要用8个比特才能表示,说明它信息量很大。假如巴西队夺冠的概率是1/4,那么只要2个比特就足够了,说明它的信息量就很小。同样一件事情,根据发生的概率不同,它的信息量也是不同的。 那么信息熵的含义其实就是信息量的期望,也就是用信息量乘上它的概率: 同样,假设我们有一份数据集合,其中一共有K类样本,每一类样本所占的比例是,那么我们把这个比例看成是概率的话,就可以写出这整个集合的信息熵: 理解了信息熵的概念之后,再来看信息增益就很简单了。信息增益说白了就是我们划分前后信息熵的变化量,假设我们选择了某一个特征进行切分,将数据集D切分成了D1和D2。那么就叫做信息增益,也就是切分之后信息熵与之前的变化量。 我们根据熵的定义可以知道,如果数据变得纯粹了,那么信息熵应该会减少。减少得越多,说明切分的效果越好。所以我们就找到了衡量切分效果的方法,就是信息增益。我们根据信息增益的定义,可以很简单地理出整个决策树建立的过程。就是我们每次在选择切分特征的时候,都会遍历所有的特征,特征的每一个取值对应一棵子树,我们通过计算信息增益找到切分之后增益最大的特征。上层的结构创建好了之后, 通过递归的形式往下继续建树,直到切分之后的数据集变得纯粹,或者是所有特征都使用结束了为止。 这个算法称为ID3算法,它也是决策树最基础的构建算法。这里有一个小细节, 根据ID3算法的定义,每一次切分选择的是特征,而不是特征的取值。并且被选中作为切分特征的特征的每一个取值都会建立一棵子树,也就是说每一个特征在决策树当中都只会最多出现一次。因为使用一次之后,这个特征的所有取值就都被使用完了。 举个例子,比如拍打声音是否清脆这个特征,我们在一开始就选择了它。根据它的两个取值,是和否都建立了一棵子树。那么如果我们在子树当中再根据这个特征拆分显然没有意义,因为子树中的所有数据的这个特征都是一样的。另外,ID3算法用到的所有特征必须是离散值,因为连续值无法完全切分。如果西瓜的重量是一个特征,那么理论上来说所有有理数都可能是西瓜的质量,我们显然不可能穷尽所有的取值。这一点非常重要,不仅关系到我们实现的决策树是否正确,也直接关系到我们之后理解其他的建树算法。 代码实现 理解了算法原理和流程之后,就到了我们紧张刺激的编码环节。老实讲决策树的算法实现并不难,比之前的FP-growth还要简单,大家不要有压力。 首先,我们来创造实验数据: 这份数据模拟的是学生考试,一共考三门,一共要考到150分以上才算是通过。由于ID3算法只能接受离散值的特征,所以我们要先将连续值转成离散值,我们根据每一门的考试分数,生成三个档次。大于70分的是2档,40到70分的是1档,小于40分的是0档。 为了方便编码,我们把预测值Y放在特征的最后,并且返回这三个特征的名称,方便以后用来建树。 我们运行一下数据查看一下结果: 下面,我们实现计算集合信息熵的函数。这个函数也很简单,我们只需要计算出每个类别的占比,然后套用一下信息熵的公式即可。 有了信息熵的计算函数之后,我们接下来实现拆分函数,也就是根据特征的取值将数据集进行拆分的函数。 本质上就是根据特征取值归类的过程,我们可以随便调用测试一下: 和我们预期一样,根据特征的取值将数据分成了若干份。接下来我们就要实现核心的特征的选择函数了,也就是要选择信息增益最大的特征对数据进行切分。 到这里,我们所有工具方法都已经开发完了,下面就到了我们紧张刺激的建树部分了。建树其实并没有什么大不了的,无非是通过递归来重复调用上面的方法来创造每一个分支节点而已。如果你熟悉树形数据结构,会发现它和其他树形数据结构的构建过程并没有什么两样。我们来看下代码,整个过程也只有十几行而已。 我们运行一下这段代码,会得到一份dict,这个dict当中的层次结构其实就是决策树的结构: 我们这样看可能不太清楚,但是我们把这个dict展开就得到了下图的这棵树结构: 我们观察一下上图当中红圈的部分,这个节点只有两个分叉,而其他的节点都有三个分叉。这并不是代码有bug,而是说明数据当中缺失了这种情况,所以少了一个分叉。这其实非常正常,当我们训练数据的样本量不够的时候,很有可能无法覆盖所有的情况,就会出现这种没有分叉的情况。 到这里虽然决策树是实现完了,但是还没有结束,还有一个关键的部分我们没有做,就是预测。我们训练完了,总得把模型用起来,显然需要一个预测的函数。这个预测的函数也简单,它介绍一条数据以及我们训练完的树结构,返回分类的结果。其实也是一个递归调用的过程: 我们来创造一些简单的数据测试一下: 基本上和我们的预期一致,说明我们决策树就实现完了。 总结 我们的决策树虽然构建完了,但是仍然有很多不完美的地方。比如说,目前我们的模型只能接受离散值的特征,如果是连续值则无法进行拆分。而且我们每个特征只能用一次,有时候我们希望能够多次使用同一个特征。在这种情况下ID3就无法实现了。所以我们还需要引入其他的优化。 在后序的文章当中我们将会讨论这些相关的优化,以及决策树这个模型本身的一些特性。如果对此感兴趣,一定不要错过。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-05-22本文作者:承志本文来自:“掘金”,了解相关信息可以关注“掘金”

优秀的个人博客,低调大师

手把手教你用Python做个可视化的“剪刀石头布”小游戏

/1 前言/ 最近在学习PyQt5可视化界面,这是一个内容非常丰富的gui库,相对于tkinter库,功能更加强大,界面更加美观,操作也不难。于是我开始小试牛刀,用PyQt5做个可视化的“剪刀石头布”小游戏,总体效果如下: 该程序可以实现游戏轮次统计,双方得分、平局次数统计和重新开始功能,不管是1局决胜负,还是三局两胜、七局三胜,都能完美解决。 /2 具体实现/ 下面给大家详细介绍一下具体步骤。 第一步:创建游戏主窗口 PyQt5创建主窗口有其固定的套路,首先要创建应用程序对象:app=QApplication(sys.argv),参数sys.argv是命令行参数,这使得可以在电脑系统终端执行程序时,传入命令参数,来执行不同的逻辑代码。执行应用程序对象,进入消息循环等待退出: sys.exit(app.exec_()),代码如下图所示: 其中,GameWindow()是本次游戏的类,窗口大小为900X400 再为该窗口添加标题和图标如下图所示: 效果如下图所示: 第二步:以网格布局方式放控件 PyQt5有5种布局方式,分别是绝对布局、水平布局、垂直布局、网格布局和表单布局,本次只采用网格布局,其余布局方式各有特点,感兴趣的朋友可以研究一下。 1.我想把整个出窗口分成3x3=9个网格,然后以网格布局的方式往里填内容,首先将“红方选手”、“第X轮”、“蓝方选手”分别放入第一行的3个网格中。 网格布局需要用到addWidget函数,它的上图中的4个参数分别代表放置的空间、放置行数、放置的列数,上述3个控件分别放在第1行的1-3列。效果如下图所示: 2.留出“剪刀石头布”图片展示位置,分别放置在第二行的1和3网格。 第二行中间网格放置红蓝双方得分情况。 这里需要注意一下,我在第二行第二个网格里又嵌入一个新的网格对象,将其分成1个1行3列的网格,其中第1个网格放红方得分,第二个网格放“VS”,第三个放蓝方得分。 3.绑定“开始游戏”、“重新开始”信号槽 用QpushButton创建“开始游戏”按钮,绑定gamestart函数(后续还会讲),并将该按钮放入第三行的第二个网格中。 用QpushButton创建“重新开始”按钮,绑定restart函数(后续还会讲),并将该按钮放入第三行的第三个网格中。效果如下图所示: 现在基本框架已经搭建好了。 第三步:信号槽绑定信号 主要是针对开始游戏和重新开始游戏按钮绑定信号,下面给大家介绍一下上述的gamestart和restart函数。 gamestart函数 1)游戏开始后,我需要随机从“剪刀”、“石头”、“布”三张图片中选出1张放置到相应位置,代码如下图所示: 这里用了red和blue两个类,每次点击开始游戏按钮,都会调用该类,用random函数随机选出图片,并在相应位置展示。 2)判断输赢,实时更新数据 Gamestart下调用judge函数,判断得分,记录红方得分、蓝方得分、平局次数3个值,并用setText函数立即更新红方得分框、蓝方得分框及平局次数框的内容。 最后,为了避免游戏中不小心点击关闭窗口按钮,添加1个关闭事件,如下图所示。 当点击右上角叉号时,会进行提示,效果如下图所示: 到这里,这个小游戏就制作完毕了,界面比较简单,感兴趣的朋友可以继续开发更高级的功能。 /3 结语/ 本文基于PyQt5可视化界面,用PyQt5做个可视化的“剪刀石头布”小游戏,可以实现游戏轮次统计,双方得分、平局次数统计和重新开始功能,不管是1局决胜负,还是三局两胜、七局三胜,都能完美解决。 欢迎大家尝试,消耗在家的无聊时间。本文涉及的代码都上传到了github地址上,后台回复“剪刀石头布”五个字即可获取代码。

优秀的个人博客,低调大师

21、 Python快速开发分布式搜索引擎Scrapy精讲—爬虫数据保存

注意:数据保存的操作都是在pipelines.py文件里操作的 将数据保存为json文件 spider是一个信号检测 #-*-coding:utf-8-*- #Defineyouritempipelineshere # #Don'tforgettoaddyourpipelinetotheITEM_PIPELINESsetting #See:http://doc.scrapy.org/en/latest/topics/item-pipeline.html fromscrapy.pipelines.imagesimportImagesPipeline#导入图片下载器模块 importcodecs importjson classAdcPipeline(object):#定义数据处理类,必须继承object def__init__(self): self.file=codecs.open('shuju.json','w',encoding='utf-8')#初始化时打开json文件 defprocess_item(self,item,spider):#process_item(item)为数据处理函数,接收一个item,item里就是爬虫最后yielditem来的数据对象 #print('文章标题是:'+item['title'][0]) #print('文章缩略图url是:'+item['img'][0]) #print('文章缩略图保存路径是:'+item['img_tplj'])#接收图片下载器填充的,图片下载后的路径 #将数据保存为json文件 lines=json.dumps(dict(item),ensure_ascii=False)+'\n'#将数据对象转换成json格式 self.file.write(lines)#将json格式数据写入文件 returnitem defspider_closed(self,spider):#创建一个方法继承spider,spider是一个信号,当前数据操作完成后触发这个方法 self.file.close()#关闭打开文件 classimgPipeline(ImagesPipeline):#自定义一个图片下载内,继承crapy内置的ImagesPipeline图片下载器类 defitem_completed(self,results,item,info):#使用ImagesPipeline类里的item_completed()方法获取到图片下载后的保存路径 forok,valueinresults: img_lj=value['path']#接收图片保存路径 #print(ok) item['img_tplj']=img_lj#将图片保存路径填充到items.py里的字段里 returnitem#将item给items.py文件的容器函数 #注意:自定义图片下载器设置好后,需要在 将数据保存到数据库 我们使用一个ORM框架sqlalchemy模块,保存数据 数据库操作文件 #!/usr/bin/envpython #-*-coding:utf-8-*- fromsqlalchemy.ext.declarativeimportdeclarative_base fromsqlalchemyimportColumn fromsqlalchemyimportInteger,String,TIMESTAMP fromsqlalchemyimportForeignKey,UniqueConstraint,Index fromsqlalchemy.ormimportsessionmaker,relationship fromsqlalchemyimportcreate_engine #配置数据库引擎信息 ENGINE=create_engine("mysql+pymysql://root:279819@127.0.0.1:3306/cshi?charset=utf8",max_overflow=10,echo=True) Base=declarative_base()#创建一个SQLORM基类 classSendMsg(Base):#设计表 __tablename__='sendmsg' id=Column(Integer,primary_key=True,autoincrement=True) title=Column(String(300)) img_tplj=Column(String(300)) definit_db(): Base.metadata.create_all(ENGINE)#向数据库创建指定表 defdrop_db(): Base.metadata.drop_all(ENGINE)#向数据库删除指定表 defsession(): cls=sessionmaker(bind=ENGINE)#创建sessionmaker类,操作表 returncls() #drop_db()#删除表 #init_db()#创建表 pipelines.py文件 #-*-coding:utf-8-*- #Defineyouritempipelineshere # #Don'tforgettoaddyourpipelinetotheITEM_PIPELINESsetting #See:http://doc.scrapy.org/en/latest/topics/item-pipeline.html fromscrapy.pipelines.imagesimportImagesPipeline#导入图片下载器模块 fromadcimportshujukuasORM#导入数据库文件 classAdcPipeline(object):#定义数据处理类,必须继承object def__init__(self): ORM.init_db()#创建数据库表 defprocess_item(self,item,spider):#process_item(item)为数据处理函数,接收一个item,item里就是爬虫最后yielditem来的数据对象 print('文章标题是:'+item['title'][0]) print('文章缩略图url是:'+item['img'][0]) print('文章缩略图保存路径是:'+item['img_tplj'])#接收图片下载器填充的,图片下载后的路径 mysq=ORM.session() shuju=ORM.SendMsg(title=item['title'][0],img_tplj=item['img_tplj']) mysq.add(shuju) mysq.commit() returnitem classimgPipeline(ImagesPipeline):#自定义一个图片下载内,继承crapy内置的ImagesPipeline图片下载器类 defitem_completed(self,results,item,info):#使用ImagesPipeline类里的item_completed()方法获取到图片下载后的保存路径 forok,valueinresults: img_lj=value['path']#接收图片保存路径 #print(ok) item['img_tplj']=img_lj#将图片保存路径填充到items.py里的字段里 returnitem#将item给items.py文件的容器函数 #注意:自定义图片下载器设置好后,需要在 【转载自:http://www.lqkweb.com】

优秀的个人博客,低调大师

Python爬虫入门教程 54-100 博客园等博客网站自动评论器

爬虫背景 爬虫最核心的问题就是解决重复操作,当一件事情可以重复的进行的时候,就可以用爬虫来解决这个问题,今天要实现的一个基本需求是完成“博客园“ 博客的自动评论,其实原理是非常简单的,提炼一下需求 基本需求 登录博客园<不实现,登录单独编写博客> 调用评论接口 返回请求结果 确定流程之后,基本就是找突破口的环节了 实际的去评论一下,然后不管你用什么抓包工具都可以,只要抓取到你想要的数据,即可 评论API如下 Request URL: https://www.cnblogs.com/mvc/PostComment/Add.aspx Request Method: POST POST URL 有了,下面就是参数的问题 我随便找了一个请求的参数 {"blogApp":"wuxiaobin","postId":10510784,"body":"继续

优秀的个人博客,低调大师

Python爬虫入门教程 44-100 Charles的安装与使用-手机APP爬虫部分

1. 第二款抓包工具Charles安装与使用 Charles和Fiddler一样,也是一款抓包工具,比Fiddler界面更加清晰,支持多平台 1.1 官方网址 https://www.charlesproxy.com/ 1.2 下载地址 Charles工具下载地址:https://www.charlesproxy.com/download/ 自己去百度一款,我找了2个百度网盘的 链接挂了就不补了啊~ 链接: https://pan.baidu.com/s/1pMawsEv 密码:meuk 链接: https://pan.baidu.com/s/1kV3h0gf 密码: nqaa 下载之后,安装就比较简单了,常规操作即可 2. Charles基本操作 打开Charles在电脑上就可以使用了 2.1 PC设置抓包,包括HTTP和HTTPS 软件安装好了之

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册