首页 文章 精选 留言 我的

精选列表

搜索[安全框架],共10000篇文章
优秀的个人博客,低调大师

Java高并发、分布式框架,从无到有微服务架构设计

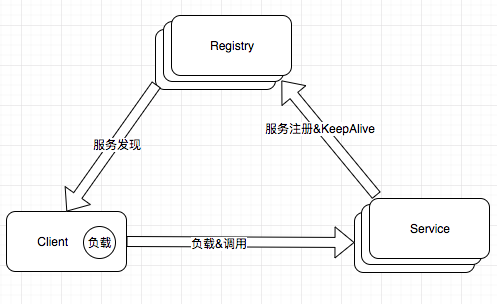
微服务架构模式(Microservice Architect Pattern)。近两年在服务的疯狂增长与云计算技术的进步,让微服务架构受到重点关注 微服务架构是一种架构模式,它提倡将单一应用程序划分成一组小的服务,服务之间互相协调、互相配合,为用户提供最终价值。每个服务运行在其独立的进程中,服务与服务间采用轻量级的通信机制互相沟通(通常是基于HTTP的RESTful API)。每个服务都围绕着具体业务进行构建,并且能够被独立地部署到生产环境、类生产环境等。另外,应尽量避免统一的、集中式的服务管理机制,对具体的一个服务而言,应根据业务上下文,选择合适的语言、工具对其进行构建。 微服务架构优势 首先简单介绍了微服务(Microservices)的内涵及优势,微服务架构的本质,是用一些功能比较明确、业务比较精练的服务去解决更大、更实际的问题。微服务架构将服务拆分,分别采用相对独立的服务对各方面进行管理,彼此之间使用统一的接口来进行交流,架构变得复杂,优势也很明显: 复杂度可控:在将应用分解的同时,规避了原本复杂度无止境的积累。每一个微服务专注于单一功能,并通过定义良好的接口清晰表述服务边界。由于体积小、复杂度低,每个微服务可由一个小规模开发团队完全掌控,易于保持高可维护性和开发效率。 微服务架构 独立部署:由于微服务具备独立的运行进程,所以每个微服务也可以独立部署。当某个微服务发生变更时无需编译、部署整个应用。由微服务组成的应用相当于具备一系列可并行的发布流程,使得发布更加高效,同时降低对生产环境所造成的风险,最终缩短应用交付周期。 技术选型灵活:微服务架构下,技术选型是去中心化的。每个团队可以根据自身服务的需求和行业发展的现状,自由选择最适合的技术栈。由于每个微服务相对简单,当需要对技术栈进行升级时所面临的风险较低,甚至完全重构一个微服务也是可行的。 容错:当某一组建发生故障时,在单一进程的传统架构下,故障很有可能在进程内扩散,形成应用全局性的不可用。在微服务架构下,故障会被隔离在单个服务中。若设计良好,其他服务可通过重试、平稳退化等机制实现应用层面的容错。 扩展:单块架构应用也可以实现横向扩展,就是将整个应用完整的复制到不同的节点。当应用的不同组件在扩展需求上存在差异时,微服务架构便体现出其灵活性,因为每个服务可以根据实际需求独立进行扩展。 互联网高并发相关名词 页面浏览数(page views ) 唯一身份浏览量(Unique PageViews) 独立访问者数量(unique visitors) 重复访问者数量(repeat visitors) 每个访问者的页面浏览数(Page Views per user) 高并发 之前我将高并发的解决方法误认为是线程或者是队列可以解决,因为高并发的时候是有很多用户在访问,导致出现系统数据不正确、丢失数据现象,所以想到 的是用队列解决,其实队列解决的方式也可以处理,比如我们在竞拍商品、转发评论微博或者是秒杀商品等,同一时间访问量特别大,队列在此起到特别的作用,将 所有请求放入队列,以毫秒计时单位,有序的进行,从而不会出现数据丢失系统数据不正确的情况。 经过查资料,高并发的解决方法有俩种,一种是使用缓存、另一种是使用生成静态页面;还有就是从最基础的地方优化我们写代码减少不必要的资源浪费:( 1.不要频繁的new对象,对于在整个应用中只需要存在一个实例的类使用单例模式.对于String的连接操作,使用StringBuffer或者StringBuilder.对于utility类型的类通过静态方法来访问。 避免使用错误的方式,如Exception可以控制方法推出,但是Exception要保留stacktrace消耗性能,除非必要不要使用 instanceof做条件判断,尽量使用比的条件判断方式.使用JAVA中效率高的类,比如ArrayList比Vector性能好。) 高并发 - 需要解决的问题 一:应用缓存 二:HTTP缓存 三:多级缓存 四:池化 五:异步并发 六:扩容 七:队列 高并发-应用缓存 堆缓存 使用Java堆内存来存储缓存对象。使用堆缓存的好处是没有序列化/反序列化,是最快的缓存。缺点也很明显,当缓存的数据量很大时,GC(垃圾回收)暂停时间会变长,存储容量受限于堆空间大小。一般通过软引用/弱引用来存储缓存对象,即当堆内存不足时,可以强制回收这部分内存释放堆内存空间。一般使用堆缓存存储较热的数据。有 Guava Cache: 缓存和ConcurrentMap是非常相像的,但是它们也不完全一样。最根本的区别就是,ConcurrentMap会持有所有添加的对象,直到被显示的移除。而缓存为了限制其内存的使用,通常都会配置成可以自动的将对象移除。在某些情况下即使不自动移除对象也是非常有用的,如LoadingCache它会自动加载缓存对象。 Ehcache 3.x:是一种广泛使用的开源Java分布式缓存。主要面向通用缓存,Java EE和轻量级容器。它具有内存和磁盘存储,缓存加载器,缓存扩展,缓存异常处理程序,一个gzip缓存servlet过滤器,支持REST和SOAP api等特点。 MapDB: mapdb是一个内嵌的纯java的数据库,提供了并发的HashMap、TreeMap、Queue,可以基于堆外或者磁盘来存储数据 高并发-应用缓存 堆外缓存 即缓存数据存储在堆外内存,可以减少GC暂停时间(堆对象转移到堆外,GC扫描和移动的对象变少),但是,读取数据时需要序列化/反序列化,因此会比堆缓存要慢很多。有Ehcache 3.x、MapDB实现 磁盘缓存 即缓存数据存储在磁道上,在JVM重启时数据还存在的,而堆缓存/堆外缓存数据会丢失,需要重新加载。有Ehcache 3.x、MapDB实现 分布式缓存 进程内缓存和磁盘缓存,在多JVM实例的情况下,会存在两个问题: 1、单机容量问题; 2、数据一致性问题(多台JVM实例的缓存数据不一致怎么办?),这个问题不用纠结,既然数据允许缓存,则表示允许一定时间内的不一致,因此可以设置缓存数据的过期时间来定期更新数据; 3、缓存不命中时,需要回源到DB/服务请求多变问题:每个实例在缓存不命中的情况下都会回源到DB加载数据,因此多实例后DB整体的访问量变多了解决办法是可以使用如一致性哈希分片算法。因此,这些情况可以考虑使用分布式缓存来解决。 可以使用ehcache –clustered(配合 Terracotta server) 实现JAVA进程间分布式缓存。最好的办法是使用redis实现分布式缓存。 高并发- HTTP缓存 浏览器缓存是指当我们使用浏览器访问一些网站页面或者http服务时,根据服务端返回的缓存设置响应头将响应内容缓存到浏览器,下次可以直接使用缓存内容或者仅需要去服务端验证内容是否过期即可。这样的好处可以减少浏览器和服务端之间来回传输的数据量,节省带宽提升性能。 解决办法:内容不需要动态(计算、渲染等)速度更快,内容越接近于用户速度越快。像apache traffic server、squid、varnish、nginx等技术都可以来进行内容缓存。 还有CDN就是用来加速用户访问的: 即用户首先访问到全国各地的CDN节点(使用如ATS、Squid实现),如果CDN没命中,会回源到中央nginx集群,该集群如果没有命中缓存(该集群的缓存不是必须的,要根据实际命中情况等决定),最后回源到后端应用集群。 高并发- 多级缓存(分布式缓存) 高并发-池化 在应用系统开发过程中,我们经常会用到池化技术,如对象池、连接池、线程池等,通过池化来减少一些消耗,以提升性能。 对象池通过复用对象从而减少创建对象、垃圾回收 的开销。但是,池化不能太大,太大会影响GC时的扫描时间。 连接池如数据库连接池、Redis连接池、Http连接池,通过复用TCP连接减少创建和释放连接的时间来提升性能。 线程池也是类似的,通过复用线程提升性能。也就是说池化的目的就是通过复用技术提升性能。 高并发-扩容 1、读写分离:当数据库访问量还不是很大的时候,我们可以适当增加服务器,数据库主从复制的方式将读写分离 2、垂直分区:当写入操作一旦增加的时候,那么主从数据库将花更多的时间的放在数据同步上,这个时候服务器也是不堪重负的;那么就有了数据的垂直分区,数据的垂直分区思路是将写入操作比较频繁的数据表,如用户表_user,或者订单表_orders,那么我们就可以把这个两个表分离出来,放在不同的服务器,如果这两个表和其他表存在联表查询,那么就只能把原来的sql语句给拆分了,先查询一个表,在查询另一个,虽然说这个会消耗更过性能,但比起那种大量数据同步,负担还是减轻了不少; 3、水平分区:但是往往事情不尽人意,可能采取垂直分区能撑一段时间,由于网站太火了,访问量又每日100w,一下子蹦到了1000w,这个时候可以采取数据的进行分离,我们可以根据user的Id不同进行分配,如采取%2、 形式,当然这种形式对以后的扩展有了很大的限制,当我由10个分区增加到20个的时候,所有的数据都得重新分区,那么将是一个的很庞大的计算量;几种常见的算法: 哈希算法:就是采用user_id%的方式; 范围:可以根据user_id字符值范围分区,如1-1000为一区,1001-2000则是另一个区等; 映射关系:就是将user_id存在的所对应的分区放在数据库中保存,当用户操作时先去查询所在分区,再进行操作。 喜欢就关注吧 本次给大家推荐一个免费的学习群 744677563,里面概括Java分布式、高并发、JVM、高性能、微服务、区块链、大数据等技术,以及面试资源等。 成就大神不是梦,还是要看你加不加

优秀的个人博客,低调大师

大型分布式C++框架《四:netio之请求包中转站 上》

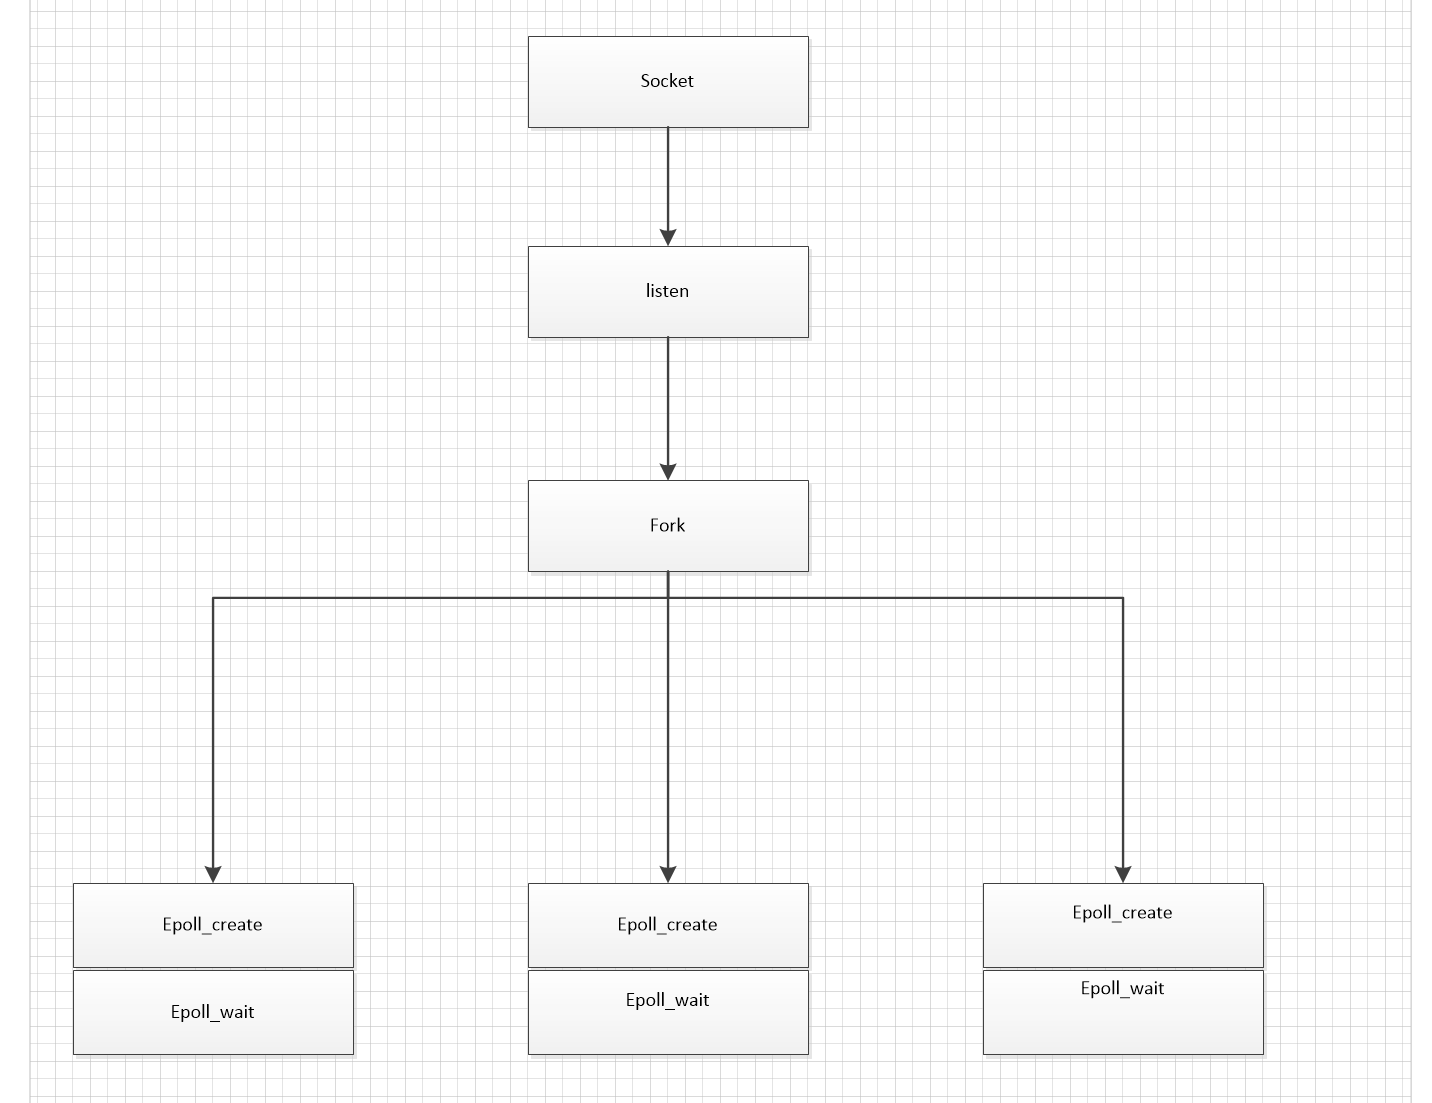
本来一篇文章就该搞定的。结果要分上下篇了。主要是最近颈椎很不舒服。同时还在做秒杀的需求也挺忙的。 现在不能久坐。看代码的时间变少了。然后还买了两本治疗颈椎的书。在学着,不过感觉没啥用。突然心里好害怕。如果颈椎病越来越重。以后的路怎么走。 现在上下班有跑步,然后坐一个小时就起来活动活动。然后在跟着同时们一起去打羽毛球吧。也快30的人了。现在发觉身体才是真的。其他都没什么意思。兄弟们也得注意~~ 废话不多说。下面介绍下netio。 netio在系统中主要是一个分包的作用。netio本事没有任何的业务处理。拿到包以后进行简单的处理。再根据请求的命令字发送到对应的业务处理进程去。 一、多进程下的socket epoll以及“惊群现象” 2.1 多进程下 是监听socket的方式 1)比如我们想创建三个进程同时处理一个端口下到来的请求。 2)父进程先创建socket。然后再listen。注意这个时候父进程frok。 2个进程出来。加上父进程就是3个进程 3)每个进程单独创建字节epoll_create和epoll_wait. 并把socket放到epoll_wait里 以上是平台多进程下监听同一个端口的方式。我们下面探究下为什么要这么做 2.1.1、为什么要fork出来的子进程来继承父进程的socket。而不是多个进程绑定同一个端口? 首先如果一个端口正在被使用,无论是TIME_WAIT、CLOSE_WAIT、还是ESTABLISHED状态。 这个端口都不能被复用,这里面自然也是包括不能被用来LISTEN(监听)。所以在三个进程里分别listen和bind端口肯定会失败的 2.1.2 、为什么不能使用SO_REUSEADDR来是多个进程监听同一个端口? 首先我们来看下SO_REUSEADDR的用途 服务端重启的时候会进入到TIME_WAIT的状态。这个时候我们在bind的端口会失败的。但是我们不可能等TIME_WAIT状态过去在重启服务 因为TIME_WAIT可能会在一分钟以上。这个时候我们设置为SO_REUSEADDR就是使得 端口处在TIME_WAIT时候,可以复用监听。 注意SO_REUSEADDR只是在TIME_WAIT 重启服务的时候有用。如果你是多个进程要bind同一个端口。且IP相同。那么即使你设置了SO_REUSEADDR也会失败 因为SO_REUSEADDR允许在同一端口上启动同一服务器的多个实例,只要每个实例捆绑一个不同的本地IP地址即可。对于TCP,我们根本不可能启动捆绑相同IP地址和相同端口号的多个服务器。 2.1.3、TIME_WAIT的作用。为什么要TIME_WAIT的? 因为TCP实现必须可靠地终止连接的两个方向(全双工关闭), 一方必须进入 TIME_WAIT 状态,因为可能面临重发最终ACK的情形。 否则的会发送RST 2.1.4、多进行下实现监听同一个端口的原因 因为创建子进程的时候,复制了一份socket资源给子进程。其实可以这么理解。其实只有父进程一个socket绑定了端口。其他子进程只是使用的是复制的socket资源 2.1.5、epoll放到fork之后会怎么样? netio起5个进程 james 2356 1 0 08:22 pts/0 00:00:00 ./netio netio_config.xml james 2357 2356 0 08:22 pts/0 00:00:00 ./netio netio_config.xml james 2358 2356 0 08:22 pts/0 00:00:00 ./netio netio_config.xml james 2359 2356 0 08:22 pts/0 00:00:00 ./netio netio_config.xml james 2360 2356 0 08:22 pts/0 00:00:00 ./netio netio_config.xml 我们先做几个实验然后再具体分析 a)实验一 正常请求。我们慢慢的按顺序发送十个请求。每个请求都是新的请求。 我们看下netio处理的进程pid 发现每次都是2358 开始我以为会这五个请求来竞争来取socket接收到的请求化。那么每次处理的请求的子进程应该不一样才对。但是每次都是同一个请求 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2358 b)实验二 我们先并发2个请求。看服务处理进程pid还是2358 after epoll_wait pid:2358 after epoll_wait pid:2358 这个时候我们客户端fork8个进程并发请求服务。发现2357和2358开始交替处理 after epoll_wait pid:2358 after epoll_wait pid:2358 after epoll_wait pid:2357 after epoll_wait pid:2358 after epoll_wait pid:2357 after epoll_wait pid:2358 after epoll_wait pid:2357 after epoll_wait pid:2358 c)实验三 我们在epoll_wait后面.recv之前 加上sleep(100000) 然后发送一个请求。发现每个进程被唤醒以后 但是因为sleep阻塞了。 然后会接着唤醒别的进程来处理。每次唤醒都会被阻塞。一直到5个进程全部被阻塞 after epoll_wait pid:2358 after epoll_wait pid:2357 after epoll_wait pid:2359 after epoll_wait pid:2356 after epoll_wait pid:2360 d)实验四 我们在epoll_wait后面recv 后面 加上是sleep(100000) 然后发送一个请求。发现有一个进程recv处理完以后。sleep住。其他进程并没有被唤醒。 1 after epoll_wait pid:2358 当我们并发两个请求的时候。发现唤醒了两个进程 after epoll_wait pid:2357 after epoll_wait pid:2359 四个实验已经做完现在我们来具体分析下原因 1)实验一中为什么 每次只有一个进程来处理。 首先我们三个进程都epoll_wait同一个fd。按理来说这个时候其实应该唤醒三个进程都来处理的。但是每次都只有一个进程来处理。如果是进程竞争处理的话。别的子进程应该也有机会来处理的。但是没有。这就是我们所谓的“惊群”现象。但是并没有发生。 查了下资料发现。内核采用的不是竞争。而是分配策略。在有多个子进程epoll_wait 同一个fd的时候。会选择一个子进程来处理这个消息。 并不会唤醒其他子进程。 2)实验二中 并发增大的时候 为什么会开始有多个子进程来处理。 其实这里做的很有意思。内核轮流唤醒监听fd的子进程。如果子进程很快处理完。那么就一直让这个子进程来处理fd.但是如果子进程处理不完。速度没那么快。会接着唤醒别的子进程来处理这个fd. 即fd事件到达的时候。内核会先去看下A进程是否繁忙。如果不繁忙 。则让这个A进程一直处理。如果发现A进程繁忙中。会去查看进程B是否繁忙。如果不繁忙则B处理 后面的子进程以此类推 所以我们看到 并发请求增大的时候 开始有多个子进程来处理了 3)实验三、5个进程为什么都被唤醒了? 其实就是上面说的。被sleep住了。我们认为进程就是繁忙状态中。会依次通知其他进程来处理。 4)实验四 为什么只有一个进程被唤醒处理 我们在sleep放在recv之后。发现只有一个进程被唤醒。 我们可以任务进程已经接受并处理了任务。所有不需要再通知其他进程了 这里我们小结下: epoll放在fork之后这种方式不会引起惊群现象。 会轮询选择其中一个子进程来处理。如果子进程来不及处理。则会通知另外一个子进程来处理。 但是以上结论是做实验和查资料得来的。并没有看内核源码。所有如果有看过内核源码的同学。希望能指点下。 2.1.6、epoll放到fork之前会怎么样? 把epoll放到fork 之前。当发送一个请求的时候 发现也是只唤醒了一个进程来处理。 这里其实跟epoll放到fork之后是一样的。 但这里有个很蛋痛的地方 。 我们系统用到了unix域来做消息通知。当container处理完消息。会发送uinx域来通知neito来处理回包。 但是回包的时候。不知道为什么 5个进程都被唤醒了来被处理。最后有三个进程被主动结束了。 下面是我自己的理解 a) 首先 是进程id为 6000 的netio处理的数据。 当container回包实际数据只会通知 f000_6000的uinx域中 如下图。有5个进程。就有5个uinx域 b) 但是由于多进程公用一个epoll。其他进程也被唤醒了。然后判断发现这个fd是uxin域的类型。 然后就会去不停的读取自己对应的unix域文件。 但是其实没有消息的。container只回到了 f000_6000 中所以其他进程一直recvfrom =-1 而且由于正在处理 f000_6000 的进程不够及时。这个消息没处理。epoll的特性是会一直通知进程来处理。所以其他进程会一直读自己的unix域。然后就一直recvfrom =-1 如下图。没贴全。除了进程6000其他进程打印了一堆这样的信息 c) 最后我们读进程6000从的uinx域中读到数据后。 其他进程刚好这个时候拿到fd是被处理过的。这个时候再来处理这个fd就是未定义的。 而我们对未定义的fd会直接stop进程。所以最后三个进程被主动关闭了 这里我们小结一下 因为没有看内核代码 所有对这种情况只有靠实验和猜了。。。。。跪求大神指导 1、首先针对TCP端口内核应该是做了特殊处理。所以epoll在fork前还是后。如果处理及时。应该都是只有一个进程被唤醒。来处理。处理不及时会依次唤醒别的进程。并不会造成惊群现象(就是那种临界资源多个进程来抢这个包。最后只有一个进程能抢到包。但是做实验发现好像并不是竞争的关系) 2、但是针对unix域的fd。公用一个epoll没有特殊处理。 就会造成惊群现象。并且多个进程都能拿到这个fd来处理。 二、netio之定时器 先看下图。netio定时器所处在的位置。 由于epoll_wait了10毫秒。无论是否有请求触发。 每隔10毫秒都会轮询一次。这样可以防止当container通知netio的时候。消息丢失而导致netio不能处理的情况 定时器是一个比较重要的概念。每个服务进程都会有个定时器来处理定时任务。这里介绍下netio的定时器. 这里检查定时时间事件做两件事。一个是找出已经到达的时间事件。并执行子类的具体处理函数。第二个是给自动时间事件续期。 netio初始化的时候。会注册一个60秒的循环时间事件。即每60秒会执行一次时间事件。这个时间事件有以下几个动作。1)清除超时的socket 2)查询本地命令字列表 3)定时输出netio的统计信息 3.1 定时器的数据结构 netio的定时器数据结构是最小堆。即最近的定时任务是在最小堆上 a)申请了65个大小的二维数组 const uint32_t DEFAULT_QUEUE_LEN = 1 + 64; m_pNodeHeap = new CNode*[DEFAULT_QUEUE_LEN]; 这里为什么申请1+64.其实只有64个可用。 其中的一个指针是用来辅助最小堆算法的。 即m_pNodeHeap[0]=NULL; 是一直指向空的。 最小堆的最小值 是m_pNodeHeap【1】. b) CNode成员变量的意义 struct CNode { CNode(ITimerHandler *pTimerHandler = NULL, int iTimerID = 0) : m_pTimerHandler(pTimerHandler) , m_iTimerID(iTimerID) , m_dwCount(0) , bEnable(true) { } ITimerHandler *m_pTimerHandler; int m_iTimerID; CTimeValue m_tvExpired; // TimeValue for first check CTimeValue m_tvInterval; // Time check interval unsigned int m_dwCount; // Counter for auto re-schedule bool bEnable; }; m_pTimerHandler 主要是用来保存父类指针。当时间事件触发的时候。通过父类指针找到继承类。来处理具体的 时间事件 m_tvExpired 记录过期时间。比如一个事件过期时间是10秒。那么m_tvExpired就是存的当前时间+10秒这个值。每次比较的时候。拿最小堆的的这个值跟当前时间比对。如果当前时间小于m_tvExpired说明 没有任何时间时间被触发。如果当前时间大于这个值。则认为需要处理时间事件 m_dwCount 这个是用来设置自动过期时间的次数。比如我们有一个时间事件。我们希望它执行三次。每次的间隔以为1分钟。那么这个值设置为3. 当第一次到达时间时间的时候。我们发现这个值大于0.则对m_tvExpired赋值当前时间+1分钟 重新进入最小堆。然后m_dwCount减一。 下次依然是这样处理。直到m_dwCount这个值到0.我们就认为不需要再自动给这个时间设置定时任务。 bEnable 这个值是用来判断这个事件事件是否还有效。这里的做法很有意思。当一个时间事件执行完。或者不需要的时候。我们先是帮它设置为false.等下次check时间最堆的时候。如果发现这个时间事件是无效的。这个时候在delete m_tvInterval 这个是时间事件的间隔时间。比如我的时间事件是每10秒执行一次。则这个值就设置为10秒 m_iTimerID 这个是时间事件的唯一ID 这个值是自增的。每来一个新时间事件。m_iTimerID都会+1. 因为初始化的时候。这个值为1了。所以最开始的时间事件m_iTimerID的值为2 3.2 定时清理无效连接 a)首先如果有客户端connet进来。 netio会把这个connet的fd保存下来 还有到来的时间。 m_mapTcpHandle[iTcpHandle]=(int)time(NULL); b ) 每次接受到数据 都会更新这个时间 c ) netio有个配置文件。 我们一般是设置为10秒。每次检查定时事件的时候。都会去检查m_mapTcpHandle。 用当前时间 跟m_mapTcpHandle里面保存的时间比较。当发现超过10秒的时候 我们认为这个连接时无效的。然后会把这个fd关闭。并删除 d ) 所以如果 要保持长连接的话。 需要客户端不停的发送心跳包。来更新这个时间 3.3 定时统计netio的统计信息 这有个很有意思的地方。 在初始化的时候。我们已经注册了一个每60秒执行一次输出的netio状态的时间事件 前面我们说了m_dwCount这个值用来控制自动时间事件的次数。我们每一分钟会输出netio的状态信息。 这就是固定的时间事件。我们入参dwCount设置0.那么系统就认为你这个时间事件是需要无限循环的。 就设置了一个最大值 (unsigned int )-1。 这个值算出来是4294967295。 我们以每分钟一次来计算。差不多要8000多年才能把这个m_dwCount减为0~~~~~ if (dwCount > 0) m_l_pNode->m_dwCount = dwCount; else m_l_pNode->m_dwCount = (unsigned int)-1; 当输出完状态信息后。会把netio的一些状态初始化为0.因为我们的状态输出是统计一分钟的状态。比如这一分钟的请求包个数。比率。丢包个数等。 3.4 定时请求命令字 这里还是比较重要的是。比如我们新加了一个服务。如果不重启netio是不知道的。但是我们会没隔一分钟去请求所有的命令字。 可以发现有心的服务加了进来。 三、netio 之日志分析 4.1、netio_debug.log日志分析 下面分析下简单netio的日志。这里就大概介绍了 。不具体在介绍netio的值了 。 多看看就知道是什么意思的。 还是请求道container. container发现参数校验不对直接把包丢回给netio的回包队列 如下图 a)192.168.254.128:58638 当请求到来的时候会打印请求的IP和端口 b)Handle=00700008 但是这个socket不是原生的。是经过处理的。 c)ConnNum=1 当前有多个连接数 d)Timestamp=1460881087 请求到了的时间戳 如下图 a) SendMsgqREQUESTSTART 这里是把内容丢到消息队列里 b)_NotifyNextREQUESTSTART 这里是通知container的uinx域。有消息丢到了你的消息队列里 c)OnRecvFromREQUESTSTART 这里是接收到了container发来的uinx域 。告诉netio我已经处理完。丢到你的回包消息队列里去了。你赶紧去处理吧 d)OnEventFirerequest:0 从消息队列里拿到数据并开始处理。 回给客户端包 e)OnCloseREQUESTSTART 客户端发送close socket信号。 服务端接收后。关闭socket 4.2 netio_perform.log 日志分析 以下都是一份钟的统计数据 PkgRecv 收到的包 PkgSent 发送出去的包 ErrPkgSent 错误的包。 PkgPushFail 这个暂时没用到 PkgSendFail 这个是netio 包发送的时候 。发不出去的个数 BytesRecv 收到的字节数 BytesSent 发送出去的字节数 MaxConn 最大连接数。这个值不是一份内的最大值。是从开始到输出统计是。最高的同时连接数据 TcpConnTimeout 因为超时。netio自动关闭的TCP连接。 Cmd[0x20630001] 是netio从回包队列中拿到。命令字 Count[15] 该命令字一分钟内总共拿到的回包总数 AverageTime[0] 每个包的平均处理时间。 这里是拿这15个包从netio-container-netio这期间的总时间 除以 15得到的平均时间 单位是毫秒 MaxTime[1] 这15个包中耗时最长的一个包。所耗时间 AverageRspLen[89] 平均每个包回给客户端的字节数 MaxRspLen[89] 最大的一个回包字节数 Ratio[100] 这里先会拿到一个一分钟内netio接受包的总个数(这里指客户端来的请求包) 。然后用用0x20630001命令字的个数来除以总包数再乘以100。得到0x20630001在这一分钟内。所占处理包的比重。 后面接着的一串是 命令字0x20630001的分布在不同相应时间的个数 最后一天是正对一分钟所有命令字包的统计 最后: 1)对大型系统。统计日志很重要。可以时事了解系统的状态 2)一定要处理好多进程的关系 3)最后 一定要保护好身体。 身体才是根本啊~~~

优秀的个人博客,低调大师

大型分布式C++框架《三:序列化与反序列化》

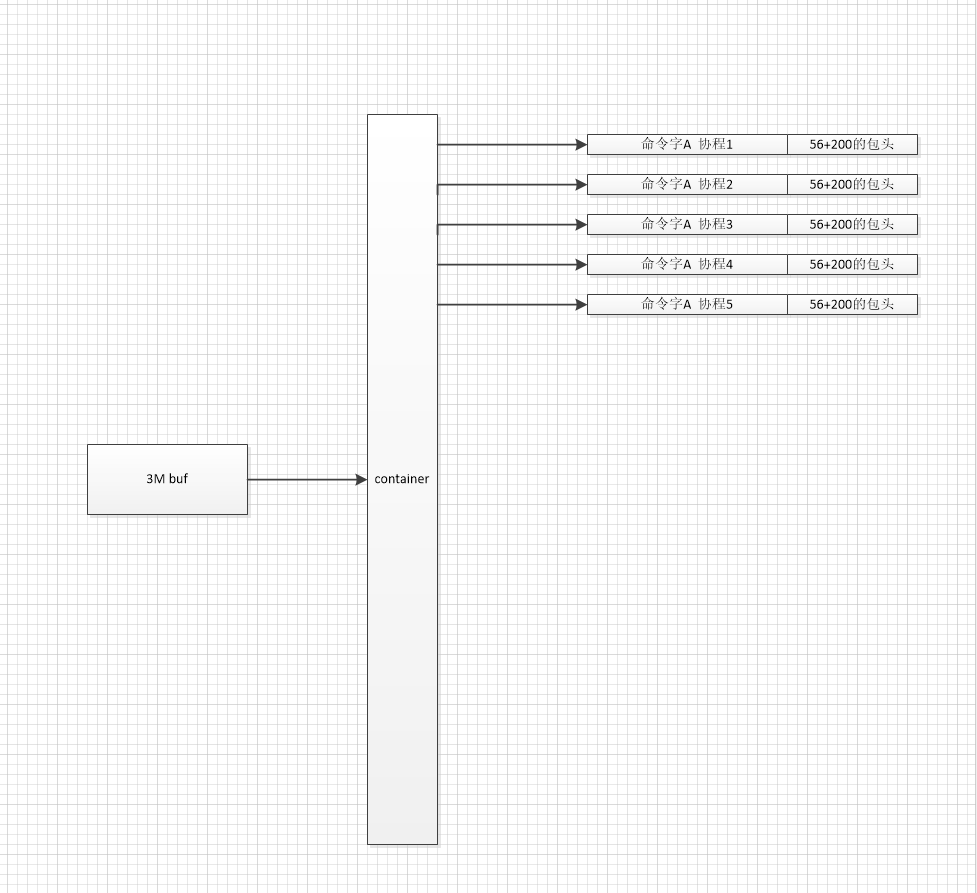
一、前言 个人感觉序列化简单来说就是按一定规则组包。反序列化就是按组包时的规则来接包。正常来说。序列化不会很难。不会很复杂。因为过于复杂的序列化协议会导致较长的解析时间,这可能会使得序列化和反序列化阶段成为整个系统的瓶颈。就像压缩文件、解压文件,会占用大量cpu时间。 所以正常的序列化会在时间和空间上考虑。个人感觉对于电商业务时间应该是相对重要些。毕竟用户没有那么多时间等你解析。 我们是用thrift来序列化的。一份thrift文件生成2份。一份是c++生成的用来编写服务接口。一份是php生成的。所有请求都会先落到前端机器。然后前端机器用php调用服务端函数接口。返回处理结果。这其实是远程调用rpc。 二、分配序列化空间的大小 说序列化之前先说下平台给序列化分配的buf的空间大小 1、每个协程会分配大概固定包头(56个字节)+特殊buf(200个字节)的空间来保存包头。所以首先如果收到的包特殊buf(就是放sessionkey和uid等信息)大于200个字节。会报错不处理。但是并不会给netio 返回一个错误包消息。所以客户端 会一直等到客户端设置的超时时间 2、每个container会分配3M的空间来处理数据。所以去掉包头和特殊buf.剩下的就是可以用来序列化的空间 3*1024*1024-固定包头-特殊buf。 所以最少会有3*1024*1024-56-200的空间 这里其实可以看到协程的好处。这个3M的空间。对于每个协程来说是共享的。因为我们是协程的方式,其实是一种顺序流程,没有协程会跟你竞争使用这个buf的资源。因为可以自己手动控制协程的切换。 如果是多线程的话。可能就要对这个buf加锁。竞争这一个全局资源来处理数据。这也是多线程编程被诟病的一个地方,需要加锁。 三、序列化步骤 1、我们先看下请求。 oCntlInfo.setOperatorUin(10458); oCntlInfo.setOperatorKey("abcde"); oCntlInfo.setRouteKey(1234); std::string source = "aaaaa"; std::string inReserve; std::string errmsg; std::string outStr; std::string machineKey; for(int i =0;i<500*1024;i++) { machineKey.append("a"); } AoActionInfo oActionInfo; oActionInfo.SetDisShopId(1111); oActionInfo.SetDistributorId(2222); uint32_t dwResult = Stub4App.AddActionSupplier( oCntlInfo, machineKey, source, 1, 1, oActionInfo, inReserve, errmsg, outStr); if(dwResult == 0) { std::cout << "Invoke OK!" << std::endl; std::cout << "Invoke OK!" << std::endl; } 客户端直接调用函数接口。到服务端请求结果 最后需要序列化的东西如下是类_Cao_action_AddActionSupplier_Req 函数的入参都是我们需要序列化的内容。注意这里是rpc调用的一个关键点。 2、序列化开始 a) 先看下我们的thritf 如果下图。发现我们的函数入参也是打上了tag标志的。作用跟我们在结构体中打tag标志是一样的。为了标识一个字段的含义。 序列化的时候把这些tag序列化进去。 然后反序列化的时候靠这些tag来解析 b ) 先把图贴出来。按着图来讲更清晰些 c) 首先我们会创建一个CByteStream的类来。序列化内容。在CByteStream的构造函数会自动写入一个字节的序列化包头。值为1 CByteStream(char*pStreamBuf=NULL,uint32_tnBufLen=0,boolbStore=true,boolbRealWrite=true); pStreamBuf 是序列化buf指针 pStreamBuf 是序列化的长度 bStore true表示是否需要包数据存储下来。 false表示不需要把数据存下来 bRealWrite 表示是否支持读写buf d) 接着就开始写类_Cao_action_AddActionSupplier_Req的成员变量。其实就是函数入参。写的时候是先协tag就是下图中的fid。 其实就是在thrift中已经写好的函数入参的tag值。 具体写的过程我们先看简单基本类型。比如strMachineKey 1)先写tag。 strMachineKey 的tag为1. 程序里规定tag占两个字节。所以函数入参可以是0xffff个。 2 ) 接着会写4个固定的字节。用来存储后面紧跟着数据的值。这里strMachineKey的长度是512000. 3 ) 写内容 。 把strMachineKey的内容写入紧跟着的buf 针对整形和长整形就不说了 大同小异 e) 接着我们关注下 是怎么写结构体oActionInfo的。 1)先写tag。 oActionInfo 的tag为5. 程序里规定tag占两个字节。 2 ) 接着针对结构体这里 会写4个固定的字节用来存结构体序列化长度。因为开始不知道所以值为0。 3 ) 接着写字段 DistributorId。 它在oActionInfo结构体中的tag值为6.类型为int64. 所以先写tag=6占两个字节,接着分配4个字节存长度。最后分配8个字节存内容 4)跟着写DisShopId字段。就不细说了 5)最后写了2个字节包尾 6)最后 回写结构体的长度 这里注意下写结构体时候的写法。不注意的话会看错。 1)这里先拿到开始写结构体的buf指针。注意这里是用的int32_t。占四个字节。跟前面保持一直。这里用来的存后面总序列虚化结构体提的总长度。 2)由于刚开始的时候 并不知道后面的结构体会序列化多少个字节。所以这里先写4个字节。 同时把这便宜的4个字节的内存值 设置为0 bs<<0; (这里其实建议写成 bs<<int32_t(0) 会好一点。开起来一致) 这里开始没注意。以为写4个字节值为0的结构体的头。其实这里是放结构体长度的 3)最后第5步。 重新赋值 结构体的长度 1)int32_t* pLen = (int32_t*)bs.getRawBufCur(); 2)bs << 0; 3)int32_t iLen=bs.getWrittenLength(); 4)Serialize_w(bs); 5)*pLen = bs.getWrittenLength() - iLen; f)最后对整个_Cao_action_AddActionSupplier_Req写了两个字节的包尾 g) 我么可以看到oActionInfo其实有一堆的字段。但是我们在请求的时候只写了两个字段。所有在序列化的时候也只序列化了两个字段 其实我们可以看到我们的这种序列化,很整齐。很规则。比较紧凑。但是并不节省空间。这个里面有很多数据可以压缩的。但是压缩带来一个问题就是解压的时候很消耗cpu的。跟我的业务场景不服和。也没必要。 四、序列化解析 其实知道了数据是怎么写入的 解析起来就很容易了。其实这种序列化就是两边约定规则。知道规则以后就可以解析了 解析的具体步骤就不详细说了。这里说下解析的时候几个特殊的地方 1、因为tag占2个字节。所以函数入参不能大于0xffff. 一个结构体的字段个数不能大于0xffff 2、假如前端传入的tag在解析端找不到。解析端会偏移处理下一个tag。所以这是为什么我们可以删除字段的原因。 比如前端传入的结构如下 struct A{ 1:int aa 2:int bb } 但是服务端后台编译后删除了一个字段 struct A{ 1:int aa } a)如果前端只填了字段aa。 那么解析起来没有任何问题.因为不会把字段bb的任何信息序列化进去。 b)假如前端填了 aa 和 bb字段。 那么服务端在解析的时候。拿到tag2。发现找不到对应的数据。 那么它会偏移4个字节取tag2对应字段内容所占的字节数。比如这里是4. 接着它发现是4.就偏移4个字节。不处理字段值内容。直接取下一个tag进行处理 这也就是我们为什么能删除字段的原因。 这样看来我们的函数入参其实也是可以删除的 3、我们服务端新增字段重新编译。前端没有对应的tag。根本不会序列化进来。这也是我们可以增加字段的原因。 4、解析的时候如果发现tag为0.则会是认为解析结束。所以我们的tag是不能为0的 5、这样我们也就能为服务端函数增加入参的。 同一个函数比如前端的入参是4个。服务端可以增加N个. 但是注意不能占用 函数已经用的tag。否则会有问题。而且为了保证函数的统一性。最好别这么做。 6、到这里已经很清晰了。 最后再说一次不能改tag对应的类型。 五、话外 我们的这一套就是远程调用rpc服务。通过我们的序列化。 其实就能了解所谓的RPC服务是什么样的。 说白了,远程调用就是将对象名、函数名、参数等传递给远程服务器,服务器将处理结果返回给客户端。 为了能解析出这些信息。在入参的时候做上标识(这里是打tag). 谷歌的protobuf也用过。跟thrift其实差不多但是序列化和反序列的话的具体实现是有些不同的。 谷歌的protobuf更节省空间 以前具体看过序列化的源码。觉得序列化反序列化以及rpc很神秘。现在看了源码才发现确实写的确实好, 但是没那么神秘里。其实就是按一定规则组包。所以还是要多看源码啊。 我们用的thrift就是 facebook的thrift。但是改了些东西。大体是一样的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册