首页 文章 精选 留言 我的

精选列表

搜索[机器学习系统],共10000篇文章
优秀的个人博客,低调大师

【案例学习】两年打造150,000个容器,看PAYPAL的Docker实践之路

背景介绍 PayPal(贝宝)是美国eBay公司的全资子公司。1998年12月由Peter Thiel及Max Levchin建立,总部位于美国加利福尼亚州圣荷西市。PayPal致力于使金融服务大众化,让人们与企业能够参与到全球经济的繁荣发展中。PayPal开放式的数字支付平台让2.18亿用户相信他们能够以一种全新且强大的方式进行交易。为了实现这一目标,PayPal建立了全球性服务网络,确保用户可以随时、随地使用PayPal。如果PayPal的服务器出现故障,那么这种影响会波及到许多只依靠PayPal进行支付解决方案的小型企业客户。 案例简介 PayPal借助于Docker 企业版来帮助他们提高运营效率(构建、测试、部署周期的速度提高50%)。与此同时,他们通过Docker的动态部署能力和基础设施的独立性提高了其应用程序的可用性。为了提

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 13)——数据类型之整型和浮点型

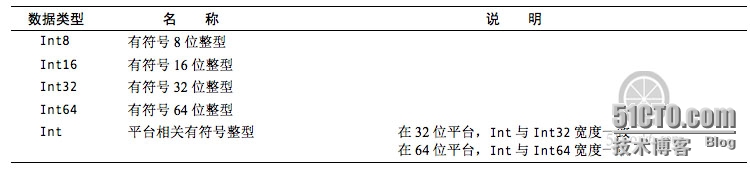
Swift提供8、16、32、64位形式的有符号及无符号整数。这些整数类型遵循C语言的命名规约,我归纳了Swift中的整型: 整型示例: 1 2 3 4 5 6 print( "UInt8range:\(UInt8.min)~\(UInt8.max)" ) print( "Int8range:\(Int8.min)~\(Int8.max)" ) print( "UIntrange:\(UInt.min)~\(UInt.max)" ) print( "UInt64range:\(UInt64.min)~\(UInt64.max)" ) print( "Int64range:\(Int64.min)~\(Int64.max)" ) print( "Intrange:\(Int.min)~\(Int.max)" ) 输出结果如下: UInt8 range: 0 ~ 255 Int8 range: -128 ~ 127 UInt range: 0 ~18446744073709551615 UInt64 range: 0 ~18446744073709551615 Int64 range:-9223372036854775808 ~ 9223372036854775807 Int range:-9223372036854775808 ~ 9223372036854775807 上述代码是通过整数的min和max属性计算各个类型的范围。 浮点型主要用来储存小数数值,也可以用来储存范围较大的整数。它分为浮点数(float)和双精度浮点数(double)两种,双精度浮点数所使用的内存空间比浮点数多,可表示的数值范围与精确度也比较大。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746103,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 14)——字符串的插入、删除和替换

对应可变字符串可以插入、删除和替换,String提供了几个方法可以帮助实现这些操作。这些方法如下: splice(_:atIndex:)。在索引位置插入字符串。 insert(_:atIndex:)。在索引位置插入字符。 removeAtIndex(_:)。在索引位置删除字符。 removeRange(_:)。删除指定范围内的字符串。 replaceRange(_:,with: String)。使用字符串或字符替换指定范围内的字符串。 代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 varstr= "Swift" print( "原始字符串:\(str)" ) str.splice( "Objective-Cand" .characters,atIndex:str.startIndex) print( "插入字符串后:\(str)" ) str.insert( "." ,atIndex:str.endIndex) print( "插入.字符后:\(str)" ) str.removeAtIndex(str.endIndex.predecessor()) print( "删除.字符后:\(str)" ) varstartIndex=str.startIndex varendIndex=advance(startIndex, 9 ) varrange=startIndex...endIndex str.removeRange(range) print( "删除范围后:\(str)" ) startIndex=str.startIndex endIndex=advance(startIndex, 0 ) range=startIndex...endIndex str.replaceRange(range,with: "C++" ) print( "替换范围后:\(str)" ) 输出结果: 原始字符串:Swift 插入字符串后:Objective-C and Swift 插入.字符后:Objective-Cand Swift. 删除.字符后:Objective-Cand Swift 删除范围后:C and Swift 替换范围后:C++ and Swift 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746108,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 53)——do-try-catch错误处理模式

Swift 1.x的错误处理模式存在很多弊端,例如:为了在编程时候省事,给error参数传递一个nil,或者方法调用完成后不去判断error是否为nil,不进行错误处理。 1 2 3 4 5 6 letcontents=NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding,error:nil) //error参数传递一个nil 或者 varerr:NSError? letcontents=NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding,error:&err) 不好的编程习惯,由于Objective-C和Swift 1.x没有强制处理机制,因此一旦真的发生错误,程序就会发生崩溃。 同样的从文件中读取字符串示例,如果使用Swift2错误处理模式代码如下: 1 2 3 4 5 6 7 8 import Foundation do { //要做一些操作 letstr= try NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding) //要尝试做的事情 } catch leterrasNSError{ //如果失败则进入catch代码块 err.description } do-try-catch这种错误模式与Java中异常处理机制非常类似,本意就是尝试(try)做一件事情,如果失败则捕获(catch)处理。 捕获错误 完整的do-try-catch错误处理模式的语法如下: 1 2 3 4 5 6 do { try 语句 成功处理语句组 } catch 匹配错误{ 错误处理语句组 } 在try语句中可以产生错误,当然也可能不会产生错误,如果有错误发生,catch就会处理错误。catch代码块可以有多个,错误由哪个catch代码块处理是由catch后面的错误匹配与否而定的。错误类型的多少就决定了catch可以有多少。我们先介绍一下错误类型。 错误类型 在Swift中错误类型必须遵从ErrorType协议,其次考虑到错误类型的匹配,它应该被设计成为枚举类型,枚举类型非常适合将一组相关值关联起来。 如果我们编写访问数据库表程序,实现对表数据插入、删除、修改和查询等操作,我们会需要类似如下代码的错误类型: 1 2 3 4 enum DAOError:ErrorType{ case NoData case PrimaryKeyNull } NoData表示没有数据情况,PrimaryKeyNull表示表的主键(Primary Key)为空情况。 那么我们就可以通过如下代码捕获错误。 1 2 3 4 5 6 7 do { //try访问数据表函数或方法 } catch DAOError.NoData{ print( "没有数据。" ) }catchDAOError.PrimaryKeyNull{ print( "主键为空。" ) } 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1748300,如需转载请自行联系原作者

优秀的个人博客,低调大师

Swift 2.0学习笔记(Day 6)——哎呀常量和变量都该什么时候用啊?

使用var还是let? 在我们开发过程中啊什么时候定义关键字为var,还是定义为let呢? 其实啊都能满足我们的需求,那我们到底应该如何选择? 例如:可以将圆周率π定义为let或var。 let π = 3.14159 var π = 3.14159 上面代码编译不会报错。但是从业务逻辑层面讲,π应该定义为常量(let)的,因为一方面常量(let)不能修改,另外在程序中使用常量(let)可以提高程序的可读性。 我觉得:原则上优先使用let,它有很多好处,可以防止程序运行过程中不必要的修改、提高程序的可读性。特别是引用数据类型声明时候经常采用let声明,虽然在业务层面上并不是一个常量,而是防止程序运行过程中错误地修改它引用。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746077,如需转载请自行联系原作者

优秀的个人博客,低调大师

IBatis.Net学习笔记十二:发现一个好用的IBatis.Net生成工具

现一个好用的IBatis.Net生成工具,可以根据数据库自动生成domain和xml文件,名称是 MyGeneration 。 我试用了一下,效果不错。 详细介绍参见它的主页: http://www.mygenerationsoftware.com/portal/default.aspx 支持的语言为:C#,vb.net 支持的数据库有: Microsoft SQL , Oracle , IBM DB2 , PostgreSQL , Microsoft Access , FireBird , Interbase , VistaDB , SQLite , MySQL , Advantage andPervasive 支持的架构有: dOOdads ,EntitySpaces,EasyObjects.NET/EntLib, Gentle.NET , Opf3 , NHibernate , Microsoft's DAAB , DotNetNuke , iBatis 也就是说这个工具是根据模板配置的,你也可以写一个自己的模板,来生成自己需要的格式的代码文件,比较方便灵活。 目前已经提供了一些常用的ORM框架的模板 下载地址: http://www.download.com/3001-10252_4-10685426.html?spi=76243c3b641e877670346e8d0bffceb9 IBatis模板的下载地址:http://www.mygenerationsoftware.com/TemplateLibrary/Archive/?guid=19d6d575-13f0-4aad-b887-e8ff7b6b17b2 本文转自永春博客园博客,原文链接:http://www.cnblogs.com/firstyi/archive/2007/10/11/921094.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark RDD概念学习系列之RDD的依赖关系(宽依赖和窄依赖)(三)

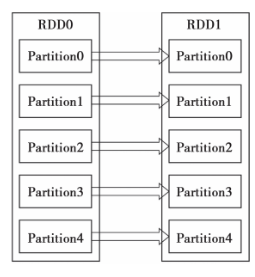
RDD的依赖关系? RDD和它依赖的parent RDD(s)的关系有两种不同的类型,即窄依赖(narrow dependency)和宽依赖(wide dependency)。 1)窄依赖指的是每一个parent RDD的Partition最多被子RDD的一个Partition使用,如图1所示。 2)宽依赖指的是多个子RDD的Partition会依赖同一个parent RDD的Partition,如图2所示。 RDD作为数据结构,本质上是一个只读的分区记录集合。一个RDD可以包含多个分区,每个分区就是一个dataset片段。RDD可以相互依赖。 1)如果RDD的每个分区最多只能被一个Child RDD的一个分区使用,则称之为narrow dependency。 2)如果多个Child RDD分区都可以依赖,则称之为wide / shuffle dependency 。 Spark之所以将依赖分为narrow 和 shuffle / wide 。基于两点原因 1、首先,narrow dependencies可以支持在同一个cluster node上,以pipeline形式执行多条命令,例如在执行了map后,紧接着执行filter。 相反,shuffle / wide dependencies 需要所有的父分区都是可用的,可能还需要调用类似MapReduce之类的操作进行跨节点传递。 2、其次,则是从失败恢复的角度考虑。narrow dependencies的失败恢复更有效,因为它只需要重新计算丢失的parent partition即可,而且可以并行地在不同节点进行重计算。 相反,shuffle / wide dependencies 牵涉RDD各级的多个parent partition。 图 1 RDD的窄依赖 图 2RDD的宽依赖 接下来可以从不同类型的转换来进一步理解RDD的窄依赖和宽依赖的区别,如图3所示。 对于map和filter形式的转换来说,它们只是将Partition的数据根据转换的规则进行转化,并不涉及其他的处理,可以简单地认为只是将数据从一个形式转换到另一个形式。对于union,只是将多个RDD合并成一个,parent RDD的Partition(s)不会有任何的变化,可以认为只是把parent RDD的Partition(s)简单进行复制与合并。对于join,如果每个Partition仅仅和已知的、特定的Partition进行join,那么这个依赖关系也是窄依赖。对于这种有规则的数据的join,并不会引入昂贵的Shuffle。对于窄依赖,由于RDD每个Partition依赖固定数量的parent RDD(s)的Partition(s),因此可以通过一个计算任务来处理这些Partition,并且这些Partition相互独立,这些计算任务也就可以并行执行了。 对于groupByKey,子RDD的所有Partition(s)会依赖于parent RDD的所有Partition(s),子RDD的Partition是parent RDD的所有Partition Shuffle的结果,因此这两个RDD是不能通过一个计算任务来完成的。同样,对于需要parent RDD的所有Partition进行join的转换,也是需要Shuffle,这类join的依赖就是宽依赖而不是前面提到的窄依赖了。 不同的操作依据其特性,可能会产生不同的依赖。例如map、filter操作会产生narrow dependency。reduceBykey操作会产生wide / shuffle dependency。 通俗点来说,RDD的每个Partition,仅仅依赖于父RDD中的一个Partition,这才是窄。就这么简单! 反正子Rdd的partition和父Rdd的Partition如果是一对一就是窄依赖,这样理解就好区分了 !!! 我以前总感觉这是窄依赖,其实 Rdd1的partition0依赖父Rdd0的 partition0和partition1,所以是宽依赖! 所有的依赖都要实现trait Dependency[T]: abstract class Dependency[T] extends Serializable { def rdd: RDD[T] } 其中rdd就是依赖的parent RDD。 对于窄依赖的实现(有两种) abstract class NarrowDependency[T](_rdd: RDD[T]) extends Dependency[T] { //返回子RDD的partitionId依赖的所有的parent RDD的Partition(s) def getParents(partitionId: Int): Seq[Int] override def rdd: RDD[T] = _rdd } 窄依赖是有两种具体实现,分别如下: ·一种是一对一的依赖,即OneToOneDependency: class OneToOneDependency[T](rdd: RDD[T]) extends NarrowDependency[T](rdd) { override def getParents(partitionId: Int) = List(partitionId) 通过getParents的实现不难看出,RDD仅仅依赖于parent RDD相同ID的Partition。 还有一个是范围的依赖,即 RangeDependency,它仅仅被org.apache.spark.rdd.UnionRDD使用。UnionRDD是把多个RDD合成一个RDD,这些RDD是被拼接而成,即每个parent RDD的Partition的相对顺序不会变,只不过每个parent RDD在UnionRDD中的Partition的起始位置不同。因此它的getPartents如下: override def getParents(partitionId: Int) = { if(partitionId >= outStart && partitionId < outStart + length) { List(partitionId - outStart + inStart) } else { Nil } } 其中,inStart是parent RDD中Partition的起始位置,outStart是在UnionRDD中的起始位置,length就是parent RDD中Partition的数量。 对于宽依赖的实现(只有一种) 宽依赖的实现只有一种:ShuffleDependency。子RDD依赖于parent RDD的所有Partition,因此需要Shuffle过程: class ShuffleDependency[K, V, C]( @transient _rdd: RDD[_ <: Product2[K, V]], val partitioner: Partitioner, val serializer: Option[Serializer] = None, val keyOrdering: Option[Ordering[K]] = None, val aggregator: Option[Aggregator[K, V, C]] = None, val mapSideCombine: Boolean = false) extends Dependency[Product2[K, V]] { override def rdd = _rdd.asInstanceOf[RDD[Product2[K, V]]] //获取新的shuffleId val shuffleId: Int = _rdd.context.newShuffleId() //向ShuffleManager注册Shuffle的信息 val shuffleHandle: ShuffleHandle = _rdd.context.env.shuffleManager.registerShuffle( shuffleId, _rdd.partitions.size, this) _rdd.sparkContext.cleaner.foreach(_.registerShuffleForCleanup(this)) } 注意:宽依赖支持两种Shuffle Manager。 即org.apache.spark.shuffle.hash.HashShuffleManager(基于Hash的Shuffle机制) 和org.apache.spark.shuffle.sort.SortShuffleManager(基于排序的Shuffle机制)。 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5723403.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop概念学习系列之如何去找到历史版本的Hadoop发行包(三十四)

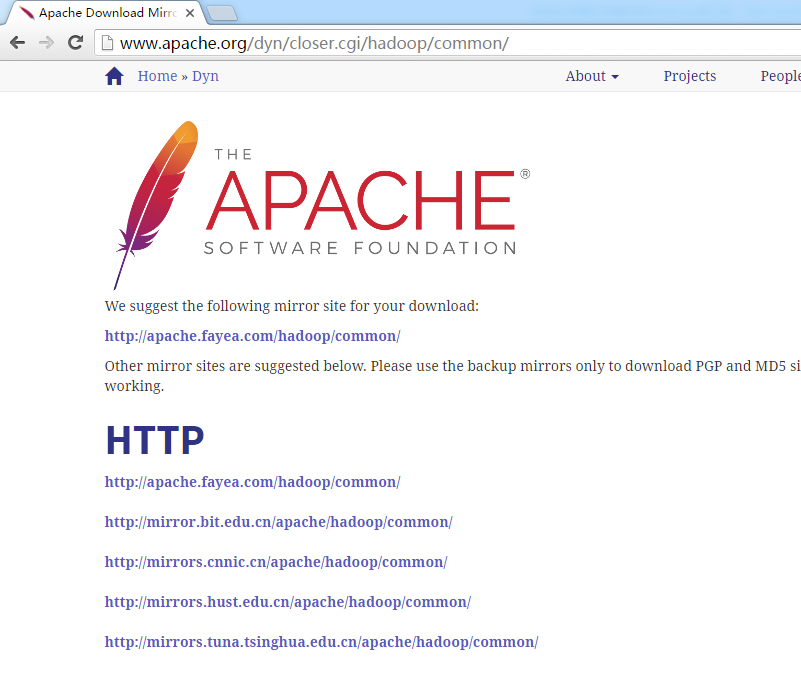
如何去找到历史版本的Hadoop发行包 找到Hadoop历史版本 这里我需要的Hadoop版本是2.0.3。打开hadoop的下载页面 http://www.apache.org/dyn/closer.cgi/hadoop/common/ 随便打开一个下载镜像,我们都找不到2.0.3这个版本。 具体怎么找到历史版本的Hadoop发行包,步骤如下: http://hadoop.apache.org/releases.html https://archive.apache.org/dist/hadoop/common/ 成功! 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5891316.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop概念学习系列之Hadoop HA进一步深入(二十八)

对于Hadoop里的HA,有hdfs HA和resourcemanger HA之分。 1、hdfs HA 为什么引入federation? 因为,这样能达到允许在一个集群里,有多对namenode。通常引入hdfs HA后,是一对namenode。但,在其后,又引入了federation。 以上是,weekend01(active)、weekend02(standby) 当weekend01给kill 掉namenode, 变成weekend01(standby)、weekend02(active) ********************************************************************************************************* 模拟weekend02断电 以上是weekend01(standby)、weekend02(active) 当weekend02断电后,再启动 weekend01(active)、weekend02(standby) *************************************************************************************************** 以上是weekend01(active)、weekend02(standby) 当weekend01在传文件时,weekend02杀掉namenode进程, 依然还是weekend01(active)、weekend02(standby) 以上是weekend01、02的hdfs的HA测试 ----------------------------------------------------------------------------------------------------------------------------------、 2、yarn HA 现在,用指令来切换 这样,是告诉我们,有时候会碰到,如weekend01、02都是standby时,来命令将其中一个切换成active weekend03、04的yarn的HA测试 现在,来测试 会发现,yrcrm1 变成 yrcrm2 只是,yarn的HA仅限于此,跟hdfs的HA不一样, 如weekend01(active)在上传文件,突然中断,weekend02(standby) 对于,weekend03、04的yarn的HA, 现在是,weekend03(standby)提交作业,weekend04(active) weekend07上,共有8个yarnchild, Weekend05、06、07一起,是20个yarnchild,跑作业的节点。 对于,weekend03、04的yarn的HA, 现在是,weekend03(standby)提交作业,weekend04(active) 现在依然还是,weekend03(standby)提交作业,weekend04(active) 以上是Weekend03、4的yarn的HA测试 总结: 以上是weekend01、02的hdfs的HA测试 Weekend03、4的yarn的HA测试 Weekend05、06、07是用来跑作业的, 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5728060.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册