首页 文章 精选 留言 我的

精选列表

搜索[云数据库独享集群],共10000篇文章
优秀的个人博客,低调大师

智能数据构建与管理Dataphin公共云公测

产品介绍: 智能数据构建与管理Dataphin是智能大数据平台建设引擎,面向各行各业大数据建设、管理及应用诉求,一站式提供从数据接入到数据消费全链路的智能数据构建与管理的大数据能力,包括产品、技术和方法论等,助力打造标准统一、融会贯通、资产化、服务化、闭环自优化的智能数据体系,以驱动创新。适用客户: 有数据规范建设诉求的客户发布功能: 智能数据构建与管理Dataphin旨在通过提供数据引入、数据研发、数仓建模&自动化研发、数据萃取、数据资产管理、数据主题化服务的全链路、一站式产品+技术+方法论服务,助力客户高效搭建高质的自有数据中台(向下兼容复杂的大数据计算及存储,向上对接多样的大数据应用),灵活、高效地支持好业务前台决策、营销等场景需求。核心功能及价值点:1)数仓规划:全局架构逻辑空间和物理空间,包括通用定义、组织管理、资源管控2)数据引入:提供多种异构数据源的数据读写入能力,提供脏数据过滤、流量控制等功能3)数据智能研发:配置逻辑数据模型,并通过数据智能引擎自动生成物理模型和SQL代码4)数据资产管理:提供数据的资产化管理能力,提供可视化查看资产全景、查询元数据等功能5)调度中心:支持百万级别任务的稳定调度和维护6)主题式数据服务:支持逻辑数据模型的雪花关联式主题查询付费方式: 支持购买智能研发版,5w元/月产品文档: https://help.aliyun.com/product/87584.html?spm=5176.cndataphin.0.0.52545cafRWszNL&aly_as=7YL6CpLU

优秀的个人博客,低调大师

Tablestore结合Blink公共云使用手册

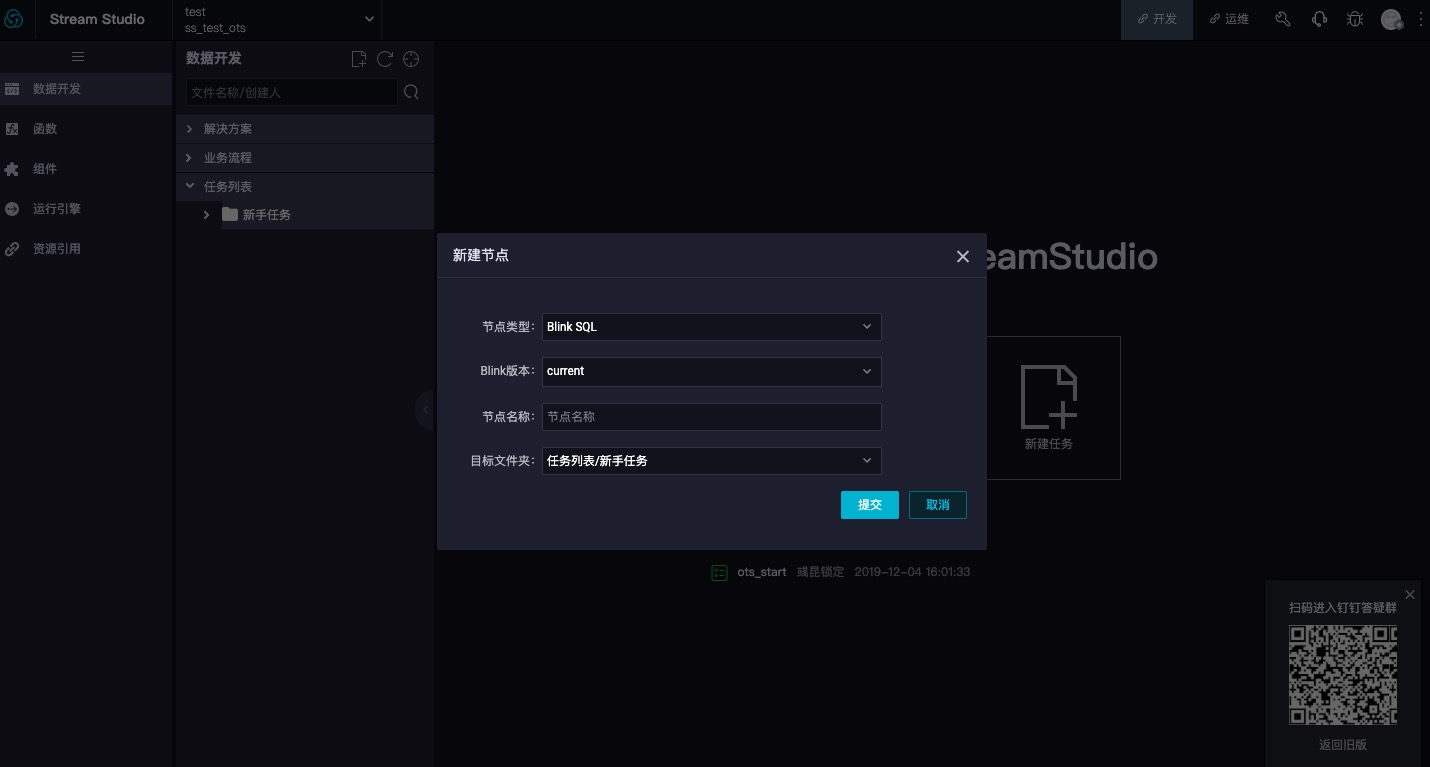
前言 本文将介绍在Blink实时计算平台建立以Tablestore作为流计算的源表以及结果表作业的流程。 表格存储通道服务 表格存储通道服务是基于表格存储(Tablestore)数据接口之上的全增量一体化服务,它通过一组Tunnel Service API和SDK为用户提供了增量、全量和增量加全量三种类型的分布式数据实时消费通道。通过为数据表建立Tunnel Service数据通道,用户可以通过流式计算的方式对表中历史存量和新增的数据进行消费处理。流计算能将Tunnel Service数据通道作为流式数据的输入,每条数据类似一个JSON格式,如下所示: { "OtsRecordType": "PUT", // 数据操作类型,包括PUT、UPDATE、DELETE "OtsRecordTimestamp": 1506416585740836, //数据写入时间(微秒),全量数据时为0 "PrimaryKey": [ { "ColumnName": "pk_1", //第一主键列 "Value": 1506416585881590900 }, { "ColumnName": "pk_2", //第二主键列 "Value": "string_pk_value" } ], "Columns": [ { "OtsColumnType": "Put", // 列操作类型,包括PUT、DELETE_ONE_VERSION、DELETE_ALL_VERSION "ColumnName": "attr_0", "Value": "hello_table_store", }, { "OtsColumnType": "DELETE_ONE_VERSION", // DELETE操作没有Value字段 "ColumnName": "attr_1" } ] } 其中,数据的各个主键和属性列值均可以在BLINK DDL以列名以及相应的类型映射读取,例如上述实例,我们需要定义的DDL如下所示: create table tablestore_stream( pk_1 BIGINT, pk_2 VARCHAR, attr_0 VARCHAR, attr_1 DOUBLE, primary key(pk_1, pk_2) ) with ( type ='ots', endPoint ='http://blink-demo.cn-hangzhou.vpc.tablestore.aliyuncs.com', instanceName = "blink-demo", tableName ='demo_table', tunnelName = 'blink-demo-stream', accessId ='xxxxxxxxxxx', accessKey ='xxxxxxxxxxxxxxxxxxxxxxxxxxxx', ignoreDelete = 'false' //是否忽略delete操作的数据 ); 如果字段名称有前缀,需要使用反撇,例:OTS字段名称为TEST.test,BLINK DDL定义为TEST.test。而OtsRecordType、OtsRecordTimestamp字段以及每个Column的OtsColumnType字段都会支持通过属性字段的方式读取: 字段名 说明 OtsRecordType 数据操作类型 OtsRecordTimestamp 数据操作时间(全量数据时为0) 列名_OtsColumnType 以具体列名和_"_____OtsColumnType__"_拼接,某列的操作类型 需要OtsRecordType和某些Column的OtsColumnType字段时,Blink提供了HEADER关键字用于获取源表中的属性字段,具体DDL: create table tablestore_stream( OtsRecordType VARCHAR HEADER, OtsRecordTimestamp BIGINT HEADER, pk_1 BIGINT, pk_2 VARCHAR, attr_0 VARCHAR, attr_1 DOUBLE, attr_1_OtsColumnType VARCHAR HEADER, primary key(pk_1, pk_2) ) with ( ... ); WITH参数 参数 注释说明 备注 endPoint 表格存储的实例访问地址 endPoint instanceName 表格存储的实例名称 instanceName tableName 表格存储的数据表名 tableName tunnelName 表格存储数据表的数据通道名 tunnelName accessId 表格存储读取的accessKey accessId accessKey 表格存储读取的秘钥 ignoreDelete 是否忽略DELETE操作类型的实时数据 可选,默认为false SQL示例 数据同步,ots sink会以update的方式写入结果表: create table otsSource ( pkstr VARCHAR, pklong BIGINT, col0 VARCHAR, primary key(pkstr, pklong) ) WITH ( type ='ots', endPoint ='http://blink-demo.cn-hangzhou.ots.aliyuncs.com', instanceName = "blink-demo", tableName ='demo_table', tunnelName = 'blink-demo-stream', accessId ='xxxxxxxxxxx', accessKey ='xxxxxxxxxxxxxxxxxxxxxxxxxxxx', ignoreDelete = 'true' ); CREATE TABLE otsSink ( pkstr VARCHAR, pklong BIGINT, col0 VARCHAR, primary key(pkstr, pklong) ) WITH ( type='ots', instanceName='blink-target', tableName='demo_table', accessId ='xxxxxxxxxxx', accessKey ='xxxxxxxxxxxxxxxxxxxxxxxxxxxx', endPoint='https://blink-target.cn-hangzhou.ots.aliyuncs.com', valueColumns='col0' ); INSERT INTO otsSink SELECT t.pkstr, t.pklong, t.col0 FROM otsSource AS t 流计算作业建立流程 在Blink实时计算平台数据开发模块建立新任务,并填写节点类型、Blink版本、节点名称以及目标文件夹等相关内容,如下图所示:新建任务之后,进入该任务,点击切换为SQL模式按钮。按照之前介绍的DDL定义开发自己的任务。如下图所示:作业完成之后,点击发布,选择运行环境及配置可用CU,此次建立的流式作业就正式启动了,可通过运维界面管理作业以及查看作业运行相关信息。如下图所示:

优秀的个人博客,低调大师

Tablestore结合Blink公有云使用手册

前言 本文将介绍在Blink实时计算平台建立以Tablestore作为流计算的源表以及结果表作业的流程。 表格存储通道服务 表格存储通道服务是基于表格存储(Tablestore)数据接口之上的全增量一体化服务,它通过一组Tunnel Service API和SDK为用户提供了增量、全量和增量加全量三种类型的分布式数据实时消费通道。通过为数据表建立Tunnel Service数据通道,用户可以通过流式计算的方式对表中历史存量和新增的数据进行消费处理。流计算能将Tunnel Service数据通道作为流式数据的输入,每条数据类似一个JSON格式,如下所示: { "OtsRecordType": "PUT", // 数据操作类型,包括PUT、UPDATE、DELETE "OtsRecordTimestamp": 1506416585740836, //数据写入时间(微秒),全量数据时为0 "PrimaryKey": [ { "ColumnName": "pk_1", //第一主键列 "Value": 1506416585881590900 }, { "ColumnName": "pk_2", //第二主键列 "Value": "string_pk_value" } ], "Columns": [ { "OtsColumnType": "Put", // 列操作类型,包括PUT、DELETE_ONE_VERSION、DELETE_ALL_VERSION "ColumnName": "attr_0", "Value": "hello_table_store", }, { "OtsColumnType": "DELETE_ONE_VERSION", // DELETE操作没有Value字段 "ColumnName": "attr_1" } ] } 其中,数据的各个主键和属性列值均可以在BLINK DDL以列名以及相应的类型映射读取,例如上述实例,我们需要定义的DDL如下所示: create table tablestore_stream( pk_1 BIGINT, pk_2 VARCHAR, attr_0 VARCHAR, attr_1 DOUBLE, primary key(pk_1, pk_2) ) with ( type ='ots', endPoint ='http://blink-demo.cn-hangzhou.vpc.tablestore.aliyuncs.com', instanceName = "blink-demo", tableName ='demo_table', tunnelName = 'blink-demo-stream', accessId ='xxxxxxxxxxx', accessKey ='xxxxxxxxxxxxxxxxxxxxxxxxxxxx', ignoreDelete = 'false' //是否忽略delete操作的数据 ); 如果字段名称有前缀,需要使用反撇,例:OTS字段名称为TEST.test,BLINK DDL定义为TEST.test。而OtsRecordType、OtsRecordTimestamp字段以及每个Column的OtsColumnType字段都会支持通过属性字段的方式读取: 字段名 说明 OtsRecordType 数据操作类型 OtsRecordTimestamp 数据操作时间(全量数据时为0) 列名_OtsColumnType 以具体列名和_"_____OtsColumnType__"_拼接,某列的操作类型 需要OtsRecordType和某些Column的OtsColumnType字段时,Blink提供了HEADER关键字用于获取源表中的属性字段,具体DDL: create table tablestore_stream( OtsRecordType VARCHAR HEADER, OtsRecordTimestamp BIGINT HEADER, pk_1 BIGINT, pk_2 VARCHAR, attr_0 VARCHAR, attr_1 DOUBLE, attr_1_OtsColumnType VARCHAR HEADER, primary key(pk_1, pk_2) ) with ( ... ); WITH参数 参数 注释说明 备注 endPoint 表格存储的实例访问地址 endPoint instanceName 表格存储的实例名称 instanceName tableName 表格存储的数据表名 tableName tunnelName 表格存储数据表的数据通道名 tunnelName accessId 表格存储读取的accessKey accessId accessKey 表格存储读取的秘钥 ignoreDelete 是否忽略DELETE操作类型的实时数据 可选,默认为false SQL示例 数据同步,ots sink会以update的方式写入结果表: create table otsSource ( pkstr VARCHAR, pklong BIGINT, col0 VARCHAR, primary key(pkstr, pklong) ) WITH ( type ='ots', endPoint ='http://blink-demo.cn-hangzhou.ots.aliyuncs.com', instanceName = "blink-demo", tableName ='demo_table', tunnelName = 'blink-demo-stream', accessId ='xxxxxxxxxxx', accessKey ='xxxxxxxxxxxxxxxxxxxxxxxxxxxx', ignoreDelete = 'true' ); CREATE TABLE otsSink ( pkstr VARCHAR, pklong BIGINT, col0 VARCHAR, primary key(pkstr, pklong) ) WITH ( type='ots', instanceName='blink-target', tableName='demo_table', accessId ='xxxxxxxxxxx', accessKey ='xxxxxxxxxxxxxxxxxxxxxxxxxxxx', endPoint='https://blink-target.cn-hangzhou.ots.aliyuncs.com', valueColumns='col0' ); INSERT INTO otsSink SELECT t.pkstr, t.pklong, t.col0 FROM otsSource AS t 流计算作业建立流程 在Blink实时计算平台数据开发模块建立新任务,并填写节点类型、Blink版本、节点名称以及目标文件夹等相关内容,如下图所示:新建任务之后,进入该任务,点击切换为SQL模式按钮。按照之前介绍的DDL定义开发自己的任务。如下图所示:作业完成之后,点击发布,选择运行环境及配置可用CU,此次建立的流式作业就正式启动了,可通过运维界面管理作业以及查看作业运行相关信息。如下图所示:

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册