首页 文章 精选 留言 我的

精选列表

搜索[腾讯技术创作特训营S8],共10000篇文章
优秀的个人博客,低调大师

【Java技术探索】「ConcurrentHashMap」深入浅出的源码分析(JDK1.7版本)

## 前提概要 - **ConcurrentHashMap是Java并发包中提供的一个线程安全且高效的HashMap实现,以及被广泛使用,经典的开源框架Spring的底层数据结构就是使用ConcurrentHashMap实现的**。 - **ConcurrentHashMap在并发编程的场景中使用频率非常之高,本文就来分析下ConcurrentHashMap的实现原理,并对其实现原理进行分析(JDK1.7)**。 - **与同是线程安全的老大哥HashTable相比,它已经更胜一筹,因此它的锁更加细化,而不是像HashTable一样为几乎每个方法都添加了synchronized锁,这样的锁无疑会影响到性能。** ## 实现原理 > **众所周知,哈希表是中非常高效,复杂度为O(1)的数据结构,在Java开发中,我们最常见到最频繁使用的就是HashMap和HashTable,但是在线程竞争激烈的并发场景中使用都不够合理**。 - **HashMap:先说HashMap,HashMap是线程不安全的,在并发环境下,可能会形成环状链表(扩容时可能造成),导致get操作时,cpu空转,所以,在并发环境中使用HashMap是非常危险的**。 - **HashTable:HashTable和HashMap的实现原理几乎一样,差别: 1. **HashTable不允许key和value为null**; 2. **HashTable是线程安全的**。 - **HashTable线程安全的策略实现代价却太大了,简单粗暴,get/put所有相关操作都是synchronized的**,**这相当于给整个哈希表加了一把大锁,多线程访问时候,只要有一个线程访问或操作该对象,那其他线程只能阻塞,相当于将所有的操作串行化,在竞争激烈的并发场景中性能就会非常差**。 ![](https://oscimg.oschina.net/oscnet/up-7109c45e6c385d4955c6a83e7d388cd1c29.png) > HashTable性能差主要是由于所有操作需要竞争同一把锁,而如果容器中有多把锁,每一把锁锁一段数据,这样在多线程访问时不同段的数据时,就不会存在锁竞争了,这样便可以有效地提高并发效率。**这就是ConcurrentHashMap所采用的"分段锁"思想**。 ![](https://oscimg.oschina.net/oscnet/up-9547fd89b675851827e66d2d0333b0c13d1.png) ## **ConcurrentHashMap的主干是个Segment数组**。 ```java final Segment [] segments; ``` - **Segment继承ReentrantLock,所以它就是一种可重入锁ReentrantLock**。 - ConcurrentHashMap,一个Segment就是一个子哈希表,Segment里维护了一个HashEntry数组,并发环境下,对于不同Segment的数据进行操作是不用考虑锁竞争的。 就按默认的ConcurrentLevel为16来讲,理论上就允许16个线程并发执行,有木有很酷 **对于同一个Segment的操作才需考虑线程同步,不同的Segment则无需考虑。** > **Segment类似于HashMap,一个Segment维护着一个HashEntry数组** ```java transient volatile HashEntry [] table; ``` HashEntry是目前我们提到的最小的逻辑处理单元了。 **一个ConcurrentHashMap维护一个Segment数组,一个Segment维护一个HashEntry数组。** ```java static final class HashEntry { final int hash; final K key; volatile V value; volatile HashEntry next; //其他省略 } ``` **Segment类似哈希表(HashTable),那么一些属性就跟我们之前提到的HashMap差不离,比如负载因子loadFactor,比如阈值threshold等等,看下Segment的构造方法** ```java public Segment(float lf, int threshold, HashEntry [] tab) { this.loadFactor = lf;//负载因子 this.threshold = threshold;//阈值 this.table = tab;//主干数组即HashEntry数组 } ``` 我们来看下ConcurrentHashMap的构造方法 ```java public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { if (!(loadFactor > 0) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); //MAX_SEGMENTS 为1<<16=65536,也就是最大并发数为65536 if (concurrencyLevel > MAX_SEGMENTS) concurrencyLevel = MAX_SEGMENTS; //2的sshif次方等于ssize,例:ssize=16,sshift=4;ssize=32,sshif=5 int sshift = 0; //ssize 为segments数组长度,根据concurrentLevel计算得出 int ssize = 1; while (ssize < concurrencyLevel) { ++sshift; ssize <<= 1; } //segmentShift和segmentMask这两个变量在 //定位segment时会用到,后面会详细讲 this.segmentShift = 32 - sshift; this.segmentMask = ssize - 1; if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; // 计算cap的大小,即Segment中HashEntry的数组长度, // cap也一定为2的n次方. int c = initialCapacity / ssize; if (c * ssize < initialCapacity) ++c; int cap = MIN_SEGMENT_TABLE_CAPACITY; while (cap < c) cap <<= 1; // 创建segments数组并初始化第一个Segment, // 其余的Segment延迟初始化 Segment s0 = new Segment (loadFactor, (int)(cap * loadFactor), (HashEntry [])new HashEntry[cap]); Segment [] ss = (Segment [])new Segment[ssize]; UNSAFE.putOrderedObject(ss, SBASE, s0); this.segments = ss; } ``` > 初始化方法有三个参数,如果用户不指定则会使用默认值,initialCapacity为16,loadFactor为0.75(负载因子,扩容时需要参考),concurrentLevel为16。 **Segment数组的大小ssize是由concurrentLevel来决定的,但是却不一定等于concurrentLevel,ssize一定是大于或等于concurrentLevel的最小的2的次幂**。 > **比如:默认情况下concurrentLevel是16,则ssize为16;若concurrentLevel为14,ssize为16;若concurrentLevel为17,则ssize为32**。 **为什么Segment的数组大小一定是2的次幂?其实主要是便于通过按位与的散列算法来定位Segment的index。** ## 重要的属性 首先来看几个重要的属性,与HashMap相同的就不再介绍了,这里重点解释一下sizeCtl这个属性。可以说它是ConcurrentHashMap中出镜率很高的一个属性,因为它是一个控制标识符,在不同的地方有不同用途,而且它的取值不同,也代表不同的含义。 负数代表正在进行初始化或扩容操作 -1 代表正在初始化 -N 表示有N-1个线程正在进行扩容操作 正数或0代表hash表还没有被初始化,这个数值表示初始化或下一次进行扩容的大小,这一点类似于扩容阈值的概念。还后面可以看到,它的值始终是当前ConcurrentHashMap容量的0.75倍,这与loadfactor是对应的。 接下来,我们来看看put方法 ```java public V put(K key, V value) { Segment s; //concurrentHashMap不允许key/value为空 if (value == null) throw new NullPointerException(); //hash函数对key的hashCode重新散列,避免差劲的不合理的hashcode,保证散列均匀 int hash = hash(key); //返回的hash值无符号右移segmentShift位与段掩码进行位运算, // 定位segment int j = (hash >>> segmentShift) & segmentMask; if ((s = (Segment ) // nonvolatile; recheck UNSAFE.getObject(segments, (j << SSHIFT) + SBASE)) == null) // in ensureSegment s = ensureSegment(j); return s.put(key, hash, value, false); } ``` ### put的主要逻辑也就两步: 1. **定位segment并确保定位的Segment已初始化** 2. **调用Segment的put方法。** > 关于segmentShift和segmentMask > **segmentShift和segmentMask这两个全局变量的主要作用是用来定位Segment**,**int j =(hash >>> segmentShift) & segmentMask**。 - segmentMask:**段掩码,假如segments数组长度为16,则段掩码为16-1=15;segments长度为32,段掩码为32-1=31。这样得到的所有bit位都为1,可以更好地保证散列的均匀性** - segmentShift:**2的sshift次方等于ssize,segmentShift=32-sshift。若segments长度为16,segmentShift=32-4=28;若segments长度为32,segmentShift=32-5=27。而计算得出的hash值最大为32位,无符号右移segmentShift,则意味着只保留高几位(其余位是没用的),然后与段掩码segmentMask位运算来定位Segment**。 ### get/put方法 #### get方法 ```java public V get(Object key) { Segment s; HashEntry [] tab; int h = hash(key); long u = (((h >>> segmentShift) & segmentMask) << SSHIFT) + SBASE; //先定位Segment,再定位HashEntry if ((s = (Segment ) UNSAFE.getObjectVolatile(segments, u)) != null && (tab = s.table) != null) { for (HashEntry e = (HashEntry ) UNSAFE.getObjectVolatile (tab, ((long)(((tab.length - 1) & h)) << TSHIFT) + TBASE); e != null; e = e.next) { K k; if ((k = e.key) == key || (e.hash == h && key.equals(k))) return e.value; } } return null; } ``` get方法无需加锁,由于其中涉及到的共享变量都使用volatile修饰,volatile可以保证内存可见性,所以不会读取到过期数据。 来看下concurrentHashMap代理到Segment上的put方法,Segment中的put方法是要加锁的。只不过是锁粒度细了而已。 ```java final V put(K key, int hash, V value, boolean onlyIfAbsent) { HashEntry node = tryLock() ? null : scanAndLockForPut(key, hash, value); //tryLock不成功时会遍历定位到的HashEnry位置的链表(遍历主要是为了使CPU缓存链表),若找不到,则创建HashEntry。 // tryLock一定次数后(MAX_SCAN_RETRIES变量决定),则lock。若遍历过程中,由于其他线程的操作导致链表头结点变化,则需要重新遍历。 V oldValue; try { HashEntry [] tab = table; int index = (tab.length - 1) & hash; //定位HashEntry,可以看到, //这个hash值在定位Segment时和在Segmen //t中定位HashEntry都会用到, //只不过定位Segment时只用到高几位。 HashEntry first = entryAt(tab, index); for (HashEntry e = first;;) { if (e != null) { K k; if ((k = e.key) == key || (e.hash == hash && key.equals(k))) { oldValue = e.value; if (!onlyIfAbsent) { e.value = value; ++modCount; } break; } e = e.next; } else { if (node != null) node.setNext(first); else node = new HashEntry (hash, key, value, first); int c = count + 1; //若c超出阈值threshold,需要扩容并rehash。扩容后的容量是当前容量的2倍。这样可以最大程度避免之前散列好的entry重新散列,具体在另一篇文章中有详细分析,不赘述。扩容并rehash的这个过程是比较消耗资源的。 if (c > threshold && tab.length < MAXIMUM_CAPACITY) rehash(node); else setEntryAt(tab, index, node); ++modCount; count = c; oldValue = null; break; } } } finally { unlock(); } return oldValue; } ``` ## 总结 > **ConcurrentHashMap作为一种线程安全且高效的哈希表的解决方案,尤其其中的"分段锁"的方案,相比HashTable的全表锁在性能上的提升非常之大。**

优秀的个人博客,低调大师

🏆Java技术专题-JVM研究系列(36) 性能调优之CMS垃圾回收器(上)

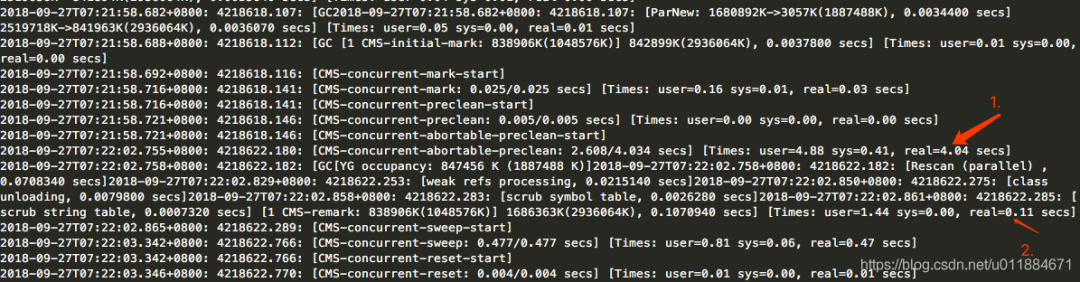
前提概要 如果没有冬天,春天不会如此悦人;如果没有偶尔的不幸,幸运不会如此受人欢迎。 CMS垃圾回收的6个重要阶段 initial-mark 初始标记(CMS的第一个STW阶段),标记GC Root直接引用的对象,GC Root直接引用的对象不多,所以很快。 concurrent-mark并发标记阶段,由第一阶段标记过的对象出发,所有可达的对象都在本阶段标记。 concurrent-preclean 并发预清理阶段,也是一个并发执行的阶段。在本阶段,会查找前一阶段执行过程中,[从新生代晋升或新分配或被更新的对象]。通过并发地重新扫描这些对象,预清理阶段可以减少下一个stop-the-world 重新标记阶段的工作量。 concurrent-abortable-preclean,并发可中止的预清理阶段。这个阶段其实跟上一个阶段做的东西一样,也是为了减少下一个STW重新标记阶段的工作量。增加这一阶段是为了让我们可以控制这个阶段的结束时机,比如扫描多长时间(默认5秒)或者Eden区使用占比达到期望比例(默认50%)就结束本阶段。 remark重标记阶段(CMS的第二个STW阶段),暂停所有用户线程,从GC Root开始重新扫描整堆,标记存活的对象。需要注意的是,虽然CMS只回收老年代的垃圾对象,但是这个阶段依然需要扫描新生代,因为很多GC Root都在新生代,而这些GC Root指向的对象又在老年代,这称为“跨代引用”。 concurrent-sweep ,并发清理。 分析 分析其GC日志,发现GC发生在CMS的收集阶段。 箭头1 显示abortable-preclean阶段耗时4.04秒。 箭头2 显示的是remark阶段,耗时0.11秒。 虽然abortable-preclean阶段是concurrent的,不会暂停其他的用户线程。就算不优化,可能影响也不大。 调优之前先看下该应用的GC统计数据,包括GC次数,耗时: 统计期间内(18天)发生CMS GC 69次,其中abortable preclean阶段平均耗时2.45秒,final remark阶段平均112ms,最大耗时170ms。 优化目标 降低abortable preclean时间,而且不增加final remark的时间(因为remark是STW的)。 JVM参数调优 第一次调优 先尝试调低abortable preclean阶段的时间,看看效果。 有两个参数可以控制这个阶段何时结束: -XX:CMSMaxAbortablePrecleanTime=5000 默认值5s,代表该阶段最大的持续时间 -XX:CMSScheduleRemarkEdenPenetration=50 默认值50%,代表Eden区使用比例超过50%就结束该阶段进入remark 调整为最大持续时间为1s,Eden区使用占比10%,如下: -XX:CMSMaxAbortablePrecleanTime=1000 -XX:CMSScheduleRemarkEdenPenetration=10 为什么调整成这样两个值:首先每次CMS都发生在老年代使用占比达到80%时,因为这是由下面两个参数决定的: -XX:CMSInitiatingOccupancyFraction=80 -XX:+UseCMSInitiatingOccupancyOnly 这两个设置一般配合使用,一般用于『降低CMS GC频率或者增加频率、减少GC时长』的需求 -XX:CMSInitiatingOccupancyFraction=80 是指设定CMS在对内存占用率达到80%的时候开始GC(因为CMS会有浮动垃圾,所以一般都较早启动GC); -XX:+UseCMSInitiatingOccupancyOnly :标志来命令JVM不基于运行时收集的数据来启动CMS垃圾收集周期。 当该标志被开启时,JVM通过CMSInitiatingOccupancyFraction的值进行每一次CMS收集,而不仅仅是第一次。(否则后续会动态控制回收阈值) (慎用) 因此,只有当我们充足的理由(比如测试)并且对应用程序产生的对象的生命周期有深刻的认知时,才应该使用该标志。 老年代的增长是由于部分对象在Minor GC后仍然存活,被晋升到老年代,导致老年代使用占比增长的,也就是在每次CMS GC发生之前刚刚发生过一次Minor GC,所以在那一刻新生代的使用占比是很低的。 那么我们预计这个时候尽快结束abortable preclean阶段,在remark时就不需要扫描太多的Eden区对象,remark STW的时间也就不会太长。 第一次调整参数 在统计期间(17小时左右)内,发生过2次CMS GC。Abortable Preclean 平均耗时835ms,这是预期内的。但是Final Remark 平均耗时495ms(调整前是112ms),其中一次是80ms,另一次是910ms!将近1秒钟!Remark是STW的!对于要求低延时的应用来说这是无法接受的! [YG occupancy: 181274 K (1887488 K)] - 年轻代当前占用情况和总容量 耗时80ms的这次remark发生时(早上9点,非高峰时段),新生代(YG)占用181.274M。 remark耗时910ms的那次GC日志 [YG occupancy: 773427 K (1887488 K)] 耗时910ms的这次remark发生时(晚上10点左右,高峰时段),新生代(YG)占用773.427M。因为这个时候高峰期,新生代的占用量上升的非常快,几乎同样的时间内,非高峰时段仅上升到181M,但是高峰时段就上升到773M。 如果abortale preclean阶段时间太短,随后在remark时,新生代占用越大,则remark持续的时间(STW)越长。 不缩短abortale preclean耗时会出现过程gc;缩短的话,remark阶段又会变长,而且是STW,更不能接受。 对于这种情况,CMS提供了CMSScavengeBeforeRemark参数,尝试在remark阶段之前进行一次Minor GC,以降低新生代的占用。 第二次调优 增加 -XX:+CMSScavengeBeforeRemark 不是没有代价的,因为这会增加一次Minor GC停顿。所以这个方案好或者不好的判断标准就是:增加CMSScavengeBeforeRemark参数之后的minor GC停顿时间 + remark 停顿时间如果比增加之前的remark GC停顿时间要小,这才是好的方案。 -XX:+CMSScavengeBeforeRemark: 在CMS GC前启动一次ygc,目的在于减少old gen对ygc gen的引用,降低remark时的开销-----一般CMS的GC耗时 80%都在remark阶段 第二次调整的结果 在统计期间(20小时左右)内,发生3次CMS GC。Abortable preclean 平均耗时693ms。Final remark平均耗时50ms,最大耗时60ms。Final remark的时间比调优前的平均时间(112ms)更低。 3次CMS GC remark前的Minor GC日志分析 第1次是非高峰时段的表现,Minor GC 耗时 0.01s + remark耗时 0.06s = 0.07s = 70ms,如下 第2次是高峰时段,Minor GC 耗时 0.01s + remark耗时 0.05s = 0.06s = 60ms,如下 第3次是非高峰时段,Minor GC 耗时 0.00s + remark耗时 0.04s = 0.04s = 40ms,如下 所以,3次Minor GC + remark耗时的平均耗时 < 60ms,这比第一次调优时remark平均耗时495ms好得多了。 总结 解决abortable preclean 时间过长的方案可以归结为两步: 缩短abortable preclean 时长,通过调整这两个参数: -XX:CMSMaxAbortablePrecleanTime=xxx -XX:CMSScheduleRemarkEdenPenetration=xxx 调整为多少的一个判断标准是:abortable preclean阶段结束时,新生代的空间占用不能大于某个参考值。 在前面第一次调优后,新生代(YG)占用181.274M,remark耗时80ms;新生代(YG)占用773.427M时,remark耗时910ms。所以这个参考值可以是300M。 而如果新生代增长过快,像这次调优应用2秒内就能用光2G新生代堆空间的,就只能通过CMSScavengeBeforeRemark做一次Minor GC了。 增加CMSScavengeBeforeRemark参数开启remark前进行Minor GC的尝试 虽然官方说明这个增加这个参数是尝试进行Minor GC,不一定会进行。但实际使用起来,几乎每次remark前都会Minor GC。

优秀的个人博客,低调大师

数栈技术分享:用短平快的方式告诉你Flink-SQL的扩展实现

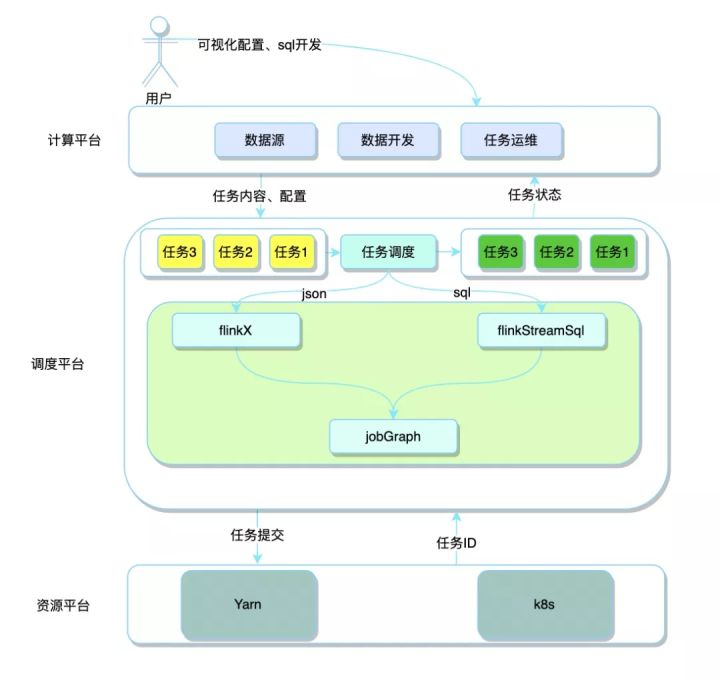
数栈是云原生—站式数据中台PaaS,我们在github和gitee上有一个有趣的开源项目:FlinkX,FlinkX是一个基于Flink的批流统一的数据同步工具,既可以采集静态的数据,也可以采集实时变化的数据,是全域、异构、批流一体的数据同步引擎。大家喜欢的话请给我们点个star!star!star! github开源项目:https://github.com/DTStack/flinkx gitee开源项目:https://gitee.com/dtstack_dev_0/flinkx 首先,本文所述均基于flink 1.5.4。 一、我们为什么扩展Flink-SQL? 由于Flink 本身SQL语法并不提供在对接输入源和输出目的的SQL语法。数据开发在使用的过程中需要根据其提供的Api接口编写Source和 Sink, 异常繁琐,不仅需要了解FLink 各类Operator的API,还需要对各个组件的相关调用方式有了解(比如kafka,redis,mongo,hbase等),并且在需要关联到外部数据源的时候没有提供SQL相关的实现方式,因此数据开发直接使用Flink编写SQL作为实时的数据分析时需要较大的额外工作量。 我们的目的是在使用Flink-SQL的时候只需要关心做什么,而不需要关心怎么做。不需要过多的关心程序的实现,专注于业务逻辑。 接下来,我们一起来看下Flink-SQL的扩展实现吧! 二、扩展了哪些flink相关sql 1、创建源表语句 2、创建输出表语句 3、创建自定义函数 4、维表关联 三、各个模块是如何翻译到flink的实现 1、如何将创建源表的sql语句转换为flink的operator Flink中表的都会映射到Table这个类。然后调用注册方法将Table注册到environment。 StreamTableEnvironment.registerTable(tableName, table); 当前我们只支持kafka数据源。Flink本身有读取kafka 的实现类, FlinkKafkaConsumer09,所以只需要根据指定参数实例化出该对象。并调用注册方法注册即可。 另外需要注意在flink sql经常会需要用到rowtime, proctime, 所以我们在注册表结构的时候额外添加rowtime,proctime。 当需要用到rowtime的使用需要额外指定DataStream.watermarks(assignTimestampsAndWatermarks),自定义watermark主要做两个事情:1:如何从Row中获取时间字段。 2:设定最大延迟时间。 2、 如何将创建的输出表sql语句转换为flink的operator Flink输出Operator的基类是OutputFormat, 我们这里继承的是RichOutputFormat, 该抽象类继承OutputFormat,额外实现了获取运行环境的方法getRuntimeContext(), 方便于我们之后自定义metric等操作。 我们以输出到mysql插件mysql-sink为例,分两部分: 将create table 解析出表名称,字段信息,mysql连接信息。 该部分使用正则表达式的方式将create table 语句转换为内部的一个实现类。该类存储了表名称,字段信息,插件类型,插件连接信息。 继承RichOutputFormat将数据写到对应的外部数据源。 主要是实现writeRecord方法,在mysql插件中其实就是调用jdbc 实现插入或者更新方法。 3、如何将自定义函数语句转换为flink的operator; Flink对udf提供两种类型的实现方式: 1)继承ScalarFunction 2)继承TableFunction 需要做的将用户提供的jar添加到URLClassLoader, 并加载指定的class (实现上述接口的类路径),然后调用TableEnvironment.registerFunction(funcName, udfFunc);即完成了udf的注册。之后即可使用改定义的udf; 4、维表功能是如何实现的? 流计算中一个常见的需求就是为数据流补齐字段。因为数据采集端采集到的数据往往比较有限,在做数据分析之前,就要先将所需的维度信息补全,但是当前flink并未提供join外部数据源的SQL功能。 实现该功能需要注意的几个问题: 1)维表的数据是不断变化的 在实现的时候需要支持定时更新内存中的缓存的外部数据源,比如使用LRU等策略。 2)IO吞吐问题 如果每接收到一条数据就串行到外部数据源去获取对应的关联记录的话,网络延迟将会是系统最大的瓶颈。这里我们选择阿里贡献给flink社区的算子RichAsyncFunction。该算子使用异步的方式从外部数据源获取数据,大大减少了花费在网络请求上的时间。 3)如何将sql 中包含的维表解析到flink operator 为了从sql中解析出指定的维表和过滤条件, 使用正则明显不是一个合适的办法。需要匹配各种可能性。将是一个无穷无尽的过程。查看flink本身对sql的解析。它使用了calcite做为sql解析的工作。将sql解析出一个语法树,通过迭代的方式,搜索到对应的维表;然后将维表和非维表结构分开。 通过上述步骤可以通过SQL完成常用的从kafka源表,join外部数据源,写入到指定的外部目的结构中。

优秀的个人博客,低调大师

【Java技术探索】HashMap深入浅出的源码分析(JDK1.8版本)

【每日一句】 一个人最大的挑战,是如何去克服自己的缺点。 【基本原理】 HashMap是一个基于map接口实现的散列表,存储内容是键值对 (key-value) 映射,并且键和值都可以使用null,因为key不允许重复,因此只能有一个键为null。 HashMap使用 hash 算法进行数据的存储和查询。 HashMap的实现用的是数组+链表+红黑树的结构,也叫哈希桶。在jdk 1.8之前都是数组+链表的结构,因为在链表的查询操作都是O(N)的时间复杂度,如果当节点数量多,转换为红黑树结构,那么将会提高很大的效率,因为红黑树结构中,增删改查都是O(log n)。 【基本特性】 HashMap的散列表是懒加载机制,在第一次put的时候才会创建 它根据键的 hashCode 值存储数据,大多数情况下可以直接定位到它的值,因而具有很快的访问速度,但遍历顺序却是不确定的。 HashMap 最多只允许一条记录的键(Key)为 null,允许多条记录的值为 null。 HashMap是无序不重复的,而且HashMap是线程不安全的。 HashMap 默认情况下使用一个Entry表示键值对 key-value,用Entry的数组保存所有键值对,Entry通过链表的方式链接后续的节点 (1.8 后会根据链表长度决定是否转换成一棵树类似TreeMap来节省查询时间,Node节点会采用LinkedHashMapEntry的属性),Entry通过计算 key 的 hash 值来决定映射到具体的哪个数组(也叫 Bucket) 中。 HashMap 非线程安全,即任一时刻可以有多个线程同时写 HashMap,可能会导致数据的不一致。 如果需要满足线程安全,可以用 Collections 的 synchronizedMap 方法使 HashMap 具有线程安全的能力,或者使用 ConcurrentHashMap。 【优化点】 链表改为红黑树:时间复杂度(O(N) —> O(log(N))) 【原理简述】 【put方法】 输入参数 key值,value值 运作流程 首先针对于传入的对Key求hash值,然后再计算下标。 如果没有碰撞,直接放入桶中(碰撞的意思是计算得到的hash值相同,需要放到同一个bucket中,代表着属于链表)。 如果hash值发生碰撞后,以链表的方式链接到后面。 如果链表长度超过阀值( TREEIFY THRESHOLD==8),就把链表转成红黑树,链表长度低于6,就把红黑树转回链表。 如果key的hashcode相同且value也相同的情况下,就替换旧值 如果桶到达阈值(Threshold)后(初始化容量(16)以及加载因子(0.75)),就需要 resize(扩容2倍后并且进行重排(重新hash和重新排版)) 数据结构图 HashMap属性代码 首先,需要记住的是,JCF的一个传统模式,就是集成AbstractXXX抽象类和实现所有的基础接口XXX,XXX(Map,List,Set,Collection等),并且可以实现序列化和克隆。 属性默认值 public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable { //序列号,序列化的时候使用 private static final long serialVersionUID = 362498820763181265L; //默认容量,为2的4次方,即为16, 必须为 2 的 n 次方 (一定是合数) static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; //最大容量,为2的30次方。 static final int MAXIMUM_CAPACITY = 1 << 30; //加载因子,用于扩容使用。 static final float DEFAULT_LOAD_FACTOR = 0.75f; //链表转成红黑树的阈值。即在哈希表扩容时,当链表的长度(桶中元素个数)超过这个值的时候,进行链表到红黑树的转变 static final int TREEIFY_THRESHOLD = 8; //红黑树转为链表的阈值。即在哈希表扩容时,如果发现链表长度(桶中元素个数)小于 6,则会由红黑树重新退化为链表 static final int UNTREEIFY_THRESHOLD = 6; //当整个hashMap中元素数量大于64时,也会进行转为红黑树结构。 //HashMap 的最小树形化容量。这个值的意义是:位桶(bin)处的数 //据要采用红黑树结构进行存储时,整个Table的最小容量(存储方式由 //链表转成红黑树的容量的最小阈值) 当哈希表中的容量大于这个值 //时,表中的桶才能进行树形化,否则桶内元素太多时会扩容,而不是 // 树形化为了避免进行扩容、树形化选择的冲突,这个值不能小于 4 * // TREEIFY_THRESHOLD static final int MIN_TREEIFY_CAPACITY = 64; } 属性参数 public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable { transient Node<K,V>[] table; //将数据转换成set的另一种存储形式,这个变量主要用于迭代功能。 transient Set<Map.Entry<K,V>> entrySet; //元素数量 transient int size; //统计该map修改的次数,用来记录 HashMap 内部结构发生变化的次数,主要用于迭代的快速失败机制 transient int modCount; //HashMap 的门限阀值/扩容阈值,所能容纳的 key-value 键值对极 // // 限,当size>=threshold时,就会扩容,计算方法:容量capacity * 负 // 载因子load factor 。 int threshold; //加载因子 final float loadFactor; } Node[] table:的初始化长度 length(默认值是 16),loadFactor 为负载因子 (默认值 DEFAULT_LOAD_FACTOR 是 0.75),threshold 是 HashMap 所能容纳的最大数据量的 Node(键值对) 个数。 *threshold = length loadFactor。也就是说,在数组定义好长度之后,负载因子越大,所能容纳的键值对个数越多。** *这里我们需要加载因子 (load_factor),加载因子默认为 0.75,当 HashMap 中存储的元素的数量大于 (容量 × 加载因子),也就是默认大于 160.75=12 时,HashMap 会进行扩容的操作 **。 size:这个字段其实很好理解,就是HashMap中实际存在的键值对数量。注意和 table 的长度 length、容纳最大键值对数量 threshold 的区别。 modCount:字段主要用来记录HashMap内部结构发生变化的次数,主要用于迭代的快速失败。强调一点,内部结构发生变化指的是结构发生变化。 put新键值对,某个key对应的value值被覆盖不属于结构变化。 HashMap的内部功能实现很多,本文主要从根据key获取哈希桶数组索引位置、put方法的详细执行、扩容过程等具有代表性的点深入展开讲解。 构造函数 第一个默认初始化+默认加载因子,第二个设置初始容量+初始化默认加载因子,第三个设置初始容量和加载因子。 // 默认初始化容量+默认负载因子 public HashMap() { this.loadFactor = DEFAULT_LOAD_FACTOR; } // 自定义初始化容量+默认负载因子 public HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } // 自定义初始化容量以及负载因子 public HashMap(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; this.threshold = tableSizeFor(initialCapacity); } public HashMap(Map<? extends K, ? extends V> m) { this.loadFactor = DEFAULT_LOAD_FACTOR; putMapEntries(m, false); } final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) { //获取该map的实际长度 int s = m.size(); if (s > 0) { //判断table是否初始化,如果没有初始化 if (table == null) { // pre-size /**求出需要的容量,因为实际使用的长度=容量*0.75得来的,+1是因为小数相除,基本都不会是整数,容量大小不能为小数的,后面转换为int,多余的小数就要被丢掉,所以+1,例如,map实际长度22,22/0.75=29.3,所需要的容量肯定为30,有人会问如果刚刚好除得整数呢,除得整数的话,容量大小多1也没什么影响**/ float ft = ((float)s / loadFactor) + 1.0F; //判断该容量大小是否超出上限。 int t = ((ft < (float)MAXIMUM_CAPACITY) ? (int)ft : MAXIMUM_CAPACITY); /**对临界值进行初始化,tableSizeFor(t)这个方法会返回大于t值的,且离其最近的2次幂,例如t为29,则返回的值是32**/ if (t > threshold) threshold = tableSizeFor(t); } //如果table已经初始化,则进行扩容操作,resize()就是扩容。 else if (s > threshold) resize(); //遍历,把map中的数据转到hashMap中。 for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) { K key = e.getKey(); V value = e.getValue(); putVal(hash(key), key, value, false, evict); } } } 节点对象 HashMap内部类TreeNode,该类是一个红黑树结构。 static final class TreeNode<K,V> extends LinkedHashMap.LinkedHashMapEntry<K,V> { // red-black tree links TreeNode<K,V> parent; TreeNode<K,V> left; TreeNode<K,V> right; // needed to unlink next upon deletion TreeNode<K,V> prev; boolean red; TreeNode(int hash, K key, V val, Node<K,V> next) { super(hash, key, val, next); } } HashMap内部类Node, 结构为单向链表。 static class Node<K,V> implements Map.Entry<K,V> { final int hash; final K key; V value; Node<K,V> next; Node(int hash, K key, V value, Node<K,V> next) { this.hash = hash; this.key = key; this.value = value; this.next = next; } public final K getKey() { return key; } public final V getValue() { return value; } public final String toString() { return key + "=" + value; } public final int hashCode() { return Objects.hashCode(key) ^ Objects.hashCode(value); } public final V setValue(V newValue) { V oldValue = value; value = newValue; return oldValue; } public final boolean equals(Object o) { if (o == this) return true; if (o instanceof Map.Entry) { Map.Entry<?,?> e = (Map.Entry<?,?>)o; if (Objects.equals(key, e.getKey()) && Objects.equals(value, e.getValue())) return true; } return false; } } 哈希方法 解决Hash 的的冲突的hash()方法,HashMap的hash计算时先计算 hashCode(), 然后进行二次hash。 // 计算二次Hash int hash = hash(key.hashCode()); // 通过Hash找数组索引 int i = hash & (tab.length-1); static final int hash(Object key) { int h; // 先获取到key的hashCode,然后进行移位再进行异或运算,为什么这 //么复杂,不用想肯定是为了减少hash冲突 return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } 这个方法非常巧妙,它总是通过 h &(table.length -1) 来得到该对象的保存位置,而 HashMap 底层数组的长度总是 2 的 n 次方。当 length 总是 2 的倍数时,h & (length-1) 将是一个非常巧妙的设计: 假设 h=5,length=16, 那么 h & length - 1 将得到 5; 假设 h=6,length=16, 那么 h & length - 1 将得到 6 假设 h=15,length=16, 那么 h & length - 1 将得到 15; 但是当 h=16 时 , length=16 时,那么 h & length - 1 将得到 0 了;当 h=17 时 , length=16 时,那么 h & length - 1 将得到 1 了。这样保证计算得到的索引值总是位于 table 数组的索引之内。 添加元素 public V put(K key, V value) { // 对key的hashCode()做hash return putVal(hash(key), key, value, false, true); } /** * Implements Map.put and related methods * * @param hash hash for key * @param key the key * @param value the value to put * @param onlyIfAbsent if true, don't change existing value * @param evict if false, the table is in creation mode. * @return previous value, or null if none */ final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; // table为空或者length=0时,以默认大小扩容,n为table的长度 if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; // 计算index,并对null做处理,table[i]==null if ((p = tab[i = (n - 1) & hash]) == null) // (n-1)&hash 与Java7中indexFor方法的实现相同,若i位置上的值为空,则新建一个Node,table[i]指向该Node。 // 直接插入 tab[i] = newNode(hash, key, value, null); else { // 若i位置上的值不为空,判断当前位置上的Node p 是否与要插入的key的hash和key相同 Node<K,V> e; K k; // 若节点key存在,直接覆盖value if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) e = p; // 判断table[i]该链是否是红黑树,如果是红黑树,则直接在树中插入键值对 else if (p instanceof TreeNode) // 不同,且当前位置上的的node p已经是TreeNode的实例,则再该树上插入新的node e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); // table[i]该链是普通链表,进行链表的插入操作 else { // 在i位置上的链表中找到p.next为null的位置,binCount计算出当前链表的长度,如果继续将冲突的节点插入到该链表中,会使链表的长度大于tree化的阈值,则将链表转换成tree。 for (int binCount = 0; ; ++binCount) { // 如果遍历到了最后一个节点,说明没有匹配的key,则创建一个新的节点并添加到最后 if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); // 链表长度大于8转换为红黑树进行处理 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } // 遍历过程中若发现 key 已经存在直接覆盖 value 并跳出循环即可 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } // 已经存在该key的情况时,将对应的节点的value设置为新的value if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } } ++modCount; // 插入成功后,判断实际存在的键值对数量 size 是否超多了最大容量 threshold,如果超过,进行扩容 if (++size > threshold) resize(); afterNodeInsertion(evict); return null; } 红黑树结构的putVal方法 final TreeNode<K,V> putTreeVal(HashMap<K,V> map, Node<K,V>[] tab,int h, K k, V v) { Class<?> kc = null; boolean searched = false; TreeNode<K,V> root = (parent != null) ? root() : this; for (TreeNode<K,V> p = root;;) { int dir, ph; K pk; if ((ph = p.hash) > h) dir = -1; else if (ph < h) dir = 1; else if ((pk = p.key) == k || (k != null && k.equals(pk))) return p; else if ((kc == null && (kc = comparableClassFor(k)) == null) || (dir = compareComparables(kc, k, pk)) == 0) { if (!searched) { TreeNode<K,V> q, ch; searched = true; if (((ch = p.left) != null && (q = ch.find(h, k, kc)) != null) || ((ch = p.right) != null && (q = ch.find(h, k, kc)) != null)) return q; } dir = tieBreakOrder(k, pk); } TreeNode<K,V> xp = p; if ((p = (dir <= 0) ? p.left : p.right) == null) { Node<K,V> xpn = xp.next; TreeNode<K,V> x = map.newTreeNode(h, k, v, xpn); if (dir <= 0) xp.left = x; else xp.right = x; xp.next = x; x.parent = x.prev = xp; if (xpn != null) ((TreeNode<K,V>)xpn).prev = x; moveRootToFront(tab, balanceInsertion(root, x)); return null; } } } 总结 put()方法大致的思路为: 对key的hashCode()做hash,然后再计算 index; 如果没碰撞直接放到 bucket里; 如果碰撞了,以链表的形式存在 buckets 后; 如果碰撞导致链表过长 (大于等于 TREEIFY_THRESHOLD=8),就把链表转换成红黑树; 如果节点已经存在就替换 old value(保证 key 的唯一性) *如果 bucket 满了 (超过 load factorcurrent capacity),就要 resize**。 具体步骤为 如果 table 没有使用过的情况(tab=table)==null || (n=tab.length) == 0,则以默认大小进行一次 resize。 计算key的hash值,然后获取底层 table 数组的第 (n-1) & hash 的位置的数组索引tab[i] 处的数据,即hash对n取模的位置,依赖的是n 为2的次方这一条件 先检查该 bucket 第一个元素是否是和插入的 key 相等 (如果是同一个对象则肯定 equals) 如果不相等并且是 TreeNode 的情况,调用TreeNode 的 put 方法否则循环遍历树节点, 如果找到相等的key跳出循环否则达到最后一个节点时将新的节点添加到链表最后, 当前面找到了相同的 key 的情况下替换这个节点的 value 为新的 value。 最后如果新增了 key-value 对,则增加 size 并且判断是否超过了 threshold, 如果超过则需要进行 resize 扩容 扩容尺寸 扩容 (resize) 就是重新计算容量,向HashMap对象里不停的添加元素,而HashMap对象内部的数组无法装载更多的元素时,对象就需要扩大数组的长度,以便能装入更多的元素。 当然Java里的数组是无法自动扩容的,方法是使用一个新的数组代替已有的容量小的数组,就像我们用一个小桶装水,如果想装更多的水,就得换大水桶。 由于需要考虑hash冲突解决时采用的可能是链表也可能是红黑树的方式,因此resize方法相比JDK7 中复杂了一些。 rehashing触发的条件: *超过默认容量 加载因子**; 加载因子不靠谱,比如远大于 1。 在HashMap进行扩容时,会进行2倍扩容,而且会将哈希碰撞处的数据再次分散开来,一部分依照新的 hash 索引值呆在 “原处”,另一部分加上偏移量移动到新的地方。 具体步骤为: 首先计算 resize() 后的新的 capacity 和 threshold 值。 如果原有的 capacity 大于零则将 capacity 增加一倍,否则设置成默认的 capacity。 创建新的数组,大小是新的capacity 将旧数组的元素放置到新数组中 final Node<K,V>[] resize() { // 将字段引用copy到局部变量表,这样在之后的使用时可以减少getField指令的调用 Node<K,V>[] oldTab = table; // oldCap为原数组的大小或当空时为0 int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; if (oldCap > 0) { if (oldCap >= MAXIMUM_CAPACITY) { // 如果超过最大容量1>>30,无法再扩充table,只能改变阈值 threshold = Integer.MAX_VALUE; return oldTab; } // 新的数组的大小是旧数组的两倍 else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) // 当旧的的数组大小大于等于默认大小时,threshold也扩大一倍 newThr = oldThr << 1; } else if (oldThr > 0) // initial capacity was placed in threshold newCap = oldThr; else { // zero initial threshold signifies using defaults // 初始化操作 newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } if (newThr == 0) { float ft = (float)newCap * loadFactor; newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE); } threshold = newThr; @SuppressWarnings({"rawtypes","unchecked"}) // 创建容量为newCap的newTab,并将oldTab中的Node迁移过来,这里需要考虑链表和tree两种情况。 Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; table = newTab; // 将原数组中的数组复制到新数组中 if (oldTab != null) { for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) // 如果e是该bucket唯一的一个元素,则直接赋值到新数组中 newTab[e.hash & (newCap - 1)] = e; else if (e instanceof TreeNode) // split方法会将树分割为lower 和upper tree两个树,如果子树的节点数小于了UNTREEIFY_THRESHOLD阈值,则将树untreeify,将节点都存放在newTab中。 // TreeNode的情况则使用TreeNode中的split方法将这个树分成两个小树 ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); else { // preserve order 保持顺序 // 否则则创建两个链表用来存放要放的数据,hash值&oldCap为0的(即oldCap的1的位置的和hash值的同样的位置都是1,同样是基于capacity是2的次方这一前提)为low链表,反之为high链表, 通过这种方式将旧的数据分到两个链表中再放到各自对应余数的位置 Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; // 按照e.hash值区分放在loTail后还是hiTail后 if ((e.hash & oldCap) == 0) { // 运算结果为0的元素,用lo记录并连接成新的链表 if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { // 运算结果不为0的数据,用li记录 if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); // 处理完之后放到新数组中 if (loTail != null) { loTail.next = null; // lo仍然放在“原处”,这个“原处”是根据新的hash值算出来的 newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; // li放在j+oldCap位置 newTab[j + oldCap] = hiHead; } } } } } return newTab; } 获取元素 get(key) 方法时获取 key 的 hash 值,计算 hash & (n-1) 得到在链表数组中的位置 first=tab[hash&(n-1)],先判断first的key是否与参数 key相等,不等就遍历后面的链表找到相同的key值返回对应的Value值即可。 public V get(Object key) { Node<K,V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } /** * Implements Map.get and related methods * @param hash hash for key * @param key the key * @return the node, or null if none */ final Node<K,V> getNode(int hash, Object key) { Node<K,V>[] tab; Node<K,V> first, e; int n; K k; if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) { //如果是头结点,则直接返回头结点 if (first.hash == hash && // always check first node ((k = first.key) == key || (key != null && key.equals(k)))) return first; if ((e = first.next) != null) { //判断是否是红黑树结构 if (first instanceof TreeNode) //如果是红黑树,那就去红黑树中找,然后返回 return ((TreeNode<K,V>)first).getTreeNode(hash, key); do { //否则就是链表节点,遍历链表,找到该节点并返回 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) return e; } while ((e = e.next) != null); } } return null; } 红黑树结构 static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> { TreeNode<K,V> parent; // red-black tree links 父节点 TreeNode<K,V> left; // 左子树 TreeNode<K,V> right; // 右子树 TreeNode<K,V> prev; // needed to unlink next upon deletion boolean red; // 颜色属性 TreeNode(int hash, K key, V val, Node<K,V> next) { super(hash, key, val, next); } } 树形化操作 根据哈希表中元素个数确定是扩容还是树形化,如果是树形化遍历桶中的元素,创建相同个数的树形节点,复制内容,建立起联系,然后让桶第一个元素指向新建的树头结点,替换桶的链表内容为树形内容// MIN_TREEIFY_CAPACITY 的值为64,若当前table的length不够,则resize() // 将桶内所有的 链表节点 替换成 红黑树节点 final void treeifyBin(Node<K,V>[] tab, int hash) { int n, index; Node<K,V> e; // 如果当前哈希表为空,或者哈希表中元素的个数小于树形化阈值(默认为 64),就去新建(扩容) if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY) resize(); // 如果哈希表中的元素个数超过了树形化阈值,则进行树形化 // e 是哈希表中指定位置桶里的链表节点,从第一个开始 else if ((e = tab[index = (n - 1) & hash]) != null) { // 红黑树的头、尾节点 TreeNode<K,V> hd = null, tl = null; do { // 新建一个树形节点,内容和当前链表节点 e 一致 TreeNode<K,V> p = replacementTreeNode(e, null); // 确定树头节点 if (tl == null) hd = p; else { p.prev = tl; tl.next = p; } tl = p; } while ((e = e.next) != null); // 让桶的第一个元素指向新建的红黑树头结点,以后这个桶里的元素就是红黑树而不是链表了 if ((tab[index] = hd) != null) hd.treeify(tab); } } TreeNode<K,V> replacementTreeNode(Node<K,V> p, Node<K,V> next){ return new TreeNode<>(p.hash, p.key, p.value, next); } 删除元素 下面再来看看删除方法remove。 public V remove(Object key) { //临时变量 Node<K,V> e; /**调用removeNode(hash(key), key, null, false, true)进行删除,第三个value为null,表示,把key的节点直接都删除了,不需要用到值,如果设为值,则还需要去进行查找操作**/ return (e = removeNode(hash(key), key, null, false, true)) == null ? null : e.value; } /**第一参数为哈希值,第二个为key,第三个value,第四个为是为true的话,则表示删除它key对应的value,不删除key,第四个如果为false,则表示删除后,不移动节点**/ final Node<K,V> removeNode(int hash, Object key, Object value, boolean matchValue, boolean movable) { //tab 哈希数组,p 数组下标的节点,n 长度,index 当前数组下标 Node<K,V>[] tab; Node<K,V> p; int n, index; //哈希数组不为null,且长度大于0,然后获得到要删除key的节点所在是数组下标位置 if ((tab = table) != null && (n = tab.length) > 0 && (p = tab[index = (n - 1) & hash]) != null) { //nodee 存储要删除的节点,e 临时变量,k 当前节点的key,v 当前节点的value Node<K,V> node = null, e; K k; V v; //如果数组下标的节点正好是要删除的节点,把值赋给临时变量node if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) node = p; //也就是要删除的节点,在链表或者红黑树上,先判断是否为红黑树的节点 else if ((e = p.next) != null) { if (p instanceof TreeNode) //遍历红黑树,找到该节点并返回 node = ((TreeNode<K,V>)p).getTreeNode(hash, key); else { //表示为链表节点,一样的遍历找到该节点 do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) { node = e; break; } /**注意,如果进入了链表中的遍历,那么此处的p不再是数组下标的节点,而是要删除结点的上一个结点**/ p = e; } while ((e = e.next) != null); } } //找到要删除的节点后,判断!matchValue,我们正常的remove删除,!matchValue都为true if (node != null && (!matchValue || (v = node.value) == value || (value != null && value.equals(v)))) { //如果删除的节点是红黑树结构,则去红黑树中删除 if (node instanceof TreeNode) ((TreeNode<K,V>)node).removeTreeNode(this, tab, movable); //如果是链表结构,且删除的节点为数组下标节点,也就是头结点,直接让下一个作为头 else if (node == p) tab[index] = node.next; else /**为链表结构,删除的节点在链表中,把要删除的下一个结点设为上一个结点的下一个节点**/ p.next = node.next; //修改计数器 ++modCount; //长度减一 --size; /**此方法在hashMap中是为了让子类去实现,主要是对删除结点后的链表关系进行处理**/ afterNodeRemoval(node); //返回删除的节点 return node; } } //返回null则表示没有该节点,删除失败 return null; } 删除还有clear方法,把所有的数组下标元素都置位null。 size()方法 HashMap 的大小很简单,不是实时计算的,而是每次新增加 Entry 的时候,size 就递增。删除的时候就递减。空间换时间的做法。因为它不是线程安全的。完全可以这么做,效率高。


优秀的个人博客,低调大师

Java技术专题-JVM研究系列(25)你真正掌握了Java对象创建的流程吗?

每日一句 拥有梦想只是一种智力,实现梦想才是真正的能力 前提概要 我们都知道类的装载过程中,分为 加载、链接(校验、准备、解析)、初始化(类的初始化),此处初始化主要是代表着类的初始化操作,之后会进入装载阶段之外的操作【类的实例化】 类初始化 类的创建的触发操作 在Java代码中,有很多行为可以引起对象的创建,最为直观的一种就是使用new关键字来调用一个类的构造函数显式地创建对象,这种方式在Java规范中被称为 :由执行类实例创建表达式而引起的对象创建。除此之外,我们还可以使用反射机制(Class类的newInstance方法、使用Constructor类的newInstance方法)、使用Clone方法、使用反序列化等方式创建对象。 使用new关键字创建对象 这是我们最常见的也是最简单的创建对象的方式,通过这种方式我们可以调用任意的构造函数(无参的和有参的)去创建对象。比如: Student student = new Student(); 使用Class类的newInstance方法(反射机制) 我们也可以通过Java的反射机制使用Class类的newInstance方法来创建对象,事实上,这个newInstance方法调用无参的构造器创建对象,比如: Student student2 = (Student)Class.forName("Student类全限定名").newInstance(); Student stu = Student.class.newInstance(); 使用Constructor类的newInstance方法(反射机制) java.lang.relect.Constructor类里也有一个newInstance方法可以创建对象,该方法和Class类中的newInstance方法很像,但是相比之下,Constructor类的newInstance方法更加强大些,我们可以通过这个newInstance方法调用有参数的和私有的构造函数,比如: public class Student { private int id; public Student(Integer id) { this.id = id; } public static void main(String[] args) throws Exception { Constructor<Student> constructor = Student.class .getConstructor(Integer.class); Student stu3 = constructor.newInstance(123); } } 使用newInstance方法的这两种方式创建对象使用的就是Java的反射机制,事实上Class的newInstance方法内部调用的也是Constructor的newInstance方法。 使用Clone方法创建对象 无论何时我们调用一个对象的clone方法,JVM都会帮我们创建一个新的、一样的对象,特别需要说明的是,用clone方法创建对象的过程中并不会调用任何构造函数。简单而言,要想使用clone方法,我们就必须先实现Cloneable接口并实现其定义的clone方法,这也是原型模式的应用。比如: public class Student implements Cloneable{ private int id; public Student(Integer id) { this.id = id; } @Override protected Object clone() throws CloneNotSupportedException { // TODO Auto-generated method stub return super.clone(); } public static void main(String[] args) throws Exception { Constructor<Student> constructor = Student.class .getConstructor(Integer.class); Student stu3 = constructor.newInstance(123); Student stu4 = (Student) stu3.clone(); } } 使用(反)序列化机制创建对象 当我们反序列化一个对象时,JVM会给我们创建一个单独的对象,在此过程中,JVM并不会调用任何构造函数。为了反序列化一个对象,我们需要让我们的类实现Serializable接口,比如: public class Student implements Cloneable, Serializable { private int id; public Student(Integer id) { this.id = id; } @Override public String toString() { return "Student [id=" + id + "]"; } public static void main(String[] args) throws Exception { Constructor<Student> constructor = Student.class .getConstructor(Integer.class); Student stu3 = constructor.newInstance(123); // 写对象 ObjectOutputStream output = new ObjectOutputStream( new FileOutputStream("student.bin")); output.writeObject(stu3); output.close(); // 读对象 ObjectInputStream input = new ObjectInputStream(new FileInputStream( "student.bin")); Student stu5 = (Student) input.readObject(); System.out.println(stu5); } } 使用Unsafe类创建对象 Unsafe类使Java拥有了像C语言的指针一样操作内存空间的能力,同时也带来了指针的问题。过度的使用Unsafe类会使得出错的几率变大,因此Java官方并不建议使用的,官方文档也几乎没有。Oracle正在计划从Java 9中去掉Unsafe类,如果真是如此影响就太大了。 我们无法直接创建Unsafe对象。这里我们使用反射方法得到 private static Unsafe getUnsafe() { try { Field field = Unsafe.class.getDeclaredField("theUnsafe"); field.setAccessible(true); Unsafe unsafe = (Unsafe) field.get(null); return unsafe; } catch (Exception e) { e.printStackTrace(); } return null; } 拿到这个对象后,调用其中的native方法allocateInstance 创建一个对象实例 Object event = unsafe.allocateInstance(Test.class); 从Java虚拟机层面看,除了使用new关键字创建对象(<init>(invokespecial))的方式外,其他方式全部都是通过转变为invokevirtual指令直接创建对象的。 类的初始化与实例化 概念介绍 Java对象的创建过程往往包括类初始化和类实例化两个阶段。类的初始化在前、类的实例化在后。 注意:这与spring的bean正好相反,spring的bean的生命周期,主要是先进行实例化java对象,然后在进行操作属性、最后进行初始化,这里初始化并不是java对象的初始化,而是spring的参数的初始化(initMethod、afterPropertiesSet)等。(@PostConstruct是前置拦截初始化方法)。 类的初始化 主要职责: 类的构造器调用(<clinit>),初始化相关静态代码块以及静态变量的赋值 对象在可以被使用之前必须要被正确地初始化,这一点是Java规范规定的。在实例化一个对象时,JVM首先会检查相关类型是否已经加载并初始化,如果没有,则JVM立即进行加载并调用类构造器完成类的初始化。 注意:可以看到类的初始化主要到类构造器变量结束执行的时间点。 类的实例化 主要职责:实例的构造器调用(<init>)、分配内存、属性值得定制化赋值机制。 类的实例化本身意义就是对象的概念,其实就是实例化对应的对象的过程。 实例对象内存的分配、实例对象参数的默认初始化+实例对象参数的实例化(就是按开发要求的实现调用,例如调用构造器<init>等) 此时一般处于在装载阶段的初始化完成之后,使用之前的阶段,接下来就要进行类的实例化操作 类初始化过程中或初始化完毕后,根据具体情况才会去对类进行实例化,首先会有一下几个步骤: java虚拟机就会为其分配内存来存放自己及其从父类继承过来的实例变量 为这些实例变量分配内存的同时,这些实例变量先会被赋予默认值(零值)【这个零值与加载阶段中的准备很相似,就是先赋值语义级别的默认值,而并非参数真正的初始化】 在内存分配完成之后调用<init>方法,Java虚拟机执行构造代码块、构造方法等,方法参数执行等。才会对新创建的对象赋予我们程序给定的值 小结:创建一个对象包含下面两个过程: 类构造器完成类初始化(赋予静态变量默认值) 类实例化(分配内存、赋予默认值、执行定制化赋值操作) 类实例化过程 检测类是否被加载 Java虚拟机遇到一条new指令时,首先将去检查这个指令的参数是否能在常量池中定位到一个类的符号引用,并且检查这个符号引用代表的类是否已被加载、解析和初始化过**。如果没有,那必须先执行相应的类加载过程**。 为新生对象分配内存 在类加载并完成类初始化之后,接下来虚拟机将为新生对象分配内存。对象所需内存的大小在类加载及初始化完成后便可完全确定。 确定对象内存大小 对象的大小在类加载完成后就已经确定,对象在内存中可以分为三块。 对象头 大小确定 与类无关 与操作系统有关,包括标记字段和类型指针 实例数据 即使父类的实例字段被子类覆盖或者被private修饰,都照样为其分配内存,相同宽度的字段会分配在一起,其次,父类的字段在子类之前赋值和初始化。 对齐填充 满足虚拟机对8的倍数的要求 对象分配内存的方式。 假设Java堆中内存是绝对规整的,所有用过的内存都放在一边,空闲的内存放在另一边,中间放着一个指针作为分界点的指示器,那么分配内存就仅仅是把那个指针向空闲空间那边挪动一段与对象大小相等的距离,这种分配方式称为“指针碰撞”。 如果Java堆中的内存并不是规整的,已使用的内存和空闲的内存相互交错,那就没有办法简单地进行指针碰撞了,虚拟机就必须维护个列表,记录上哪些内存块是可用的,在分配的时候从列表中找到一块足够大的空间划分给对象实例,并更新列表上的记录,这种分配方式称为“空闲列表”。 选择哪种分配方式由Java堆是否规整决定,而Java堆是否规整又由所采用的垃圾收集器是否带有压缩整理功能决定。 对象创建在虚拟机执行的过程中是非常频繁的行为,仅仅修改一个指针所指向的位置,在并发情况下不是线程安全的。因此也有两种解决方案: 使用CAS并配上失败重试的方式保证更新操作的原子性。 (TLAB)给每一个线程在Java堆中预先分配线程私有分配缓冲区,哪个线程需要分配内存,只要在线程私有分配缓冲区中分配即可以。 初始化零值 将分配到的内存空间初始化零值,这保证了实例字段不赋值可以直接使用。如果使用了TLAB,这一步可以提前到TLAB分配的时候进行。 内存分配完成后,虚拟机需要将分配到的内存空间都初始化为零值(不包括对象头),这一步操作保证了对象的实例字段在Java代码中可以不赋初始值就直接使用,程序能访问到这些字段的数据类型所对应的零值。 进行必要的对象头设置 虚拟机要对对象进行必要的设置,例如这个对象是哪个类的实例、如何才能找到类的元数据信息、对象的哈希码、对象的GC分代年龄等信息。这些信息存放在对象的对象头之中,主要负责的5个点。 对象是哪个类的实例; 如何找到类的元数据信息; 对象的哈希码; 对象的GC分代年龄信息; 锁的标识等; 执行完以上步骤,从虚拟机角度,一个对象已经产生了,但是对于java程序而言,构造函数还没有开始执行。接下来按照构造函数的要求,对对象进行初始化即可。 对象头主要包含两类信息。第一类是用于存储对象自身的运行时数据,如哈希码、GC分代年龄、锁状态标志、线程持有的锁、偏向线程ID、偏向时间戳等。对象头的另外一部分是类型指针,即对象指向它的类型元数据的指针。 类型数据部分是对象真正存储的有效信息,即程序代码中定义的各种类型的字段内容。 对齐填充:任何对象的大小都必须是8字节的整数倍。 对象的访问定位 使用句柄访问的话,Java堆中将可能会划分出来一块内存来作为句柄池。Reference变量中存放的是句柄池的地址,句柄池中存放有到对象实例数据的指针以及到对象类型数据的指针。 使用直接访问的话,reference变量中存放的是对象的实例数据、对象的实例数据中包含有到对象类型数据的指针。 执行init方法 在上面工作都完成之后,从虚拟机的视角来看,一个新的对象已经产生了,但从Java程序的视角来看,对象创建才刚开始,<init>方法还没有执行,所有的字段都还为零。所以一般来说,执行new指令之后会接着执行<init>方法,把对象按照程序的进行初始化,这样一个真正可用的对象才算完全产生出来。 总结创建一个对象的过程 检测类是否被加载没有加载的先加载→为新生对象分配内存→将分配到的内存空间都初始化为零值→**对对象进行必要的设置(对象头)**→执行<init>方法把对象进行初始化 扩展延伸 需要类初始化的五种情况(有且仅有这五种) 。 遇到new getstatic putstatic invokestatic这四个指令时,如果类没有初始化,则会触发类的初始化。 四个指令对应的最常见的情况为使用new关键字实例化对象,读取静态变量,设置静态变量(编译期结果放入常量池的除外,会触发前几个阶段) ,调用类的静态方法。 使用java.lang.reflect包的方法对类进行反射调用 初始化一个类时 如果父类未初始化 则初始化父类 常见的不会触发初始化的引用方式 通过子类引用父类的静态变量 只会初始化父类 不会初始化子类 创建类的数组 引用常量池内的变量 总体流程图 加载 通过名字获取类的二进制流并在内存中生成class对象。 验证 验证二进制流的正确性和安全性 包括文件格式验证,元数据验证,字节码验证以及符号引用验证四个步骤。 准备 给类变量(static)分配空间并完成初始化 注意:如果不是final变量,值均为零值。 解析 将符号引用解析为直接引用,包括类或接口的解析,字段解析,类方法解析,接口方法解析。 初始化 执行类的<cinit>()方法,这个方法由所有对静态变量的赋值操作和所有静态代码块组成,虚拟机会保证父类的<cinit>()方法在子类的方法开始之前结束,并且提供线程安全的保证(类似于double check,多个线程同时初始化时只有一个线程进入方法,其他线程阻塞,执行完成后其他线程不会再进入方法) 类加载器-双亲委派模型 Java推荐的类加载器的实现模型,除了启动类加载器(bootstrap classLoader)以外的所有类加载器都应该拥有父加载器,这个关系不是通过继承来实现,而是通过组合的方式。类加载器收到加载请求时,首先请求父加载器进行加载,如果父加载器不能加载则调用自己的加载方法。 遵从双亲委派模型:自定义类加载器时如果我们希望则重写findClass()方法。 不想遵循双亲委托型:方案即重写loadClass()方法 类加载器-分类 遵循双亲委派从上到下可以分为 启动类加载器 (Bootstrap classLoader) 加载<JAVA_HOME>\lib下的指定文件名的类 扩展类加载器 (Extension classLoader) 加载<JAVA_HOME>\lib\ext下的类 系统类加载器(应用类加载器) 加载Classpath内的类 自定义类加载器 不遵循双亲委派的常见类加载器: SPI (Service Provider Interface)加载器 - 线程上下文加载器 实现父加载器向子加载器请求加载 OSGi模块化加载器 每个模块拥有一个自定义类加载器 网状结构的加载过程 分配内存 内存分配与内存回收紧密相关,根据不同的回收策略也有不同的分配策略。 如果采用的是具有压缩过程的垃圾回收策略,如Serial,ParNew,则Java堆中的内存是规整的,我们只需要将内存指针向后移内存大小的位置即可,这种方式称为指针碰撞(Bump the Pointer)。如果采用的回收策略没有压缩过程,如CMS,那虚拟机就需要维护一个列表,记录哪些内存是可用的,这种方式称为空闲列表(Free List) 其次,对象创建也需要考虑线程安全的问题,一种方案是采用CAS+失败重试的方法来保证线程安全,另一种方法则是为每一个线程提前分配一块内存,称为本地线程分配缓冲(Thread Local Allocation Buffer , TLAB),线程创建对象时优先在自己的TLAB上分配。 对象头 对象头包括 MarkWord 32bit/64bit 取决于操作系统 类型指针 指向类元数据的指针 数组长度 如果是数组的话 我们主要介绍MarkWord 根据锁状态的不同,markword会复用自己的空间,分别记录一些不同的信息。 我们注意到 轻量级锁和重量级锁状态时,会将分代年龄覆盖掉,那当锁状态解除时,要怎么恢复呢? 答案是上锁时,锁的数据中会保存一份原markword的备份

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册