首页 文章 精选 留言 我的

精选列表

搜索[在线课堂],共10000篇文章
优秀的个人博客,低调大师

推荐一个采用方便程序员在线动画学习常用算法的良心网站

网址:https://algorithm-visualizer.org/ 进去之后的页面是程序员熟悉的码农风格: 假设我想学习冒泡排序算法,在搜索栏里输入sort,在结果列表里选择bubble sort: 点击之后,排序操作处于就绪状态,点击play开始: 此时右边的JavaScript代码像我们平时单步调试一样逐行执行,同时每一步执行后排序的效果在屏幕正中实时显示: 比单步调试更强大之处是,我们能随时回退到前面的执行结果,通过下图高亮的84/144这个柱状开关控制。144意思是这个排序全过程总共要进行144次单步执行,当前已经执行了84步。自动播放的速度也可以在下图所示的Speed开关控制。 这是非波拉契数列的生成动画: 二叉树的遍历动画: Dijkstra迪杰斯特拉算法最短路径算法: 有了这个网站,算法学习从此不再枯燥。这个网站的源代码是完全开源的,如果你有新的算法想给全世界的编程爱好者展示,可以按照Readme.md里定义的规范,提交您的动画。 https://github.com/algorithm-visualizer/algorithm-visualizer 截至2019年3月16日,已经有14000多个赞了,顺手去点一个吧。 本文来自云栖社区合作伙伴“汪子熙”

优秀的个人博客,低调大师

北京Workshop准备条件:《云数据·大计算:快速搭建互联网在线运营分析平台》

实验背景介绍 了解更多2017云栖大会·北京峰会 TechInsight & Workshop. 本手册为云栖大会Workshop之《云计算·大数据:海量日志数据分析与应用》场的前提准备条件所需。主要为保障各位学员在workshop当天能够顺畅进行动手实操,那么本场需要各位学员再参加之前确保自己云账号已免费开通表格存储TableStore、大数据计算服务MaxCompute、DataWorks和Quick BI。 实验涉及大数据产品 表格存储 TableStore 大数据计算服务 MaxCompute 数据工场 DataWorks 智能分析套件Quick BI 其中表格存储TableStore、大数据计算服务MaxCompute的服务Region都选择华北2. 实验环境准备 必备条件:首先需要确保自己有阿里云云账号并已实名认证。详细点击

优秀的个人博客,低调大师

20【在线日志分析】之记录一次Spark Streaming+Spark SQL的数据倾斜

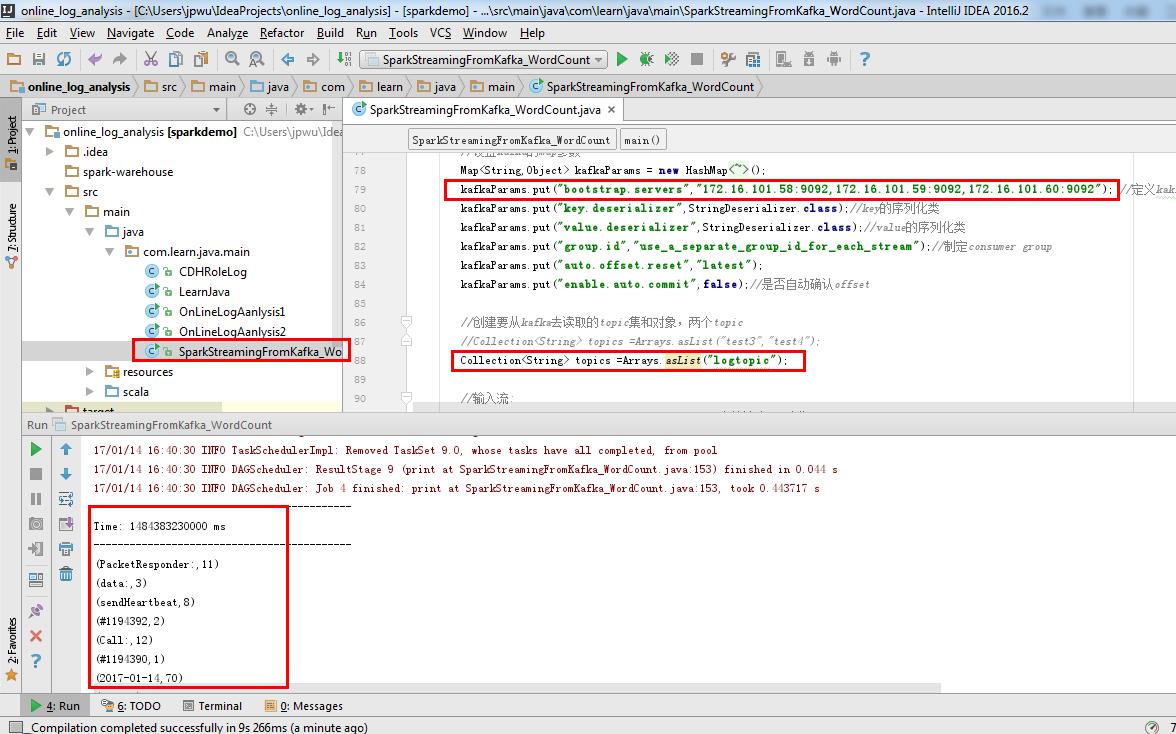
1.现象 三台机器都有产生executor,每台都会产生tasks,但是其中只有一台的task有input数据,其他机器的tasks都没有数据。 2.猜想 2.1是不是数据倾斜? 是 2.2是数据量过大,group by时,导致key分布不均? 比如key1 有98万,key2有2万,那么shuffle时,肯定数据倾斜。但是我刚开始数据量不是很大,所以pass (就算数据量大,也很简单处理,一般处理时key加上随机前缀数) 2.3是不是数据量太少 不够分区的? 也怀疑过,不过还没去验证 2.4 flume流到kafka,是snappy压缩格式,而spark作为kafka的消费者,虽然能够自动识别压缩格式,但是这种snappy格式不支持切分 也怀疑过,不过还没去修改支持spilt的压缩格式,也还没去验证 2.5 spark streaming分区数目是有谁决定的? 使用direct这种模式是由kafka的分区数目决定, 使用receiver这种模式由流的数目决定也就是由receiver数目决定。 3.修改分区数 [root@sht-sgmhadoopdn-02 kafka]#bin/kafka-topics.sh --alter --zookeeper 172.16.101.58:2181,172.16.101.59:2181,172.16.101.60:2181/kafka --topic logtopic --partitions 3 [root@sht-sgmhadoopdn-02 kafka]# bin/kafka-topics.sh --describe --zookeeper 172.16.101.58:2181,172.16.101.59:2181,172.16.101.60:2181/kafka --topic logtopic Topic:logtopic PartitionCount:3 ReplicationFactor:3 Configs: Topic: test Partition: 0 Leader: 3 Replicas: 3,1,2 Isr: 3,1,2 Topic: test Partition: 1 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 Topic: test Partition: 2 Leader: 2 Replicas: 2,3,1 Isr: 2,3,1 [root@sht-sgmhadoopdn-02 kafka]#4.验证(每个executor都有input数据)

优秀的个人博客,低调大师

03【在线日志分析】之hadoop-2.7.3编译和搭建集群环境(HDFS HA,Yarn HA)

环境:CentOS6.5 1.下载hadoop2.7.3最新源码[root@sht-sgmhadoopnn-01 ~]# mkdir -p learnproject/compilesoft[root@sht-sgmhadoopnn-01 ~]# cd learnproject/compilesoft[root@sht-sgmhadoopnn-01 compilesoft]# wget http://www-eu.apache.org/dist/hadoop/common/hadoop-2.7.3/hadoop-2.7.3-src.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# tar -xzvf hadoop-2.7.3-src.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# cd hadoop-2.7.3-src[root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# cat BUILDING.txt Build instructions for Hadoop ----------------------------------------------------------------------------------Requirements: * Unix System* JDK 1.7+* Maven 3.0 or later* Findbugs 1.3.9 (if running findbugs)* ProtocolBuffer 2.5.0* CMake 2.6 or newer (if compiling native code), must be 3.0 or newer on Mac* Zlib devel (if compiling native code)* openssl devel ( if compiling native hadoop-pipes and to get the best HDFS encryption performance )* Linux FUSE (Filesystem in Userspace) version 2.6 or above ( if compiling fuse_dfs )* Internet connection for first build (to fetch all Maven and Hadoop dependencies)----------------------------------------------------------------------------------Installing required packages for clean install of Ubuntu 14.04 LTS Desktop: * Oracle JDK 1.7 (preferred) $ sudo apt-get purge openjdk* $ sudo apt-get install software-properties-common $ sudo add-apt-repository ppa:webupd8team/java $ sudo apt-get update $ sudo apt-get install oracle-java7-installer* Maven $ sudo apt-get -y install maven* Native libraries $ sudo apt-get -y install build-essential autoconf automake libtool cmake zlib1g-dev pkg-config libssl-dev* ProtocolBuffer 2.5.0 (required) $ sudo apt-get -y install libprotobuf-dev protobuf-compiler Optional packages: * Snappy compression $ sudo apt-get install snappy libsnappy-dev* Bzip2 $ sudo apt-get install bzip2 libbz2-dev* Jansson (C Library for JSON) $ sudo apt-get install libjansson-dev* Linux FUSE $ sudo apt-get install fuse libfuse-dev 2.安装依赖包[root@sht-sgmhadoopnn-01 compilesoft]# yum install svn autoconf automake libtool cmake ncurses-devel openssl-devel gcc* 3.安装jdk[root@sht-sgmhadoopnn-01 compilesoft]# vi /etc/profileexport JAVA_HOME=/usr/java/jdk1.7.0_67-clouderaexport PATH=$JAVA_HOME/bin:$PATH [root@sht-sgmhadoopnn-01 compilesoft]# source /etc/profile[root@sht-sgmhadoopnn-01 compilesoft]# java -versionjava version "1.7.0_67"Java(TM) SE Runtime Environment (build 1.7.0_67-b01)Java HotSpot(TM) 64-Bit Server VM (build 24.65-b04, mixed mode)You have mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 compilesoft]# 4.安装maven[root@sht-sgmhadoopnn-01 compilesoft]# wget http://ftp.cuhk.edu.hk/pub/packages/apache.org/maven/maven-3/3.3.9/binaries/apache-maven-3.3.9-bin.tar.gz -O apache-maven-3.3.9-bin.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# tar xvf apache-maven-3.3.9-bin.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# vi /etc/profile export JAVA_HOME=/usr/java/jdk1.7.0_67-clouderaexport MAVEN_HOME=/root/learnproject/compilesoft/apache-maven-3.3.9# 在编译过程中为了防止Java内存溢出,需要加入以下环境变量export MAVEN_OPTS="-Xmx2048m -XX:MaxPermSize=512m" export PATH=$MAVEN_HOME/bin:$JAVA_HOME/bin:$PATH [root@sht-sgmhadoopnn-01 compilesoft]# source /etc/profile[root@sht-sgmhadoopnn-01 compilesoft]# mvn -versionApache Maven 3.3.9 (bb52d8502b132ec0a5a3f4c09453c07478323dc5; 2015-11-11T00:41:47+08:00)Maven home: /root/learnproject/compilesoft/apache-maven-3.3.9Java version: 1.7.0_67, vendor: Oracle CorporationJava home: /usr/java/jdk1.7.0_67-cloudera/jreDefault locale: en_US, platform encoding: UTF-8OS name: "linux", version: "2.6.32-431.el6.x86_64", arch: "amd64", family: "unix"You have new mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 apache-maven-3.3.9]# 5.编译安装protobuf[root@sht-sgmhadoopnn-01 compilesoft]# wget ftp://ftp.netbsd.org/pub/pkgsrc/distfiles/protobuf-2.5.0.tar.gz -O protobuf-2.5.0.tar.gz[root@hadoop-01 compilesoft]# tar -zxvf protobuf-2.5.0.tar.gz[root@hadoop-01 compilesoft]# cd protobuf-2.5.0/[root@hadoop-01 protobuf-2.5.0]# ./configure [root@hadoop-01 protobuf-2.5.0]# make[root@hadoop-01 protobuf-2.5.0]# make install # 查看protobuf版本以测试是否安装成功[root@hadoop-01 protobuf-2.5.0]# protoc --versionprotoc: error while loading shared libraries: libprotobuf.so.8: cannot open shared object file: No such file or directory[root@hadoop-01 protobuf-2.5.0]# export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/usr/local/lib[root@hadoop-01 protobuf-2.5.0]# protoc --versionlibprotoc 2.5.0[root@hadoop-01 protobuf-2.5.0]# 6.安装snappy[root@sht-sgmhadoopnn-01 compilesoft]# wget http://pkgs.fedoraproject.org/repo/pkgs/snappy/snappy-1.1.1.tar.gz/8887e3b7253b22a31f5486bca3cbc1c2/snappy-1.1.1.tar.gz# 用root用户执行以下命令[root@sht-sgmhadoopnn-01 compilesoft]#tar -zxvf snappy-1.1.1.tar.gz[root@sht-sgmhadoopnn-01 compilesoft]# cd snappy-1.1.1/[root@sht-sgmhadoopnn-01 snappy-1.1.1]# ./configure[root@sht-sgmhadoopnn-01 snappy-1.1.1]# make[root@sht-sgmhadoopnn-01 snappy-1.1.1]# make install #查看snappy库文件[root@sht-sgmhadoopnn-01 snappy-1.1.1]# ls -lh /usr/local/lib |grep snappy-rw-r--r-- 1 root root 229K Jun 21 15:46 libsnappy.a-rwxr-xr-x 1 root root 953 Jun 21 15:46 libsnappy.lalrwxrwxrwx 1 root root 18 Jun 21 15:46 libsnappy.so -> libsnappy.so.1.2.0lrwxrwxrwx 1 root root 18 Jun 21 15:46 libsnappy.so.1 -> libsnappy.so.1.2.0-rwxr-xr-x 1 root root 145K Jun 21 15:46 libsnappy.so.1.2.0[root@sht-sgmhadoopnn-01 snappy-1.1.1]# 7.编译[root@sht-sgmhadoopnn-01 compilesoft]# cd hadoop-2.7.3-src mvn clean package -Pdist,native -DskipTests -Dtar或mvn package -Pdist,native -DskipTests -Dtar [root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# mvn clean package –Pdist,native –DskipTests –Dtar[INFO] Executing tasksmain: [exec] $ tar cf hadoop-2.7.3.tar hadoop-2.7.3 [exec] $ gzip -f hadoop-2.7.3.tar [exec] [exec] Hadoop dist tar available at: /root/learnproject/compilesoft/hadoop-2.7.3-src/hadoop-dist/target/hadoop-2.7.3.tar.gz [exec] [INFO] Executed tasks[INFO] [INFO] --- maven-javadoc-plugin:2.8.1:jar (module-javadocs) @ hadoop-dist ---[INFO] Building jar: /root/learnproject/compilesoft/hadoop-2.7.3-src/hadoop-dist/target/hadoop-dist-2.7.3-javadoc.jar[INFO] ------------------------------------------------------------------------[INFO] Reactor Summary:[INFO] [INFO] Apache Hadoop Main ................................. SUCCESS [ 14.707 s][INFO] Apache Hadoop Build Tools .......................... SUCCESS [ 6.832 s][INFO] Apache Hadoop Project POM .......................... SUCCESS [ 12.989 s][INFO] Apache Hadoop Annotations .......................... SUCCESS [ 14.258 s][INFO] Apache Hadoop Assemblies ........................... SUCCESS [ 0.411 s][INFO] Apache Hadoop Project Dist POM ..................... SUCCESS [ 4.814 s][INFO] Apache Hadoop Maven Plugins ........................ SUCCESS [ 23.566 s][INFO] Apache Hadoop MiniKDC .............................. SUCCESS [02:31 min][INFO] Apache Hadoop Auth ................................. SUCCESS [ 29.587 s][INFO] Apache Hadoop Auth Examples ........................ SUCCESS [ 13.954 s][INFO] Apache Hadoop Common ............................... SUCCESS [03:03 min][INFO] Apache Hadoop NFS .................................. SUCCESS [ 9.285 s][INFO] Apache Hadoop KMS .................................. SUCCESS [ 45.068 s][INFO] Apache Hadoop Common Project ....................... SUCCESS [ 0.049 s][INFO] Apache Hadoop HDFS ................................. SUCCESS [03:49 min][INFO] Apache Hadoop HttpFS ............................... SUCCESS [01:08 min][INFO] Apache Hadoop HDFS BookKeeper Journal .............. SUCCESS [ 28.935 s][INFO] Apache Hadoop HDFS-NFS ............................. SUCCESS [ 4.599 s][INFO] Apache Hadoop HDFS Project ......................... SUCCESS [ 0.044 s][INFO] hadoop-yarn ........................................ SUCCESS [ 0.043 s][INFO] hadoop-yarn-api .................................... SUCCESS [02:49 min][INFO] hadoop-yarn-common ................................. SUCCESS [ 40.792 s][INFO] hadoop-yarn-server ................................. SUCCESS [ 0.041 s][INFO] hadoop-yarn-server-common .......................... SUCCESS [ 15.750 s][INFO] hadoop-yarn-server-nodemanager ..................... SUCCESS [ 25.311 s][INFO] hadoop-yarn-server-web-proxy ....................... SUCCESS [ 6.415 s][INFO] hadoop-yarn-server-applicationhistoryservice ....... SUCCESS [ 12.274 s][INFO] hadoop-yarn-server-resourcemanager ................. SUCCESS [ 27.555 s][INFO] hadoop-yarn-server-tests ........................... SUCCESS [ 7.751 s][INFO] hadoop-yarn-client ................................. SUCCESS [ 11.347 s][INFO] hadoop-yarn-server-sharedcachemanager .............. SUCCESS [ 5.612 s][INFO] hadoop-yarn-applications ........................... SUCCESS [ 0.038 s][INFO] hadoop-yarn-applications-distributedshell .......... SUCCESS [ 4.029 s][INFO] hadoop-yarn-applications-unmanaged-am-launcher ..... SUCCESS [ 2.611 s][INFO] hadoop-yarn-site ................................... SUCCESS [ 0.077 s][INFO] hadoop-yarn-registry ............................... SUCCESS [ 8.045 s][INFO] hadoop-yarn-project ................................ SUCCESS [ 5.456 s][INFO] hadoop-mapreduce-client ............................ SUCCESS [ 0.226 s][INFO] hadoop-mapreduce-client-core ....................... SUCCESS [ 28.462 s][INFO] hadoop-mapreduce-client-common ..................... SUCCESS [ 25.872 s][INFO] hadoop-mapreduce-client-shuffle .................... SUCCESS [ 6.697 s][INFO] hadoop-mapreduce-client-app ........................ SUCCESS [ 14.121 s][INFO] hadoop-mapreduce-client-hs ......................... SUCCESS [ 9.328 s][INFO] hadoop-mapreduce-client-jobclient .................. SUCCESS [ 23.801 s][INFO] hadoop-mapreduce-client-hs-plugins ................. SUCCESS [ 2.412 s][INFO] Apache Hadoop MapReduce Examples ................... SUCCESS [ 8.876 s][INFO] hadoop-mapreduce ................................... SUCCESS [ 4.237 s][INFO] Apache Hadoop MapReduce Streaming .................. SUCCESS [ 14.285 s][INFO] Apache Hadoop Distributed Copy ..................... SUCCESS [ 19.759 s][INFO] Apache Hadoop Archives ............................. SUCCESS [ 3.069 s][INFO] Apache Hadoop Rumen ................................ SUCCESS [ 7.446 s][INFO] Apache Hadoop Gridmix .............................. SUCCESS [ 5.765 s][INFO] Apache Hadoop Data Join ............................ SUCCESS [ 3.752 s][INFO] Apache Hadoop Ant Tasks ............................ SUCCESS [ 2.771 s][INFO] Apache Hadoop Extras ............................... SUCCESS [ 5.612 s][INFO] Apache Hadoop Pipes ................................ SUCCESS [ 10.332 s][INFO] Apache Hadoop OpenStack support .................... SUCCESS [ 7.131 s][INFO] Apache Hadoop Amazon Web Services support .......... SUCCESS [01:32 min][INFO] Apache Hadoop Azure support ........................ SUCCESS [ 10.622 s][INFO] Apache Hadoop Client ............................... SUCCESS [ 12.540 s][INFO] Apache Hadoop Mini-Cluster ......................... SUCCESS [ 1.142 s][INFO] Apache Hadoop Scheduler Load Simulator ............. SUCCESS [ 7.354 s][INFO] Apache Hadoop Tools Dist ........................... SUCCESS [ 12.269 s][INFO] Apache Hadoop Tools ................................ SUCCESS [ 0.035 s][INFO] Apache Hadoop Distribution ......................... SUCCESS [ 58.051 s][INFO] ------------------------------------------------------------------------[INFO] BUILD SUCCESS[INFO] ------------------------------------------------------------------------[INFO] Total time: 26:29 min[INFO] Finished at: 2016-12-24T21:07:09+08:00[INFO] Final Memory: 214M/740M[INFO] ------------------------------------------------------------------------You have mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# [root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# cp /root/learnproject/compilesoft/hadoop-2.7.3-src/hadoop-dist/target/hadoop-2.7.3.tar.gz ../../You have mail in /var/spool/mail/root[root@sht-sgmhadoopnn-01 hadoop-2.7.3-src]# cd ../../[root@sht-sgmhadoopnn-01 learnproject]# lltotal 193152drwxr-xr-x 5 root root 4096 Dec 24 20:24 compilesoft-rw-r--r-- 1 root root 197782815 Dec 24 21:16 hadoop-2.7.3.tar.gz[root@sht-sgmhadoopnn-01 learnproject]# 8.搭建HDFS HA,YARN HA集群(5个节点)参考:http://blog.itpub.net/30089851/viewspace-1994585/https://github.com/Hackeruncle/Hadoop 9.搭建集群,验证版本和支持的压缩信息[root@sht-sgmhadoopnn-01 app]# hadoop versionHadoop 2.7.3Subversion Unknown -r UnknownCompiled by root on 2016-12-24T12:45ZCompiled with protoc 2.5.0From source with checksum 2e4ce5f957ea4db193bce3734ff29ff4This command was run using /root/learnproject/app/hadoop/share/hadoop/common/hadoop-common-2.7.3.jar[root@sht-sgmhadoopnn-01 app]# hadoop checknative16/12/25 15:55:43 INFO bzip2.Bzip2Factory: Successfully loaded & initialized native-bzip2 library system-native16/12/25 15:55:43 INFO zlib.ZlibFactory: Successfully loaded & initialized native-zlib libraryNative library checking:hadoop: true /root/learnproject/app/hadoop/lib/native/libhadoop.so.1.0.0zlib: true /lib64/libz.so.1snappy: true /usr/local/lib/libsnappy.so.1lz4: true revision:99bzip2: true /lib64/libbz2.so.1openssl: true /usr/lib64/libcrypto.so[root@sht-sgmhadoopnn-01 app]# file /root/learnproject/app/hadoop/lib/native/libhadoop.so.1.0.0/root/learnproject/app/hadoop/lib/native/libhadoop.so.1.0.0: ELF 64-bit LSB shared object, x86-64, version 1 (SYSV), dynamically linked, not stripped[root@sht-sgmhadoopnn-01 app]# 【参考】:http://happyshome.cn/blog/deploy/centos/hadoop2.7.2.htmlhttp://blog.csdn.net/haohaixingyun/article/details/52800048

优秀的个人博客,低调大师

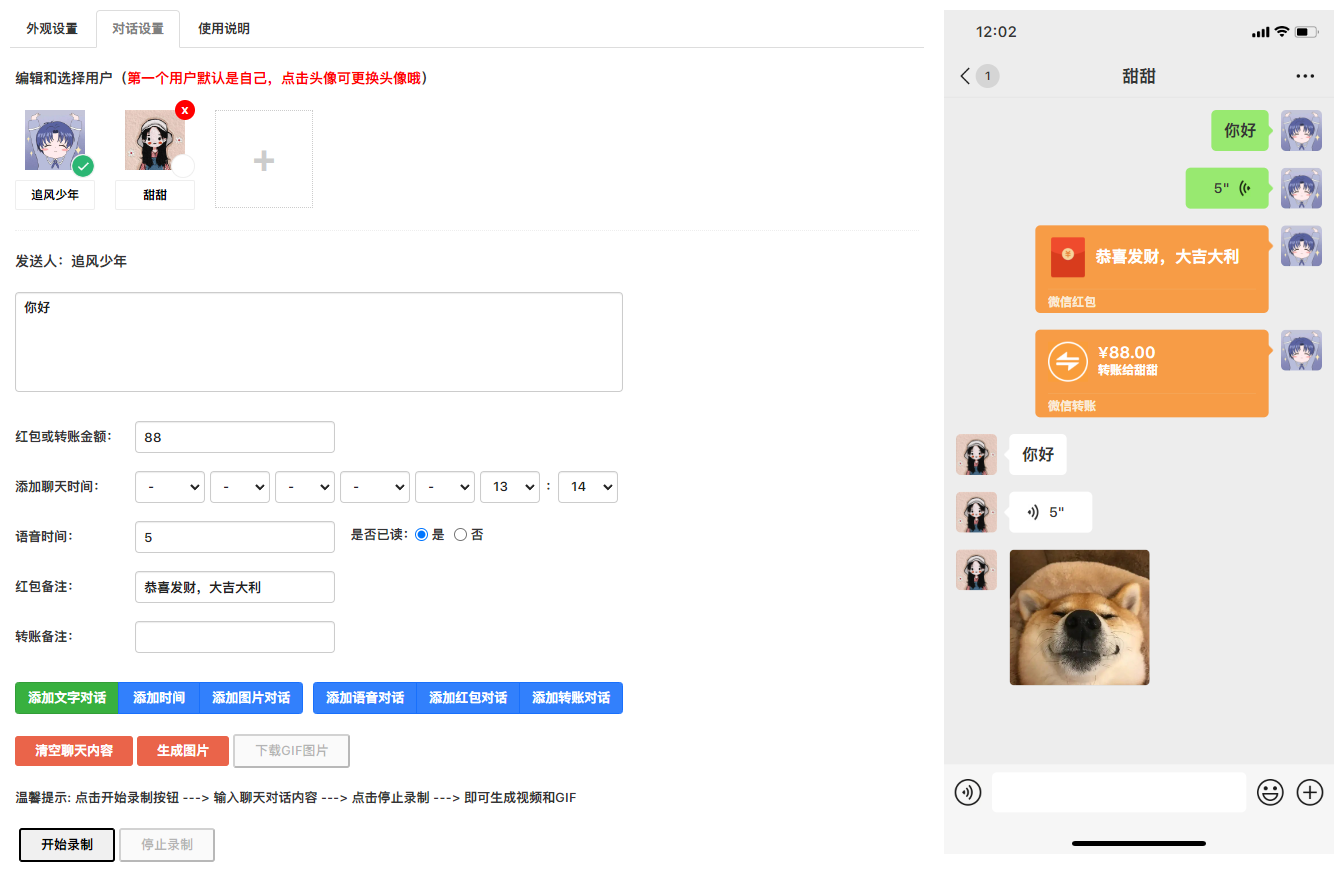
在线微信对话生成器,抖音微信聊天记录视频制作工具

修复年份选项问题,增加年份选项到2027 新增生成图片功能(该功能需要将项目部署在服务器上) 新增生成视频功能(该功能需要将项目部署在服务器上) 成品(解决无法右击保存生成好的图片) 成品(添加菜单栏刷新功能,用于解决录制视频后需重启才能二次录制的问题) 新增生成GIF功能 控制发送间隔时间(待开发) 高清录制MP4格式视频功能(待开发)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册