【Python】从0开始写爬虫——开发环境
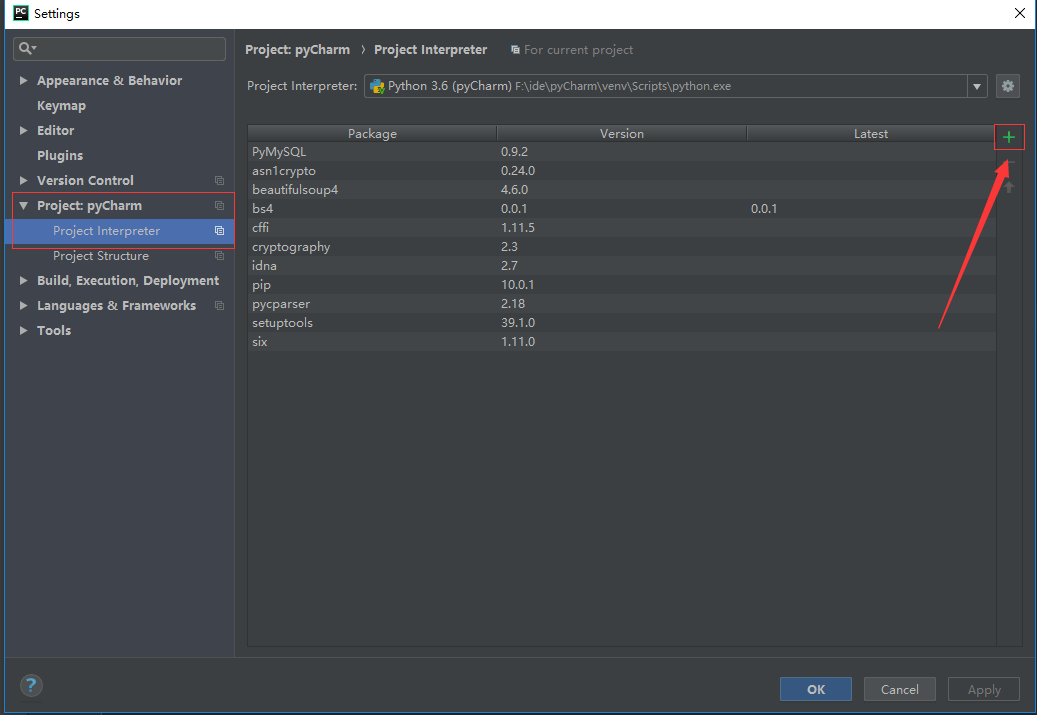
python小白,稍微看了点语法而已, 连字典的切片都永不顺的那种。本身是写java的,其实java也写得菜, 每天下了班不是太想写java。所以下班总是乱搞,什么都涉猎一点,也没什么太实际的收获。现在打算慢慢写个python爬虫玩 1. python环境搭建。我在windows上也是搭了python环境的,很久了。但是这个我在windows用pip安装的第三方库用起来总是报错。所以我一般都不用。我时用pycharm的python环境的。 在pycharm上安装需要的包,新建项目后,在左上角 File ->> Settings,然后弹出如下界面。点击红色箭头处添加,然后搜索就行了。不推荐自己在windows装,没必要浪费时间搞windows的环境 2. linux上,我租的阿里服务器,装的是CentOS7, linux上安装python3我就不介绍了。主要提醒一下CentOS是自带python2.7的,而且有一些功能是要用的这个版本的python,比如yum, 所以不要轻易卸载。 我安装的python3。在控制台输入 python2 就进入python2.7的shell, 输入python3就进入python3的shell。如下 [root@izwz94jyld0skyrwc1772ez ~]# python2 Python 2.7.5 (default, Jul 13 2018, 13:06:57) [GCC 4.8.5 20150623 (Red Hat 4.8.5-28)] on linux2 Type "help", "copyright", "credits" or "license" for more information. >>> >>> print 'hello, world' hello, world >>> [1]+ Stopped python2 [root@izwz94jyld0skyrwc1772ez ~]# python3 Python 3.6.2 (default, Jul 8 2018, 11:17:50) [GCC 4.8.5 20150623 (Red Hat 4.8.5-28)] on linux Type "help", "copyright", "credits" or "license" for more information. >>> >>> print('Hello, World') Hello, World >>> 但是在用 pip 安装第三方库的时候,只有python2能用。比如我安装个pandas。 [root@izwz94jyld0skyrwc1772ez ~]# pip install pandas Looking in indexes: http://mirrors.aliyun.com/pypi/simple/ Collecting pandas Downloading http://mirrors.aliyun.com/pypi/packages/65/b2/8c3a7fc10f581d0ef196e54ba13248e09b25012ab3b213cda83f8f5e7678/pandas-0.23.3-cp27-cp27mu-manylinux1_x86_64.whl (8.9MB) 100% |████████████████████████████████| 8.9MB 75.9MB/s Collecting pytz>=2011k (from pandas) Downloading http://mirrors.aliyun.com/pypi/packages/30/4e/27c34b62430286c6d59177a0842ed90dc789ce5d1ed740887653b898779a/pytz-2018.5-py2.py3-none-any.whl (510kB) 100% |████████████████████████████████| 512kB 81.3MB/s Collecting numpy>=1.9.0 (from pandas) Downloading http://mirrors.aliyun.com/pypi/packages/85/51/ba4564ded90e093dbb6adfc3e21f99ae953d9ad56477e1b0d4a93bacf7d3/numpy-1.15.0-cp27-cp27mu-manylinux1_x86_64.whl (13.8MB) 100% |████████████████████████████████| 13.8MB 75.1MB/s Collecting python-dateutil>=2.5.0 (from pandas) Downloading http://mirrors.aliyun.com/pypi/packages/cf/f5/af2b09c957ace60dcfac112b669c45c8c97e32f94aa8b56da4c6d1682825/python_dateutil-2.7.3-py2.py3-none-any.whl (211kB) 100% |████████████████████████████████| 215kB 85.7MB/s Requirement already satisfied: six>=1.5 in /usr/lib/python2.7/site-packages (from python-dateutil>=2.5.0->pandas) (1.11.0) Installing collected packages: pytz, numpy, python-dateutil, pandas Successfully installed numpy-1.15.0 pandas-0.23.3 python-dateutil-2.7.3 pytz-2018.5 然后我分别在python2和python3去使用它, 会发现python2可以用而python3不能用 [root@izwz94jyld0skyrwc1772ez ~]# python2 Python 2.7.5 (default, Jul 13 2018, 13:06:57) [GCC 4.8.5 20150623 (Red Hat 4.8.5-28)] on linux2 Type "help", "copyright", "credits" or "license" for more information. >>> from pandas import DataFrame /usr/lib64/python2.7/site-packages/pandas/_libs/__init__.py:4: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from .tslib import iNaT, NaT, Timestamp, Timedelta, OutOfBoundsDatetime /usr/lib64/python2.7/site-packages/pandas/__init__.py:26: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import (hashtable as _hashtable, /usr/lib64/python2.7/site-packages/pandas/core/dtypes/common.py:6: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import algos, lib /usr/lib64/python2.7/site-packages/pandas/core/util/hashing.py:7: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import hashing, tslib /usr/lib64/python2.7/site-packages/pandas/core/indexes/base.py:7: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import (lib, index as libindex, tslib as libts, /usr/lib64/python2.7/site-packages/pandas/tseries/offsets.py:21: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 import pandas._libs.tslibs.offsets as liboffsets /usr/lib64/python2.7/site-packages/pandas/core/ops.py:16: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import algos as libalgos, ops as libops /usr/lib64/python2.7/site-packages/pandas/core/indexes/interval.py:32: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs.interval import ( /usr/lib64/python2.7/site-packages/pandas/core/internals.py:14: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import internals as libinternals /usr/lib64/python2.7/site-packages/pandas/core/sparse/array.py:33: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 import pandas._libs.sparse as splib /usr/lib64/python2.7/site-packages/pandas/core/window.py:36: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 import pandas._libs.window as _window /usr/lib64/python2.7/site-packages/pandas/core/groupby/groupby.py:68: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import (lib, reduction, /usr/lib64/python2.7/site-packages/pandas/core/reshape/reshape.py:30: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import algos as _algos, reshape as _reshape /usr/lib64/python2.7/site-packages/pandas/io/parsers.py:45: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 import pandas._libs.parsers as parsers /usr/lib64/python2.7/site-packages/pandas/io/pytables.py:50: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 from pandas._libs import algos, lib, writers as libwriters >>> data={} >>> data['a'] = [1,2,3,4,5] >>> data['b'] = [6,7,8,9,0] >>> data['c'] = [11,12,13,14,15] >>> df = DataFrame(data) >>> print df a b c 0 1 6 11 1 2 7 12 2 3 8 13 3 4 9 14 4 5 0 15 >>> [8]+ Stopped python2 [root@izwz94jyld0skyrwc1772ez ~]# [root@izwz94jyld0skyrwc1772ez ~]# [root@izwz94jyld0skyrwc1772ez ~]# [root@izwz94jyld0skyrwc1772ez ~]# [root@izwz94jyld0skyrwc1772ez ~]# python3 Python 3.6.2 (default, Jul 8 2018, 11:17:50) [GCC 4.8.5 20150623 (Red Hat 4.8.5-28)] on linux Type "help", "copyright", "credits" or "license" for more information. >>> from pandas import DataFrame Traceback (most recent call last): File "<stdin>", line 1, in <module> ModuleNotFoundError: No module named 'pandas' >>> 因为pip默认用的是python2的。 所以如果我们要给python3 安装第三方库。不能直接用pip。应该用pip3. [root@izwz94jyld0skyrwc1772ez ~]# [root@izwz94jyld0skyrwc1772ez ~]# pip3 install pandas Looking in indexes: http://mirrors.aliyun.com/pypi/simple/ Collecting pandas Downloading http://mirrors.aliyun.com/pypi/packages/f4/cb/a801eaf624e36fffaa6cf1f4597a1e4b0742c200ed928e689c58fb3cb811/pandas-0.23.3-cp36-cp36m-manylinux1_x86_64.whl (8.9MB) 100% |████████████████████████████████| 8.9MB 73.6MB/s Collecting pytz>=2011k (from pandas) Downloading http://mirrors.aliyun.com/pypi/packages/30/4e/27c34b62430286c6d59177a0842ed90dc789ce5d1ed740887653b898779a/pytz-2018.5-py2.py3-none-any.whl (510kB) 100% |████████████████████████████████| 512kB 68.8MB/s Collecting numpy>=1.9.0 (from pandas) Downloading http://mirrors.aliyun.com/pypi/packages/88/29/f4c845648ed23264e986cdc5fbab5f8eace1be5e62144ef69ccc7189461d/numpy-1.15.0-cp36-cp36m-manylinux1_x86_64.whl (13.9MB) 100% |████████████████████████████████| 13.9MB 75.1MB/s Collecting python-dateutil>=2.5.0 (from pandas) Downloading http://mirrors.aliyun.com/pypi/packages/cf/f5/af2b09c957ace60dcfac112b669c45c8c97e32f94aa8b56da4c6d1682825/python_dateutil-2.7.3-py2.py3-none-any.whl (211kB) 100% |████████████████████████████████| 215kB 81.7MB/s Requirement already satisfied: six>=1.5 in /usr/local/python3/lib/python3.6/site-packages (from python-dateutil>=2.5.0->pandas) (1.11.0) Installing collected packages: pytz, numpy, python-dateutil, pandas Successfully installed numpy-1.15.0 pandas-0.23.3 python-dateutil-2.7.3 pytz-2018.5 You are using pip version 10.0.1, however version 18.0 is available. You should consider upgrading via the 'pip install --upgrade pip' command. [root@izwz94jyld0skyrwc1772ez ~]# python3 Python 3.6.2 (default, Jul 8 2018, 11:17:50) [GCC 4.8.5 20150623 (Red Hat 4.8.5-28)] on linux Type "help", "copyright", "credits" or "license" for more information. >>> from pandas import DataFrame /usr/local/python3/lib/python3.6/importlib/_bootstrap.py:205: RuntimeWarning: numpy.dtype size changed, may indicate binary incompatibility. Expected 96, got 88 return f(*args, **kwds) >>> data={} >>> data['b'] = [6,7,8,9,0] >>> data['b'] = [6,7,8,9,0] >>> data['c'] = [11,12,13,14,15] >>> df = DataFrame(data) >>> print(df) b c 0 6 11 1 7 12 2 8 13 3 9 14 4 0 15 >>> 这样就ok了。 3. 我先安装了几个包 bs4 用BeautifulSoup来解析html PyMySQL用来把数据存到数据库 4. 目前的打算是 1. 用 urllib 来获取html数据 2. 用 BeautifulSoup来解析html爬取要得信息。 3. 用PyMySQL来存储数据 4. 单页面都测试成功了考虑用线程池。放到服务器上跑个一天两天? 5. 然后会做一点数据分析。。。emmmm这都是后话了