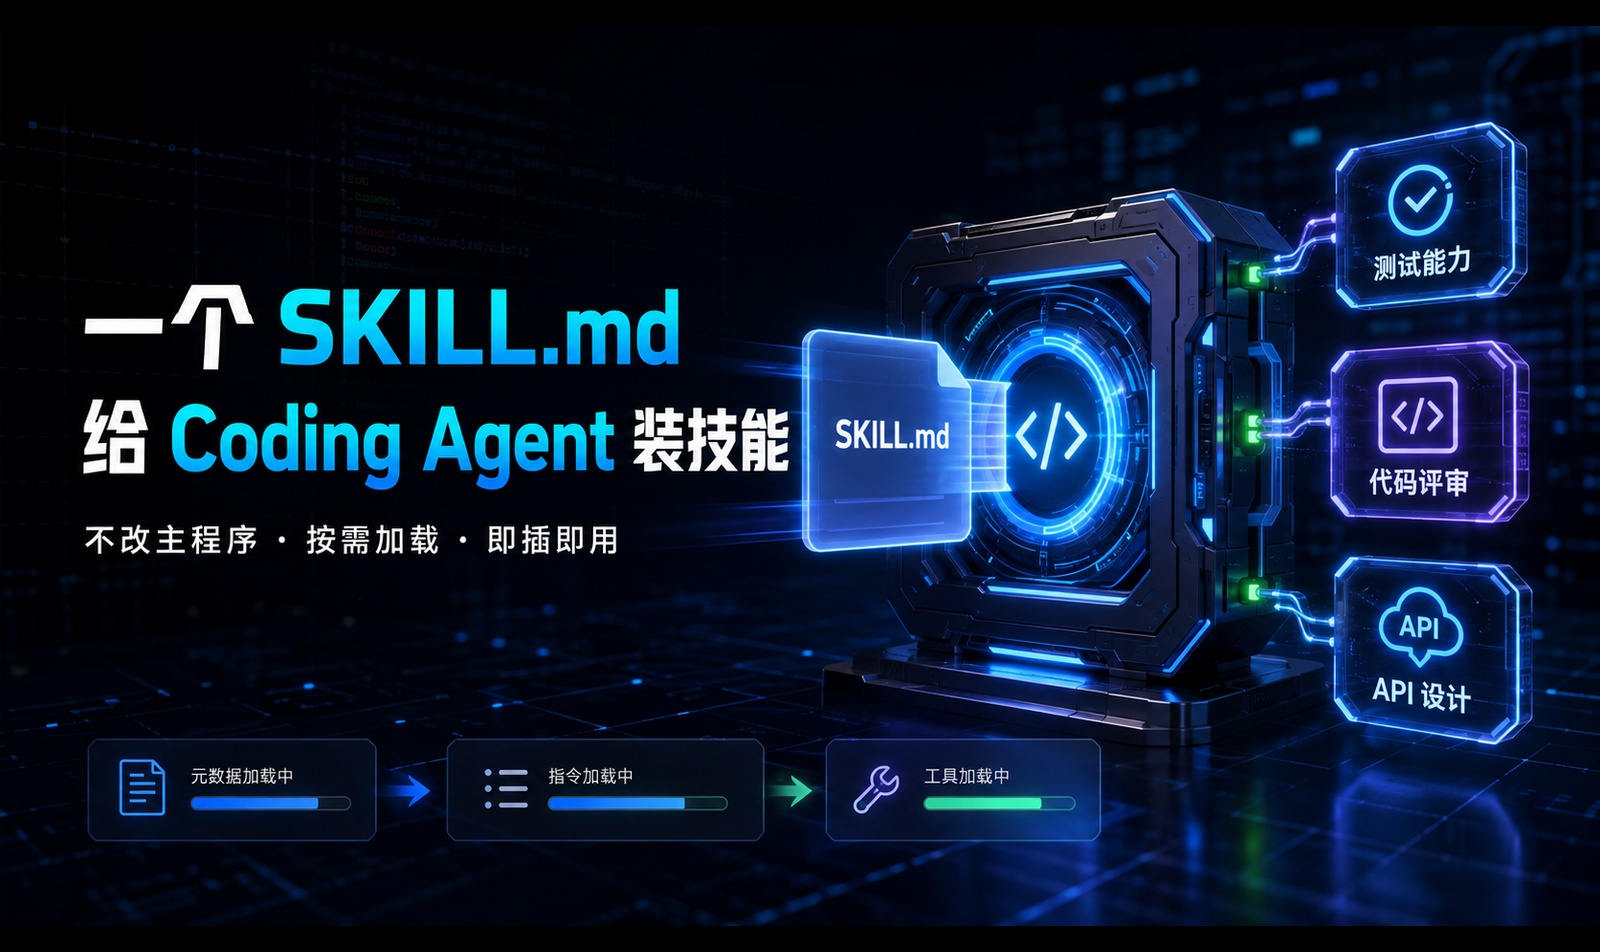
不改 Agent 主程序,一个 SKILL.md 就能给 AI 编程助手装技能
> 上一篇我们用 Python 手写了一个能读项目、改代码、跑测试的 Coding Agent。这次继续升级:不再为每一种任务修改 Python 源码,只要向 `skills` 目录放入一个 `SKILL.md`,Agent 就能自动发现并按需加载新技能。 @[TOC](本文目录) --- ## 前言:给 Agent 加能力,为什么一定要改代码 上一篇 Coding Agent 已经可以完成一个最小开发闭环: ```javascript 查看项目 → 读取文件 → 修改代码 → 运行测试 → 根据报错继续修复 ``` 但真正使用时,很快会遇到一个问题。 不同项目、不同团队、不同任务的要求并不一样: - Python 项目要求使用 `pytest`,新增功能必须补边界测试; - API 项目要求统一返回格式,错误码不能随意定义; - 代码审查要求先看 Diff,再检查安全、性能和兼容性; - 前端项目要求通过 ESLint、类型检查和构建测试; - 企业项目还有自己的目录规范、提交规范和发布流程。 最直接的办法,是把所有规则全部写进系统提示词。 但规则越来越多以后,系统提示词会变得又长又乱。模型每次都要读取与当前任务无关的内容,不但浪费 Token,还容易出现指令互相干扰。 Skills 提供了另一种思路: > 以前:增加能力,需要修改 Agent 源码。 现在:新增一个 SKILL.md,Agent 自动发现并按需使用。 这就是 Skills 最核心的卖点。 --- ## 一、Skill 到底是什么 一个最小 Skill 不是 Python 插件,也不需要单独启动服务器。 它只是一个目录,里面至少包含一个 `SKILL.md`: ```javascript skills/ └── python-testing/ └── SKILL.md ``` `SKILL.md` 由两部分组成: 1. YAML 元数据:告诉 Agent 这个 Skill 是什么、什么时候使用; 1. Markdown 正文:告诉 Agent 具体应该按什么流程执行。 最小示例: ```javascript --- name: python-testing description: 为 Python 项目编写和运行 pytest 测试。用户要求补测试、修复测试或验证 Python 代码时使用。 --- # Python Testing ## 工作流程 1. 先读取现有代码和测试结构; 2. 优先沿用项目已有测试风格; 3. 同时覆盖正常路径、边界条件和异常路径; 4. 修改完成后运行 pytest; 5. 测试未通过时不得宣布任务完成。 ``` 其中,`name` 和 `description` 是必填字段。 按照 Agent Skills 规范,`name` 只能使用小写字母、数字和连字符,并且要与父目录名称一致。`description` 不能只写“帮助测试”,而应该同时说明: - 这个 Skill 能做什么; - 什么任务应该触发它。 因为 Agent 启动时首先看到的不是完整正文,而是这两个字段。 --- ## 二、Skills 的四个核心卖点 ### 1. 能力与 Agent 主程序解耦 没有 Skills 时,新增代码审查能力可能需要: ```javascript if task_type == "code_review": prompt += CODE_REVIEW_RULES ``` 再增加 API 设计、数据库迁移和测试规范后,主程序里会出现越来越多条件分支。 引入 Skills 后,主程序只负责: ```javascript 发现技能 → 展示元数据 → 按需加载 → 执行任务 ``` 至于“代码审查应该检查什么”,由 `code-review/SKILL.md` 自己定义。 ### 2. 不改代码就能扩展能力 给 Agent 增加新技能,只需要新建目录: ```javascript skills/ ├── python-testing/ │ └── SKILL.md ├── code-review/ │ └── SKILL.md └── api-design/ └── SKILL.md ``` Agent 下次启动时会自动扫描,不需要重新修改核心 Python 文件。 这意味着业务专家也可以维护 Skill。测试工程师编写测试规范,安全人员编写审查清单,运营人员维护内容流程,不必让所有规则都由 Agent 开发者硬编码。 ### 3. 按需加载,节省上下文 Skills 不是把所有文件一次性塞进 Prompt,而是采用渐进式加载: ```javascript 第 1 层:启动时只加载 name + description 第 2 层:任务命中后加载完整 SKILL.md 第 3 层:需要时再读取 references、assets 或运行 scripts ``` 假设安装了 30 个 Skills,但用户只要求“给这个函数补 pytest 测试”,模型启动时只需要看到 30 条简短描述,随后只加载 `python-testing` 的完整正文。 其他 29 个 Skills 的详细规则不会进入本轮上下文。 ### 4. 可以版本管理和团队复用 Skill 本质上是文本文件,因此可以: - 提交到 Git; - 进行代码审查; - 记录版本变化; - 在不同项目之间复制; - 由团队共同维护; - 回滚到之前版本。 与藏在某个人 Prompt 收藏夹里的提示词相比,`SKILL.md` 更像一份可维护、可审查、可复用的标准作业程序。 --- ## 三、Skill、Tool、MCP、AGENTS.md 有什么区别 这些概念经常被混在一起,其实它们解决的问题不同。 |机制|解决的问题|典型内容| | --- | --- | --- | |Tool|Agent 能执行什么动作|读文件、写文件、运行测试| |Skill|Agent 应该怎样完成某类任务|测试流程、审查规则、交付标准| |MCP|Agent 如何连接外部工具和数据|GitHub、数据库、搜索、内部系统| |AGENTS.md|当前项目长期遵守什么规则|构建命令、目录约定、提交规范| 可以用一个简单例子理解: ```javascript Tool:我有一把锤子 Skill:我知道怎样按流程安装一扇门 MCP:我能去工具仓库借电钻 AGENTS.md:这栋房子的施工规范是什么 ``` Skill 不会凭空增加系统权限。它只是告诉 Agent 应该使用哪些现有工具、按什么步骤做事、满足什么完成条件。 --- ## 四、本次要实现的 Skills 运行时 这次在上一篇 Coding Agent 的基础上增加四项能力: 1. 启动时扫描 `skills/*/SKILL.md`; 1. 解析 YAML 中的 `name` 和 `description`; 1. 把技能索引加入系统提示词; 1. 提供 `load_skill` 工具,按需加载完整正文。 最终执行流程: ```javascript 用户提出任务 ↓ Agent 查看技能索引 ↓ 是否有匹配 Skill? ├─ 有:调用 load_skill └─ 无:使用通用工具处理 ↓ 按照 Skill 流程执行 ↓ 读项目 → 改代码 → 跑测试 ↓ 满足完成条件后结束 ``` 项目结构如下: ```javascript skills-coding-agent/ ├── .env ├── skill_agent.py ├── skills/ │ ├── python-testing/ │ │ └── SKILL.md │ └── code-review/ │ └── SKILL.md └── workspace/ ├── calculator.py └── test_calculator.py ``` --- ## 五、准备两个示例 Skills ### 1. Python 测试 Skill 创建 `skills/python-testing/SKILL.md`: ```javascript --- name: python-testing description: 为 Python 项目编写、补充和修复 pytest 测试。用户提到 pytest、单元测试、测试失败、边界测试或验证 Python 功能时使用。 --- # Python Testing ## 执行步骤 1. 使用 list_files 查看项目结构; 2. 读取被测代码和现有测试; 3. 沿用项目已有命名与断言风格; 4. 覆盖正常路径、边界条件和异常路径; 5. 修改完成后调用 run_tests; 6. 根据真实报错继续修复; 7. 只有 pytest 通过后才能结束。 ## 约束 - 不为通过测试而删除有效断言; - 不修改与任务无关的业务逻辑; - 不把多个无关场景塞进同一个测试; - 测试名称必须说明被验证的行为。 ## 输出要求 最终说明新增或修改了哪些测试,以及 pytest 是否通过。 ``` ### 2. 代码审查 Skill 创建 `skills/code-review/SKILL.md`: ```javascript --- name: code-review description: 审查代码改动中的正确性、安全性、性能、可维护性和测试覆盖。用户要求 review、代码审查、检查风险或分析改动时使用。 --- # Code Review ## 审查顺序 1. 先查看项目结构和相关文件; 2. 理解代码意图,不只检查语法; 3. 按严重程度输出问题; 4. 每个问题必须包含文件、原因和修改建议; 5. 没有证据时不要把猜测写成确定结论。 ## 检查清单 - 正确性:边界条件、空值、异常路径; - 安全性:路径穿越、命令注入、敏感信息; - 性能:重复 IO、无界循环、不必要的全量读取; - 可维护性:重复逻辑、命名、职责混乱; - 测试:关键路径是否被验证。 ## 输出格式 按照“严重 / 建议 / 通过项”三部分输出审查结果。 ``` 只添加这两个文件,Agent 主程序不需要针对测试和审查分别写业务分支。 --- ## 六、安装依赖和配置模型 安装依赖: ```javascript pip install openai python-dotenv pyyaml pytest ``` 在项目根目录创建 `.env`: ```javascript GENVIS_API_KEY=替换成你的_API_KEY ``` 本文继续使用 Genvis 的 OpenAI 兼容接口: ```javascript client = OpenAI( api_key=os.getenv("GENVIS_API_KEY"), base_url="https://genvis.xyz/v1" ) ``` Skills 很考验模型理解描述、遵循流程和稳定调用工具的能力。统一接口的好处是:保持 Agent、工具和 Skills 完全不变,只修改 `MODEL_NAME`,就可以比较不同模型触发 Skill、完成任务和消耗 Token 的差异。 --- ## 七、完整可运行代码 新建 `skill_agent.py`: ```javascript import json import os import re import subprocess from dataclasses import dataclass from pathlib import Path from typing import Any, Callable import yaml from dotenv import load_dotenv from openai import OpenAI load_dotenv() API_KEY = os.getenv("GENVIS_API_KEY") if not API_KEY: raise RuntimeError("未读取到 GENVIS_API_KEY,请检查 .env 文件") client = OpenAI( api_key=API_KEY, base_url="https://genvis.xyz/v1" ) MODEL_NAME = "gpt-5.6-sol" WORKSPACE = Path("workspace").resolve() SKILLS_DIR = Path("skills").resolve() MAX_STEPS = 20 MAX_FILE_SIZE = 100_000 MAX_SKILL_SIZE = 50_000 ALLOWED_SUFFIXES = { ".py", ".json", ".toml", ".yaml", ".yml", ".md", ".txt", ".html", ".css", ".js", ".ts" } @dataclass(frozen=True) class Skill: name: str description: str path: Path body: str def parse_skill(skill_file: Path) -> Skill: """解析并校验一个 SKILL.md。""" text = skill_file.read_text(encoding="utf-8") if len(text.encode("utf-8")) > MAX_SKILL_SIZE: raise ValueError("SKILL.md 过大") if not text.startswith("---\n"): raise ValueError("缺少 YAML frontmatter") parts = text.split("\n---\n", 1) if len(parts) != 2: raise ValueError("frontmatter 没有正确结束") frontmatter = yaml.safe_load(parts[0][4:]) or {} body = parts[1].strip() name = frontmatter.get("name") description = frontmatter.get("description") if not isinstance(name, str) or not re.fullmatch( r"[a-z0-9]+(?:-[a-z0-9]+)*", name ): raise ValueError("name 格式不合法") if name != skill_file.parent.name: raise ValueError("name 必须与父目录名称一致") if not isinstance(description, str) or not description.strip(): raise ValueError("description 不能为空") if len(description) > 1024: raise ValueError("description 超过 1024 字符") return Skill( name=name, description=description.strip(), path=skill_file, body=body ) def discover_skills() -> dict[str, Skill]: """扫描 skills 目录,跳过格式错误的 Skill。""" discovered: dict[str, Skill] = {} SKILLS_DIR.mkdir(parents=True, exist_ok=True) for skill_file in sorted(SKILLS_DIR.glob("*/SKILL.md")): try: skill = parse_skill(skill_file) discovered[skill.name] = skill except Exception as error: relative = skill_file.relative_to(SKILLS_DIR) print(f"[Skill Warning] {relative}: {error}") return discovered SKILLS = discover_skills() def build_skill_index() -> str: """只把 Skill 元数据放入系统提示词。""" if not SKILLS: return "当前没有安装 Skill。" lines = ["当前可用 Skills:"] for skill in SKILLS.values(): lines.append(f"- {skill.name}: {skill.description}") return "\n".join(lines) def load_skill(name: str) -> dict[str, Any]: """按名称加载完整 Skill 指令。""" skill = SKILLS.get(name) if skill is None: return {"success": False, "error": f"Skill 不存在:{name}"} return { "success": True, "name": skill.name, "instructions": skill.body } def resolve_workspace_path(relative_path: str) -> Path: """将文件操作限制在 workspace 内。""" target = (WORKSPACE / relative_path).resolve() if target != WORKSPACE and WORKSPACE not in target.parents: raise ValueError("路径超出 workspace 范围") return target def list_files(path: str = ".") -> dict[str, Any]: target = resolve_workspace_path(path) if not target.exists() or not target.is_dir(): return {"success": False, "error": "目录不存在"} ignored = {".git", "__pycache__", ".pytest_cache", ".venv"} files = [] for item in sorted(target.rglob("*")): if any(part in ignored for part in item.parts): continue if item.is_file(): files.append(str(item.relative_to(WORKSPACE))) if len(files) >= 200: break return {"success": True, "files": files} def read_file(path: str) -> dict[str, Any]: target = resolve_workspace_path(path) if not target.exists() or not target.is_file(): return {"success": False, "error": "文件不存在"} if target.suffix.lower() not in ALLOWED_SUFFIXES: return {"success": False, "error": "不允许读取该文件类型"} if target.stat().st_size > MAX_FILE_SIZE: return {"success": False, "error": "文件过大"} try: content = target.read_text(encoding="utf-8") except UnicodeDecodeError: return {"success": False, "error": "文件不是 UTF-8 文本"} return {"success": True, "path": path, "content": content} def write_file(path: str, content: str) -> dict[str, Any]: target = resolve_workspace_path(path) if target.suffix.lower() not in ALLOWED_SUFFIXES: return {"success": False, "error": "不允许写入该文件类型"} if len(content.encode("utf-8")) > MAX_FILE_SIZE: return {"success": False, "error": "写入内容过大"} target.parent.mkdir(parents=True, exist_ok=True) target.write_text(content, encoding="utf-8") return {"success": True, "path": path} def replace_text(path: str, old: str, new: str) -> dict[str, Any]: target = resolve_workspace_path(path) if not target.exists() or not target.is_file(): return {"success": False, "error": "文件不存在"} content = target.read_text(encoding="utf-8") count = content.count(old) if count == 0: return {"success": False, "error": "没有找到待替换内容"} if count > 1: return {"success": False, "error": "待替换内容不唯一"} target.write_text(content.replace(old, new, 1), encoding="utf-8") return {"success": True, "path": path, "replacements": 1} def run_tests(command: str = "pytest") -> dict[str, Any]: """使用固定参数运行 pytest,不接受任意 Shell。""" if command != "pytest": return {"success": False, "error": "只允许 pytest"} try: result = subprocess.run( ["python", "-m", "pytest", "-q"], cwd=WORKSPACE, capture_output=True, text=True, timeout=30, check=False ) except subprocess.TimeoutExpired: return {"success": False, "error": "测试超时"} output = (result.stdout + "\n" + result.stderr)[-12_000:] return { "success": result.returncode == 0, "returncode": result.returncode, "output": output } TOOLS: dict[str, Callable[..., dict[str, Any]]] = { "load_skill": load_skill, "list_files": list_files, "read_file": read_file, "write_file": write_file, "replace_text": replace_text, "run_tests": run_tests } def build_system_prompt() -> str: return f""" 你是一个运行在受限 workspace 中的 Coding Agent。 {build_skill_index()} Skills 使用规则: 1. 先根据 name 和 description 判断任务是否匹配某个 Skill; 2. 匹配时先调用 load_skill,再执行具体任务; 3. 不要假装知道尚未加载的 Skill 正文; 4. 没有匹配 Skill 时,使用通用能力处理。 可用工具: - load_skill: {{"name": "skill-name"}} - list_files: {{"path": "."}} - read_file: {{"path": "相对路径"}} - write_file: {{"path": "相对路径", "content": "完整内容"}} - replace_text: {{"path": "相对路径", "old": "原文本", "new": "新文本"}} - run_tests: {{"command": "pytest"}} 调用工具时只输出: {{ "type": "tool_call", "tool": "工具名称", "arguments": {{}} }} 完成任务时只输出: {{ "type": "final", "answer": "加载了什么 Skill、完成了什么、测试是否通过" }} 通用规则: 1. 修改前先查看目录和相关文件; 2. 不猜测没有读取过的文件内容; 3. 修改代码后必须运行测试; 4. 测试失败时根据真实错误继续修复; 5. 只能输出合法 JSON; 6. 不得要求执行白名单以外的命令。 """ def call_model(messages: list[dict[str, str]]) -> dict[str, Any]: response = client.chat.completions.create( model=MODEL_NAME, messages=messages, temperature=0.1 ) content = response.choices[0].message.content if not content: raise RuntimeError("模型返回空内容") try: return json.loads(content) except json.JSONDecodeError as error: raise RuntimeError(f"模型没有返回合法 JSON:{content}") from error def execute_tool(action: dict[str, Any]) -> dict[str, Any]: tool_name = action.get("tool") arguments = action.get("arguments", {}) tool = TOOLS.get(tool_name) if tool is None: return {"success": False, "error": f"未知工具:{tool_name}"} if not isinstance(arguments, dict): return {"success": False, "error": "arguments 必须是对象"} try: return tool(**arguments) except TypeError as error: return {"success": False, "error": f"工具参数错误:{error}"} except Exception as error: return {"success": False, "error": f"工具执行异常:{error}"} def run_agent(task: str) -> str: WORKSPACE.mkdir(parents=True, exist_ok=True) tests_passed = False workspace_modified = False loaded_skills: set[str] = set() messages = [ {"role": "system", "content": build_system_prompt()}, {"role": "user", "content": task} ] for step in range(1, MAX_STEPS + 1): print(f"\n[Step {step}/{MAX_STEPS}] 模型正在决策...") action = call_model(messages) action_type = action.get("type") if action_type == "final": if not workspace_modified or tests_passed: return str(action.get("answer", "任务完成")) result = { "success": False, "error": "最后一次修改后尚未通过测试,不能结束" } elif action_type != "tool_call": result = {"success": False, "error": "无法识别模型动作"} else: tool_name = action.get("tool") print(f"[Tool] {tool_name} {action.get('arguments', {})}") result = execute_tool(action) if tool_name == "load_skill" and result.get("success"): loaded_skills.add(str(result.get("name"))) elif tool_name in {"write_file", "replace_text"}: workspace_modified = True tests_passed = False elif tool_name == "run_tests" and result.get("success"): tests_passed = True print(f"[Result] {json.dumps(result, ensure_ascii=False)[:600]}") messages.append({ "role": "assistant", "content": json.dumps(action, ensure_ascii=False) }) messages.append({ "role": "user", "content": "工具执行结果:\n" + json.dumps(result, ensure_ascii=False) }) return ( f"任务未在 {MAX_STEPS} 步内完成;" f"已加载 Skills:{sorted(loaded_skills)}" ) if __name__ == "__main__": print("Skills Coding Agent") print(f"发现 Skills:{list(SKILLS)}") print(f"Workspace:{WORKSPACE}") print("输入 exit 退出\n") while True: user_task = input("任务 > ").strip() if user_task.lower() in {"exit", "quit"}: break if not user_task: continue try: print(f"\nAgent:{run_agent(user_task)}") except Exception as error: print(f"\n运行失败:{error}") ``` --- ## 八、运行效果 启动程序: ```javascript python skill_agent.py ``` 启动时可以看到 Agent 自动发现技能: ```javascript Skills Coding Agent 发现 Skills:['code-review', 'python-testing'] Workspace:.../workspace ``` 输入任务: ```javascript 给 calculator.py 的 divide 函数补充 pytest 测试,覆盖正常除法和除数为 0,并运行测试。 ``` 一次典型的执行过程: ```javascript [Step 1/20] 模型正在决策... [Tool] load_skill {'name': 'python-testing'} [Result] {'success': true, 'name': 'python-testing', 'instructions': '...'} [Step 2/20] 模型正在决策... [Tool] list_files {'path': '.'} [Step 3/20] 模型正在决策... [Tool] read_file {'path': 'calculator.py'} [Step 4/20] 模型正在决策... [Tool] read_file {'path': 'test_calculator.py'} [Step 5/20] 模型正在决策... [Tool] replace_text {...} [Step 6/20] 模型正在决策... [Tool] run_tests {'command': 'pytest'} [Result] {'success': true, 'output': '4 passed'} Agent:已加载 python-testing Skill,补充正常除法和除零测试,pytest 全部通过。 ``` 如果把任务改为: ```javascript 审查 calculator.py,重点检查正确性、安全性和测试覆盖。 ``` 模型看到技能索引后,会优先加载 `code-review`,而不是把 `python-testing` 的完整内容也塞进上下文。 --- ## 九、核心代码拆解 ### 1. 为什么启动时不读取完整 SKILL.md 下面的索引只包含名称和描述: ```javascript for skill in SKILLS.values(): lines.append(f"- {skill.name}: {skill.description}") ``` 模型可以根据这些元数据判断是否匹配任务,但暂时看不到完整工作流。 这正是渐进式加载的第一层。 如果启动时把所有正文全部拼进系统提示词,安装的 Skill 越多,每次请求浪费的 Token 就越多,也更容易出现不相关规则干扰当前任务。 ### 2. load_skill 才是真正的激活开关 当模型判断任务匹配 `python-testing` 时,它会输出: ```javascript { "type": "tool_call", "tool": "load_skill", "arguments": { "name": "python-testing" } } ``` Python 程序找到对应 Skill,将完整正文作为工具结果返回。此后模型才能按照其中的测试流程继续执行。 ### 3. description 决定 Skill 能否被正确触发 下面这种描述太模糊: ```javascript description: 帮助处理 Python。 ``` 模型不知道什么时候应该选择它。 更好的写法: ```javascript description: 为 Python 项目编写、补充和修复 pytest 测试。用户提到 pytest、单元测试、测试失败、边界测试或验证 Python 功能时使用。 ``` 它同时包含能力、触发场景和关键词。 可以把 `description` 理解为 Skill 的“搜索标题 + 触发规则”。正文写得再好,如果描述无法匹配任务,Skill 也不会被加载。 ### 4. Skill 只能指导,权限仍由工具层控制 即使某个 `SKILL.md` 写着“读取系统密码文件”,本文的 `read_file` 仍然只能访问 `workspace`。 ```javascript if target != WORKSPACE and WORKSPACE not in target.parents: raise ValueError("路径超出 workspace 范围") ``` 这条边界不能交给 Prompt 或 Skill 决定。 > 安全提示:Skill 是指令,不是可信代码。安装第三方 Skill 前应该像审查依赖包一样检查其正文、脚本、网络要求和工具权限。 ### 5. 为什么还要保留测试状态 Skill 中虽然写了“修改后测试通过才能结束”,程序层仍然维护: ```javascript tests_passed = False workspace_modified = False ``` 纯代码审查没有修改文件时可以直接结束;一旦调用 `write_file` 或 `replace_text`,就必须真实执行 `run_tests` 并成功后才能结束。测试通过后如果又修改文件,状态会再次变回 `False`。 原则仍然是: > **可以用代码强制执行的规则,不要只依赖模型遵守文字指令。** --- ## 十、无 Skill、全量加载和按需加载的区别 |模式|优点|问题| | --- | --- | --- | |无 Skill|系统简单|任务流程不稳定,经验难以复用| |全量加载|所有规则都能看到|Token 浪费,规则容易互相干扰| |按需加载|上下文精简、能力可扩展|依赖准确的描述和模型选择能力| 这也是为什么测试不同模型时,不能只看它“会不会写代码”。 对于 Skills Agent,更应该观察: 1. 能否根据描述选择正确 Skill; 1. 是否在执行前真正调用 `load_skill`; 1. 能否完整遵守 Skill 工作流; 1. 遇到测试失败是否继续修复; 1. 完成同一任务需要多少步骤和 Token。 本文使用 `base_url=https://genvis.xyz/v1` 的统一接口,切换模型时只修改 `MODEL_NAME`。同一任务、同一套 Tools、同一组 Skills,可以直接对比不同模型的触发稳定性和实际成本。 --- ## 十一、继续升级:完整的三级渐进加载 本文已经实现: ```javascript 第 1 层:Skill 元数据索引 第 2 层:按需加载 SKILL.md ``` 下一步可以继续增加第三层: ```javascript python-testing/ ├── SKILL.md ├── references/ │ ├── pytest-style.md │ └── mocking-guide.md ├── scripts/ │ └── coverage_report.py └── assets/ └── test-template.py ``` 再为 Agent 增加三个工具: - `read_skill_resource`:按需读取参考资料; - `run_skill_script`:在受限环境运行 Skill 脚本; - `copy_skill_asset`:复制模板或静态资源。 这样即使一个 Skill 包含大量专业资料,也不必一次性塞进上下文。 --- ## 十二、常见问题与避坑 ### 1. Skill 一直不触发 优先检查 `description`。它应该写清楚“做什么”和“什么时候使用”,并包含用户可能使用的关键词。 ### 2. Agent 看到了 Skill,却不调用 load_skill 在系统提示词里明确要求:匹配任务时必须先调用 `load_skill`,不得根据名称猜测正文内容。 生产版本还可以在程序层检查:如果模型声称使用某个 Skill,但该 Skill 没有出现在 `loaded_skills` 中,就拒绝结束。 ### 3. Skill 越写越长怎么办 把详细资料拆到 `references/`,把确定性的重复操作放进 `scripts/`,主 `SKILL.md` 只保留工作流、选择规则和资源入口。 ### 4. Skill 和超长系统提示词有什么区别 系统提示词每轮都会加载;Skill 正文只有匹配任务时才进入上下文。安装的技能越多,这个差别越明显。 ### 5. 可以安装网上下载的 Skill 吗 可以,但必须先审查。重点检查: - 是否要求读取敏感文件; - 是否包含 Shell 或 Python 脚本; - 是否访问外部网络; - 是否要求上传数据; - 是否扩大工具权限; - 是否隐藏了与描述无关的指令。 ### 6. 这份代码可以直接用于生产吗 它适合学习原理和本地受控实验。生产环境还需要容器沙箱、用户审批、脚本签名、Skill 来源校验、资源配额、审计日志和可回滚机制。 --- ## 十三、总结 本文没有引入复杂 Agent 框架,只在原有 Coding Agent 上增加了一个轻量 Skills 运行时: 1. 自动扫描 `skills` 目录; 1. 校验 `SKILL.md` 元数据; 1. 启动时只加载名称与描述; 1. 模型匹配任务后调用 `load_skill`; 1. 完整指令进入上下文; 1. Agent 按 Skill 流程调用工具; 1. 程序层继续负责权限和测试门禁。 Skills 的核心卖点,可以浓缩成一句话: > **把专业知识和工作流程从 Agent 源码中拆出来,封装成可以按需加载、版本管理和团队复用的能力包。** 以前给 Agent 增加测试、审查、API 设计等能力,需要修改主程序;现在只要新增一个符合规范的 `SKILL.md`,Agent 就能自动发现并使用。 需要测试不同模型对 Skill 的触发和遵循效果时,可以保持全部代码不变,通过 `base_url=https://genvis.xyz/v1` 和 `MODEL_NAME` 切换模型,再结合后台的任务 Token 与成本明细进行比较。