首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

论文笔记系列-Simple And Efficient Architecture Search For Neural Networks

摘要 本文提出了一种新方法,可以基于简单的爬山过程自动搜索性能良好的CNN架构,该算法运算符应用网络态射,然后通过余弦退火进行短期优化运行。 令人惊讶的是,这种简单的方法产生了有竞争力的结果,尽管只需要与训练单个网络相同数量级的资源。例如使用该算法,在单个GPU上训练12个小时就可以将CIFAR-10数据集的错误率降低到6%一下,训练一整天后能够降低到5%左右。 1.介绍 背景不再详述,我们可以知道的是传统的优化算法并不能实现神经网络架构的自动搜索是因为其架构搜索空间是 离散的(例如层数、层类型等), 有条件的(例如,定义层的参数的数量取决于层类型)。因此,依赖于可微分或者独立参数的算法是不可行的。 由于上述原因也就使得进化算法和增强算法得到广泛应用,但是这些方法要么消耗巨大,要么无法获得优异的表现。 本文的贡献如下: 提出了一种基线方法,该方法 随机构造出网络,并使用SGDR对这些网络训练。该基线方法在CIFAR-10的测试集上能够实现6%-7%的错误率。 正式确定并扩展了网络态射的工作(Chen et al。,2015; Wei et al。,2016; Cai et al。,2017),以提供流行的网络构建模块,例如跳过连接和批量规范化。 提出 Neural Architecture Search by Hillclimbing (NASH),该算法已在摘要中介绍。 2.相关工作 Hyperparameter optimization: random search (Bergstra & Bengio, 2012) Bayesian optimization (Bergstra et al., 2011; Snoek et al., 2012) bandit-based approaches (Li et al., 2016a) evolutionary strategies (Loshchilov & Hutter, 2016) Automated architecture search: (Bergstra et al., 2011; Mendoza et al., 2016)将架构搜索视为超参数搜索,使用标准的超参数优化算法来优化架构。 (Baker et al., 2016; Zoph & Le, 2017; Cai et al., 2017)三个方法都采用训练增强学习代理(reinforcement learning agent)的方式。 Baker et al. (2016)通过训练一个RL Agent来按顺序选择层类型(卷积,池化,全连接)和它们的参数。 Zoph & Le (2017)使用递归神经网络控制器来按顺序生成用于表示网络架构的字符串。 上述两个方法都是从头训练所生成的网络,并且耗时较长。为了解决这些问题,Cai et al. (2017)提出在RL中应用网络变换/态射的概念。 Real et al. (2017) 和 Suganuma et al. (2017)使用进化算法从小网络来迭代生成强有力的网络。诸如插入一层、修改一层的参数、增加跳跃连接都视为“突变”。其中前者使用大量的计算资源(250GPUs,10天),后者则由于处理大量网络而被限制在相对较小的网络上。前面两种算法中的网络容量会随时间不断增大,而, Saxena & Verbeek(2016)则是在一开始就训练一个大型的网络,然后在最后做剪枝。 Network morphism/ transformation.:这是Chen et al. (2015)在迁移学习基础上提出来的。作者介绍了一个函数保留操作,该函数可以使得网络更深("Net2Deeper")或者更宽("Net2Wider"),目的是加速培训和探索网络架构。Wei et al. (2016) 提出了其它的操作,如用于处理非幂等激活函数、改变内核大小,并引入网络态射概念。 3. 网络态射(Network Morphism) 令\(N(X)\)表示定义在\(X \subset{R^n}\)一组神经网络。网络态射是指从参数为\(w∈R^k\)的神经网络\(f^w∈N(x)\)映射为参数为\(\tilde{w}∈R^j\)的神经网络\(g^{\tilde{w}}∈N(x)\),即: \[f^w(x)=g^{\tilde{w}(x)} \, for \, every \, x ∈ X \tag{1}\] 下面会给出几个网络态射的例子以及用于构建神经网络的操作(如添加一个卷积层)是如何表示为网络态射的。为方便说明,令\(f_i^{w_i}(x)\)表示神经网络\(f^w(x)\)的某一个部分,如可能是某一层或者是子集网络。 3.1 Network morphism Type I 使用下式代替\(f_i^{w_i}(x)\) \[\tilde{f_i}^{\tilde{w}_i}(x)=Af_i^{w_i}(x)+b \tag{2}\] 其中\(\tilde{w}_i=(w_i,A,b)\)。显然当\(A=1,b=0\)时,公式(2)则退化成公式(1)。 这种态射可以用于添加全连接层或者卷积层,因为这些层都是简单的线性映射。Chen et al. (2015) 称这个态射为"Net2DeeperNet"。 除了上面的替换方式,也可以有 \[\tilde{f_i}^{\tilde{w}_i}(x)=C(Af_i^{w_i}(x)+b)+d \tag{3}\] 其中\(\tilde{w}_i=(w_i,C,d)\)。\(A,b\)是固定的,不可学习的。当\(C=A^{-1},d=-Cb\)时公式(3)变成了公式(1)。批标准化层(或者其他标准化层)可以用上面的表达式表示:\(A,b\)表示批量统计数据,\(C,d\)表示可学习的缩放和位移。 3.2 Network morphism Type II 假设\(f_i^{w_i}(x)=Ah^{w_h}(x)+b\),其中\(h\)为任意函数。 我们使用如下式子代替\(f_i^{w_i}(x)\): 其中\(\tilde{h}^{w_{\tilde{h}}} (x)\)是任意函数。新参数\(\tilde{w}_i=(w_i,w_{\tilde{h}},\tilde{A})\)。同理,当\(\tilde{A}=0\)时依然可以得到公式(1)。 公式(4)可以有两种对NN的修改方式: 1.加宽某一层,例如当\(\tilde{h}=h\)时,宽度加倍。 2.可以事先跳跃连接(skip connections)。例如假设\(h(x)\)表示一系列的网络层,即\(h(x)=h_n(x)◦···h_0(x)\),那么当\(\tilde{h}(x)=x\)时则实现了从\(h_0\)到\(h_n\)的跳跃连接。 3.3 Network morphism Type III 根据定义,每一个幂等函数\(f_i^{w_i}(x)\)都可以用下面的式子代替: \[f_i^{(w_i,\tilde{w}_i)}=f_i^{w_i}◦f_i^{\tilde{w}_i} \tag{5}\] 初始化\(\tilde{w}_i=w_i\)。 幂等(idempotent、idempotence)是一个数学与计算机学概念,常见于抽象代数中。 在编程中一个幂等操作的特点是其任意多次执行所产生的影响均与一次执行的影响相同。 例如f(f(x))=f(x),那么f(x)就是幂等函数。 3.4 Network morphism Type IV 使用下式代替\(f_i^{w_i}(x)\): \[ \tilde{f}_i^{\tilde{w}_i}(x)=λf_i^{w_i}(x)+(1-λ)h^{w_h}(x),\,\, \tilde{w}_i=(w_i,λ,w_h) \tag{6} \] \(h\)为任意函数。 这种态射可用于合并任何函数,尤其是任何非线性函数。 4. ARCHITECTURE SEARCH BY NETWORK MORPHISMS 1. 最开始使用一个小型的预训练模型 2. 将网络态射应用到该初始化网络中,经过训练后可以生成表现更加,更大的网络。所生成的网络可看作是“child”网络,初始网络可看作是“parent”网络。 3. 在上面步骤生成的子网络中找到表现最优秀的网络,然后在该网络上继续生成子网络,不断迭代优化。 以上方法即为 Neural Architecture Search by Hill-climbing (NASH) 下图展示了NASH的步骤: NASH的算法步骤如下: 在实现上图中的算法时,函数ApplyNetMorph(model, n)应用\(n\)个网络态射,每个都是从下面三种情况中均匀随机采样的: 使网络更深,即加上"Conv-Batchnorm-Relu"模块。模块所加的位置和kernel大小(\(∈{3,5}\))都是均匀采样的。通道的数量与前一个最近的卷积通道数相等。 使网络更宽,即通过使用 网络态射II增加通道数量。需要拓宽的卷积层和拓宽因子(\(∈{2,4}\))都是均匀采样的。 通过分别使用网络态射类型II或IV,添加从第i层到第j层的跳跃连接(通过 concatenation 或 addition - 均匀采样)。 层i和j也都是均匀地采样。 5. 实验与结果 具体的实验结果可查阅原论文 Simple And Efficient Architecture Search For Neural Networks。 MARSGGBO原创 2018-7-27

优秀的个人博客,低调大师

Java并发编程笔记之 CountDownLatch闭锁的源码分析

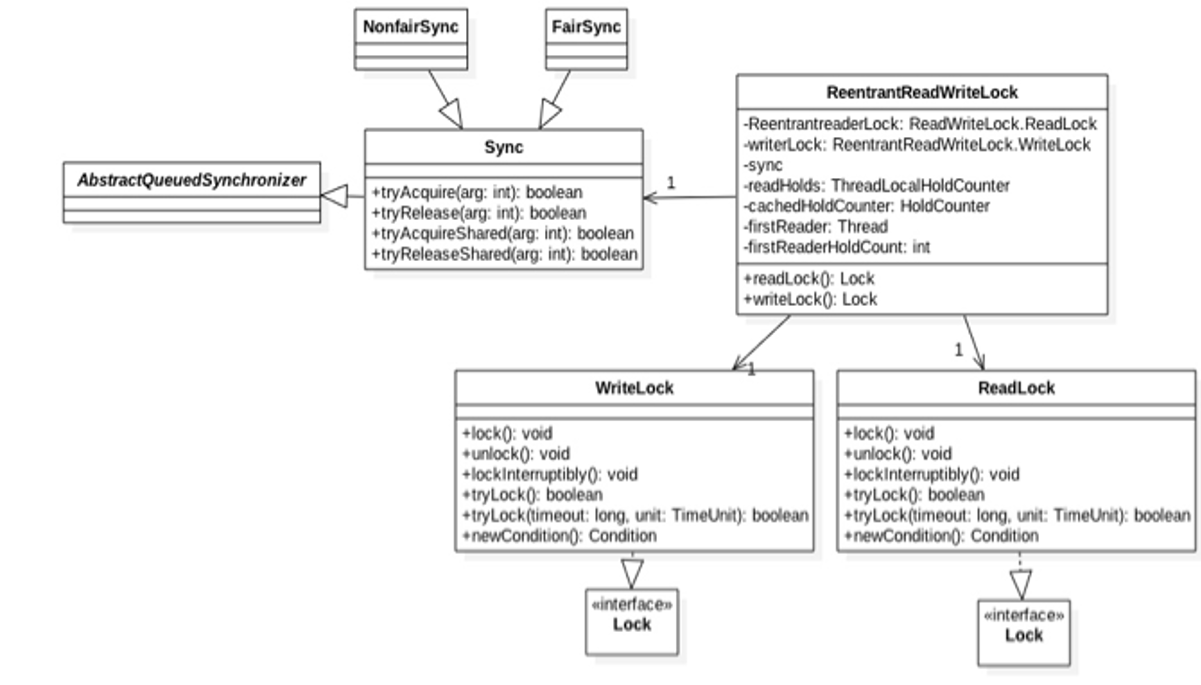
JUC 中倒数计数器 CountDownLatch 的使用与原理分析,当需要等待多个线程执行完毕后在做一件事情时候 CountDownLatch 是比调用线程的 join 方法更好的选择,CountDownLatch 与 线程的 join 方法区别是什么? 日常开发中经常会遇到需要在主线程中开启多线程去并行执行任务,并且主线程需要等待所有子线程执行完毕后再进行汇总的场景,它的内部提供了一个计数器,在构造闭锁时必须指定计数器的初始值,且计数器的初始值必须大于0。另外它还提供了一个countDown方法来操作计数器的值,每调用一次countDown方法计数器都会减1,直到计数器的值减为0时就代表条件已成熟,所有因调用await方法而阻塞的线程都会被唤醒。这就是CountDownLatch的内部机制,看起来很简单,无非就是阻塞一部分线程让其在达到某个条件之后再执行。但是CountDownLatch的应用场景却比较广泛,只要你脑洞够大利用它就可以玩出各种花样。最常见的一个应用场景是开启多个线程同时执行某个任务,等到所有任务都执行完再统计汇总结果。下图动态演示了闭锁阻塞线程的整个过程。 在CountDownLatch出现之前一般都是使用线程的join()方法来实现,但是join不够灵活,不能够满足不同场景的需求。接下来我们看看CountDownLatch的原理实现。 一.CountDownLatch原理探究 从CountDownLatch的名字可以猜测内部应该有个计数器,并且这个计数器是递减的,下面就通过源码看看JDK开发组是何时初始化计数器,何时递减的,计数器变为 0 的时候做了什么操作,多个线程是如何通过计时器值实现同步的,首先我们先看看CountDownLatch内部结构,类图如下: 从类图可以知道CountDownLatch内部还是使用AQS实现的,通过下面构造函数初始化计数器的值,可知实际上是把计数器的值赋值给了AQS的state,也就是这里AQS的状态值来表示计数器值。 构造函数源码如下: public CountDownLatch(int count) { if (count < 0) throw new IllegalArgumentException("count < 0"); this.sync = new Sync(count); } Sync(int count) { setState(count); } 接下来主要看一下CountDownLatch中几个重要的方法内部是如何调用AQS来实现功能的。 1.void await()方法,当前线程调用了CountDownLatch对象的await方法后,当前线程会被阻塞,直到下面的情况之一才会返回:(1)当所有线程都调用了CountDownLatch对象的countDown方法后, 也就是说计时器值为 0 的时候。(2)其他线程调用了当前线程的interrupt()方法中断了当前线程,当前线程会抛出InterruptedException异常后返回。接下来让我们看看await()方法内部是如何调用 AQS的方法的,源码如下: //CountDownLatch的await()方法 public void await() throws InterruptedException { sync.acquireSharedInterruptibly(1); } //AQS的获取共享资源时候可被中断的方法 public final void acquireSharedInterruptibly(int arg)throws InterruptedException { //如果线程被中断则抛异常 if (Thread.interrupted()) throw new InterruptedException(); //尝试看当前是否计数值为0,为0则直接返回,否者进入AQS的队列等待 if (tryAcquireShared(arg) < 0) doAcquireSharedInterruptibly(arg); } //sync类实现的AQS的接口 protected int tryAcquireShared(int acquires) { return (getState() == 0) ? 1 : -1; } 从上面代码可以看到await()方法委托sync调用了AQS的acquireSharedInterruptibly方法,该方法的特点是线程获取资源的时候可以被中断,并且获取到的资源是共享资源,这里为什么要调用AQS的这个方法,而不是调用独占锁的accquireInterruptibly方法呢?这是因为这里状态值需要的并不是非 0 即 1 的效果,而是和初始化时候指定的计数器值有关系,比如你初始化的时候计数器值为 8 ,那么state的值应该就有 0 到 8 的状态,而不是只有 0 和 1 的独占效果。 这里await()方法调用acquireSharedInterruptibly的时候传递的是 1 ,就是说明要获取一个资源,而这里计数器值是资源总数,也就是意味着是让总的资源数减 1 ,acquireSharedInterruptibly内部首先判断如果当前线程被中断了则抛出异常,否则调用sync实现的tryAcquireShared方法看当前状态值(计数器值)是否为 0 ,是则当前线程的await()方法直接返回,否则调用AQS的doAcquireSharedInterruptibly让当前线程阻塞。另外调用tryAcquireShared的方法仅仅是检查当前状态值是不是为 0 ,并没有调用CAS让当前状态值减去 1 。 2.boolean await(long timeout, TimeUnit unit),当线程调用了 CountDownLatch 对象的该方法后,当前线程会被阻塞,直到下面的情况之一发生才会返回: (1)当所有线程都调用了 CountDownLatch 对象的 countDown 方法后,也就是计时器值为 0 的时候,这时候返回 true; (2) 设置的 timeout 时间到了,因为超时而返回 false; (3)其它线程调用了当前线程的 interrupt()方法中断了当前线程,当前线程会抛出 InterruptedException 异常后返回。源码如下: public boolean await(long timeout, TimeUnit unit) throws InterruptedException { return sync.tryAcquireSharedNanos(1, unit.toNanos(timeout)); } 3.void countDown() 当前线程调用了该方法后,会递减计数器的值,递减后如果计数器为 0 则会唤醒所有调用await 方法而被阻塞的线程,否则什么都不做,接下来看一下countDown()方法内部是如何调用AQS的方法的,源码如下: //CountDownLatch的countDown()方法 public void countDown() { //委托sync调用AQS的方法 sync.releaseShared(1); } //AQS的方法 public final boolean releaseShared(int arg) { //调用sync实现的tryReleaseShared if (tryReleaseShared(arg)) { //AQS的释放资源方法 doReleaseShared(); return true; } return false; } 如上面代码可以知道CountDownLatch的countDown()方法是委托sync调用了AQS的releaseShared方法,后者调用了sync 实现的AQS的tryReleaseShared,源码如下: //syn的方法 protected boolean tryReleaseShared(int releases) { //循环进行cas,直到当前线程成功完成cas使计数值(状态值state)减一并更新到state for (;;) { int c = getState(); //如果当前状态值为0则直接返回(1) if (c == 0) return false; //CAS设置计数值减一(2) int nextc = c-1; if (compareAndSetState(c, nextc)) return nextc == 0; } } 如上代码可以看到首先获取当前状态值(计数器值),代码(1)如果当前状态值为 0 则直接返回 false ,则countDown()方法直接返回;否则执行代码(2)使用CAS设置计数器减一,CAS失败则循环重试,否则如果当前计数器为 0 则返回 true 。返回 true 后,说明当前线程是最后一个调用countDown()方法的线程,那么该线程除了让计数器减一外,还需要唤醒调用CountDownLatch的await 方法而被阻塞的线程。这里的代码(1)貌似是多余的,其实不然,之所以添加代码 (1) 是为了防止计数器值为 0 后,其他线程又调用了countDown方法,如果没有代码(1),状态值就会变成负数。 4.long getCount() 获取当前计数器的值,也就是 AQS 的 state 的值,一般在 debug 测试时候使用,源码如下: public long getCount() { return sync.getCount(); } int getCount() { return getState(); } 如上代码可知内部还是调用了 AQS 的 getState 方法来获取 state 的值(计数器当前值)。 到目前为止原理理解的差不多了,接下来用一个例子进行讲解CountDownLatch的用法,例子如下: package com.hjc; import java.util.concurrent.CountDownLatch; import java.util.concurrent.atomic.AtomicInteger; /** * Created by cong on 2018/7/6. */ public class CountDownLatchTest { private static AtomicInteger id = new AtomicInteger(); // 创建一个CountDownLatch实例,管理计数为ThreadNum private static volatile CountDownLatch countDownLatch = new CountDownLatch(3); public static void main(String[] args) throws InterruptedException { Thread threadOne = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(3000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println("【玩家" + id.getAndIncrement() + "】已入场"); countDownLatch.countDown(); } }); Thread threadTwo = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(2000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println("【玩家" + id.getAndIncrement() + "】已入场"); countDownLatch.countDown(); } }); Thread threadThree = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println("【玩家" + id.getAndIncrement() + "】已入场"); countDownLatch.countDown(); } }); // 启动子线程 threadOne.start(); threadTwo.start(); threadThree.start(); System.out.println("等待斗地主玩家进场"); // 等待子线程执行完毕,返回 countDownLatch.await(); System.out.println("斗地主玩家已经满人,开始发牌....."); } } 运行结果如下: 如上代码,创建了一个 CountDownLatch 实例,因为有两个子线程所以构造函数参数传递为 3,主线程调用 countDownLatch.await()方法后会被阻塞。子线程执行完毕后调用 countDownLatch.countDown() 方法让 countDownLatch 内部的计数器减一,等所有子线程执行完毕调用 countDown()后计数器会变为 0,这时候主线程的 await()才会返回。 如果把上面的代码中Thread.sleep和countDownLatch.await()的代码注释掉,运行几遍,运行结果就可能会出现如下结果,如下图: 可以看到在注释掉latch.await()这行之后,就不能保证在所有玩家入场后才开始发牌了。 总结:CountDownLatch 与 join 方法的区别,一个区别是调用一个子线程的 join()方法后,该线程会一直被阻塞直到该线程运行完毕,而 CountDownLatch 则使用计数器允许子线程运行完毕或者运行中时候递减计数,也就是 CountDownLatch 可以在子线程运行任何时候让 await 方法返回而不一定必须等到线程结束;另外使用线程池来管理线程时候一般都是直接添加 Runable 到线程池这时候就没有办法在调用线程的 join 方法了,countDownLatch 相比 Join 方法让我们对线程同步有更灵活的控制。

优秀的个人博客,低调大师

Java并发编程笔记之LongAdder和LongAccumulator源码探究

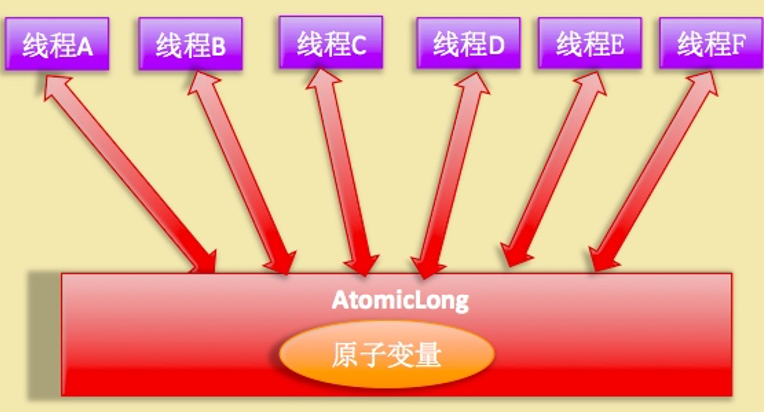
一.LongAdder原理 LongAdder类是JDK1.8新增的一个原子性操作类。AtomicLong通过CAS算法提供了非阻塞的原子性操作,相比受用阻塞算法的同步器来说性能已经很好了,但是JDK开发组并不满足于此,因为非常搞并发的请求下AtomicLong的性能是不能让人接受的。 如下AtomicLong 的incrementAndGet的代码,虽然AtomicLong使用CAS算法,但是CAS失败后还是通过无限循环的自旋锁不多的尝试,这就是高并发下CAS性能低下的原因所在。源码如下: public final long incrementAndGet() { for (;;) { long current = get(); long next = current + 1; if (compareAndSet(current, next)) return next; } } 在高并发下N多线程同时去操作一个变量会造成大量线程CAS失败,然后处于自旋状态,这样导致大大浪费CPU资源,降低了并发性。 既然AtomicLong性能问题是由于过多线程同时去竞争同一个变量的更新而降低的,那么如果把一个变量分解为多个变量,让同样多的线程去竞争多个资源,那么性能问题不久迎刃而解了吗? 没错,因此,JDK8 提供的LongAdder就是这个思路。下面通过图形来标示两者的不同,如下图: 如上图 AtomicLong 是多个线程同时竞争同一个变量情景。 如上图所示,LongAdder则是内部维护多个Cell变量,每个Cell里面有一个初始值为0的long型变量,在同等并发量的情况下,争夺单个变量的线程会减少,这是变相的减少了争夺共享资源的并发量,另外多个线程在争夺同一个原子变量时候, 如果失败并不是自旋CAS重试,而是尝试获取其他原子变量的锁,最后当获取当前值时候是把所有变量的值累加后再加上base的值返回的。 LongAdder维护了要给延迟初始化的原子性更新数组和一个基值变量base数组的大小保持是2的N次方大小,数组表的下标使用每个线程的hashcode值的掩码表示,数组里面的变量实体是Cell类型。 Cell 类型是Atomic的一个改进,用来减少缓存的争用,对于大多数原子操作字节填充是浪费的,因为原子操作都是无规律的分散在内存中进行的,多个原子性操作彼此之间是没有接触的,但是原子性数组元素彼此相邻存放将能经常共享缓存行,也就是伪共享。所以这在性能上是一个提升。 另外由于Cells占用内存是相对比较大的,所以一开始并不创建,而是在需要时候再创建,也就是惰性加载,当一开始没有空间时候,所有的更新都是操作base变量。 接下来进行LongAdder代码简单分析 这里我只是简单的介绍一下代码的实现,详细实现,大家可以翻看代码去研究。为了降低高并发下多线程对一个变量CAS争夺失败后大量线程会自旋而造成降低并发性能问题,LongAdder内部通过根据并发请求量来维护多个Cell元素(一个动态的Cell数组)来分担对单个变量进行争夺资源。 首先我们先看LongAdder的构造类图,如下图: 可以看到LongAdder继承自Striped64类,Striped64内部维护着三个变量,LongAdder的真实值其实就是base的值与Cell数组里面所有Cell元素值的累加,base是个基础值,默认是0,cellBusy用来实现自旋锁,当创建Cell元素或者扩容Cell数组时候用来进行线程间的同步。 接下来进去源码如看Cell的构造,源码如下: @sun.misc.Contended static final class Cell { volatile long value; Cell(long x) { value = x; } final boolean cas(long cmp, long val) { return UNSAFE.compareAndSwapLong(this, valueOffset, cmp, val); } // Unsafe 技术 private static final sun.misc.Unsafe UNSAFE; private static final long valueOffset; static { try { UNSAFE = sun.misc.Unsafe.getUnsafe(); Class<?> ak = Cell.class; valueOffset = UNSAFE.objectFieldOffset (ak.getDeclaredField("value")); } catch (Exception e) { throw new Error(e); } } } 正如上面的代码可以知道Cell的构造很简单,内部维护一个声明volatile的变量,这里声明为volatile是因为线程操作value变量时候没有使用锁,为了保证变量的内存可见性这里只有声明为volatile。另外这里就是先前文件所说的使用Unsafe类的方法来设置value的值 接下来进入LongAdder的源码里面去看几个重要的方法,如下: 1.long sum() 方法:返回当前的值,内部操作是累加所有 Cell 内部的 value 的值后累加 base,如下代码,由于计算总和时候没有对 Cell 数组进行加锁,所以在累加过程中可能有其它线程对 Cell 中的值进行了修改,也有可能数组进行了扩容,所以 sum 返回的值并不是非常精确的, 返回值并不是一个调用 sum 方法时候的一个原子快照值。 源码如下: public long sum() { Cell[] as = cells; Cell a; long sum = base; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) sum += a.value; } } return sum; } 2.void reset() 方法:重置操作,如下代码把 base 置为 0,如果 Cell 数组有元素,则元素值重置为 0。源码如下: public void reset() { Cell[] as = cells; Cell a; base = 0L; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) a.value = 0L; } } } 3.long sumThenReset() 方法:是sum 的改造版本,如下代码,在计算 sum 累加对应的 cell 值后,把当前 cell 的值重置为 0,base 重置为 0。 当多线程调用该方法时候会有问题,比如考虑第一个调用线程会清空 Cell 的值,后一个线程调用时候累加时候累加的都是 0 值。 源码如下: public long sumThenReset() { Cell[] as = cells; Cell a; long sum = base; base = 0L; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) { sum += a.value; a.value = 0L; } } } return sum; } 4.long longValue() 等价于 sum(),源码如下: public long longValue() { return this.sum(); } 5.void add(long x) 累加增量 x 到原子变量,这个过程是原子性的。源码如下: public void add(long x) { Cell[] as; long b, v; int m; Cell a; if ((as = cells) != null || !casBase(b = base, b + x)) {//(1) boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 ||//(2) (a = as[getProbe() & m]) == null ||//(3) !(uncontended = a.cas(v = a.value, v + x)))//(4) longAccumulate(x, null, uncontended);//(5) } } final boolean casBase(long cmp, long val) { return UNSAFE.compareAndSwapLong(this, BASE, cmp, val); } 可以看到上面代码,当第一个线程A执行add时候,代码(1)会执行casBase方法,通过CAS设置base为 X, 如果成功则直接返回,这时候base的值为1。 假如多个线程同时执行add时候,同时执行到casBase则只有一个线程A成功返回,其他线程由于CAS失败执行代码(2),代码(2)是获取cells数组的长度,如果数组长度为0,则执行代码(5),否则cells长度不为0,说明cells数组有元素则执行代码(3), 代码(3)首先计算当前线程在数组中下标,然后获取当前线程对应的cell值,如果获取到则执行(4)进行CAS操作,CAS失败则执行代码(5)。 代码(5)里面是具体进行数组扩充和初始化,这个代码比较复杂,这里就不讲解了,有兴趣的可以进去看看。 二.LongAccumulator类源码分析 LongAdder类是LongAccumulator的一个特例,LongAccumulator提供了比LongAdder更强大的功能,如下构造函数,其中accumulatorFunction是一个双目运算器接口,根据输入的两个参数返回一个计算值,identity则是LongAccumulator累加器的初始值。 public LongAccumulator(LongBinaryOperator accumulatorFunction,long identity) { this.function = accumulatorFunction; base = this.identity = identity; } public interface LongBinaryOperator { //根据两个参数计算返回一个值 long applyAsLong(long left, long right); } 上面提到LongAdder 其实就是LongAccumulator 的一个特例,调用LongAdder 相当使用下面的方式调用 LongAccumulator。 LongAdder adder = new LongAdder(); LongAccumulator accumulator = new LongAccumulator(new LongBinaryOperator() { @Override public long applyAsLong(long left, long right) { return left + right; } }, 0); LongAccumulator相比LongAdder 可以提供累加器初始非0值,后者只能默认为0,另外前者还可以指定累加规则,比如不是累加而相乘,只需要构造LongAccumulator 时候传入自定义双目运算器即可,后者则内置累加规则。 从下面代码知道LongAccumulator相比于LongAdde的不同在于casBase的时候,后者传递的是b+x,而前者则是调用了r=function.applyAsLong(b=base.x)来计算。 LongAdder类的add源码如下: public void add(long x) { Cell[] as; long b, v; int m; Cell a; if ((as = cells) != null || !casBase(b = base, b + x)) { boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[getProbe() & m]) == null || !(uncontended = a.cas(v = a.value, v + x))) longAccumulate(x, null, uncontended); } } LongAccumulator的accumulate方法的源码如下: public void accumulate(long x) { Cell[] as; long b, v, r; int m; Cell a; if ((as = cells) != null || (r = function.applyAsLong(b = base, x)) != b && !casBase(b, r)) { boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[getProbe() & m]) == null || !(uncontended = (r = function.applyAsLong(v = a.value, x)) == v || a.cas(v, r))) longAccumulate(x, function, uncontended); } } 另外LongAccumulator调用longAccumulate时候传递的是function,而LongAdder是null,从下面代码可以知道当fn为null,时候就是使用v+x 加法运算,这时候就等价于LongAdder,fn不为null的时候则使用传递的fn函数计算,如果fn为加法则等价于LongAdder; else if (casBase(v = base, ((fn == null) ? v + x :fn.applyAsLong(v, x)))) // Fall back on using basebreak;

优秀的个人博客,低调大师

《第一本Docker书》(学习笔记一)

1、简介、安装、入门、镜像与仓库、构建服务、fig配置docker、使用docker api 2 docker核心组件:docker客户端和服务器、docker镜像、registry、docker容器 3 docker架构: docker不支持32位 linux3.8以上内核 内核必须支持cgroup和命名空间功能 1、uname -a 检查安装device-mapper modprobe dm_mod yum install -y docker 启动:dockerd & 获取docker信息:docker info 搜索容器:docker search centos 容器安装: docker run -i -t centos /bin/bash #i开启标准化输入 t开启tty docker run -i -t docker.io/centos /bin/bash 查看正在运行的容器:docker ps 查看所有容器:docker ps -a 安装带名字的容器: docker run --name centostest -i -t centos /bin/bash 删除容器: docker rm wonderful_blackwell 启动容器:docker start centostest 付着到容器:docker attach centostest 创建守护进程容器:docker run --name centos1 -d centos /bin/sh 查看日志:docker logs centostest docker logs --tail 10 -t centostest #获取最后10行日志,带时间 查看容器内的进程:docker top centostest 启动交互式进程: docker exec -t -i centostest /bin/bash 在容器内运行一个新的后台进程:docker exec -d centostest touch /xxx 重启容器:docker run --restart=always --name centostest -d centos /bin/sh --restart=on-failure --restart=on-failure:5 #最多重启5次 获得容器的详细信息:docker inspect centostest docker镜像: docker images 列出镜像 docker pull centos:laste 提交自己创建的镜像: docker commit -m="xxxx" --author="xxx" idxjljldkjf name/name:biaoqian 查看镜像的每一层: docker history centostest 指定端口映射: docker run -d -p 80:80 --name mynginx xxx/xxx docker run -d -P --name mynginx xxx/xxxx #公开所有端口 CMD ["/bin/bash","-l"] 运行时覆盖工作目录:docker run -ti -w /var/log xxx pwd USER nginx USER www:www 添加卷: VOLUME ["/opt/project","/data"] ADD有解压,COPY没有解压 docker push xxxxx/xxxx docker rmi xx/xx 运行自己的registry docker run -p 5000:5000 registry 传容器到自己的镜像: docker tag xxx docker.image.com:5000/xxx/xxx docker push docker.image.com:5000/xx/xxx docker run -t -i docker.image.com:5000/xxx/xx

优秀的个人博客,低调大师

java并发编程笔记--volatile与synchronized关键字

合理使用并发 单线程程序并不一定比多线程程序性能差 1) 当任务较轻,执行任务的消耗没有开启多线程消耗多时;2) 当上下文切换带来的消耗较高时;3) 当多线程的同步处理代价过大时; 并发的优势 1) 提高系统的吞吐率:能够合理的利用IO等待时间等情况;2) 提高响应性:防止因为处理业务等待导致响应时间过长;3) 充分利用多核CPU资源:单线程程序对多核CPU使用效率不高;4) 最小化系统资源的使用:线程共享资源,避免了多进程造成的资源浪费;5) 简化程序结构:现实世界是并行的,多线程能够更容易的表达现实世界; 如何减少上下文切换? 1) 无锁并发编程:不同的线程尽可能减少共享数据的范围,或者不共享数据;对于共享数据,可以考虑将数据分片,操作时,不同的线程访问不同的分片,从而减小数据共享范围;2) CAS算法:使用CAS算法,通过乐观锁代替悲观锁,减少不必要的锁;3) 最少线程:线程并非越多越好,使用合适的线程数,避免产生大量的上下文切换;4) 协程:在单个线程中实现多任务调度,并在单个线程里维护多个任务间的切换; 如何避免死锁? 1) 避免一个线程同时获取多个锁;2) 避免一个线程在锁内同时占用多个资源,尽量保证一个锁只占用一个资源;3) 使用定时锁tryLock代替内部锁机制,通过锁超时打破死锁;4) 对于数据库锁,加锁和解决应该放在一个会话(连接)中; volatile关键字 核心功能 1) 保证内存可见性:一个线程对一个被volatile修饰的变量值的更改,对于后面要访问该变量的线程总是可见的;2) 禁止指令重排序:禁止编译器和CPU进行指令重排序; cpu术语 lock指令 1)当volatile修饰的共享变量进行写操作时,会多出一条lock指令;2)lock指令的功能如下: a) 将当前处理器缓存行中的数据写回到系统内存; b) 写回内存操作会使其它CPU里缓存了该内存地址的数据无效; 3)lock指令会被翻译称为LOCK#信号;LOCK#信号的功能用于保证处理器声言该信号时,保证cpu操作的数据对其它cpu可见;通常有如下两种实现: a) 锁定总线:保持在处理器声言该信号时,能够独占内存;锁住总线,导致其它处理器不能访问总线,即其它处理器此时不可以访问内存;但锁定总线开销较大; b) 锁定缓存:锁定当前处理器处理数据对应的高速缓存行,并回写数据到内存;通过处理器的缓存一致性协议来通知其它cpu数据发生变更;该实现相比而言开销较小;且由于缓存一致性协议的限制,不会出现同一时间多个cpu都更新同一数据的情况; 缓存一致性协议 1) cpu实现了缓存一致性协议,每个处理器通过嗅探在总线上传播的数据来检查自己缓存的值是不是过期了,当处理器发现自己缓存行对应的内存地址被修改,就会将当前处理器的缓存行设置成无效状态,当处理器对这个数据进行修改操作时,会重新从系统内存中把数据读到处理器缓存里;2) 缓存一致性协议会阻止同时修改两个以上的处理器缓存的内存数据区域; 编程技巧:通过追加字节,提高性能 1)LinkedTransferQueue中,链表中的节点,通过定义无用的引用,将节点占用内存追加到64字节,从而保证处理器每次读取缓存行时,都只能读取一个节点的数据,避免了多个处理器同时访问相同缓存行的情况;2)如果不追加字节,则处理器每次固定读取64个字节的数据,有可能将队列的头结点和尾节点放入同一个缓存行,导致其它处理器无法同时访问同一缓存行,降低性能;3)适用场景: a) cpu字节宽度为64字节; b) 共享变量被频繁写; Synchronized关键字 核心功能 1)实现操作的原子性:通过关键字设定临界区,保证同一时间仅有一个线程可以进入临界区;2)保证内存的可见性:一个线程执行临界区的代码对数据的修改,对后面进入临界区的线程可见; 实现基础 1)Java中的每一个对象都可以作为锁;表现如下: a) 普通同步方法(对象方法):当前对象; b) 静态同步方法(类方法):当前类的类对象; c) 同步方法块:括号中匹配的对象;2)JVM通过进入和退出Monitor对象来实现方法同步和代码块同步;两者实现细节不同; 3)同步代码块:通过monitorenter和monitorexit指令实现;monitorenter指令是在编译后插入到同步代码块开始位置;monitorexit插入到方法结束处和异常处;JVM保证每个monitorenter指令都有与之对应的monitorexit指令;任何对象都有一个monitor对象与之关联,当monitor被持有后,即处于锁定状态;执行monitorenter指令时,会尝试获取对象对应的monitor的所有权,即尝试获取对象的锁;4)synchronized方法:则会被翻译成普通的方法调用和返回指令如:invokevirtual、areturn指令,在JVM字节码层面并没有任何特别的指令来实现被synchronized修饰的方法,而是在Class文件的方法表中将该方法的access_flags字段中的synchronized标志置为1,表示该方法是同步方法并使用调用该方法的对象或该方法所属的Class在JVM的内部对象表示Klass做为锁对象。 Java对象头 Synchronized的锁存放在Java对象头中;如果对象是数组类型,则对象头占3个字,否则占两个字;例如:32位JVM中,一个字为4个字节,则数组类型的对象头占用12个字节,非数组类型的对象头占用8个字节; 对象头存储结构 Mark Word存储结构 Mark Work中的数据会随着对象锁标志位的变化而变化; 32位JVM 问题1:当有锁状态时,原先的hashcode和分代年龄存放何处?是否是在解锁之后重新计算? 加锁时,线程将对象Mark Word存放到线程栈桢中的存储空间,称为:Displaced Mark Word;解锁时,通过持有锁线程栈桢中存放的Mark Word替换回来; 问题2:轻量级锁和重量级锁存放指针的长度仅有30位,指针通常不是有32位,如何存放? 详见monitor record结构,8byte对齐,最低三位可作为状态位; 64位JVM Monitor Record Monitor Record是线程私有的数据结构,每一个线程都有一个可用monitor record列表,同时还有一个全局的可用列表;那么这些monitor record有什么用呢?每一个被锁住的对象都会和一个monitor record关联(对象头中的LockWord指向monitor record的起始地址,由于这个地址是8byte对齐的所以LockWord的最低三位可以用来作为状态位),同时monitor record中有一个Owner字段存放拥有该锁的线程的唯一标识,表示该锁被这个线程占用。 1)Owner:初始时为NULL表示当前没有任何线程拥有该monitor record,当线程成功拥有该锁后保存线程唯一标识,当锁被释放时又设置为NULL;2)EntryQ:关联一个系统互斥锁(semaphore),阻塞所有试图锁住monitor record失败的线程;3)RcThis:表示blocked或waiting在该monitor record上的所有线程的个数;4)Nest:用来实现重入锁的计数;5)HashCode:保存从对象头拷贝过来的HashCode值(可能还包含GC age);6)Candidate:用来避免不必要的阻塞或等待线程唤醒,因为每一次只有一个线程能够成功拥有锁,如果每次前一个释放锁的线程唤醒所有正在阻塞或等待的线程,会引起不必要的上下文切换(从阻塞到就绪然后因为竞争锁失败又被阻塞)从而导致性能严重下降。Candidate只有两种可能的值:0表示没有需要唤醒的线程,1表示要唤醒一个继任线程来竞争锁; 锁升级 在JVM中monitorenter和monitorexit字节码依赖于底层的操作系统的Mutex Lock来实现的,但是由于使用Mutex Lock需要将当前线程挂起并从用户态切换到内核态来执行,这种切换的代价是非常昂贵的。在java 1.6中,为了减少使用重量级锁(互斥锁)带来的性能消耗,引入了引入了大量的优化,如锁粗化(Lock Coarsening)、锁消除(Lock Elimination)、轻量级锁(Lightweight Locking)、偏向锁(Biased Locking)、适应性自旋(Adaptive Spinning)等技术来减少锁操作的开销。 1) 锁粗化(Lock Coarsening):减少不必要的紧连在一起的unlock,lock操作,将多个连续的锁扩展成一个范围更大的锁;2) 锁消除(Lock Elimination):通过运行时JIT编译器的逃逸分析来消除一些没有在当前同步块以外被其他线程共享的数据的锁保护,通过逃逸分析也可以在线程本地Stack上进行对象空间的分配(同时还可以减少Heap上的垃圾收集开销);3) 轻量级锁(Lightweight Locking):这种锁实现的背后基于这样一种假设,即在真实的情况下我们程序中的大部分同步代码一般都处于无锁竞争状态(即单线程执行环境),在无锁竞争的情况下完全可以避免调用操作系统层面的重量级互斥锁,取而代之的是在monitorenter和monitorexit中只需要依靠一条CAS原子指令就可以完成锁的获取及释放。当存在锁竞争的情况下,执行CAS指令失败的线程将调用操作系统互斥锁进入到阻塞状态,当锁被释放的时候被唤醒(具体处理步骤下面详细讨论)。4) 偏向锁(Biased Locking):是为了在无锁竞争的情况下避免在锁获取过程中执行不必要的CAS原子指令,因为CAS原子指令虽然相对于重量级锁来说开销比较小但还是存在非常可观的本地延迟(可参考这篇文章)。5) 适应性自旋(Adaptive Spinning):当线程在获取轻量级锁的过程中执行CAS操作失败时,在进入与monitor相关联的操作系统重量级锁(mutex semaphore)前会进入忙等待(Spinning)然后再次尝试,当尝试一定的次数后如果仍然没有成功则调用与该monitor关联的semaphore(即互斥锁)进入到阻塞状态。 问题:如何理解用户态和内核态? 概念:用户态,普通线程执行时,所处的状态;内核态,当需要调用系统内核资源时,进程需要由用户态切换成内核态;转换条件:系统调用,主动,比如fork调用;异常,被动,执行程序时,遇到不可知异常;外围设备中断,被动,cpu需要暂停当前任务,执行中断处理程序; JVM使用锁标志位标志对象的锁状态;状态值依次是:无锁状态、偏向锁状态、轻量级锁状态、重量级锁状态;这几个状态会随着竞争的加剧而主键升级;当升级值重量级锁状态时,将不会降级; 偏向锁 1) 问题:大多数情况下,锁不仅不存在竞争,而且总是由同一线程多次获得;2) 目的:减少同一线程获取锁和释放锁带来的性能消耗;3) 原理:在Mark Word中记录持有偏向锁的线程ID,当线程尝试获取锁时,检查Mark Word中存放的线程ID是否是当前线程,如果是,则表示直接获取锁,无须进行CAS操作来加锁、解锁;4) 加锁:即线程进入synchronized同步代码,但此时并没有线程与之竞争,则默认使用偏向锁;5) 撤销:当线程出现竞争时,偏向锁会撤销,此时对象为无锁状态或者转而使用更加”严格”的锁机制;撤销需要等待全局安全点(即这个时间点没有执行字节码);6) 解锁:偏向锁解锁过程很简单,只需要测试下是否Object上的偏向锁模式是否还存在,如果存在则解锁成功不需要任何其他额外的操作; 问题:epoch是什么? 轻量级锁 1)加锁:在执行同步代码之前,JVM会在当前线程的栈桢中创建用于存储锁记录的空间,并将对象头中的Mark Word复制到所记录中,然后线程尝试使用CAS将对象头中的Mark Word替换为指向所记录的指针;如果成功,则当前线程获得锁;失败,则表示存在竞争,当前线程尝试使用自旋的方式获取锁;2)解锁:使用CAS操作,将线程栈桢中存放的Mark Word替换回对象头中;如果失败,则表示存在竞争,锁会膨胀为重量级锁; 问题:偏向锁如何变为轻量级锁? 1)初始时对象处于biasable状态,并且ThreadID为0即biasable & unbiased状态(这里不讨论epoch和age);2)当一个线程试图锁住一个处于biasable & unbiased状态的对象时,通过一个CAS将自己的ThreadID放置到Mark Word中相应的位置,如果CAS操作成功进入第(3)步否则进入(4)步;3)当进入到这一步时代表当前没有锁竞争,Object继续保持biasable状态,但是这时ThreadID字段被设置成了偏向锁所有者的ID,然后进入到第(6)步;4)当前线程执行CAS获取偏向锁失败(这一步是偏向锁的关键),表示在该锁对象上存在竞争并且这个时候另外一个线程获得偏向锁所有权。当到达全局安全点(safepoint)时获得偏向锁的线程被挂起,并从偏向锁所有者的私有Monitor Record列表中获取一个空闲的记录,并将Object设置为LightWeight Lock状态并且Mark Word中的LockRecord指向刚才持有偏向锁线程的Monitor record,最后被阻塞在安全点的线程被释放,进入到轻量级锁的执行路径中,同时被撤销偏向锁的线程继续往下执行同步代码;5)当一个线程试图锁住一个处于biasable & biased并且ThreadID不等于自己的ID时,这时由于存在锁竞争必须进入到第(4)步来撤销偏向锁;6)运行同步代码块; 重量级锁 1) 重量级锁,即为所有线程都会阻塞等待,直到持有锁的线程释放锁后,才进行新一轮的竞争;2) 因为自旋锁会消耗CPU,为了避免无用的消耗,锁升级重量级锁后,就无法降级为轻量级锁;此时,未持有锁的线程在尝试获取锁时,都会进入阻塞状态,等到锁释放后才会被唤醒,进行新一轮的争夺; 锁升级过程 问题:重量级锁解锁后,对象是否还能够回到偏向锁状态? 锁的优缺点 原子操作实现原理 cpu术语 处理器如何实现原子操作 1) 处理器保证从内存中读写一个字节是原子的,当一个处理器访问一个字节时,其余处理器不能够访问这个字节的内存地址;2) 多处理器的原子操作,通过对缓存加锁或者总线加锁来保证;3) 访问跨缓存行、跨总线宽度、跨页表访问的原子操作,通过对缓存加锁或者总线加锁来保证; Java如何实现原子操作 1) Java通过锁机制和循环CAS方式实现原子操作;2) CAS操作使用处理器提供的CMPXCHG指令实现;3) CAS实现原子操作的缺点: a) ABA问题:通过引入版本号来解决; b) 自旋带来的CPU消耗; c) 只能保证一个共享变量的原子操作:多个对象放入到一个对象中操作;比如:AtomicReference类;4) 锁机制:除偏向锁外,其余锁都通过CAS+自旋来加锁和解锁; 运维经验 1) 通过jstack分析jvm中线程的运行状态,查看是否有死锁(BLOCKED)或者大量等待(WAITING)线程; 参考 Java Synchronized Mark WordJVM内部细节之一:synchronized关键字及实现细节(轻量级锁Lightweight Locking)JVM内部细节之二:偏向锁(Biased LockingJava 轻量级锁原理详解(Lightweight Locking)Linux用户态和内核态

优秀的个人博客,低调大师

jQuery学习笔记--效果,操作html元素,遍历DOM树

参考W3school: http://www.w3school.com.cn/jquery/jquery_hide_show.asp jQuery效果: 隐藏: 基础语句: $(selector).hide(speed,callback); 可选的 speed 参数规定隐藏/显示的速度,可以取以下值:”slow”、”fast” 或毫秒。 可选的 callback 参数是隐藏或显示完成后所执行的函数名称。 实现:单击p标签的文字 文字消失 <script> $(document).ready(function(){ $("p").click(function(){ $(this).hide(); }); }); </script> 实现:单击button按钮 文字在2秒内消失 <script type="text/javascript"> $(document).ready(function(){ $("button").click(function(){ $("p").hide(2000); }); }); </script> 实现:单击按钮 包含按钮的div缓慢隐藏 <!DOCTYPE html> <html> <head> <script src="/jquery/jquery-1.11.1.min.js"></script> <script type="text/javascript"> $(document).ready(function(){ $(".ex .hide").click(function(){ $(this).parents(".ex").hide("slow"); }); }); </script> <style type="text/css"> div.ex { background-color:#e5eecc; padding:7px; border:solid 1px #c3c3c3; } </style> </head> <body> <div class="ex"> <button class="hide" type="button">隐藏</button> <p>大家好<br /> 我是小莫<br /> 哈哈</p> </div> </body> </html> 注意: parents(“.ex”)父亲节点中class为ex的元素 div.ex表示 又是div又是class为ex的元素 div .ex则表示 div中 class为ex的元素 区别 中间空格 而#ex则表示id为ex的元素 $(“.ex .hide”)表示class为ex元素中的class为hide的元素 hide(“slow”)是缓慢消失的意思 显示: 基础语句: $(selector).show(speed,callback); 可选的 speed 参数规定隐藏/显示的速度,可以取以下值:”slow”、”fast” 或毫秒。 可选的 callback 参数是隐藏或显示完成后所执行的函数名称。 实现:单击id为show的元素时候p文本文件显示 <script type="text/javascript"> $(document).ready(function(){ $("#show").click(function(){ $("p").show(); }); }); </script> 那有没有方法实现hide和show转换的呢? 有,还真有 那就是toggle()函数: 显示被隐藏的元素,并隐藏已显示的元素: 语法: $(selector).toggle(speed,callback); 可选的 speed 参数规定隐藏/显示的速度,可以取以下值:”slow”、”fast” 或毫秒。 可选的 callback 参数是 toggle() 方法完成后所执行的函数名称。 <script type="text/javascript"> $(document).ready(function(){ $("button").click(function(){ $("p").toggle(); }); }); </script> 淡入淡出: 淡入: 实现:单击按钮 id为div1的淡入 id为div2缓慢淡入 id为div3 3秒内淡入 前提三个div中style:display:none fadeIn() <script> $(document).ready(function(){ $("button").click(function(){ $("#div1").fadeIn(); $("#div2").fadeIn("slow"); $("#div3").fadeIn(3000); }); }); </script> 淡出: fadeOut()类似fadeIn() <script type="text/javascript"> $(document).ready(function(){ $("button").click(function(){ $("#div1").fadeOut(); $("#div2").fadeOut("slow"); $("#div3").fadeOut(3000); }); }); </script> 转换淡入淡出: fadeToggle()类似于上文的toggle() <script> $(document).ready(function(){ $("button").click(function(){ $("#div1").fadeToggle(); $("#div2").fadeToggle("slow"); $("#div3").fadeToggle(3000); }); }); </script> 可以指定淡出的透明度: fadeTo(速度,透明度); <script> $(document).ready(function(){ $("button").click(function(){ $("#div1").fadeTo("slow",0.1); $("#div2").fadeTo("slow",0.4); $("#div3").fadeTo("slow",0.7); }); }); </script> 总结: 通过 jQuery,您可以实现元素的淡入淡出效果。 jQuery 拥有下面四种 fade 方法: fadeIn() 淡入 fadeOut() 淡出 fadeToggle() 转换淡入淡出 fadeTo() 指定淡出透明度 jQuery fadeToggle() 方法可以在 fadeIn() 与 fadeOut() 方法之间进行切换。 如果元素已淡出,则 fadeToggle() 会向元素添加淡入效果。 如果元素已淡入,则 fadeToggle() 会向元素添加淡出效果。 语法: $(selector).fadeIn(speed,callback); $(selector).fadeOut(speed,callback); $(selector).fadeToggle(speed,callback); 可选的 speed 参数规定效果的时长。它可以取以下值:”slow”、”fast” 或毫秒。 可选的 callback 参数是 fading 完成后所执行的函数名称。 fadeTo有点不同: $(selector).fadeTo(speed,opacity,callback); fadeTo() 方法中必需的 opacity 参数将淡入淡出效果设置为给定的不透明度(值介于 0 与 1 之间)。 滑动: jQuery 拥有以下滑动方法: slideDown() slideUp() slideToggle() slideDown() 向下滑动显示: div.panel { height:120px; display:none; } <script type="text/javascript"> $(document).ready(function(){ $(".flip").click(function(){ $(".panel").slideDown("slow"); }); }); </script> slideUp() 向上滑动隐藏 div.panel { height:120px; } <script type="text/javascript"> $(document).ready(function(){ $(".flip").click(function(){ $(".panel").slideUp("slow"); }); }); </script> 转换滑动方向也相当于 转换显示和隐藏 slideToggle() 如果元素向下滑动,则 slideToggle() 可向上滑动它们。 如果元素向上滑动,则 slideToggle() 可向下滑动它们。 div.panel { height:120px; display:none; } <script type="text/javascript"> $(document).ready(function(){ $(".flip").click(function(){ $(".panel").slideToggle("slow"); }); }); </script> 语法: $(selector).slideDown(speed,callback); (selector).slideUp(speed,callback);(selector).slideUp(speed,callback);(selector).slideToggle(speed,callback); 可选的 speed 参数规定效果的时长。它可以取以下值:”slow”、”fast” 或毫秒。 可选的 callback 参数是滑动完成后所执行的函数名称。 动画: animate() 方法用于创建自定义动画 语法: $(selector).animate({params},speed,callback); 必需的 params 参数定义形成动画的 CSS 属性。 可选的 speed 参数规定效果的时长。它可以取以下值:”slow”、”fast” 或毫秒。 可选的 callback 参数是动画完成后所执行的函数名称。 单击按钮 div元素移动到离左端100px的地方 <script> $(document).ready(function(){ $("button").click(function(){ $("div").animate({left:'100px'}); }); }); </script> <div style="background:#98bf21;height:100px;width:100px;position:absolute;"> 也可以操作多个属性: {params}中有多个属性 里面是最终的状态 举个栗子: 离左端250px 透明度50% 高度150px 宽150px <script> $(document).ready(function(){ $("button").click(function(){ $("div").animate({ left:'250px', opacity:'0.5', height:'150px', width:'150px' }); }); }); </script> 可以使用相对值: <script> $(document).ready(function(){ $("button").click(function(){ $("div").animate({ left:'250px', height:'+=150px', width:'+=150px' }); }); }); </script> 使用预定义的值: 把属性的动画值设置为 “show”、”hide” 或 “toggle” 高度显示和隐藏通过按钮转换 <script> $(document).ready(function(){ $("button").click(function(){ $("div").animate({ height:'toggle' }); }); }); </script> 队列功能: 依次执行animate <script> $(document).ready(function(){ $("button").click(function(){ var div=$("div"); div.animate({height:'300px',opacity:'0.4'},"slow"); div.animate({width:'300px',opacity:'0.8'},"slow"); div.animate({height:'100px',opacity:'0.4'},"slow"); div.animate({width:'100px',opacity:'0.8'},"slow"); }); }); </script> 总结: 默认情况下,所有 HTML 元素的位置都是静态的,并且无法移动。如需对位置进行操作,记得首先把元素的 CSS position 属性设置为 relative、fixed 或 absolute。 注意: 提示:可以用 animate() 方法来操作所有 CSS 属性吗? 是的,几乎可以!不过,需要记住一件重要的事情:当使用 animate() 时,必须使用 Camel 标记法书写所有的属性名,比如,必须使用 paddingLeft 而不是 padding-left,使用 marginRight 而不是 margin-right,等等。 同时,色彩动画并不包含在核心 jQuery 库中。 如果需要生成颜色动画,您需要从 jQuery.com 下载 Color Animations 插件。 stop() stop() 方法用于停止动画或效果,在它们完成之前。 stop() 方法适用于所有 jQuery 效果函数,包括滑动、淡入淡出和自定义动画。 id为panel动画下滑的时候 单击id为panel的按钮暂停 单击id为flip的按钮继续 <script> $(document).ready(function(){ $("#flip").click(function(){ $("#panel").slideDown(5000); }); $("#stop").click(function(){ $("#panel").stop(); }); }); </script> 注意: stop语法 $(selector).stop(stopAll,goToEnd); 可选的 stopAll 参数规定是否应该清除动画队列。默认是 false,即仅停止活动的动画,允许任何排入队列的动画向后执行。 可选的 goToEnd 参数规定是否立即完成当前动画。默认是 false。 Callback 函数 在当前动画 100% 完成之后执行。 实现:单击按钮 文字文本1秒内隐藏后 输出”hahaha” <script type="text/javascript"> $(document).ready(function(){ $("button").click(function(){ $("p").hide(1000,function(){ alert("hahaha"); }); }); }); </script> 一种名为链接(chaining)的技术,允许我们在相同的元素上运行多条 jQuery 命令,一条接着另一条。 举个栗子: “p1” 元素首先会变为红色,然后向上滑动,然后向下滑动 $("#p1").css("color","red").slideUp(2000).slideDown(2000); 等效于: $("#p1").css("color","red") .slideUp(2000) .slideDown(2000); jQuery 会抛掉多余的空格,并按照一行长代码来执行上面的代码行。 jQuery操作DOM 三个简单实用的用于 DOM 操作的 jQuery 方法: text() - 设置或返回所选元素的文本内容 html() - 设置或返回所选元素的内容(包括 HTML 标记) val() - 设置或返回表单字段的值 举个栗子: <script> $(document).ready(function(){ $("#btn1").click(function(){ alert("Text: " + $("#test").text()); }); $("#btn2").click(function(){ alert("HTML: " + $("#test").html()); }); }); </script> <p id="test">这是段落中的<b>粗体</b>文本。</p> 第一个alert返回的是 这是段落中的粗体文本。 第二个alert返回的是 这是段落中的<b>粗体</b>文本。 <script> $(document).ready(function(){ $("button").click(function(){ alert("Value: " + $("#test").val()); }); }); </script> 返回的是表单的内容 如果是text返回的是 输入的值或者默认值 attr() 方法用于获取属性值。 返回的是id为w3s的href属性值 <script> $(document).ready(function(){ $("button").click(function(){ alert($("#w3s").attr("href")); }); }); </script> 也可直接通过上述方法修改内容 举个栗子: 修改id为test1的文本文件值为”Hello world!” 修改id为test2的html内容为<b>Hello world!</b> 修改id为test3的内容为Dolly Duck <script> $(document).ready(function(){ $("#btn1").click(function(){ $("#test1").text("Hello world!"); }); $("#btn2").click(function(){ $("#test2").html("<b>Hello world!</b>"); }); $("#btn3").click(function(){ $("#test3").val("Dolly Duck"); }); }); </script> 设置属性 - attr() 修改id为w3s的href属性为 http://www.w3school.com.cn/jquery $("button").click(function(){ $("#w3s").attr("href","http://www.w3school.com.cn/jquery"); }); attr() 方法也允许您同时设置多个属性。 $("button").click(function(){ $("#w3s").attr({ "href" : "http://www.w3school.com.cn/jquery", "title" : "hhaha" }); }); attr其实有个问题 如果涉及到复选框之类的设置true false值的时候就不可靠 要用prop 使用attr获取checked属性时返回”checked”和”“,现在使用prop方法获取属性则统一返回true和false。 那么,什么时候使用attr(),什么时候使用prop()? 1.添加属性名称该属性就会生效应该使用prop(); 2.是有true,false两个属性使用prop(); 3.其他则使用attr(); 参考: https://www.cnblogs.com/smartXiang/p/5686800.html text()、html() 以及 val() 的回调函数 回调函数由两个参数:被选元素列表中当前元素的下标,以及原始(旧的)值。然后以函数新值返回您希望使用的字符串。 $("#btn1").click(function(){ $("#test1").text(function(i,origText){ return "Old text: " + origText + " New text: Hello world! (index: " + i + ")"; }); }); $("#btn2").click(function(){ $("#test2").html(function(i,origText){ return "Old html: " + origText + " New html: Hello <b>world!</b> (index: " + i + ")"; }); }); $("button").click(function(){ $("#w3s").attr("href", function(i,origValue){ return origValue + "/jquery"; }); }); 添加新的 HTML 内容 append() - 在被选元素的结尾插入内容 prepend() - 在被选元素的开头插入内容 after() - 在被选元素之后插入内容 before() - 在被选元素之前插入内容 append(): 元素结尾插入 在p结尾添加粗体 在ol列表中结尾添加一行 <script> $(document).ready(function(){ $("#btn1").click(function(){ $("p").append(" <b>Appended text</b>."); }); $("#btn2").click(function(){ $("ol").append("<li>Appended item</li>"); }); }); </script> appendTo跟append相反 prepend():元素开头插入 <script> $(document).ready(function(){ $("#btn1").click(function(){ $("p").prepend("<b>Prepended text</b>. "); }); $("#btn2").click(function(){ $("ol").prepend("<li>Prepended item</li>"); }); }); </script> append和prepend可以一次性添加多个 function appendText() { var txt1="<p>Text.</p>"; // 以 HTML 创建新元素 var txt2=$("<p></p>").text("Text."); // 以 jQuery 创建新元素 var txt3=document.createElement("p"); // 以 DOM 创建新元素 txt3.innerHTML="Text."; $("p").append(txt1,txt2,txt3); // 追加新元素 } after() 和 before() 元素前面和元素后面添加元素 <script> $(document).ready(function(){ $("#btn1").click(function(){ $("img").before("<b>Before</b>"); }); $("#btn2").click(function(){ $("img").after("<i>After</i>"); }); }); </script> 通过 after() 和 before() 方法添加若干新元素 <script> function afterText() { var txt1="<b>I </b>"; // 以 HTML 创建元素 var txt2=$("<i></i>").text("love "); // 通过 jQuery 创建元素 var txt3=document.createElement("big"); // 通过 DOM 创建元素 txt3.innerHTML="jQuery!"; $("img").after(txt1,txt2,txt3); // 在 img 之后插入新元素 } </script> 删除元素 remove() - 删除被选元素(及其子元素) empty() - 从被选元素中删除子元素 举个栗子: 删除id为div1的元素 删除id为div2的元素中的子元素 $("#div1").remove(); $("#div2").empty(); 过滤被删除的元素 添加参数即可 删除 class=”italic” 的所有 元素 $("p").remove(".italic"); 获取并设置 CSS 类 addClass() - 向被选元素添加一个或多个类 removeClass() - 从被选元素删除一个或多个类 toggleClass() - 对被选元素进行添加/删除类的切换操作 css() - 设置或返回样式属性 addClass() 向元素添加css样式 也可向多个元素添加同一个css样式 $("button").click(function(){ $("h1,h2,p").addClass("blue"); $("div").addClass("important"); }); removeClass() 移除一个或者多个类的css样式 $("button").click(function(){ $("h1,h2,p").removeClass("blue"); }); toggleClass() 该方法对被选元素进行添加/删除类的切换操作 先添加blue样式 后删除blue样式 $("button").click(function(){ $("h1,h2,p").toggleClass("blue"); }); 返回 CSS 属性 css() 设置或返回被选元素的一个或多个样式属性 $(“p”).css(“background-color”); 如果有多个p则返回首个匹配元素的 background-color 值 设置 CSS 属性 所有匹配元素设置 background-color 值为yellow $("p").css("background-color","yellow"); 设置多个 CSS 属性 为所有匹配元素设置 background-color 和 font-size $("p").css({"background-color":"yellow","font-size":"200%"}); jQuery 提供多个处理尺寸的重要方法: width()不包括内边距、边框或外边距 height()不包括内边距、边框或外边距 innerWidth()包括内边距 innerHeight()包括内边距 outerWidth()包括内边距和边框 outerHeight()包括内边距和边框 outerWidth(true) 方法返回元素的宽度(包括内边距、边框和外边距)。 outerHeight(true) 方法返回元素的高度(包括内边距、边框和外边距)。 设置指定的 <div >元素的宽度和高度 $("button").click(function(){ $("#div1").width(500).height(500); }); 返回文档(HTML 文档)和窗口(浏览器视口)的宽度和高度 $("button").click(function(){ var txt=""; txt+="Document width/height: " + $(document).width(); txt+="x" + $(document).height() + "\n"; txt+="Window width/height: " + $(window).width(); txt+="x" + $(window).height(); alert(txt); }); 遍历: 向上遍历 DOM 树 parent() 返回被选元素的直接父元素 返回span元素的直接父类 $("span").parent(); parents() 方法返回被选元素的所有祖先元素,它一路向上直到文档的根元素 ()。 所有的span的祖先元素的css元素都设置为红色 $("span").parents().css("color":"red"); 返回所有 元素的所有祖先,并且它是 <ul>>元素 $(document).ready(function(){ $("span").parents("ul"); }); span的所有祖先父类 但是低于div元素父类 就是介于span和div之间的所有元素 $(document).ready(function(){ $("span").parentsUntil("div"); }); 向下遍历 DOM 树 children() 方法返回被选元素的所有直接子元素 返回每个 <div>元素的所有直接子元素 $(document).ready(function(){ $("div").children(); }); 可以使用可选参数来过滤对子元素的搜索 比如: 返回类名为 “1” 的所有 <p> 元素,并且它们是 <div>的直接子元素 $("div").children("p.1"); find() 返回被选元素的后代元素,一路向下直到最后一个后代。 比如: <div> 后代的所有 <span> 元素 $(document).ready(function(){ $("div").find("span"); }); 返回 <div>>的所有后代: $(document).ready(function(){ $("div").find("*"); }); 同胞遍历: siblings() 返回被选元素的所有同胞元素 next() 返回被选元素的下一个同胞元素 只有一个 nextAll() 返回被选元素的所有跟随的同胞元素 nextUntil() 回介于两个给定参数之间的所有跟随的同胞元素 prev() prevAll() prevUntil() prev(), prevAll() & prevUntil() 跟前面的一样 不过是向前而已 siblings() 返回被选元素的所有同胞元素 也可以使用可选参数来过滤对同胞元素的搜索。 $("h2").siblings(); 所有同胞 $("h2").siblings("p"); 是p类型的同胞 nextUntil() 举例: 返回介于 <h2>与 <h6>元素之间的所有同胞元素 不包括h2和h6 $(document).ready(function(){ $("h2").nextUntil("h6"); }); 过滤 first() 第一个元素 last() 最后一个元素 eq() 根据指定索引找元素 filter() 匹配元素 not() 返回不匹配的元素 它们允许您基于其在一组元素中的位置来选择一个特定的元素 first() 返回被选元素的首个元素。 选取首个 <div>元素内部的第一个 <p>元素 $(document).ready(function(){ $("div p").first(); }); last() 相反: 选择最后一个 <div> 元素中的最后一个 <p> 元素 $(document).ready(function(){ $("div p").last(); }); eq() 返回被选元素中带有指定索引号的元素 从0开始 举例:选取第二个 <p> 元素 $(document).ready(function(){ $("p").eq(1); }); filter() 返回匹配的元素 举例: 返回带有类名 “intro” 的所有 <p>元素 $(document).ready(function(){ $("p").filter(".intro"); }); not() 回不匹配标准的所有元素 not() 方法与 filter() 相反。 返回不带有类名 “intro” 的所有<p>元素 $(document).ready(function(){ $("p").not(".intro"); });

优秀的个人博客,低调大师

Nginx PHP配置与优化(学习笔记二十二)

这篇是Nginx安装配置PHP(FastCGI)环境的教程。Nginx不支持对外部程序的直接调用或者解析,所有的外部程序(包括PHP)必须通过FastCGI接口来调用。 一、什么是 FastCGI FastCGI是一个可伸缩地、高速地在HTTP server和动态脚本语言间通信的接口。多数流行的HTTP server都支持FastCGI,包括Apache、Nginx和lighttpd等,同时,FastCGI也被许多脚本语言所支持,其中就有PHP。 FastCGI是从CGI发展改进而来的。传统CGI接口方式的主要缺点是性能很差,因为每次HTTP服务器遇到动态程序时都需要重新启动脚本解析器来执行解析,然后结果被返回给HTTP服务器。这在处理高并发访问时,几乎是不可用的。另外传统的CGI接口方式安全性也很差,现在已经很少被使用了。 FastCGI接口方式采用C/S结构,可以将HTTP服务器和脚本解析服务器分开,同时在脚本解析服务器上启动一个或者多个脚本解析守护进程。当HTTP服务器每次遇到动态程序时,可以将其直接交付给FastCGI进程来执行,然后将得到的结果返回给浏览器。这种方式可以让HTTP服务器专一地处理静态请求或者将动态脚本服务器的结果返回给客户端,这在很大程度上提高了整个应用系统的性能。 二、Nginx+FastCGI运行原理 Nginx不支持对外部程序的直接调用或者解析,所有的外部程序(包括PHP)必须通过FastCGI接口来调用。FastCGI接口在Linux下是socket,(这个socket可以是文件socket,也可以是ip socket)。为了调用CGI程序,还需要一个FastCGI的wrapper(wrapper可以理解为用于启动另一个程序的程序),这个wrapper绑定在某个固定socket上,如端口或者文件socket。当Nginx将CGI请求发送给这个socket的时候,通过FastCGI接口,wrapper接纳到请求,然后派生出一个新的线程,这个线程调用解释器或者外部程序处理脚本并读取返回数据;接着,wrapper再将返回的数据通过FastCGI接口,沿着固定的socket传递给Nginx;最后,Nginx将返回的数据发送给客户端,这就是Nginx+FastCGI的整个运作过程。详细的过程,如图1所示。 图1 Nginx+FastCGI运行原理 三、spawn-fcgi与PHP-FPM 前面介绍过,FastCGI接口方式在脚本解析服务器上启动一个或者多个守护进程对动态脚本进行解析,这些进程就是FastCGI进程管理器,或者称之为FastCGI引擎, spawn-fcgi与PHP-FPM就是支持PHP的两个FastCGI进程管理器。下面简单介绍spawn-fcgi与PHP-FPM的异同。 spawn-fcgi是HTTP服务器lighttpd的一部分,目前已经独立成为一个项目,一般与lighttpd配合使用来支持PHP,但是ligttpd的spwan-fcgi在高并发访问的时候,会出现内存泄漏甚至自动重启FastCGI的问题。 Nginx是个轻量级的HTTP server,必须借助第三方的FastCGI处理器才可以对PHP进行解析,因此Nginx+spawn-fcgi的组合也可以实现对PHP的解析,这里不过多讲述。 PHP-FPM也是一个第三方的FastCGI进程管理器,它是作为PHP的一个补丁来开发的,在安装的时候也需要和PHP源码一起编译,也就是说PHP-FPM被编译到PHP内核中,因此在处理性能方面更加优秀;同时它在处理高并发方面也比spawn-fcgi引擎好很多,因此,推荐Nginx+PHP/PHP-FPM这个组合对PHP进行解析。 FastCGI 的主要优点是把动态语言和HTTP Server分离开来,所以Nginx与PHP/PHP-FPM经常被部署在不同的服务器上,以分担前端Nginx服务器的压力,使Nginx专一处理静态请求和转发动态请求,而PHP/PHP-FPM服务器专一解析PHP动态请求。 四、 PHP与PHP-FPM的安装及优化 1. 下载安装包 从php官方网站下载PHP源码包,这里下载的是稳定版php-5.2.13.tar.gz。从这里下载对应的PHP-FPM源码包,这里下载的是php-5.2.13-fpm-0.5.13.diff.gz。需要注意,在下载软件包版本时,尽量使PHP和PHP-FPM版本一致,如果版本之间相差太大,可以会出现兼容问题。 2. 配置安装环境 安装PHP需要下面软件包的支持,如果没有安装,请自行安装。 yum -y install gcc gcc-c++ libxml2 libxml2-devel autoconf libjpeg libjpeg-devel libpng libpng-devel freetype freetype-devel zlib zlib-devel glibc glibc-devel glib2 glib2-devel 由于各个Linux系统版本的不确定性,读者也可以在安装PHP过程中,根据错误提示信息,安装对应的软件库。 3. 开始编译安装PHP和PHP-FPM 编译安装PHP和PHP-FPM很简单,下面是安装过程: tar zxvf php-5.2.13.tar.gz gzip -cd php-5.2.13-fpm-0.5.13.diff.gz | patch -d php-5.2.13 -p1 cd php-5.2.13 ./configure --prefix=/usr/local/php --enable-fastcgi --enable-fpm make make install cp php.ini-dist /usr/local/php/lib/php.ini 其中,第二步将PHP-FPM作为补丁加入PHP源码中。 在“./configure”编译选项中,指定将PHP安装到/usr/local下,“--enable-fastcgi”是启用对PHP的FastCGI支持,“--enable-fpm”是激活对FastCGI模式的fpm支持。 在编译PHP时可以加入很多编译选项,但是这里为了介绍PHP的FastCGI功能没有加入更多的编译选项。 4. 配置与优化 PHP-FPM PHP的全局配置文件是php.ini,在上面的步骤中,已经将此文件复制到了/usr/local/php/lib/php.ini下。可以根据每个应用需求的不同,对php.ini进行相应的配置。 下面重点介绍PHP-FPM引擎的配置文件。根据上面指定的安装路径,PHP-FPM的默认配置文件为/usr/local/php/etc/php-fpm.conf。 php-fpm.conf是一个XML格式的纯文本文件,其内容很容易看明白。 这里重点介绍几个重要的配置标签: 标签listen_address是配置fastcgi进程监听的IP地址以及端口,默认是127.0.0.1:9000。 127.0.0.1:9000 标签display_errors用来设置是否显示PHP错误信息,默认是0,不显示错误信息,设置为1可以显示PHP错误信息。 0 标签user和group用于设置运行FastCGI进程的用户和用户组。需要注意的是,这里指定的用户和用户组要和Nginx配置文件中指定的用户和用户组一致。 nobody < value name="group">nobody 标签max_children用于设置FastCGI的进程数。根据官方建议,小于2GB内存的服务器,可以只开启64个进程,4GB以上内存的服务器可以开启200个进程。 5 标签request_terminate_timeout用于设置FastCGI执行脚本的时间。默认是0s,也就是无限执行下去,可以根据情况对其进行修改。 0s 标签rlimit_files用于设置PHP-FPM对打开文件描述符的限制,默认值为1024。这个标签的值必须和Linux内核打开文件数关联起来,例如要将此值设置为65535,就必须在Linux命令行执行'ulimit -HSn 65536'。 1024 标签max_requests指明了每个children最多处理多少个请求后便会被关闭,默认的设置是500。 500 标签allowed_clients用于设置允许访问FastCGI进程解析器的IP地址。如果不在这里指定IP地址,Nginx转发过来的PHP解析请求将无法被接受。 127.0.0.1 5. 管理FastCGI进程 在配置完php-fpm后,就可以启动FastCGI进程了。启动fastcgi进程有两种方式: /usr/local/php/bin/php-cgi --fpm 或者 /usr/local/php/sbin/php-fpm start 建议采用第二种方式启动FastCGI进程。/usr/local/php/sbin/php-fpm还有其他参数,具体为start|stop|quit|restart|reload|logrotate。 每个启动参数的含义如下: start,启动PHP的FastCGI进程 stop,强制终止PHP的FastCGI进程 quit,平滑终止PHP的FastCGI进程 restart, 重启PHP的FastCGI进程 reload, 重新加载PHP的php.ini logrotate, 重新启用log文件 reload是个很重要的参数,它可以在PHP的FastCGI进程不中断的情况下重新加载改动过的php.ini,因此通过php-fpm可以平滑变更FastCGI模式下的PHP设置。 在FastCGI进程启动后,其监听的IP地址和端口也随即启动,可以通过ps和netstat查看相关信息。 netstat -antl|grep 9000 tcp 0 0 127.0.0.1:9000 0.0.0.0:* LISTEN ps -ef|grep php-cgi root 3567 1 0 17:06 ? 00:00:00 /usr/local/php/bin/php-cgi --fpm --fpm-config /usr/local/php/etc/php-fpm.conf nobody 3568 3567 0 17:06 ? 00:00:00 /usr/local/php/bin/php-cgi --fpm --fpm-config /usr/local/php/etc/php-fpm.conf nobody 3569 3567 0 17:06 ? 00:00:00 /usr/local/php/bin/php-cgi --fpm --fpm-config /usr/local/php/etc/php-fpm.conf nobody 3570 3567 0 17:06 ? 00:00:00 /usr/local/php/bin/php-cgi --fpm --fpm-config /usr/local/php/etc/php-fpm.conf nobody 3571 3567 0 17:06 ? 00:00:00 /usr/local/php/bin/php-cgi --fpm --fpm-config /usr/local/php/etc/php-fpm.conf nobody 3572 3567 0 17:06 ? 00:00:00 /usr/local/php/bin/php-cgi --fpm --fpm-config /usr/local/php/etc/php-fpm.conf root 3583 3524 0 17:09 pts/1 00:00:00 grep php-cgi 五、配置Nginx来支持PHP Nginx的安装特别简单,前面已经对此进行了详细介绍,这里不再进行讲述。下面重点介绍Nginx如何通过php-fpm的FastCGI进程对PHP进行解析处理。 由于Nginx本身不会对PHP进行解析,因此要实现Nginx对PHP的支持,其实是将对PHP页面的请求交给fastCGI进程监听的IP地址及端口。如果把php-fpm当做动态应用服务器,那么Nginx其实就是一个反向代理服务器。Nginx通过反向代理功能实现对PHP的解析,这就是Nginx实现PHP动态解析的原理。 这里假定Nginx的安装目录为/usr/local,则Nginx配置文件的路径为/usr/local/nginx/conf/nginx.conf。下面是在Nginx下支持PHP解析的一个虚拟主机配置实例。 server { include port.conf; server_name www.ixdba.net ixdba.net; location / { index index.html index.php; root /web/www/www.ixdba.net; } location ~ .php$ { root html; fastcgi_pass 127.0.0.1:9000; fastcgi_index index.php; fastcgi_param SCRIPT_FILENAME html$fastcgi_script_name; include fastcgi_params; } } 通过location指令,将所有以php为后缀的文件都交给127.0.0.1:9000来处理,而这里的IP地址和端口就是FastCGI进程监听的IP地址和端口。fastcgi_param指令指定放置PHP动态程序的主目录,也就是$fastcgi_script_name前面指定的路径,这里是/usr/local/nginx/html目录,建议将这个目录与Nginx虚拟主机指定的根目录保持一致,当然也可以不一致。fastcgi_params文件是FastCGI进程的一个参数配置文件,在安装Nginx后,会默认生成一个这样的文件,这里通过include指令将FastCGI参数配置文件包含了进来。 接下来,启动nginx服务。/usr/local/nginx/sbin/nginx到此为止,Nginx+PHP已经配置完成。 六、测试Nginx对PHP的解析功能 这里在/usr/local/nginx/html目录下创建一个phpinfo.php文件,内容如下: < ?php phpinfo(); ?> 然后通过浏览器访问,默认会在浏览器显示“Welcome to Nginx!”表示Nginx正常运行。 接着在浏览器中访问phpinfo.php,如果PHP能够正常解析,会出现PHP安装配置以及功能列表统计信息。 七、实例讲解Nginx中FastCGI参数的优化 在配置完成Nginx+FastCGI之后,为了保证Nginx下PHP环境的高速稳定运行,需要添加一些FastCGI优化指令。下面给出一个优化实例,将下面代码添加到Nginx主配置文件中的HTTP层级。 fastcgi_cache_path /usr/local/nginx/fastcgi_cache levels=1:2 keys_zone=TEST:10m inactive=5m; fastcgi_connect_timeout 300; fastcgi_send_timeout 300; fastcgi_read_timeout 300; fastcgi_buffer_size 64k; fastcgi_buffers 4 64k; fastcgi_busy_buffers_size 128k; fastcgi_temp_file_write_size 128k; fastcgi_cache TEST; fastcgi_cache_valid 200 302 1h; fastcgi_cache_valid 301 1d; fastcgi_cache_valid any 1m; 下面是对上述代码的含义进行介绍: 第一行代码是为FastCGI缓存指定一个文件路径、目录结构等级、关键字区域存储时间和非活动删除时间。 fastcgi_connect_timeout指定连接到后端FastCGI的超时时间。 fastcgi_send_timeout指定向FastCGI传送请求的超时时间,这个值是已经完成两次握手后向FastCGI传送请求的超时时间。 fastcgi_read_timeout指定接收FastCGI应答的超时时间,这个值是已经完成两次握手后接收FastCGI应答的超时时间。 fastcgi_buffer_size用于指定读取FastCGI应答第一部分需要用多大的缓冲区,这个值表示将使用1个64KB的缓冲区读取应答的第一部分(应答头),可以设置为fastcgi_buffers选项指定的缓冲区大小。 fastcgi_buffers指定本地需要用多少和多大的缓冲区来缓冲FastCGI的应答请求。如果一个PHP脚本所产生的页面大小为256KB,那么会为其分配4个64KB的缓冲区来缓存;如果页面大小大于256KB,那么大于256KB的部分会缓存到fastcgi_temp指定的路径中,但是这并不是好方法,因为内存中的数据处理速度要快于硬盘。一般这个值应该为站点中PHP脚本所产生的页面大小的中间值,如果站点大部分脚本所产生的页面大小为256KB,那么可以把这个值设置为“16 16k”、“4 64k”等。 fastcgi_busy_buffers_size的默认值是fastcgi_buffers的两倍。 fastcgi_temp_file_write_size表示在写入缓存文件时使用多大的数据块,默认值是fastcgi_buffers的两倍。 fastcgi_cache表示开启FastCGI缓存并为其指定一个名称。开启缓存非常有用,可以有效降低CPU的负载,并且防止502错误的发生,但是开启缓存也会引起很多问题,要视具体情况而定。 fastcgi_cache_valid、fastcgi用来指定应答代码的缓存时间,实例中的值表示将200和302应答缓存一个小时,将301应答缓存1天,其他应答均缓存1分钟。

优秀的个人博客,低调大师

Jenkins +Cobertura代码覆盖率(学习笔记三十七)

https://www.cnblogs.com/testway/p/6380656.html 1、新建一个maven工程,在src/main/java 下建一个CoverageTest.java 类 package test_junit;publicclass CoverageTest { public CoverageTest() { // TODO Auto-generated constructor stub } publicstaticvoid main(String[] args) { // TODO Auto-generated method stub } publicstaticinttestadd(intx,int y){ intc = 0; if(x == 10){ c = x + y; }else{ c = (x + y)*2; } return c; } } 2、在src/main/java 新建一个测试类JunitTest.java package junit;import org.junit.Assert;import org.junit.Test;import test_junit.CoverageTest;/** * Created by 000284 on 2017/2/6. */publicclass JunitTest { @Test publicvoid testadd(){ intb = CoverageTest.testadd(5, 20); Assert.assertEquals(b,50); } } 3、pom.xml 文件 4.0.0testunittest_junit1.0-SNAPSHOTjenkinsenv.BUILD_NUMBERorg.codehaus.mojocobertura-maven-plugin2.7xmlpackagecoberturajunitjunit4.12 3、jenkins 安装插件cobertura 4、新建jenkins job build >Goals and options 设置:clean cobertura:cobertura Cobertura xml report pattern 设置:**/target/site/cobertura/coverage.xml post setps 设置:Enable the "Publish Cobertura Coverage Report" publisher 5、构建job 查看Coverage Report就会显示覆盖率报表

优秀的个人博客,低调大师

Jenkins ANT+JUNIT实例(学习笔记二十七)

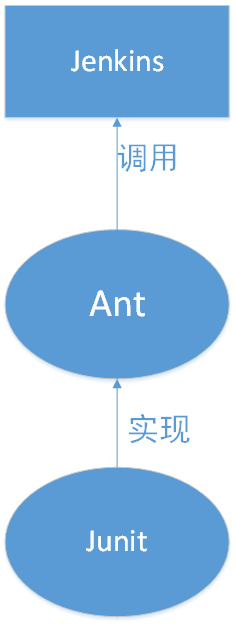
转载:http://www.cnblogs.com/helloIT/p/5761740.html 1.环境 windows10 专业版 Jenkins 2.7 apache-ant-1.9.6 JDK1.8.0_20 2.整体思路 jdk:支持ant脚本中的编译、测试等target。 ant脚本:负责java代码的编译、JUnit。 Jenkins:调度触发ant脚本的执行。 3.开始练兵 3.1 项目整体结构 com.java.src下面放源码 MessageUtil.java com.java.test目录下放JUnit测试文件TestMessageUtil.java build.xml文件放在根目录下,即位于AntJunit-v1.0目录下,和src位于同一级别。 3.2 项目源码 1package com.java.src; 2 3publicclass MessageUtil { 4private String message; 5 6//Constructor 7//@param message to be printed 8public MessageUtil(String message){ 9this.message = message; 10 }1112// prints the message13public String printMessage(){14 System.out.println(message);15return message;16 } 1718// add "Hi!" to the message19public String salutationMessage(){20message = "Hi!" + message;21 System.out.println(message);22return message;23 } 24} 1package com.java.test; 2 3 4 5 6importstaticorg.junit.Assert.*; 7 8import org.junit.Test; 910import com.java.src.MessageUtil;1112publicclass TestMessageUtil {13String message = "Robert"; 14MessageUtil messageUtil =new MessageUtil(message);1516 @Test17publicvoid testPrintMessage() { 18System.out.println("Inside testPrintMessage()"); 19 assertTrue(message.equals(messageUtil.printMessage()));20 }2122 @Test23publicvoid testSalutationMessage() {24System.out.println("Inside testSalutationMessage()");25message = "Hi!" + "Robert";26 assertTrue(message.equals(messageUtil.salutationMessage()));27 }28} 1 2 3 4 5 6 7 8 9101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778 3.3 必要的环境配置 将junit-4.10.jar复制到%ANT_HOME%\lib目录下。例如,我需复制到D:\SoftInstall\apache-ant-1.9.6\lib下。 这一步很有必要,否则正式运行会报错。 3.4 配置Jenkins 新建一个自由风格的job,名字为AntJunit-V1.0。 源码管理:选择No。利用SVN或git对源码进行管理时,Jenkins总是会把代码拷贝一份到自己的工作空间,然后对备份进行操作,因此本demo忽略源码管理,直接将代码拷贝到Jenkins工作区。 增加构建步骤:选择Invoke Ant。Targets的名字test来自build.xml中的target名字test(test在build.xml中也是默认执行的target)。 另外,这里的构建可以用windows脚本执行。二者效果完全一样。 构建后操作:选择Publish JUnit test result report。测试报告xml填:report/junit/html/TESTS-TestSuites.xml 。 点击「保存」。 4.构建结果 点击中间的「最新测试结果」,查看详情: 5.总结 ①完全可以在ant环境下调试好结果再放到jenkins工作空间。因为起实质作用的是ant,jenkins仅仅是调度。ant和jenkins天然有着密切的联系。 ②这个demo中ant脚本模拟的是手动编译、测试java代码的过程。ant典型应用还有对Java程序的打包、部署等。当然,ant还有更多应用,有兴趣的童鞋可以搜索ant学习。 6.致谢 本文参考了参考一和参考二,在此对原作者表示感谢。 7.在ubuntu14.04下遇到的问题(2016.8.16,jenkins版本为2.7.2) 上述作业在windows下没有任何问题。但是移植到ubuntu14.04虽然能够构建,但查看详情发现报错:Error Message:org/hamcrest/SelfDescribing。 原来是由于Junit4.10.jar中不包含hamcrest-core-1.3.jar(参考这里)。 将hamcrest-core-1.3.jar添加到${JENKINS_HOME}/workspace/AntJunit/lib目录下,重新构建,成功!

优秀的个人博客,低调大师

Zabbix proxy分布式监控(学习笔记三十一)

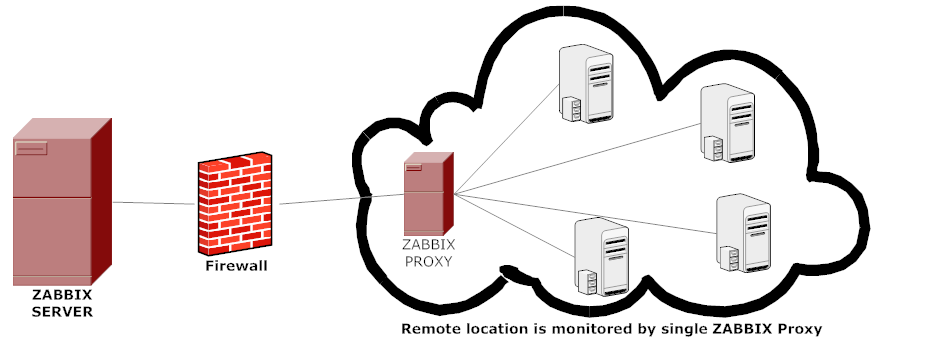
转载:http://www.cnblogs.com/yaoyaojcy/p/8182067.html 自学Zabbix13.1分布式监控proxy介绍 zabbix2.4版本之前,zabbix提供了两种解决方案,分别为:proxy和nodes proxy代替zabbix server在本地检索数据,然后提交给zabbix server Nodes则就是一个完整的zabbix Server(不做介绍) zabbix自从2.4版本之后,分布式监控就移除了 nodes 模式 1. 概述 zabbixproxy可以代替zabbix server检索客户端的数据,然后把数据汇报给zabbix server,并且在一定程度上分担了zabbix server的压力.zabbix proxy可以非常简便的实现了集中式、分布式监控。 zabbix proxy使用场景: 监控远程区域设备 监控本地网络不稳定区域 当zabbix监控上千设备时,使用它来减轻server的压力 简化zabbix的维护 2.zabbix proxy架构图 zabbix proxy仅仅需要一条tcp连接到zabbix server,所以防火墙上仅仅需要加上一条规则即可。 zabbix proxy数据库必须和server分开,否则数据会被破坏,毕竟这两个数据库的表大部分都相同。总之记住,数据库分开即可。 proxy收集到数据之后,首先将数据缓存在本地,然后在一定得时间之后传递给zabbix server。 这个时间由proxy配置文件中参数ProxyLocalBuffer and ProxyOfflineBuffer决定。 3.zabbix proxy功能 zabbix proxy是一个数据收集器,它不计算触发器、不处理事件、不发送报警,如下是proxy的功能. ItemsFunction Supported by proxy Zabbix agent checksYes Zabbix agent checks (active)Yes Simple checksYes Trapper itemsYes SNMP checksYes SNMP trapsYes IPMI checksYes JMX checksYes Log file monitoringYes Internal checksYes SSH checksYes Telnet checksYes External checksYes Built-in web monitoringYes Network discoveryYes Low-level discoveryYes Calculating triggersNo Processing eventsNo Sending alertsNo Remote commandsNo 备注: 使用agent active模式,一定要记住在agent的配置文件参数ServerActive加上proxy的IP地址 分为两部分: 安装proxy 配置proxy 1. 安装proxy 官方文档使用的是源码安装,因为方便我们使用yum安装,因为我们只有2台,所以就用agent当做Proxy 1.1 安装 [root@linux-node2 ~]# yum install -y zabbix-proxy zabbix-proxy-mysql mariadb-server 我们需要启动MySQL [root@linux-node2 ~]# systemctl start mariadb.service 1.2 创建数据库 1mysql2create database zabbix_proxy character set utf8;3grant all on zabbix_proxy.* to zabbix_proxy@localhost identified by'zabbix_proxy'; 1.3 导入数据 [root@linux-node2 ~]# cd /usr/share/doc/zabbix-proxy-mysql-3.0.8/[root@linux-node2 zabbix-proxy-mysql-3.0.8]# zcat schema.sql.gz | mysql -uzabbix_proxy -p zabbix_proxyEnter password: #密码是:zabbix_proxy 是我们数据库授权的密码 1.4 检查数据库 1mysql2show databases;3use zabbix_proxy;4show tables;5#查看是否含有数据 1.5 修改proxy的配置文件 1[root@linux-node2 zabbix-proxy-mysql-3.0.8]# vim /etc/zabbix/zabbix_proxy.conf 2Server=172.18.50.33 3Hostname=Zabbix proxy 4DBName=zabbix_proxy 5#数据库名称 6DBUser=zabbix_proxy 7#用户名 8DBPassword=zabbix_proxy 9#用户密码10配置文件中没有配置的内容如下:(有需要可以配置)11# ProxyLocalBuffer=012#数据保留的时间(小时为单位)13# ProxyOfflineBuffer=114#连不上Server,数据要保留多久(小时为单位,默认1小时)15# DataSenderFrequency=116#数据的发送时间间隔(默认是1秒)17# StartPollers=518#启动的线程数19# StartIPMIPollers=020#启动IPMI的线程数 过滤修改过的配置如下: 1[root@linux-node2 zabbix-proxy-mysql-3.0.8]# grep '^[a-Z]' /etc/zabbix/zabbix_proxy.conf 2Server=172.18.50.33 3Hostname=Zabbix proxy 4LogFile=/var/log/zabbix/zabbix_proxy.log 5LogFileSize=0 6PidFile=/var/run/zabbix/zabbix_proxy.pid 7DBName=zabbix_proxy 8DBUser=zabbix_proxy 9DBPassword=zabbix_proxy10SNMPTrapperFile=/var/log/snmptrap/snmptrap.log11Timeout=412ExternalScripts=/usr/lib/zabbix/externalscripts13LogSlowQueries=3000 1.6 启动, 查看proxy进程 [root@linux-node2 ~]# systemctl start zabbix-proxy 1[root@linux-node2 ~]# netstat -lntup 2Active Internet connections (only servers) 3Proto Recv-Q Send-Q Local Address Foreign Address State PID/Program name 4tcp 0 0 0.0.0.0:3306 0.0.0.0:* LISTEN 15685/mysqld 5tcp 0 0 0.0.0.0:22 0.0.0.0:* LISTEN 1073/sshd 6tcp 0 0 127.0.0.1:25 0.0.0.0:* LISTEN 2498/master 7tcp 0 0 0.0.0.0:10051 0.0.0.0:* LISTEN 15924/zabbix_proxy 8tcp6 0 0 :::44589 :::* LISTEN 9052/java 9tcp6 0 0 :::8080 :::* LISTEN 9052/java 10tcp6 0 0 :::22 :::* LISTEN 1073/sshd 11tcp6 0 0 :::8888 :::* LISTEN 9052/java 12tcp6 0 0 ::1:25 :::* LISTEN 2498/master 13tcp6 0 0 :::39743 :::* LISTEN 9052/java 14tcp6 0 0 :::10051 :::* LISTEN 15924/zabbix_proxy 15tcp6 0 0 127.0.0.1:8005 :::* LISTEN 9052/java 16tcp6 0 0 :::8009 :::* LISTEN 9052/java Zabbix-proxy 监控10051端口,因为是代理就必须跟Server的端口相同,对于Agent Proxy就是Server 2. proxy配置 2.1 administrator --- proxies---creat proxy 参数描述 Proxy nameproxy名称,必须和proxy配置文件中的hostname一致 Proxy mode选择proxy模式 Activeproxy主动连接到zabbix server并且请求配置文件数据 PassiveZabbix server连接到proxy Hosts哪些主机需要被proxy监控 2.2 encryption选项 连接到代理服务器如何连接到被动代理:没有加密(默认),使用PSK(预共享密钥)或证书。 来自代理的连接选择从活动代理允许什么类型的连接 可以同时选择几种连接类型(用于测试和切换到其他连接类型) 默认没有加密 发行人允许颁发证书。证书首先由CA(证书颁发机构)验证。如果它是有效的,在CA签署,然后发行领域可以用来进一步限制允许约这个字段是可选的,如果你打算使用Zabbix安装使用证书从多个CAS。 科目允许证书。证书首先由CA.验证,如果它是有效的,由CA签名,则主题字段可用于只允许一个主题字符串值。如果此字段为空,则接受配置的CA签署的任何有效证书。 身份认证预共享密钥标识字符串。 预共享密钥最大长度:512进制数(256字节的PSK) 如果Zabbix uses GnuTLS或OpenSSL库,64进制数(32字节的PSK) 如果Zabbix使用MBED TLS(polarssl)。例如:1f87b595725ac58dd977beef14b97461a7c1045b9a1c963065002c5473194952 2.3 配置主机HOST的时候,如果需要被proxy代理,那么都选择对应的proxy名称 。

优秀的个人博客,低调大师

Zabbix 二次开发API(学习笔记三十)

Zabbix API我们可以做很多,自己开发web界面、开发手机端zabbix、获取zabbix指定数据、创建zabbix监控项等等。 1. zabbix API开发库 zabbix API请求和响应都是json,并且还提供了各种语法的lib库,http://zabbix.org/wiki/Docs/api/libraries,包含php、c#、Python、Perl、go等等语言,简单看了下phpzabbixapi,使用非常方便。 2.请求zabbix API post json数据到api接口地址,例如你得zabbix地址是http://company.com/zabbix,那么你得接口地址是:http://company.com/zabbix/api_jsonrpc.php,必须包含content-type头,值为application/json-rpc,application/jsonorapplication/jsonrequest之一。 POSThttp://company.com/zabbix/api_jsonrpc.php HTTP/1.1 Content-Type:application/json-rpc {"jsonrpc":"2.0","method":"apiinfo.version","id":1,"auth":null,"params":{}} 3. zabbix API登陆 获取auth token(登陆) 在操作zabbix之前,我们必须先登陆zabbix,得到token,以后的操作带着这个token即可,要不然肯定没权限。 请求的json如下: { "jsonrpc":"2.0", "method":"user.login", "params":{ "user":"Admin", "password":"zabbix" }, "id":1, "auth":null } 属性说明 jsonrps - JSON-RPC版本,基本上用2.0就行了; method - 调用的API方法,方法列表请上官网; params - 需要传递的参数,这边是user和password; id - 请求标志; auth - 用户token,这边使用null,因为还没通过验证 验证成功,会返回如下json数据 { "jsonrpc":"2.0", "result":"0424bd59b807674191e7d77572075f33", "id":1 } result便是我们要德token数据,id对应请求的id。 4. zabbix api检索主机 通过验证之后,我们带着token使用host.get获取主机列表,请求的json如下: { "jsonrpc":"2.0", "method":"host.get", "params":{ "output":[ "hostid", "host" ], "selectInterfaces":[ "interfaceid", "ip" ] }, "id":2, "auth":"0424bd59b807674191e7d77572075f33" } 获取到如下数据: { "jsonrpc":"2.0", "result":[ { "hostid":"10084", "host":"Zabbix server", "interfaces":[ { "interfaceid":"1", "ip":"127.0.0.1" } ] } ], "id":2 } 请使用你的程序处理一下即可。

优秀的个人博客,低调大师

java学习笔记--简单掌握正则表达式

正则表达式: 主要用于操作字符串的规则 用于检索替换那些符合规定的文本 预定义字符 . 任何字符 . 就单纯代表. \d是 数字 \D 非数字 \s 空白字符 包括\t \n \r \S 非空白字符 \w 单词字符 比如 a—z A-Z _还有0到9 \W 非单词字符 如果预定义字符没有加上数量词 那就只能匹配一个字符 数量词: ? 一次或者一次也没有 * 0次或者多次 + 1次或者多次 {n}恰好n次 {n,} 至少n次 {n,m} 至少n次,但是不超过m次 范围词: 没有数量词就只能匹配一个字符 [abc] 在abc内 [^abc] 除了abc外 [a-zA-Z] a到z或者A到Z 两头字母包括在内 [a-d[m-p]]a到d或者m到p 并集 [a-d&&[def]] 交集 匹配功能 举个例子: String match="1[12a]\\d{2}"; System.out.println(number.matches(match)?"ok":"flase");//number是被匹配的字符串 意思就是第一个为1 第二个为1或2或a 接下来的为数字并且有且只有两个 再举例: String match="a\\d{0,2}[a]{2}"; 第一个为a 第二个开始后0个到2个内必须为数字 剩下的两位必须为a 数量词如{2} 必须跟范围词或者预定义符后面有效 是对这两个的修饰 切割功能 举例:根据空格来对字符串进行切分 String str = "aa.bb.cc"; str = "-1 99 4 23"; String[] arr = str.split(" +"); //+这里代表一个或者多个空格 再举例:根据重叠词进行切割 String str = "sdqqfgkkkhjppppkl"; String[] arr = str.split("(.)\\1+"); 注意:为了提高规则复用,用()进行封装,每一个括号都有一个编号,从1开始,为了复用这个规则。可以通过编号来完成该规则的调用。需要对编号数字进行转义。\1就代表获取1组规则。 等于说 第一次获得s 然后\1引用 变成ss+ 无法切割 然后下一个 替换: String name="wocao141311164sdfsdf1232"; String reg="1[2345]\\d{3}"; String aa=name.replaceAll(reg, "****"); //将满足条件的内容替换成****格式 替换重复的 String name="wo我洗爱你你你"; String reg="(.)\\1+"; String aa=name.replaceAll(reg,"$1"); 如果需要在replaceAll方法正则的时候外部引用组的内容 要使用$组号 查找: 范例: Pattern p = Pattern.compile("a*b"); Matcher m = p.matcher("aaaaab"); boolean b = m.matches(); **注意:步骤: 1,先将正则表达式编译成正则对象。使用的是Pattern类一个静态的方法。compile(regex); 2,让正则对象和要操作的字符串相关联,通过matcher方法完成,并返回匹配器对象(Matcher)。 3,通过匹配器对象的方法将正则模式作用到字符串上对字符串进行针对性的功能操作** 查找三个的单词 String str = "da jia zhu yi le,ming tian bu fang jia,xie xie!"; String reg="\\b[a-zA-Z]{3}\\b"; Pattern pattern=Pattern.compile(reg); Matcher matcher= pattern.matcher(str); while(matcher.find()) { System.out.println(matcher.group()); } 先find(寻找有没有满足的 然后下移位置)才可以group(得到满足条件的字符串) \b是边界词 不匹配 只表示开始和结束 匹配emil: String str = "123sdfsd@sin.com.cn"; true str="1@1.1"; false String reg="[a-zA-Z_0-9]+@[a-zA-Z0-9]+(\\.[a-zA-Z]+)+"; System.out.println(str.matches(reg)); 网络爬虫:emil String content="有事没事联系:112312@12.com 又是没事士大夫似的说的说的1211112312@22.cn1211dfsd1@22.cn.com"; String reg="[a-zA-Z1-9]\\w{5,7}@[a-zA-Z0-9]{2,}(\\.(com|cn|net)){1,2}"; Matcher matcher= pattern.matcher(content); while(matcher.find()) { System.out.println(matcher.group()); } 我认为的重点: \b 熟悉: 匹配的是位置 \b 匹配这样的位置:它的前一个字符和后一个字符不全是(一个是,一个不是或不存在) \w String str = "sshello world"; String reg="hello\\b"; Pattern pattern=Pattern.compile(reg); Matcher matcher= pattern.matcher(str); while(matcher.find()) { String name=matcher.group(); System.out.println(name); } 抽象出来直接看区别: **String str = “sshello world”; String reg=”hello\b”;** 返回hello 分析: 以hello结尾 **String str = “ss hello,world”; String reg=”\bhello”;** 返回hello 分析: 以hello开头 就用 “It’s a nice day today.” 举例说明: 正确的正则:\bnice\b 分析:第一个 \b 前面一个字符是空格,后面一个字符是 ‘n’,不全是 \w, 所以可以匹配出 ‘n’ 是一个单词的开头。第二个 \b 前面一个字符是 ‘e’, 后面一个字符是空格,不全是 \w,可以匹配出 ‘e’ 是一个单词的结尾。 所以,合在一起,就能匹配出以 ‘n’ 开头以 ‘e’ 结尾的单词, 这里就能匹配出 “nice” 这个单词。 举例: String str = “ss shello world”; String reg=”hello\b w”; 返回hello w 分析: 以hello结尾 空格w开始 的内容 String str = “ss shello world”; String reg=”hello\bw”; 失败 分析: hello后面跟着w 违反了\b前后不能同时为\w所以匹配不到 reg就写错了 String str = “ss shello,world”; String reg=”hello\b.w”; 返回 hello,w 虽然.是任何字符都行 但是还是要根据str来判断 如文中 ,不是\w所以可以匹配到 如果是String str = “ss shellosworld”; 则无法匹配到

优秀的个人博客,低调大师

Linux探索之路1---CentOS入坑笔记整理

前言 上次跟运维去行方安装行内环境,发现linux命令还是不是很熟练。特别是用户权限分配以及vi下的快捷操作。于是决定在本地安装一个CentOS虚拟机,后面有时间就每天学习一点Linux常用命令。 作为一个小白正式入坑CentOS了,于是就有了CentOS摸索系列。后续我会根据自己的摸索情况不间断更新。 安装 安装VMWare WorkStation:直接百度搜索下载安装即可,我这里安装的版本是VMware® Workstation 14 Pro。正版需要序列号,否则只能试用30天。这里我给出一些该版本的序列号: CG54H-D8D0H-H8DHY-C6X7X-N2KG6 ZC3WK-AFXEK-488JP-A7MQX-XL8YF AC5XK-0ZD4H-088HP-9NQZV-ZG2R4 ZC5XK-A6E0M-080XQ-04ZZG-YF08D ZY5H0-D3Y8K-M89EZ-AYPEG-MYUA8 安装CentOS: 直接进入CentOS官网https://www.centos.org/, 点击上方的Get CentOS.并且选择DVD版,我这里下载的版本是: CentOS-7-x86_64-DVD-1708.iso 创建新的虚拟机: 打开VMWare WorkStation, 点击“创建新的虚拟机”---》典型---》选择"安装程序光盘映像文件",选择刚刚下载的iso镜像文件,后续安装过程这里直接跳过 修改root密码 ​ 前面迷迷糊糊的安装完成之后,我需要下载一个东西,于是我使用yum install命令,发现需要root权限,于是我使用su root命令进行用户切换,需要输入root密码,我输入我创建的用户密码一致显示认证失败,完了。看来必须要改一次密码了...... ​ 好在修改密码并不复杂,这里给出一个正确可行的链接:https://linux.cn/article-3962-1.html。 总结了下,基本步骤也就包含以下几个: 启动的时候按e进入grab模式 找到fi后面那一行,将ro替换为rw init=/sysroot/bin/sh 按下Control + X 键,使用单用户模式启动 执行chroot命令,然后执行passwd开始进行密码修改 执行touch /.autorelabel更新系统信息,并执行exit退出chroot模式 执行reboot重启即可 网络连接不上 ​ 修改了root密码之后,切换到root模式下,我想使用yum install 命令下载,发现报了个网络连接不上的错误。于是我试了下: ping www.baidu.com, 竟然报了个name or service not know。无赖继续搜索解决方案,最终发现https://www.cnblogs.com/Lin-Yi/p/7787392.html所说的方案能够正常解决我的问题,这里将关键点列举一下: 添加DNS服务器: root用户执行vi /ect/resolv.conf, 在文件中添加如下两行: nameserver 8.8.8.8 nameserver 8.8.4.4 保存退出后重启虚拟机 修改网络配置: 执行命令vi /etc/sysconfig/network-scprits/ifcfg-ens33(文件名称ifcfg-ens33后面的数字可能不同,最好先进到对应目录ls看下),将文件中的onboot=no替换成onboot=yes .保存并退出 重启网络: root下执行service network restart 重启网络 注意网络配置: 一般情况下执行完前面步骤之后应该可以正常ping通,如果还不行的话,需确认虚拟机的网络适配器配置的是NAT模式 无法鼠标选中复制 ​ 这些基本的问题解决之后,发现鼠标在centOS中无法选中复制文字,于是继续搜索解决。最终解决方案如下: 安装gpm: 执行yum install gpm* 启动gpm服务: 执行service gpm start 将gpm服务添加为后台服务: 执行systemctl enable gpm.service 这里给出CentOS服务启用停用的相关方法: systemctl start [服务文件名] systemctl restart [服务文件名] systemctl stop [服务文件名] systemctl status [服务文件名] 设置开机启动 systemctl enable [服务文件名] systemctl disable [服务文件名] 安装VMTools ​ 安装了gpm之后文字可以在CentOS内部复制粘贴了,但是无法在虚拟机和主机之间进行复制。网上搜索说要安装VMTools,好吧开始安装。 主要参考下面两个链接: https://blog.csdn.net/warnerwu/article/details/73718901 https://www.cnblogs.com/mylinux/p/5612168.html ​ 本地XShell连接虚拟机 ​ 开始准备在CentOS中安装各种软件以方便虚拟机操作,后续一搜才发现,可以直接通过XShell连接CentOS。那直接通过XShell连接CentOS操作比打开丑陋的CentOS操作不是要爽的多。于是开始摸索XShell连接CentOS。 ​ 本来想通过固定虚拟机的IP,这样每次连接CentOS就不用修改IP。但是参照了网上的固定IP教程之后,蛋疼的事情发生了: 虚拟机连接不到网络......而且本机telnet虚拟机的22端口一直不通!! ​ 只有最后还原网络设置,折腾了几个小时终于又能ping通百度了。。 ​ 这里总结下XShell连接CentOS的相关设置: 开启CentOS的SSH服务: 默认情况下CentOS是默认自带SSH的,使用命令rpm -qa|grep ssh查看 是否安装了SSH,如果安装了话输出会大致如下: openssh-7.4p1-11.el7.x86_64 openssh-server-7.4p1-11.el7.x86_64 openssh-clients-7.4p1-11.el7.x86_64 libssh2-1.4.3-10.el7_2.1.x86_64 如果未安装则执行yum install openssh*安装对应的ssh服务。安装完成后通过命令systemctl status sshd查看该服务是否开启。如果未开启,则执行命令service sshd restart . 启动之后通过命令netstat -ant | grep 22进一步确认是否开启ssh的22号端口是否开启 关闭防火墙: systemctl stop firewalld.service #停止firewall systemctl disable firewalld.service #禁止firewall开机启动 firewall-cmd --state #查看默认防火墙状态(关闭后显示notrunning,开启后显示running) 关闭iptables: 如果未安装iptables这里直接跳过,如果安装了iptables这使用下面命令来关闭iptables: systemctl stop iptables.service #重启防火墙使配置生效 systemctl disable iptables.service #设置防火墙开机启动 ​ 之后就可以愉快地使用XShell来连接CentOS了 安装rzsz软件 ​ 刚安装的CentOS是不支持rz/sz命令的,这里直接使用yum install lrzsz进行安装 安装JDK ​ 网上一般给的安装步骤如下: 查找有哪些可安装的JDK: 执行命令 yum search jdk|grep java 安装JDK: 找到想要装的JDK版本,用对应的yum命令进行安装,我这里执行的是yum install java-1.8.0-openjdk.x86_64 ​ 需要注意的是这种情况下,只是安装了JRE。此时不管怎样都是无法启用javac命令的。这里还需要正确安装jdk: 使用rpm -qa | grep jdk查找刚刚安装的jdk,我这里查询的结果如下 java-1.8.0-openjdk-1.8.0.161-0.b14.el7_4.x86_64 java-1.8.0-openjdk-headless-1.8.0.161-0.b14.el7_4.x86_64 针对刚刚查询出来的jdk依次删除: yum -y remove java java-1.8.0-openjdk-1.8.0.161-0.b14.el7_4.x86_64 yum -y remove java java-1.8.0-openjdk-headless-1.8.0.161-0.b14.el7_4.x86_64 使用yum install java-devel直接安装原生的jdk即可 配置环境变量: sudo vi /ect/profile, 在文件最后两行之前加入如下配置: export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.161-0.b14.el7_4.x86_64 export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export PATH=$JAVA_HOME/bin:$PATH 重新启用配置文件: 执行命令 source /etc/profile 安装tomcat 安装wget支持: 执行yum install wget 下载tomcat安装包: 直接去tomcat官网找到tomcat的下载链接,然后通过wget命令去获取,我这里执行的命令如下:wget http://mirrors.shu.edu.cn/apache/tomcat/tomcat-9/v9.0.11/bin/apache-tomcat-9.0.11.tar.gz 解压刚下载的tomcat: 执行命令tar -zxvf apache-tomcat-9.0.7.tar.gz 验证: 进入tomcat的bin目录执行:sh startup.sh, 本机通过虚拟机IP:端口访问看是否成功 修改目录的所有者 ​ 在开始安装tomcat的过程中,我开始在创建tomcat目录是在root用户下操作的。后续我切换到tomcat用户发现wget没有权限写这个tomcat目录。于是通过以下命令将该目录以及其下的子目录权限全部改为tomcat用户: chown -R tomcat:tomcat tomcat 其中-R表示递归旗下的所有子目录 如何返回上一次输入的目录 ​ 直接执行cd - 即可返回上一次操作的目录。输入cd或者cd ~ 即可进入当前用户的根目录 黎明前最黑暗,成功前最绝望!

优秀的个人博客,低调大师

自定义控件探索之旅一1(笔记)

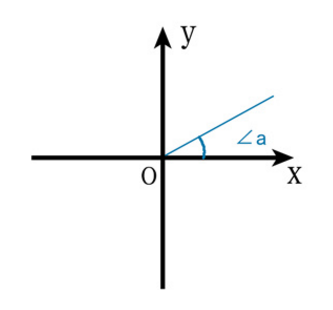
前言:自定义控件,是Android攻城狮进阶的必备技能,是Android应用研发的一门高级艺术,所以接下来的文章主要是学习和探索自定义控件,方便开发使用以及日后查阅。关于什么是自定义控件和为什么要使用自定义控件的这一些就不多说了,因为自定义控件设计的内容非常多,所以分几个系列去写,下面我们直接开始自定义控件探索之旅的第一篇。 安卓自定义View基础 : 坐标系 我们先来复习下坐标系,坐标系是我们初中代数里面学到的东西(美帝高中僧才开始接触,所以天朝的教育一向都是策马奔腾呐) 熟悉的坐标系 笛卡尔坐标系告诉我们,事物的一切抽象概念都是参照于其所属的坐标系存在的,同一个事物在不同的作标系中就会有不同抽象概念来表示,坐标系表达的事物有联系的抽象概念的数量(既坐标轴的数量)就是该事物所处空间的维度。图中蓝色线和角度a 是在第一象限内,第一象限的两个坐标(x 和 y)都是正值......回忆了这么多我们就打住吧否则越扯越远,说完了笛卡尔我们在说Android的屏幕坐标系,先上图 Android屏幕坐标系 按照笛卡尔的说法,事物的一切抽象概念都是参照于其所属的坐标系存在的。所以Android的屏幕也有参照物,(参照物数值化的具象化也就是 x y轴上的值 ,通过实际数值即可测量位置),但是Android的屏幕系的坐标是反的(主要指的是Y轴),其Y轴是向下的,屏幕的左上角为原点(x = 0,y = 0),从屏幕原点向左,x 轴数值会增大;从屏幕原点向下,y 轴数值会增大,反之。 所以:在常见的笛卡尔数学坐标系中角度增大方向为逆时针(0度到90度为逆时针);在默认的屏幕坐标系中角度增大方向为顺时针(因为 y轴的反的,所以角度增大方向为顺时针)。 B:View的坐标系 我们知道,Android屏幕上面会有很多的button imageView textView 这些View控件,每一个控件设置宽高,设置间距开发者都可以通过 xml 布局或者代码布局去实现。 首先:View的坐标系统是相对于父控件而言的 getTop(); //获取子View左上角距父View顶部的距离 getLeft(); //获取子View左上角距父View左侧的距离 getBottom(); //获取子View右下角距父View顶部的距离 getRight(); //获取子View右下角距父View左侧的距离 给大家上一幅图更有助于理解: View的坐标系 我们知道,在MotionEvent中 可以通过,event.getX() , event.getY() 去获取触摸点相对于其所在组件坐标系的坐标,但是它还有个很类似的API ,event.getRawX() , event.getRawY() ,这个API其实是获取触摸点相对于屏幕默认坐标系的坐标,上一幅图更有助于我们理解: MotionEvent 其中, e 是我们触摸的点;银灰色区域是我们的组件;黄色区域部分是屏幕的默认坐标系(也就是最外层)蓝色线调用的是 e.getY()获取的是触摸点到组件的距离;e.getRawY()获取的是触摸点到屏幕的距离。 安卓自定义View基础 : 角度与弧度 为什么自定义控件会涉及到角度(angle)与弧度(radian),这个是我们可以理解的,比如说我们自定义这样一个圆弧,你必须要计算它的弧度,所以又涉及到了数学的一些计算公式(千万别被数学公式吓到了,其实就是一些很基本的运算) 角度与弧度的定义? 首先,角度和弧度一样都是描述角的一种度量单位。 角度:两条射线从圆心向圆周射出,形成一个夹角和夹角正对的一段弧。当这段弧长正好等于圆周长的360分之一时,两条射线的夹角的大小为1度。(简单理解就是 我们口中最经常提及的角度,比如下面的一幅图,< AOB ,这就是角度) 弧度:两条射线从圆心向圆周射出,形成一个夹角和夹角正对的一段弧。当且仅当这段弧长正好等于圆的半径时,两条射线的夹角大小为1弧度。(既然是 弧 ,那么简单理解它对应的是一条曲线,度,是测量单位)。角度可能比较好理解,弧度可能有点晕,继续看图加深理解 弧度 当且仅当 AB的距离(注意,这里是弧长)等于 AO 或者 BO(半径)的时候,我们就称这是 1 弧度。所以,我们得知角度与弧度的换算公式:一个圆 对应的角度为360度(角度),对应的弧度为2π(弧度) 等价公式 : 360(角度) = 2π(弧度) == > 180(角度) = π(弧度) 进一步换算我们可以得知下面两个公式: 公式一:角度 = 180 / π * 弧度 公式二:弧度 = π / 180 * 角度 论证: 公式一,当弧度为 2 弧度的时候,角度 = 180 / π * 2 π = 360度 公式二,当角度为360度的是吧,弧度 = π / 180 * 360 = 2 π 安卓自定义View基础 : 颜色 原来我对颜色的理解就是简单的RGB值,查阅了资料才发现颜色居然这么讲究,首先,安卓支持的颜色模式有以下四种: 颜色模式 其中ARG、ARGB这些字母,它表示通道类型,数值表示该类型用多少位二进制来描述。如ARGB8888则表示有四个通道(ARGB),每个对应的通道均用8位来描述。 注意:我们常用的是ARGB8888和ARGB4444,而在所有的安卓设备屏幕上默认的模式都是RGB565,请留意这一点。 其中 A R G B 代表的意思分别是:A(Alpha)表示的是透明度,R(Red)表示红色,G(Green)代表的是绿色,B(Blue)代表的是蓝色。定义颜色的基本方式有两种,第一种是在代码中设置,通过Color这个类,就可以设置颜色值;第二种是在XML中设置,通过 # 符号开头,后面跟十六进制的值。 自定义控件探索之旅的第一篇主要就介绍到这里,第一篇主要介绍了安卓自定义控件的基础,主要内容有Android的坐标系、角度与弧度的换算、安卓的颜色介绍,第一篇的内容就是这样。 未完待续。。。 如果这篇文章对你有帮助,希望各位看官留下宝贵的star,谢谢。 Ps:著作权归作者所有,转载请注明作者, 商业转载请联系作者获得授权,非商业转载请注明出处(开头或结尾请添加转载出处,添加原文url地址),文章请勿滥用,也希望大家尊重笔者的劳动成果,谢谢。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册