首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

自定义控件探索之旅一1(笔记)

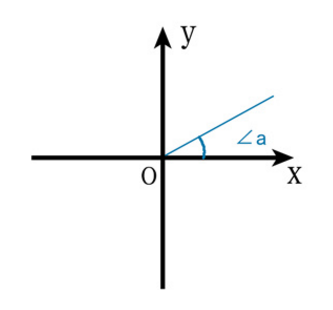
前言:自定义控件,是Android攻城狮进阶的必备技能,是Android应用研发的一门高级艺术,所以接下来的文章主要是学习和探索自定义控件,方便开发使用以及日后查阅。关于什么是自定义控件和为什么要使用自定义控件的这一些就不多说了,因为自定义控件设计的内容非常多,所以分几个系列去写,下面我们直接开始自定义控件探索之旅的第一篇。 安卓自定义View基础 : 坐标系 我们先来复习下坐标系,坐标系是我们初中代数里面学到的东西(美帝高中僧才开始接触,所以天朝的教育一向都是策马奔腾呐) 熟悉的坐标系 笛卡尔坐标系告诉我们,事物的一切抽象概念都是参照于其所属的坐标系存在的,同一个事物在不同的作标系中就会有不同抽象概念来表示,坐标系表达的事物有联系的抽象概念的数量(既坐标轴的数量)就是该事物所处空间的维度。图中蓝色线和角度a 是在第一象限内,第一象限的两个坐标(x 和 y)都是正值......回忆了这么多我们就打住吧否则越扯越远,说完了笛卡尔我们在说Android的屏幕坐标系,先上图 Android屏幕坐标系 按照笛卡尔的说法,事物的一切抽象概念都是参照于其所属的坐标系存在的。所以Android的屏幕也有参照物,(参照物数值化的具象化也就是 x y轴上的值 ,通过实际数值即可测量位置),但是Android的屏幕系的坐标是反的(主要指的是Y轴),其Y轴是向下的,屏幕的左上角为原点(x = 0,y = 0),从屏幕原点向左,x 轴数值会增大;从屏幕原点向下,y 轴数值会增大,反之。 所以:在常见的笛卡尔数学坐标系中角度增大方向为逆时针(0度到90度为逆时针);在默认的屏幕坐标系中角度增大方向为顺时针(因为 y轴的反的,所以角度增大方向为顺时针)。 B:View的坐标系 我们知道,Android屏幕上面会有很多的button imageView textView 这些View控件,每一个控件设置宽高,设置间距开发者都可以通过 xml 布局或者代码布局去实现。 首先:View的坐标系统是相对于父控件而言的 getTop(); //获取子View左上角距父View顶部的距离 getLeft(); //获取子View左上角距父View左侧的距离 getBottom(); //获取子View右下角距父View顶部的距离 getRight(); //获取子View右下角距父View左侧的距离 给大家上一幅图更有助于理解: View的坐标系 我们知道,在MotionEvent中 可以通过,event.getX() , event.getY() 去获取触摸点相对于其所在组件坐标系的坐标,但是它还有个很类似的API ,event.getRawX() , event.getRawY() ,这个API其实是获取触摸点相对于屏幕默认坐标系的坐标,上一幅图更有助于我们理解: MotionEvent 其中, e 是我们触摸的点;银灰色区域是我们的组件;黄色区域部分是屏幕的默认坐标系(也就是最外层)蓝色线调用的是 e.getY()获取的是触摸点到组件的距离;e.getRawY()获取的是触摸点到屏幕的距离。 安卓自定义View基础 : 角度与弧度 为什么自定义控件会涉及到角度(angle)与弧度(radian),这个是我们可以理解的,比如说我们自定义这样一个圆弧,你必须要计算它的弧度,所以又涉及到了数学的一些计算公式(千万别被数学公式吓到了,其实就是一些很基本的运算) 角度与弧度的定义? 首先,角度和弧度一样都是描述角的一种度量单位。 角度:两条射线从圆心向圆周射出,形成一个夹角和夹角正对的一段弧。当这段弧长正好等于圆周长的360分之一时,两条射线的夹角的大小为1度。(简单理解就是 我们口中最经常提及的角度,比如下面的一幅图,< AOB ,这就是角度) 弧度:两条射线从圆心向圆周射出,形成一个夹角和夹角正对的一段弧。当且仅当这段弧长正好等于圆的半径时,两条射线的夹角大小为1弧度。(既然是 弧 ,那么简单理解它对应的是一条曲线,度,是测量单位)。角度可能比较好理解,弧度可能有点晕,继续看图加深理解 弧度 当且仅当 AB的距离(注意,这里是弧长)等于 AO 或者 BO(半径)的时候,我们就称这是 1 弧度。所以,我们得知角度与弧度的换算公式:一个圆 对应的角度为360度(角度),对应的弧度为2π(弧度) 等价公式 : 360(角度) = 2π(弧度) == > 180(角度) = π(弧度) 进一步换算我们可以得知下面两个公式: 公式一:角度 = 180 / π * 弧度 公式二:弧度 = π / 180 * 角度 论证: 公式一,当弧度为 2 弧度的时候,角度 = 180 / π * 2 π = 360度 公式二,当角度为360度的是吧,弧度 = π / 180 * 360 = 2 π 安卓自定义View基础 : 颜色 原来我对颜色的理解就是简单的RGB值,查阅了资料才发现颜色居然这么讲究,首先,安卓支持的颜色模式有以下四种: 颜色模式 其中ARG、ARGB这些字母,它表示通道类型,数值表示该类型用多少位二进制来描述。如ARGB8888则表示有四个通道(ARGB),每个对应的通道均用8位来描述。 注意:我们常用的是ARGB8888和ARGB4444,而在所有的安卓设备屏幕上默认的模式都是RGB565,请留意这一点。 其中 A R G B 代表的意思分别是:A(Alpha)表示的是透明度,R(Red)表示红色,G(Green)代表的是绿色,B(Blue)代表的是蓝色。定义颜色的基本方式有两种,第一种是在代码中设置,通过Color这个类,就可以设置颜色值;第二种是在XML中设置,通过 # 符号开头,后面跟十六进制的值。 自定义控件探索之旅的第一篇主要就介绍到这里,第一篇主要介绍了安卓自定义控件的基础,主要内容有Android的坐标系、角度与弧度的换算、安卓的颜色介绍,第一篇的内容就是这样。 未完待续。。。 如果这篇文章对你有帮助,希望各位看官留下宝贵的star,谢谢。 Ps:著作权归作者所有,转载请注明作者, 商业转载请联系作者获得授权,非商业转载请注明出处(开头或结尾请添加转载出处,添加原文url地址),文章请勿滥用,也希望大家尊重笔者的劳动成果,谢谢。

优秀的个人博客,低调大师

Ansible yaml的语法、playbook文件例子(学习笔记十七)

1、ansible有两种调用方式,一种是临时语句,一种是yml文件调用,语法格式分别为: ansible all -m ping ansible-playbook test.yml 2、test.yml为yaml文件,yaml使用空白、缩进、分行组织数据。 3、yaml有如下几个基本规则: ·大小写敏感 ·缩进表示层级关系 ·禁止使用tab键 ·缩进长度没有限制,只要元素对齐就表示 这些元素属于一个层级 ·#号注释 4、yaml的数据结构有如下规则: ·使用冒号(:)表示键值对: age:12 name:huang ·使用连字符(-)表示数组: -a -b -c 5、复合使用的例子: languages: - Ruby - Perl - Python websites: YAML: yaml.org Ruby: ruby-lang.org Python: python.org Perl: use.perl.org 6、 test.yml --- - hosts: webservers gather_facts: false tasks: - name: chattr -i shell: chattr -i /etc/shadow - name: copy ssh key shell: echo 'xxxxxxxxx' |passwd --stdin root - name: chattr +i shell: chattr +i /etc/shadow hosts表示主机群组,gather_facts表示是否获取主机的信息,空格间的对齐必须严格,每个name代表一个任务,如果中间某个任务出错,下面的任务不会继续执行。

优秀的个人博客,低调大师

学习笔记CB005:关键词、语料提取

关键词提取。pynlpir库实现关键词提取。 # coding:utf-8 import sys import importlib importlib.reload(sys) import pynlpir pynlpir.open() s = '怎么才能把电脑里的垃圾文件删除' key_words = pynlpir.get_key_words(s, weighted=True) for key_word in key_words: print(key_word[0], 't', key_word[1]) pynlpir.close() 百度接口:https://www.baidu.com/s?wd=机器学习 数据挖掘 信息检索 安装scrapy pip install scrapy。创建scrapy工程 scrapy startproject baidu_search。做抓取器,创建baidu_search/baidu_search/spiders/baidu_search.py文件。 # coding:utf-8 import sys import importlib importlib.reload(sys) import scrapy class BaiduSearchSpider(scrapy.Spider): name = "baidu_search" allowed_domains = ["baidu.com"] start_urls = [ "https://www.baidu.com/s?wd=电脑 垃圾 文件 删除" ] def parse(self, response): filename = "result.html" with open(filename, 'wb') as f: f.write(response.body) 修改settings.py文件,ROBOTSTXT_OBEY = False,USER_AGENT = 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/50.0.2661.102 Safari/537.36' ,DOWNLOAD_TIMEOUT = 5 , 进入baidu_search/baidu_search/目录,scrapy crawl baidu_search 。生成result.html,正确抓取网页。 语料提取。搜索结果只是索引。真正内容需进入链接。分析抓取结果,链接嵌在class=c-container Div h3 a标签 href属性。url添加到抓取队列抓取。提取正文,去掉标签,保存摘要。提取url时,提取标题和摘要,scrapy.Request meta传递到处理函数parse_url,抓取完成后能接到这两个值,提取content。完整数据:url、title、abstract、content。 # coding:utf-8 import sys import importlib importlib.reload(sys) import scrapy from scrapy.utils.markup import remove_tags class BaiduSearchSpider(scrapy.Spider): name = "baidu_search" allowed_domains = ["baidu.com"] start_urls = [ "https://www.baidu.com/s?wd=电脑 垃圾 文件 删除" ] def parse(self, response): # filename = "result.html" # with open(filename, 'wb') as f: # f.write(response.body) hrefs = response.selector.xpath('//div[contains(@class, "c-container")]/h3/a/@href').extract() # for href in hrefs: # print(href) # yield scrapy.Request(href, callback=self.parse_url) containers = response.selector.xpath('//div[contains(@class, "c-container")]') for container in containers: href = container.xpath('h3/a/@href').extract()[0] title = remove_tags(container.xpath('h3/a').extract()[0]) c_abstract = container.xpath('div/div/div[contains(@class, "c-abstract")]').extract() abstract = "" if len(c_abstract) > 0: abstract = remove_tags(c_abstract[0]) request = scrapy.Request(href, callback=self.parse_url) request.meta['title'] = title request.meta['abstract'] = abstract yield request def parse_url(self, response): print(len(response.body)) print("url:", response.url) print("title:", response.meta['title']) print("abstract:", response.meta['abstract']) content = remove_tags(response.selector.xpath('//body').extract()[0]) print("content_len:", len(content)) 参考资料: 《Python 自然语言处理》 http://www.shareditor.com/blogshow/?blogId=43 http://www.shareditor.com/blogshow?blogId=76 欢迎推荐上海机器学习工作机会,我的微信:qingxingfengzi

优秀的个人博客,低调大师

HBase学习&实践笔记之HBase初探(to be continued...)

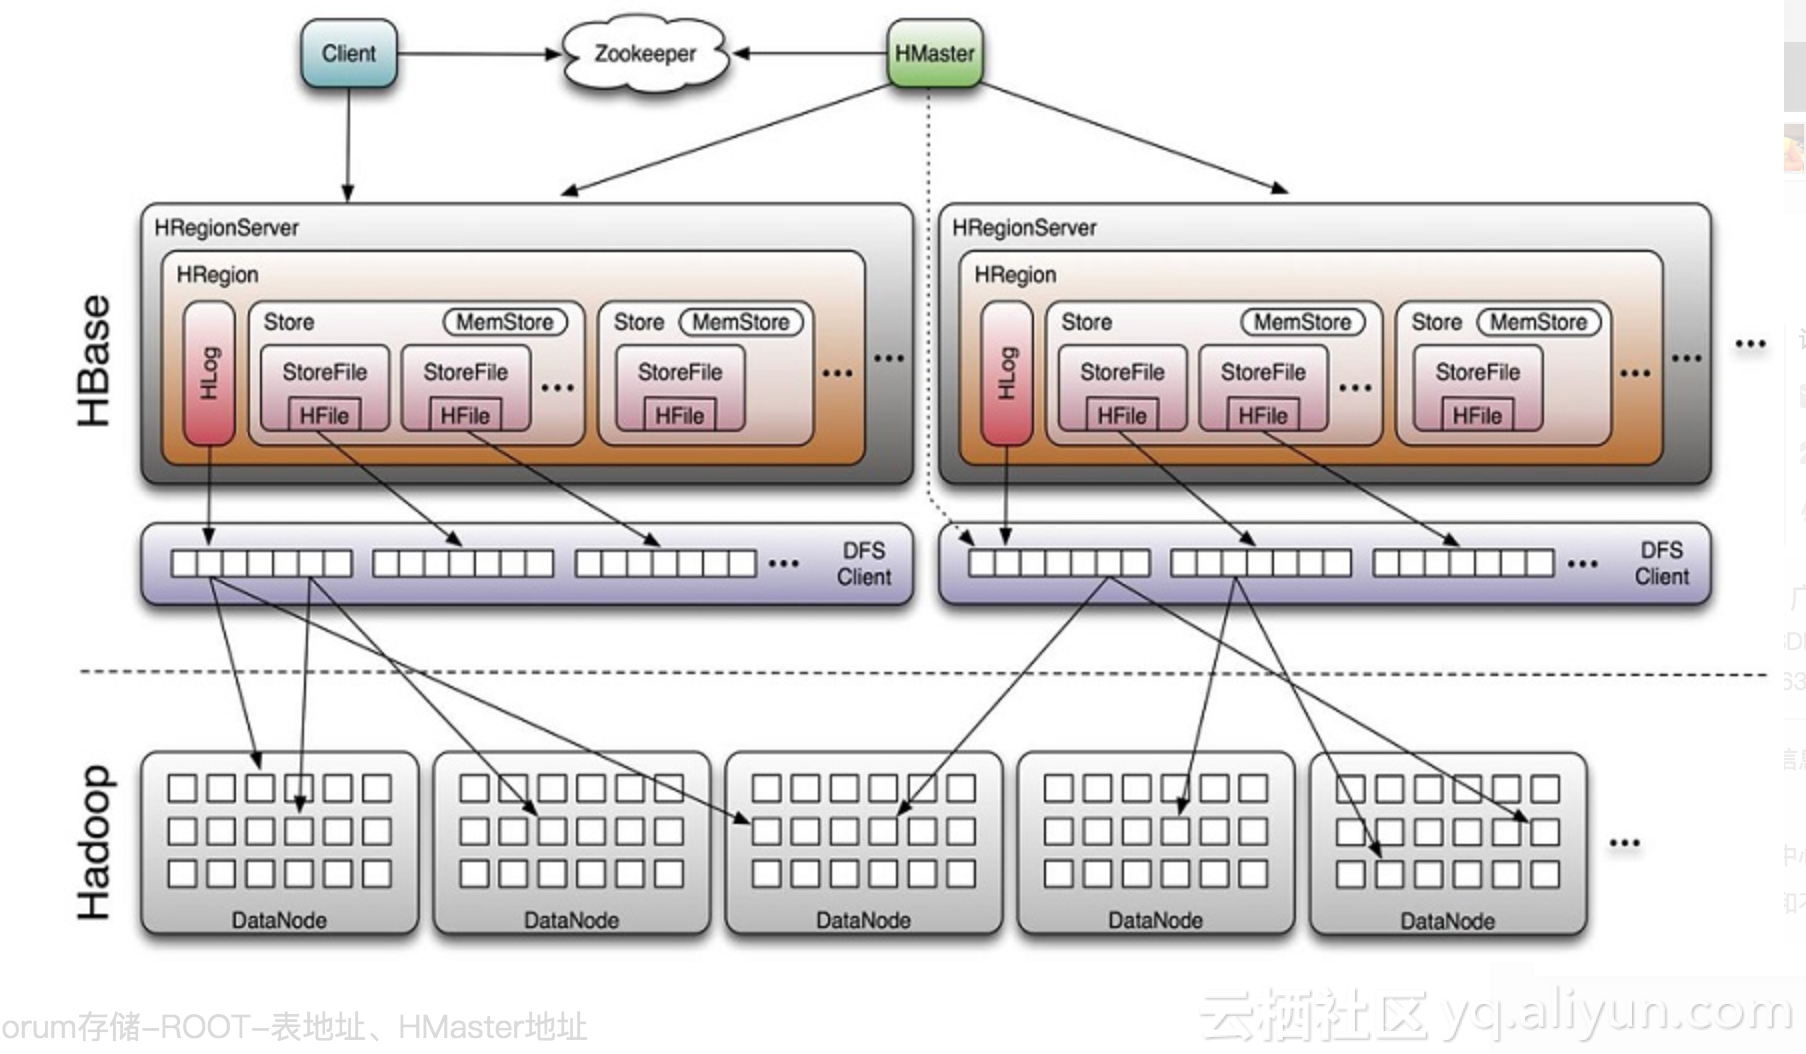
HBase初探 To be continued... HBase架构 HBASE的逻辑&物理存储结构 启动HBase HBase version: 1.2.6 Hadoop version: 3.0.0 伪分布式启动 hbasedir/conf/hbase-env.xml配好JAVA_HOME。 export JAVA_HOME=$(/usr/libexec/java_home) 我做了几个系统宏,方便命令执行。 alias starthbase='sudo /Users/fujianbo/Applications/hbase-1.2.6/bin/start-hbase.sh' alias stophbase='sudo /Users/fujianbo/Applications/hbase-1.2.6/bin/stop-hbase.sh' alias startresthbase='sudo /Users/fujianbo/Applications/hbase-1.2.6/bin/hbase rest start' alias hbaseshell='sudo /Users/fujianbo/Applications/hbase-1.2.6/bin/hbase shell' 伪分布式启动下,不需要开启zookeeper相关配置,否则在启动hbase控制台时会报错: ERROR [main] zookeeper.RecoverableZooKeeper: ZooKeeper exists failed after {N} attempts 分布式启动 DDL: 在控制台执行 Let's move! starthbase -> hbaseshell, 启动hbase并进入hbase控制台。 使用"put 'user','row1','info:name','jianbo'"命令往user表里插入一条rowkey='row1', value='jianbo'的纪录: 对于同一个rowkey,第二次put操作被认为是更新操作: 使用"get [tablename],[rowkey],[column family]"命令查询数据: 使用"disable [tablename]"命令失效表(注:非物理删除),表失效后已不能新增或者查询数据。 使用"enable [tablename]"生效已被失效的表,"drop [tablename]"物理删除表。 使用"describe [tablename]"查看表结构。 使用list命令查看"本地"数据库信息: 使用"scan [tablename]"全表扫描数据: 使用"deleteall [tablename],[rowkey]"删除整行数据: 使用"truncate [tablename]"删除指定表的所有数据: 其他系统命令 【查看连接hbase的用户信息】whoami

优秀的个人博客,低调大师

大数据学习笔记(二):Hadoop2.x概述

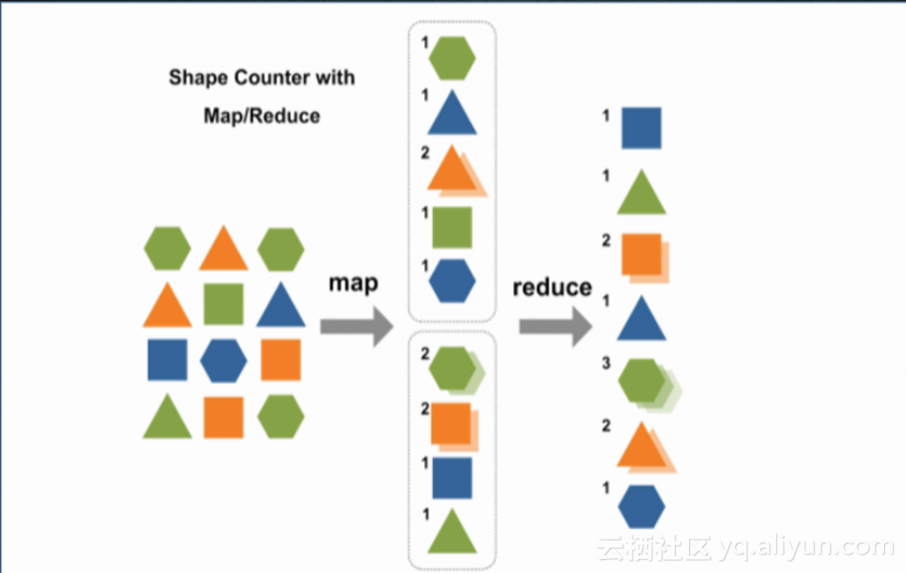
什么是Hadoop 开源的 可靠的:可以通过备份的数据恢复 可扩展:机器动态的增加或减少不会影响数据的存储和计算 分布式计算:多台机器并行的处理 Hadoop能做什么 海量数据的存储——HDFS 存储海量数据 动态的添加机器 备份 当数据收到损坏时,快速自动恢复 海量数据分析——mapreduce 核心理念:分而治之 处理海量的数据获得有价值的信息 mapreduce原理: 假设有海量的数据要我们来数其中各个图形的数目,我们可以简化一下,如上图,要数左边的个数,可以分给两个计算机去处理,最后何总得到结果。同样的,如果有大量数据,就可以分给百台计算机去处理。 任务调度和集群资源管理——YARN 资源管理(cpu,内存) 通过资源管理来合理安排任务,进行任务调度 Hadoop特点 扩容能力:动态增加或减少,并不会影响集群计算 成本低:普通的机器也能作为集群的结点 高效率:分布式计算 可靠性:默认备份三份,也可以指定备份多少 应用场景 日志分析:公司的每天产生的日志分析 推荐系统:淘宝购买物品之后,分析你的购物,推荐物品 来看一下课程中给的一张图:

优秀的个人博客,低调大师

DC学院学习笔记(十四):总体、采样及Error Bar

相关概念 1.采样相关概念 总体:研究对象的全体 样本:从总体中的随机抽样 采样偏差:是由于抽样过程中没有达到足够随机而产生 、 抽样的方式会严重影响样本的随机性,从而影响对总体的预测,抽样的方法有多种,可以使用一定的方法来减小采样误差,然而采样误差是无法避免的。 2.误差:不确定性的某种表示 标准差:使用标准差画error bar;用于表征数据分散程度 总体标准差: 样本标准差: Bootstrap置信区间:用总体统计量的估计区间画error bar;用于表征数据的波动范围 可重复采样:抽取的个体仍可参加下次采样,常用于估计总体统计量的置信区间 如何使用Bootstrap计算置信区间(Quantile算法):用重采样的采样方法,计算统计量并排序,取相应的分位数,作为置信区间的边界 推荐阅读:如果你有兴趣,可以阅读《An Introduction to the Bootstrap》这本书了解更多关于Bootstrap的知识和其他计算置信区间的方法 seaborn画图参数区别:1)使用标准差绘制error bar:ci=’sd’ 2)使用Bootstrap置信区间画error bar:ci & n_boot 代码如下: import pandas iris = pandas.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data') iris.columns=['sepal_length','sepal_width','petal_length','petal_width','species'] import seaborn %matplotlib inline seaborn.barplot(x='species',y='petal_length',data=iris,ci='sd') seaborn.barplot(x='species',y='petal_length',data=iris,ci=90,n_boot=1000) Error Bar:黑线即为Error Bar,在每一列上的Error Bar 表征:在给定的置信区间下,统计量的范围会在黑线内波动

优秀的个人博客,低调大师

DC学院学习笔记(十五):验证型数据分析

一些概念 1.随机变量:是试验结果的函数,是定义在样本空间$\Omega$上的实值函数:$X=X(\omega)$,随机变量一般用大写拉丁字母或小写希腊字母来表示 2.概率分布 关于随机变量,有一个非常值得关心的特性就是概率分布 概率:是一个在0-1之间的实数,度量随机事件发生的可能性,通常用于来量化某些不确定性命题 概率分布:在概率的基础上,一个随机变量所有的可能取值加上它取某一个值的概率,比如在投掷硬币的事件中,正反面的取值的概率分布就就是正面0.5,反面0.5 3.离散随机变量 定义:随机变量仅能取有限个或可列个值 4.连续随机变量 定义:随机变量的可能取值充满数轴上的一个区间,有无限个可能取值 如正态分布的曲线呈现一个钟型,也称为bell,由两个参数:均值(最高点在横轴的哪个位置)、方差(曲线的方差)确定,和Z检验密切相关 假设检验 假设检验是根据数据样本所提供的证据,肯定或否定有关总体的声明 假设检验的基本流程 假设检验一般分为三步 提出零假设,以及对应的备择假设 零假设前提下,推断样本统计量出现的概率(统计量可符合不同的分布,对应不同的概率分布有不同的检验方法) 设定拒绝零假设的阈值,样本统计量在零假设下出现的概率小于阈值,则拒绝零假设,承认备择假设 淑女品茶——假设检验的案例 来自于一位统计学家的女同事可以分辨奶茶是先加入牛奶还是茶的事例 1.零假设:女同事不能分辨;备择假设:女同事可以分辨 2.假设检验方法:让女同事连续判断8杯不同的奶茶 3.测试统计量:女同事判断正确的次数 4.结论:假设阈值设定为5%,在零假设的前提下,8杯全猜对的概率小于5%,拒绝零假设 单样本检验、双样本检验 1.单样本检验:针对一个样本空间里的一些统计量做单样本检验,常用的有单样本z检验,t检验 2.双样本检验:针对两个不同的样本空间的某一类统计数据做双样本检验,常用的有双样本t检验 验证型数据分析实践 P-value P-value:是假设检验的一个重要概念,为在零假设成立的时候,观察到样本的概率 如果小于我们设定的阈值,如5%,1%等的时候,我们转而接受备择假设,即P-value越小越拒绝原假设 阈值的选择通常为5%,1%,0.1%,具体视情况而定 1.单样本检验 单样本z检验 假设: 要检验的统计量近似满足正态分布 正态分布的密度函数: ,其中$\sigma$为方差,$\mu$为平均值 常见用途:检测总体平均值是否等于某个常数 中心极限定理:大量互相独立的随机变量,其均值的分布以正态分布为极限,中心极限定理支持了可以用正态分布来进行均值的判断 单样本z检验案例:原假设:掷硬币朝上和朝下的概率都为50%。连续抛掷硬币1000次,观察到700次朝上,在中心极限定理的前提下,这种情况出现的概率远远小于预先设定的参数,所以选择拒绝原假设 Python 实现: Python中和统计模型相关的一个包:statsmodels, #零假设:复旦大学男生平均身高175cm #备择假设:复旦大学男生平均身高不为175cm #需要先构造一个平均值为175,标准差为5,服从正态分布的样本X,样本量为100(你也可以尝试构造平均值为180,标准差为2,服从正态分布的样本,看看使用Z检验的得分区别) import numpy X=numpy.random.normal(175,5,100).round(1) #使用Z检验计算pval import statsmodels.stats.weightstats z,pval = statsmodels.stats.weightstats.ztest(X,value=175) print(pval) #直接返回的pval,即为P值可以用于判断零假设是否成立 0.235448153111 看来平均值还是很接近175的,那么下面我们可以看一下真实的平均值: import numpy as np np.mean(X) 174.45500000000001 ok,果然没错! 2. 单样本t检验 适用:适用于样本量较少的情况(n<30) 参数:t分布的参数为自由度,即样本数量减1(n-1);当自由度接近于30的时候,t分布趋向于正态分布,这也就说明了为什么t分布适用于样本量较少的情况,因为样本量大于30时,往往可以用z检验 Python实现: Python中用于进行t检验的包:Scipy #零假设:复旦大学男生平均身高175cm #备择假设:复旦大学男生平均身高不为175cm #使用t检验计算pval import scipy.stats t,pval=scipy.stats.ttest_1samp(X,popmean=175)#这里的X也需要事先构造 #直接返回的pval,即为P值可以用于判断零假设是否成立 print (pval) 0.238287606815 可以看出来跟单样本z检验的结果很接近,但是略高于(原因可以在两者的图像对比中看出来:t检验的边界情况的概率略高于z检验) 3.双样本检验 双样本t检验 适用:用于比较两组样本的平均值是否一致 Python实现: #零假设:复旦大学和上海交大男生平均身高一样 #备择假设:复旦大学和上海交大男生平均身高不一样 #双样本检验用到了scipy包的另一个函ttest_ind #注意,X1,X2需要事先自行创建 t,pval=scipy.stats.ttest_ind(X1,X2) #直接返回的pval,即为P值可以用于判断零假设是否成立

优秀的个人博客,低调大师

Android学习笔记--文件下载和SD卡的使用

MicrosoftInternetExplorer402DocumentNotSpecified7.8Normal0 1.使用http协议下载文件 //步骤 A):创建一个HttpURLConection对象 HttpURLConnectionurlConn=(HttpURLConnection)url.openConnection(); B):获取一个InputStream urlConn.getInputStream(); C):访问网络的权限 android.permission.INTERNET 例:1.声明控件对象(略) 2.获得控件对象(略) 3.绑定事件(略) 4.创建监听器对象 //封装方法httpDownloader PublicclassHttpDownloader{ PrivateURLurl=null; PublicStringdownload(StringurlStr){ StringBuffersb=newStringBuffer(); Stringline=null; BufferedReaderbuffer=null; Try{ //创建一个URL对象 Url=newURL(urlStr); //创建一个Http连接 HttpURLConnectionurlConn=(HttpURLConnection)url.openConnection(); //使用IO流读取数据 Buffer=newBufferedReader(newInputStreamReader(urlConn.getInputStream())); While((line=buffer.readline())!=null){ Sb.append(line); }catch(Execptione){ e.printStackTrace(); }finally{ Try{ Buffer.close(); }catch(Execptione){ e.printStackTrace(); } } Returndb.ToString(); } } //返回值-1.下载文件出错0下载成功1文件已存在 PublicintdownFile(StringurlStr,Stringpath,StringfileName){ InputStreaminputStream=null; Try{ FileUtilsfileUtils=newFileUtils(); If(fileUtils.isFileExists(path+fileName)){ Return1; }else{ InputStream=getInputStreamFromUrl(urlStr); FileresultFile=fileUtils.write2SDFromInput(path,fileName,inputStream); If(resultFile==null){ Return-1; } } }catch(Exceptione){ e.printStackTrace(); Return-1; }finally{ Try{ inputStream.close(); }catch(Execptione){ e.printStackTrace(); } } Return0; } //根据url得到输入流 PublicInputStreamgetInputStreamFromUrl(StringurlStr) ThrowsMalfromedURLExecption,IOExecption{ Url=newURL(urlStr); HttpURLConnectionurlConn=(HttpURLConnection)url.openConnection(); InputStreaminputStream=urlConn.getInputStream(); ReturninputStream; } } PublicvoidonClick(Viewv){ HttpDownloaderhttpDownloader=newHttpDownloader(); Stringlrc=httpDownloader.download("http://192.168.0.1:8080/XXX.txt"); System.out.println(lrc); } 2.将下载的文件写入SDCARD 访问SDCARD //得到当前设备sdka的目录 Environment.getExternalStorageDirectory(); //访问SD卡的权限 Android.permission.WRITE_EXTERNAL_STORAGE 例://一个完整的访问封装类 PublicclassFileUtils{ PrivateStringSDPATH; PublicStringgetSDPATH(){ ReturnSDPATH; } PublicFileUtils(){ SDPATH=Environment.getExternalStorageDirectory()+"/"; } //在SD卡上创建文件 PublicFilecreateSDFile(StirngfileName)throwsIOException{ Filefile=newFile(SDPATH+fileName); file.createNewFile(); Returnfile; } //在SD卡上创建目录 PublicFilecreateSDDir(StringdirName){ Filedir=newFile(SDPATH+dirName); Dir.mkdir(); Returndir; } //判断SD卡上的文件夹是否存在 PublicbooleanisFileExist(StringfileName){ Filefile=newFile(SDPATH+fileName); Returnfile.exists(); } //将一个inputStream里面的数据写入到SD卡上 Publicfilewrite2SDFromInput(Stringpath,stringfileName,InputStreaminput){ Filefile=null; OutputStreamoutput=null; Try{ createSDDir(path); File=createSDFile(path+fileName); Output=newFileOutPutStream(file); Bytebuffer[]=newbyte[4*1024]; While((input.read(buffer))!=-1){ Output.write(buffer); } Output.flush(); }catch(Exceptione){ e.printStackTrace(); }finally{ Try{ Output.close(); }catch(Exceptione){ e.printStackTrace(); } } Returnfile; } } 最后在AndroidManifest,xml中加入标签 <user-permissionandroid:name="android.permission.WRITE_EXTERNAL_STORAGE"/> 本文转自My_King1 51CTO博客,原文链接:http://blog.51cto.com/apprentice/1360569,如需转载请自行联系原作者

优秀的个人博客,低调大师

C++学习笔记第一天:基础

前言 N年前学的C,经过VB、JAVA、JS、C#等后辈的轮番蹂躏,当初学的那点儿东西早就还给老师了 现在有了在桌面端实现 Native + Web 的初衷,需要利用CEF开源组件来封装这个Native 所以,还是要对C++有个基本的认识,否则连Debug都找不到入口 开始 首先,菜鸟教程走起:http://www.runoob.com/cplusplus/cpp-tutorial.html 从头开始:基本语法、数据类型、变量类型、各种运算符、循环语句、分支语句。。。一路学习 教程里写的很细了,没必要再搬过来一次,只挑自己认为比较特殊的点摘出来,重点记忆 基本数据类型 类型 关键字 布尔型 bool 字符型 char 整型 int 单精度浮点型 float 双精度浮点型 double 无类型 void 宽字符型 wchar_t 一些基本类型可以使用一个或多个类型修饰符进行修饰: signed unsigned short long 给类型起名字 这个挺好玩的,可以用 typedef 为一个已有的类型取一个新的名字。 例如,下面的语句会告诉编译器,feet 是 int 的另一个名称: typedef int feet; feet distance; // 跟 int distance 的作用相同 枚举类型 定义枚举的一般形式: enum 枚举名{ 标识符[=整型常数], 标识符[=整型常数], ... 标识符[=整型常数]} 枚举变量; 例如: enum color { red, green, blue } c; c = blue; 定义常量 在 C++ 中,有两种简单的定义常量的方式: 1、使用 #define 预处理器 #define LENGTH 10 #define WIDTH 5#define NEWLINE '\n' 2、使用 const 关键字 const int LENGTH = 10;const int WIDTH = 5;const char NEWLINE = '\n'; 数组 double balance[10]; //声明数组 double balance[5] = {1000.0, 2.0, 3.4, 7.0, 50.0}; //声明并初始化数组 字符串 1、C风格字符串 char greeting[] = "Hello"; //来自:char greeting[6] = {'H', 'e', 'l', 'l', 'o', '\0'}; 2、C++ 引入的 string 类类型 #include <string> string str1 = "Hello";string str2 = "World"; 一些疑惑 1、C++的namespace跟JAVA的package根本不是一回事,需要详细了解,尤其是那个官方的std; 2、头文件(*.h)和源文件(*.cpp)的模式还不太理解,需要深入学习; 3、extern:在声明变量或函数时的一个关键字,一般用在头文件(*.h)里,意思是其声明的函数或变量可以在全局使用。具体含义暂不理解,挂起待查。 下一步 除了上面的三点疑惑以外,下一步就要学习C++的杀手锏 -- 指针与引用了! 总结 通过第一天的初步了解,个人感觉,相比于JAVA的有迹可循,C++实在顽固了些,另外VS用起来也感觉没有Eclipse顺手,还需要慢慢习惯 对我这样更偏重于Web前端的人来说,实在不喜欢这种体验,但既然开始了就要坚持下去,期待下一天吧 宠辱不惊,看庭前花开花落;去留无意,望天上云卷云舒

优秀的个人博客,低调大师

《C++标准程序库》读书笔记(三)

STL中的智能指针auto_ptr可以实现简单的内存自动回收,防止内存泄漏(memory leakage)。auto_ptr实际是一个类,在该类析构时自动调用delete,从而达到了内存回收的效果。但是,由于同一个指针同一时刻只能被一个auto_ptr占用,如果采用赋值操作(=)或者拷贝构造函数调用,就会发生所有权转移,例如: auto_ptr<int> p(new int(0)); auto_ptr<int> q; 此时,p拥有指向一个int的指针,q的指针为空。如果执行q=p;则,p指向空,q指向int;但是,这样所有权转换的问题同样发生在参数传递中,例如 void foo(auto_ptr<int> t); 如果调用 foo(p);那么p就丢失了指针,所以一个解决方法是用引用,例如: void foo1(auto_ptr<int>& t); void foo2 (const auto_ptr<int>& t); 两者都是可以的,不过foo1非常不安全,因为在函数里面很容易通过类似赋值的操作使t丢失指针,而foo2不会。例如 void foo2(const auto_ptr<int>& t) { auto_ptr<int> m; m=t; } 会发生编译错误,从而避免灾难的发生。但随之又出现一个很大的问题,就是auto_ptr类的拷贝构造函数,或者赋值函数。最理想的情况是这样(如果能成功,就不会有别的什么问题): auto_ptr(const auto_ptr& rhs):ap(rhs.release()){} 但由于上述的原因,会发生编译错误(因为调用了release(),而release()会改变成员变量,不再是const)。所以只能去掉const,变为 auto_ptr(auto_ptr& rhs):ap(rhs.release()){} 这样可以编译成功,而且往往也能正确运行,但是唯一的问题是: 当rhs为右值时会出现问题。 为了简化问题,先假设拷贝构造函数什么都不做,即: auto_ptr(auto_ptr& rhs){} 那么,如果有 auto_ptr<int> p(new int(10)),执行 auto_ptr<int> q(p),不会有任何问题,因为p是左值。但如果执行auto_ptr<int> q(auto_ptr<int>(new int(10))) ,则会发生编译错误,因为auto_ptr<int>(new int(10)) 是右值,对右值的引用只能是常引用,也就是"const auto_ptr& rhs"的形式。但这里要注意的是,刚才那段代码用VC编译没有任何问题,并且可以顺利运行,但是用GCC之类的标准c++就不能顺利编译。 在VC中auto_ptr<int>& p=auto_ptr<int>(new int(0)) 是合法的,但在标准C++中是不合法的,只有const auto_ptr<int>& p=auto_ptr<int>(new int(0)) 才是合法的,也即在标准C++中,对右值的引用只能是常引用。所以说,要在标准C++中实现 auto_ptr<int> p(auto_ptr<int>(new int(0))) 就变得不可能了,因为如上所说,拷贝构造函数是这样的形式:auto_ptr(auto_ptr<T>& rhs):ap(rhs.release()){} 但是不能把右值传到一个非常引用中。但毕竟有聪明的人能想到解决办法,利用代理类( proxy class)声明如下结构,为了方便,我用int代替模板参 struct auto_ptr_ref { int* p; auto_ptr_ref(int *t):p(t){} }; 然后在auto_ptr类中增加了以下函数 auto_ptr(auto_ptr_ref rhs):ap(rhs.p){} auto_ptr& operator=(auto_ptr_ref rhs){reset(rhs.p); return *this;} operator auto_ptr_ref(){return auto_ptr_ref(release());} 之后,如果在标准C++有以下调用(VC中也会按照这个步骤调用,虽然没有auto_ptr_ref它也能直接调用) auto_ptr<int> p(auto_ptr<int>(new int(0))) 便可以成功,过程如下: 1. 构造临时对象 auto_ptr<int>(new int(0)) 2. 想将临时对象通过拷贝构造函数传给p,却发现没有合适的拷贝构造函数,因为只有auto_ptr(auto_ptr& rhs)这个不能用,又没有auto_ptr(const auto_ptr& rhs) (因为用了在所有权转移中会出错)! 3. 编译器只能曲线救国,看看类型转换后能不能传递。 4. 由于我们定义了 operator auto_ptr_ref() 所以编译器自然就可以试一下转为 auto_ptr_ref类型。 5. 编译器猛然间发现,我们定义了 auto_ptr(auto_ptr_ref rhs):ap(rhs.p){} 的构造函数,可以传递。 6. 顺利构造p,任务完成。 其实说白了问题很简单,因为构造函数不能接受右值,则取中间左值=右值, 然后再让函数接受中间左值。 而这一系列过程正是利用编译器能够自动进行类型转换而完成的。 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2008/08/19/1271700.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

《C++标准程序库》读书笔记(四)

, 复制代码 #include <iostream> #include <list> #include <algorithm> using namespace std; int main() { list<int> coll; list<int>::iterator pos25,pos35,pos; for(int i=20;i<=40;++i) coll.push_back(i); pos25 = find(coll.begin(),coll.end(),25); pos35 = find(coll.begin(),pos25,35); if(pos35!=pos25) {//pos35在pos25前 pos = find(coll.begin(),pos25,30); } else {//pos25在pos35前 pos = find(pos25,coll.end(),30); } cout<<"num: "<<*pos<<endl; system("pause"); return 0; } 复制代码 使用仿函数 复制代码 #include <functional> /* class for the compose_f_gx_hx adapter*/ template <class OP1, class OP2, class OP3> class compose_f_gx_hx_t : public std::unary_function<typename OP2::argument_type, typename OP1::result_type> { private: OP1 op1; // process: op1(op2(x),op3(x)) OP2 op2; OP3 op3; public: // constructor compose_f_gx_hx_t (const OP1& o1, const OP2& o2, const OP3& o3) : op1(o1), op2(o2), op3(o3) { } // function call typename OP1::result_type operator()(const typename OP2::argument_type& x) const { return op1(op2(x),op3(x)); } }; /* convenience function for the compose_f_gx_hx adapter*/ template <class OP1, class OP2, class OP3> inline compose_f_gx_hx_t<OP1,OP2,OP3> compose_f_gx_hx (const OP1& o1, const OP2& o2, const OP3& o3) { return compose_f_gx_hx_t<OP1,OP2,OP3>(o1,o2,o3); } 复制代码 复制代码 #include <iostream> #include <list> #include <algorithm> #include <functional> #include "compose21.hpp" using namespace std; int main() { list<int> coll; list<int>::iterator pos; for(int i=20;i<=40;++i) coll.push_back(i); pos = find_if(coll.begin(),coll.end(), compose_f_gx_hx(logical_or<bool>(), bind2nd(equal_to<int>(),25), bind2nd(equal_to<int>(),35))); cout<<"num: "<<*pos<<endl; system("pause"); return 0; } 复制代码 2,三种迭代器适配器: 1) Insert iterator 插入位置可以是容器的最前或最后,或是在某一特定位置上. 复制代码 #include <iostream> #include <vector> #include <list> #include <deque> #include <set> #include <algorithm> using namespace std; int main() { list<int> coll1; // insert elements from 1 to 9 into the first collection for (int i=1; i<=9; ++i) { coll1.push_back(i); } // copy the elements of coll1 into coll2 by appending them vector<int> coll2; copy (coll1.begin(), coll1.end(), // source back_inserter(coll2)); // destination // copy the elements of coll1 into coll3 by inserting them at the front // - reverses the order of the elements deque<int> coll3; copy (coll1.begin(), coll1.end(), // source front_inserter(coll3)); // destination // copy elements of coll1 into coll4 // - only inserter that works for associative collections set<int> coll4; copy (coll1.begin(), coll1.end(), // source inserter(coll4,coll4.begin())); // destination return 0; } 复制代码 back_inserter的内部调用push_back(),在容器尾端插入元素,只有在提供有push_back()成员函数的容器中才能使用,这样的容器有:vector,deque,list. front_inserter的内部调用push_front(),在容器最前端插入元素,只有在提供有push_ front()成员函数的容器中才能使用,这样的容器有deque和list;一般性的inserter,作用是将元素插入”初始化时接受之第二参数”所指的位置的前方.它内部调用insert(). 2)Stream iterator.这是用来读写流的迭代器. 复制代码 #include <iostream> #include <vector> #include <string> #include <algorithm> #include <iterator> using namespace std; int main() { vector<string> coll; copy (istream_iterator<string>(cin), // start of source istream_iterator<string>(), // end of source back_inserter(coll)); // destination sort (coll.begin(), coll.end()); unique_copy (coll.begin(), coll.end(), // source ostream_iterator<string>(cout,"\n")); // destination } 复制代码 3)Reverse iterator 复制代码 #include <iostream> #include <vector> #include <algorithm> #include <iterator> using namespace std; int main() { vector<int> coll; // insert elements from 1 to 9 for (int i=1; i<=9; ++i) { coll.push_back(i); } // print all element in reverse order copy (coll.rbegin(), coll.rend(), // source ostream_iterator<int>(cout," ")); // destination cout << endl; } 复制代码 3,移除元素 复制代码 #include <iostream> #include <list> #include <algorithm> #include <iterator> using namespace std; int main() { list<int> coll; // insert elements from 6 to 1 and 1 to 6 for (int i=1; i<=6; ++i) { coll.push_front(i); coll.push_back(i); } // print all elements of the collection copy (coll.begin(), coll.end(),ostream_iterator<int>(cout," ")); cout << endl; list<int>::iterator end = remove (coll.begin(), coll.end(),3);//新的尾节点 // print resulting elements of the collection copy (coll.begin(), end,ostream_iterator<int>(cout," ")); cout << endl; // print number of resulting elements cout << "number of removed elements: "<< distance(end,coll.end()) << endl; // remove ``removed'' elements coll.erase (end, coll.end()); // print all elements of the modified collection copy (coll.begin(), coll.end(),ostream_iterator<int>(cout," ")); cout << endl; } 复制代码 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2008/08/27/1278096.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

docker学习笔记002-docker-engine安装过程

虚拟机内核版本: Linux SHDL009020142 2.6.32-642.el6.x86_64 #1 SMP Wed Apr 13 00:51:26 EDT 2016 x86_64 x86_64 x86_64 GNU/Linux 采用手动安装方式,安装docker-engine 直接下载文件安装 [baseuser@SHDL009020139 ~]$ wget https://yum.dockerproject.org/repo/main/centos/6/Packages/docker-engine-1.7.1-1.el6.x86_64.rpm 安装依赖 [baseuser@SHDL009020139 ~]$ sudo yum install -y libcgroup-* [baseuser@SHDL009020139 ~]$ rpm -ivh docker-engine-1.7.1-1.el6.x86_64.rpm warning: docker-engine-1.7.1-1.el6.x86_64.rpm: Header V4 RSA/SHA1 Signature, key ID 2c52609d: NOKEY error: Failed dependencies: xz is needed by docker-engine-1.7.1-1.el6.x86_64 报错提示安装依赖XZ, [baseuser@SHDL009020139 ~]$ yum search xz Loaded plugins: product-id, search-disabled-repos, subscription-manager =========================================================== N/S Matched: xz =========================================================== xz.x86_64 : LZMA compression utilities xz-devel.i686 : Devel libraries & headers for liblzma xz-devel.x86_64 : Devel libraries & headers for liblzma xz-libs.i686 : Libraries for decoding LZMA compression xz-libs.x86_64 : Libraries for decoding LZMA compression xz-lzma-compat.x86_64 : Older LZMA format compatibility binaries Name and summary matches only, use "search all" for everything. [baseuser@SHDL009020139 ~]$ sudo yum install -y xz-* [baseuser@SHDL009020139 ~]$ rpm -ivh docker-engine-1.7.1-1.el6.x86_64.rpm warning: docker-engine-1.7.1-1.el6.x86_64.rpm: Header V4 RSA/SHA1 Signature, key ID 2c52609d: NOKEY error: can't create transaction lock on /var/lib/rpm/.rpm.lock (Permission denied) [baseuser@SHDL009020139 ~]$ sudo rpm -ivh docker-engine-1.7.1-1.el6.x86_64.rpm warning: docker-engine-1.7.1-1.el6.x86_64.rpm: Header V4 RSA/SHA1 Signature, key ID 2c52609d: NOKEY Preparing... ########################################### [100%] 1:docker-engine ########################################### [100%] 查询已安装的docker [baseuser@SHDL009020139 ~]$ yum list installed | grep docker docker-engine.x86_64 1.7.1-1.el6 installed [baseuser@SHDL009020139 ~]$ [baseuser@SHDL009020139 ~]$ ps -ef|grep docker baseuser 4460 3491 0 11:43 pts/0 00:00:00 grep docker [baseuser@SHDL009020139 ~]$ sudo service docker start [sudo] password for baseuser: Starting cgconfig service: [ OK ] Starting docker: [ OK ] [baseuser@SHDL009020139 ~]$ ps -ef|grep docker root 4506 1 2 11:44 pts/0 00:00:00 /usr/bin/docker -d baseuser 4622 3491 0 11:44 pts/0 00:00:00 grep docker [baseuser@SHDL009020139 ~]$ sudo docker run hello-world Hello from Docker! This message shows that your installation appears to be working correctly. To generate this message, Docker took the following steps: 1. The Docker client contacted the Docker daemon. 2. The Docker daemon pulled the "hello-world" image from the Docker Hub. 3. The Docker daemon created a new container from that image which runs the executable that produces the output you are currently reading. 4. The Docker daemon streamed that output to the Docker client, which sent it to your terminal. To try something more ambitious, you can run an Ubuntu container with: $ docker run -it ubuntu bash Share images, automate workflows, and more with a free Docker ID: https://cloud.docker.com/ For more examples and ideas, visit: https://docs.docker.com/engine/userguide/ [baseuser@SHDL009020139 ~]$ sudo docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES e5f07cbd2647 hello-world "/hello" 33 seconds ago Exited (0) 32 seconds ago grave_turing [baseuser@SHDL009020139 ~]$ docker version Client version: 1.7.1 Client API version: 1.19 Go version (client): go1.4.2 Git commit (client): 786b29d OS/Arch (client): linux/amd64 Server version: 1.7.1 Server API version: 1.19 Go version (server): go1.4.2 Git commit (server): 786b29d OS/Arch (server): linux/amd64 [baseuser@SHDL009020139 ~]$ 卸载 [baseuser@SHDL009020139 ~]$ yum list installed | grep docker docker-engine.x86_64 1.7.1-1.el6 installed 删除安装包 [baseuser@SHDL009020139 ~]$ sudo yum -y remove docker-engine.x86_64 [baseuser@SHDL009020139 ~]$ yum list installed | grep docker [baseuser@SHDL009020139 ~]$ 以上安装过程。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册