首页 文章 精选 留言 我的

精选列表

搜索[AI漏洞挖掘],共10000篇文章
优秀的个人博客,低调大师

Qdrant —— 面向下一代 AI 应用的矢量数据库

Qdrant 是一个矢量相似度搜索引擎和矢量数据库。它提供了一个生产就绪的服务,带有一个方便的 API 来存储、搜索和管理点 —— 带有额外有效载荷的矢量 Qdrant 是为扩展过滤支持而定制的。它使它可用于各种神经网络或基于语义的匹配、分面搜索和其他应用程序。 Qdrant 是用 Rust 编写的,即使在高负载下也能快速可靠。可参阅基准。借助 Qdrant,嵌入或神经网络编码器可以变成成熟的应用程序,用于匹配、搜索、推荐等。也可在云中使用https://cloud.qdrant.io/ 特性: 过滤和有效载荷 Qdrant 使 JSON 有效载荷与向量相关联,从而根据有效载荷值提供存储和过滤。它支持 should、must 和 must_not 条件的各种组合,确保检索所有相关的向量,与 ElasticSearch post-filtering 不同。 丰富的数据类型 矢量负载适应不同的数据类型和查询条件,包括字符串匹配、数值范围、地理位置等。这些过滤条件使你能够在相似性匹配之上创建自定义业务逻辑。 Query Planning 和 Payload Indexes Query planner利用存储的有效负载信息来优化查询执行。例如,受过滤器限制的较小搜索空间可能会受益于对索引的完全暴力破解。 SIMD 硬件加速 Qdrant 利用现代 CPU x86-x64 架构,在现代硬件上提供更快的搜索性能。 Write-Ahead Logging Qdrant 通过更新确认确保数据持久性,即使在断电期间也是如此。更新日志存储所有操作,可以毫不费力地重建最新的数据库状态。 分布式部署 从v0.8.0开始,Qdrant 支持分布式部署。多台 Qdrant 机器形成一个集群,用于水平扩展,通过Raft协议进行协调。 Stand-alone Qdrant 独立运行,不依赖外部数据库或编排控制器,简化了配置。

优秀的个人博客,低调大师

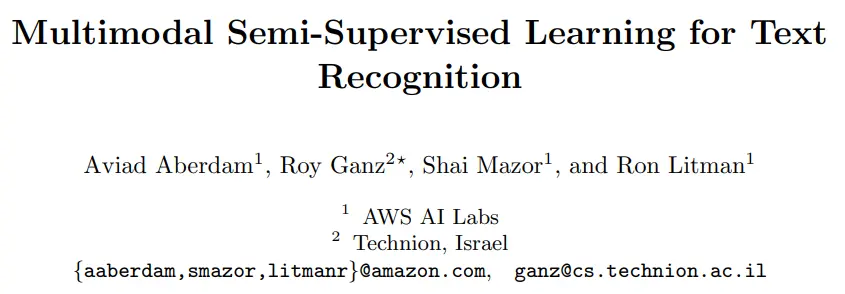
带你读AI论文丨针对文字识别的多模态半监督方法

摘要:本文提出了一种针对文字识别的多模态半监督方法,具体来说,作者首先使用teacher-student网络进行半监督学习,然后在视觉、语义以及视觉和语义的融合特征上,都进行了一致性约束。 本文分享自华为云社区《一种针对文字识别的多模态半监督方法》,作者: Hint 。 摘要 直到最近,公开的真实场景文本图像的数量仍然不足以训练场景文本识别器。因此,当前大多数的训练方法都依赖于合成数据并以全监督的方式运行。然而,最近公开的真实场景文本图像的数量显着增加,包括大量未标记的数据。利用这些资源需要半监督方法;然而,这些方法不能直接适配文字识别这类视觉语言的多模态结构。因此,本文提出了半监督多模态文本识别器(SemiMTR),它在训练阶段中,利用每个模态的未标记数据。此外,本文的方法并不需要额外的训练阶段,保持了当前的三阶段多模态训练策略。 首先,在视觉模型方面,本文提出了一个将自监督预训练和强监督训练结合的单阶段训练模型。然后,语言模型是在一个大型文本语料库上进行自监督预训练。得到两个模态的预训练模型之后,对文字识别进行半监督训练。本文采用的是teacher-student的结构,具体来说,对一张文本图像分别进行弱数据扩增和强数据扩增,然后对两个网络不同模态的输出进行一致性约束。大量实验证实本文的方法优于当前的训练方案,并在多个场景文本识别基准上取得了最先进的结果。 方法 1. 识别模型框架: 首先,本文的文字识别框架采用的是ABINet。大致流程如下:首先,视觉模型首先提取图像的特征序列并将其解码成字符序列;接着,将字符序列输入给语言模型,得到文本的语义特征;最后,使用一个融合模块,将视觉和语义特征进行融合,得到最终的识别结果。为了进一步提高识别性能,可以采用迭代的方式,多次对识别结果进行微调。 2. 视觉模型预训练 本文将自监督预训练与强监督预训练融合到了一个统一的框架下。自监督预训练采用的是基于对比学习的方法,在自监督的同时,也会对这些数据进行有标注的强监督预训练。 3. 基于一致性约束的半监督训练 首先,本文采用的是一个常见的teacher-student网络,进行半监督训练。具体来说,将前面得到的预训练模型作为teacher和student网络的初始化模型,然后对同一张输入图像进行弱数据扩增和强数据扩增,并分别输入到teacher和student网络中;将teacher网络的预测结果作为伪标签对student的输出进行监督。区别于一般的半监督学习,本文的方法对识别模型的各个模态都进行不同程度的一致性约束,比如视觉模型,语言模型和融合模型的输出。 实验 可以看到,本文的结果在多个数据集上取得了一致性的提升。 可以看到,在视觉预训练阶段,统一自监督预训练和强监督预训练比分阶段的训练效果要好。 可以看到,使用交叉熵loss作为一致性约束loss效果最好。 由于本文采用的识别模型,具有视觉、语言和融合的模态,所以在进行一致性约束的时候,teacher网络和student网络可以采用不同的特征分别进行对齐。从上表可以看到,当teacher和student网络中的vision,language和fusion模块分别进行对齐的时候,效果最好。 论文链接:[2205.03873] Multimodal Semi-Supervised Learning for Text Recognition (arxiv.org) 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册