首页 文章 精选 留言 我的

精选列表

搜索[腾讯云 WAND],共10000篇文章
优秀的个人博客,低调大师

bali 3.2.0 发布:云原生 Python 框架带来的重大变化

更新内容: 新增 引入manager概念🥂 新的优雅的 API 定义🥂PR#122 增加db.Basedeclarative_base 应用增加__clear__方法,方便单元测试 为注册的 Resource 生成 gRPC 服务类🍕PR#125 引入pytest-grpc作为 gRPC 单元测试组件 调整 移除connection.retry_on_deadlock_decorator 移除connection.close_connection 移除bali.schema, 用bali.schemas替代 标识GRPCTestBase废弃, 并将于 v3.5 移除 增加更多的单元测试保证软件质量 🏄‍ 修复 修复请求及项目的初始问题 修复 ModelResource 在注册模式下的问题 -- 让我们来详解一下几个比较大的变化点吧: Model 新增 manager 概念 相信 Django 是很多 Pythonista 的入门框架,Django 的 Model 里面的文档 advanced 部分有关于 manager 的介绍,https://docs.djangoproject.com/en/4.0/topics/db/managers/。Bali 3.2 引入的 manager 概念与 Django 里面的 manager 概念非常相似,只不过调用方式不同。 # Sync user = User.io.first() # Async user = await User.aio.first() Model 新增优雅的异步 API 方案 近些年大部分的语言都拥有了完善的异步 IO 方案,从早期的 JavaScript 里面的 defer、 promise,到 Java 里面的 Netty,Go 里面的 Goroutine。不管哪个方案,都没有 Python 里面这么纠结的就是同步和异步是同时需要提供的。像 JavaScript 的 promise,内置的网络请求返回的总是 promise 对象,你只能用异步 IO 的思维去处理。 还未发布的 Django 4.1 已经在 Model 层增加了异步方法,API 如下: Person.objects.acreate(first_name="Bruce", last_name="Springsteen") Person.objects.afirst(first_name="Bruce", last_name="Springsteen") 可以看到,Django 的 QuerySet 及 Manager 对异步的支持是在原有的单词上增加了 `a`,个人觉得这样让代码可读性及语义化受到了干扰,create 一眼就知道是创建的意思,`acreate`是什么,如果我熟悉 Django,我会猜到这是异步的调用方式,是一个 awatable 的函数。如果业务里面需要自定义一个函数呢,比如 choose_best,这时按 Django 的方案就是 achoose_best 表示异步 IO 的方式。可以看出,choose 并不像 get、create 这么常见的时候,achoose 让我们产生了疑问,单词拼写错误?看 PyCharm 已经用波浪线提示拼写错误了。 Bali 里采用的 API 方案是 Query 使用 io/aio 来区分同步和异步,而对于 Model,自动根据当前的上下文来自适应,看一下使用示例: 使用 Manager 时 # sync user = User.io.create(username=username) # async user = await User.aio.create(username=username) 使用 Model 的实例时 异步示例: async with db.async_session() as session: result = await session.execute( select(User).where(User.username == username) ) user = result.scalars().first() # 由于 user 是在 async_session 的 context 里面查询出来的 # 所以 user 的自带的实例方法(save, delete 等)都自动转换成了异步方法 await user.save() 同步示例: user = User(username=username) user.save() 简化的注册 Resource 的方式 3.2 版本引入了 Resource 的注册使用方式,为了配合这个方式,Bali 将 Application 进行了大量重构及优化。这样一来,main.py 启动入口的代码得到了极大程度的精简。我们看一下对比: 之前版本需要将 HTTP 服务的 routers 及 RPC 服务的 service 分别传入,3.2 的版本只需要指定 title 及注册 Resource 就可以了。对应的 routers 及 service 会在启动时自动去动态生成。 我们再来看一下 Resource 转成 HTTP 服务的方式变化: 之前需要手动在 urls.py 里面手动注册,3.2 将 resource 注册到 app 后,路由相关的文件全部可以移除,是一个可选项。当然旧项目升级时,完全不受影响,因为原来的方案也注册的方式兼容,同时使用原来的定义方案及注册的方式也是可以正常的。 gRPC 的服务文件的极度简化 为什么说是极度简化呢,因为原来的 gRPC 的文件 services/rpc/service.py 这个文件直接可以移除了。 gRPC 的服务文件的极度简化 项目结构 layout structure 的变化对比: 除了 core、logic、biz 等概念,services 也从固定的结构被成了灵活结构,关键是整个 services 都是可选的。如果所有的业务都使用 Resource 开发,将没有 services 文件夹。

优秀的个人博客,低调大师

OPPO自研云原生分布式任务调度平台

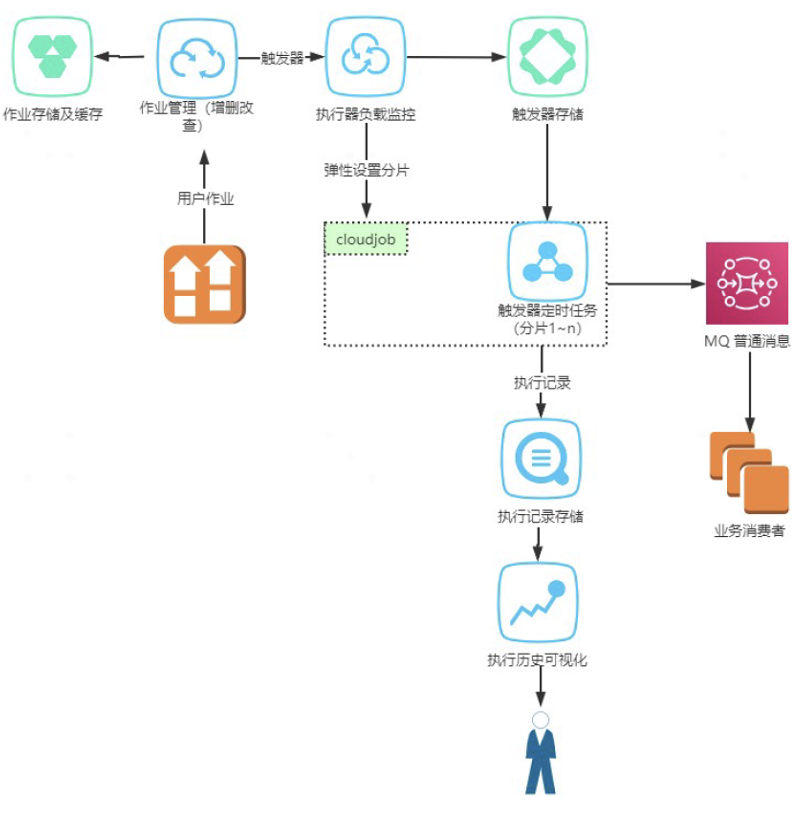
1.概述 在软件开发过程中,经常会遇到需要执行定时任务的场景。目前业界执行定时任务的分布式任务调度平台主要有XXL-Job和Elastic-Job,两者都属于轻量级的调度平台,能满足一定任务数量的作业同时调度,但是如果任务调度量增加到1万TPS甚至10万TPS,就会遭遇性能瓶颈,出现很多超时任务。 在OPPO内部,有些业务部门存在海量作业同时调度的场景,目前业界的任务调度框架难以满足业务需求,所以OPPO公司的中间件团队自主研发了一个分布式任务调度平台CloudJob,它是一个高性能(百万级TPS),低延迟(毫秒级),统一,稳定,精准并满足复杂多样定时任务场景的调度平台。它的特点如下: (1)简单:用户可以通过页面对任务进行CRUD操作,也可以通过提供的SDK对任务进行管理,方便快捷。 (2)动态:支持动态修改任务状态、启动/停止任务,以及终止运行中任务,即时生效。 (3)一致性:“调度中心”通过分布式锁保证集群分布式调度的一致性, 一次任务调度只会触发一次执行。 (4)高性能、低延迟:支持百万级任务同时调度执行,且延迟在毫秒级。 1.1 和开源产品对比 CloudJob设计的初衷是为了支持海量任务同时调度,它和其它任务调度平台的对比如下: 对比内容 Elastic-Job XXL-Job CloudJob 执行定时任务的方式 通过quartz触发任务执行,任务量大时会有延时 采用轮询jobtrigger的方式调度任务,任务量大时会有延时 轮询数据库的触发消息,作业进行了分片,任务量大延时很低 多节点部署时任务不能重复执行 支持 支持 支持 弹性扩容缩容 通过zk实现各服务的注册、控制及协调,当任务很多时zk会成为性能瓶颈 使用quartz基于数据库的分布式能力,服务器超出一定数量会给数据库造成压力 通过分片可以支持系统的横向扩展,扩容缩容方便快捷 日志可追溯 支持,可通过事件订阅的方式处理调度过程的重要事件,记录信息在数据库中可查询 支持,有日志查询界面 支持,通过链路追踪的方式记录执行过程,可以同界面查询历史记录 高可用 去中心化的调度方式,通过zookeeper来进行选举、调度。如果某个实例失败,会选举其它实例来执行 “调度中心”通过DB锁保证集群分布式调度的一致性,一次任务调度只执行一次 集群内部的定时任务通过Elastic-Job来执行,保证内部任务的高可用;通过redis缓存记录调度信息,保证作业不会重复执行 1.2 CloudJob的性能 在公司内部对CloudJob进行了多轮性能测试,通过对测试数据进行分析,CloudJob的性能如下: (1)低时延:CloudJob在处理TPS为50W的作业调度时,99.11%的作业调度延时在1秒以内;CloudJob处理上亿次调度,最大调度延时不超过2.4秒。 (2)高性能:对比Elastic-Job的单个执行器执行上千个任务就会出现大量延时,CloudJob的单个执行器处理上万个任务仍然可以保证毫米级调度任务而不超时。 (3)扩展能力强:性能测试场景TPS由10万增加到50万,系统只需要按比例增加执行器个数,依然可以保证作业正常调度而不出现严重超时。 (4)高可用:测试过程中将某个执行器宕机,该执行器的作业可以转移到其它设备调度,并且调度延时最大不超过3秒。 2.系统架构 CloudJob的总统架构如下: 2.1 名称解释 作业元数据:指作业执行的时间规则以及业务执行需要透传的参数,存在于mongodb数据库及缓存中。 作业触发消息:指作业按照时间规则计算出的产生触发执行动作的每一条记录,包含作业主键和执行绝对时间时间戳,比如每5s执行一次任务,第5s和第10s是两个触发器。 执行器:用于扫描符合条件的作业触发器的服务所在的容器。 分片:为了让系统可以横向扩展,需要将作业划分到不同的分组,每个分组就是一个分片,同时每个执行器设置一个分片属性(和作业的分片属性相对应),执行器只处理自己所在分片对应的作业。 定时任务执行周期:运行在执行器的定时任务每隔多久运行一次。本方案中该值的设置主要和触发器存储选型有关,应该设置合适的频率,避免过于频繁导致写入和存储触发器时延时较大,同时也不能因为过大,导致一些本应该执行的任务不能被及时获取,出现触发延迟太多。 时间窗口:定时任务扫描触发器的时间条件,选出将来一定时间范围内的数据。注意这个窗口最好不一定等于定时任务的执行周期。 2.2 服务模块组成 作业管理服务:负责作业增删改查,用户可以通过作业管理服务将作业注册到平台,平台将作业持久化到mongodb数据库并在redis中缓存。 执行器负载监控服务:在CloudJob平台中每个执行器会处理一个数据分片,执行器负载监控服务会将作业划分到不同分片,分片内作业数量将维持在合理的数量范围,保证作业按照时间规则发送而不延迟。该服务负责分片的作业容量管理以及分片扩缩容等功能。 触发器存储:支持可插拔的存储,提供高可用方案,保证数据零丢失。 触发器定时任务:执行器定时执行的操作,主要是扫描mongodb数据库,生成作业触发消息。 执行记录存储:记录发送到业务MQ 的消息,核对是否有漏发送、发送是否有延迟等,发现系统可能存在的问题并及时对整个系统完善优化。 执行记录可视化:通过页面查看、查询作业的历史记录,查看作业是否超时,是否由漏执行。 通过对上面几个服务模块的说明,可以看出作业在系统中的流转过程如下: 用户先通过作业管理服务将作业注册到mongodb数据库中,并通过redis来缓存作业。执行器负载监控服务对新添加的作业设置分片,获取当前系统未饱和的最小分片,将这个分片的id设置为这个作业的分片,同时将分片对应的作业数量加1。多个执行器会根据设置好的分片参数定时从mongodb数据库中扫描出符合条件的作业,然后根据作业的时间表达式生成作业触发消息,然后将触发消息写入到时间轮中,最后在作业达到执行时间时将作业的基本信息投送到消息队列中,让用户从消息队列取出消息并执行自己的业务逻辑,从而达到触发作业调度的目的。 3. 数据流转举例 定时任务按照执行次数可以分为固定周期类型和固定延迟类型。固定周期类型是指作业按照一定的周期每隔一段时间执行,固定延迟类型是指会在延迟一段时间后,执行一次,随后就不会再执行。下面举例说明这两种类型的任务是如何流转的。 3.1 固定周期类型 用户创建了一个固定周期类型的任务,每隔5s执行一次,携带的参数为 CRON 0/5 * * * ?* 其它透传参数 作业管理服务先投递到MQ 普通消息。消费者持久化该条数据,获得主键jobpk1,计算出来该定时任务后续的触发时间戳为1612493460,存储到触发器的存储中,必要字段为: JobId 1612493460 执行器上的定时任务在做扫描时,扫描到了该条触发器数据,判断是否到了预期投递时间,如果已经到了直接投递到业务MQ,否则将它压入内存时间轮中,时间轮中到了预期投递时间,再投递到业务MQ。再计算下次触发时间戳为1612493465,将redis 中的数据修改为: JobId 1612493465 执行器上的本轮定时任务处理完毕后1,处理下一轮:拉取到1612493465 这一次时间戳,随后重复上面的逻辑,或者发送MQ 消息或者压入时间轮,依次往下。 3.2 固定延迟类型 用户创建了一个固定延迟类型的任务,再15s钟之后执行,携带的参数如下 FixDelay 15000 其它透传参数 作业管理服务先投递到MQ 普通消息。消费者持久化该条数据,获得主键jobpk1,计算出来该定时任务后续的触发时间戳为1612493475,存储到触发器的存储中,必要字段为: JobId 1612493475 执行器上由cloudjob 调度的定时任务在做扫描时,扫描到了该条触发器数据,判断是否到了预期投递时间,如果已经到了直接投递到业务MQ,否则将它压入内存时间轮中,时间轮中到了预期投递时间,再投递到业务MQ。由于是固定延迟,没有下次执行,将redis 中的数据修改为: JobId 0 执行器上的本轮定时任务处理完毕后,处理下一轮:拉取的时间戳要大于0,则这个作业以后不会被扫描到。在异步记录任务时,会将该redis 中为0 的这个member 删除,并把元数据该作业的状态设置为完结。 4. 服务部署及实施流程 通过前面的介绍大家知道了CloudJob的工作原理,下面通过几个模块的部署来说明一下具体的实施过程。 4.1 作业初始化 业务的作业通过作业管理服务接口批量注册。作业管理接收到请求后发送到MQ 普通消息,由消费者完成如下步骤: 由于作业总数百万级别,需要将作业划分到不同分片上,每一个作业在注册进来时需要 获取到尚未饱和的分片。分片的数量是由执行器负载服务管理的。假设一个分片的负载容量为1万,在分片承载的作业没达到1万之前,作业都可以被分到这个分片上。如果达到这个阈值,分片被设置为饱和状态,需要分配新的分片,新的作业将被分配到新的分片上。具体过程如下: 假设新增一个5s 执行一次的作业时,获取到了sharding1 分片,将会在DB 中存储元信息同时缓存元信息。数据为 主键 时间表达式 分片 版本 JobId CRON 0 0/5 * * * ?* Sharding1 0 Version0 表示该作业元信息是首次存入,以后每修改一次这个version 递增。计算下次触发时间并在触发器缓存中存入如下数据:zset 名称sharding1,member 为jobpk1_0,是作业主键和version 的组合,可以采用高位存主键,地位存版本号的方式。score 为下次触发时间戳1612493460。 4.2 执行器高可用 执行器会定时扫描mongodb数据库,从数据库中获取符合条件的任务,这个定时任务是由Elastic-Job来分配执行的,Elastic-Job将分片分配到了各个执行器中,假设是下面这种分配模型:两个执行器均分了两个分片,执行器1只处理具有分片属性sharding1的触发器,执行器2同理。当执行器1出现宕机时,Elastic-Job将会触发失效转移,分片1将会分配给执行器2,此时执行器2会有两个线程分别处理分片1 和分片2。如果执行器后面启动成功,Elastic-Job将会重新分片,两个执行器又会均分分片。 4.3 执行器线程模型 执行器在运行时内部有两种线程,一个是定时任务扫描线程,另一个是消息队列消费线程,它们的工作模型如下: 定时任务扫描线程:主要负责定时拉取触发器,随后均衡投递到对应时间轮中,一个时间轮由一个工作线程负责处理。如果出现工作线程处理时间轮中作业比较慢,出现大量堆积的情况,需要将对应分片属性设置为饱和状态,此时不会有新的作业被分配到该执行器,直到该分片重新恢复为非饱和状态。 消息队列消费线程:主要负责处理定时任务无法cover 到的马上要执行的触发消息,比如定时任务的处理周期是20s,现在用户提交了一个每隔10s执行一次的任务,这个时候系统就需要生成一个10s之后执行的触发消息并把它写入到消息队列中,执行器的消费线程就可以立即得到这个触发消息,及时加入到执行器的时间轮中,确保消息能够按时执行。 5. CloudJob使用实践 在CloudJob分布式任务调度平台搭建好以后,用户就可以将任务部署到这个平台上。下面介绍一下用户在使用CloudJob过程中遇到的问题和优化方案。 5.1 集群隔离 相比与其它分布式任务调度框架,CloudJob是一个“重量级”的调度平台,搭建一套CloudJob需要MongoDB数据库、redis集群,消息队列以及多台主机作为执行器,如果用户的任务量非常少,这将会导致资源的浪费。所以可以采用集群隔离的方法,将各个部门的用户作业部署到一个CloudJob集群中,同时采用一种隔离方式让用户的作业互不影响,这样就可以合理的利用资源。 集群隔离的具体思路是先搭建一套物理集群,用户在创建作业之前需要先创建一个逻辑集群(或者选择之前已经创建好的逻辑集群),在这个逻辑集群设置限流策略、超时机制,并与物理集群关联起来,用户之后将自己的任务注册到这个逻辑集群中,任务就可以被物理集群调度,任务的限流策略、超时机制等又是以逻辑集群为单位管理的,这样就实现了集群隔离。 5.2 链路追踪与作业历史可视化 在CloudJob集群中,一个任务从注册到最终执行需要经过多个处理流程,为了便于排查问题和进行作业历史统计,平台需要对任务流转的各个阶段进行链路追踪,同时需要将监控数据进行持久化,便于查询作业的历史记录。链路追踪与作业历史可视化的框架如下: 链路追踪的方案是通过埋点的方式,对系统中的主要处理流程进行记录,系统中的模块每进行一次处理就生成一条记录数据,记录数据通过消息队列定时发送到任务监控平台,任务监控平台将这些数据处理后存储到Elasticsearch中,为后续的统计、查询做准备。 同时平台提供了前端页面给用户进行作业历史可视化,用户可以在页面上查看作业的历史记录,查看每一次执行的调度情况,通过页面还可以查看到作业是否有漏发、严重超时。 6. 总结与展望 CloudJob作为一个高性能、低延迟的分布式任务调度平台,通过将任务划分到不同的分片、每个执行器处理对应分片的任务,实现了系统的动态扩展和拥有海量任务调度的能力;使用定时任务扫描、时间轮、系统内部的消息队列来保证任务及时触发,保证了任务执行的低延迟;同时CloudJob通过Elastic-Job来执行系统内部的定时任务,保证执行器的高可用。 当然CloudJob还是有些不足,如果用户将任务部署到CloudJob平台上,还需要将自己的业务处理代码运行到自己的主机上,这会造成主机资源的浪费。后续CloudJob的演进方向就是将任务平台接入到Serverless平台,用户只需要在页面编辑自己的业务代码,然后点击保存,平台就会在Serverless中新建任务实例,将用户的代码运行在任务实例中等待接收触发消息,执行完任务后自动释放任务实例。这样既可以方便用户快速部署任务,又可以充分利用资源。 作者简介 XinchunOPPO高级后端工程师 目前负责分布式作业调度系统的开发,关注消息队列、redis数据库、ElasticSearch等中间件技术 推荐阅读 |MySQL 分布式事务的“路”与“坑” |OPPO大数据离线任务调度系统OFLOW 本文版权归OPPO公司所有,如需转载请在后台留言联系 本文分享自微信公众号 - OPPO数智技术(OPPO_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册