首页 文章 精选 留言 我的

精选列表

搜索[日活数],共10000篇文章
优秀的个人博客,低调大师

求伯君:10 月 24 日应该为程序员放半天假

最近有一个六代技术人共话“我们的技术时代”论坛,金山软件创始人、WPS 创始人,有“中国第一程序员”之称的求伯君又贡献了很多金句和有趣的小故事: 当时雷军就破解了其中一个版本(WPS),我也因此与他结识。 做程序员很痛苦,做公司更痛苦。 让程序员去干非程序员干的事情是非常痛苦的事情。 为了完成游戏的任务,写代码将自己从劳动中解放出来。 有人 80 岁还一直在写程序,多写程序说不定还能防止老年痴呆。 10 月 24 号应该为所有程序员放半天假。 下面是从网上摘抄的求伯君在论坛上的发言: 求伯君:我们那个时代编程工具只有汇编,后来慢慢有了很多语言,但那时资料和工具都不齐全,互联网也不够发达,为了买开发工具或者查阅资料都得去中关村,因此我早期写程序都是用汇编。 当时第一版的 WPS 写了有上百万条程序,因为高级语言里调用的函数,在汇编里实现需要一百多条代码,每个功能要全部一条条去写,因此工作量很大。我当时很佩服一个同事,他是用 DeBug 写代码的,调试好了,再存入执行代码。 那个年代写程序真的很难,但同时也很快乐。那时为了解决 Bug 功能,我们写程序都没有日夜概念,就把自己关一个房间里,饿了就吃方便面,困了就睡,经常带着问题入睡。有一次在梦中想到了解决方案,醒来就特别兴奋地去实践,结果真的成功了。这段做梦实现的代码我记得是为了解决汉字输入法的一个中断问题。 当时写应用程序与操作系统是分不开的,经常要调用硬件部分,包括硬盘分配、存储、输出等等。现在回忆起那段时光,还是非常快乐的。 还有一个快乐我很少讲。因为起初我写 WPS 纯属兴趣,没有想过用它创业或者赚钱,所以我当年到中关村,看到一夜之间很多人在用盗版 WPS,我那时也没有版权概念,看到很多人用,我就非常高兴。当时雷军就破解了其中一个版本,我也因此与他结识。 求伯君:做程序员很痛苦,做公司更痛苦。中国流传着“痛并快乐着”这句话,意味着快乐与痛苦是相辅相成的,如果你没有快乐,那肯定就没有痛苦。 我的痛苦就是创业过程中遇到的很多困难。虽然我现在可以坦然地说,我当时看到有人用盗版 WPS 都很开心,但这确确实实影响了我的发展。在 1992-1993 年,那时候我连员工的工资都发不起。如果我只是打工的,那没关系,可我当时招了许多人,那时遇到的困难已经超出了我的能力范围。 后来我把雷军这些人招进来去管理事务之后,我发现我解脱了。所以我认为,让程序员去干非程序员干的事情是非常痛苦的事情。 求伯君:我做软件企业比较早,现在很多大公司的人以前都在我的公司工作过。如现在的腾讯、阿里也有从我们公司出去的人,这个也算是我们的贡献。 在创办企业之初,我是一个人写程序,发现事情做不完了再开始加人,后来就慢慢建立了团队,我是属于被驱动的。招人的时候,我是先找一个同样是写程序的,后来发现企业全部都是程序员,那时候才意识到,一个企业需要各种不同的人才,招人的时候才开始有其他的方向。 求伯君:首先退休是真的,我没有再去参与公司的日常管理。因为身体不好,我正在锻炼身体,平时会关注一些感兴趣的东西,也写一些自己用的游戏代码,不是作为商品去写的。譬如游戏外挂之类的,当然这不方便拿出来炫耀。为了完成游戏的任务,写代码将自己从劳动中解放出来。 求伯君:程序员的生命周期我认为是可以一直写下去的。我不写商业程序是因为体力跟不上,商业程序需要规定时间,而我自己写个小游戏可以有时间就写。因此只要有逻辑思维在,我认为程序员就可以一直干下去。有人 80 岁还一直在写程序,多写程序说不定还能防止老年痴呆。 求伯君:两年前的一次1024大会上,我曾呼吁:程序员太辛苦了,在这一天一定要放半天假。现在我仍然呼吁:10月24号应该为所有程序员放半天假。

优秀的个人博客,低调大师

ECCV 2020 双料冠军团队,带你7日攻克目标检测

计算机视觉最火方向是什么? 当然是目标检测啦! 目标检测,是计算机视觉领域的核心问题之一,近两年全球顶会的相关论文达上百篇,受到越来越多的人关注。无论是做人脸识别、自动驾驶、文字检测、人机交互,都离不开目标检测这一大基石。 随着精准度的逐年提升,目标检测技术的落地愈发成熟,已被广泛应用于工业、交通、遥感、医疗、娱乐等各个领域! 百度作为「中国AI头雁」在目标检测算法研究、产业实践、工业落地方面,积累了丰富的经验! 2020年7月,百度PaddleDetection研发团队探索并开源了工业级目标检测模型PP-YOLO,精度及预测速度优于YOLOv4,处于业界领先行列! 2020年8月,百度视觉团队在国际视觉领域顶级赛事ECCV 2020中表现优异,拿下目标检测领域Tiny Object Detection和COCO的“双料冠军”! 为帮助更多开发者深入理解目标检测这一领域,百度视觉团队与PaddleDetection研发团队强强联合,结合多年实战经验,亲自授课,带领大家专项攻克目标检测! 下载安装命令 ## CPU版本安装命令 pip install -f https://paddlepaddle.org.cn/pip/oschina/cpu paddlepaddle ## GPU版本安装命令 pip install -f https://paddlepaddle.org.cn/pip/oschina/gpu paddlepaddle-gpu 7天攻克目标检测 顶级名师倾囊相授 全球ECCV目标检测双料冠军团队教研,PaddleDetection资深研发授课,基于多年顶会科研与100+AI产业落地经验,全程直播授课。 深入啃透算法原理 详细拆解RCNN、YOLO、AnchorFree系列算法,还包含SOTA性能的工业级检测模型PP-YOLO,循序渐进带你拨开迷雾! 真实工业项目实战 深入剖析4大百度特色真实工业案例:路标检测、工业质检、电力巡检、商业超市密集商品检测。 手把手带打CVPR2020最新比赛 2019年CVPR 目标检测世界冠军,首次公开分享冠军秘籍,带打2020年最新比赛,基于COCO数据集的密集物体检测! 特别福音 优秀学员有机会入职百度 结业邮寄纸质版结业证书 与百度资深研发全程深入交流 开源生态贡献卓越者,优先晋级成为PPDE(飞桨技术专家) 课程全程免费,包含直播、实践、作业批改、答疑等,提供免费GPU资源 课程大纲 01目标检测任务综述 1. 目标检测发展历程、重要基本概念(bbox、nms、IOU、mAP) 2. 数据集格式介绍 3. PaddleDetection整体介绍和使用 【实战】路标检测 02RCNN系列目标检测算法详解 1. RCNN系列模型的介绍 2. FasterRCNN模块的详解 3. PaddleDetection训练RCNN模型 03RCNN系列算法优化策略与案例 1. FPN介绍 2. CasacdeRCNN介绍 3. 两阶段模型速度和精度的优化 4. 工业质检案例 【实战】基于RCNN工业质检缺陷检测 04YOLO系列目标检测算法详解 1. YOLO系列的介绍 2. YOLOv3模块的详解 3. 训练YOLO模型 05PP-YOLO优化策略与案例分享 1. PP-YOLO介绍 2. YOLO模型速度和精度的优化 3. 电力巡检案例 【实战】PP-YOLO工业质检缺陷检测 06AnchorFree系列算法介绍和实践 1. AnchorFree系列介绍 2. FCOS介绍 3. CornetNet/TTF-Net介绍 【实战】AnchorFree工业质检缺陷检测 07世界冠军手把手带打顶会比赛 1. 发布2020年CVPR最新赛题 2. 世界冠军分享2019比赛秘籍 【实战】商业超市密集商品检测 (密集物体检测) 讲师介绍 青青老师 :百度资深研发工程师 负责飞桨视觉方向,多年从事飞桨框架、视觉算法研发,从0到1参与了飞桨的系统及视觉模型库研发,负责了飞桨分类、分割、目标检测、生成等模型研发,及模型压缩工具的研发,有丰富的系统优化经验及视觉算法应用经验。 鹏鹏老师 :百度资深研发工程师 服务器端PP-YOLO模型主要作者,PaddleDetection目标检测库核心研发骨干,对YOLO系列模型的原理和优化有深入的理解和研究,开发和发布的多种服务器端和移动端的YOLOv3模型,在精度和速度上均达到业界前列。 冠冠老师:百度高级研发工程师 飞桨目标检测套件PaddleDetection核心研发骨干,从0到1打造了飞桨目标检测端到端的开发套件,开发的检测模型效果达到业界前列,具有多年目标检测方向的算法积累和实战经验,对目标检测领域有着深入的理解。 学习激励 担心无法坚持学习?别担心,成长的路上需要鼓励。 我们设置了精彩的比赛PK环节,我们准备了100份精美礼品等你来拿! 百度飞桨官方认证结业证书 扫码关注【飞桨】公众号 回复:冠军团队 获取专属报名通道 下载安装命令 ## CPU版本安装命令 pip install -f https://paddlepaddle.org.cn/pip/oschina/cpu paddlepaddle ## GPU版本安装命令 pip install -f https://paddlepaddle.org.cn/pip/oschina/gpu paddlepaddle-gpu >>访问 PaddlePaddle 官网,了解更多相关内容。

优秀的个人博客,低调大师

7月2日 JindoFS 系列直播【Hadoop 小文件/冷文件分析】

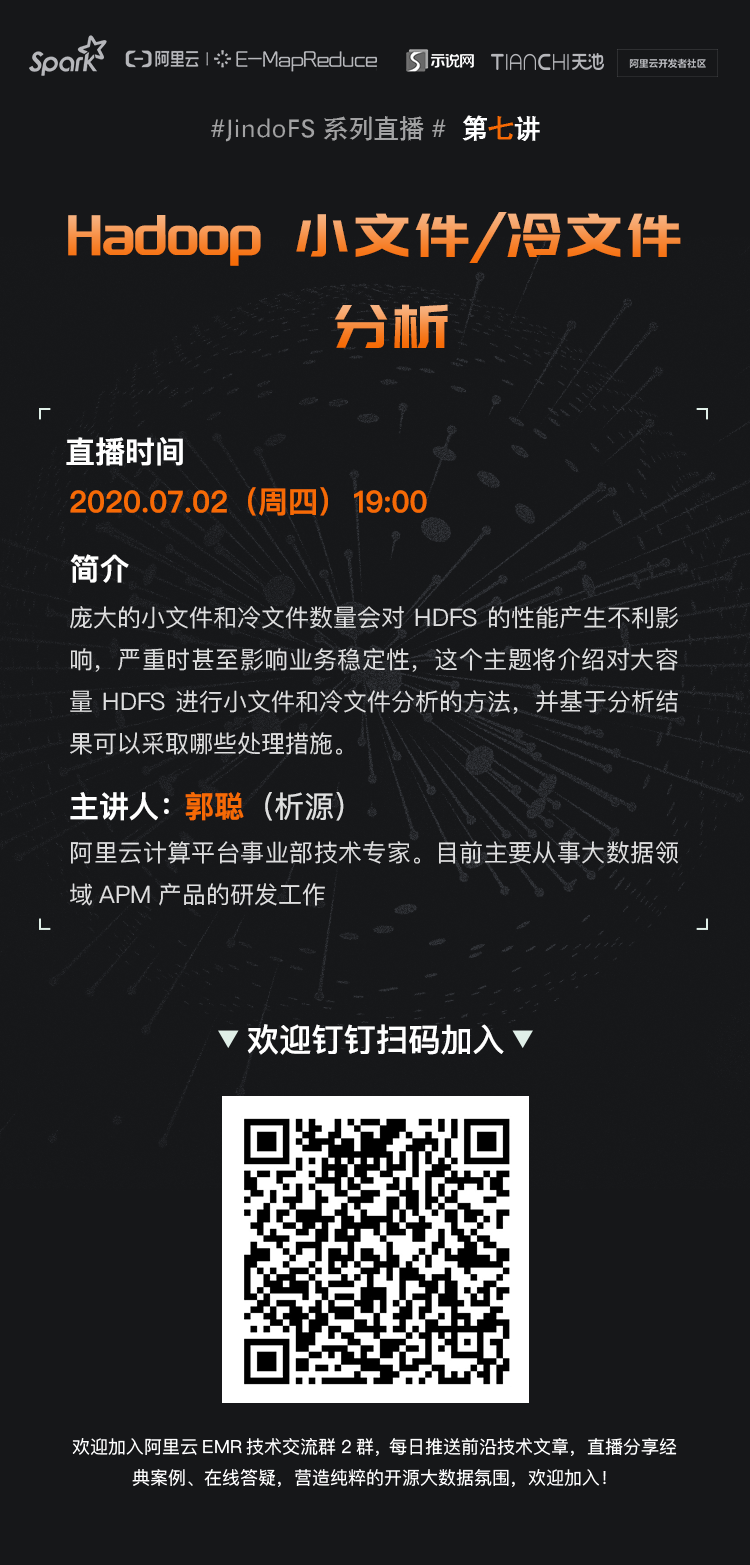
主题: Hadoop 小文件/冷文件分析 时间: 2020.7.2 19:00 参与方式: 扫描下方二维码加入钉钉群直接观看或届时点击链接进入直播间(此链接也是回看链接)https://developer.aliyun.com/live/43367 讲师: 郭聪,花名析源,阿里云计算平台事业部技术专家。目前主要从事大数据领域APM产品的研发工作。 直播简介: 庞大的小文件和冷文件数量会对HDFS的性能产生不利影响,严重时甚至影响业务稳定性,这个主题将介绍对大容量HDFS进行小文件和冷文件分析的方法,并基于分析结果可以采取哪些处理措施。

优秀的个人博客,低调大师

3月19日JindoFS系列直播【关于 JindoFS 最新的 OTS 方案】

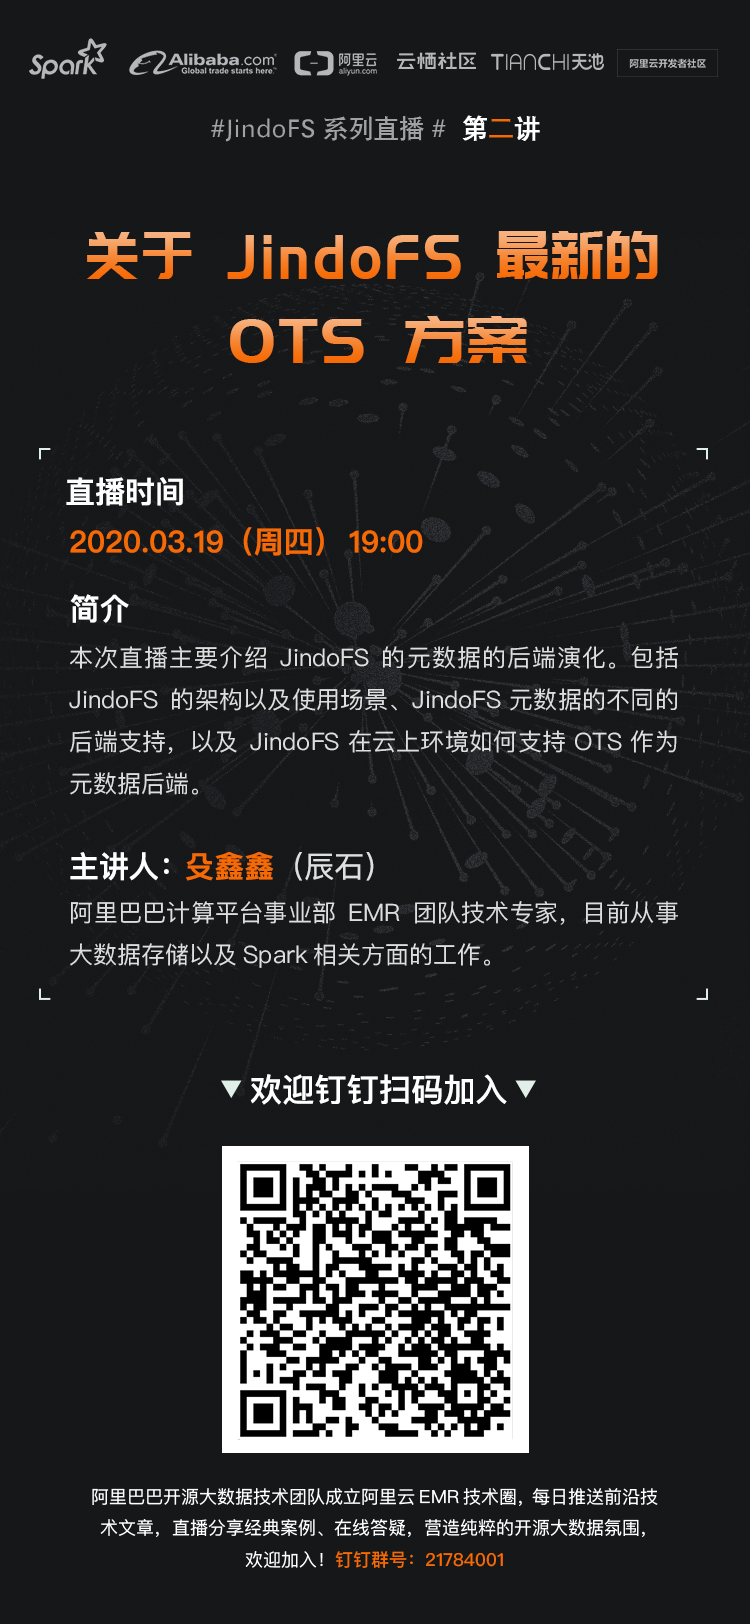
主题: 关于 JindoFS 最新的 OTS 方案 时间: 2020.3.19(周四)19:00 参与方式: 扫描下方二维码加入钉钉群,群内直接观看 或点击直播间链接: https://tianchi.aliyun.com/course/live?liveId=41140 讲师: 殳鑫鑫,花名辰石,阿里巴巴计算平台事业部EMR团队技术专家,目前从事大数据存储以及Spark相关方面的工作。 直播简介: 本次直播主要介绍JindoFS的元数据的后端演化。包括JindoFS的架构以及使用场景、JindoFS 元数据的不同的后端支持,以及JindoFS 在云上环境如何支持 OTS 作为元数据后端。

优秀的个人博客,低调大师

日处理20亿数据,实时用户行为服务系统架构实践【转】

携程实时用户行为服务作为基础服务,目前普遍应用在多个场景中,比如猜你喜欢(携程的推荐系统)、动态广告、用户画像、浏览历史等等。 以猜你喜欢为例,猜你喜欢为应用内用户提供潜在选项,提高成交效率。旅行是一项综合性的需求,用户往往需要不止一个产品。作为一站式的旅游服务平台,跨业务线的推荐,特别是实时推荐,能实际满足用户的需求,因此在上游提供打通各业务线之间的用户行为数据有很大的必要性。 携程原有的实时用户行为系统存在一些问题,包括:1)数据覆盖不全;2)数据输出没有统一格式,对众多使用方提高了接入成本;3)日志处理模块是web service,比较难支持多种数据处理策略和实现方便扩容应对流量洪峰的需求等。 而近几年旅游市场高速增长,数据量越来越大,并且会持续快速增长。有越来越多的使用需求,对系统的实时性,稳定性也提出了更高的要求。总的来说,当前需求对系统的实时性/可用性/性能/扩展性方面都有很高的要求。 一、架构 这样的背景下,我们按照如下结构重新设计了系统: 图1:实时用户行为系统逻辑视图 新的架构下,数据有两种流向,分别是处理流和输出流。 在处理流,行为日志会从客户端(App/Online/H5)上传到服务端的Collector Service。Collector Service将消息发送到分布式队列。数据处理模块由流计算框架完成,从分布式队列读出数据,处理之后把数据写入数据层,由分布式缓存和数据库集群组成。 输出流相对简单,Web Service的后台会从数据层拉取数据,并输出给调用方,有的是内部服务调用,比如推荐系统,也有的是输出到前台,比如浏览历史。系统实现采用的是Java+Kafka+Storm+Redis+MySQL+Tomcat+spring的技术栈。 1. Java:目前公司内部Java化的氛围比较浓厚,并且Java有比较成熟的大数据组件 2. Kafka/Storm:Kafka作为分布式消息队列已经在公司有比较成熟的应用,流计算框架Storm也已经落地,并且有比较好的运维支持环境。 3. Redis: Redis的HA,SortedSet和过期等特性比较好地满足了系统的需求。 4. MySQL: 作为基础系统,稳定性和性能也是系统的两大指标,对比NoSQL的主要选项,比如HBase和ElasticSearch,十亿数据级别上MySQL在这两方面有更好的表现,并且经过设计能够有不错的水平扩展能力。 目前系统每天处理20亿左右的数据量,数据从上线到可用的时间在300毫秒左右。查询服务每天服务8000万左右的请求,平均延迟在6毫秒左右。下面从实时性/可用性/性能/部署几个维度来说明系统的设计。 二、实时性 作为一个实时系统,实时性是首要指标。线上系统面对着各种异常情况。例如如下几种情况: 1.突发流量洪峰,怎么应对; 2.出现失败数据或故障模块,如何保证失败数据重试并同时保证新数据的处理; 3.环境问题或bug导致数据积压,如何快速消解; 4.程序bug,旧数据需要重新处理,如何快速处理同时保证新数据; 系统从设计之初就考虑了上述情况。 首先是用storm解决了突发流量洪峰的问题。storm具有如下特性: 图2:Storm特性 作为一个流计算框架,和早期大数据处理的批处理框架有明显区别。批处理框架是执行完一次任务就结束运行,而流处理框架则持续运行,理论上永不停止,并且处理粒度是消息级别,因此只要系统的计算能力足够,就能保证每条消息都能第一时间被发现并处理。 对当前系统来说,通过storm处理框架,消息能在进入kafka之后毫秒级别被处理。此外,storm具有强大的scale out能力。只要通过后台修改worker数量参数,并重启topology(storm的任务名称),可以马上扩展计算能力,方便应对突发的流量洪峰。 对消息的处理storm支持多种数据保证策略,at least once,at most once,exactly once。对实时用户行为来说,首先是保证数据尽可能少丢失,另外要支持包括重试和降级的多种数据处理策略,并不能发挥exactly once的优势,反而会因为事务支持降低性能,所以实时用户行为系统采用的at least once的策略。这种策略下消息可能会重发,所以程序处理实现了幂等支持。 storm的发布比较简单,上传更新程序jar包并重启任务即可完成一次发布,遗憾的是没有多版本灰度发布的支持。 图3:Storm架构 在部分情况下数据处理需要重试,比如数据库连接超时,或者无法连接。连接超时可能马上重试就能恢复,但是无法连接一般需要更长时间等待网络或数据库的恢复,这种情况下处理程序不能一直等待,否则会造成数据延迟。实时用户行为系统采用了双队列的设计来解决这个问题。 图4:双队列设计 生产者将行为纪录写入Queue1(主要保持数据新鲜),Worker从Queue1消费新鲜数据。如果发生上述异常数据,则Worker将异常数据写入Queue2(主要保持异常数据)。 这样Worker对Queue1的消费进度不会被异常数据影响,可以保持消费新鲜数据。RetryWorker会监听Queue2,消费异常数据,如果处理还没有成功,则按照一定的策略(如下图)等待或者重新将异常数据写入Queue2。 图5:补偿重试策略 另外,数据发生积压的情况下,可以调整Worker的消费游标,从最新的数据重新开始消费,保证最新数据得到处理。中间未经处理的一段数据则启动backupWorker,指定起止游标,在消费完指定区间的数据之后,backupWorker会自动停止。(如下图) 图6:积压数据消解 三、可用性 作为基础服务,对可用性的要求比一般的服务要高得多,因为下游依赖的服务多,一旦出现故障,有可能会引起级联反应影响大量业务。项目从设计上对以下问题做了处理,保障系统的可用性: 1.系统是否有单点? 2.DB扩容/维护/故障怎么办? 3.Redis维护/升级补丁怎么办? 4.服务万一挂了如何快速恢复?如何尽量不影响下游应用? 首先是系统层面上做了全栈集群化。kafka和storm本身比较成熟地支持集群化运维;web服务支持了无状态处理并且通过负载均衡实现集群化;redis和DB方面携程已经支持主备部署,使用过程中如果主机发生故障,备机会自动接管服务;通过全栈集群化保障系统没有单点。 另外系统在部分模块不可用时通过降级处理保障整个系统的可用性。先看看正常数据处理流程:(如下图) 图7:正常数据流程 在系统正常状态下,storm会从kafka中读取数据,分别写入到redis和mysql中。服务从redis拉取(取不到时从db补偿),输出给客户端。DB降级的情况下,数据流程也随之改变(如下图) 图8:系统降级-DB 当mysql不可用时,通过打开db降级开关,storm会正常写入redis,但不再往mysql写入数据。数据进入reids就可以被查询服务使用,提供给客户端。另外storm会把数据写入一份到kafka的retry队列,在mysql正常服务之后,通过关闭db降级开关,storm会消费retry队列中的数据,从而把数据写入到mysql中。redis和mysql的数据在降级期间会有不一致,但系统恢复正常之后会通过retry保证数据最终的一致性。redis的降级处理也类似(如下图) 图9:系统降级-Redis 唯一有点不同的是Redis的服务能力要远超过MySQL。所以在Redis降级时系统的吞吐能力是下降的。这时我们会监控db压力,如果发现MySQL压力较大,会暂时停止数据的写入,降低MySQL的压力,从而保证查询服务的稳定。 为了降低故障情况下对下游的影响,查询服务通过Netflix的Hystrix组件支持了熔断模式(如下图)。 图10:Circuit Breaker Pattern 在该模式下,一旦服务失败请求在给定时间内超过一个阈值,就会打开熔断开关。在开关开启情况下,服务对后续请求直接返回失败响应,不会再让请求经过业务模块处理,从而避免服务器进一步增加压力引起雪崩,也不会因为响应时间延长拖累调用方。 开关打开之后会开始计时,timeout后会进入Half Open的状态,在该状态下会允许一个请求通过,进入业务处理模块,如果能正常返回则关闭开关,否则继续保持开关打开直到下次timeout。这样业务恢复之后就能正常服务请求。 另外,为了防止单个调用方的非法调用对服务的影响,服务也支持了多个维度限流,包括调用方AppId/ip限流和服务限流,接口限流等。 四、性能&扩展 由于在线旅游行业近几年的高速增长,携程作为行业领头羊也蓬勃发展,因此访问量和数据量也大幅提升。公司对业务的要求是可以支撑10倍容量扩展,扩展最难的部分在数据层,因为涉及到存量数据的迁移。 实时用户行为系统的数据层包括Redis和MySQL,Redis因为实现了一致性哈希,扩容时只要加机器,并对分配到新分区的数据作读补偿就可以。 MySQL方面,我们也做了水平切分作为扩展的准备,分片数量的选择考虑为2的n次方,这样做在扩容时有明显的好处。因为携程的mysql数据库现在普遍采用的是一主一备的方式,在扩容时可以直接把备机拉平成第二台(组)主机。假设原来分了2个库,d0和d1,都放在服务器s0上,s0同时有备机s1。扩容只需要如下几步: 1.确保s0 -> s1同步顺利,没有明显延迟 2.s0暂时关闭读写权限 3.确认s1已经完全同步s0更新 4.s1开放读写权限 5.d1的dns由s0切换到s1 6.s0开放读写权限 迁移过程利用MySQL的复制分发特性,避免了繁琐易错的人工同步过程,大大降低了迁移成本和时间。整个操作过程可以在几分钟完成,结合DB降级的功能,只有在DNS切换的几秒钟时间会产生异常。 整个过程比较简单方便,降低了运维负担,一定程度也能降低过多操作造成类似GitLab式悲剧的可能性。 五、部署 前文提到Storm部署是比较方便的,只要上传重启就可以完成部署。部署之后由于程序重新启动上下文丢失,可以通过Kafka记录的游标找到之前处理位置,恢复处理。 另外有部分情况下程序可能需要多版本运行,比如行为纪录暂时有多个版本,这种情况下我们会新增一个backupJob,在backupJob中运行历史版本。

优秀的个人博客,低调大师

开源大数据周刊-2018年08月10日 第96期

资讯 阿里云E-MapReduce新版工作流管理正式上线 新版E-MapReduce工作流管理功能正式发布上线,工作流调度和编排是大数据开发的重要场景。此次升级新增作业DAG执行,作业临时查询等功能,拖拽编辑工作流节点等功能,在作业并行化缩短执行时间,提升了易用性。欢迎了解更多E-MapReduce产品详情。 2018 Gartner全球云存储魔力象限解读:阿里云跃升至挑战者 云存储催热数据湖 7月外媒披露了最新的Gartner全球云存储魔力象限,全球前四依然是亚马逊AWS、微软Azure、谷歌GCP和阿里云,与去年相比最大变化是,谷歌和阿里云各自跃升了一个象限,分别跻身领导者和挑战者象限,这是中国云计算厂商首次进入Gartner云存储挑战者象限。 TensorFlow 版本 1.10.0 发布 TensorFlow 1.10 预构建二进

优秀的个人博客,低调大师

开源大数据周刊-2018年08月03日 第95期

资讯 Apache Kafka 2.0.0 正式发布,分布式消息发布订阅系统 Apache Kafka 2.0.0 已正式发布,这是一个主要版本,新增了许多重要的新功能。此外还包括许多重要的 bug 修复和改进,其中还包括一些严重的错误修复。 如何解决AI的大数据困境?杨强提出联邦迁移学习 2018中国人工智能大会在深圳举行。会上,国际人工智能联合会(IJCAI)主席、AAAI/ACM/IEEE Fellow、香港科技大学教授杨强发表了题为《AI面临的挑战和迁移学习所带来的机遇》的演讲,谈到了AI发展遇到的大数据的困境以及解决办法。 Tableau发布2018.2版本 可拖放第三方应用功能到仪表板 Tableau公司近日推出Tableau 2018.2版本更新,该更新的扩展API能够让用户直接拖放第三方应用功能到仪表板。此外,在新推出的Tab

优秀的个人博客,低调大师

开源大数据周刊-2018年07月27日 第94期

资讯 谷歌Edge TPU专用芯片横空出世!抢攻IoT欲一统物联网江湖谷歌今天宣布推出用于边缘计算的Edge TPU,作为Cloud TPU的补充,目前Edge TPU仅用于推理,专为在边缘运行TensorFlow Lite ML模型而设计。除了自用,谷歌Edge TPU也将提供给其他厂商使用,进一步把开发者锁定在谷歌生态系统,或对整个智能云计算市场带来巨大冲击! 2018最具创新力的大数据解决方案排行榜截至目前,人类文明进程已经历了三次极为重要的革命:第一次是蒸汽机的发明;第二次是电力的广泛应用;第三次则是计算机与互联网的发明。这三次革命无一不推进了人类社会发展的进程,促进了社会的进步。尤其是第三次革命,让全世界联系起来,遥远的一切不再那么遥远。 我国首次开展大数据安全整治《经济参考报》记者获悉,我国正在开展的全国网络安全执法大检查行

优秀的个人博客,低调大师

SQL Saturday 北京将于7月25日举办线下活动,欢迎参加

地点:北京微软(中国)有限公司【望京利星行】,三层308室 报名地址:https://onedrive.live.com/redir?page=survey&resid=f7168005d28de959!20447&authkey=!AE6PrTtXrBuyC_c&ithint=file%2cxlsx 如果OneDrive无法打开,请邮件报名,格式如下: 报名邮件:careyson@163.com 标题SQL Saturdays 北京活动报名 姓名: 手机号: 所在公司: 我们邀请了微软公司的SQL技术专家和来自不同公司的讲师和大家一起分享SQL Server的管理/开发/架构经验,学习前沿的技术发展。 本地会议完全免费,由微软公司和PASS组织提供赞助。并提供茶点与午餐。 PASS是全球最大的SQL Server技术社群,详细信息请访问www.sqlpass.org 议程 上午10:00-11:30 Session1 午饭11:30-12:30 下午 12:30 – 1:30 Session2 中场休息 1:40-2:50 Session3 中场休息 3:00-4:00 Session4 查询优化器是如何使用统计信息的 内容简介 : 主要讨论统计信息是如何被查询优化器所使用的。统计信息主要包含了三个部分的信息内容:直方图(histiogram)、密度信息(density information) 和 头部信息(head),每一部分都会对基数估计过程的不同部分使用到,我会首先解释一下统计信息方面的内容:创建、更新和维护;然后通过一些Demo演示查询优化器是如何使用统计信息的;最后介绍查询优化器在一些模型中的基数估计的计算方法,并为大家提供如何检测对查询计划质量产生负面影响的基数估计错误的信息,以及如何修复他们的建议。 姜传华,长期从事数据库方面的教学、设计开发和应用管理工作,深刻理解关系数据库原理及SQL Server体系架构,对数据库尤其是SQL Server数据库一直坚持不间断的学习、探索、实验和应用研究。 ----------------------------------------------------------------------------- 此次分享将向大家介绍微软的移动商务智能解决方案Datazen。 Datazen是微软刚刚收购的移动商务智能和数据可视化领域解决方案,基于HTML5的应用,实现了全平台的整合。 宋卫东,微软SQL Server BI专家,SQL Server MVP ------------------------------------------------------------------------------ SQL Server 2016 技术初探--大数据时代下的新型数据库产品 微软SQL Server 2016已经发布预览版,除了延续SQL 2014,继续增强对关键业务性能支撑能力和混合云部署能力之外,在这款全新发布的产品中新增了很多大数据相关的特性,例如提供对结构化非结构化数据进行混合查询的PolyBase功能、集成高级分析R语言、支持使用T-SQL输出JSON等。这次分享会向大家介绍SQL 2016的新增功能及微软整个数据平台的框架。帮助大家更加全面的理解微软的数据平台解决方案 ------------------------------------------------------------------------------ 饶超伦 (Super Rao),微软数据平台技术顾问 在微软从事数据平台解决方案和架构设计方面的工作。在IT领域有超过10年的工作经验,参与过政府、金融、零售、电子商务等领域的多个数据平台项目。精通对数据进行全生命周期管理的技术实现,对微软数据平台产品线包括SQL Server、HDInsight、Power BI、Azure Machine Learning有非常深入的理解。对数据挖掘、人工智能、云计算、商业智能领域的发展趋势及产品技术演进具有高度的前瞻性思考和丰富的实践经验。 ------------------------------------------------------------------------------ 高继伟 SQL Server并行执行原理,如何阅读相应执行计划,SQL语句并行运行时的常见瓶颈及调优方案. 分类: SQL Pass 本文转自CareySon博客园博客,原文链接:http://www.cnblogs.com/CareySon/p/4663934.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

2011年10月14日22:40,“你在哪(where are you)”诞生

【点击抢先下载Android版尝鲜】,IOS版筹划中。 你在哪1.00 找呀找呀找朋友 谁做的? “你在哪(where are you)”是由Kai和Liyao利用业余时间合作完成的,Kai目前是“1616个人门户”的系统架构师,Liyao则在联想从事安卓系统级研发。 有什么用哦? 可以和朋友分享彼此的位置和心情故事,实时找人、找回丢失的手机,还可以看看亲爱的ta在哪儿,看看小孩是否去学校了……以后还可以免费发短信哦(免费短信功能1.5版推出)。 怎么使用呢? 实时找人:添加你关注人,且ta也关注你,可以在任何时候知道ta在哪儿,只要ta的手机处于联网状态,很强大吧。 找回手机:手机丢失之后,立即用朋友的手机(需要也安装本软件)查找自己的位置,即可通过地图得你的手机位置,然后持续跟踪,直到你和手机位置接近之后,你可以拨打电话让你的手机播放音乐“呼叫”你,方便你找回。 免费发短信:打开你关心的人列表,点击进入ta的详细页,点“短信”按钮,即可在互相关注的人之间可以免费发短信,即使对方没有打开本软件,也能收到你的短信。 …… 欢迎您随时通过"更多-反馈"给我们提出批评和建议,让本软件做得更好,让您用得更舒心。 本文转自Kai的世界,道法自然博客园博客,原文链接:http://www.cnblogs.com/kaima/archive/2011/10/14/2212661.html,如需转载请自行联系原作者。

优秀的个人博客,低调大师

CentOS7下Elastic Stack 5.0日志分析系统搭建

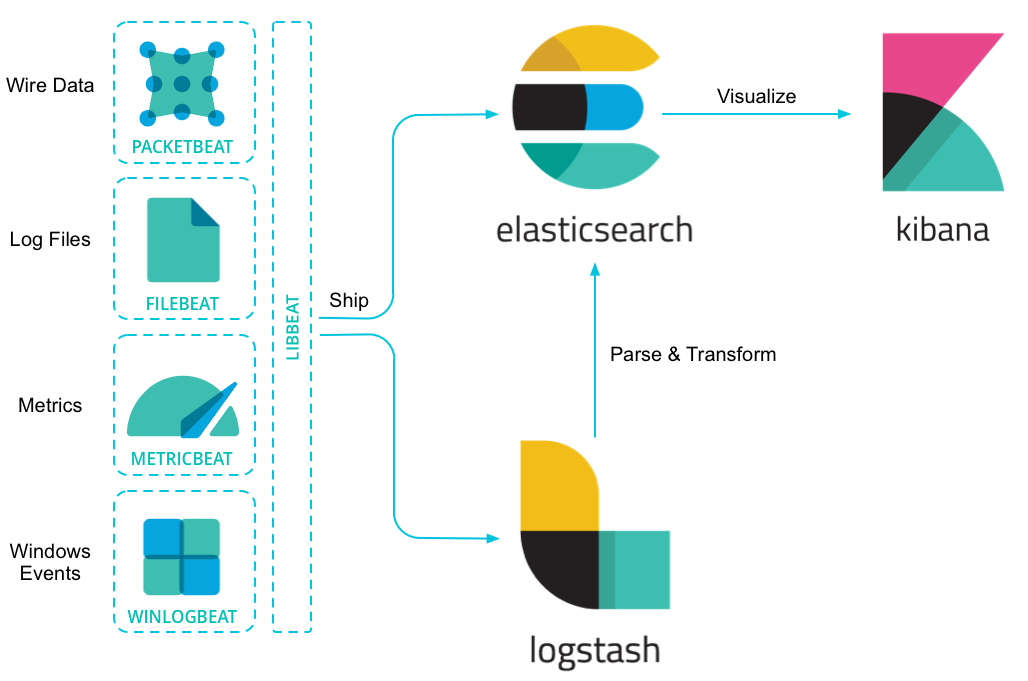
一、概述 Elasticsearch是个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。 Logstash是一个开源的用于收集,分析和存储日志的工具。 Kibana也是一个开源和免费的工具,Kibana可以为Logstash和ElasticSearch提供的日志分析友好的Web界面,可以汇总、分析和搜索重要数据日志。 Beats是elasticsearch公司开源的一款采集系统监控数据的代理agent,是在被监控服务器上以客户端形式运行的数据收集器的统称,可以直接把数据发送给Elasticsearch或者通过Logstash发送给Elasticsearch,然后进行后续的数据分析活动。Beats由如下组成: 1.Packetbeat:是一个网络数据包分析器,用于监控、收集网络流量信息, Packetbeat嗅探服务器之间的流量,解析应用层协议,并关联到消息的处理, 其支持ICMP (v4 and v6)、DNS、HTTP、Mysql、PostgreSQL、Redis、 MongoDB、Memcache等协议; 2. Filebeat:用于监控、收集服务器日志文件,其已取代 logstash forwarder; 3.Metricbeat:可定期获取外部系统的监控指标信息,其可以监控、收集 Apache、HAProxy、MongoDB、MySQL、Nginx、PostgreSQL、 Redis、System、Zookeeper等服务; 4.Winlogbeat:用于监控、收集Windows系统的日志信息; 5. Create your own Beat:自定义beat ,如果上面的指标不能满足需求,elasticsarch鼓励开发者 使用go语言,扩展实现自定义的beats,只需要按照模板,实现监控的输入,日志,输出等即可。 Beats 将搜集到的数据发送到 Logstash,经 Logstash 解析、过滤后,将其发送到 Elasticsearch 存储,并由 Kibana 呈现给用户。 Beats 作为日志搜集器没有Logstash 作为日志搜集器消耗资源,解决了 Logstash 在各服务器节点上占用系统资源高的问题。 Elastic Stack官方下载地址:https://www.elastic.co/downloads。 二、开源实时日志分析系统Elastic Stack 5.0部署: A.安装依赖包JDK ①关闭防火墙 1 2 3 4 #cat/etc/selinux/config|grep-v"#" SELINUX=disabled ##关闭selinux SELINUXTYPE=targeted #systemctlstopfirewalld##关闭防火墙 ②下载安装JDK 1 2 3 4 5 6 #wgethttp://dl.fedoraproject.org/pub/epel/epel-release-latest-7.noarch.rpm #yuminstalljre##这里我只安装的是jre环境,一样可用 #java-version openjdkversion "1.8.0_111" OpenJDKRuntimeEnvironment(build1.8.0_111-b15) OpenJDK64-BitServerVM(build25.111-b15,mixedmode B.安装Elasticsearch ①下载安装elasticsearch 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 #rpm--importhttps://artifacts.elastic.co/GPG-KEY-elasticsearch #cat>/etc/yum.repos.d/elasticsearch.repo<<EOF [elasticsearch-5.x] name=Elasticsearchrepository for 5.xpackages baseurl=https: //artifacts .elastic.co /packages/5 .x /yum gpgcheck=1 gpgkey=https: //artifacts .elastic.co /GPG-KEY-elasticsearch enabled=1 autorefresh=1 type =rpm-md EOF #yuminstallelasticsearch #systemctlstartelasticsearch #systemctlstatuselasticsearch #/usr/share/elasticsearch/bin/elasticsearch-V##查看elasticsearch版本 Version:5.0.1,Build:080bb47 /2016-11-11T22 :08:49.812Z,JVM:1.8.0_111 注:安装后出现如下问题,致使elasticsearch无法启动 1 2 3 4 5 6 7 #systemctlstatuselasticsearch OpenJDK64-BitServerVMwarning:Ifthenumberofprocessorsisexpectedtoincreasefromone, then youshouldconf...CThreads=N OpenJDK64-BitServerVMwarning:INFO:os::commit_memory(0x0000000085330000,2060255232,0)failed;error= 'Cannota...' (errno=12) #ThereisinsufficientmemoryfortheJavaRuntimeEnvironmenttocontinue. #Nativememoryallocation(mmap)failedtomap2060255232bytesforcommittingreservedmemory. #Anerrorreportfilewithmoreinformationissavedas: #/tmp/hs_err_pid11084.log 解决: 配置elasticsearch下的jvm.options: 1 2 3 4 5 #vi/etc/elasticsearch/jvm.options -Xms4g ##启用如下两项 -Xmx4g ##-Xms2g##关闭如下两项 ##-Xmx2g ②ElasticSearch默认的对外服务的HTTP端口是9200,节点间交互的TCP端口是9300。 1 #ss-tlnp|grep-E'9200|9300' ③测试服务 1 2 3 4 5 6 7 8 9 10 11 12 13 14 #curl-XGEThttp://localhost:9200 { "name" : "XVY0Ovb" , "cluster_name" : "elasticsearch" , "cluster_uuid" : "tR_H9avzT6Kf4hXWTIfWyA" , "version" :{ "number" : "5.0.1" , "build_hash" : "080bb47" , "build_date" : "2016-11-11T22:08:49.812Z" , "build_snapshot" : false , "lucene_version" : "6.2.1" }, "tagline" : "YouKnow,forSearch" } 也可以使用如下命令测试 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 #curl-i-XGET'localhost:9200/' HTTP /1 .1200OK content- type :application /json ;charset=UTF-8 content-length:327 { "name" : "XVY0Ovb" , "cluster_name" : "elasticsearch" , "cluster_uuid" : "tR_H9avzT6Kf4hXWTIfWyA" , "version" :{ "number" : "5.0.1" , "build_hash" : "080bb47" , "build_date" : "2016-11-11T22:08:49.812Z" , "build_snapshot" : false , "lucene_version" : "6.2.1" }, "tagline" : "YouKnow,forSearch" } C.安装Logstash 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 #rpm--importhttps://artifacts.elastic.co/GPG-KEY-elasticsearch #cat>/etc/yum.repos.d/logstash.repo<<EOF [logstash-5.x] name=Elasticrepository for 5.xpackages baseurl=https: //artifacts .elastic.co /packages/5 .x /yum gpgcheck=1 gpgkey=https: //artifacts .elastic.co /GPG-KEY-elasticsearch enabled=1 autorefresh=1 type =rpm-md EOF #yuminstalllogstash #systemctlstartlogstash #systemctlstatuslogstash #/usr/share/logstash/bin/logstash-V##查看logstash版本 logstash5.0.1 D.安装Kibana ①安装Kibana 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 #rpm--importhttps://artifacts.elastic.co/GPG-KEY-elasticsearch #cat>/etc/yum.repos.d/kibana.repo<<EOF [kibana-5.x] name=Kibanarepository for 5.xpackages baseurl=https: //artifacts .elastic.co /packages/5 .x /yum gpgcheck=1 gpgkey=https: //artifacts .elastic.co /GPG-KEY-elasticsearch enabled=1 autorefresh=1 type =rpm-md EOF #yuminstallkibana #systemctlstartkibana #systemctlstatuskibana #/usr/share/kibana/bin/kibana-V##查看kibana版本 5.0.1 ②只需更改如下配置 1 2 #cat/etc/kibana/kibana.yml|grep-v"#" server.host: "192.168.147.128" ③检测服务 1 #ss-tlnp|grep5601##Kibana默认进程名:node,端口5601 浏览器输入http://localhost:5601 E、Beats安装部署 a.安装部署Filebeat ①安装Filebeat 1 2 3 4 5 6 #curl-L-Ohttps://artifacts.elastic.co/downloads/beats/filebeat/filebeat-5.0.1-x86_64.rpm #rpm-ivhfilebeat-5.0.1-x86_64.rpm #systemctlstartfilebeat #systemctlstatusfilebeat #filebeat.sh-version##查看版本 filebeatversion5.0.1(amd64),libbeat5.0.1 ②配置Filebeat 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 #cd/etc/filebeat #cpfilebeat.ymlfilebeat.yml.bak #vi/etc/filebeat/filebeat.yml##配置filebeat #=============Filebeatprospectors=============== filebeat.prospectors: -input_type:log paths: - /var/log/ *.log #====================Outputs===================== #-------------Elasticsearchoutput--------------- output.elasticsearch: #Arrayofhoststoconnectto. hosts:[ "localhost:9200" ] #----------------Logstashoutput----------------- output.logstash: #TheLogstashhosts hosts:[ "localhost:5043" ] ##只需配置该处,其他默认即可 #filebeat.sh-configtest-e##验证配置文件 ③配置Logstash 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 #cat/etc/logstash/conf.d/logstash.conf input{ beats{ port=> "5043" } } filter{ grok{ match=>{ "message" => "%{COMBINEDAPACHELOG}" } } geoip{ source => "clientip" } } output{ elasticsearch{ hosts=>[ "localhost:9200" ] } } #systemctlrestartlogstash##重启logstash #/usr/share/logstash/bin/logstash-f/etc/logstash/conf.d/logstash.conf--config.test_and_exit##验证配置文件 SendingLogstashlogsto /var/log/logstash which isnowconfiguredvialog4j2.properties ConfigurationOK #ss-tlnp|grep-E'5043|9600' ④配置kibana 浏览器输入http://localhost:5601,配置filebeat的索引(只需输入filebeat-*即可)。 在第一个框里输入filebeat-*后稍等片刻,kibana会自动识别,OK后下面的按钮会由灰色变为可操控的按钮"Create",如上图所示。点击该按钮后,最后就会呈现如下图所示: 我们再回过头新建logstash的索引,浏览器输入http://localhost:5601,点击左边栏的”Management” ===> 然后点击“index Patterns” ===> ===> 然后点击“Add New” ===> ===> 点击“Crete”按钮创建logstash索引,创建完成后即会展现如下图所示: b.安装部署Packetbeat ①安装配置Packetbeat 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 #yuminstalllibpcap #curl-L-Ohttps://artifacts.elastic.co/downloads/beats/packetbeat/packetbeat-5.0.1-x86_64.rpm #rpm-ivhpacketbeat-5.0.1-x86_64.rpm #cat/etc/packetbeat/packetbeat.yml ====================Networkdevice=================== packetbeat.interfaces.device:any ##捕获所有消息发送或接收的网络接口 ========================Flows======================== packetbeat.flows: timeout:30s period:10s ==================Transactionprotocols============== ##如下是packetbeat默认支持的主要协议及端口 packetbeat.protocols.icmp: enabled: true packetbeat.protocols.amqp: ports:[5672] packetbeat.protocols.cassandra: ports:[9042] packetbeat.protocols.dns: ports:[53] include_authorities: true include_additionals: true packetbeat.protocols.http: ports:[80,8080,8000,5000,8002] packetbeat.protocols.memcache: ports:[11211] packetbeat.protocols.mysql: ports:[3306] packetbeat.protocols.pgsql: ports:[5432] packetbeat.protocols.redis: ports:[6379] packetbeat.protocols.thrift: ports:[9090] packetbeat.protocols.mongodb: ports:[27017] packetbeat.protocols.nfs: ports:[2049] =========================General========================= =========================Outputs========================= -------------------Elasticsearchoutput------------------ output.elasticsearch: hosts:[ "localhost:9200" ] ---------------------Logstashoutput--------------------- output.logstash: hosts:[ "localhost:5043" ] ##只需配置该处,其他默认即可 =============================Logging===================== ②验证配置并启动packetbeat 1 2 3 4 5 6 7 #packetbeat.sh-version##查看packetbeat版本 packetbeatversion5.0.1(amd64),libbeat5.0.1 #packetbeat.sh-configtest-e##测试配置文件 ...... ConfigOK #systemctlstartpacketbeat #systemctlstatuspacketbeat ③配置Kibana(新建packetbeat索引) 在http://localhost:5601下新建索引页面输入“packetbeat-*”,之后kibana会自动更新,在“Time-field name”下面的三个选项中选择“@timestamp”,最后点击“Create”创建即可。 创建完成后,kibana显示如下: c.安装部署Metricbeat ①安装配置metricbeat 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 #curl-L-Ohttps://artifacts.elastic.co/downloads/beats/metricbeat/metricbeat-5.0.1-x86_64.rpm #rpm-ivhmetricbeat-5.0.1-x86_64.rpm #cat/etc/metricbeat/metricbeat.yml =================Modulesconfiguration================= metricbeat.modules: ----------------------SystemModule--------------------- -module:system metricsets: -cpu -load -filesystem -fsstat -memory -network -process enabled: true period:10s processes:[ '.*' ] =========================General======================= =========================Outputs======================= -------------------Elasticsearchoutput---------------- output.elasticsearch: hosts:[ "localhost:9200" ] ---------------------Logstashoutput------------------- output.logstash: hosts:[ "localhost:5043" ] ##只需配置该项,其他默认即可 =======================Logging========================= ②验证配置并启动metricbeat 1 2 3 4 5 #metricbeat.sh-version##查看版本信息 metricbeatversion5.0.1(amd64),libbeat5.0.1 #metricbeat.sh-configtest-e##验证配置文件 #systemctlstartmetricbeat #systemctlstatusmetricbeat ③配置kibana(新建metricbeat索引) 在http://localhost:5601下新建索引页面输入“metricbeat-*”,之后kibana会自动更新,在“Time-field name”下面的选项中选择“@timestamp”,最后点击“Create”创建即可。 最后呈现如下图所示: 注1: 关于ELK Stack的一些查询语句: ①查询filebeat 1 #curl-XGET'http://localhost:9200/filebeat-*/_search?pretty' ②查询packetbeat 1 #curl-XGET'http://localhost:9200/packetbeat-*/_search?pretty' ③查询metricbeat 1 #curl-XGET'http://localhost:9200/metricbeat-*/_search?pretty' ④查询集群健康度 1 #curl'localhost:9200/_cat/health?v' ⑤查看节点列表 1 2 3 #curl'localhost:9200/_cat/nodes?v' ipheap.percent ram .percentcpuload_1mload_5mload_15mnode.rolemastername 127.0.0.1379330.050.070.41mdi*XVY0Ovb ⑥列出所有索引 1 2 3 4 5 6 7 8 9 10 11 12 #curl'localhost:9200/_cat/indices?v' healthstatusindexuuidprirepdocs.countdocs.deletedstore.sizepri.store.size yellow open filebeat-2016.11.28Mn4MzxdTRaCj9iseutcmqA512012kb12kb yellow open filebeat-2016.11.29iMrr710mT42mApxdV62k-A51159065.9kb65.9kb yellow open packetbeat-2016.11.29wkTcIwD6RgiiCFwlWBIILA51565201.6mb1.6mb yellow open customerNvxXLgHoREefJLRhot13Ug5100800b800b yellow open packetbeat-2016.11.28Beoe07S7QB-dntNV4nxJNQ5124460676.4kb676.4kb yellow open test M7WbkYq2QNmeJ9NOyMfMZA5100800b800b yellow open logstash-2016.11.28pcb_84ChSBe9A7VRd-SQNw511610123.2kb123.2kb yellow open metricbeat-2016.11.29AmVeT1xCQGCnxlAFXUxhYw5194459037.6mb37.6mb yellow open logstash-2016.11.296PCKMYKCSVmPfdg-Sx2ARA5185772020.3mb20.3mb yellow open .kibanaQYTg0I5KS-yc3d7GSey3Zw1150102kb102kb 注2: 如果搭建期间有什么不清楚或不了解的,建议去看官方文档,文档地址如下: https://www.elastic.co/guide/index.html 注3:如需创建自己的beat,该处有教程可供学习: http://www.itnose.net/detail/6675459.html 本文转自 结束的伤感 51CTO博客,原文链接:http://blog.51cto.com/wangzhijian/1878636

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册