首页 文章 精选 留言 我的

精选列表

搜索[搜索引擎优化],共10000篇文章
优秀的个人博客,低调大师

优化技术专题-系统服务优化系列-这绝对是你的知识盲点,NUMA的为什么存在

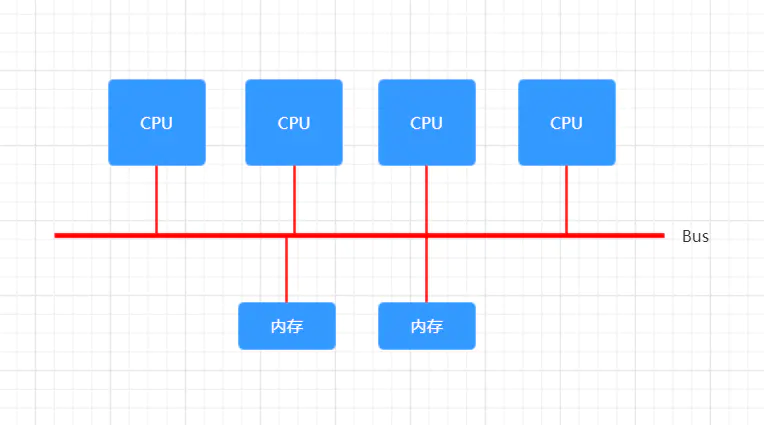
NUMA的产生背景 在NUMA架构出现前,CPU欢快的朝着频率越来越高的方向发展(纵向发展)。受到物理极限的挑战,又转为核数越来越多的方向发展(横向发展)。在一开始,内存控制器还在北桥中,所有CPU对内存的访问都要通过北桥来完成。此时所有CPU访问内存都是“一致的”,如下图所示: 这样的架构称为UMA(Uniform Memory Access),直译为“统一内存访问”,这样的架构对软件层面来说非常容易,总线模型保证所有的内存访问是一致的,即每个处理器核心共享相同的内存地址空间。但随着CPU核心数的增加,这样的架构难免遇到问题,比如对总线的带宽带来挑战、访问同一块内存的冲突问题。为了解决这些问题,有人搞出了NUMA。 注意:北桥芯片(North Bridge)是主板芯片组中起主导作用的最重要的组成部分,也称为主桥(Host Bridge)。 一般来说, 芯片组的名称就是以北桥芯片的名称来命名的,例如:英特尔845E芯片组的北桥芯片是82845E,875P芯片组的北桥芯片是82875P等等。 NUMA构架细节 通过“NUMA的产生背景”,让我们了解到了之前内存访问架构原则,与此相对的就是NUMA,NUMA 全称 Non-Uniform Memory Access,译为“非一致性内存访问”。这种构架下,不同的内存器件和CPU核心从属不同的Node,每个 Node 都有自己的集成内存控制器(IMC,Integrated Memory Controller)。 在 Node 内部,架构类似SMP,使用IMC Bus进行不同核心间的通信;不同的 Node间通过QPI(Quick Path Interconnect)进行通信,如下图所示: 一般来说,一个内存插槽对应一个Node。需要注意的一个特点是,QPI的延迟要高于IMC Bus,也就是说CPU访问内存有了远近(remote/local)之别,而且实验分析来看,这个差别非常明显。 在Linux中,对于NUMA有以下几个需要注意的地方: 默认情况下,内核不会将内存页面从一个 NUMA Node 迁移到另外一个 NUMA Node; 但是有现成的工具可以实现将冷页面迁移到远程(Remote)的节点:NUMA Balancing; 关于不同 NUMA Node 上内存页面迁移的规则,社区中有依然有不少争论。 NUMA详细分析 非一致性内存架构(Non-uniform Memory Architecture)是为了解决传统的对称多处理(Symmetric Multi-processor)系统中的可扩展性问题而诞生的。在对称多处理系统中,处理器共享北桥中的内存控制器来达到共同访问外部内存和IO的目的,也就是说所有的处理器对内存和I/O的访问方式和开销都是相同的。在这种系统中,随着更多的处理器被添加到SMP系统中,总线的竞争将会越来越大,系统的性能也必将随之大打折扣。SMP系统的示意图如下: 本地节点: 对于某个节点中的所有CPU,此节点称为本地节点;(速度最快) 邻居节点: 与本地节点相邻的节点称为邻居节点;(速度次之) 远端节点: 非本地节点或邻居节点的节点,称为远端节点。(速度最差) 超立方体可以作为一种有效的拓扑来描述NUMA系统,它将系统中的节点数限制在2^C内,C是每个节点拥有的邻居节点数,如下图所示 开销总结 以C=3为例,则对于节点1而言,2,3,5则为邻居节点,4,6,7,8为远端节点,显然访问开销的关系为 本地节点<邻居节点<远端节点。 NUMA案例分析 AMD Hyper-Transport 早期的SMP(对称多处理器系统) 只拥有一个位于北桥中的内存控制器,而如今更先进的做法是将内存控制器整合到CPU中去,这样每个CPU都拥有自己的内存控制器,不会相互之间产生竞争。 最先采用这种做法的一批处理器就是AMD在2003年推出的AMD Opteron系列处理器,其结构如下图所示: 每个CPU中都整合了一个内存控制器(IMC),并且CPU之间采用了一种Hyper-Transport的技术建立连接,这种连接可以使得CPU通过其他CPU来访问外部内存,当然访问开销要比访问本地内存更大。 操作系统的支持 为了支持NUMA架构,OS的设计必须将内存分布的特点考虑进去。 举一个简单的例子,假如一个进程运行在一个给定的处理器中,那么为这个进程所分配的物理内存就应该是该处理器的本地内存,而不是外部内存。 OS还要注意避免将一个进程从一个节点给迁移到另一个节点。在一个普通的多处理系统中,OS就应该已经尝试不去在处理器之间迁移进程,因为这意味着一个处理器的cache中的相关内容都将被丢失。如果在某种情况下必须进行迁移,那么OS可以随意选择一个空闲的处理器。 但是在NUMA系统中,可选择的新处理器将要受到一些限制,最重要的一点就是新处理器访问内存的开销不能比先前的处理器大,也就是说应该尽可能选择本地节点中的处理器。 当找不到符合条件的处理器,OS才能选择其他类型的处理器。 在这种较糟的情况下有两种选择: 如果进程只是暂时性的被迁移出去,可以再将其迁移回更加合适的处理器; 如果不是暂时性的,那么可以将该进程的内存拷贝到新处理器的内存中,这样就可以通过访问拷贝的内存来消除访问外部内存的开销,显然这是一种空间换时间的做法。 NUMA Node 操作 NUMA Node 分配 有两个NUMA Node,每个节点管理16GB内存。 NUMA Node 绑定 Node 和 Node 之间进行通信的代价是不等的,同样是 Remote 节点,其代价可能不一样,这个信息在 node distances 中以一个矩阵的方式展现。 我们可以将一个进程绑定在某个 CPU 或 NUMA Node 的内存上执行,如上图所示。 NUMA 状态

优秀的个人博客,低调大师

18、 Python快速开发分布式搜索引擎Scrapy精讲—Scrapy启动文件的配置—xpath表达式

【http://www.bdyss.cn】 【http://www.swpan.cn】 我们自定义一个main.py来作为启动文件 main.py #!/usr/bin/envpython #-*-coding:utf8-*- fromscrapy.cmdlineimportexecute#导入执行scrapy命令方法 importsys importos sys.path.append(os.path.join(os.getcwd()))#给Python解释器,添加模块新路径,将main.py文件所在目录添加到Python解释器 execute(['scrapy','crawl','pach','--nolog'])#执行scrapy命令 爬虫文件 #-*-coding:utf-8-*- importscrapy fromscrapy.httpimportRequest importurllib.response fromlxmlimportetree importre classPachSpider(scrapy.Spider): name='pach' allowed_domains=['blog.jobbole.com'] start_urls=['http://blog.jobbole.com/all-posts/'] defparse(self,response): pass xpath表达式 1、 2、 3、 基本使用 allowed_domains设置爬虫起始域名start_urls设置爬虫起始url地址parse(response)默认爬虫回调函数,response返回的是爬虫获取到的html信息对象,里面封装了一些关于htnl信息的方法和属性 responsehtml信息对象下的方法和属性response.url获取抓取的rulresponse.body获取网页内容response.body_as_unicode()获取网站内容unicode编码xpath()方法,用xpath表达式过滤节点extract()方法,获取过滤后的数据,返回列表 #-*-coding:utf-8-*- importscrapy classPachSpider(scrapy.Spider): name='pach' allowed_domains=['blog.jobbole.com'] start_urls=['http://blog.jobbole.com/all-posts/'] defparse(self,response): leir=response.xpath('//a[@class="archive-title"]/text()').extract()#获取指定标题 leir2=response.xpath('//a[@class="archive-title"]/@href').extract()#获取指定url print(response.url)#获取抓取的rul print(response.body)#获取网页内容 print(response.body_as_unicode())#获取网站内容unicode编码 foriinleir: print(i) foriinleir2: print(i) 【转载自:http://www.lqkweb.com】

优秀的个人博客,低调大师

Coding Agent长期记忆方案与Token优化

全球软件工程正加速进入"Agentic Coding"时代。据行业观测,复杂编码基准中读操作(cat/grep/head 等)已消耗 Claude Sonnet 4.5 全部 Token 的 76.1%,而无状态 Agent 每会话 bootstrap 可烧掉 59,000+ input tokens 才写第一行代码(含 12,000 token 产品规格、8,000 token 架构文档、3,000 token 编码规范、6,000 token 历史决策)。当标准 Transformer 自注意力面对 4k–128k tokens 的有限缓冲时,注意力复杂度二次增长且对"lost in the middle"高度敏感,上下文填满后模型推理能力下降。

优秀的个人博客,低调大师

性能优化左移:测试提前介入实战指南

在多数软件交付流程中,性能问题总在UAT甚至上线后才浮出水面——API响应超时、高并发下服务雪崩、数据库连接池耗尽……这些‘意料之外’的故障,往往源于一个共同症结:性能测试被严重右移。据2023年Apica与GitLab联合调研,72%的企业将性能测试安排在开发完成之后,平均修复成本是早期发现的6.8倍。而真正的效能革命,不在压测报告里,而在第一行代码提交前。

优秀的个人博客,低调大师

团队转型:测试覆盖率优化实战

在敏捷与DevOps深度落地的今天,「测得快」已成标配,而「测得准、测得全、测得稳」正成为测试团队价值跃迁的关键分水岭。某金融级SaaS企业「智信科技」曾面临典型困境:单元测试覆盖率长期徘徊在42%,核心交易链路缺乏契约保障,每次发布前需投入3人日进行回归验证,线上缺陷逃逸率高达18%。2023年Q2起,其测试团队启动系统性转型——不以覆盖率数字为目标,而以「可交付质量韧性」为北极星指标,最终10个月内将关键模块单元测试覆盖率提升至89%,集成测试通过率稳定达99.6%,发布周期缩短40%。这场转型,不是工具堆砌,而是一场认知重构与工程协同的深度实践。

优秀的个人博客,低调大师

测试专家必看:智能回归测试性能优化

在持续交付节奏日益加快的今天,回归测试正从‘质量守门员’演变为‘交付加速器’。然而,传统回归测试面临三大顽疾:用例冗余率超65%(2023年Applitools调研)、执行耗时占CI流水线42%、缺陷漏出率随版本迭代不降反升。当一个中型SaaS产品单日提交超200次,人工维护的回归套件已不堪重负——此时,‘智能回归测试’不再是一种可选项,而是性能瓶颈突围的关键路径。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册