首页 文章 精选 留言 我的

精选列表

搜索[搜索引擎优化],共10000篇文章
优秀的个人博客,低调大师

Native 性能稳定性极致优化

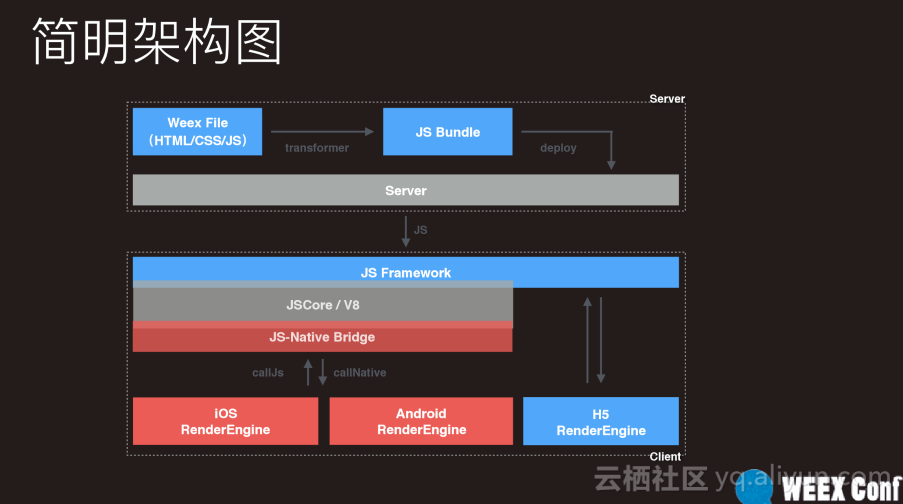
Weex 作为阿里开源的高性能跨平台移动开发框架,开源至今倍受关注,不到一年的时间,已经Github Star数超过1w!它能够完美兼顾性能与动态性,让移动开发者通过简捷的前端语法写出Native级别的性能体验,并支持iOS、安卓、YunOS及Web等多端部署。 Weex简明架构 图中是Weex 整体的工作流程:业务开发者通过声明式的定义组件完成.we文件开发之后,经过Transformer模块将.we 文件转为 JS Bundle,JS Bundle主要描述了业务页面的模板、结构、数据逻辑;然后再将其部署到业务服务端。客户端访问Weex页面时,首先会网络请求JS Bundle,JS Bundle被加载到客户端本地后,会进入JSFramework中进行解析渲染;JSFramework解析和渲染的过程其实是根据JS Bundle的数

优秀的个人博客,低调大师

YARN and MapReduce的【内存】优化配置详解

在Hadoop2.x中, YARN负责管理MapReduce中的资源(内存, CPU等)并且将其打包成Container。 使之专注于其擅长的数据处理任务, 将无需考虑资源调度. 如下图所示 Y ARN会管理集群中所有机器的可用计算资源. 基于这些资源YARN会调度应用(比如MapReduce)发来的资源请求, 然后YARN会通过分配Co ntainer来给每个应用提供处理能力, Container是YARN中处理能力的基本单元, 是对内存, CPU等的封装. 目前我这里的服务器情况:6台slave,每台:32G内存,2*6核CPU。 由于hadoop 1.x存在JobTracker和TaskTracker,资源管理有它们实现,在执行mapreduce作业时,资源分为map task和reduce task。所有存在下面两个参数分别设置每个TaskTracker可以运行的任务数: 点击(此处)折叠或打开 <property> <name>mapred.tasktracker.map.tasks.maximum</name> <value>6</value> <description><![CDATA[CPU数量=服务器CPU总核数 / 每个CPU的核数;服务器CPU总核数 = more /proc/cpuinfo | grep 'processor' | wc -l;每个CPU的核数 = more /proc/cpui nfo | grep 'cpu cores']]></description> </property> <property> <name>mapred.tasktracker.reduce.tasks.maximum</name> <value>4</value> <description>一个task tracker最多可以同时运行的reduce任务数量</description> </property> 但是在hadoop 2.x中,引入了Yarn架构做资源管理,在每个节点上面运行NodeManager负责节点资源的分配,而slot也不再像1.x那样区分Map slot和Reduce slot。在Yarn上面Container是资源的分配的最小单元。 Yarn集群的内存分配配置在yarn-site.xml文件中配置: 点击(此处)折叠或打开 <property> <name>yarn.nodemanager.resource.memory-mb</name> <value>22528</value> <discription>每个节点可用内存,单位MB</discription> </property> <property> <name>yarn.scheduler.minimum-allocation-mb</name> <value>1500</value> <discription>单个任务可申请最少内存,默认1024MB</discription> </property> <property> <name>yarn.scheduler.maximum-allocation-mb</name> <value>16384</value> <discription>单个任务可申请最大内存,默认8192MB</discription> </property> 由于我Yarn集群还需要跑Spark的任务,而Spark的Worker内存相对需要大些,所以需要调大单个任务的最大内存(默认为8G)。 而Mapreduce的任务的内存配置: 点击(此处)折叠或打开 <property> <name>mapreduce.map.memory.mb</name> <value>1500</value> <description>每个Map任务的物理内存限制</description> </property> <property> <name>mapreduce.reduce.memory.mb</name> <value>3000</value> <description>每个Reduce任务的物理内存限制</description> </property> <property> <name>mapreduce.map.java.opts</name> <value>-Xmx1200m</value> </property> <property> <name>mapreduce.reduce.java.opts</name> <value>-Xmx2600m</value> </property> mapreduce. map .memory.mb:每个 map 任务的内存,应该是大于或者等于 Container 的最小内存。 按照上面的配置:每个slave可以运行 map 的数据<= 22528 / 1500 , reduce 任务的数量<= 22528/3000 。 mapreduce.map.memory.mb >mapreduce.map.java.optsmapreduce.reduce.memory.mb >mapreduce.reduce.java.opts mapreduce.map.java.opts / mapreduce.map.memory.mb =0.70~0.80mapreduce.reduce.java.opts / mapreduce.reduce.memory.mb =0.70~0.80 在yarn container这种模式下,JVM进程跑在container中,mapreduce.{map|reduce}.java.opts 能够通过Xmx设置JVM最大的heap的使用, 一般设置为0.75倍的memory.mb, 则预留些空间会存储java,scala code等。


优秀的个人博客,低调大师

Android官方开发文档Training系列课程中文版:布局性能优化之ListView的优化

原文地址:http://android.xsoftlab.net/training/improving-layouts/smooth-scrolling.html 想要让ListView滑动流畅的关键所在是减轻主线程的负担。要确保任何的磁盘访问、网络访问、或者SQL访问都是在单独的线程中执行的。如果要测试APP的状态,可以开启StrictMode。 使用后台线程 使用工作线程可以使UI线程将所有的注意力都集中在UI的绘制上。在很多情况下,使用AsyncTask所提供的功能就可以在工作线程中处理耗时任务。AsyncTask会自动的将execute()发起的请求排队,并依次执行。这意味着你不要自己创建线程池。 在下面的示例代码中,AsyncTask被用来加载一张图像,并在加载结束后自动的将其渲染到UI上。它还在图像加载时展示了一个旋转的进度条。 // Using an AsyncTask to load the slow images in a background thread new AsyncTask<ViewHolder, Void, Bitmap>() { private ViewHolder v; @Override protected Bitmap doInBackground(ViewHolder... params) { v = params[0]; return mFakeImageLoader.getImage(); } @Override protected void onPostExecute(Bitmap result) { super.onPostExecute(result); if (v.position == position) { // If this item hasn't been recycled already, hide the // progress and set and show the image v.progress.setVisibility(View.GONE); v.icon.setVisibility(View.VISIBLE); v.icon.setImageBitmap(result); } } }.execute(holder); 从Android 3.0开始,AsyncTask提供了一项新特性:可以将任务运行在多核处理器上。你可以使用executeOnExecutor()方法发起执行请求,这样多个请求就可以同时进行,同时进行的任务数量取决于CPU的核心数量。 使用View Holder持有View对象 在滑动ListView时,代码可能会频繁的调用findViewById(),这会降低性能。就算是Adapter将已经加载过的View返回,但是在复用时还是需要去查询这些View来更新它们。杜绝重复使用findViewById()的方法就是使用”View Holder”设计模式。 ViewHolder对象将每个View组件存储于布局容器的tag属性内,所以你可以快速访问它们而不需要每次都去查询。首先,你需要创建一个类来持有已加载的View: static class ViewHolder { TextView text; TextView timestamp; ImageView icon; ProgressBar progress; int position; } 然后对ViewHolder的成员属性赋值,然后将其存放在布局容器内: ViewHolder holder = new ViewHolder(); holder.icon = (ImageView) convertView.findViewById(R.id.listitem_image); holder.text = (TextView) convertView.findViewById(R.id.listitem_text); holder.timestamp = (TextView) convertView.findViewById(R.id.listitem_timestamp); holder.progress = (ProgressBar) convertView.findViewById(R.id.progress_spinner); convertView.setTag(holder); 那么现在就可以很方便的对这些View组件进行访问,而不再需要对它们单独进行查询,如此便可以节省出宝贵的CPU资源。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册