首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

主流编程语言的对比分析

最近做Android和IOS项目,由资深windows平台C++开发转型做移动平台,涉及到C++、Java、ObjectC三类语言的对比,本文将从面向对象语言三大特性&五大原则角度对比分析,总结沉淀下来(N年前做Java的时候就想干的事,现在总算动手了) 三大特性: 封装 封装:把客观事物封装成抽象的类,并且类可以把自己的数据和方法只让可信的类或者对象操作,对不可信的进行信息隐藏。类就是一个封装了数据以及操作这些数据的代码的逻辑实体。 继承 继承:指可以让某个类型的对象获得另一个类型的对象的属性的方法。 C++ Java ObjectC 多态 多态:指一个类实例的相同方法在不同情形有不同表现形式 C++ Java ObjectC 重载 C++ Java ObjectC 五大原则 单一职责原则 对类来说:类的功能要单一,不能包罗万象。 开放封闭原则 对模块来说:在扩展性方面应该是开放的而在更改性方面应该是封闭的。比如在设计解码模块时,要考虑ffmpeg软解、Android和IOS的硬解,在设计模块对外接口时,抽取其共性,搭好框架后,可以先实现软解,在后期再扩展硬解时,无需改变整体代码,即可方便扩展。这也是插件化思想的体现。 替换原则 对继承来说:子类应当可以替换父类并出现在父类能够出现的任何地方。即可通过替换原则验证父类设计是否合理,有无改进。 依赖倒置原则 依赖倒置原则是设计中解耦、减少依赖的核心方法。 举例:依赖倒置的典型时序图—-待补充 接口分离原则 模块间要通过抽象接口隔离开,而不是通过具体的类强耦合起来

优秀的个人博客,低调大师

浅谈多线程编程中的误区

虽然很多程序员可以对异步、GCD等等与线程相关的概念说的天花乱坠。但是实质上深挖本质的话,大多数人并不能很好的区分Race Condition,Atomic,Immutable对象在线程安全中真正起到的作用。 所以今天就以这篇文章来谈谈我所理解的线程安全。 首先就允许我从Immutable来开始整篇话题吧。 Immutable 最近几年,Immutable这个说法开始越来越流行。比如用过Swift的人都知道,Swift相较于Objective-C有一个比较明显的改动就是将结构体(Struct)和类型(Class)进行了分离。从某种方面来说,Swift将值类型和引用类型进行了明显的区分。为什么要这么做? 避免了引用类型在被作为参数传递后被他人持有后修改,从而引发比较难以排查的问题。 在某些程度上提供了一定的线程安全(因为多线程本身的问题很大程序

优秀的个人博客,低调大师

MapReduce编程实例之倒排索引 1

任务描述: 有一批电话清单,记录了用户A拨打给用户B的记录 做一个倒排索引,记录拨打给用户B所有的用户A、 example data: 13614004876 110 18940084808 10086 13342445911 10001 13614004876 120 18940084808 1008611 13342445911 110 15847985621 10000 code: <span style="font-size:14px;">package mrTest; import java.io.IOException; import java.util.Date; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import com.ibm.icu.text.SimpleDateFormat; public class daopaisuoyin { enum Counter{ LINESKIP, //出错的行 } public static class Map extends Mapper<Object, Text, Text, Text>{ public void map(Object key,Text value,Context context){ String line = value.toString(); try{ String[] lineSplit = line.split(" "); String newKey = lineSplit[0]; String newValue = lineSplit[1]; context.write(new Text(newKey), new Text(newValue)); }catch(Exception e){ context.getCounter(Counter.LINESKIP).increment(1); return; } } } public static class Reduce extends Reducer<Text, Text, Text, Text>{ public void reduce(Text key, Iterable<Text> values, Context context) throws IOException, InterruptedException{ String result = ""; for (Text value : values) { result += value.toString() + " # "; } context.write(key, new Text(result)); } } public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException { // TODO Auto-generated method stub Job job = new Job(new Configuration(), " 倒排索引 "); job.setJarByClass(daopaisuoyin.class); job.setNumReduceTasks(1); job.setOutputKeyClass(Text.class); job.setOutputValueClass(Text.class); job.setMapperClass(Map.class); job.setReducerClass(Reduce.class); FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); //记录时间 SimpleDateFormat sdf = new SimpleDateFormat(); Date start = new Date(); //开始时间 int result = job.waitForCompletion(true)? 0 : 1; //任务开始 Date end = new Date(); //结束时间 float time = (float)((end.getTime() - start.getTime()) / 60000.0); //任务开始到结束经历的时间 System.out.println("Job 开始的时间为:" + start); System.out.println("Job 结束的时间为:" + end); System.out.println("Job 经历的时间为:" + time + "分钟"); System.out.println("Job 的名字:" + job.getJobName()); System.out.println("Job 是否成功:" + job.isSuccessful() ); System.out.println("Job 输入的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_INPUT_RECORDS").getValue()); System.out.println("Job 输出的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_OUTPUT_RECORDS").getValue()); System.exit(result); //判断是否结束 } } </span> 结果显示:

优秀的个人博客,低调大师

MapReduce编程实例之数据去重

任务描述: 让原始数据中出现次数超过一次的数据在输出文件中只出现一次。 example data: 2015-3-1 a 2015-3-2 b 2015-3-3 c 2015-3-4 d 2015-3-5 e 2015-3-6 f 2015-3-7 g 2015-3-1 a 2015-3-2 b 2015-3-3 c 2015-3-4 d 2015-3-5 e 2015-3-6 f 2015-3-7 g 2015-3-1 a 2015-3-2 b 2015-3-3 c 2015-3-4 d 2015-3-5 e 2015-3-6 f 2015-3-7 g code: package mrTest; import java.io.IOException; import java.util.Date; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.NullWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import com.ibm.icu.text.SimpleDateFormat; public class shujuquchong { public static class Map extends Mapper<Object, Text, Text, NullWritable>{ public void map(Object key,Text value,Context context) throws IOException, InterruptedException{ context.write(value, NullWritable.get()); } } public static class Reduce extends Reducer< Text, NullWritable, Text, NullWritable>{ public void reduce(Text key, Iterable<NullWritable> values, Context context) throws IOException, InterruptedException{ context.write(key, NullWritable.get()); } } public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException { // TODO Auto-generated method stub Job job = new Job(new Configuration(), " 数据去重"); job.setJarByClass(shujuquchong.class); job.setNumReduceTasks(1); job.setOutputKeyClass(Text.class); job.setOutputValueClass(NullWritable.class); job.setMapperClass(Map.class); job.setReducerClass(Reduce.class); FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); //记录时间 SimpleDateFormat sdf = new SimpleDateFormat(); Date start = new Date(); //开始时间 int result = job.waitForCompletion(true)? 0 : 1; //任务开始 Date end = new Date(); //结束时间 float time = (float)((end.getTime() - start.getTime()) / 60000.0); //任务开始到结束经历的时间 System.out.println("Job 开始的时间为:" + start); System.out.println("Job 结束的时间为:" + end); System.out.println("Job 经历的时间为:" + time + "分钟"); System.out.println("Job 的名字:" + job.getJobName()); System.out.println("Job 是否成功:" + job.isSuccessful() ); System.out.println("Job 输入的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_INPUT_RECORDS").getValue()); System.out.println("Job 输出的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "MAP_OUTPUT_RECORDS").getValue()); System.out.println("Job 输入的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "REDUCE_INPUT_RECORDS").getValue()); System.out.println("Job 输出的行数:" + job.getCounters().findCounter("org.apache.hadoop.mapred.Task$Counter", "REDUCE_OUTPUT_RECORDS").getValue()); System.exit(result); //判断是否结束 } } 结果展示:
优秀的个人博客,低调大师

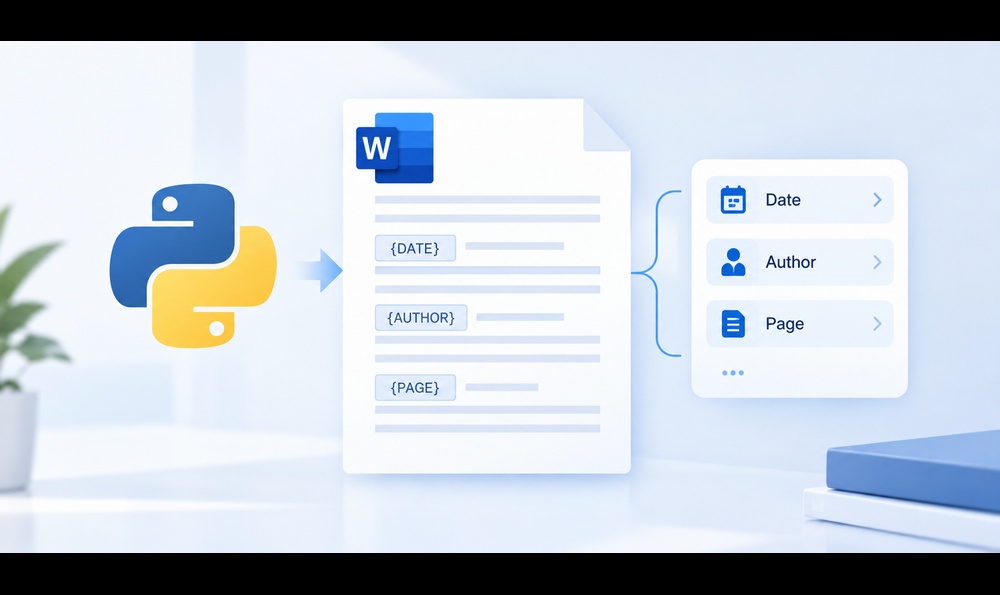
Python Word 编程:插入、更新和管理域

域(Field)是 Word 中的一种特殊元素,它的显示内容由域代码和域结果组成,可以根据环境或文档状态动态更新。例如页脚里的"第 X 页"、目录页码、章节引用,以及"如果数量大于 100 则显示某段文字"这种条件判断,都是通过域实现的。手动在 Word 中插入域需要熟悉域代码的写法,而且当一个文档里散落着几十个域时,逐个更新很麻烦。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册