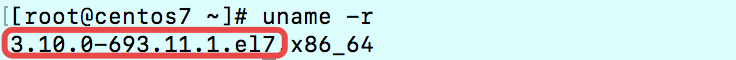首页 文章 精选 留言 我的

精选列表

搜索[搭建],共10000篇文章
优秀的个人博客,低调大师

windows 基于docker下的 spark 开发环境搭建

docker toolbox https://www.docker.com/products/docker-toolbox spark https://hub.docker.com/r/singularities/spark/~/dockerfile/ # start-hadoop-namenode # hadoop fs -mkdir /user # hadoop fs -mkdir /user/root/ # hadoop fs -put ./README.md /user/root # start-spark # start-spark worker [master] # spark-shell # spark-shell --master spark://a60b8c8f9653:7077 scala> val lines = sc.textFile("file:///usr/local/spark-2.1.0/README.md") scala> val lines = sc.textFile("hdfs:///usr/local/spark-2.1.0/README.md") lines: org.apache.spark.rdd.RDD[String] = file:///usr/local/spark-2.1.0/README.md MapPartitionsRDD[1] at textFile at <console>:24 scala> lines.count() res0: Long = 104 scala> lines.saveAsTextFile("hdfs:///user/root/README2.md") // 保存到hdfs 本文转自 拖鞋崽 51CTO博客,原文链接:http://blog.51cto.com/1992mrwang/1895904

优秀的个人博客,低调大师

Hadoop2.6.0伪分布式集群搭建

应用场景 在研究hadoop的过程中,当然需要部署hadoop集群,如果想要在本地简单试用hadoop,并且没有那么多服务器供你使用,那么伪分布式hadoop环境绝对是你最好的选择。 操作步骤 1. 安装JDK 1.1 查看是否安装了openjdk # java -version openjdk version "1.8.0_65" OpenJDK Runtime Environment (build 1.8.0_65-b17) OpenJDK 64-Bit Server VM (build 25.65-b01, mixed mode) 1.2 查看openjdk源 # rpm -qa | grep java java-1.7.0-openjdk-1.7.0.91-2.6.2.3.el7.x86_64 tzdata-java-2015g-1.el7.noarch python-javapackages-3.4.1-11.el7.noarch javapackages-tools-3.4.1-11.el7.noarch java-1.8.0-openjdk-headless-1.8.0.65-3.b17.el7.x86_64 java-1.8.0-openjdk-1.8.0.65-3.b17.el7.x86_64 java-1.7.0-openjdk-headless-1.7.0.91-2.6.2.3.el7.x86_64 1.3 依次删除openjdk # rpm -e --nodeps java-1.7.0-openjdk-1.7.0.91-2.6.2.3.el7.x86_64 # rpm -e --nodeps tzdata-java-2015g-1.el7.noarch # rpm -e --nodeps java-1.8.0-openjdk-headless-1.8.0.65-3.b17.el7.x86_64 # rpm -e --nodeps java-1.8.0-openjdk-1.8.0.65-3.b17.el7.x86_64 # rpm -e --nodeps java-1.7.0-openjdk-headless-1.7.0.91-2.6.2.3.el7.x86_64 1.4 重新下载jdk 将下载JDK的后缀为.tar.gz,上传到linux上,解压缩至/opt路径下 jdk下载地址 1.5 配置JDK环境变量 # vim /etc/profile JAVA_HOME=/opt/jdk1.7.0_79 JRE_HOME=/opt/jdk1.7.0_79/jre CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib:$CLASSPATH PATH=$JAVA_HOME/bin:$PATH 1.6 使变量生效 # source /etc/profile 2. SSH免秘钥登录 2.1 正常登陆,节点跳转ssh,需要输入用户名密码,每次都需要输入,很麻烦,需要设置成免密码登录 # ssh localhost The authenticity of host 'localhost (::1)' can't be established. ECDSA key fingerprint is 7b:10:e3:b5:ea:7d:29:be:77:83:1c:c0:1d:85:de:ba. Are you sure you want to continue connecting (yes/no)? yes Warning: Permanently added 'localhost' (ECDSA) to the list of known hosts. [root@localhost's password: Last login: Sat Apr 2 22:32:44 2016 2.2 配置免密码登录 # cd ~/.ssh/ #若没有该目录,请先执行一次 # ssh localhost # ssh-keygen -t rsa #会有提示,都按回车就可以 # cat id_rsa.pub >> authorized_keys # chmod 600 ./authorized_keys # 加入授权 2.3 再次登录,可免秘钥 # ssh localhost Last login: Sat Apr 2 22:51:41 2016 from localhost 3. 安装Hadoop 3.1 解压Hadoop至/opt路径下 下载hadoop2.6.0 下载hadoop其他版本 3.2 配置Hadoop环境变量 # vim /etc/profile export JAVA_HOME=/opt/jdk1.7.0_79 export HADOOP_HOME=/opt/hadoop-2.6.0 export HADOOP_PREFIX=/opt/hadoop-2.6.0 export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin 3.3 使变量生效 # source /etc/profile 3.4 修改hadoop-env.sh # cd /opt/hadoop-2.6.0 # 进入hadoop目录,修改hadoop-env.sh,添加JAVA_HOME路径 # vim etc/hadoop/hadoop-env.sh export JAVA_HOME=/opt/jdk1.7.0_79 # bin/hadoop # 执行hadoop指令,测试 3.5 配置HDFS 3.5.1 编辑core-site.xml # vim /opt/hadoop-2.6.0/etc/hadoop/core-site.xml <configuration> <property> <name>hadoop.tmp.dir</name> <value>file:/opt/hadoop-2.6.0/tmp</value> <description>Abase for other temporary directories.</description> </property> <property> <name>fs.defaultFS</name> <value>hdfs://192.168.208.110:9000</value> </property> </configuration> 3.5.2 编辑hdfs-site.xml # vim /opt/hadoop-2.6.0/etc/hadoop/hdfs-site.xml <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.namenode.name.dir</name> <value>file:/opt/hadoop-2.6.0/tmp/dfs/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <value>file:/opt/hadoop-2.6.0/tmp/dfs/data</value> </property> <property> <name>dfs.permissions.enabled</name> <value>false</value> </property> </configuration> 3.5.3 格式化 [root@hadoop hadoop-2.6.0]# hdfs namenode -format 省略N行 16/04/02 22:54:15 INFO common.Storage: Storage directory /tmp/hadoop-root/dfs/name has been successfully formatted. /************************************************************ SHUTDOWN_MSG: Shutting down NameNode at bogon/221.192.153.42 ************************************************************/ 3.5.4 开启HDFS # start-dfs.sh 访问http://localhost:50070 3.5.5 HDFS简单使用案例 # hdfs dfs -mkdir /user # hdfs dfs -mkdir /user/lei # hdfs dfs -put etc/hadoop input # 如果出现没有input错误 put: `input': No such file or directory # bin/hadoop fs -mkdir -p input # 手动创建 # hdfs dfs -put etc/hadoop input # hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.6.0.jar grep input output 'dfs[a-z.]+' # hdfs dfs -ls / #查看文件 DEPRECATED: Use of this script to execute hdfs command is deprecated. Instead use the hdfs command for it. Found 2 items drwxr-xr-x - root supergroup 0 2016-04-02 23:39 input drwxr-xr-x - root supergroup 0 2016-04-02 23:43 output 3.6 YARN配置 3.6.1 配置mapred-site.xml # cp etc/hadoop/mapred-site.xml.template etc/hadoop/mapred-site.xml # vim /opt/hadoop-2.6.0/etc/hadoop/mapred-site.xml <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <property> <name>mapred.job.tracker</name> <value>192.168.208.110:10020</value> </property> </configuration> 3.6.2 配置yarn-site.xml # vim /opt/hadoop-2.6.0/etc/hadoop/yarn-site.xml <configuration> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> </configuration> 3.6.3 启动YARN # start-yarn.sh 访问http://localhost:8088

优秀的个人博客,低调大师

0基础搭建Hadoop大数据处理-初识

在互联网的世界中数据都是以TB、PB的数量级来增加的,特别是像BAT光每天的日志文件一个盘都不够,更何况是还要基于这些数据进行分析挖掘,更甚者还要实时进行数据分析,学习,如双十一淘宝的交易量的实时展示。 大数据什么叫大?4个特征: 体量化 Volume,就是量大。 多样化 Variety,可能是结构型的数据,也可能是非结构行的文本,图片,视频,语音,日志,邮件等 快速化 Velocity,产生快,处理也需要快。 价值密度低 Value,数据量大,但单个数据没什么意义,需要宏观的统计体现其隐藏的价值。 可以看出想只要一台强大的服务器来实时处理这种体量的数据那是不可能的,而且成本昂贵,代价相当大,普通的关系型数据库也随着数据量的增大其处理时间也随之增加,那客户是不可能忍受的,所以我们需要Hadoop来解决此问题。 优点: Hadoop是一个能够让用户轻松架构和使用的分布式计算平台。用户可以轻松地在Hadoop上开发和运行处理海量数据的应用程序。它主要有以下几个优点: 高可靠性。Hadoop按位存储和处理数据的能力值得人们信赖。 高扩展性。Hadoop是在可用的计算机集簇间分配数据并完成计算任务的,这些集簇可以方便地扩展到数以千计的节点中。 高效性。Hadoop能够在节点之间动态地移动数据,并保证各个节点的动态平衡,因此处理速度非常快。 高容错性。Hadoop能够自动保存数据的多个副本,并且能够自动将失败的任务重新分配。 低成本。与一体机、商用数据仓库以及QlikView、Yonghong Z-Suite等数据集市相比,hadoop是开源的,项目的软件成本因此会大大降低。 Hadoop得以在大数据处理应用中广泛应用得益于其自身在数据提取、变形和加载(ETL)方面上的天然优势。Hadoop的分布式架构,将大数据处理引擎尽可能的靠近存储,对例如像ETL这样的批处理操作相对合适,因为类似这样操作的批处理结果可以直接走向存储。Hadoop的MapReduce功能实现了将单个任务打碎,并将碎片任务(Map)发送到多个节点上,之后再以单个数据集的形式加载(Reduce)到数据仓库里。 Hadoop在各应用中是最底层,最基础的组件,所以其重要性不言而喻。 框架结构 Hadoop主要由HDFS ( 分布式文件系统)和MapReduce (并行计算框架)组成。 Hadoop 由许多元素构成。其最底部是 Hadoop Distributed File System(HDFS),它存储 Hadoop 集群中所有存储节点上的文件。HDFS(对于本文)的上一层是MapReduce引擎,该引擎由 JobTrackers 和 TaskTrackers 组成。通过对Hadoop分布式计算平台最核心的分布式文件系统HDFS、MapReduce处理过程,以及数据仓库工具Hive和分布式数据库Hbase的介绍,基本涵盖了Hadoop分布式平台的所有技术核心。 HDFS 对外部客户机而言,HDFS就像一个传统的分级文件系统。可以创建、删除、移动或重命名文件,等等。但是 HDFS 的架构是基于一组特定的节点构建的,这是由它自身的特点决定的。这些节点包括 NameNode(仅一个),它在 HDFS 内部提供元数据服务;DataNode,它为 HDFS 提供存储块。由于仅存在一个 NameNode,因此这是 HDFS 的一个缺点(单点失败)。 存储在 HDFS 中的文件被分成块,然后将这些块复制到多个计算机中(DataNode)。这与传统的 RAID 架构大不相同。块的大小(通常为 64MB)和复制的块数量在创建文件时由客户机决定。NameNode 可以控制所有文件操作。HDFS 内部的所有通信都基于标准的TCP/IP协议。 单节点物理结构 主从结构 主节点,只有一个: namenode 从节点,有很多个: datanodes namenode负责:接收用户操作请求 、维护文件系统的目录结构、管理文件与block之间关系,block与datanode之间关系 NameNode 是一个通常在HDFS实例中的单独机器上运行的软件。它负责管理文件系统名称空间和控制外部客户机的访问。 datanode负责:存储文件文件被分成block存储在磁盘上、为保证数据安全,文件会有多个副本 MapReduce MapReduce是处理大量半结构化数据集合的编程模型。编程模型是一种处理并结构化特定问题的方式。例如,在一个关系数据库中,使用一种集合语言执行查询,如SQL。告诉语言想要的结果,并将它提交给系统来计算出如何产生计算。还可以用更传统的语言(C++,Java),一步步地来解决问题。这是两种不同的编程模型,MapReduce就是另外一种。 MapReduce和Hadoop是相互独立的,实际上又能相互配合工作得很好。 主从结构 主节点,只有一个: JobTracker 从节点,有很多个: TaskTrackers JobTracker负责:接收客户提交的计算任务、把计算任务分给TaskTrackers执行、监控TaskTracker的执行情况 TaskTrackers负责:执行JobTracker分配的计算任务 Hadoop能做什么? 大数据量存储:分布式存储 日志处理: Hadoop擅长这个 海量计算: 并行计算 ETL:数据抽取到oracle、mysql、DB2、mongdb及主流数据库 使用HBase做数据分析: 用扩展性应对大量的写操作—Facebook构建了基于HBase的实时数据分析系统 机器学习: 比如Apache Mahout项目 搜索引擎:hadoop + lucene实现 数据挖掘:目前比较流行的广告推荐 大量地从文件中顺序读。HDFS对顺序读进行了优化,代价是对于随机的访问负载较高。 数据支持一次写入,多次读取。对于已经形成的数据的更新不支持。 数据不进行本地缓存(文件很大,且顺序读没有局部性) 任何一台服务器都有可能失效,需要通过大量的数据复制使得性能不会受到大的影响。 用户细分特征建模 个性化广告推荐 智能仪器推荐 扩展 实际应用: Hadoop+HBase建立NoSQL分布式数据库应用 Flume+Hadoop+Hive建立离线日志分析系统 Flume+Logstash+Kafka+Spark Streaming进行实时日志处理分析 酷狗音乐的大数据平台 京东的智能供应链预测系统 Hadoop的学习不仅仅是学习Hadoop,还要学习Linux,网络知识,Java、还有数据结构和算法等等,所以万里长征才开始第一步,希望Hadoop学习不是从了解到放弃。 本文转自欢醉博客园博客,原文链接http://www.cnblogs.com/zhangs1986/p/6528227.html如需转载请自行联系原作者 欢醉

优秀的个人博客,低调大师

android122 zhihuibeijing 主页面使用fragment搭建

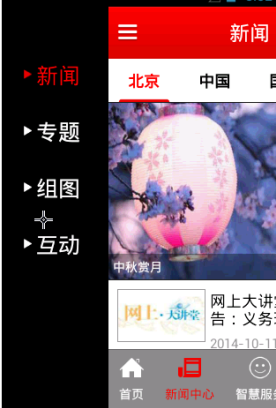
fragment的生命周期: onAttach()当fragment添加进Activity的时候调用(这个时候Activity对象已经存在了,不然就依赖不上去的) onCreate()当fragment创建的时候调用。 onCreateView()当fragment画界面的时候调用。 onActivityCreated()当fragment依附的Activity创建完成的时候调用。 onStart(),onResume(),onPause(),onStop(),onDestroyView(),onDestroy(). onStart()对着onStop(), onResume()对着onPause(), onDestroyView()对着onCreateView(), onDestroy()对着onCreate()。 Mainactivity package com.itheima.zhbj52; import android.os.Bundle; import android.support.v4.app.FragmentManager; import android.support.v4.app.FragmentTransaction; import com.itheima.zhbj52.fragment.ContentFragment; import com.itheima.zhbj52.fragment.LeftMenuFragment; import com.jeremyfeinstein.slidingmenu.lib.SlidingMenu; import com.jeremyfeinstein.slidingmenu.lib.app.SlidingFragmentActivity; /** * 主页面 */ public class MainActivity extends SlidingFragmentActivity {//使用开源SlidingMenu框架实现侧边栏, private static final String FRAGMENT_LEFT_MENU = "fragment_left_menu"; private static final String FRAGMENT_CONTENT = "fragment_content"; @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main);//主页面是一个空的FrameLayout,后面会用Fragment填充。 setBehindContentView(R.layout.left_menu);//侧边栏也是一个空的FrameLayout,后面会用Fragment填充,SlidingFragmentActivity这个库的方法,设置左侧边栏布局。 SlidingMenu slidingMenu = getSlidingMenu();// 获取侧边栏对象 slidingMenu.setTouchModeAbove(SlidingMenu.TOUCHMODE_FULLSCREEN);// 设置主屏幕可以全屏触摸进行滑动, slidingMenu.setBehindOffset(200);// 设置预留屏幕的宽度,左右侧边栏滑动的时候主屏幕最少有100像素。 initFragment(); } /** * 初始化fragment, 将fragment数据填充给布局文件 */ private void initFragment() { FragmentManager fm = getSupportFragmentManager(); FragmentTransaction transaction = fm.beginTransaction();// 开启事务 //fl_left_menu和fl_content位于不同的xml transaction.replace(R.id.fl_left_menu, new LeftMenuFragment(), FRAGMENT_LEFT_MENU);// 用fragment替换framelayout,FRAGMENT_LEFT_MENU是名字。 transaction.replace(R.id.fl_content, new ContentFragment(), FRAGMENT_CONTENT); transaction.commit();// 提交事务 // Fragment leftMenuFragment = fm.findFragmentByTag(FRAGMENT_LEFT_MENU);根据名字找fragment, } } activity_main.xml <?xml version="1.0" encoding="utf-8"?> 空布局,就是一个容器。 <FrameLayout xmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/fl_content" android:layout_width="match_parent" android:layout_height="match_parent" > </FrameLayout> left_menu.xml <?xml version="1.0" encoding="utf-8"?> 空布局,就是一个容器。 <FrameLayout xmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/fl_left_menu" android:layout_width="match_parent" android:layout_height="match_parent" > </FrameLayout> LeftMenuFragment package com.itheima.zhbj52.fragment; import com.itheima.zhbj52.R; import android.view.View; /** * 侧边栏 * * @author Kevin * */ public class LeftMenuFragment extends BaseFragment { @Override public View initViews() { View view = View.inflate(mActivity, R.layout.fragment_left_menu, null); return view; } } fragment_left_menu.xml <RelativeLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" android:background="#f00" > <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="我是侧边栏!" /> </RelativeLayout> ContentFragment package com.itheima.zhbj52.fragment; import com.itheima.zhbj52.R; import android.view.View; /** * 主页内容 * * @author Kevin * */ public class ContentFragment extends BaseFragment { @Override public View initViews() { View view = View.inflate(mActivity, R.layout.fragment_content, null); return view; } } fragment_content.xml <RelativeLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" > <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="我是主页面哦!" /> </RelativeLayout> BaseFragment package com.itheima.zhbj52.fragment; import android.app.Activity; import android.os.Bundle; import android.support.v4.app.Fragment; import android.view.LayoutInflater; import android.view.View; import android.view.ViewGroup; /** * fragment基类 */ public abstract class BaseFragment extends Fragment { public Activity mActivity; // fragment创建 @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); mActivity = getActivity();//拿到fragment所依赖Activity的对象,fragment创建创建的时候Activity对象肯定是已经存在了,所以这个对象不会是空的。 } // 处理fragment的布局 @Override public View onCreateView(LayoutInflater inflater, ViewGroup container, Bundle savedInstanceState) { return initViews();//子类实现,因为每个布局不一样。 } // 依附的activity创建完成 @Override public void onActivityCreated(Bundle savedInstanceState) { super.onActivityCreated(savedInstanceState); initData(); } // 子类必须实现初始化布局的方法 public abstract View initViews(); // 初始化数据, 可以不实现 public void initData() { } } 本文转自农夫山泉别墅博客园博客,原文链接:http://www.cnblogs.com/yaowen/p/5040283.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

使用Docker搭建WordPress博客(三)nginx镜像制作

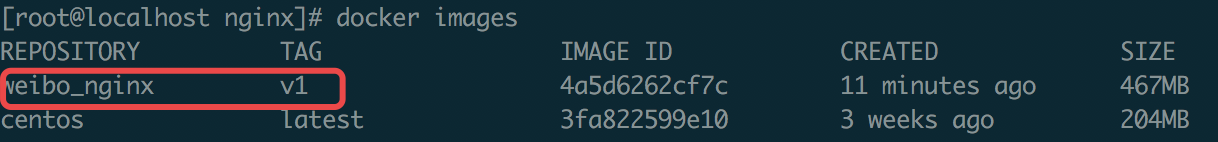
1.查看创建nginx镜像所有文件 [root@localhost nginx]# ls default.conf Dockerfile fastcgi_params run.sh 2.创建Dockerfile文件 [root@localhost nginx]# cat Dockerfile #VERSION 0.0.1 FROM centos MAINTAINER wtf "wtf@data.com" RUN rpm -ivh http://mirrors.sohu.com/fedora-epel/epel-release-latest-7.noarch.rpm RUN yum -y install nginx php php-fpm php-cli php-common php-gd php-mbstring php-mcrypt php-mysql php-pdo php-devel php-imagick php-xmlrpc php-xml php-bcmath php-dba php-enchant ADD default.conf /etc/nginx/conf.d/default.conf ADD fastcgi_params /etc/nginx/fastcgi_params ADD run.sh /tmp/ RUN chmod +x /tmp/run.sh ENTRYPOINT ["./tmp/run.sh"] EXPOSE 80 3.创建Nginx的default.conf server { listen 80 default_server; servername; location / { root /usr/share/nginx/html; index index.html index.htm; } error_page 404 /404.html; location = /404.html { root /usr/share/nginx/html; } # error_page 500 502 503 504 /50x.html; location = /50x.html { root /usr/share/nginx/html; } location ~ \.php$ { root html; fastcgi_pass 127.0.0.1:9000; fastcgi_index index.php; fastcgi_param SCRIPT_FILENAME /scripts$fastcgi_script_name; include fastcgi_params; } } 4.创建fastcgi_params [root@localhost nginx]# cat fastcgi_params fastcgi_param GATEWAY_INTERFACE CGI/1.1; fastcgi_param SERVER_SOFTWARE nginx; fastcgi_param QUERY_STRING $query_string; fastcgi_param REQUEST_METHOD $request_method; fastcgi_param CONTENT_TYPE $content_type; fastcgi_param CONTENT_LENGTH $content_length; fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name; fastcgi_param SCRIPT_NAME $fastcgi_script_name; fastcgi_param REQUEST_URI $request_uri; fastcgi_param DOCUMENT_URI $document_uri; fastcgi_param DOCUMENT_ROOT $document_root; fastcgi_param SERVER_PROTOCOL $server_protocol; fastcgi_param REMOTE_ADDR $remote_addr; fastcgi_param REMOTE_PORT $remote_port; fastcgi_param SERVER_ADDR $server_addr; fastcgi_param SERVER_PORT $server_port; fastcgi_param SERVER_NAME $server_name; 5.创建run.sh [root@localhost nginx]# cat run.sh #!/bin/sh /usr/sbin/php-fpm -D /usr/sbin/nginx -g "daemon off;" 6.创建nginx镜像 docker build -f Dockerfile -t weibo_nginx:v1 . 说明:-f 指定文件 , -t 指定生成镜像名称 ,冒号后为版本号。 7.查看生成的镜像 本文转自品鉴初心51CTO博客,原文链接:http://blog.51cto.com/wutengfei/2054434,如需转载请自行联系原作者

优秀的个人博客,低调大师

使用Docker搭建WordPress博客(一)yum安装docker

WordPress说明 WordPress是一个非常著名的PHP编写的博客平台,发展到目前为止已经形成了一个庞大的网站平台系统。在WP上有规模庞大的插件和主题,可以帮助我们快速建立一个博客甚至网站。 Windows与Linux上部署WordPress 在Windows上可以非常方便的安装WordPress,因为IIS上集成了WordPress的一键安装包。而在Linux上安装WordPress就比较复杂了,我们需要配置PHP环境、Apache或者Nginx服务器、MySQL数据库以及各种权限和访问问题。所以在Linux上最好的办法就是使用Docker来安装WordPress。 安装docker (1)先确定内核版本是否是3.8以上 [root@centos7 ~]# cat /etc/redhat-release CentOS Linux release 7.4.1708 (Core) (2)安装docker包 [root@centos7 ~]# yum install -y docker (3)docker安装报错(如有) 错误原因及解决方法: yum安装docker,有时候会报一个错误,这时按ctrl+c将其强制停止。报错原因是因为PID15269被占用,删除/var/run.yum.pid,然后重新执行yum安装docker即可! 启动docker服务 查看docker版本 (docker version和docker info都是查看版本的命令,不同之处在于,docker version 显示 Docker 版本信息,而docker info 显示 Docker 系统信息,包括镜像和容器数) 验证docker安装是否正确 [root@centos7 ~]# docker pull busybox 本文转自品鉴初心51CTO博客,原文链接:http://blog.51cto.com/wutengfei/2049861,如需转载请自行联系原作者

优秀的个人博客,低调大师

redhat 6.4 虚拟化平台搭建千万PV架构

前段通过HAproxy做反向代理,实现内部网站数据的访问 内部使用varnish做缓存服务器实现动静分离,将动态数据负载到2台tomcat,静态数据代理到nginx服务器处理 对于2台tomcat服务器实现基于session的共享集群 tomcat服务器的数据存储到mysql集群中 nginx用于处理静态文件,反代用户图片的请求道MFS 架构集群运行在redhat 6.4 企业版 KVM虚拟化平台上 本文转自潘阔 51CTO博客,原文链接:http://blog.51cto.com/pankuo/1630271,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop,HBase集群环境搭建的问题集锦(四)

21.Schema.xml和solrconfig.xml配置文件里參数说明: 參考资料:http://www.hipony.com/post-610.html 22.执行时报错: 23., /commons-cloud/src/main/resources/testClientUtil.properties 中配置的什么? 在ws-cloud中也有个 答: 好像是mysql的server, 如今预计没用了 24.在ws-cloud项目中 192.168.101.153 这又是干嘛的机器? 答: 这台机器是给定了mavens获取所须要的jar包的仓库信息 25.搭好hbase solr后台环境, 配置好相关文件, 开发机器上tomcatserver执行web-cloud和ws-cloud项目, 用maoqiang/hanwang账号登陆后, 到摘抄页面, 点击”添加”button, 想添加一个摘抄文件. Eclipse下报出例如以下信息: ====================ENTER==================input:{“uid”:”95841248414524”,”sid”:”11111111111”,”ver”:”1.0.0”,”userid”:”maoqiang”,”devid”:”hwa30_12345678”,”ftype”:”0”,”sort”:{“accessTime”:”desc”},”start”:”“,”count”:”10”,”fuid”:”“,”title”:”\u6211\u662f\u8c01”,”summary”:”\u6211\u662f\u8c01”,”content”:”\u6211\u662f\u8c01”,”serVer”:”“,”qstr”:{“start”:”“,”end”:”“,”month”:”“,”title”:”“,”cnt”:”“}} 2015-05-20 16:03:19,353 WARN [http-8080-1] (HConnectionManager.java:1098) - Encountered problems when prefetch hbase:meta table: org.apache.hadoop.hbase.TableNotFoundException: Cannot find row in hbase:meta for table: fileInfo, row=fileInfo,,99999999999999 at org.apache.hadoop.hbase.client.MetaScanner.metaScan(MetaScanner.java:146) at org.apache.hadoop.hbase.client.HConnectionManagerHConnectionImplementation.prefetchRegionCache(HConnectionManager.java:1095)atorg.apache.hadoop.hbase.client.HConnectionManagerHConnectionImplementation.locateRegionInMeta(HConnectionManager.java:1155) … at java.lang.Thread.run(Thread.java:744) 2015-05-20 16:03:19,360 INFO [http-8080-1] (AuthorizeFilter.java:215) - KEY:null—URL:http://localhost:8080/ws-epen/rt/ap/v1/user/listaxis—TIME:21 我想到了hbase内也许应该建好对应的rowkey和列族等信息. 是的, 确实是这么回事, 创建好了hbase的表就好了. 26.关于Mybatis的一条信息, 怎么破? 解决的方法:( 暂未解决,下面是參考解决的方法, ) 在集成Spring + mybaits时出现下面警告org.mybatis.spring.mapper.MapperScannerConfigurer$Scanner.main No MyBatis mapper was found in ‘com.***.dao.impl’ package. Please check your configuration. 出现以上情况是由于你的配置文件写多了这一段, [java] view plaincopyprint?<bean class="org.mybatis.spring.mapper.MapperScannerConfigurer"> <property name="basePackage" value="com.lanyuan.dao.impl" /> </bean> 亲爱吊丝们。把它删除吧。 原因:是org.mybatis.spring.mapper.MapperScannerConfigurer是扫描仓储类的接口,我不是用接口方式实现管理的.所把那段删除便可。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5258384.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MAC下Android的Eclipse开发环境的搭建

一.Eclipse的下载 到网站:http://www.eclipse.org/downloads/上,由于我们是用Java开发的所以步骤如下: 1.找到“Eclipse IDE for java Developers”此处右上角会根据你当前使用的系统自动选择,Mac下就会自动选择位“Mac OS X(Cocoa)” 2.然后点击右边的“Mac OS X 64bit”(这里我的Pro是i5处理器可以用64位的),根据你的机器也可以选择“Mac OS X 32bit”进行下载。 二.安装ADT ADT是Android应用程序的开发环境 在线安装,本来还有个离线安装的,但是我试图去下载这个离线安装包但是没有找到下载的地方,所以这里我主要介绍如何进行在线安装。 1.点击菜单中的Help——> Install New Software⋯; 2.在弹出的对话框中有个“Work with”,在右边的输入栏中输入:https://dl-ssl.google.com/android/eclipse/然后下面就会pending出来一个“Developer Tools”,勾选上,然后一路的Next下去就可以安装完成。 三.设定ADT 在菜单栏Refactor中如果能看到Android的标签表示ADT安装成功。 1下载Android SDK 打开网站:http://developer.android.com/sdk/index.html选择Mac OS X(intel)的SDK版本进行下载(因为我的pro是intel的i5处理器) 2安装Android SDK 刚下载的Mac版的SDK文件是:“android-sdk-mac_x86.rar”文件,将其解压出来,然后运行tools/Android,在弹出的Android SDK and AVD Manager对话框中选择左边的Installed packages,右边就会列出当前已经安装了的SDK,点击下面的“Update All”然后一步一步来就会下载所有的Android SDK的版本并进行安装。 然后在菜单栏Eclipse—> Preferences(偏好设置),会弹出一个Preferences对话框,选Android,然后在SDK Loaction中填入刚下载的SDK的路径或者点击右边的Browser选择。 3生成模拟器 菜单栏Window—> Android SDK and AVD Manger会弹出对话框,然后在对话框中选择new开始按自己的需求新建模拟器,至此就大功告成了!

优秀的个人博客,低调大师

云服务器 ECS 搭建WordPress网站:备案

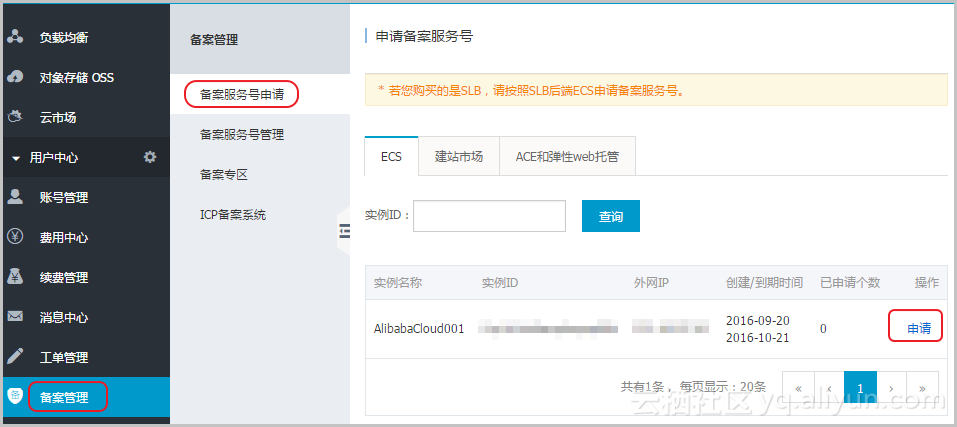
备案 对于域名指向中国境内服务器的网站,必须进行网站备案。在域名获得备案号之前,网站是无法开通使用的。 阿里云有代备案系统,方便您进行备案。备案免费,一般审核时间为20天左右。请您耐心等待。 注意:目前只有 包年包月 的 ECS 可以备案。 操作步骤 1.首先给购买的ECS实例申请备案服务号。这个服务号在备案时会用到。打开 备案管理>备案服务号申请,然后单击申请。 2.在弹出的提示信息对话框中,单击确定。 3.申请成功后,页面自动跳转到备案服务号管理页面,显示与 ECS 实例绑定的备案号。然后单击备案专区,了解备案相关信息。 4.首次备案的用户,请使用阿里云账号登录备案入口 http://beian.aliyun.com 开始备案。 关于首次备案的详细步骤,请参考 首次备案图文引导。 下一步 配置域名解析原文链接

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册