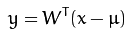首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

iOS 9 学习系列:UIStack View

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 在 iOS9 中,Apple 引入了 UIStackView,他让你的应用可以通过简单的方式,纵向或横向的叠放你的 views。UIStackView 采用 auto layout 的方式来管理他的子视图的位置和尺寸。让你更简单的构建自适应的 UI。 如果在 iOS9 之前,你想要创建类似 UIStackView 为你提供的这种布局,你需要构建大量的 constraints。你需要编辑许多诸如边距、高度、x/y 轴的位置,还有它们的依赖关系等。 UIStackView 把这些全部帮你做了。甚至在你添加或者移除某些 view 时,还提供了平滑的动画。当 view 状态改变时,他会自动的改变 layout 的属性值。 使用 UIStackView 现在我们通过创建一个例子来说明怎么使用 UIStackView,最终的代码放在了 Github,你可以下载来研究.我们要创建一个简单的示范,演示 UIStackView 是怎么工作的?这个页面底部有2个segmented controls,用来控制 UIStackView 的对齐和分布的属性。 上面的图片就是我们要创建的示例。如你所见,我们显示了4个朋友的图片,还有2个 segmented controls 在下面。这些 UI 使用了auto layout 布局,可以适配多种尺寸。 一会儿的制作过程,会让你感到惊喜,我们仅仅手动的添加了4个 layout positioning constraints。所有在这个UIStackView中的view都由它自动控制位置。我们一共有4个 UIStackView, 只有***个我们需要设置一下他的 constraints。这是我们页面中 stackview 所在的位置。 当你从 Interface Builder 中拖拽了一个 vertical stack view 到页面上后,你可以打开它的 constraint 面板,像上图一样编辑它的属性。这会把这个主 stack view 放在页面的中央,正确的位置上。 从 Interface Builder 中拖拽3个 horizontal stack view 到刚才创建好的 UIStackView 中。在最上面的 stack view,包含四个 UIImageView ,每个 imageView 中展示一个我们的朋友的照片。你拖拽四个 UIImageView 到 stack view 中就可以了。每个图片的大小尺寸都是不一样的。为了避免变形,我们给 imageView 的 contentMode 设置为 Aspect Fit。这意味着,不去管图片的尺寸,图片总会以正确的比例展示在 imageView 中。 你可能注意到了,在最终的 demo 中,每个 imageView 之间有个间隔,这是因为设置了 stackView的 spacing 属性为5的原因。在 interface builder 的 attributes inspector 面板可以设置 spacing 的值,同时还可以设置 alignment 和 distribution 的属性。这里我们缺省的设置为 Fill。因为一会儿我们会通过选择 segment 来改变它的值。 另外两个 stackView,同样是 horizontal stack view。非常简单,每个 stack view 中包含一个 label 和一个 segmented control。设置 segmented control为下面的内容。 Distribution Fill FillEqually FillProportionally EqualSpacing EqualCentering Alignment Fill Top Center Bottom 我们一会儿就能看到,这些属性是如何影响布局的。很多时候,他们的排列方式依赖 contentSize的值。好在,我们这个例子非常简单,image 的大小就是照片的实际大小。 现在我们的 UI 都创建好了。我们需要给 segment 设置选中后的动作。首先把最上面的 stack view 拖拽 outlet 到 viewController 中,命名为 peopleStackView。然后分别拖拽一个 action 给segmented control。在 action 中对 peopleStackView 的 alignment 和 distribution 属性进行调节,对齐和排列方式由用户决定。 你可以看到,我给每个动作加了一个动画的效果,但这不是必须的。如果你移除动画效果,对齐和排列的方式依然会改变。好现在运行一下程序吧。 你可以看到视频中的结果,点击打开视频 尝试着使用不同的排列组合,看一下会是什么结果。它会让你知道UIStackView时多么强大,在不同尺寸的设备上开发用户界面有多方便。 为现有的view,添加UIStackView 如果你想为你现在已经做好的 view 添加 UIStackView,也很简单。先移除掉你的 view 上的constraint,然后选中他们,点击一下 interface builder 的底部右手边,***个按钮。(就是原来你给 view 添加 constraint 的那些按钮,左边多了一个)。这会立刻把你选中的view,全部放入一个 UIStackView 中。 这会把你原来的布局方式转为stack view的布局方式,由stack view来控制布局。 延伸阅读 想要了解更多关于Xcode7中 UIStackView的内容,推荐阅读 WWDC 2015 的 session 218 Mysteries of Auto Layout, Part 1.在视频前15分钟里,Jason Yao 介绍了 UIStackView,并且现场制作了一个Demo演示如何操作的。

优秀的个人博客,低调大师

OpenCV学习(40) 人脸识别(4)

在人脸识别模式类中,还实现了一种基于LBP直方图的人脸识别方法。LBP图的原理参照:http://www.cnblogs.com/mikewolf2002/p/3438698.html 在代码中,我们只要使用 Ptr<FaceRecognizer> model = createLBPHFaceRecognizer(); 就创建了一个基于LBPH的人脸识别类,其它代码和前面两种人脸识别方法一样。 在train函数中,会计算每个样本的LBP图像,并求出该图像的二维直方图,把直方图保存在_histograms中,以便在predict函数调用这些直方图进行匹配。 for(size_t sampleIdx = 0; sampleIdx < src.size(); sampleIdx++) { // 计算LBP图 Mat lbp_image = elbp(src[sampleIdx], _radius, _neighbors); // 得到直方图 Mat p = spatial_histogram( lbp_image, /* lbp_image */ static_cast<int>(std::pow(2.0, static_cast<double>(_neighbors))), //可能的模式数 _grid_x, /* grid size x */ _grid_y, /* grid size y */ true); // 把直方图加到匹配模版中 _histograms.push_back(p); } 在预测函数中,会先求出输入图像的LBPH图,然后和保存的样本LBPH进行比较,距离最今即为匹配的人脸。 Mat lbp_image = elbp(src, _radius, _neighbors); Mat query = spatial_histogram( lbp_image, /* lbp_image */ static_cast<int>(std::pow(2.0, static_cast<double>(_neighbors))), /* number of possible patterns */ _grid_x, /* grid size x */ _grid_y, /* grid size y */ true /* normed histograms */); // 查找最近的匹配者 minDist = DBL_MAX; minClass = -1; for(size_t sampleIdx = 0; sampleIdx < _histograms.size(); sampleIdx++) { double dist = compareHist(_histograms[sampleIdx], query, CV_COMP_CHISQR); if((dist < minDist) && (dist < _threshold)) { minDist = dist; minClass = _labels.at<int>((int) sampleIdx); } } 代码: #include "opencv2/core/core.hpp"#include "opencv2/contrib/contrib.hpp"#include "opencv2/highgui/highgui.hpp"#include <iostream>#include <fstream>#include <sstream>using namespace cv;using namespace std;static void read_csv(const string& filename, vector<Mat>& images, vector<int>& labels, char separator = ';') { std::ifstream file(filename.c_str(), ifstream::in);if (!file) { string error_message = "No valid input file was given, please check the given filename."; CV_Error(CV_StsBadArg, error_message); } string line, path, classlabel;while (getline(file, line)) { stringstream liness(line); getline(liness, path, separator); getline(liness, classlabel);if(!path.empty() && !classlabel.empty()) { images.push_back(imread(path, 0)); labels.push_back(atoi(classlabel.c_str())); } } }int main(int argc, const char *argv[]) {// Get the path to your CSV. string fn_csv = string("facerec_at_t.txt");// These vectors hold the images and corresponding labels. vector<Mat> images; vector<int> labels;// Read in the data. This can fail if no valid// input filename is given.try { read_csv(fn_csv, images, labels); } catch (cv::Exception& e) { cerr << "Error opening file \"" << fn_csv << "\". Reason: " << e.msg << endl;// nothing more we can do exit(1); }// Quit if there are not enough images for this demo.if(images.size() <= 1) { string error_message = "This demo needs at least 2 images to work. Please add more images to your data set!"; CV_Error(CV_StsError, error_message); }// Get the height from the first image. We'll need this// later in code to reshape the images to their original// size:int height = images[0].rows;// The following lines simply get the last images from// your dataset and remove it from the vector. This is// done, so that the training data (which we learn the// cv::FaceRecognizer on) and the test data we test// the model with, do not overlap. Mat testSample = images[images.size() - 1];int testLabel = labels[labels.size() - 1]; images.pop_back(); labels.pop_back();// The following lines create an LBPH model for// face recognition and train it with the images and// labels read from the given CSV file.//// The LBPHFaceRecognizer uses Extended Local Binary Patterns// (it's probably configurable with other operators at a later// point), and has the following default values//// radius = 1// neighbors = 8// grid_x = 8// grid_y = 8//// So if you want a LBPH FaceRecognizer using a radius of// 2 and 16 neighbors, call the factory method with://// cv::createLBPHFaceRecognizer(2, 16);//// And if you want a threshold (e.g. 123.0) call it with its default values://// cv::createLBPHFaceRecognizer(1,8,8,8,123.0)// Ptr<FaceRecognizer> model = createLBPHFaceRecognizer(); model->train(images, labels);// The following line predicts the label of a given// test image:int predictedLabel = model->predict(testSample);//// To get the confidence of a prediction call the model with://// int predictedLabel = -1;// double confidence = 0.0;// model->predict(testSample, predictedLabel, confidence);// string result_message = format("Predicted class = %d / Actual class = %d.", predictedLabel, testLabel); cout << result_message << endl;// Sometimes you'll need to get/set internal model data,// which isn't exposed by the public cv::FaceRecognizer.// Since each cv::FaceRecognizer is derived from a// cv::Algorithm, you can query the data.//// First we'll use it to set the threshold of the FaceRecognizer// to 0.0 without retraining the model. This can be useful if// you are evaluating the model:// model->set("threshold", 0.0);// Now the threshold of this model is set to 0.0. A prediction// now returns -1, as it's impossible to have a distance below// it predictedLabel = model->predict(testSample); cout << "Predicted class = " << predictedLabel << endl;// Show some informations about the model, as there's no cool// Model data to display as in Eigenfaces/Fisherfaces.// Due to efficiency reasons the LBP images are not stored// within the model: cout << "Model Information:" << endl; string model_info = format("\tLBPH(radius=%i, neighbors=%i, grid_x=%i, grid_y=%i, threshold=%.2f)", model->getInt("radius"), model->getInt("neighbors"), model->getInt("grid_x"), model->getInt("grid_y"), model->getDouble("threshold")); cout << model_info << endl;// We could get the histograms for example: vector<Mat> histograms = model->getMatVector("histograms");// But should I really visualize it? Probably the length is interesting: cout << "Size of the histograms: " << histograms[0].total() << endl;return 0; } 程序代码:工程FirstOpenCV35

优秀的个人博客,低调大师

OpenCV学习(36) 人脸识别(1)

本文主要参考OpenCV人脸识别教程:http://docs.opencv.org/modules/contrib/doc/facerec/facerec_tutorial.html 1、OpenCV 从2.4开始支持3个新的人脸识别算法。 Eigenfaces 极值特征脸 createEigenFaceRecognizer() Fisherfaces createFisherFaceRecognizer() Local Binary Patterns Histograms局部二值直方图 createLBPHFaceRecognizer() 2、为了使用这三种算法,我们首先需要准备人脸训练样本,本文采用AT&T Facedatabase(点击下载)提供的人脸训练样本,该样本包括40个人,每人10张照片。照片在不同时间、不同光照、不同表情(睁眼闭眼、笑或者不笑)、不同人脸细节(戴眼镜或者不戴眼镜)下采集。所有的图像都在一个黑暗均匀的背景下,正面竖直人脸(有些有轻微旋转)。图像格式为pgm,图像大小为92*112,我们可以用gimp打开该格式的图像。 解压AT&T人脸数据库后,我们把目录att_faces拷贝到solution文件目录。在att_faces目录中,有s1,s2,...s40,共40个子目录,每个子目录中有1.pgm...10.pgm,10个文件,每个子目录对应一个人,子目录中的每副照片,对应一个人的各种人脸表情。比如s1中存放的10张人脸样本如下所示: 下面我们我们创建一个txt文件facerec_at.txt,格式如下,每一行包括两个字段,中间用“;”分开,第一个字段表示样本图片的路径文件名,第二个参数是一个整数索引,表示第几个人,例如第二个参数都为0,则表示第一个人,后面依次类推: ../att_faces/s13/2.pgm;12 ../att_faces/s13/7.pgm;12 ../att_faces/s13/6.pgm;12 ../att_faces/s13/9.pgm;12 ../att_faces/s13/5.pgm;12 ../att_faces/s13/3.pgm;12 ../att_faces/s13/4.pgm;12 ../att_faces/s13/10.pgm;12 ../att_faces/s13/8.pgm;12 ../att_faces/s13/1.pgm;12 ../att_faces/s17/2.pgm;16 ../att_faces/s17/7.pgm;16 ... ../att_faces/s38/10.pgm;37 ../att_faces/s38/8.pgm;37 ../att_faces/s38/1.pgm;37 3. Eigenfaces算法描述: 二维灰度图像p*q大小,是一个m=pq维的向量空间,一个100*100像素大小的图像就是10000维的图像空间。我们可以通过主成分分析算法(PCA)来对m维的图像向量进行降维操作。OpenCV中PCA算法细节,可以参考:http://www.cnblogs.com/mikewolf2002/p/3432243.html,通过PCA算法,我们可以得到k个特征脸,k就是我们选择降到的维数。 算法描述Algorithmic Description 令 表示一个随机特征,其中 . 计算均值向量 计算协方差矩阵 S 计算 的特征值 和对应的特征向量 对特征值进行递减排序,特征向量和它顺序一致. k个主成分也就是k个最大的特征值对应的特征向量。 x的K个主成份: 其中 . PCA基的重构: 其中 . 然后特征脸通过下面的方式进行人脸识别: 把所有的训练数据投影到PCA子空间 把待识别图像投影到PCA子空间 找到训练数据投影后的向量和待识别图像投影后的向量最近的那个。 4. 程序开始后,我们把样本图像和索引标签读到两个vector变量中。 // 得到txt文件的名字 string fn_csv = string("facerec_at_t.txt"); // 定义一个Mat格式的vector用来保存图像,int格式的vector表示图像索引标签 vector<Mat> images; vector<int> labels; //读入图像文件和索引标签 try { read_csv(fn_csv, images, labels); } catch (cv::Exception& e) { cerr << "Error opening file \"" << fn_csv << "\". Reason: " << e.msg << endl; exit(1); } 我们选择images中的最后一副图片,作为检测的图像,并把它从images中移除。 Mat testSample = images[images.size() - 1]; int testLabel = labels[labels.size() - 1]; images.pop_back(); labels.pop_back(); 通过下面的代码,我们输入待检测的图像,返回结果是对应人的索引标签,我们输入图像是第37个人,从结果看是对的。 //创建特征脸算法模型,并通过样本训练数据 Ptr<FaceRecognizer> model = createEigenFaceRecognizer(); model->train(images, labels); //通过predict输入待检测的图像,返回结果是索引标签 int predictedLabel = model->predict(testSample); string result_message = format("Predicted class = %d / Actual class = %d.", predictedLabel, testLabel); cout << result_message << endl; 5. 通过下面的代码,我们可以求得特征值和特征向量值,并把特征向量显示为特征脸。 // 特征值和特征向量 Mat eigenvalues = model->getMat("eigenvalues"); // And we can do the same to display the Eigenvectors (read Eigenfaces): Mat W = model->getMat("eigenvectors"); //特征值列数是1,行数是特征值的数量399 //特征向量10304*399,每一列都是一个特征向量 //每一个特征值对应一个特征向量 printf("特征值数量 :%d\n", eigenvalues.rows); printf("特征向量维数 :%d\n",W.rows); //显示10个特征向量 for (int i = 0; i < min(10, W.cols); i++) { string msg = format("Eigenvalue #%d = %.5f", i, eigenvalues.at<double>(i)); cout << msg << endl; // 得到第i个特征向量 Mat ev = W.col(i).clone(); // 把特征向量归一化到0-255,便于显示 Mat grayscale = toGrayscale(ev.reshape(1, height)); // 用Jet colormap显示灰度图. imshow(format("gray image%d", i), grayscale); Mat cgrayscale; applyColorMap(grayscale, cgrayscale, COLORMAP_JET); imshow(format("%d", i), cgrayscale); } 我们总共显示了10个特征向量(特征脸),第一个特征脸的灰度图和color map图如下: 程序代码:工程FirstOpenCV31

优秀的个人博客,低调大师

机器学习 | 基于机器学习的银行电话营销客户购买可能性预测分析

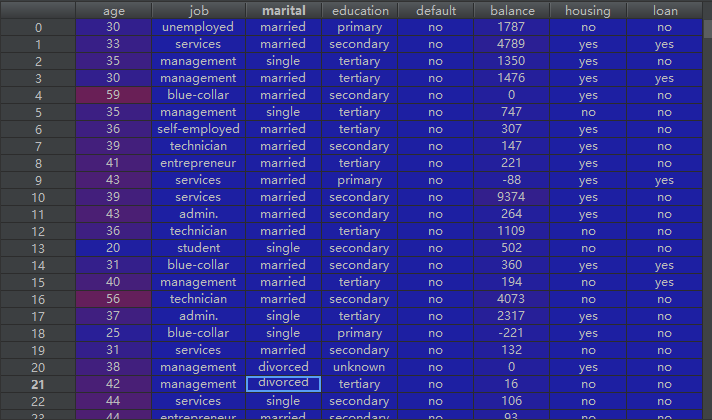
数据集:uci下载的某家银行电话营销与是否购买定期存储的数据。 模拟目标:知道客户数据,预测购买理财产品概率 我认为将电话营销的数据消除只保留基本属性可以模拟实际银行能够获取的数据。 电话营销数据代表一些对用户决定由影响但是获取难度较大的数据。比如说,买房、买车、小孩上学,这些数据银行不能立刻获得,或者获取成本较高。这里不使用这些数据参与预测。虽然预测准确度会降低,但是更符合实际情况。 然后定期存储是一种产品,可以当做一种理财,如果能对一种进行预测行进实现和验证,那么可以扩展到多种产品的预测 数据情况,见下表 Age 年龄 Job 工作 Marital 婚姻情况 Education 教育情况 Default 违约情况 - no 无违约 yes 有违约 Balance 账户余额 House 是否买房子 - no 无房产 yes 有房子 Loan 贷款 - no 无贷款 yes 有贷款 数据处理 数据清洗常规套路(空值检查,去重,去异常值) 由于数据集较好,基本不需要处理,但实现数据很有可能需要清洗,比如说,年龄缺失不能简单补0。 balance处理的尝试 1.balance的分布在较大值较少,需要处理 2.balance不处理 对数据one-hot encoding,对yes,no等2分类用0,1替换 处理之后数据为 使用lightgbm建模,参数如下 对测试集预测的结果左边为客户序号,predict为预测购买的可能性(推荐度),real为真是购买情况(0为未购买,1为已购买) 评价模型的好坏,对于少部分人购买(大部分预测都低于百分之50),很难用accurate去评价 举个例子, 真实情况是A类人购买率0.1,B类人购买率0.2,C类人购买率0.2。 即真实100个A, 100个 B, 100个 C 分别购买为10,20,20 2个模型经过训练对A,B,C,3类人的购买可能性预测为0.3 ,0.2, 0.1;0.15, 0.2, 0.2模型认为A,B,C三类人都不会购买。 accurate为预测正确人数/总人数 accurate(模型1)=accurate(模型2)=250(250没买东西,模型预测所有人都不会购买)/300=83% 如果用accurate去评价,模型1的性能是等于模型2的。 但是显然模型2更符合真实情况,所以这里不再使用accurate来作为标准。 这里使用的方法是,对预测值进行排序,如果预测准确,那么可能性高的人一定会多买产品。通过下图来衡量模型的好坏,红色为随机推荐,绿色为安概率排序后推荐。 如果绿线开始上升越快,说明模型效果越好。 这图除了来衡量模型好坏,也是一个有用的结论: 对一个人群范围,可以先通过模型排序,然后选取一定范围进行营销活动,提高转换率。 这里用1000的人来做标准,之后的模型也使用这个数据来做判断标准。排序前推荐1000人,购买率为104/1000=10.4%,排序后推荐1000人,购买率为270/1000=27%,差距最大点为1362。在推荐1362人是使用排序算法都购买人数和随意推荐差距最大。 特征值的重要程度如下图,可以看出账户余额和年龄是最重要的2个特征值 通过dnn和xgboost建模(具体见py代码) 3种建模的效果比较 1000人时,实际购买人数如下图 3种取现 结论分析在目前的参数设置来说 效果为xgboost>lightgbm>dnn 对比试验,之前的数据集是认为只有客户的基础属性,然后对客户的购买可能性做出预测。 现在增加电话营销的数据,来模拟一些营销数据(比如说发过几封推荐邮件)。 新增3个参数为 Duration:最后一次通话持续时间 Campaign:在这一次推广活动中,练习次数 Poutcome:之前的推广活动的结果,success为成功,failure为失败,unknown和other不是很清楚是什么属性 使用lightgbm建模结果如下 特征值的重要程度如下图,新增的特征值duration(持续通话时间)和campaign(联系次数)对预测有相当重要的影响。 对比没有这3个特征值时的预测(同样使用lightgbm) 这个对比说明了,在有效的特征值越多的情况下,预测越准确。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册