首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

6000 字 | 深入理解 Ribbon 的架构原理

大家好,我是悟空。 先说下哈,这篇文章画原理图用了很多时间。另外 Eureka 注册中心系列文章已经写到第六篇了,欢迎持续关注。 一、前言 上一篇我们讲解了客户端首次获取注册表时,需要从注册中心全量拉取注册表到本地存着。那后续如果有客户端注册、下线的话,注册表肯定就发生变化了,这个时候客户端就得更新本地注册表了,怎么更新呢?下面我会带着大家一起来看下客户端第二次获取注册表的方式。 题外话:之前写过一篇 Redis 主从同步的架构原理,里面也涉及到首次同步和第二次同步,其实原理也类似,但是 Redis 的主从同步原理要复杂些。强烈推荐配合着看一波: 镜 | 5 个维度深度剖析「主从架构」原理 二、增量获取引发的问题 上面我们说到,当第一次获取全量信息后,本地就有注册信息了。那如果 Server 的注册表有更新,比如有服务注册、下线,Client 必须要重新获取一次注册表信息才行。 那是否可以重新全量拉取一次呢? 可以是可以,但是,如果注册表信息很大呢?比如有几百个微服务都注册上去了,那一次拉取是非常耗时的,而且占用网络带宽,性能较差,这种方案是不靠谱的。 所以我们就需要用增量拉取注册信息表的方式,也就是说只拉取变化的数据,这样数据量就比较小了。如下图所示: 从源码里面我们可以看到,Eureka Client 通过调用 getAndUpdateDelta 方法获取增量的变化的注册表数据,Eureka Server 将变化的数据返回给 Client。 这里就有几个问题: (1)Client 隔多久进行一次增量获取? (2)Server 将变化的数据存放在哪里? (3)Client 如何将变化的数据合并到本地注册表里面? 下面分别针对上面的几个问题进行解答。 三、间隔多久同步一次? 3.1 默认间隔时间 默认每隔 30 s 执行一次同步,如下图所示: 这个 30 s 就是由变量 client.refresh.interval 定义的。 Eureka 每 30 s 会调用一个后台线程去拉取增量注册表,这个后台线程的名字叫做:cacheRefresh。如下所示: 3.2 Client 发送拉取注册表的请求 就是调用 getDelta 方法,发送 HTTP请求调用 jersey 的 restful 接口,然后 Server 端的 Jersey 框架就会去处理这个请求了。发送请求的方法 getDelta 如下所示: eurekaTransport.queryClient.getDelta(remoteRegionsRef.get()); restful 接口的地址就长这样: http://localhost:8080/v2/apps/delta 那么 Server 端如何过滤出增量的注册表信息呢?我们可以找到这个方法:getContainerDifferential。如下图所示: 这个方法主要干的活就是去获取最近改变的数据。接下来我们看下最近改变的数据存放在哪。 四、变化的数据存放在哪? 4.1 数据结构 其实就是放在这个队列里面:recentlyChangedQueue。它的数据结构是一个并发安全的链表队列 ConcurrentLinkedQueue。链表里面存放的元素就是最近变化的注册信息 RecentlyChangedItem。 ConcurrentLinkedQueue<RecentlyChangedItem> 当有客户端注册的时候,这个链表里面的尾部就会追加一个对象。 关于 ConcurrentLinkedQueue,还记得我之前写过的 18 种队列吗?不记得话看下这篇: 45张图庖丁解牛18种Queue,你知道几种? ConcurrentLinkedQueue 是由链表结构组成的线程安全的先进先出无界队列。如下图所示: 4.2 内部构造 我觉得这个队列的构造还是非常值得我们学习的,我们来看下这个队列的构造,如下图所示: 这个队列里面存放的对象是最近改变的对象 RecentlyChangedItem。 RecentlyChangedItem 存有三个元素:实例信息、操作类型和最后更新时间。 实例信息:使用 Lease<InstanceInfo> 保存一个客户端的注册表信息,这个在第四篇讲解注册表结构已经介绍过。 操作类型:当有客户端发起注册、更新注册表、下线时,会设置 actionType,对应三种枚举值:新增、更新、删除。 最后更新时间:客户端注册信息发生改变时,需要同时更新最后更新时间。 4.3 最近的数据 既然上面说到是最近改变的数据才会放进去,那这个最近是多近呢?1 分钟?2分钟? 通过源码我们找到了这个默认配置,三分钟刷新一次,也就是 180s 刷新一次。 那刷新了什么?刷新其实是会遍历这个队列:recentlyChangedQueue。 将队列里面的所有元素都遍历一遍,比对每个对象的最后更新时间是否超过了三分钟,如果超过了,就移除这个元素。如下图所示: 当元素的最后更新时间超过 3 分钟未更新,则移除该元素。如下图所示: 4.4 检查间隔 Server 端会将最近 3 分钟有更新的注册信息放入到队列中,超过 3 分钟未更新的数据将会被移除。那么多久会检查一次呢? 通过源码我们找到,每隔 30s 就会调用一次检查任务。如下图所示: 4.5 小结 Client 每隔 30 秒调用一次增量获取注册表的接口。 Server 每隔 30 秒调用检查一次队列。 如果队列中有元素在 3 分钟以内都没有更新过,则从队列中移除该元素。 五、客户端注册表合并 这里有个问题:客户端首次拿到的全量注册表,存放本地了。第二次拿到的是增量的注册表,怎么将两次的数据合并在一起呢?如下图所示: 下面我们来看看下客户端注册表合并的原理。 当客户端调用获取增量注册表的请求后,注册表会返回增量信息,然后客户端就会调用本地合并的方法:updateDelta。 合并注册表的原理图如下所示: 首先就会遍历增量注册表,检查其中的每一项,不论 actionType 是新增、删除还是更新,如果本地本来就有,则执行后续的类型判断逻辑。 如果实例信息的名字在本地不存在则会先往本地注册表新增一个注册信息。然后本地肯定存在注册信息了,执行后续的判断逻辑。 当类型字段 actionType 等于新增或更新时,先删除后增加。 当类型字段 actionType 等于删除时,直接进行删除。 经过这一些列的逻辑之后,增量注册表和本地注册表就合并好了。 六、比对注册表 经过重重判断 + 合并操作,客户端终于完成了本地注册表的刷新,理论上来说,这个时候客户端的注册表应该和注册中心的注册表一致了。 但是如何确定是一致的呢?这里我们来考虑几种方案: 再全量拉取一次注册表,和本地注册表进行比对。但是既然又要做一次全量拉取,那之前的增量拉取就没有必要了。 拉取增量注册表,Server 返回全量注册表的实例 id,客户端比对每个实例 id 是否存在,以及检查本地是否有多余的,如果能匹配上,则认为是一致的。但是这里也有一个问题,对于新增和更新的注册实例,得把更新的实例信息的字段一一比对才能确定是否一致,这就太麻烦了。另外还有一个致命的问题:如果客户端因为网络故障下线了,上一次最近 3 分钟的增量数据没有拉取到,那么相当于丢失了一次增量数据,这个时候,就不是完整的注册表信息了。 有没有既方便又准确的比对方式呢? 有的,那就是哈希比对。哈希比对的意思就是将两个对象经过哈希算法计算出两个 hash 值,如果两个 hash 值相等,则认为这两个对象相等。这种方式在代码中也非常常见,比如类的 hashcode() 方法。 从源码中,我们看到 Eureka Server 返回注册表时,会返回一个 hash 值,是将全量注册表 hash 之后的值。调用的是这个方法:getReconcileHashCode()。 如下图所示,获取增量注册表的接口,会返回增量注册表和 hashcode。 然后本地注册表合并后,再计算出一个 hashcode,和 Server 返回的 hashcode 进行比对,如果一致,说明本地注册表和 Server 端一致。如果不一致,则会进行一次全量拉取。 上面说的原理我们画一张原理图看下就清楚了: 七、总结 本篇文章可以用一张图来做总结,直接上图: 客户端每隔 30s 获取一次增量数据,注册中心返回最近 3 分钟变化的注册信息,包含了新注册的、更新的和下线的服务实例。然后将增量注册表 + 全量注册表的 hash 值返回。 客户端将本地注册表 + 增量注册表进行合并。合并完成后,计算一个 hash 值,和 Server 返回的 hash 值进行比对,如果相等,则说明客户端的注册表和注册中心的注册表一致,同步完成。如果不一致,则还需要全量拉取一次。 提个问题:为什么 hash 比对会不一致?答案在文中哦! 下篇,注册中心的缓存架构走起! 作者简介:悟空,8年一线互联网开发和架构经验,用故事讲解分布式、架构设计、Java 核心技术。《JVM性能优化实战》专栏作者,开源了《Spring Cloud 实战 PassJava》项目,公众号:悟空聊架构。本文已收录至www.passjava.cn

优秀的个人博客,低调大师

如何理解敏捷开发的从0到1

数字化时代之下,越来越多的企业在尝试构建自身的平台与应用,以支持企业内部的业务场景、连接产业链上下游。随着产品的使用深入与业务的变化创新,企业IT部门面临着如何更快速响应需求与变化的挑战,而此时,敏捷开发也常常被提起。 我们在和很多客户的交流中发现,很多客户已经认识到了敏捷开发的意义,期待用敏捷开发的理念与方法去帮助团队带来改善,但是大家普遍会有一个疑问,敏捷开发如何从0到1?哪里是开始?如何开始?又如何定义1呢? 0:迭 代 0 这里先会讲一下“迭代0”的概念,让大家进入敏捷迭代开发前缓冲一下。 在大多数敏捷项目中,在第一次迭代开始之前,会做一些“准备工作”,这称之为“迭代 0”,在这个迭代中可以制定未来的增量发布路线图、产品待办事项列表等,分析迭代环境和一些硬件配置,“确保”项目已准备就绪的事情。 如果是个新团队,面对全新的人组合在一起,合作时往往都是陌生的,不知道对方的水平和工作模式,这种情况,迭代0可以帮助大家彼此熟悉。迭代0的周期往往不会很长,可以控制在1周左右,产品负责人根据团队的大小,制定迭代的待办事项。 👉团队中包括三个角色,他们分别是产品负责人、开发团队和 Scrum Master。 在迭代0里,团队更多关注成员间如何合作,包括适合团队的故事大小、适合团队的故事点评估方式、适合团队的协作模式、适合团队的开发规范等等。 迭代开启:Scrum+看板 摸清了团队协作的“套路”,产品负责人就可以制定适合团队的开发节奏。比如:2周一个迭代,2个迭代加上1周的持续改进,这样5周一个版本的速率稳定向前更新,这也是猪齿鱼研发团队的迭代频率。当然,如果在迭代中遇到了突发事件、人员变动等,迭代的周期可以进行调整。 开发团队在敏捷迭代中通常采用Scrum+看板的方式开展工作。敏捷开发过程中涉及了很多会议,在一个迭代真正开启前,有一个重要的会议——迭代计划会,确定本迭代的待办列表。迭代计划会一般耗时2-3小时,由敏捷教练组织、团队成员参加。会议上产品经理描述故事(即任务项)的业务背景及设计逻辑,团队成员提出疑问,在相互的反馈沟通中对故事的产品设计达成共识,基于对故事的共同认知,团队成员评估故事的故事点大小(有的时候我们也用工时)、拆解为可工作的子任务,并认领到具体责任人。在迭代计划会上,团队根据评估的故事大小和团队产能,最终共同承诺本迭代的待办列表。 迭代开启后,每个人都按之前领取的任务的优先级进行开发工作,这个阶段在Scrum中称为Sprint,每天都会举行每日站会,时长大概在10-15分钟的站会,团队中每个人讲述昨天做了什么、今天要做什么、需要什么支持,借助看板工具进行任务的推进。 每个Sprint结束时,都会有一个Sprint评审会议。评审会议最重要的工作是演示功能和交付成果,验证用户故事的实现场景,并接受评价。在迭代评审会前,团队会检查本次迭代的工作情况,为了兑现迭代计划会上的承诺,团队通常会想方设法“冲刺”,以守住自己的承诺,而这也是Sprint的意义。 在Sprint评审会之后,敏捷/特性团队会进行Sprint回顾会,回顾会的重点是团队检视与调整,进行工作问题和改进点的反馈。敏捷/特性团队敏捷团队会检视上一回顾会的问题是否完全解决,同时提前根据本迭代的达成目标、产品功能、敏捷流程、需求管理等方面进行准备,针对开发团队在实施敏捷开发中的各种进步和问题进行讨论。 敏捷开发的小“1”:MVP MVP (Minimum Viable Product,最小可行产品) ,即它是一个产品且可以运行,表示产品有足够的功能供早期用户使用,用户可以为未来的产品开发持续提供反馈。但是,一个产品只有一个MVP可能用户并不买账。 客户内心OS:我并不想仅仅只用一个简易版本,到底什么时候才能达到我的预期? 这时候制定项目各个阶段的MVP的路线图很有必要,路线图需要体现“MVP”步骤的是什么?MVP如何进行调整?下一步可以看到什么?以这种方式设计组织中的流程,可以让用户提早的看到产品的前进及递增结果,以提高用户对产品有效性,研发效率的满意度。 MVP促使着开发者们将产品价值传递到用户手中,形成小“1”,然后通过用户的反馈和时间的推移还能不断增加这种价值,最终得到一个优质的“1”。 总结 敏捷开发的从0到1,不仅仅是通过多次迭代产品的从0到1,更是自组织跨职能团队从0到1的协作和进步。其核心在于团队拥有共同的价值观和理念,尊重变化、迭代开发,借助可落地的方法与工具,更快更强更稳定地持续交付价值。 本文由猪齿鱼技术团队原创,转载请注明出处:猪齿鱼官网 关于猪齿鱼 猪齿鱼Choerodon全场景效能平台,提供体系化方法论和协作、测试、DevOps及容器工具,帮助企业拉通需求、设计、开发、部署、测试和运营流程,一站式提高管理效率和质量。从团队协同到DevOps工具链、从平台工具到体系化方法论,猪齿鱼全面满足协同管理与工程效率需求,贯穿端到端全流程,助力团队效能更快更强更稳定。戳此处试用猪齿鱼

优秀的个人博客,低调大师

每日一博 | Redis GeoHash 核心原理解析

1. 引言 小麦同学是个吃货+技术宅,平日里就喜欢拿着手机地图点点按按来查询一些好玩的东西。某一天到北海公园游玩,肚肚饿了,于是乎打开手机地图,搜索北海公园附近的餐馆,并选了其中一家用餐。饱暖思yin欲的麦叔饭后思考地图后台如何根据自己所在位置查询来查询附近餐馆的呢?苦思冥想了半天,小麦想出了个方法:计算所在位置P与北京所有餐馆的距离,然后返回距离<=1000米的餐馆。小得意了一会儿,小麦发现北京的餐馆何其多啊,这样计算不得了,于是想了,既然知道经纬度了,那它应该知道自己在西城区,那应该计算所在位置P与西城区所有餐馆的距离啊,机机运用了递归的思想,想到了西城区也很多餐馆啊,应该计算所在位置P与所在街道所有餐馆的距离,这样计算量又小了,效率也提升了。 小麦的计算思想很朴素,就是通过过滤的方法来减小参与计算的餐馆数目,从某种角度上讲,机机在使用索引技术。 一提到索引,大家脑子里马上浮现出B树索引,因为大量的数据库(如MySQL、oracle、PostgreSQL等)都在使用B树。B树索引本质上是对索引字段进行排序,然后通过类似二分查找的方法进行快速查找,即它要求索引的字段是可排序的,一般而言,可排序的是一维字段,比如时间、年龄、薪水等等。但是对于空间上的一个点(二维,包括经度和纬度),如何排序呢?又如何索引呢?解决的方法很多,下文介绍一种方法来解决这一问题。 思想:如果能通过某种方法将二维的点数据转换成一维的数据,那样不就可以继续使用B树索引了嘛。那这种方法真的存在嘛,答案是肯定的。目前很火的GeoHash算法就是运用了上述思想,下面我们就开始GeoHash之旅吧。 2. 感性认识 先来两个干货,在线查看GPS某个区域的GeoHash值。 1. http://geohash.gofreerange.com/ 在这里插入图片描述 2. http://www.geohash.cn/ 跟更好用些 3. 通俗说 GeoHash将二维的经纬度转换成字符串,比如下图展示了北京9个区域的GeoHash字符串,分别是WX4ER,WX4G2、WX4G3等等,每一个字符串代表了某一矩形区域。也就是说,这个矩形区域内所有的点(经纬度坐标)都共享相同的GeoHash字符串,这样既可以保护隐私(只表示大概区域位置而不是具体的点),又比较容易做缓存,比如左上角这个区域内的用户不断发送位置信息请求餐馆数据,由于这些用户的GeoHash字符串都是WX4ER,所以可以把WX4ER当作key,把该区域的餐馆信息当作value来进行缓存,而如果不使用GeoHash的话,由于区域内的用户传来的经纬度是各不相同的,很难做缓存。字符串越长,表示的范围越精确。如图所示,5位的编码能表示10平方千米范围的矩形区域,而6位编码能表示更精细的区域(约0.34平方千米)字符串相似的表示距离相近(特殊情况后文阐述),这样可以利用字符串的前缀匹配来查询附近的POI信息。如下两个图所示,第一个在城区,第二个在郊区,城区的GeoHash字符串之间比较相似,郊区的字符串之间也比较相似,而城区和郊区的GeoHash字符串相似程度要低些。通过上面的介绍我们知道了GeoHash就是一种将经纬度转换成字符串的方法,并且使得在大部分情况下,字符串前缀匹配越多的距离越近,回到我们的案例,根据所在位置查询来查询附近餐馆时,只需要将所在位置经纬度转换成GeoHash字符串,并与各个餐馆的GeoHash字符串进行前缀匹配,匹配越多的距离越近。 4. GeoHash算法的步骤 下面以北海公园附近随便一个位置为例介绍GeoHash算法的计算步骤,先用百度 GPS反定位系统查找看下经纬度。纬度=116.395371,经度=39.931957。 根据经纬度计算GeoHash二进制编码 地球纬度区间是[-90,90], 北海公园的纬度是39.928167,可以通过下面算法对纬度39.928167进行逼近编码: 区间[-90,90]进行二分为[-90,0),[0,90],称为左右区间,可以确定39.928167属于右区间[0,90],给标记为1; 接着将区间[0,90]进行二分为 [0,45),[45,90],可以确定39.928167属于左区间 [0,45),给标记为0; 递归上述过程39.928167总是属于某个区间[a,b]。随着每次迭代区间[a,b]总在缩小,并越来越逼近39.928167; 如果给定的纬度x(39.928167)属于左区间,则记录0,如果属于右区间则记录1,这样随着算法的进行会产生一个序列1011100,序列的长度跟给定的区间划分次数有关。 39.928167 根据纬度算编码 bit min mid max 1 -90.000 0.000 90.000 0 0.000 45.000 90.000 1 0.000 22.500 45.000 1 22.500 33.750 45.000 1 33.750 39.375 45.000 0 39.375 42.188 45.000 0 39.375 40.7815 42.188 0 39.375 40.07825 40.7815 1 39.375 39.726625 40.07825 1 39.726625 39.9024375 40.07825 同理,地球经度区间是[-180,180],可以对经度116.389550进行编码。根据经度算编码 bit min mid max 1 -180 0.000 180 1 0.000 90 180 0 90 135 180 1 90 112.5 135 0 112.5 123.75 135 0 112.5 118.125 123.75 1 112.5 115.3125 118.125 0 115.3125 116.71875 118.125 1 115.3125 116.015625 116.71875 1 116.015625 116.3671875 116.71875 组码 通过上述计算,纬度产生的编码为10111 00011,经度产生的编码为11010 01011。偶数位放经度,奇数位放纬度,把2串编码组合生成新串:11100 11101 00100 01111。最后使用用0-9、b-z(去掉a, i, l, o)这32个字母进行base32编码,首先将11100 11101 00100 01111转成十进制,对应着28、29、4、15,十进制对应的编码就是wx4g。同理,将编码转换成经纬度的解码算法与之相反,具体不再赘述。 5. GeoHash Base32编码长度与精度 可以看出,当geohash base32编码长度为8时,精度在19米左右,而当编码长度为9时,精度在2米左右,编码长度需要根据数据情况进行选择。 一、经纬度距离换算 在纬度相等的情况下: 经度每隔0.00001度,距离相差约1米; 每隔0.0001度,距离相差约10米; 每隔0.001度,距离相差约100米; 每隔0.01度,距离相差约1000米; 每隔0.1度,距离相差约10000米。 在经度相等的情况下: 纬度每隔0.00001度,距离相差约1.1米; 每隔0.0001度,距离相差约11米; 每隔0.001度,距离相差约111米; 每隔0.01度,距离相差约1113米; 每隔0.1度,距离相差约11132米。 6. GeoHash算法 上文讲了GeoHash的计算步骤,仅仅说明是什么而没有说明为什么?为什么分别给经度和维度编码?为什么需要将经纬度两串编码交叉组合成一串编码?本节试图回答这一问题。 如下图所示,我们将二进制编码的结果填写到空间中,当将空间划分为四块时候,编码的顺序分别是左下角00,左上角01,右下脚10,右上角11,也就是类似于Z的曲线,当我们递归的将各个块分解成更小的子块时,编码的顺序是自相似的(分形),每一个子快也形成Z曲线,这种类型的曲线被称为Peano空间填充曲线。 这种类型的空间填充曲线的优点是将二维空间转换成一维曲线(事实上是分形维),对大部分而言,编码相似的距离也相近, 但Peano空间填充曲线最大的缺点就是突变性,有些编码相邻但距离却相差很远,比如0111与1000,编码是相邻的,但距离相差很大。 除Peano空间填充曲线外,还有很多空间填充曲线,如图所示,其中效果公认较好是Hilbert空间填充曲线,相较于Peano曲线而言,Hilbert曲线没有较大的突变。为什么GeoHash不选择Hilbert空间填充曲线呢?可能是Peano曲线思路以及计算上比较简单吧,事实上,Peano曲线就是一种四叉树线性编码方式。 7. 使用注意点 1. 临界问题 由于GeoHash是将区域划分为一个个规则矩形,并对每个矩形进行编码,这样在查询附近POI信息时会导致以下问题,比如红色的点是我们的位置,绿色的两个点分别是附近的两个餐馆,但是在查询的时候会发现距离较远餐馆的GeoHash编码与我们一样(因为在同一个GeoHash区域块上),而较近餐馆的GeoHash编码与我们不一致。这个问题往往产生在边界处。 解决的思路很简单,我们查询时,除了使用定位点的GeoHash编码进行匹配外,还使用周围8个区域的GeoHash编码,这样可以避免这个问题。 2. 注意点 我们已经知道现有的GeoHash算法使用的是Peano空间填充曲线,这种曲线会产生突变,造成了编码虽然相似但距离可能相差很大的问题,因此在查询附近餐馆时候,首先筛选GeoHash编码相似的POI(point of interest)点,然后进行实际距离计算。 3. 使用心得 GeoHash只是空间索引的一种方式,特别适合点数据,而对线、面数据采用R树索引更有优势(可为什么需要空间索引)。 GeoHash值可以区分精度,位数越多,精度越高,表达的地理位置越精细;如一位的GeoHash值把地球划分为32个矩形,8位的geohash值把地球划分为32^8个小矩形 适合根据某个经纬度坐标position计算出GeoHash值,然后和数据库中精度更高的GeoHash值做前缀比较 8.空间索引 常见问题:如何根据自己所在位置查询来查询附近50米的POI(point of interest,比如商家、景点等)呢(图1a)?每个POI都有经纬度信息,用图1b的SQL语句在mySQL中建立了POI_spatial的表,其中lat和lng两个字段来代表纬度和经度。为后续分析方便起见,我人造了40万个POI数据。 方法一:暴力方法 该方法的思路很直接:计算位置与所有POI的距离,并保留距离小于50米的POI。 插句题外话,计算经纬度之间的距离不能像求欧式距离那样平方开根号,因为地球是个不规整的球体(图2a),普通计算适合都是默认按最简单的完美球体假设,两点之间的距离函数应该如图2b所示。 该方法的复杂度为:40万*距离函数。我们将球体距离函数写为mysql存储过程distance,之后我们执行查询操作(图3),发现花费了4.66秒。 方法二:矩形过滤方法 该方法采用逐步细化的方式,一般分为两部: 先用矩形框过滤(图4a),判断一个点在矩形框内很简单,只要进行两次判断(LtMin<lat<LtMax; LnMin<lng<LnMax),落在矩形框内的POI个数为n(n<<40万); 用球面距离公式计算位置与矩形框内n个POI的距离(图4b),并保留距离小于50米的POI 矩形过滤方法的复杂度:40万矩形过滤函数 + n距离函数(n<<40万)。 根据这个思路我们执行SQl查询(图5)(注:经度或纬度每隔0.001度,距离相差约100米,由此推算出矩形左下角和右上角坐标),发现过滤后正好剩下两个POI。 此查询花费了0.36秒,相比于方法一查询时间大大降低,但是对于一次查询来说还是很长。时间长的原因在于遍历了40万次。 方法三:B树对经度或纬度建立索引 方法二耗时的原因在于执行了遍历操作,为了不进行遍历,我们自然想到了索引。我们对纬度进行了B树索引。 altertablepoi_spatialaddindexlatindex(lat);altertablepoi_spatialaddindexlngindex(lng); 此方法包括三个步骤: 通过B树快速找到某纬度范围的POI(图6a),个数为m(m<40万),复杂度为Log(40万)*过滤函数; 在步骤a过滤得到的m个POI中查找某经度范围的POI(图6b),个数为n(n<m),复杂度为m*过滤函数; 用球面距离公式计算位置与步骤b得到的n个POI的距离(图6c),并保留距离小于50米的POI 执行SQL查询(图7),发现时间已经大大降低,从方法2的0.36秒下降到0.01秒 三、B树能索引空间数据吗? 这时候有人会说了:方法三效果如此好,能够满足我们附近POI查询问题啊,看来B树用来索引空间数据也是可以的嘛!那么B树真的能够索引空间数据吗? 只能对经度或纬度索引(一维索引),与期望的不符 我们期待的是快速找出落在某一空间范围的POI(如矩形)(图8a),而不是快速找出落在某纬度或经度范围的POI(图8b),想象一下,我要查询北京某区的POI,但是B树索引不仅给我找出了北京的,还有与北京同一维度的天津、大同、甚至国外城市的POI,当数据量很大时,效率很低。 当数据是多维,比如三维(x,y,z),B树怎么索引?比如z可能是高程值,也可能是时间。有人会说B树其实可以对多个字段进行索引,但这时需要指定优先级,形成一个组合字段,而空间数据在各个维度方向上不存在优先级,我们不能说纬度比经度更重要,也不能说纬度比高程更重要。 当空间数据不是点,而是线(道路、地铁、河流等),面(行政区边界、建筑物等),B树怎么索引?对于面来说,它由一系列首尾相连的经纬度坐标点组成,一个面可能有成百上千个坐标,这时数据库怎么存储,B树怎么索引,这些都是问题。 既然传统的索引不能很好的索引空间数据,我们自然需要一种方法能对空间数据进行索引,即空间索引。 参考 Java实现GPS范围查找 浙大大佬通俗说GPS 本文分享自微信公众号 - sowhat1412(sowhat9094)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Android 启动优化(六)- 深入理解布局优化

前言 说到 Android 启动优化,你一般会想到什么呢? Android 多线程异步加载 Android 首页懒加载 对,这是两种很常见的优化手段,但是如果让你主导这件事情,你会如何开始呢? 梳理现有的业务,哪些是一定要在启动初始化的,哪些是不必要的 需要在启动初始化的,哪些是可以在主线程初始化的,哪些是可以在子线程初始化的 当我们把任务丢到子线程初始化,这时候,我们又会遇到两个问题。 在首页,我们需要用到这个库,如果直接使用,这个库可能还没有初始化,这时候直接调用该库,会发生异常,你要怎么解决 当我们的任务相互依赖时,比如 A 依赖于 B, C 也依赖于 B,要怎么解决这种依赖关系。 这些你有想过嘛。答案都在这几篇文章里面了,这里我就不展开讲了。有疑问的可以一起探讨探讨。 Android 启动优化(一) - 有向无环图 Android 启动优化(二) - 拓扑排序的原理以及解题思路 Android 启动优化(三)- AnchorTask 开源了 Android 启动优化(四)- AnchorTask 是怎么实现的 Android 启动优化(五)- AnchorTask 1.0.0 版本正式发布了 接下来,我们来说一下布局优化相关的。 布局优化的现状与发展趋势 耗时原因 众所周知,布局加载一直是耗时的重灾区。特别是启动阶段,作为第一个 View 加载,更是耗时。 而布局加载之所以耗时,有两个原因。 读取 xml 文件,这是一个 IO 操作。 解析 xml 对象,反射创建 View 一些很常见的做法是 减少布局嵌套层数,减少过度绘制 空界面,错误界面等界面进行懒加载那除了这些做法,我们还有哪些手段可以优化呢? 解决方案 异步加载 采用代码的方式编写布局 异步加载 google 很久之前提供了 AsyncLayoutInflater,异步加载的方案,不过这种方式有蛮多坑的,下文会介绍 采用代码的方式编写布局 代码编写的方式编写布局,我们可能想到使用 java 声明布局,对于稍微复杂一点的布局,这种方式是不可取的,存在维护性查,修改困难等问题。为了解决这个问题,github 上面诞生了一系列优秀的开源库。 litho: https://github.com/facebook/litho X2C: https://github.com/iReaderAndroid/X2C 为了即保留xml的优点,又解决它带来的性能问题,我们开发了X2C方案。即在编译生成APK期间,将需要翻译的layout翻译生成对应的java文件,这样对于开发人员来说写布局还是写原来的xml,但对于程序来说,运行时加载的是对应的java文件.我们采用APT(Annotation Processor Tool)+ JavaPoet技术来完成编译期间【注解】->【解注解】->【翻译xml】->【生成java】整个流程的操作。 这两个开源库在大型的项目基本不会使用,不过他们的价值是值得肯定的,核心思想很有意义。 xml 布局加载耗时的问题, google 也想改善这种现状,最近 Compose beta 发布了,他是采用声明式 UI 的方式来编写布局,避免了 xml 带来的耗时。同时,还支持布局实时预览。这个应该是以后的发展趋势。 compose-samples: https://github.com/android/compose-samples 小结 上面讲了布局优化的现状与发展趋势,接下来我们一起来看一下,有哪些布局优化手段,可以应用到项目中的。 渐进式加载 异步加载 compose 声明式 UI 渐进式加载 什么是渐进式加载 渐进式加载,简单来说,就是一部分一部分加载,当前帧加载完成之后,再去加载下一帧。 一种极致的做法是,加载 xml 文件,就想加载一个空白的 xml,布局全部使用 ViewStub 标签进行懒加载。 这样设计的好处是可以减缓同一时刻,加载 View 带来的压力,通常的做法是我们先加载核心部分的 View,再逐步去加载其他 View。 有人可能会这样问了,这样的设计很鸡肋,有什么用呢? 确实,在高端机上面作用不明显,甚至可能看不出来,但是在中低端机上面,带来的效果还是很明显的。在我们项目当中,复杂的页面首帧耗时约可以减少 30%。 优点:适配成本低,在中低端机上面效果明显。 缺点:还是需要在主线程读取 xml 文件 核心伪代码 1start(){2loadA(){3loadB(){4loadC()5}6}7} 上面的这种写法,是可以的,但是这种做法,有一个很明显的缺点,就是会造成回调嵌套层数过多。当然,我们也可以使用 RxJava 来解决这种问题。但是,如果项目中没用 Rxjava,引用进来,会造成包 size 增加。 一个简单的做法就是使用队列的思想,将所有的 ViewStubTask 添加到队列当中,当当前的 ViewStubTask 加载完成,才加载下一个,这样可以避免回调嵌套层数过多的问题。 改造之后的代码见 1valdecorView=this.window.decorView2ViewStubTaskManager.instance(decorView)3.addTask(ViewStubTaskContent(decorView))4.addTask(ViewStubTaskTitle(decorView))5.addTask(ViewStubTaskBottom(decorView))6.start() 1classViewStubTaskManagerprivateconstructor(valdecorView:View):Runnable{ 2 3privatevariViewStubTask:IViewStubTask?=null 4 5companionobject{ 6 7constvalTAG="ViewStubTaskManager" 8 9@JvmStatic10funinstance(decorView:View):ViewStubTaskManager{11returnViewStubTaskManager(decorView)12}13}1415privatevalqueue:MutableList<ViewStubTask>=CopyOnWriteArrayList()16privatevallist:MutableList<ViewStubTask>=CopyOnWriteArrayList()171819funsetCallBack(iViewStubTask:IViewStubTask?):ViewStubTaskManager{20this.iViewStubTask=iViewStubTask21returnthis22}2324funaddTask(viewStubTasks:List<ViewStubTask>):ViewStubTaskManager{25queue.addAll(viewStubTasks)26list.addAll(viewStubTasks)27returnthis28}2930funaddTask(viewStubTask:ViewStubTask):ViewStubTaskManager{31queue.add(viewStubTask)32list.add(viewStubTask)33returnthis34}353637funstart(){38if(isEmpty()){39return40}41iViewStubTask?.beforeTaskExecute()42//指定decorView绘制下一帧的时候会回调里面的runnable43ViewCompat.postOnAnimation(decorView,this)44}4546funstop(){47queue.clear()48list.clear()49decorView.removeCallbacks(null)50}5152privatefunisEmpty()=queue.isEmpty()||queue.size==05354overridefunrun(){55if(!isEmpty()){56//当队列不为空的时候,先加载当前viewStubTask57valviewStubTask=queue.removeAt(0)58viewStubTask.inflate()59iViewStubTask?.onTaskExecute(viewStubTask)60//加载完成之后,再postOnAnimation加载下一个61ViewCompat.postOnAnimation(decorView,this)62}else{63iViewStubTask?.afterTaskExecute()64}6566}6768funnotifyOnDetach(){69list.forEach{70it.onDetach()71}72list.clear()73}7475funnotifyOnDataReady(){76list.forEach{77it.onDataReady()78}79}8081}8283interfaceIViewStubTask{8485funbeforeTaskExecute()8687funonTaskExecute(viewStubTask:ViewStubTask)8889funafterTaskExecute()909192} 源码地址:https://github.com/gdutxiaoxu/AnchorTask,核心代码主要在ViewStubTask,ViewStubTaskManager, 有兴趣的可以看看 异步加载 异步加载,简单来说,就是在子线程创建 View。在实际应用中,我们通常会先预加载 View,常用的方案有: 在合适的时候,启动子线程 inflate layout。然后取的时候,直接去缓存里面查找 View 是否已经创建好了,是的话,直接使用缓存。否则,等待子线程 inlfate 完成。 AsyncLayoutInflater 官方提供了一个类,可以来进行异步的inflate,但是有两个缺点: 每次都要现场new一个出来 异步加载的view只能通过callback回调才能获得(死穴) 因此,我们可以仿造官方的 AsyncLayoutInflater 进行改造。核心代码在 AsyncInflateManager。主要介绍两个方法。 asyncInflate方法,在子线程 inflateView,并将加载结果存放到 mInflateMap 里面。 1@UiThread 2funasyncInflate( 3context:Context, 4varargitems:AsyncInflateItem? 5){ 6items.forEach{item-> 7if(item==null||item.layoutResId==0||mInflateMap.containsKey(item.inflateKey)||item.isCancelled()||item.isInflating()){ 8return 9}10mInflateMap[item.inflateKey]=item11onAsyncInflateReady(item)12inflateWithThreadPool(context,item)13}1415} getInflatedView方法,用来获得异步inflate出来的view,核心思想如下 先从缓存结果里面拿 View,拿到了view直接返回 没拿到view,但是子线程在inflate中,等待返回 如果还没开始inflate,由UI线程进行inflate 1/** 2*用来获得异步inflate出来的view 3* 4*@paramcontext 5*@paramlayoutResId需要拿的layoutId 6*@paramparentcontainer 7*@paraminflateKey每一个View会对应一个inflateKey,因为可能许多地方用的同一个layout,但是需要inflate多个,用InflateKey进行区分 8*@paraminflater外部传进来的inflater,外面如果有inflater,传进来,用来进行可能的SyncInflate, 9*@return最后inflate出来的view10*/11@UiThread12fungetInflatedView(13context:Context?,14layoutResId:Int,15parent:ViewGroup?,16inflateKey:String?,17inflater:LayoutInflater18):View{19if(!TextUtils.isEmpty(inflateKey)&&mInflateMap.containsKey(inflateKey)){20valitem=mInflateMap[inflateKey]21vallatch=mInflateLatchMap[inflateKey]22if(item!=null){23valresultView=item.inflatedView24if(resultView!=null){25//拿到了view直接返回26removeInflateKey(item)27replaceContextForView(resultView,context)28Log.i(TAG,"getInflatedViewfromcache:inflateKeyis$inflateKey")29returnresultView30}3132if(item.isInflating()&&latch!=null){33//没拿到view,但是在inflate中,等待返回34try{35latch.await()36}catch(e:InterruptedException){37Log.e(TAG,e.message,e)38}39removeInflateKey(item)40if(resultView!=null){41Log.i(TAG,"getInflatedViewfromOtherThread:inflateKeyis$inflateKey")42replaceContextForView(resultView,context)43returnresultView44}45}4647//如果还没开始inflate,则设置为false,UI线程进行inflate48item.setCancelled(true)49}50}51Log.i(TAG,"getInflatedViewfromUI:inflateKeyis$inflateKey")52//拿异步inflate的View失败,UI线程inflate53returninflater.inflate(layoutResId,parent,false)54} 简单 Demo 示范 第一步:选择在合适的时机调用AsyncUtils#asyncInflate方法预加载 View, 1objectAsyncUtils{ 2 3funasyncInflate(context:Context){ 4valasyncInflateItem= 5AsyncInflateItem( 6LAUNCH_FRAGMENT_MAIN, 7R.layout.fragment_asny, 8null, 9null10)11AsyncInflateManager.instance.asyncInflate(context,asyncInflateItem)12}1314funisHomeFragmentOpen()=15getSP("async_config").getBoolean("home_fragment_switch",true)16} 第二步:在获取 View 的时候,先去缓存里面查找 View 1overridefunonCreateView( 2inflater:LayoutInflater,container:ViewGroup?, 3savedInstanceState:Bundle? 4):View?{ 5//Inflatethelayoutforthisfragment 6valstartTime=System.currentTimeMillis() 7valhomeFragmentOpen=AsyncUtils.isHomeFragmentOpen() 8valinflatedView:View 910inflatedView=AsyncInflateManager.instance.getInflatedView(11context,12R.layout.fragment_asny,13container,14LAUNCH_FRAGMENT_MAIN,15inflater16)1718Log.i(19TAG,20"onCreateView:homeFragmentOpenis$homeFragmentOpen,timeInstanceis${System.currentTimeMillis()-startTime},${inflatedView.context}"21)22returninflatedView23//returninflater.inflate(R.layout.fragment_asny,container,false)24} 优缺点 优点: 可以大大减少 View 创建的时间,使用这种方案之后,获取 View 的时候基本在 10ms 之内的。 缺点 由于 View 是提前创建的,并且会存在在一个 map,需要根据自己的业务场景将 View 从 map 中移除,不然会发生内存泄露 View 如果缓存起来,记得在合适的时候重置 view 的状态,不然有时候会发生奇奇怪怪的现象。 总结 参考文章:https://juejin.cn/post/6844903924965572615 View 的渐进式加载,在 JectPack compose 没有推广之后,推荐使用这种方案,适配成本低 View 的异步加载方案,虽然效果显著,但是适配成本也高,没搞好,容易发生内存泄露 JectPack compose 声明式 UI,基本是未来的趋势,有兴趣的可以提前了解一下他。 这篇文章,加上一些 Demo,足足花了我几个晚上的时间,觉得不错的话可以关注一下我的微信公众号程序员徐公,小弟在此感谢各位大佬们。主要分享 Android 开发相关的知识,包括 java,kotlin, Android 技术 面试相关的东西,包括常见的面试题目,面试经验分享 算法相关的知识,比如怎么学习算法,leetcode 常见算法总结 一些时事点评,主要是关于互联网的,比如小米高管屌丝事件,拼多多女员工猝死事件等 源码地址:https://github.com/gdutxiaoxu/AnchorTask Android 启动优化(一) - 有向无环图 Android 启动优化(五)- AnchorTask 1.0.0 版本正式发布了 什么?Android webView 的字体突然变小了 徐公啐啐念 - 蹭热点也要有底线 本文分享自微信公众号 - 徐公码字(stormjun94)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。


优秀的个人博客,低调大师

基于业务和平台理解数字营销概念

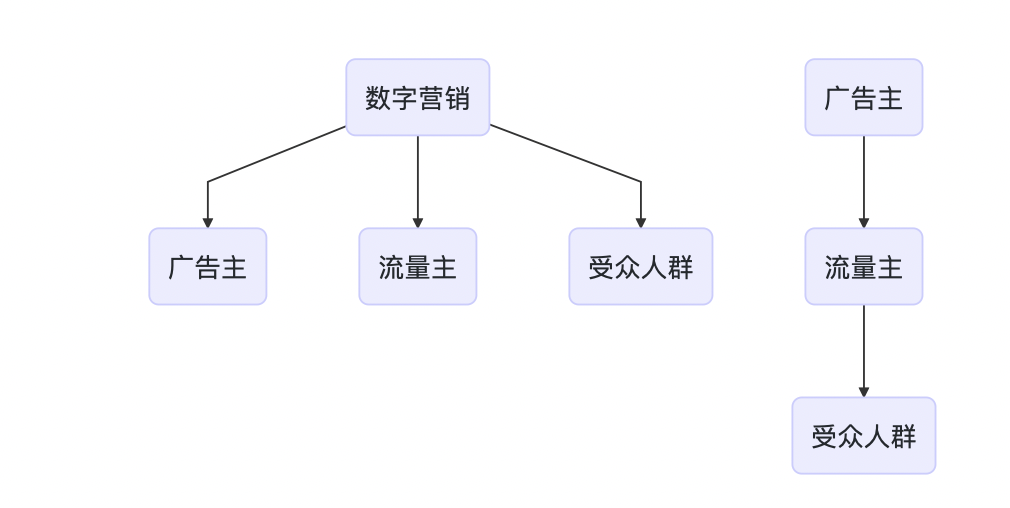
一、基本角色划分 数字营销模式中三个基本角色和模式:广告主通过流量主把广告内容传递到受众人群。 1、广告主 广告主是指想为自己的品牌或者产品做广告推销的用户,广告的根本目的是提高营销收入,从模式上看又分为两种:品牌广告和效果广告。 品牌广告主 受众人群广泛,产品容易被消费,存在着明显普遍被需求的基本特点,营销的效果不追求实时交易,更多是攻占用户注意力和视野,产生大众化的影响,收费模式通常按照曝光率计算。例如:生活用品,食品,电脑手机等。 效果广告主 受众人群不高,但是要求受众准确度高,十分追求广告的转化效果,讲究实时的营销效果,营销成功的单价较高,最典型的就是游戏推广的案例。 2、流量主 即有互联网流量存在的地方,从大的方面看,例如很多网站,社交应用,媒体流APP等,大量用户在使用和消费,流量大的平台通常都有自己一套流程化的广告对接模式。从小的方面看,很多平台上的博主,自媒体号主在拥有大量读者关注后也可以称为流量主。 3、受众人群 数字营销产业链上最核心的角色就是就是受众人群,即浏览广告的用户,之所以称为受众人群,通常会把用户按照画像特点基于标签进行人群分类,根据广告的需求,可能是根据不同年龄段,地域,消费能力等各种标签。数字营销的基本就是广告主把营销内容传递到潜在的消费者,并触发用户交易动作。 二、管理平台分类 1、DSP平台 DSP是【Demand-Side Platform】的简称即需求方平台,主要用来简化广告主和流量渠道对接的复杂过程。通常情况下广告主对接广告的过程如下: 分析受众人群的特点,分开投放; 确定广告要投放的多个流量平台; 熟悉对接广告平台的规则与流程; 逐个平台进行投放并分析投放结果; 多个渠道投放效果分析与结算; 上面的这个过程的是复杂和漫长,并且需要投入大量的人力和财力成本,这个时候DSP平台就应运而生。广告主你只需要负责把需求对接到DSP平台上,DSP平台聚合对接多家流量平台,并且输出广告过程的各个旅程状态,对于广告主而言可以像购物车那般选择流量平台并下单即可,像一些具备用户能力的平台和自建DMP系统的,甚至可以提供受众人群,这样就大大减少广告主的成本和周期,这就是很多聚合服务平台的价值。 DSP解决的核心问题:自动化投放流程,避免人群复投现象,多方对接成本,效果分析和结算。通过强大的受众数据分析和效果反馈把控,帮助广告主做实时规则性决策,让广告主的营销费用实现最大化收益。 2、DMP平台 DMP管理平台在【数据全景洞察】的文章中说到过,把分散的多方数据进行整合纳入统一的技术平台,并对这些数据进行标准化和标签化管理,让用户可以把这些细分结果推向现有的互动营销环境里的平台。核心作用如下:可以对统一对数据快速查询、圈选符合条件的人群,生成特定场景对数据分析报告。 通常情况下DSP平台可能存在受众数据,也可能没有数据,数据营销需要数据全面准确并且有实时更新的能力,作为数字化营销的最核心组成部分,很有拥有大量用户的公司都有自己的DMP系统,真正持有大量受众数据的平台通常具有更高的定价能力,并且也会组建自己的DSP平台或者对接多个其他的DSP平台,让数据发挥出更高的价值。 还有一种情况,广告主拥有自己的用户,可能是大量的或者少量的,用户量大且具备标签能力的话直接借助DSP平台推广即可,用户量小可以借助DMP平台以种子用户的方式进行扩量在推到营销平台,不同的方式都会影响营销成本。 3、基本协作模式 基本流程模式如下,注意这里的DMP平台具体归属哪里是不确定的,只是从模式上看需要借助DMP这样一个概念性质的平台对营销人群做标签分析。 广告主提出需求,例如推销编程书籍; DMP系统根据需求筛选受众人群,例如:程序员; DSP平台将受众推到流量平台,例如:博客网站; DSP平台接收推广效果,并生成分析报告和结算; 不同的营销模式和思路其收费标准也各不相同,例如不管效果按照指定时间段展示曝光收费,按照曝光量收费,按照营销效果收费,或者曝光量收费低加按成交量提成等等。 在实际上流程是远比这里描述的复杂,例如DSP平台需要分析哪些用户没有被触达,需要投放到其他渠道,当广告主的营销费用没有消耗完,如果根据反馈效果做二次数据分析并再次进行营销,这里的模式和思维都很值得细细思考。 三、营销模式 1、AB客群测试 AB测试是为Web或App界面或流程制作两个(A/B)或多个(A/B/n)版本,在同一时间维度,分别让组成成分相同(相似)的访客群组(目标人群)随机的访问这些版本,收集各群组的用户体验数据和业务数据,最后分析、评估出最好版本,正式采用。用于验证用户体验、市场推广等是否正确,而一般的工程测试主要用于验证软硬件是否符合设计预期,因此AB测试与一般的工程测试分属于不同的领域。广告优化可能是AB测试最常见的应用场景了,同时结果也是最直接的,营销人员可以通过AB测试的方法了解哪个版本的广告更受用户的青睐,哪些步骤怎么做才能更吸引用户。 2、营销类型场景 主动式营销,企业主动对特定人群发起沟通或营销触达; 触发式营销,基于客户的行为特点或者特征变化实时触发预设的营销规则触达; 周期性营销,按照固定周期对特定人群发起营销触达和沟通; 纪念日营销,由设定时间点触发的营销触达和沟通; 场景化营销,视觉营销场景,特定兴趣场景,需求场景,购买场景; 熟悉了解多种营销方式或者场景,结合业务的需求特点,分析客群在什么状态下最可能通过营销实现促成交易,不断进行分析和优化策略。 3、营销渠道 全渠道 互联网存在的客群可能在全渠道和营销模式触达和互动,所以基于全渠道看不同营销效果,因为不同的流量渠道中的用户特点不一样,所以分析不同渠道下不同的营销方式的效果尤为重要。 短信营销 通常DMP平台会提供完整的短信营销方案,从短信模板的设置、内容实时动态组装、定向定时发送、实时监控、效果评估。 App消息推送 App推送是很常用的一种营销手段,通常一天下来可能收到很多推送消息,根据客群的App使用情况分析,广告内容可主动通过消息推送触达客户,可进行精准的1对1消息推送,并支持推送消息管理、动态内容、定时定向推送和送达效果监控等功能。 邮件营销 邮件营销一般针对广告方已有的客户,现在很多垃圾邮件都会被邮件平台直接拉黑,所以相对适应对广告方的已有客户进行营销,通过对邮件到达率、反馈率、退订管理做综合分析。 四、源代码地址 GitHub·地址 https://github.com/cicadasmile GitEE·地址 https://gitee.com/cicadasmile

优秀的个人博客,低调大师

深入理解 relocating 对Elasticsearch集群的影响

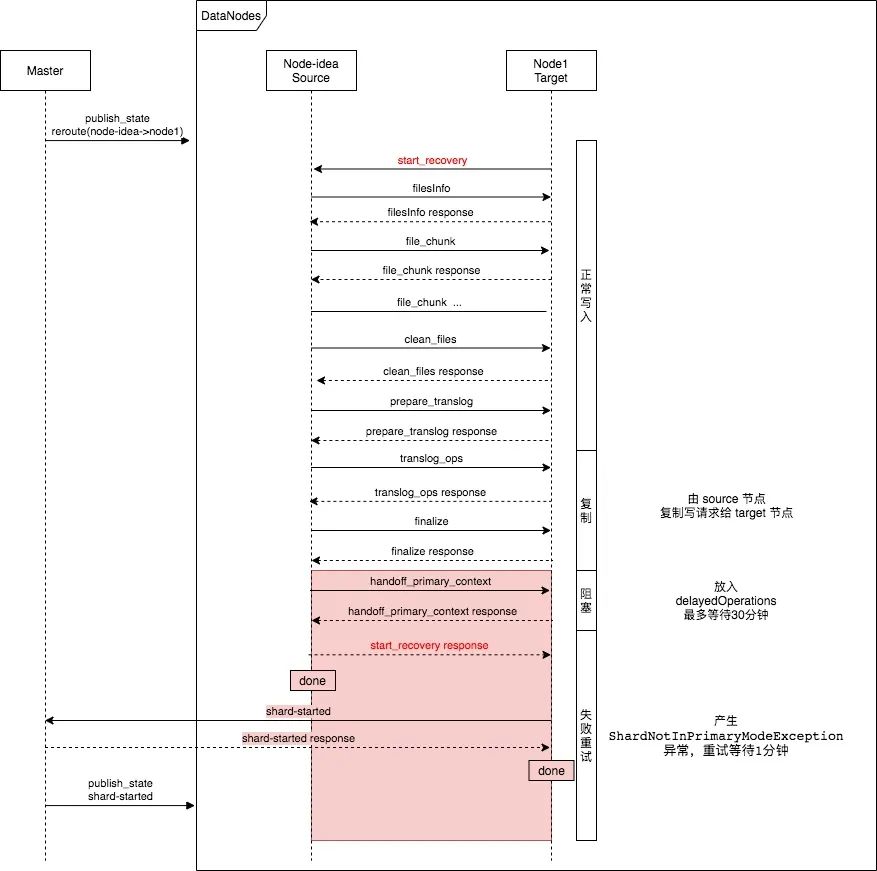
rebalance 用于将集群中的分片进行均衡,保持各个节点的分片数量大致相等,当集群扩容或缩容,掉一个节点的时候,这过程会自动完成。直观的感觉他应该是在后台默默干活的过程,最多占用带宽和磁盘 io 资源,应该感受不到他的存在,但实际情况是,他可能引起一些意想不到的问题。 这篇文章主要思考分片 relocating 对集群会有哪些影响(基于 v7.7),有下面几个。 shard-started RPC 会抢占较多的 master 处理时间 分片移动结束后,target 节点会向 master 发起一个 shard-started PRC,该 RPC 具有次高优先级:URGENT, master 对该 RPC 的处理比较慢,尤其是在集群分片数量到几万的级别,从而可能导致一些较低优先级的 RPC 长时间来不及执行,例如 put-mapping,进而导致对业务的明显影响。 由于 rebalance,allocation filtering,forced awareness等任意原因产生的 shard-started RPC 都会存在这个问题,例如扩容集群的时候,如果把 rebalance 并发开的比较大,对 master 的处理能力造成明显影响。因此对于分片数较多的集群,当你想要加大 rebalance 和 recovery 并发的时候要考虑到对 master 的影响。 move 一个主分片,对写入流程的影响 当一个主分片被 rebalance 或者手工 move 的时候,可以想象必然存在一个时间段该主分片无法写入。 Elasticsearch 对主分片的 relocating 也是直接 move,不会先将主分片资格让给其他副分片,再进行 move,即便如此,也会存在一个时间点进行切换,无法响应写入。 这个时间段从 RPC 的时序来看的话,如下图所示,红色标记的区域为阻塞写入流程的时间段。在该时间段内,客户端的写入请求会被阻塞无返回,直到这部分处理完成。  以手工 move 为例,当一个主分片从 node-idea move 到 node1时,主要有以下几个阶段完成: 首先会通过发布新的集群状态,将该分片标记为 RELOCATING状态,更新 routing_table 和 routing_nodes 数据节点收到集群状态后,开始执行 recovery 流程,该流程自 target 节点发送 start_recovery开始,至 Source 阶段返回 start_recovery response 结束。 recovery 完成后,target发送 shards-started RPC 给 master 节点,master 节点再次下发集群状态,将该分片标记为 STARTED 状态。 阻塞客户端 bulk 写入的阶段,就在 source 节点执行 finalize 阶段时,准备发送 handoff RPC 时开始,直到收到 master 新的集群状态,将该分片标记为 STARTED,每个节点应用集群状态的时间点略有差异,所以每个节点停止阻塞写入的时间点也会有微小差异。 handoff 的 RPC的作用是告知 target 节点该分片可以切换主分片状态,对 handoff RPC 的处理都是一些计算操作,其中涉及到几个锁,一般会很快完成。 整个主分片的 relocating 过程对写入的影响是很复杂的处理过程,我将他们划分为几个阶段,下面是详细过程。 阻塞过程详细原理 在分片的整个 relocating 过程中,对 target 节点的请求都会被转发到 source 节点,直到 target 节点应用了 master 下发的分片变为 STARTED 的集群状态。 正常写入阶段 起初,写入请求到达 source 节点,像往常一样正常写入到主分片中,直到复制阶段。 复制阶段 此阶段将收到的写请求复制给 target 节点。他从收到 prepare_translog 的 response之后开始,直到 handoff 阶段开始之前。 1.将 target 分片加入到 replication group 收到 prepare_translog response之后,recovery 的 phase1阶段已结束,segments 文件发送完毕,target 节点的 engine 已启动。通过 shard.initiateTracking将 target 分片加入到复制组,后续的写入操作都会复制给 target 节点。 prepareEngineStep.whenComplete(prepareEngineTime -> { runUnderPrimaryPermit(() -> shard.initiateTracking(request.targetAllocationId()), shardId + " initiating tracking of " + request.targetAllocationId(), shard, cancellableThreads, logger); final Translog.Snapshot phase2Snapshot = shard.getHistoryOperations("peer-recovery", historySource, startingSeqNo);}); 复制组信息在 ReplicationTracker 的 replicationGroup成员中维护。 2.在写入过程中,将写请求复制给 target 在写入流程的 performOnPrimary#doRun() 函数的 finishRequest方法中,最终调用 ReplicationOperation#handlePrimaryResult函数的 performOnReplicas方法将 index 发送给 target 节点。 handoff阻塞阶段 handoff阶段是为了完成主分片状态的转移,该阶段对收到的写入请求放到队列中,待主分片状态转移完成后继续执行,最多阻塞30分钟。期间对 target 节点的写入也会被转发的 source 节点执行。此阶段从 source 节点收到 finalize 的 response之后开始,直到下一阶段。 1.recovery 过程设置阻塞标记 在 source 节点收到 finalize 的 response之后,通过 handoff RPC 交接主分片状态,这个交接过程通过 indexShardOperationPermits.blockOperations 对此时收到的写入请求进行阻塞,最多30分钟。 public void relocated(final String targetAllocationId, final Consumer<ReplicationTracker.PrimaryContext> consumer){ try { indexShardOperationPermits.blockOperations(30, TimeUnit.MINUTES, () -> {//block 的范围就是这段括号里的代码 final ReplicationTracker.PrimaryContext primaryContext = replicationTracker.startRelocationHandoff(targetAllocationId); try {//下面调用 RemoteRecoveryTargetHandler.handoffPrimaryContext consumer.accept(primaryContext);//执行这里之后发送和响应了 handoff_primary_context RPC } }); } } indexShardOperationPermits.blockOperations 中的阻塞操作只是 queuedBlockOperations 加1,后面写入流程会检查 queuedBlockOperations 的值是否为0 2.写入流程的处理产生在写入链路的 acquire函数: acquire:255, IndexShardOperationPermits (org.elasticsearch.index.shard)acquirePrimaryOperationPermit:2764, IndexShard (org.elasticsearch.index.shard)handlePrimaryRequest:256, TransportReplicationAction 该函数判断 queuedBlockOperations 大于0,于是将他添加到 delayedOperations,写入流程到此结束。delayedOperations中的操作会在本阶段的阻塞过程结束后处理。 失败重试阶段 失败重试阶段自source 节点处理完 handoff response之后开始,直到 master 下发了将分片标记为 STARTED 的集群状态,数据节点应用了集群状态之后结束,在应用这个集群状态之前,分片处于 relocating 状态,期间的写入操作由 source 节点执行,并且会写入失败,抛出 ShardNotInPrimaryModeException 异常,并捕获该异常,等待1分钟后重试写入,再次失败则退出;如果1分钟内收到了新的集群状态,也会重试写入,然后写入成功。 写入流程中,执行 acquire 函数时,发现 queuedBlockOperations为0,执行onAcquired.onResponse(releasable),调用到 wrapPrimaryOperationPermitListener函数时,发现分片已经不是主分片状态,抛出 ShardNotInPrimaryModeException 异常。 if (replicationTracker.isPrimaryMode()) { l.onResponse(r);} else { r.close(); l.onFailure(new ShardNotInPrimaryModeException(shardId, state));} 对于上者返回的异常,写入流程 acquirePrimaryOperationPermit 设置的 Listener会区分异常类型,如果是 ShardNotInPrimaryModeException 异常,则等待1分钟后进行重试。 move 一个副分片,对写入流程的影响 副分片的 move 过程与主分片的 move 过程相似,也是下发两次集群状态,通过 recovery 复制到 target 节点。 需要注意的是,recovery 复制分片到 target 节点,并非从副分片当前所在节点复制到 target,而是从主分片复制到 target。例如,主分片在节点 node-idea 上,副分片在 node-1,当我们从 node-1 move 到 node-2时,recovery 是从 node-idea 复制到 node-2。当 node-1应用主节点发布的分片状态变为 STARTED 的集群状态时,发现分片已经属于自己,于是删除本节点的分片。 与主分片的 relocating 类似的是,在复制阶段,会将正在 recovery 的分片添加到 replication group,这样 replication group 中就有了三个分片,主分片,原副分片,以及 move 到 target 节点的新的副分片。在复制阶段,写入操作会写入到这三个分片。 以手工 move 一个副分片为例,从 node-1 move 到 node-2时,当收到第一个第一个集群状态,分片被标记为 relocating,于是数据从 node-idea recovery 到 node-2。在此期间,新的 index 操作会由主分片节点复制到另外两个节点。如下图所示。 这个过程相当于先增加了一个副分片,执行副分片的 recovery 流程复制到新的 target。 当 recovery 执行完毕,master 下发第二个集群状态,分片被标记为 STARTED,node-1原来持有的分片被删除,如下图所示。 副分片的 relocating 过程不会有 handoff 阶段,整个 relocating 过程如同副分片的 recovery 过程一样,没有对写入进行阻塞的阶段。 (扫码或长按关注本公众号) 本文分享自微信公众号 - Elasticsearch 原理与实践(gh_81a98ec906ca)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册