首页 文章 精选 留言 我的

精选列表

搜索[MSA技术],共10000篇文章
优秀的个人博客,低调大师

2026 技术观察:智慧机场进入协同调度阶段,航班过站、机位冲突和保障资源预测成为新重点

## 概述 2026 年,机场运行正在从“单环节信息化”走向“全流程协同调度”。 一架航班落地后,需要依次完成机位停靠、旅客下机、行李卸载、客舱清洁、航空配餐、燃油补给、机务检查、行李装载和旅客登机等保障任务。 这些任务由不同单位负责,却共同影响航班能否准时起飞。 如果摆渡车迟到、行李装载延误、廊桥发生冲突,或者前序航班长时间占用机位,就可能导致后续航班连续延误。 因此,智慧机场开始进入协同调度阶段。 系统不只是展示航班信息,而是实时分析航班状态、机位占用、保障任务、车辆位置和人员负载,提前识别冲突,并动态调整资源。 --- ## 一、为什么机场需要协同调度? 机场运行是一个高度协同的复杂系统。 航班、机位、车辆、人员和保障任务之间存在紧密依赖。任何一个环节出现延误,都可能影响整个过站流程。 智慧机场调度系统可以帮助管理者回答几个问题: 1. 哪些航班存在延误风险; 1. 哪些机位可能发生时间冲突; 1. 哪些保障任务尚未完成; 1. 哪些车辆或人员负载过高; 1. 是否需要重新分配保障资源; 1. 如何生成航班过站运行报告。 下面用 Python 写一个简化版机场航班过站协同调度系统。 --- ## 二、基础数据:定义航班和机位 第一步是准备航班计划和机位信息。 ``` import json from datetime import datetime, timedelta from collections import defaultdict FLIGHTS = [ { "flight_no": "MU5101", "arrival_time": "2026-07-10 14:00", "departure_time": "2026-07-10 15:20", "aircraft_type": "A320", "passenger_count": 156, "gate_id": "G01", "status": "landed" }, { "flight_no": "CA1836", "arrival_time": "2026-07-10 14:35", "departure_time": "2026-07-10 15:45", "aircraft_type": "B737", "passenger_count": 172, "gate_id": "G02", "status": "approaching" }, { "flight_no": "CZ3218", "arrival_time": "2026-07-10 15:00", "departure_time": "2026-07-10 16:10", "aircraft_type": "A321", "passenger_count": 198, "gate_id": "G01", "status": "scheduled" } ] GATES = [ { "gate_id": "G01", "gate_type": "bridge", "supported_aircraft": ["A320", "A321", "B737"], "status": "available" }, { "gate_id": "G02", "gate_type": "bridge", "supported_aircraft": ["A320", "B737"], "status": "available" }, { "gate_id": "R01", "gate_type": "remote", "supported_aircraft": ["A320", "A321", "B737"], "status": "30664.t.kuaisou.com " } ] ``` 航班和机位数据是机场协同调度的基础。 真实系统中,这些数据通常来自航班信息系统、机场运行数据库和航空公司运行平台。 --- ## 三、机位冲突检测 第二步是检查同一机位上的航班时间是否重叠。 ``` def parse_time(value): return datetime.strptime( value, "%Y-%m-%d %H:%M" ) def detect_gate_conflicts(flights, buffer_minutes=20): gate_flights = defaultdict(list) for flight in flights: gate_flights[flight["gate_id"]].append( flight ) conflicts = [] for gate_id, items in gate_flights.items(): sorted_flights = sorted( items, key=lambda item: parse_time(item["arrival_time"]) ) for index in range(len(sorted_flights) - 1): current = sorted_flights[index] next_flight = sorted_flights[index + 1] release_time = parse_time( current["departure_time"] ) + timedelta(minutes=buffer_minutes) next_arrival = parse_time( next_flight["arrival_time"] ) if next_arrival 180 else 1.0 ) for task_type, base_minutes in TASK_TEMPLATES.items(): duration = base_minutes if task_type in [ "passenger_service", "baggage_unload", "baggage_load", "boarding" ]: duration = int( base_minutes * passenger_factor ) tasks.append({ "task_id": f"{flight['flight_no']}_{task_type}", "flight_no": flight["flight_no"], "task_type": task_type, "estimated_minutes": duration, "status": "30658.t.kuaisou.com ", "assigned_resource": None }) return tasks ``` 保障任务需要结构化。 只有把每个环节拆成任务,系统才能分析进度、依赖关系和资源需求。 --- ## 五、保障资源定义与分配 第四步是定义地面保障资源,并给任务自动分配。 ``` GROUND_RESOURCES = [ { "resource_id": "RES001", "resource_type": "baggage_team", "status": "idle", "current_task": None }, { "resource_id": "RES002", "resource_type": "cleaning_team", "status": "idle", "current_task": None }, { "resource_id": "RES003", "resource_type": "fuel_truck", "status": "idle", "current_task": None }, { "resource_id": "RES004", "resource_type": "maintenance_team", "status": "idle", "current_task": None }, { "resource_id": "RES005", "resource_type": "boarding_team", "status": "idle", "current_task": None } ] TASK_RESOURCE_MAP = { "baggage_unload": "baggage_team", "baggage_load": "baggage_team", "cabin_cleaning": "cleaning_team", "fueling": "fuel_truck", "maintenance_check": "maintenance_team", "passenger_service": "boarding_team", "boarding": "boarding_team" } def assign_ground_resources(tasks, resources): assignments = [] for task in tasks: required_type = TASK_RESOURCE_MAP.get( task["task_type"] ) if not required_type: assignments.append({ "task_id": task["task_id"], "status": "external_or_manual", "resource_id": None }) continue available = next( ( resource for resource in resources if resource["resource_type"] == required_type and resource["status"] == "idle" ), None ) if available: available["status"] = "busy" available["current_task"] = task["task_id"] task["assigned_resource"] = available["resource_id"] assignments.append({ "task_id": task["task_id"], "status": "assigned", "resource_id": available["resource_id"] }) else: assignments.append({ "task_id": task["task_id"], "status": "waiting_resource", "resource_id": None }) return assignments ``` 资源分配可以帮助机场识别保障能力不足。 当多个航班同时过站时,车辆和人员可能成为真正的瓶颈。 --- ## 六、航班过站时间评估 第五步是根据任务情况判断航班能否按计划完成保障。 ``` def evaluate_turnaround_risk(flight, tasks, assignments): available_minutes = int( ( parse_time(flight["departure_time"]) - parse_time(flight["arrival_time"]) ).total_seconds() / 60 ) waiting_tasks = [ item for item in assignments if item["status"] == "waiting_resource" ] total_estimated = sum( task["estimated_minutes"] for task in tasks ) parallel_efficiency = 0.42 estimated_turnaround = int( total_estimated * parallel_efficiency ) risk_score = 0 issues = [] if estimated_turnaround > available_minutes: risk_score += 5 issues.append("预计保障时间超过航班过站窗口。") if waiting_tasks: risk_score += len(waiting_tasks) * 2 issues.append("部分保障任务缺少可用资源。") if flight["passenger_count"] > 180: risk_score += 1 issues.append("航班旅客数量较多。") if risk_score >= 7: level = "high" elif risk_score >= 3: level = "medium" elif risk_score > 0: level = "low" else: level = "normal" return { "flight_no": flight["flight_no"], "available_minutes": available_minutes, "estimated_turnaround_minutes": estimated_turnaround, "waiting_task_count": len(waiting_tasks), "risk_score": risk_score, "risk_level": level, "issues": issues } ``` 过站风险评估可以提前发现延误可能。 系统不需要等到计划起飞时间临近,才发现还有任务没有完成。 --- ## 七、机位调整建议 第六步是针对机位冲突寻找替代机位。 ``` def recommend_alternative_gate( conflict, flights, gates ): next_flight = next( flight for flight in flights if flight["flight_no"] == conflict["next_flight"] ) candidates = [] for gate in gates: if gate["gate_id"] == conflict["gate_id"]: continue if next_flight["aircraft_type"] not in gate["supported_aircraft"]: continue occupied = any( flight["gate_id"] == gate["gate_id"] and parse_time(flight["arrival_time"]) <= parse_time(next_flight["arrival_time"]) <= parse_time(flight["departure_time"]) for flight in flights ) if not occupied: candidates.append(gate) if not candidates: return { "flight_no": next_flight["flight_no"], "recommended_gate": None, "message": "暂无满足条件的替代机位。" } candidates.sort( key=lambda item: ( item["gate_type"] != "bridge", item["gate_id"] ) ) return { "flight_no": next_flight["flight_no"], "recommended_gate": candidates[0]["gate_id"], "message": "建议调整至可用替代机位。" } ``` 机位调整要同时考虑机型适配和占用情况。 廊桥机位不足时,也可能需要安排远机位和摆渡车辆。 --- ## 八、运行完整智慧机场调度流程 最后把机位冲突、任务生成、资源分配和风险评估串起来。 ``` def run_airport_turnaround_coordination(): conflicts = detect_gate_conflicts( FLIGHTS ) conflict_suggestions = [ recommend_alternative_gate( conflict, FLIGHTS, GATES ) for conflict in conflicts ] flight_results = [] for flight in FLIGHTS: tasks = generate_turnaround_tasks( flight ) resources = [ resource.copy() for resource in GROUND_RESOURCES ] assignments = assign_ground_resources( tasks, resources ) turnaround_risk = evaluate_turnaround_risk( flight, tasks, assignments ) flight_results.append({ "flight": flight, "tasks": tasks, "assignments": assignments, "turnaround_risk": turnaround_risk }) risk_count = defaultdict(int) for item in flight_results: level = item["turnaround_risk"]["risk_level"] risk_count[level] += 1 report = { "report_name": "智慧机场航班过站协同调度报告", "gate_conflicts": conflicts, "gate_suggestions": conflict_suggestions, "flight_results": flight_results, "risk_count": 30657.t.kuaisou.com "generate_time": datetime.now().isoformat() } return report if __name__ == "__main__": report = run_airport_turnaround_coordination() print(json.dumps( report, ensure_ascii=False, indent=2 )) ``` --- ## 九、趋势判断 从这套流程可以看到,智慧机场正在从信息展示走向运行协同。 未来,机场系统不会只显示航班计划和机位状态,还会把过站任务、保障资源、时间窗口和冲突风险统一分析。 机场运行效率的提升,也不会只依靠增加人员和设备,而会更加依赖精细调度和实时协同。 谁能把航班、机位、车辆、人员和保障任务连接起来,谁就更容易降低航班延误风险,并提升机场整体运行效率。
优秀的个人博客,低调大师

SpreadJS V19.0 新特性解密:透视表日期分组,解锁时间维度分析新效率 | 葡萄城技术团队

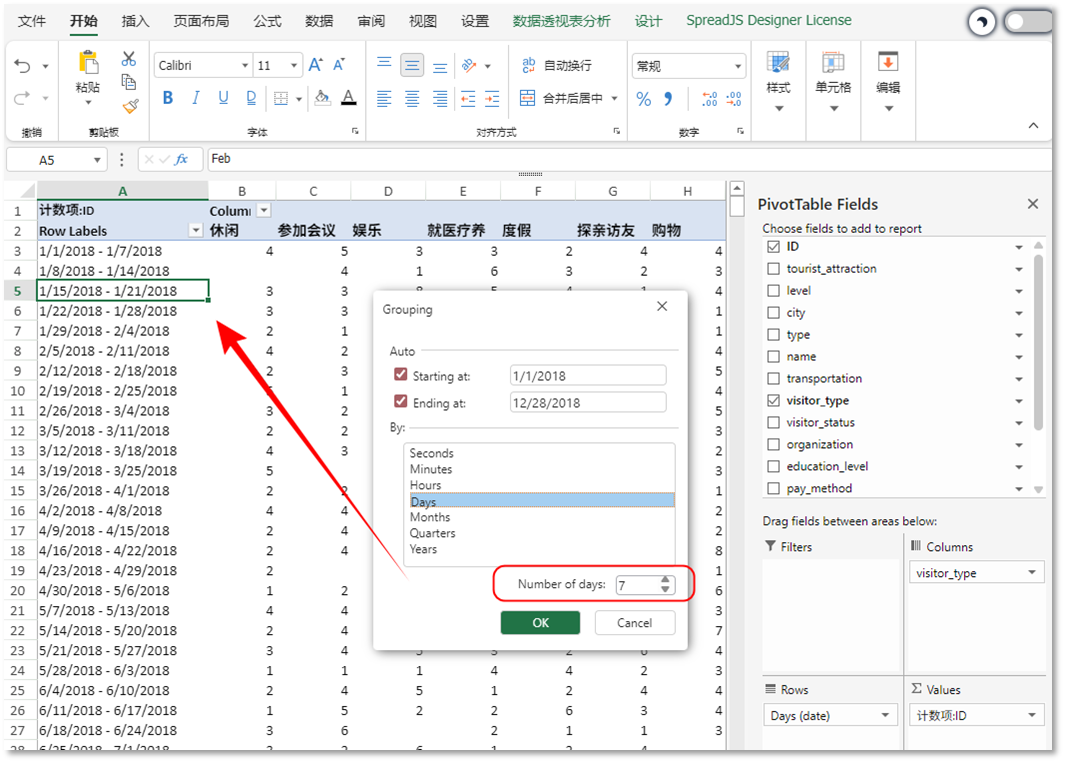
在数据分析场景中,日期维度的聚合分析是高频需求------无论是按周统计销售数据、按月汇总项目进度,还是按自定义周期分析业务趋势,都需要对日期数据进行灵活分组。传统透视表的日期处理往往局限于固定的年、月、日层级,若要实现按周、15天等自定义周期分组,需手动预处理数据或编写复杂公式,不仅操作繁琐,还容易因数据同步不及时导致分析偏差。 为解决这一痛点,SpreadJS V19.0 重磅推出透视表日期分组(Date Group)功能,支持按自定义天数灵活分组,完美适配周报、自定义周期分析等场景,让时间维度的数据聚合更高效、更贴合业务需求。下面,我们将深入解析这一特性的核心价值与使用细节。 核心功能解析:灵活配置,精准聚合日期数据 SpreadJS V19.0 的透视表日期分组功能以"自定义性强、适配场景广"为核心设计理念,提供全方位的日期分组配置能力,满足不同业务场景的分析需求: 1. 自定义天数分组,适配多元业务需求 支持按任意天数设置分组间隔(groupInterval),彻底摆脱固定时间层级的限制: 典型场景适配:设置"7天"为分组间隔,即可快速实现周报数据聚合,无需手动拆分日期区间; 自定义周期支持:根据业务需求灵活设置分组天数,如15天(半月报)、30天(月度滚动分析)、90天(季度趋势分析)等,轻松应对多样化的时间维度统计需求; 生效规则明确:groupInterval 仅在按"天"分组时生效,确保配置逻辑清晰,避免混淆。 2. 灵活控制起止时间,精准圈定分析范围 日期分组支持自定义起止时间(start/end),同时提供智能默认规则,兼顾灵活性与便捷性: 智能默认逻辑:若未手动设置起止时间,系统自动读取原始日期字段的最小值和最大值作为分组范围,无需额外配置; 自定义范围支持:可根据分析需求手动设定 start 和 end 时间,例如仅分析"2024年Q2"(4月1日-6月30日)的数据,精准圈定目标区间; 边界校验机制:系统强制要求 end 时间晚于 start 时间,避免无效配置;若起止时间间隔小于设置的 groupInterval,则直接按实际间隔分组,确保分组逻辑合理。 3. 分组项显示精细化控制,兼顾完整性与可读性 针对分组结果的显示,提供多重配置选项,平衡数据完整性与视觉可读性: 无数据分组项控制:分组后可能出现无数据的区间(如某周无销售记录),可通过设置"show items with no data"显示这些空值分组项,确保时间维度的完整性;默认不显示空值分组项,避免报表冗余; 超出范围数据处理:超出起止时间范围的日期数据,会被自动分配到特殊分组,以"< start时间"或"> end时间"标识,清晰区分有效分析区间与异常数据,便于后续数据校验。 4. 标准化时间单位,确保分组准确性 日期分组的最小单位为"天",无论原始日期数据是否包含时分秒信息,系统都会自动将其转换为当天的00:00:00进行分组计算: 避免时间精度干扰:例如原始数据中"2024-05-10 14:30:00"和"2024-05-10 23:59:00"会被归为同一组,确保日期分组的准确性; 简化数据处理逻辑:无需手动统一日期格式,系统自动标准化处理,降低操作门槛。 典型应用场景:让时间维度分析更贴合业务 这一特性的推出,让透视表的日期分析能力全面升级,在多个核心业务场景中发挥关键价值: 1. 周报/半月报快速生成 市场、销售等部门需要按周或半月汇总数据时,无需手动拆分日期区间:只需将日期字段拖入透视表行/列区域,设置分组天数为7天或15天,系统自动聚合对应区间的数据,快速生成周报、半月报,效率提升80%以上。 2. 自定义周期业务分析 针对特殊业务周期(如电商大促活动14天周期、项目迭代21天周期),可灵活设置分组天数,实时分析活动期间的业务数据趋势,无需修改数据源或编写复杂计算逻辑。 3. 跨时间段对比分析 需要对比不同年份同一周期的数据时(如2023年Q3第1周 vs 2024年Q3第1周),可通过自定义起止时间锁定对应区间,结合透视表的筛选功能,快速实现跨年度、跨周期的对比分析,助力业务趋势判断。 4. 数据合规与追溯 在金融、医疗等需要精准时间追溯的行业,可通过固定起止时间和分组间隔,标准化日期数据的聚合方式,确保分析结果的一致性和可追溯性,符合行业合规要求。 操作指南:3步实现日期分组,上手即会 SpreadJS V19.0 的日期分组功能操作简洁,无需复杂配置,3步即可完成: 插入透视表并添加日期字段:在SpreadJS设计器中插入透视表,将需要分组的日期字段拖入"行标签"或"列标签"区域; 打开日期分组设置:右键点击日期字段,选择"分组"选项,弹出分组配置对话框; 配置分组参数并应用: 选择分组单位为"天"; 设置分组天数(groupInterval),如7天(周报); 按需自定义起止时间(start/end),默认可不填; 勾选"show items with no data"(可选,需显示空值分组项时启用); 点击"确定",系统自动完成日期分组,透视表实时更新聚合结果。 注意事项:这些细节让分组更精准 为确保日期分组功能的使用效果,以下关键细节需留意: groupInterval 生效条件:仅当分组单位选择"天"时,自定义天数(groupInterval)才会生效;若选择年、月、日等固定层级,该参数不生效; 起止时间格式:自定义 start/end 时,需遵循标准日期格式(如"2024-01-01"),系统会自动识别并转换; 空值分组项默认行为:默认不显示无数据的分组项,若需完整展示时间区间,需手动启用"show items with no data"; 时间精度处理:原始日期数据的时分秒信息会被忽略,统一按"天"为单位进行分组,若需保留时分秒级别的分析,需提前对数据进行预处理。 总结与展望:让数据分析更贴合业务节奏 SpreadJS V19.0 推出的透视表日期分组功能,以"灵活配置、精准聚合、操作便捷"为核心优势,彻底解决了传统透视表日期分析的局限性,让时间维度的数据聚合更贴合业务需求,大幅降低数据分析门槛,提升工作效率。 作为一款面向企业级应用的纯前端表格控件,SpreadJS 始终聚焦开发者与终端用户的实际需求,持续优化透视表等核心功能------除了日期分组,V19.0 还为透视表带来了拖动自定义排序、受保护工作表中启用透视表等多项增强能力,全方位提升数据处理与分析体验。 如需了解更多功能细节,可访问 SpreadJS 官网 查看产品文档,或通过 在线 Demo 直接体验新特性。SpreadJS V19.0 即将正式发布,敬请期待这款更强大、更灵活的前端表格控件,为你的业务系统注入新的活力!

优秀的个人博客,低调大师

深入 OOXML 底层原理讲解修复策略 | 葡萄城技术团队

在企业级应用中,数据导出服务往往是业务交付的最后一公里。我们习惯了使用各类第三方工具生成Excel文件,但在某些复杂的定制化场景下,开发者常常会遭遇那个令人脊背发凉的时刻:代码运行完美无报错,文件正常生成,但要打开这个文件时,Excel 却冷漠地弹出一个提示框:“发现‘xxx.xlsx’中的部分内容有问题。是否让我们尽量尝试恢复?” 对于缺乏底层经验的开发者来说,这无异于面对一个黑盒:你不知道是哪一行代码触发了 Excel 渲染引擎的“报错”,只能盲目地注释代码、重试,碰运气。 本文将抛开应用层代码,下沉到微软 Office Open XML (OOXML) 标准的底层视角,通过一个真实的“冻结窗格”逻辑死锁案例,复盘一套从解包分析到手动修复的系统化排查思路。 一、 透视本质:.xlsx 文件其实是一系列xml的压缩包 自 Office 2007 发布以来,微软将文件格式从私有的二进制 OLE 结构迁移到了基于 XML 的开放标准(ECMA-376),也就是我们常说的 OOXML。这就意味着,你每天处理的 .xlsx 文件,本质上只是一个遵循特定目录结构的 ZIP 压缩包。 当你把一个损坏的 Excel 文件的后缀名简单粗暴地从 .xlsx 改为 .zip 并解压后,你就获得了解析问题的钥匙。在这个目录结构中,有几个核心组件构成了 Excel 的骨架: [Content_Types].xml:这是整个压缩包的“物资清单”,它精确声明包内每一个 XML 文件的 MIME 类型,任何未在此注册的文件都会导致 Excel 拒绝加载。 xl/workbook.xml:相当于工作簿的“目录”,它定义了当前文件包含多少个 Sheet,以及它们之间的索引关系。 xl/sharedStrings.xml:这是一个极易被忽视的性能优化组件。Excel 为了减小体积,不会在单元格里重复存储相同的文本,而是将所有文本提取到这个“字典”中,单元格通过索引(Index)来引用它。 xl/worksheets/sheetX.xml:这是我们排查的重点,每一个 Sheet 的数据内容、行高列宽、以及导致报错的“视图设置”都在此文件中。 理解了这个物理结构,我们就不再是盲人摸象,而是可以像外科医生一样对文件进行精准的病灶切除。 二、 建立排查链:从日志分析到代码 Diff 当面对一个损坏的 Excel 文件时,不要急着去改生成代码。根据我们处理海量表格导出问题的经验,建立以下三级排查漏斗是最高效的策略。 1.用好 Excel 的修复机制 Excel 的容错机制其实非常强大。当它提示“是否尝试恢复”并点击确认后,如果文件能够打开,它通常会弹出一个包含“修复记录”的对话框。 切记,不要直接关闭这个窗口。 点击其中的 XML 日志链接,它通常会给出一个极其关键的线索,例如:“/xl/worksheets/sheet1.xml 中的 xxx存在问题”。这短短一行字,直接将问题的搜索范围从整个文件缩小到了 sheet1.xml 的相关位置。 2.文件对比精准定位 如果修复日志语焉不详,那么“对比法”就是强有力的武器。 Bad Case:解压那个报错的原始文件。 Good Case:将 Excel 修复后成功打开的文件另存,并同样解压。 使用 Beyond Compare 或 WinMerge 等专业工具对比这两个文件夹。你会惊讶地发现,Excel 的修复逻辑通常非常简单粗暴——它要么删除了不符合 Schema 规范的 XML 标签,要么修正了错误的属性值。这种“差异”直接指向了你代码生成的逻辑漏洞。 3.手动排查 XML (常见错误点) 如果你想直接在解压后的文件中找问题,以下是第三方工具生成 Excel 时最容易出错的几个地方(按概率排名): 4.特殊字符转义 (最常见) 位置:xl/worksheets/sheet1.xml (或 sheetX.xml) 或 xl/sharedStrings.xml问题:生成的文本数据中包含了 XML 的保留字符,但没有转义。 错误:<v>A & B</v> 或 <t>1 < 2</t> 正确:<v>A & B</v> 或 <t>1 < 2</t> 检查方法:用文本编辑器打开 XML,搜索 &, <, >,看它们是否出现在数据标签内部且未被转义。 5.标签闭合与顺序 位置:xl/worksheets/sheet1.xml问题:OOXML 对标签的顺序要求非常严格(Schema 验证)。 错误:有的生成库可能会搞乱顺序,比如在 <row> 标签还没结束时就开始了下一行,或者列(Column)的定义顺序不对。 错误示例:<row r="1"> ... <c r="A1">...</row> (忘记闭合 <c> 标签)。 6.SharedStrings 索引越界 位置:xl/worksheets/sheet1.xml 和 xl/sharedStrings.xml问题:如果生成工具使用了“共享字符串”机制(Shared Strings Table)。 Worksheet 里的 <c t="s"><v>10</v></c> 表示引用 sharedStrings.xml 里的第 11 个字符串(索引从0开始)。 如果 sharedStrings.xml 里只有 5 个字符串,Excel 打开时就会立刻报错。 建议:检查报错单元格引用的索引值是否超过了 sharedStrings.xml 中 <si> 标签的总数。 7.数据类型不匹配 位置:xl/worksheets/sheet1.xml问题:在数值类型的单元格里塞入了非数值字符。 错误:没有指定类型(默认为数字),却填入了文字。 XML <c r="A1"><v>Hello</v> </c> 正确:文本应该用 t="inlineStr" 或者 t="s" (shared string)。 XML <c r="A1" t="inlineStr"><is><t>Hello</t></is></c> 8.[Content_Types].xml 缺失引用 位置:根目录下的 [Content_Types].xml问题:你在 xl/ 目录下生成了一个新的 sheet2.xml,但在 [Content_Types].xml 里没有声明它的 Content Type。Excel 会认为文件结构不完整。 推荐的排查工具 VS Code:安装 "XML Tools" 插件。打开解压后的 XML 文件,使用 "Format as XML" 功能,如果有语法错误(如标签未闭合),插件会直接报错指出行号。 Open XML SDK Productivity Tool (微软官方工具,虽然旧但极好用): 你可以把坏的 .xlsx 文件拖进去,点击 "Validate"。 它会直接告诉你:“Part /xl/worksheets/sheet1.xml, Line 10, Column 20: Schema validation failed...” 三、 实战复盘:一个“逻辑悖论”引发的崩溃 为了让大家更直观地理解,我们来看最近在项目中遇到的一个真实案例。 场景描述:业务部门需要导出一个包含数千行销售数据的报表,并要求代码自动将“首行冻结”,以便用户滚动时能始终看到表头。开发人员使用了第三方库生成文件,结果文件在 Excel 中打开报错,在SpreadJS中提示格式有问题。 1.捕获病灶 我们按照上述方法解压了损坏的文件,并查看 Excel 的修复日志,提示指向 sheet1.xml 的视图部分。打开对应的 XML 文件,我们定位到了如下代码片段: XML <sheetViews> <sheetView topLeftCell="A1" workbookViewId="0"> <pane state="frozen" ySplit="1"></pane> </sheetView> </sheetViews> 2.深度解析:渲染引擎的逻辑死锁 乍一看,这段代码似乎没什么问题:ySplit="1" 告诉 Excel 冻结第一行,topLeftCell="A1" 指定了左上角单元格。 然而,在 OOXML 的严格定义下,这里存在一个致命的逻辑悖论。 pane state="frozen" ySplit="1":这是一个强制指令,意味着第 1 行被物理锁定在窗口顶部的“冻结区”,它不再属于下方的“可滚动视口”。 topLeftCell="A1":这个属性定义的是下方可滚动区域(Scrollable Viewport)所显示的第一个单元格。 问题来了:你要求 Excel 渲染引擎将 A1 单元格“钉”在冻结区,同时又要求它在下方的滚动区以 A1 作为起始点开始渲染。这在逻辑上构成了冲突——同一个单元格不可能同时出现在两个互斥的渲染层级中。Excel 的解析器无法解决这个冲突,只能抛出异常。 3.外科手术式的修复 找到了根因,修复方案就显而易见了。我们需要告诉 Excel:既然第 1 行冻结了,那么下方滚动区域的起始行,理应是从第 2 行开始。 我们手动修改了 XML 代码: XML <sheetViews> <sheetView topLeftCell="A2" workbookViewId="0"> <pane state="frozen" ySplit="1" topLeftCell="A2" activePane="bottomLeft"></pane> </sheetView> </sheetViews> 4.重新打包的陷阱 修改完 XML 后,很多人在重新打包时会犯一个低级错误:直接右键压缩外层文件夹。这会导致压缩包内多出一层目录,Excel 无法识别。 正确的姿势是:进入解压后的文件夹内部,全选所有文件([Content_Types].xml, xl 目录等),进行压缩,并将后缀改为 .xlsx。 注:Mac 用户还需格外小心系统自动生成的 .DS_Store 隐藏文件,这些垃圾文件混入 ZIP 包后也会导致极其隐蔽的格式错误,建议使用纯净的压缩工具。 经此修复,文件成功打开,根本原因也清晰呈现,修改第三方工具中冻结逻辑即可规避此问题。 四、 避坑指南:我们踩过的 OOXML 禁区 除了上述的视图冲突,在构建高复杂度的 Excel 生成器时,还有几个高频“雷区”值得关注: 1.Schema 的顺序洁癖 OOXML 是一个对顺序(Sequence)极其敏感的标准。在 worksheets/sheet1.xml 中,<sheetViews> 标签必须出现在 <sheetData> 之前,<cols> 定义必须在 <sheetData> 之前。有些第三方工具在通过流式写入(Stream Writer)生成 XML 时,习惯最后才写入视图配置,这直接违反了 Schema 校验,导致文件损坏。 2.SharedStrings 的索引越界 如果你在单元格 <c t="s"><v>10</v></c> 中引用了索引为 10 的字符串,但 sharedStrings.xml 里总共只有 5 个词条,Excel 会直接报错退出。这通常发生在高并发写入时,字典更新与引用写入不同步的情况下。 3.特殊字符的转义问题 这是最基础但也最易犯的错。如果业务数据中包含 <、> 或 & 等字符,必须在写入 XML t 标签前进行实体转义(如转为 <)。一旦有一个字符疏忽,整个 XML 树的解析就会在那个字节处中断,导致“文件严重损坏”。 五、 总结 Excel 作为一个历经几十年的庞大系统,其底层 OOXML 标准的复杂度远超大多数人的想象。当我们在享受第三方工具带来的便利时,往往也放弃了对底层的掌控,遇到文件损坏无从下手。 掌握解包分析、XML 语义验证以及 Schema 逻辑排查的能力,能让我们从“面向运气编程”转变为“面向标准编程”。希望本文能为广大SpreadJS、GCExcel控件用户在遇到类似问题时提供启迪。 扩展链接 可嵌入您系统的在线Excel

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册