首页 文章 精选 留言 我的

精选列表

搜索[火山引擎],共10000篇文章
优秀的个人博客,低调大师

分布式搜索引擎Elasticsearch的架构分析

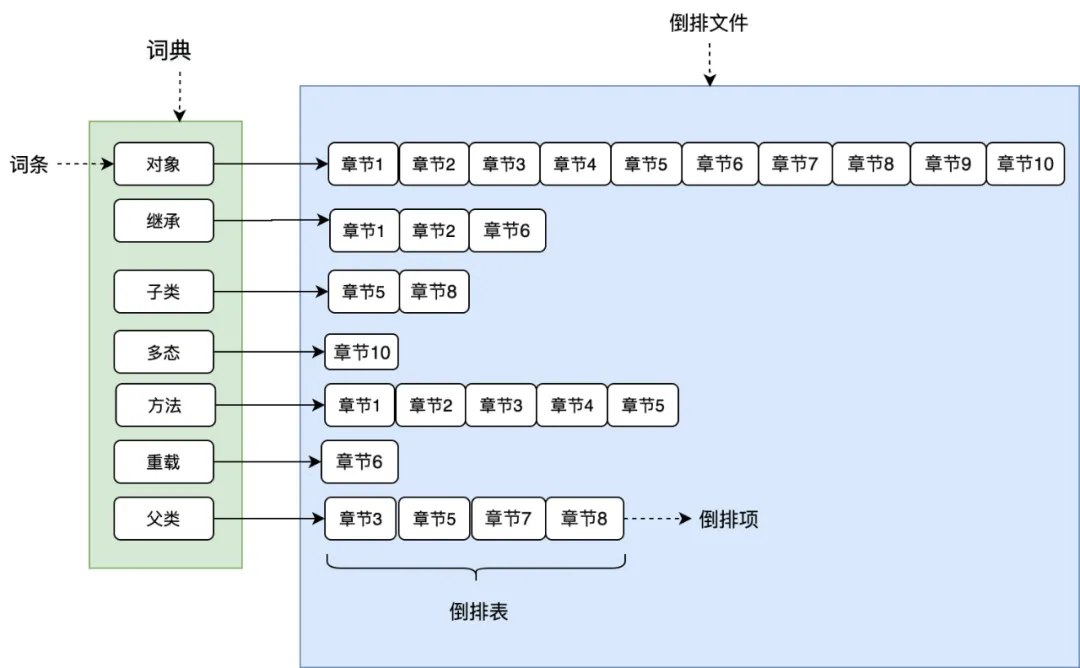
一、写在前面 ES(Elasticsearch下文统一称为ES)越来越多的企业在业务场景是使用ES存储自己的非结构化数据,例如电商业务实现商品站内搜索,数据指标分析,日志分析等,ES作为传统关系型数据库的补充,提供了关系型数据库不具备的一些能力。 ES最先进入大众视野的是其能够实现全文搜索的能力,也是由于基于Lucene的实现,内部有一种倒排索引的数据结构。 本文作者将介绍ES的分布式架构,以及ES的存储索引机制,本文不会详细介绍ES的API,会从整体架构层面进行分析,后续作者会有其他文章对ES的使用进行介绍。 二、什么是倒排索引 要讲明白什么是倒排索引,首先我们先梳理下什么索引,比如一本书,书的目录页,有章节,章节名称,我们想看哪个章节,我们通过目录页,查到对应章节和页码,就能定位到具体的章节内容,通过目录页的章节名称查到章节的页码,进而看到章节内容,这个过程就是一个索引的过程,那么什么是倒排索引呢? 比如查询《java编程思想》这本书的文章,翻开书本可以看到目录页,记录这个章节名字和章节地址页码,通过查询章节名字“继承”可以定位到“继承”这篇章节的具体地址,查看到文章的内容,我们可以看到文章内容中包含很多“对象”这个词。 那么如果我们要在这本书中查询所有包含有“对象”这个词的文章,那该怎么办呢? 按照现在的索引方式无疑大海捞针,假设我们有一个“对象”--→文章的映射关系,不就可以了吗?类似这样的反向建立映射关系的就叫倒排索引。 如图1所示,将文章进行分词后得到关键词,在根据关键词建立倒排索引,关键词构建成一个词典,词典中存放着一个个词条(关键词),每个关键词都有一个列表与其对应,这个列表就是倒排表,存放的是章节文档编号和词频等信息,倒排列表中的每个元素就是一个倒排项,最后可以看到,整个倒排索引就像一本新华字典,所有单词的倒排列表往往顺序地存储在磁盘的某个文件里,这个文件被称之为倒排文件。 (图1) 词典和倒排文件是Lucene的两种基本数据结构,但是存储方式不同,词典在内存中存储,倒排文件在磁盘上。本文不会去介绍分词,tf-idf,BM25,向量空间相似度等构建倒排索引和查询倒排索引所用到的技术,读者只需要对倒排索引有个基本的认识即可。 三、ES的集群架构 1.集群节点 一个ES集群可以有多个节点构成,一个节点就是一个ES服务实例,通过配置集群名称cluster.name加入集群。那么节点是如何通过配置相同的集群名称加入集群的呢?要搞明白这个问题,我们必须先搞清楚ES集群中节点的角色。 ES中节点有角色的区分的,通过配置文件conf/elasticsearch.yml中配置以下配置进行角色的设定。 node.master: true/false node.data: true/false 集群中单个节点既可以是候选主节点也可以是数据节点,通过上面的配置可以进行两两组合形成四大分类: (1)仅为候选主节点 (2)既是候选主节点也是数据节点 (3)仅为数据节点 (4)既不是候选主节点也不是数据节点 候选主节点:只有是候选主节点才可以参与选举投票,也只有候选主节点可以被选举为主节点。 主节点:负责索引的添加、删除,跟踪哪些节点是群集的一部分,对分片进行分配、收集集群中各节点的状态等,稳定的主节点对集群的健康是非常重要。 数据节点:负责对数据的增、删、改、查、聚合等操作,数据的查询和存储都是由数据节点负责,对机器的CPU,IO以及内存的要求比较高,一般选择高配置的机器作为数据节点。 此外还有一种节点角色叫做协调节点,其本身不是通过设置来分配的,用户的请求可以随机发往任何一个节点,并由该节点负责分发请求、收集结果等操作,而不需要主节点转发。这种节点可称之为协调节点,集群中的任何节点都可以充当协调节点的角色。每个节点之间都会保持联系。 (图2) 2.发现机制 前文说到通过设置一个集群名称,节点就可以加入集群,那么ES是如何做到这一点的呢? 这里就要讲一讲ES特殊的发现机制ZenDiscovery。 ZenDiscovery是ES的内置发现机制,提供单播和多播两种发现方式,主要职责是集群中节点的发现以及选举Master节点。 多播也叫组播,指一个节点可以向多台机器发送请求。生产环境中ES不建议使用这种方式,对于一个大规模的集群,组播会产生大量不必要的通信。 单播,当一个节点加入一个现有集群,或者组建一个新的集群时,请求发送到一台机器。当一个节点联系到单播列表中的成员时,它就会得到整个集群所有节点的状态,然后它会联系Master节点,并加入集群。 只有在同一台机器上运行的节点才会自动组成集群。ES 默认被配置为使用单播发现,单播列表不需要包含集群中的所有节点,它只是需要足够的节点,当一个新节点联系上其中一个并且通信就可以了。如果你使用 Master 候选节点作为单播列表,你只要列出三个就可以了。 这个配置在 elasticsearch.yml 文件中: discovery.zen.ping.unicast.hosts: ["host1", "host2:port"] 集群信息收集阶段采用了 Gossip 协议,上面配置的就相当于一个seed nodes,Gossip协议这里就不多做赘述了。 ES官方建议unicast.hosts配置为所有的候选主节点,ZenDiscovery 会每隔ping_interval(配置项)ping一次,每次超时时间是discovery.zen.ping_timeout(配置项),3次(ping_retries配置项)ping失败则认为节点宕机,宕机的情况下会触发failover,会进行分片重分配、复制等操作。 如果宕机的节点不是Master,则Master会更新集群的元信息,Master节点将最新的集群元信息发布出去,给其他节点,其他节点回复Ack,Master节点收到discovery.zen.minimum_master_nodes的值-1个 候选主节点的回复,则发送Apply消息给其他节点,集群状态更新完毕。如果宕机的节点是Master,则其他的候选主节点开始Master节点的选举流程。 2.1 选主 Master的选主过程中要确保只有一个master,ES通过一个参数quorum的代表多数派阈值,保证选举出的master被至少quorum个的候选主节点认可,以此来保证只有一个master。 选主的发起由候选主节点发起,当前候选主节点发现自己不是master节点,并且通过ping其他节点发现无法联系到主节点,并且包括自己在内已经有超过minimum_master_nodes个节点无法联系到主节点,那么这个时候则发起选主。 选主流程图 (图3) 选主的时候按照集群节点的参数<stateVersion, id> 排序。stateVersion从大到小排序,以便选出集群元信息较新的节点作为Master,id从小到大排序,避免在stateVersion相同时发生分票无法选出 Master。 排序后第一个节点即为Master节点。当一个候选主节点发起一次选举时,它会按照上述排序策略选出一个它认为的Master。 2.2 脑裂 提到分布式系统选主,不可避免的会提到脑裂这样一个现象,什么是脑裂呢?如果集群中选举出多个Master节点,使得数据更新时出现不一致,这种现象称之为脑裂。 简而言之集群中不同的节点对于 Master的选择出现了分歧,出现了多个Master竞争。 一般而言脑裂问题可能有以下几个原因造成: 网络问题:集群间的网络延迟导致一些节点访问不到Master,认为Master 挂掉了,而master其实并没有宕机,而选举出了新的Master,并对Master上的分片和副本标红,分配新的主分片。 节点负载:主节点的角色既为Master又为Data,访问量较大时可能会导致 ES 停止响应(假死状态)造成大面积延迟,此时其他节点得不到主节点的响应认为主节点挂掉了,会重新选取主节点。 内存回收:主节点的角色既为Master又为Data,当Data节点上的ES进程占用的内存较大,引发JVM的大规模内存回收,造成ES进程失去响应。 如何避免脑裂:我们可以基于上述原因,做出优化措施: 适当调大响应超时时间,减少误判。通过参数 discovery.zen.ping_timeout 设置节点ping超时时间,默认为 3s,可以适当调大。 选举触发,我们需要在候选节点的配置文件中设置参数 discovery.zen.munimum_master_nodes 的值。这个参数表示在选举主节点时需要参与选举的候选主节点的节点数,默认值是 1,官方建议取值(master_eligibel_nodes/2)+1,其中 master_eligibel_nodes 为候选主节点的个数。这样做既能防止脑裂现象的发生,也能最大限度地提升集群的高可用性,因为只要不少于 discovery.zen.munimum_master_nodes 个候选节点存活,选举工作就能正常进行。当小于这个值的时候,无法触发选举行为,集群无法使用,不会造成分片混乱的情况。 角色分离,即是上面我们提到的候选主节点和数据节点进行角色分离,这样可以减轻主节点的负担,防止主节点的假死状态发生,减少对主节点宕机的误判。 四、索引如何写入的 1. 写索引原理 1.1 分片 ES支持PB级全文搜索,通常我们数据量很大的时候,查询性能都会越来越慢,我们能想到的一个方式的将数据分散到不同的地方存储,ES也是如此,ES通过水平拆分的方式将一个索引上的数据拆分出来分配到不同的数据块上,拆分出来的数据库块称之为一个分片Shard,很像MySQL的分库分表。 不同的主分片分布在不同的节点上,那么在多分片的索引中数据应该被写入哪里?肯定不能随机写,否则查询的时候就无法快速检索到对应的数据了,这需要有一个路由策略来确定具体写入哪一个分片中,怎么路由我们下文会介绍。在创建索引的时候需要指定分片的数量,并且分片的数量一旦确定就不能修改。 1.2 副本 副本就是对分片的复制,每个主分片都有一个或多个副本分片,当主分片异常时,副本可以提供数据的查询等操作。主分片和对应的副本分片是不会在同一个节点上的,避免数据的丢失,当一个节点宕机的时候,还可以通过副本查询到数据,副本分片数的最大值是 N-1(其中 N 为节点数)。 对doc的新建、索引和删除请求都是写操作,这些写操作是必须在主分片上完成,然后才能被复制到对应的副本上。ES为了提高写入的能力这个过程是并发写的,同时为了解决并发写的过程中数据冲突的问题,ES通过乐观锁的方式控制,每个文档都有一个 _version号,当文档被修改时版本号递增。 一旦所有的副本分片都报告写成功才会向协调节点报告成功,协调节点向客户端报告成功。 (图4) 1.3 Elasticsearch 的写索引流程 上面提到了写索引是只能写在主分片上,然后同步到副本分片,那么如图4所示,这里有四个主分片分别是S0、S1、S2、S3,一条数据是根据什么策略写到指定的分片上呢?这条索引数据为什么被写到S0上而不写到 S1 或 S2 上?这个过程是根据下面这个公式决定的。 shard = hash(routing) % number_of_primary_shards 以上公式的值是在0到number_of_primary_shards-1之间的余数,也就是数据档所在分片的位置。routing通过Hash函数生成一个数字,然后这个数字再除以number_of_primary_shards(主分片的数量)后得到余数。routing是一个可变值,默认是文档的_id ,也可以设置成一个自定义的值。 在一个写请求被发送到某个节点后,该节点按照前文所述,会充当协调节点,会根据路由公式计算出写哪个分片,当前节点有所有其他节点的分片信息,如果发现对应的分片是在其他节点上,再将请求转发到该分片的主分片节点上。 在ES集群中每个节点都通过上面的公式知道数据的在集群中的存放位置,所以每个节点都有接收读写请求的能力。 那么为什么在创建索引的时候就确定好主分片的数量,并且不可修改?因为如果数量变化了,那么所有之前路由计算的值都会无效,数据也就再也找不到了。 (图5) 如上图5所示,当前一个数据通过路由计算公式得到的值是 shard=hash(routing)%4=0,则具体流程如下: (1)数据写请求发送到 node1 节点,通过路由计算得到值为1,那么对应的数据会应该在主分片S1上。 (2)node1节点将请求转发到 S1 主分片所在的节点node2,node2 接受请求并写入到磁盘。 (3)并发将数据复制到三个副本分片R1上,其中通过乐观并发控制数据的冲突。一旦所有的副本分片都报告成功,则节点 node2将向node1节点报告成功,然后node1节点向客户端报告成功。 这种模式下,只要有副本在,写入延时最小也是两次单分片的写入耗时总和,效率会较低,但是这样的好处也很明显,避免写入后单个机器硬件故障导致数据丢失,在数据完整性和性能方面,一般都是优先选择数据,除非一些允许丢数据的特殊场景。 在ES里为了减少磁盘IO保证读写性能,一般是每隔一段时间(比如30分钟)才会把数据写入磁盘持久化,对于写入内存,但还未flush到磁盘的数据,如果发生机器宕机或者掉电,那么内存中的数据也会丢失,这时候如何保证? 对于这种问题,ES借鉴数据库中的处理方式,增加CommitLog模块,在ES中叫transLog,在下面的ES存储原理中会介绍。 2. 存储原理 上面介绍了在ES内部的写索引处理流程,数据在写入到分片和副本上后,目前数据在内存中,要确保数据在断电后不丢失,还需要持久化到磁盘上。 我们知道ES是基于Lucene实现的,内部是通过Lucene完成的索引的创建写入和搜索查询,Lucene 工作原理如下图所示,当新添加一片文档时,Lucene进行分词等预处理,然后将文档索引写入内存中,并将本次操作写入事务日志(transLog),transLog类似于mysql的binlog,用于宕机后内存数据的恢复,保存未持久化数据的操作日志。 默认情况下,Lucene每隔1s(refresh_interval配置项)将内存中的数据刷新到文件系统缓存中,称为一个segment(段)。一旦刷入文件系统缓存,segment才可以被用于检索,在这之前是无法被检索的。 因此refresh_interval决定了ES数据的实时性,因此说ES是一个准实时的系统。segment 在磁盘中是不可修改的,因此避免了磁盘的随机写,所有的随机写都在内存中进行。随着时间的推移,segment越来越多,默认情况下,Lucene每隔30min或segment 空间大于512M,将缓存中的segment持久化落盘,称为一个commit point,此时删掉对应的transLog。 当我们在进行写操作的测试的时候,可以通过手动刷新来保障数据能够被及时检索到,但是不要在生产环境下每次索引一个文档都去手动刷新,刷新操作会有一定的性能开销。一般业务场景中并不都需要每秒刷新。 可以通过在 Settings 中调大 refresh_interval = "30s" 的值,来降低每个索引的刷新频率,设值时需要注意后面带上时间单位,否则默认是毫秒。当 refresh_interval=-1 时表示关闭索引的自动刷新。 (图6) 索引文件分段存储并且不可修改,那么新增、更新和删除如何处理呢? 新增,新增很好处理,由于数据是新的,所以只需要对当前文档新增一个段就可以了。 删除,由于不可修改,所以对于删除操作,不会把文档从旧的段中移除而是通过新增一个 .del 文件,文件中会列出这些被删除文档的段信息,这个被标记删除的文档仍然可以被查询匹配到, 但它会在最终结果被返回前从结果集中移除。 更新,不能修改旧的段来进行文档的更新,其实更新相当于是删除和新增这两个动作组成。会将旧的文档在 .del 文件中标记删除,然后文档的新版本中被索引到一个新的段。可能两个版本的文档都会被一个查询匹配到,但被删除的那个旧版本文档在结果集返回前就会被移除。 segment被设定为不可修改具有一定的优势也有一定的缺点。 优点: 不需要锁。如果你从来不更新索引,你就不需要担心多进程同时修改数据的问题。 一旦索引被读入内核的文件系统缓存,便会留在哪里,由于其不变性。只要文件系统缓存中还有足够的空间,那么大部分读请求会直接请求内存,而不会命中磁盘。这提供了很大的性能提升. 其它缓存(像 Filter 缓存),在索引的生命周期内始终有效。它们不需要在每次数据改变时被重建,因为数据不会变化。 写入单个大的倒排索引允许数据被压缩,减少磁盘 I/O 和需要被缓存到内存的索引的使用量。 缺点: 当对旧数据进行删除时,旧数据不会马上被删除,而是在 .del 文件中被标记为删除。而旧数据只能等到段更新时才能被移除,这样会造成大量的空间浪费。 若有一条数据频繁的更新,每次更新都是新增新的,标记旧的,则会有大量的空间浪费。 每次新增数据时都需要新增一个段来存储数据。当段的数量太多时,对服务器的资源例如文件句柄的消耗会非常大。 在查询的结果中包含所有的结果集,需要排除被标记删除的旧数据,这增加了查询的负担。 2.1 段合并 由于每当刷新一次就会新建一个segment(段),这样会导致短时间内的段数量暴增,而segment数目太多会带来较大的麻烦。大量的segment会影响数据的读性能。每一个segment都会消耗文件句柄、内存和CPU 运行周期。 更重要的是,每个搜索请求都必须轮流检查每个segment然后合并查询结果,所以segment越多,搜索也就越慢。 因此Lucene会按照一定的策略将segment合并,合并的时候会将那些旧的已删除文档从文件系统中清除。被删除的文档不会被拷贝到新的大segment中。 合并的过程中不会中断索引和搜索,倒排索引的数据结构使得文件的合并是比较容易的。 段合并在进行索引和搜索时会自动进行,合并进程选择一小部分大小相似的段,并且在后台将它们合并到更大的段中,这些段既可以是未提交的也可以是已提交的。 合并结束后老的段会被删除,新的段被刷新到磁盘,同时写入一个包含新段且排除旧的和较小的段的新提交点,新的段被打开,可以用来搜索。段合并的计算量庞大,而且还要吃掉大量磁盘 I/O,并且段合并会拖累写入速率,如果任其发展会影响搜索性能。 ES在默认情况下会对合并流程进行资源限制,所以搜索性能可以得到保证。 (图7) 五、写在最后 作者对ES的架构原理和索引存储和写机制进行介绍,ES的整体架构体系相对比较巧妙,我们在进行系统设计的时候可以借鉴其设计思路,本文只介绍ES整体架构部分,更多的内容,后续作者会在其他文章中继续分享。 作者:vivo官网商城开发团队

优秀的个人博客,低调大师

数据源管理 | OLAP查询引擎,ClickHouse集群化管理

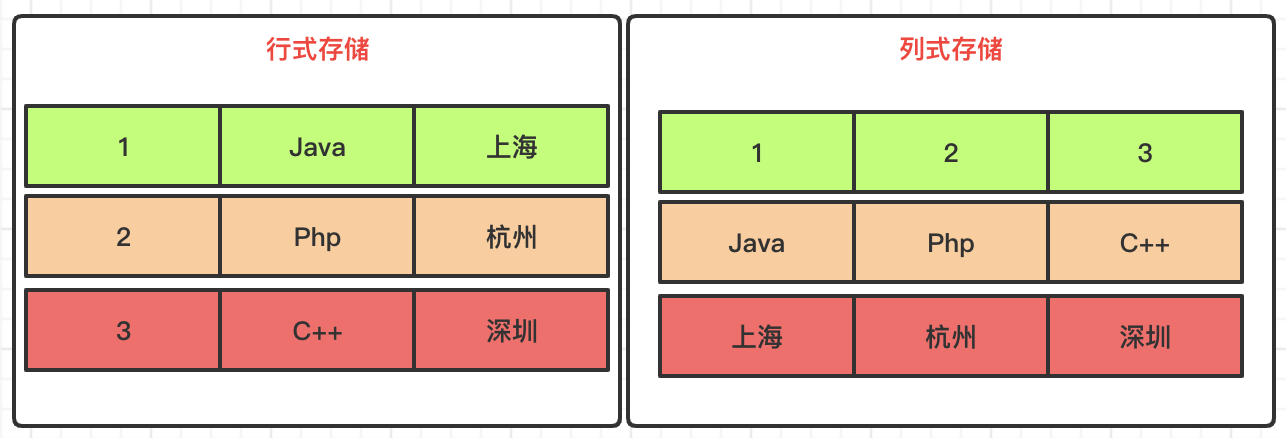
本文源码:GitHub·点这里 || GitEE·点这里 一、列式库简介 ClickHouse是俄罗斯的Yandex公司于2016年开源的列式存储数据库(DBMS),主要用于OLAP在线分析处理查询,能够使用SQL查询实时生成分析数据报告。 列式存储 行式存储和列式存储,数据在磁盘上的组织结构有着根本不同,数据分析计算时,行式存储需要遍历整表,列式存储只需要遍历单个列,所以列式库更适合做大宽表,用来做数据分析计算。 絮叨一句:注意这里比较的场景,是数据分析计算的场景。 二、集群配置 1、基础环境 ClickHouse单服务默认已经安装完毕 Linux下安装ClickHouse单机服务 SpringBoot整合ClickHouse列式数据库 2、取消文件限制 vim /etc/security/limits.conf vim /etc/security/limits.d/90-nproc.conf 文件末尾追加 * soft nofile 65536 * hard nofile 65536 * soft nproc 131072 * hard nproc 131072 3、取消SELINUX 修改/etc/selinux/config中的SELINUX=disabled后重启 4、集群配置文件 服务分别添加集群配置:vim /etc/metrika.xml <yandex> <clickhouse_remote_servers> <clickhouse_cluster> <shard> <internal_replication>true</internal_replication> <replica> <host>192.168.72.133</host> <port>9000</port> </replica> </shard> <shard> <replica> <internal_replication>true</internal_replication> <host>192.168.72.136</host> <port>9000</port> </replica> </shard> <shard> <internal_replication>true</internal_replication> <replica> <host>192.168.72.137</host> <port>9000</port> </replica> </shard> </clickhouse_cluster> </clickhouse_remote_servers> <zookeeper-servers> <node index="1"> <host>192.168.72.133</host> <port>2181</port> </node> <node index="2"> <host>192.168.72.136</host> <port>2181</port> </node> <node index="3"> <host>192.168.72.137</host> <port>2181</port> </node> </zookeeper-servers> <macros> <replica>192.168.72.133</replica> </macros> <networks> <ip>::/0</ip> </networks> <clickhouse_compression> <case> <min_part_size>10000000000</min_part_size> <min_part_size_ratio>0.01</min_part_size_ratio> <method>lz4</method> </case> </clickhouse_compression> </yandex> 注意这里 <macros> <replica>192.168.72.133</replica> </macros> 配置各自服务的IP地址。 5、启动集群 分别启动三台服务 service clickhouse-server start 6、登录客户端查看 这里登录任意一台服务就好 clickhouse-client en-master :) select * from system.clusters 这里这里集群名称:clickhouse_cluster,后续使用。 7、基本环境测试 三台服务上同时创建表结构。 CREATE TABLE ontime_local (FlightDate Date,Year UInt16) ENGINE = MergeTree(FlightDate, (Year, FlightDate), 8192); 133环境创建分布表 CREATE TABLE ontime_all AS ontime_local ENGINE = Distributed(clickhouse_cluster, default, ontime_local, rand()); 随便写入一台服务数据 insert into ontime_local (FlightDate,Year) values ('2020-03-12',2020); 查询总表 select * from ontime_all; 写入总表,数据会分布到各个单表中 insert into ontime_all (FlightDate,Year)values('2001-10-12',2001); insert into ontime_all (FlightDate,Year)values('2002-10-12',2002); insert into ontime_all (FlightDate,Year)values('2003-10-12',2003); 任意关闭一台服务,集群查询直接挂掉 三、集群环境整合 1、基础配置 url:配置全部的服务列表,主要用来管理表结构,批量处理; cluster:集群连接服务,可以基于Nginx代理服务配置; spring: datasource: type: com.alibaba.druid.pool.DruidDataSource click: driverClassName: ru.yandex.clickhouse.ClickHouseDriver url: jdbc:clickhouse://127.0.0.1:8123/default,jdbc:clickhouse://127.0.0.1:8123/default,jdbc:clickhouse://127.0.0.1:8123/default cluster: jdbc:clickhouse://127.0.0.1:8123/default initialSize: 10 maxActive: 100 minIdle: 10 maxWait: 6000 2、管理接口 分别向每个单节点服务创建表和写入数据: data_shard(单节点数据) data_all(分布数据) @RestController public class DataShardWeb { @Resource private JdbcFactory jdbcFactory ; /** * 基础表结构创建 */ @GetMapping("/createTable") public String createTable (){ List<JdbcTemplate> jdbcTemplateList = jdbcFactory.getJdbcList(); for (JdbcTemplate jdbcTemplate:jdbcTemplateList){ jdbcTemplate.execute("CREATE TABLE data_shard (FlightDate Date,Year UInt16) ENGINE = MergeTree(FlightDate, (Year, FlightDate), 8192)"); jdbcTemplate.execute("CREATE TABLE data_all AS data_shard ENGINE = Distributed(clickhouse_cluster, default, data_shard, rand())"); } return "success" ; } /** * 节点表写入数据 */ @GetMapping("/insertData") public String insertData (){ List<JdbcTemplate> jdbcTemplateList = jdbcFactory.getJdbcList(); for (JdbcTemplate jdbcTemplate:jdbcTemplateList){ jdbcTemplate.execute("insert into data_shard (FlightDate,Year) values ('2020-04-12',2020)"); } return "success" ; } } 3、集群查询 上述步骤执行完成后,可以连接集群服务查询分布总表和单表的数据。 基于Druid连接 @Configuration public class DruidConfig { @Resource private JdbcParamConfig jdbcParamConfig ; @Bean public DataSource dataSource() { DruidDataSource datasource = new DruidDataSource(); datasource.setUrl(jdbcParamConfig.getCluster()); datasource.setDriverClassName(jdbcParamConfig.getDriverClassName()); datasource.setInitialSize(jdbcParamConfig.getInitialSize()); datasource.setMinIdle(jdbcParamConfig.getMinIdle()); datasource.setMaxActive(jdbcParamConfig.getMaxActive()); datasource.setMaxWait(jdbcParamConfig.getMaxWait()); return datasource; } } 基于mapper查询 <mapper namespace="com.ckhouse.cluster.mapper.DataAllMapper"> <resultMap id="BaseResultMap" type="com.ckhouse.cluster.entity.DataAllEntity"> <result column="FlightDate" jdbcType="VARCHAR" property="flightDate" /> <result column="Year" jdbcType="INTEGER" property="year" /> </resultMap> <select id="getList" resultMap="BaseResultMap" > select * from data_all where Year=2020 </select> </mapper> 四、源代码地址 GitHub·地址 https://github.com/cicadasmile/data-manage-parent GitEE·地址 https://gitee.com/cicadasmile/data-manage-parent


优秀的个人博客,低调大师

向量搜索引擎 Milvus 发布新版本 0.7.0

版本兼容 新增功能 向量删除 新增了对单条或多条向量的删除功能。如果您对一个集合进行了向量删除操作,后续对这个集合的搜索操作仅支持一部分索引类型,包括在CPU上运行的 Flat、IVFlat、IVFSQ8 等。Milvus 的后续版本将为其他索引类型提供支持。#86 向量读取 新增了通过向量 ID 读取对应的向量值的功能。#861 数据落盘与压缩 新增了数据落盘与压缩功能。您可以设置定时落盘或者手动落盘,从而避免数据丢失。如果一个段中的向量数据被删除,被删除的向量数据占据的空间并不会自动释放。您可以对集合中的段进行压缩操作以释放多余空间。#861#1426 运行时更改 Milvus 服务端参数 新增了运行时更改 Milvus 服务端参数的功能。您可以通过 Milvus 客户端对 Milvus 服务端参数进行更改,部分参数更改后可即时生效,无需重启 Milvus。#665 预写式日志(Write-Ahead Logging, WAL) 新增了 WAL 功能,可以大大提高数据操作的可靠性。您可以在 Milvus 服务端配置文件(server_config.yaml)中对 WAL 进行设置。#830 RESTful API 新增了 RESTful API。详细信息请参考RESTful API Readme。 Go SDK 新增了 Go SDK,详细信息请参考https://github.com/milvus-io/milvus-sdk-go。 HNSW 索引的支持 新增了对 HNSW 索引类型的支持。关于 HNSW 的详细介绍请参考向量索引算法 HNSW 和 NSG 的比较。#853 Jaccard/Hamming/Tanimoto 距离的支持 新增了对 Jaccard、Hamming、Tanimoto 距离的支持。#823 Prometheus 中 Pushgateway 的支持 新增了在 Prometheus 中 Pushgateway 的支持。Pushgateway 使生命周期短、批量的 metric 能够被 Prometheus 提取。#813 AVX 512 指令集的支持 新增了对 AVX 512 指令集的支持。Milvus 理论上可支持所有包含 AVX 512 指令集的 CPU。#1122 变更说明 创建索引与搜索的接口更新 从 Milvus 0.7.0开始,所有客户端创建索引与搜索的接口中的部分参数使用 JSON 字符串进行传值。 Milvus 服务端配置文件更新 从 Milvus 0.7.0开始,Milvus 服务端配置文件(server_config.yaml)版本更新为0.2。配置文件的参数也发生了变化。 术语更新 从0.7.0开始,Milvus 的 Table(表) 正式改名为 Collection(集合)。 Bug 修复 解决了插入向量时使用自动生成的ID 时可能产生重复ID的问题。#1508 对新版本有问题吗?下周二(3.17.2020)晚上八点的线上问答将进行 v.0.7.0 相关专题, 有任何问题或是建议都可以来与我们聊聊!

优秀的个人博客,低调大师

DataGrip 2019.3 EAP 4 发布,多引擎数据库环境

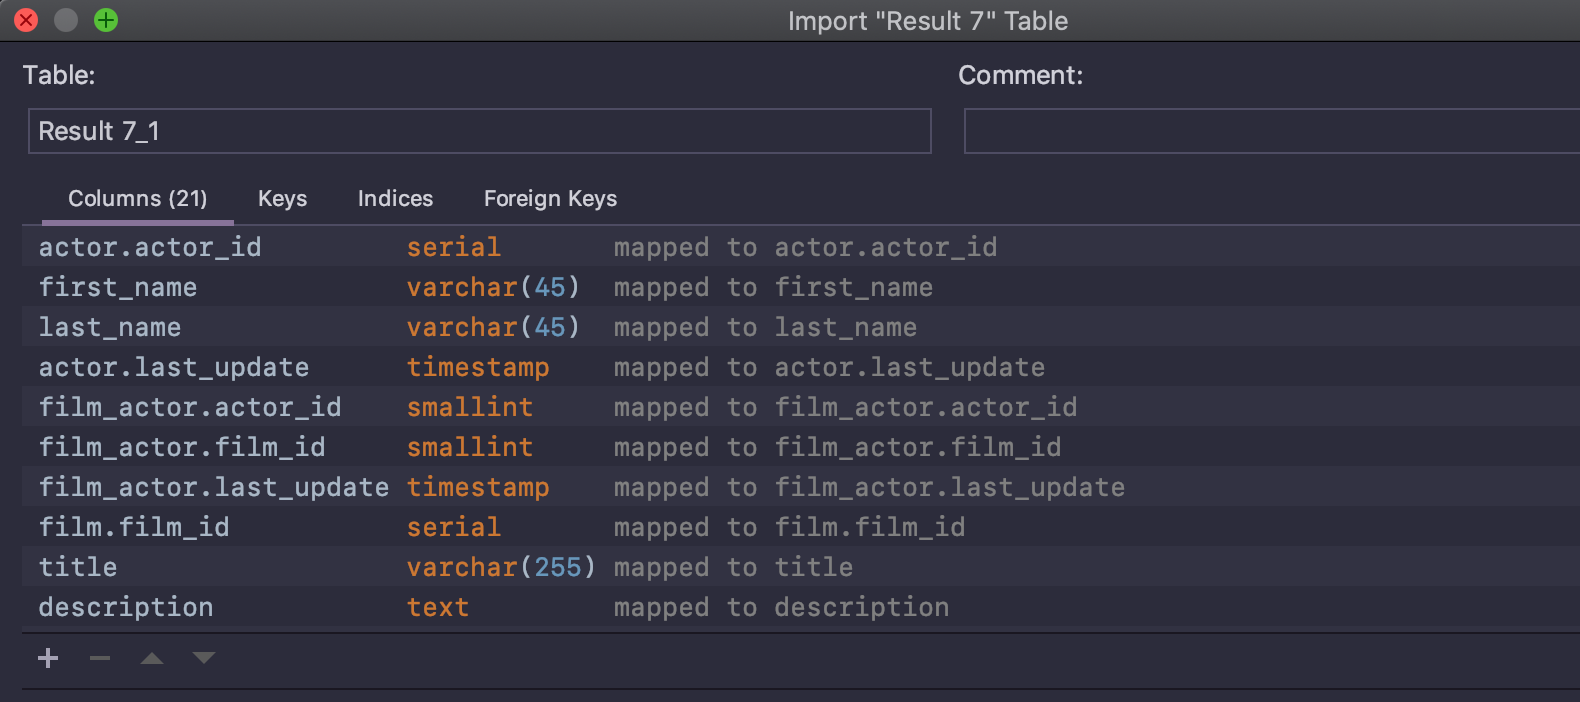
DataGrip 2019.3 的第四个早期访问计划发布了,主要更新内容如下: DBE-7976:现在可以从数据编辑器上下文中使用“修改表”操作,如果要在编辑表数据时添加新列,只需按 Ctr/Cmd+F6 继续。 DBE-9336: Intentions 现在在例程的源代码中起作用。例如,如果要通过星号上的 Alt+Enter 扩展通配符,现在就可以这样做。 DBE-9548:现在,如果结果集包含具有相同名称的多个列,那么从中创建表就不会对歧义名称造成任何问题。 DBE-9428:引入了新的意图,以帮助将 JOIN ON 转换为 JOIN USING,反之亦然。 发布公告: https://blog.jetbrains.com/datagrip/2019/11/15/datagrip-2019-3-eap-4/

优秀的个人博客,低调大师

JavaScript 引擎 V8 Lite Mode 改造 V8

去年年底,V8 团队启动了一个名为 V8 Lite 的项目,旨在大幅降低 V8 的内存使用率。最开始,团队准备把 V8 Lite 作为 V8 的独立模式,专门用于低内存的移动设备与嵌入式设备,因为这些设备更关注的是减少内存使用而不是执行速度。 在这个项目研发的过程中,开发团队发现专门为这个 Lite 模式所做的内存优化其实也可以迁移到原来的V8 上,直接两开花。V8 团队近日发表了一个文章,就详细分享了在构建 V8 Lite 的过程中将一些关键的优化部分带到现有 V8 上的过程,以及在实际工作负载中对 V8 性能表现的影响。下边简要介绍一下。 Lite Mode 分析了 V8 如何使用内存以及哪些对象类型占 V8 堆大小的比例很大之后,V8 团队发现,V8 堆的很大一部分专门用于对 JavaScript 执行来说不必要的对象,比如用于优化 JavaScript 执行和处理异常情况。具体来说比如优化代码;用于确定如何优化代码的类型反馈;用于 C++ 和 JavaScript 对象之间绑定的冗余元数据等。 所以团队从这一点入手,想通过大幅减少这些可选对象的内存分配来提高内存使用。同时团队提出了 V8 的 Lite Mode。 通过配置现有的 V8 设置可以直接应用一些 Lite Mode 的优化,例如禁用 V8 的 TurboFan 优化编译器,但是现有 V8 想支持其它 Lite Mode 优化则需要更多的考虑。 比如在 Ignition 解释器中执行代码时,V8 收集有关传递给各种操作(例如,+和o.foo)的操作数类型的反馈,以便为以后的优化定制这些类型。此信息存储在反馈向量中,这些向量占 V8 堆内存使用量的很大一部分。Lite Mode 不优化代码,所以可以直接不去分配这些反馈向量,但是 V8 的内联缓存基础结构的解释器期望反馈向量可用,因此需要相当多的重构才能支持 Lite Mode 这种无反馈执行。 Lite Mode 在 V8 v7.3 中推出,与 V8 v7.1 相比,通过禁用代码优化、不分配反馈向量并执行很少执行的字节码老化,典型网页堆大小减少 22%。 同时在这个过程中,团队还发现,可以通过使 V8 更加“Lazy”来实现 Lite Mode 的大部分内存节省,而不会影响性能。 Lazy feedback allocation 完全禁用反馈向量分配不仅会阻止 V8 的 TurboFan 编译器优化代码,还会阻止 V8 执行常见操作的内联缓存,例如 Ignition 解释器中的对象属性加载。因此,这样做会导致 V8 的执行时间显著回退,页面加载时间减少 12%,典型交互式网页方案中 V8 使用的 CPU 时间增加 120%。 为了在没有这些回退的情况下将大部分内存节省带到常规 V8 中,开发团队设计了在函数执行了一定量的字节码(目前为 1KB)之后,延迟分配反馈向量。由于大多数函数不经常执行,因此在大多数情况下避免使用反馈向量分配,但会在需要的地方快速分配它们以避免性能回退,并仍然允许优化代码。 使用这种方法,会产生另一个问题。反馈向量会形成树结构,内部函数的反馈向量被保留为外部函数的反馈向量中的条目。这是必要的,以便新创建的函数闭包接收与为同一函数创建的所有其它闭包相同的反馈向量数组。在延迟分配反馈向量的情况下,无法使用反馈向量来形成这棵树,因为无法保证外部函数会在内部函数分配其反馈向量之前就对其进行分配。 如下图,为了解决这个问题,开发团队创建了一个新的 ClosureFeedbackCellArray 来维护这个树,当一个函数的 ClosureFeedbackCellArray 变为Hot 时将其与一个完整的 FeedbackVector 交换掉。 实验显示桌面延迟反馈没有出现性能回退,而在移动端,由于垃圾回收减少,性能有所提升,因此 V8 所有版本中都启用了延迟反馈分配。 Lazy source positions 从 JavaScript 编译字节码时,会生成源位置表,将字节码序列绑定到 JavaScript 源代码中的字符位置。但是,仅在表示异常或执行开发人员任务(如调试)时才需要此信息,因此很少使用。 为了避免这种浪费,现在编译字节码而不收集源位置(假设没有附加调试器或分析器)。仅在实际生成堆栈跟踪时收集源位置,例如在调用 Error.stack 或将异常的堆栈跟踪打印到控制台时。这需要一些成本,因为生成源位置需要重新分析和编译函数,但是大多数网站不会在生产中对堆栈跟踪进行符号化,因此不会看到什么性能影响。 Bytecode flushing 从 JavaScript 源编译的字节码,包括相关的元数据占用了大量的 V8 堆空间,通常约为 15%。但是有许多函数只在初始化期间执行,或者在编译后很少使用。所以,V8 针对最近没有执行的情况,添加了在垃圾回收期间支持从函数中刷新已编译字节码的功能。 具体机制是,跟踪函数字节码的 age,每次主要(mark-compact)垃圾回收 age 都递增,并在执行函数时将其重置为零。任何超过老化阈值的字节码都可以被下一次垃圾回收回收,如果它被回收然后再次执行,则会重新编译。 这么设计的难点在于确保字节码仅在不再需要的情况下才可以被刷新。例如,如果函数 A 调用另一个长时间运行的函数 B,函数 A 可能会在它仍然在堆栈上时老化。这时候我们并不想刷新函数 A 的字节码,即使它达到了老化阈值,因为还需要在长时间运行的函数 B 返回时返回它。 解决这个问题的方法是,当字节码达到其老化阈值时,将字节码视为弱保持状态(weakly held),但是在堆栈或其它地方对字节码的任何引用将强烈保持(strongly held),并且只在没有强链接的情况下才可以刷新代码。 除了刷新字节码,同时还刷新与这些刷新函数相关的反馈向量。但是,无法在与字节码相同的 GC 周期内刷新反馈向量,因为它们不会被同一对象保留。字节码由本地上下文独立的 SharedFunctionInfo 保留,而反馈向量由本地上下文相关的JSFunction 保留。因此,会在随后的 GC 循环中刷新反馈向量。 Additional optimizations 此外开发团队还通过减小 FunctionTemplateInfo 对象的大小和对TurboFan 优化代码进行去优化等方面的优化减少了内存使用。 Results 目前已经在 V8 的最新七个版本中发布了上述优化,通常它们会先应用在 Lite Mode 中,然后再进入 V8 的默认配置。 经过测试,在一系列典型网站上将 V8 堆大小平均减少了 18%,相当于低端 AndroidGo 移动设备平均减少 1.5 MB。 通过禁用功能优化,Lite Mode 可以以一定的开销进一步为 JavaScript 执行吞吐量提供内存节省。平均而言,Lite Mode 可节省 22% 的内存,有些页面可节省高达 32% 的内存。这相当于 AndroidGo 设备上 V8 堆大小减少了 1.8 MB。 具体分析每一种优化技术带来的影响,结果如下: 完整优化介绍查看原博客: https://v8.dev/blog/v8-lite

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册