24 天,630 次提交,16 万行代码:我用 Claude Code 从零做了一个 K12 产品
 先把数字摆出来,因为它决定了这篇文章值不值得读下去。 项 | 数值 开发周期 | 24 天(首次提交到最后一次提交) 提交次数 | 630 代码量 | 163,896 行(Python 66,915 / TSX 32,998 / TS 6,345 / CSS 5,780) 文件数 | 540 测试文件 | 53 单日提交峰值 | 117 产品是一个 K12 自学工具:按课标知识点组织内容,每个知识点配教研选定的讲解视频,学完当场能测,错题按遗忘曲线自动排期。学生端、家长端、教师端、管理后台四套界面,外加一条内容采集与审核的流水线。 我不是全职写了 24 天。中间有五六天完全没碰,真正投入的大概是 14 个工作日。 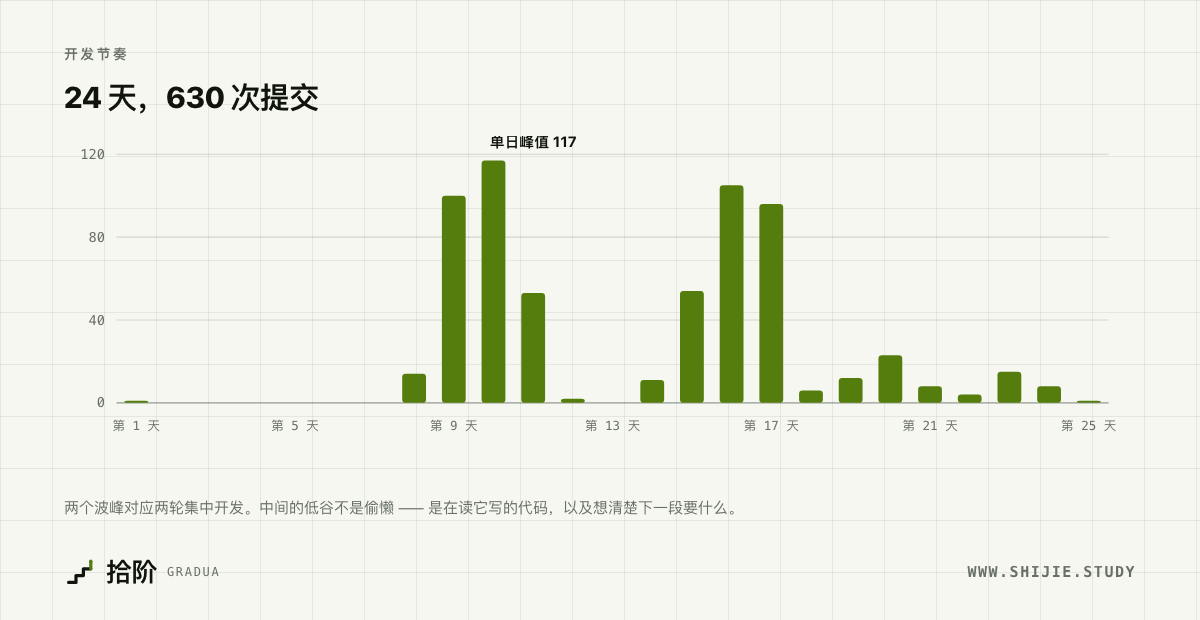 这篇不讲「AI 让你效率提升十倍」这种话。讲的是**我怎么提需求、怎么发现它写错了、以及哪些事它做不了**。 --- ## 一、最有效的需求,长得不像需求文档 翻我自己的提示记录,效果最好的那些是这样写的: > 数据库的配置信息在 `backend/.env` 的 `DATABASE_URL`。 根据数据库里的知识点,给每个知识点生成评测题目,要求: > 1. 每个知识点都要生成题目保存到数据库,包括选择题、解答题,要有题目、答案、难度等级,每个知识点不少于 30 题 > 2. 学生学完该知识点后,随机出 5–10 题做评测,覆盖不同难度。要保存答题记录和得分,选择题自动算分,解答题调用大模型评分 > 3. **关于题库和答案,如果还有我没想到的需求,请你补充并实现** 这段话里有三样东西,缺一样效果就差很多。 **一是入口。** 「配置信息在 `backend/.env` 的 `DATABASE_URL`」——它不用猜,也不用问我。省掉的不是一次对话,是一次可能猜错的分支。 **二是验收标准。** 「不少于 30 题」「覆盖不同难度」「选择题自动算分」是可以被检查的。写「题库要丰富」它也能做,但做成什么样全看运气。 **三是最后那一句。** 「如果还有我没想到的需求,请你补充并实现」——这一句的回报远超预期。它补出来的东西里,有一个我确实没想到:**题目的难度分布不能是均匀的**,随堂测评要按知识点的掌握情况调整难度构成。这是教研常识,但我在写需求的时候没想起来。 相比之下,我写得最差的需求长这样:「把题库模块做完善一点」。这种需求得到的结果通常是:它做了一堆事,每件都不深,然后我要花半小时读懂它做了什么。 **一个经验法则:如果你自己都说不出「做完了怎么验收」,那就先别提。** 想清楚验收标准这件事,比描述功能重要得多。 --- ## 二、报 bug 要给路径,不要给感受 这是我从一开始就做对的事情,回头看省了很多时间。 我的 bug 记录长这样: > **bug 1:** `console/kp` 这个列表里能看到知识点下面有题库,但是点击题库进入题库页面却看不到题目 `console/kp/eb7849c2-70c7-4d08-a5de-b91ed5d9bdc9/questions` 这个筛选下没有题目 > **bug 2:** `console/kp/eb7849c2-70c7-4d08-a5de-b91ed5d9bdc9/edit` 编辑某个知识点后,没法回退到之前选择好的知识点列表页,只能回到初始状态的列表页 `console/kp`,然后重新选择条件 注意两个细节:**带了具体的 URL,也带了具体的 UUID。** 这意味着它可以直接去查那条数据、直接去看那个路由的代码,而不是先问我「你是在哪个页面遇到的」。一次往返省下来的时间,比我打那串 UUID 的时间多得多。 反例是我偶尔犯的懒:「题库页面有问题」。这种报法的结果是它去通读整个模块,然后修了三个它认为可能有问题的地方——其中两个不是我遇到的那个。 --- ## 三、约定必须写进代码,因为约定不会报错 这是整个项目里我觉得最值钱的一条经验。 掌握度这个字段,我们定的是 **0–100 的百分数**,不是 0–1 的比率。这个约定如果被破坏,会发生什么? **什么都不会发生。** 不报错、不崩溃、类型检查也过。只是满分的学生会显示成「1%」,然后被后继知识点的解锁判定当成没学过。 所以这段约定被写进了代码: ```python """掌握度、错题本、学习状态的回写。 ⭐ 掌握度是 0–100 的百分数,不是 0–1 的比率。 这不是随便定的:kp_view_service.MASTERY_UNLOCK_THRESHOLD = 70.0 拿它做 后继知识点的解锁判定,学生端把它当百分比渲染。写成 0–1 不会报错, 只会让满分的学生显示成「1%」并被判定为没学过 —— 这类错误没有任何报错 信号,只能靠约定守住。 """ ``` **没有报错信号的错误,只能靠注释守住。** 这句话对人和对 AI 是一样的——半个月后我自己回来改这个文件,也会忘。 这带出一个更普遍的做法:**注释写「为什么」,不写「是什么」。** ```python #: 难度权重。难题答对更能说明问题,答错也更该扣。 DIFFICULTY_WEIGHT = {1: 0.6, 2: 0.8, 3: 1.0, 4: 1.3, 5: 1.6} #: 近因半衰期(天)。30 天前的作答只算半份权重。 RECENCY_HALF_LIFE_DAYS = 30.0 #: 连续答对几次算订正完成,移出错题本。 MISTAKE_CLEAR_STREAK = 2 ``` 最后那个 `2` 尤其重要。它为什么不是 1?因为四选一蒙对的概率是 25%,做对一次就放过,等于每四道题里有一道是假过关。这条理由如果不写下来,下一个人(或者下一次的我)很可能会觉得「连对两次太严了吧」然后改成 1。 --- ## 四、它会写出能跑但方向错的代码 举一个真实的例子。 学生端首页有个「摸底测验」卡片,要先选科目再选分册。我一开始的实现是:默认选中第一个科目。 结果是:**学生想摸物理,卡片默认选中语文,他一点分册就摸了语文。** 改了一版——「只有一科的时候就不必让人选了」,把那一排科目按钮隐藏掉。结果在开发库里踩了更大的坑:一年级、四年级、初一恰好只有一科有题库,于是那一整排连标签一起消失了,学生看到的是「直接让我选上册下册」,而且根本不知道摸的是哪一科。 这段经历被写进了代码注释,因为它是一条通用的教训: ```bash 「只有一个选项所以不用显示」这个推断,在**这一步存在本身就是信息**的时候是错的。 ``` 最终方案是:科目那一排始终渲染。只有一科时预先选上它(没有别的可选,让人多点一下纯属打扰),但它仍然带着标签、以选中态显示,看得见自己摸的是哪科。 **这类问题 AI 发现不了,因为它不是 bug。** 代码逻辑完全正确,测试也能过。它错在对「用户此刻知道什么」的判断上——而这需要有人真的去点那个按钮。 所以我的工作流里有一条硬规定:**每一轮功能做完,我自己去点一遍。** 不是为了找崩溃,是为了找「能跑但不对」。 --- ## 五、哪些事它做得特别好 公平地说几条它明显强于我的地方。 **一是重构的覆盖面。** 把一个设计系统从两个文件里抽出来合并成一个共享模块,涉及十几处调用点——这种活我自己做会漏,它不会。 **二是边界情况。** 跨零点怎么算、暂停播放算不算时长、网络断了怎么补、家长临时加时之后怎么恢复——这些我提需求时根本没提,它自己列出来处理了。 **三是把一句话变成一套结构。** 「LLM 调用要能控制成本」这句话,它展开成了任务分级路由、预算熔断、结果缓存、调用日志四件事,还留了后台可改的配置入口。 **四是不厌其烦。** 同一个文件改第八遍的时候,它的态度和第一遍一样。这一条不该被低估——人在第八遍的时候会开始糊弄。 --- ## 六、哪些事它做不了 **一是决定做什么。** 整个产品里最重要的几个决定——掌握度要会往下掉、积分不能充值、家长管控全部免费——没有一个是它提出来的。它能把决定实现得很好,但决定得有人做。 **二是判断「够好了没有」。** 你说「优化一下这个页面」,它能一直优化下去。什么时候停,得你说。 **三是在真实用户身上验证。** 上面那个摸底测验的坑,只有真的点过才会暴露。 **四是取舍。** 「要不要为了这个功能牺牲那个体验」——这类问题它会给你一个平衡的回答,而产品需要的往往是一个不平衡的决定。 --- ## 七、如果你要开始,我会建议的五件事 **1\. 先让它读,再让它写。** 新项目的第一步不是提需求,是让它把现有代码和文档读一遍并总结出来。它的总结和你的理解不一致的地方,就是接下来最容易出问题的地方。 **2\. 一次一件事。** 「顺手把这个也改了」是所有麻烦的开始。改动一旦跨越两个不相关的模块,出问题时你就无法判断是哪一半引起的。 **3\. 每一轮都提交。** 我 24 天 630 次提交,平均每天 26 次。频繁提交的真正价值不是备份,是**每次出问题都能精确回退到上一个好状态**,而不是在一堆混杂的改动里找。 **4\. 让它写注释解释「为什么」。** 这是给未来的你和未来的它同时留的路标。上面掌握度那段注释,后来至少救了我两次。 **5\. 自己去点一遍。** 每一轮。没有例外。 --- ## 最后 这 24 天里我最大的认知变化是:**写代码不再是瓶颈了,想清楚要什么才是。** 以前一个功能从想清楚到能用,中间隔着几天的实现。现在隔着几十分钟。这个变化的直接后果是——你脑子里那些没想清楚的地方,会被非常快地暴露出来,而且是以「做出来了但不对」的形式。 所以时间的分配变了。以前是八成写代码、两成想;现在反过来。 --- ## 附:24 天做出来的东西长什么样 数字容易夸大,界面不容易。所以把四套端各放一张,你可以自己判断这个体量是不是真的。 **学生端首页** —— 等级、积分、连续天数、今日时长,继续学习和摸底测验的入口。 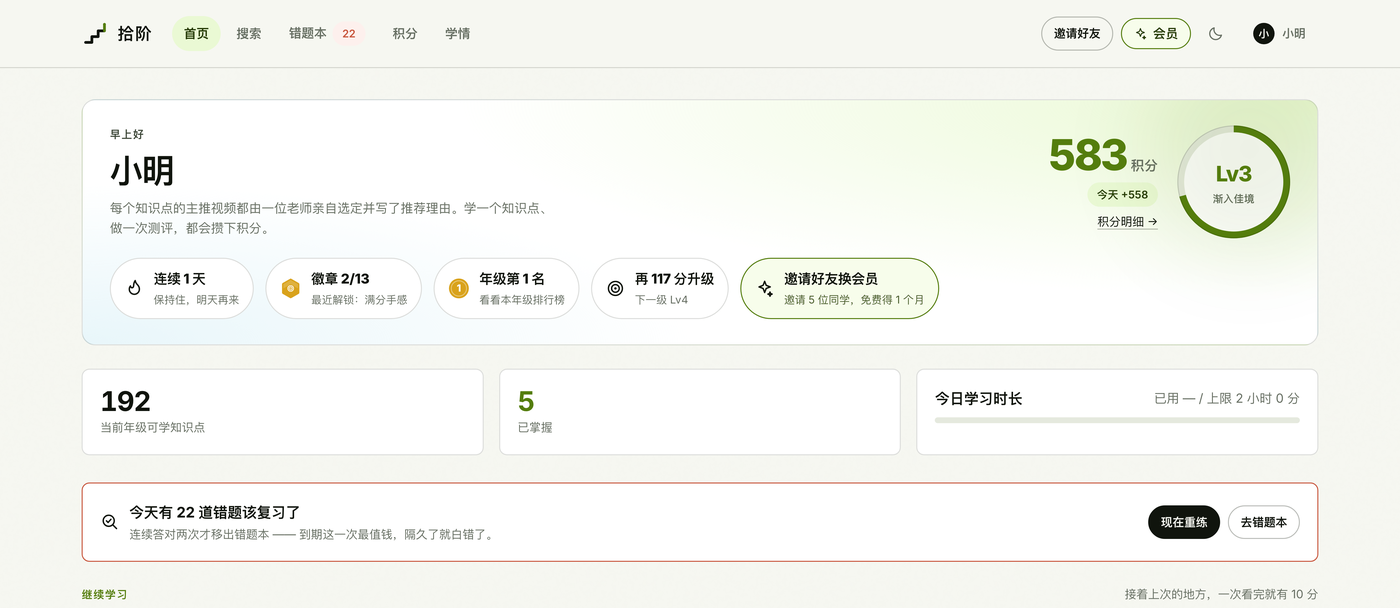 学生端首页 **知识点页** —— 右上角是这个知识点的掌握度。上面那条黄色的「建议先学」是前置知识点推断的结果:数轴掌握度 0%,所以先补它会更顺。右侧「换个老师讲」是带差异标签的备选讲法。  知识点页:掌握度、前置建议、备选讲法 **家长端** —— 时长上限、可学时段、宵禁、单次最长、强制休息,全部服务端强制。这一整套是免费的。  家长端管控 **教师工作台** —— 教研在这里给知识点定主推视频。每行右边三个数是候选/备选/题目,下面那个 7.7 是这条视频的综合评分。  教师工作台:知识点管理 四套端加起来 540 个文件、16 万行。这就是那 630 次提交的产物。 --- 后面几篇会分别讲它的几个技术细节:大模型在里面到底怎么用、AI 出的题怎么保证不教错学生、掌握度这个「会自己往下掉的数」是怎么设计的。