首页 文章 精选 留言 我的

精选列表

搜索[面试],共5092篇文章
优秀的个人博客,低调大师

面试官:select、poll、epoll有何区别?我:阿巴阿巴...

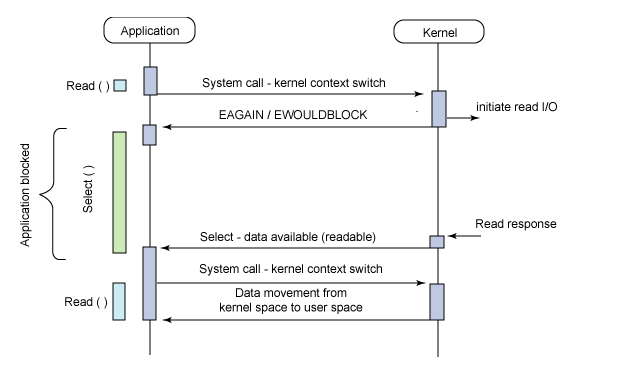
前言 很多朋友对select、poll、epoll很头疼,因为搞不清三者的区别和内在逻辑,所以今天就来给大家详细说说,一家之言,不对之处还请指正。 大家可以进群973961276一起聊聊技术吹吹牛,每周都会有几次抽奖送专业书籍的活动,奖品不甚值钱,但也算个彩头。 缺乏项目实战经验和想跳槽涨薪或是自我提升的朋友看这里>>c/c++ 项目实战/后台服务器开发高级架构师 (1)、select==>时间复杂度O(n) 它仅仅知道了,有I/O事件发生了,却并不知道是哪那几个流(可能有一个,多个,甚至全部),我们只能无差别轮询所有流,找出能读出数据,或者写入数据的流,对他们进行操作。所以select具有O(n)的无差别轮询复杂度,同时处理的流越多,无差别轮询时间就越长。 (2)、poll==>时间复杂度O(n) poll本质上和select没有区别,它将用户传入的数组拷贝到内核空间,然后查询每个fd对应的设备状态,但是它没有最大连接数的限制,原因是它是基于链表来存储的. (3)、epoll==>时间复杂度O(1) epoll可以理解为event poll,不同于忙轮询和无差别轮询,epoll会把哪个流发生了怎样的I/O事件通知我们。所以我们说epoll实际上是事件驱动(每个事件关联上fd)的,此时我们对这些流的操作都是有意义的。(复杂度降低到了O(1)) select,poll,epoll都是IO多路复用的机制。I/O多路复用就通过一种机制,可以监视多个描述符,一旦某个描述符就绪(一般是读就绪或者写就绪),能够通知程序进行相应的读写操作。但select,poll,epoll本质上都是同步I/O,因为他们都需要在读写事件就绪后自己负责进行读写,也就是说这个读写过程是阻塞的,而异步I/O则无需自己负责进行读写,异步I/O的实现会负责把数据从内核拷贝到用户空间。 epoll跟select都能提供多路I/O复用的解决方案。在现在的Linux内核里有都能够支持,其中epoll是Linux所特有,而select则应该是POSIX所规定,一般操作系统均有实现 select: select本质上是通过设置或者检查存放fd标志位的数据结构来进行下一步处理。这样所带来的缺点是: 1、 单个进程可监视的fd数量被限制,即能监听端口的大小有限。 一般来说这个数目和系统内存关系很大,具体数目可以cat /proc/sys/fs/file-max察看。32位机默认是1024个。64位机默认是2048. 2、 对socket进行扫描时是线性扫描,即采用轮询的方法,效率较低: 当套接字比较多的时候,每次select()都要通过遍历FD_SETSIZE个Socket来完成调度,不管哪个Socket是活跃的,都遍历一遍。这会浪费很多CPU时间。如果能给套接字注册某个回调函数,当他们活跃时,自动完成相关操作,那就避免了轮询,这正是epoll与kqueue做的。 3、需要维护一个用来存放大量fd的数据结构,这样会使得用户空间和内核空间在传递该结构时复制开销大 poll: poll本质上和select没有区别,它将用户传入的数组拷贝到内核空间,然后查询每个fd对应的设备状态,如果设备就绪则在设备等待队列中加入一项并继续遍历,如果遍历完所有fd后没有发现就绪设备,则挂起当前进程,直到设备就绪或者主动超时,被唤醒后它又要再次遍历fd。这个过程经历了多次无谓的遍历。 它没有最大连接数的限制,原因是它是基于链表来存储的,但是同样有一个缺点: 1、大量的fd的数组被整体复制于用户态和内核地址空间之间,而不管这样的复制是不是有意义。 2、poll还有一个特点是“水平触发”,如果报告了fd后,没有被处理,那么下次poll时会再次报告该fd。 epoll: epoll有EPOLLLT和EPOLLET两种触发模式,LT是默认的模式,ET是“高速”模式。LT模式下,只要这个fd还有数据可读,每次 epoll_wait都会返回它的事件,提醒用户程序去操作,而在ET(边缘触发)模式中,它只会提示一次,直到下次再有数据流入之前都不会再提示了,无 论fd中是否还有数据可读。所以在ET模式下,read一个fd的时候一定要把它的buffer读光,也就是说一直读到read的返回值小于请求值,或者 遇到EAGAIN错误。还有一个特点是,epoll使用“事件”的就绪通知方式,通过epoll_ctl注册fd,一旦该fd就绪,内核就会采用类似callback的回调机制来激活该fd,epoll_wait便可以收到通知。 epoll为什么要有EPOLLET触发模式? 如果采用EPOLLLT模式的话,系统中一旦有大量你不需要读写的就绪文件描述符,它们每次调用epoll_wait都会返回,这样会大大降低处理程序检索自己关心的就绪文件描述符的效率.。而采用EPOLLET这种边沿触发模式的话,当被监控的文件描述符上有可读写事件发生时,epoll_wait()会通知处理程序去读写。如果这次没有把数据全部读写完(如读写缓冲区太小),那么下次调用epoll_wait()时,它不会通知你,也就是它只会通知你一次,直到该文件描述符上出现第二次可读写事件才会通知你!!!这种模式比水平触发效率高,系统不会充斥大量你不关心的就绪文件描述符 epoll的优点: 1、没有最大并发连接的限制,能打开的FD的上限远大于1024(1G的内存上能监听约10万个端口); 2、效率提升,不是轮询的方式,不会随着FD数目的增加效率下降。只有活跃可用的FD才会调用callback函数; 即Epoll最大的优点就在于它只管你“活跃”的连接,而跟连接总数无关,因此在实际的网络环境中,Epoll的效率就会远远高于select和poll。 3、 内存拷贝,利用mmap()文件映射内存加速与内核空间的消息传递;即epoll使用mmap减少复制开销。 select、poll、epoll 区别总结: 1、支持一个进程所能打开的最大连接数 select 单个进程所能打开的最大连接数有FD_SETSIZE宏定义,其大小是32个整数的大小(在32位的机器上,大小就是3232,同理64位机器上FD_SETSIZE为3264),当然我们可以对进行修改,然后重新编译内核,但是性能可能会受到影响,这需要进一步的测试。 poll poll本质上和select没有区别,但是它没有最大连接数的限制,原因是它是基于链表来存储的 epoll 虽然连接数有上限,但是很大,1G内存的机器上可以打开10万左右的连接,2G内存的机器可以打开20万左右的连接 2、FD剧增后带来的IO效率问题 select 因为每次调用时都会对连接进行线性遍历,所以随着FD的增加会造成遍历速度慢的“线性下降性能问题”。 poll 同上 epoll 因为epoll内核中实现是根据每个fd上的callback函数来实现的,只有活跃的socket才会主动调用callback,所以在活跃socket较少的情况下,使用epoll没有前面两者的线性下降的性能问题,但是所有socket都很活跃的情况下,可能会有性能问题。 3、 消息传递方式 select 内核需要将消息传递到用户空间,都需要内核拷贝动作 poll 同上 epoll epoll通过内核和用户空间共享一块内存来实现的。 总结: 综上,在选择select,poll,epoll时要根据具体的使用场合以及这三种方式的自身特点。 1、表面上看epoll的性能最好,但是在连接数少并且连接都十分活跃的情况下,select和poll的性能可能比epoll好,毕竟epoll的通知机制需要很多函数回调。 2、select低效是因为每次它都需要轮询。但低效也是相对的,视情况而定,也可通过良好的设计改善 今天对这三种IO多路复用进行对比,参考网上和书上面的资料,整理如下: 1、select实现 select的调用过程如下所示: (1)使用copy_from_user从用户空间拷贝fd_set到内核空间 (2)注册回调函数__pollwait (3)遍历所有fd,调用其对应的poll方法(对于socket,这个poll方法是sock_poll,sock_poll根据情况会调用到tcp_poll,udp_poll或者datagram_poll) (4)以tcp_poll为例,其核心实现就是__pollwait,也就是上面注册的回调函数。 (5)__pollwait的主要工作就是把current(当前进程)挂到设备的等待队列中,不同的设备有不同的等待队列,对于tcp_poll来说,其等待队列是sk->sk_sleep(注意把进程挂到等待队列中并不代表进程已经睡眠了)。在设备收到一条消息(网络设备)或填写完文件数据(磁盘设备)后,会唤醒设备等待队列上睡眠的进程,这时current便被唤醒了。 (6)poll方法返回时会返回一个描述读写操作是否就绪的mask掩码,根据这个mask掩码给fd_set赋值。 (7)如果遍历完所有的fd,还没有返回一个可读写的mask掩码,则会调用schedule_timeout是调用select的进程(也就是current)进入睡眠。当设备驱动发生自身资源可读写后,会唤醒其等待队列上睡眠的进程。如果超过一定的超时时间(schedule_timeout指定),还是没人唤醒,则调用select的进程会重新被唤醒获得CPU,进而重新遍历fd,判断有没有就绪的fd。 (8)把fd_set从内核空间拷贝到用户空间。 总结: select的几大缺点: (1)每次调用select,都需要把fd集合从用户态拷贝到内核态,这个开销在fd很多时会很大 (2)同时每次调用select都需要在内核遍历传递进来的所有fd,这个开销在fd很多时也很大 (3)select支持的文件描述符数量太小了,默认是1024 2 poll实现 poll的实现和select非常相似,只是描述fd集合的方式不同,poll使用pollfd结构而不是select的fd_set结构,其他的都差不多,管理多个描述符也是进行轮询,根据描述符的状态进行处理,但是poll没有最大文件描述符数量的限制。poll和select同样存在一个缺点就是,包含大量文件描述符的数组被整体复制于用户态和内核的地址空间之间,而不论这些文件描述符是否就绪,它的开销随着文件描述符数量的增加而线性增大。 3、epoll epoll既然是对select和poll的改进,就应该能避免上述的三个缺点。那epoll都是怎么解决的呢?在此之前,我们先看一下epoll和select和poll的调用接口上的不同,select和poll都只提供了一个函数——select或者poll函数。而epoll提供了三个函数,epoll_create,epoll_ctl和epoll_wait,epoll_create是创建一个epoll句柄;epoll_ctl是注册要监听的事件类型;epoll_wait则是等待事件的产生。 对于第一个缺点,epoll的解决方案在epoll_ctl函数中。每次注册新的事件到epoll句柄中时(在epoll_ctl中指定EPOLL_CTL_ADD),会把所有的fd拷贝进内核,而不是在epoll_wait的时候重复拷贝。epoll保证了每个fd在整个过程中只会拷贝一次。 对于第二个缺点,epoll的解决方案不像select或poll一样每次都把current轮流加入fd对应的设备等待队列中,而只在epoll_ctl时把current挂一遍(这一遍必不可少)并为每个fd指定一个回调函数,当设备就绪,唤醒等待队列上的等待者时,就会调用这个回调函数,而这个回调函数会把就绪的fd加入一个就绪链表)。epoll_wait的工作实际上就是在这个就绪链表中查看有没有就绪的fd(利用schedule_timeout()实现睡一会,判断一会的效果,和select实现中的第7步是类似的)。 对于第三个缺点,epoll没有这个限制,它所支持的FD上限是最大可以打开文件的数目,这个数字一般远大于2048,举个例子,在1GB内存的机器上大约是10万左右,具体数目可以cat /proc/sys/fs/file-max察看,一般来说这个数目和系统内存关系很大。 总结: (1)select,poll实现需要自己不断轮询所有fd集合,直到设备就绪,期间可能要睡眠和唤醒多次交替。而epoll其实也需要调用epoll_wait不断轮询就绪链表,期间也可能多次睡眠和唤醒交替,但是它是设备就绪时,调用回调函数,把就绪fd放入就绪链表中,并唤醒在epoll_wait中进入睡眠的进程。虽然都要睡眠和交替,但是select和poll在“醒着”的时候要遍历整个fd集合,而epoll在“醒着”的时候只要判断一下就绪链表是否为空就行了,这节省了大量的CPU时间。这就是回调机制带来的性能提升。 (2)select,poll每次调用都要把fd集合从用户态往内核态拷贝一次,并且要把current往设备等待队列中挂一次,而epoll只要一次拷贝,而且把current往等待队列上挂也只挂一次(在epoll_wait的开始,注意这里的等待队列并不是设备等待队列,只是一个epoll内部定义的等待队列)。这也能节省不少的开销。

优秀的个人博客,低调大师

面试官:你怎么连MySQL死锁产生原因都不知道?

一、Mysql锁类型和加锁分析 1、锁类型介绍: MySQL有三种锁的级别:页级、表级、行级。 表级锁:开销小,加锁快;不会出现死锁;锁定粒度大,发生锁冲突的概率最高,并发度最低。 行级锁:开销大,加锁慢;会出现死锁;锁定粒度最小,发生锁冲突的概率最低,并发度也最高。 页面锁:开销和加锁时间界于表锁和行锁之间;会出现死锁;锁定粒度界于表锁和行锁之间,并发度一般 算法: next KeyLocks锁,同时锁住记录(数据),并且锁住记录前面的Gap Gap锁,不锁记录,仅仅记录前面的Gap Recordlock锁(锁数据,不锁Gap) 所以其实 Next-KeyLocks=Gap锁+ Recordlock锁 2、加锁分析: http://hedengcheng.com/?p=771 二、死锁产生原因和示例 1、产生原因: 所谓死锁<DeadLock>:是指两个或两个以上的进程在执行过程中,因争夺资源而造成的一种互相等待的现象,若无外力作用,它们都将无法推进下去.此时称系统处于死锁状态或系统产生了死锁,这些永远在互相等待的进程称为死锁进程。表级锁不会产生死锁.所以解决死锁主要还是针对于最常用的InnoDB。 死锁的关键在于:两个(或以上)的Session加锁的顺序不一致。 那么对应的解决死锁问题的关键就是:让不同的session加锁有次序 2、产生示例: 案例一 需求:将投资的钱拆成几份随机分配给借款人。 起初业务程序思路是这样的: 投资人投资后,将金额随机分为几份,然后随机从借款人表里面选几个,然后通过一条条select for update 去更新借款人表里面的余额等。 例如两个用户同时投资,A用户金额随机分为2份,分给借款人1,2 B用户金额随机分为2份,分给借款人2,1 由于加锁的顺序不一样,死锁当然很快就出现了。 对于这个问题的改进很简单,直接把所有分配到的借款人直接一次锁住就行了。 Select * from xxx where id in (xx,xx,xx) for update 在in里面的列表值mysql是会自动从小到大排序,加锁也是一条条从小到大加的锁 例如(以下会话id为主键):Session1:mysql> select * from t3 where id in (8,9) for update;+----+--------+------+---------------------+| id | course | name | ctime |+----+--------+------+---------------------+| 8 | WA | f | 2016-03-02 11:36:30 || 9 | JX | f | 2016-03-01 11:36:30 |+----+--------+------+---------------------+rows in set (0.04 sec)Session2:select * from t3 where id in (10,8,5) for update;锁等待中……其实这个时候id=10这条记录没有被锁住的,但id=5的记录已经被锁住了,锁的等待在id=8的这里不信请看Session3:mysql> select * from t3 where id=5 for update;锁等待中Session4:mysql> select * from t3 where id=10 for update;+----+--------+------+---------------------+| id | course | name | ctime |+----+--------+------+---------------------+| 10 | JB | g | 2016-03-10 11:45:05 |+----+--------+------+---------------------+row in set (0.00 sec)在其它session中id=5是加不了锁的,但是id=10是可以加上锁的。 案例二 在开发中,经常会做这类的判断需求:根据字段值查询(有索引),如果不存在,则插入;否则更新。 以id为主键为例,目前还没有id=22的行Session1:select * from t3 where id=22 for update;Empty set (0.00 sec)session2:select * from t3 where id=23 for update;Empty set (0.00 sec)Session1:insert into t3 values(22,'ac','a',now());锁等待中……Session2:insert into t3 values(23,'bc','b',now());ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction 当对存在的行进行锁的时候(主键),mysql就只有行锁。 当对未存在的行进行锁的时候(即使条件为主键),mysql是会锁住一段范围(有gap锁) 锁住的范围为: (无穷小或小于表中锁住id的最大值,无穷大或大于表中锁住id的最小值) 如:如果表中目前有已有的id为(11 , 12) 那么就锁住(12,无穷大) 如果表中目前已有的id为(11 , 30) 那么就锁住(11,30) 对于这种死锁的解决办法是: insert into t3(xx,xx) on duplicate key update `xx`='XX'; 用mysql特有的语法来解决此问题。因为insert语句对于主键来说,插入的行不管有没有存在,都会只有行锁 案例三 mysql> select * from t3 where id=9 for update;+----+--------+------+---------------------+| id | course | name | ctime |+----+--------+------+---------------------+| 9 | JX | f | 2016-03-01 11:36:30 |+----+--------+------+---------------------+row in set (0.00 sec)Session2:mysql> select * from t3 where id<20 for update;锁等待中Session1:mysql> insert into t3 values(7,'ae','a',now());ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction 这个跟案例一其它是差不多的情况,只是session1不按常理出牌了, Session2在等待Session1的id=9的锁,session2又持了1到8的锁(注意9到19的范围并没有被session2锁住),最后,session1在插入新行时又得等待session2,故死锁发生了。 这种一般是在业务需求中基本不会出现,因为你锁住了id=9,却又想插入id=7的行,这就有点跳了,当然肯定也有解决的方法,那就是重理业务需求,避免这样的写法。 案例四 一般的情况,两个session分别通过一个sql持有一把锁,然后互相访问对方加锁的数据产生死锁。 案例五 两个单条的sql语句涉及到的加锁数据相同,但是加锁顺序不同,导致了死锁。 案例六 http://hedengcheng.com/?p=844 死锁场景如下: 表结构: CREATE TABLE dltask ( id bigint unsigned NOT NULL AUTO_INCREMENT COMMENT ‘auto id’, a varchar(30) NOT NULL COMMENT ‘uniq.a’, b varchar(30) NOT NULL COMMENT ‘uniq.b’, c varchar(30) NOT NULL COMMENT ‘uniq.c’, x varchar(30) NOT NULL COMMENT ‘data’, PRIMARY KEY (id), UNIQUE KEY uniq_a_b_c (a, b, c)) ENGINE=InnoDB DEFAULT CHARSET=utf8 COMMENT=’deadlock test’; a,b,c三列,组合成一个唯一索引,主键索引为id列。 事务隔离级别: RR (Repeatable Read) 每个事务只有一条SQL: delete from dltask where a=? and b=? and c=?; SQL的执行计划: 死锁日志: 众所周知,InnoDB上删除一条记录,并不是真正意义上的物理删除,而是将记录标识为删除状态。(注:这些标识为删除状态的记录,后续会由后台的Purge操作进行回收,物理删除。但是,删除状态的记录会在索引中存放一段时间。) 在RR隔离级别下,唯一索引上满足查询条件,但是却是删除记录,如何加锁?InnoDB在此处的处理策略与前两种策略均不相同,或者说是前两种策略的组合:对于满足条件的删除记录,InnoDB会在记录上加next key lock X(对记录本身加X锁,同时锁住记录前的GAP,防止新的满足条件的记录插入。) Unique查询,三种情况,对应三种加锁策略,总结如下: 此处,我们看到了next key锁,是否很眼熟?对了,前面死锁中事务1,事务2处于等待状态的锁,均为next key锁。明白了这三个加锁策略,其实构造一定的并发场景,死锁的原因已经呼之欲出。但是,还有一个前提策略需要介绍,那就是InnoDB内部采用的死锁预防策略。 找到满足条件的记录,并且记录有效,则对记录加X锁,No Gap锁(lock_mode X locks rec but not gap); 找到满足条件的记录,但是记录无效(标识为删除的记录),则对记录加next key锁(同时锁住记录本身,以及记录之前的Gap:lock_mode X); 未找到满足条件的记录,则对第一个不满足条件的记录加Gap锁,保证没有满足条件的记录插入(locks gap before rec); 死锁预防策略 InnoDB引擎内部(或者说是所有的数据库内部),有多种锁类型:事务锁(行锁、表锁),Mutex(保护内部的共享变量操作)、RWLock(又称之为Latch,保护内部的页面读取与修改)。 InnoDB每个页面为16K,读取一个页面时,需要对页面加S锁,更新一个页面时,需要对页面加上X锁。任何情况下,操作一个页面,都会对页面加锁,页面锁加上之后,页面内存储的索引记录才不会被并发修改。 因此,为了修改一条记录,InnoDB内部如何处理: 根据给定的查询条件,找到对应的记录所在页面; 对页面加上X锁(RWLock),然后在页面内寻找满足条件的记录; 在持有页面锁的情况下,对满足条件的记录加事务锁(行锁:根据记录是否满足查询条件,记录是否已经被删除,分别对应于上面提到的3种加锁策略之一); 死锁预防策略:相对于事务锁,页面锁是一个短期持有的锁,而事务锁(行锁、表锁)是长期持有的锁。因此,为了防止页面锁与事务锁之间产生死锁。InnoDB做了死锁预防的策略:持有事务锁(行锁、表锁),可以等待获取页面锁;但反之,持有页面锁,不能等待持有事务锁。 根据死锁预防策略,在持有页面锁,加行锁的时候,如果行锁需要等待。则释放页面锁,然后等待行锁。此时,行锁获取没有任何锁保护,因此加上行锁之后,记录可能已经被并发修改。因此,此时要重新加回页面锁,重新判断记录的状态,重新在页面锁的保护下,对记录加锁。如果此时记录未被并发修改,那么第二次加锁能够很快完成,因为已经持有了相同模式的锁。但是,如果记录已经被并发修改,那么,就有可能导致本文前面提到的死锁问题。 以上的InnoDB死锁预防处理逻辑,对应的函数,是row0sel.c::row_search_for_mysql()。感兴趣的朋友,可以跟踪调试下这个函数的处理流程,很复杂,但是集中了InnoDB的精髓。 剖析死锁的成因 做了这么多铺垫,有了Delete操作的3种加锁逻辑、InnoDB的死锁预防策略等准备知识之后,再回过头来分析本文最初提到的死锁问题,就会手到拈来,事半而功倍。 首先,假设dltask中只有一条记录:(1, ‘a’, ‘b’, ‘c’, ‘data’)。三个并发事务,同时执行以下的这条SQL: delete from dltask where a=’a’ and b=’b’ and c=’c’; 并且产生了以下的并发执行逻辑,就会产生死锁: 上面分析的这个并发流程,完整展现了死锁日志中的死锁产生的原因。其实,根据事务1步骤6,与事务0步骤3/4之间的顺序不同,死锁日志中还有可能产生另外一种情况,那就是事务1等待的锁模式为记录上的X锁 + No Gap锁(lock_mode X locks rec but not gap waiting)。这第二种情况,也是”润洁”同学给出的死锁用例中,使用MySQL 5.6.15版本测试出来的死锁产生的原因。 此类死锁,产生的几个前提: Delete操作,针对的是唯一索引上的等值查询的删除;(范围下的删除,也会产生死锁,但是死锁的场景,跟本文分析的场景,有所不同) 至少有3个(或以上)的并发删除操作; 并发删除操作,有可能删除到同一条记录,并且保证删除的记录一定存在; 事务的隔离级别设置为Repeatable Read,同时未设置innodb_locks_unsafe_for_binlog参数(此参数默认为FALSE);(Read Committed隔离级别,由于不会加Gap锁,不会有next key,因此也不会产生死锁) 使用的是InnoDB存储引擎;(废话!MyISAM引擎根本就没有行锁) 最后 感谢大家看到这里,文章有不足,欢迎大家指出;如果你觉得写得不错,那就给我一个赞吧。 也欢迎大家关注我的公众号:程序员麦冬,麦冬每天都会分享java相关技术文章或行业资讯,欢迎大家关注和转发文章!

优秀的个人博客,低调大师

大厂面试爱问的「调度算法」,20 张图一举拿下

本文转载自微信公众号「小林coding」,作者小林coding 。转载本文请联系小林coding公众号。 原文地址:https://mp.weixin.qq.com/s/JWj6_BF9Xc84kQcyx6Nf_g 前言 最近,我偷偷潜伏在各大技术群,因为秋招在即,看到不少小伙伴分享的大厂面经。 然后发现,操作系统的知识点考察还是比较多的,大厂就是大厂就爱问基础知识。其中,关于操作系统的「调度算法」考察也算比较频繁。 所以,我这边总结了操作系统的三大调度机制,分别是「进程调度/页面置换/磁盘调度算法」,供大家复习,希望大家在秋招能斩获自己心意的 offer。 正文 进程调度算法 进程调度算法也称 CPU 调度算法,毕竟进程是由 CPU 调度的。 当 CPU 空闲时,操作系统就选择内存中的某个「就绪状态」的进程,并给其分配 CPU。 什么时候会发生 CPU 调度呢?通常有以下情况: 当进程从运行状态转到等待状态; 当进程从运行状态转到就绪状态; 当进程从等待状态转到就绪状态; 当进程从运行状态转到终止状态; 其中发生在 1 和 4 两种情况下的调度称为「非抢占式调度」,2 和 3 两种情况下发生的调度称为「抢占式调度」。 非抢占式的意思就是,当进程正在运行时,它就会一直运行,直到该进程完成或发生某个事件而被阻塞时,才会把 CPU 让给其他进程。 而抢占式调度,顾名思义就是进程正在运行的时,可以被打断,使其把 CPU 让给其他进程。那抢占的原则一般有三种,分别是时间片原则、优先权原则、短作业优先原则。 你可能会好奇为什么第 3 种情况也会发生 CPU 调度呢?假设有一个进程是处于等待状态的,但是它的优先级比较高,如果该进程等待的事件发生了,它就会转到就绪状态,一旦它转到就绪状态,如果我们的调度算法是以优先级来进行调度的,那么它就会立马抢占正在运行的进程,所以这个时候就会发生 CPU 调度。 那第 2 种状态通常是时间片到的情况,因为时间片到了就会发生中断,于是就会抢占正在运行的进程,从而占用 CPU。 调度算法影响的是等待时间(进程在就绪队列中等待调度的时间总和),而不能影响进程真在使用 CPU 的时间和 I/O 时间。 接下来,说说常见的调度算法: 先来先服务调度算法 最短作业优先调度算法 高响应比优先调度算法 时间片轮转调度算法 最高优先级调度算法 多级反馈队列调度算法 先来先服务调度算法 最简单的一个调度算法,就是非抢占式的先来先服务(First Come First Severd, FCFS)算法了。 FCFS 调度算法 顾名思义,先来后到,每次从就绪队列选择最先进入队列的进程,然后一直运行,直到进程退出或被阻塞,才会继续从队列中选择第一个进程接着运行。 这似乎很公平,但是当一个长作业先运行了,那么后面的短作业等待的时间就会很长,不利于短作业。 FCFS 对长作业有利,适用于 CPU 繁忙型作业的系统,而不适用于 I/O 繁忙型作业的系统。 最短作业优先调度算法 最短作业优先(Shortest Job First, SJF)调度算法同样也是顾名思义,它会优先选择运行时间最短的进程来运行,这有助于提高系统的吞吐量。 SJF 调度算法 这显然对长作业不利,很容易造成一种极端现象。 比如,一个长作业在就绪队列等待运行,而这个就绪队列有非常多的短作业,那么就会使得长作业不断的往后推,周转时间变长,致使长作业长期不会被运行。 高响应比优先调度算法 前面的「先来先服务调度算法」和「最短作业优先调度算法」都没有很好的权衡短作业和长作业。 那么,高响应比优先 (Highest Response Ratio Next, HRRN)调度算法主要是权衡了短作业和长作业。 每次进行进程调度时,先计算「响应比优先级」,然后把「响应比优先级」最高的进程投入运行,「响应比优先级」的计算公式: 从上面的公式,可以发现: 如果两个进程的「等待时间」相同时,「要求的服务时间」越短,「响应比」就越高,这样短作业的进程容易被选中运行; 如果两个进程「要求的服务时间」相同时,「等待时间」越长,「响应比」就越高,这就兼顾到了长作业进程,因为进程的响应比可以随时间等待的增加而提高,当其等待时间足够长时,其响应比便可以升到很高,从而获得运行的机会; 时间片轮转调度算法 最古老、最简单、最公平且使用最广的算法就是时间片轮转(Round Robin, RR)调度算法。 RR 调度算法 每个进程被分配一个时间段,称为时间片(Quantum),即允许该进程在该时间段中运行。 如果时间片用完,进程还在运行,那么将会把此进程从 CPU 释放出来,并把 CPU 分配另外一个进程; 如果该进程在时间片结束前阻塞或结束,则 CPU 立即进行切换; 另外,时间片的长度就是一个很关键的点: 如果时间片设得太短会导致过多的进程上下文切换,降低了 CPU 效率; 如果设得太长又可能引起对短作业进程的响应时间变长; 通常时间片设为 20ms~50ms 通常是一个比较合理的折中值。 最高优先级调度算法 前面的「时间片轮转算法」做了个假设,即让所有的进程同等重要,也不偏袒谁,大家的运行时间都一样。 但是,对于多用户计算机系统就有不同的看法了,它们希望调度是有优先级的,即希望调度程序能从就绪队列中选择最高优先级的进程进行运行,这称为最高优先级(Highest Priority First,HPF)调度算法。 进程的优先级可以分为,静态优先级或动态优先级: 静态优先级:创建进程时候,就已经确定了优先级了,然后整个运行时间优先级都不会变化; 动态优先级:根据进程的动态变化调整优先级,比如如果进程运行时间增加,则降低其优先级,如果进程等待时间(就绪队列的等待时间)增加,则升高其优先级,也就是随着时间的推移增加等待进程的优先级。 该算法也有两种处理优先级高的方法,非抢占式和抢占式: 非抢占式:当就绪队列中出现优先级高的进程,运行完当前进程,再选择优先级高的进程。 抢占式:当就绪队列中出现优先级高的进程,当前进程挂起,调度优先级高的进程运行。 但是依然有缺点,可能会导致低优先级的进程永远不会运行。 多级反馈队列调度算法 多级反馈队列(Multilevel Feedback Queue)调度算法是「时间片轮转算法」和「最高优先级算法」的综合和发展。 顾名思义: 「多级」表示有多个队列,每个队列优先级从高到低,同时优先级越高时间片越短。 「反馈」表示如果有新的进程加入优先级高的队列时,立刻停止当前正在运行的进程,转而去运行优先级高的队列; 多级反馈队列 来看看,它是如何工作的: 设置了多个队列,赋予每个队列不同的优先级,每个队列优先级从高到低,同时优先级越高时间片越短; 新的进程会被放入到第一级队列的末尾,按先来先服务的原则排队等待被调度,如果在第一级队列规定的时间片没运行完成,则将其转入到第二级队列的末尾,以此类推,直至完成; 当较高优先级的队列为空,才调度较低优先级的队列中的进程运行。如果进程运行时,有新进程进入较高优先级的队列,则停止当前运行的进程并将其移入到原队列末尾,接着让较高优先级的进程运行; 可以发现,对于短作业可能可以在第一级队列很快被处理完。对于长作业,如果在第一级队列处理不完,可以移入下次队列等待被执行,虽然等待的时间变长了,但是运行时间也会更长了,所以该算法很好的兼顾了长短作业,同时有较好的响应时间。 内存页面置换算法 在了解内存页面置换算法前,我们得先谈一下缺页异常(缺页中断)。 当 CPU 访问的页面不在物理内存时,便会产生一个缺页中断,请求操作系统将所缺页调入到物理内存。那它与一般中断的主要区别在于: 缺页中断在指令执行「期间」产生和处理中断信号,而一般中断在一条指令执行「完成」后检查和处理中断信号。 缺页中断返回到该指令的开始重新执行「该指令」,而一般中断返回回到该指令的「下一个指令」执行。 我们来看一下缺页中断的处理流程,如下图: 缺页中断的处理流程 在 CPU 里访问一条 Load M 指令,然后 CPU 会去找 M 所对应的页表项。 如果该页表项的状态位是「有效的」,那 CPU 就可以直接去访问物理内存了,如果状态位是「无效的」,则 CPU 则会发送缺页中断请求。 操作系统收到了缺页中断,则会执行缺页中断处理函数,先会查找该页面在磁盘中的页面的位置。 找到磁盘中对应的页面后,需要把该页面换入到物理内存中,但是在换入前,需要在物理内存中找空闲页,如果找到空闲页,就把页面换入到物理内存中。 页面从磁盘换入到物理内存完成后,则把页表项中的状态位修改为「有效的」。 最后,CPU 重新执行导致缺页异常的指令。 上面所说的过程,第 4 步是能在物理内存找到空闲页的情况,那如果找不到呢? 找不到空闲页的话,就说明此时内存已满了,这时候,就需要「页面置换算法」选择一个物理页,如果该物理页有被修改过(脏页),则把它换出到磁盘,然后把该被置换出去的页表项的状态改成「无效的」,最后把正在访问的页面装入到这个物理页中。 这里提一下,页表项通常有如下图的字段: 那其中: 状态位:用于表示该页是否有效,也就是说是否在物理内存中,供程序访问时参考。 访问字段:用于记录该页在一段时间被访问的次数,供页面置换算法选择出页面时参考。 修改位:表示该页在调入内存后是否有被修改过,由于内存中的每一页都在磁盘上保留一份副本,因此,如果没有修改,在置换该页时就不需要将该页写回到磁盘上,以减少系统的开销;如果已经被修改,则将该页重写到磁盘上,以保证磁盘中所保留的始终是最新的副本。 硬盘地址:用于指出该页在硬盘上的地址,通常是物理块号,供调入该页时使用。 这里我整理了虚拟内存的管理整个流程,你可以从下面这张图看到: 虚拟内存的流程 所以,页面置换算法的功能是,当出现缺页异常,需调入新页面而内存已满时,选择被置换的物理页面,也就是说选择一个物理页面换出到磁盘,然后把需要访问的页面换入到物理页。 那其算法目标则是,尽可能减少页面的换入换出的次数,常见的页面置换算法有如下几种: 最佳页面置换算法(OPT) 先进先出置换算法(FIFO) 最近最久未使用的置换算法(LRU) 时钟页面置换算法(Lock) 最不常用置换算法(LFU) 最佳页面置换算法 最佳页面置换算法 基本思路是,置换在「未来」最长时间不访问的页面。 所以,该算法实现需要计算内存中每个逻辑页面的「下一次」访问时间,然后比较,选择未来最长时间不访问的页面。 我们举个例子,假设一开始有 3 个空闲的物理页,然后有请求的页面序列,那它的置换过程如下图: 最佳页面置换算法 在这个请求的页面序列中,缺页共发生了 7 次(空闲页换入 3 次 + 最优页面置换 4 次),页面置换共发生了 4 次。 这很理想,但是实际系统中无法实现,因为程序访问页面时是动态的,我们是无法预知每个页面在「下一次」访问前的等待时间。 所以,最佳页面置换算法作用是为了衡量你的算法的效率,你的算法效率越接近该算法的效率,那么说明你的算法是高效的。 先进先出置换算法 既然我们无法预知页面在下一次访问前所需的等待时间,那我们可以选择在内存驻留时间很长的页面进行中置换,这个就是「先进先出置换」算法的思想。 还是以前面的请求的页面序列作为例子,假设使用先进先出置换算法,则过程如下图: 先进先出置换算法 在这个请求的页面序列中,缺页共发生了 10 次,页面置换共发生了 7 次,跟最佳页面置换算法比较起来,性能明显差了很多。 最近最久未使用的置换算法 最近最久未使用(LRU)的置换算法的基本思路是,发生缺页时,选择最长时间没有被访问的页面进行置换,也就是说,该算法假设已经很久没有使用的页面很有可能在未来较长的一段时间内仍然不会被使用。 这种算法近似最优置换算法,最优置换算法是通过「未来」的使用情况来推测要淘汰的页面,而 LRU 则是通过「历史」的使用情况来推测要淘汰的页面。 还是以前面的请求的页面序列作为例子,假设使用最近最久未使用的置换算法,则过程如下图: 最近最久未使用的置换算法 在这个请求的页面序列中,缺页共发生了 9 次,页面置换共发生了 6 次,跟先进先出置换算法比较起来,性能提高了一些。 虽然 LRU 在理论上是可以实现的,但代价很高。为了完全实现 LRU,需要在内存中维护一个所有页面的链表,最近最多使用的页面在表头,最近最少使用的页面在表尾。 困难的是,在每次访问内存时都必须要更新「整个链表」。在链表中找到一个页面,删除它,然后把它移动到表头是一个非常费时的操作。 所以,LRU 虽然看上去不错,但是由于开销比较大,实际应用中比较少使用。 时钟页面置换算法 那有没有一种即能优化置换的次数,也能方便实现的算法呢? 时钟页面置换算法就可以两者兼得,它跟 LRU 近似,又是对 FIFO 的一种改进。 该算法的思路是,把所有的页面都保存在一个类似钟面的「环形链表」中,一个表针指向最老的页面。 当发生缺页中断时,算法首先检查表针指向的页面: 如果它的访问位位是 0 就淘汰该页面,并把新的页面插入这个位置,然后把表针前移一个位置; 如果访问位是 1 就清除访问位,并把表针前移一个位置,重复这个过程直到找到了一个访问位为 0 的页面为止; 我画了一副时钟页面置换算法的工作流程图,你可以在下方看到: 时钟页面置换算法 了解了这个算法的工作方式,就明白为什么它被称为时钟(Clock)算法了。 最不常用算法 最不常用(LFU)算法,这名字听起来很调皮,但是它的意思不是指这个算法不常用,而是当发生缺页中断时,选择「访问次数」最少的那个页面,并将其淘汰。 它的实现方式是,对每个页面设置一个「访问计数器」,每当一个页面被访问时,该页面的访问计数器就累加 1。在发生缺页中断时,淘汰计数器值最小的那个页面。 看起来很简单,每个页面加一个计数器就可以实现了,但是在操作系统中实现的时候,我们需要考虑效率和硬件成本的。 要增加一个计数器来实现,这个硬件成本是比较高的,另外如果要对这个计数器查找哪个页面访问次数最小,查找链表本身,如果链表长度很大,是非常耗时的,效率不高。 但还有个问题,LFU 算法只考虑了频率问题,没考虑时间的问题,比如有些页面在过去时间里访问的频率很高,但是现在已经没有访问了,而当前频繁访问的页面由于没有这些页面访问的次数高,在发生缺页中断时,就会可能会误伤当前刚开始频繁访问,但访问次数还不高的页面。 那这个问题的解决的办法还是有的,可以定期减少访问的次数,比如当发生时间中断时,把过去时间访问的页面的访问次数除以 2,也就说,随着时间的流失,以前的高访问次数的页面会慢慢减少,相当于加大了被置换的概率。 磁盘调度算法 我们来看看磁盘的结构,如下图: 磁盘的结构 常见的机械磁盘是上图左边的样子,中间圆的部分是磁盘的盘片,一般会有多个盘片,每个盘面都有自己的磁头。右边的图就是一个盘片的结构,盘片中的每一层分为多个磁道,每个磁道分多个扇区,每个扇区是 512 字节。那么,多个具有相同编号的磁道形成一个圆柱,称之为磁盘的柱面,如上图里中间的样子。 磁盘调度算法的目的很简单,就是为了提高磁盘的访问性能,一般是通过优化磁盘的访问请求顺序来做到的。 寻道的时间是磁盘访问最耗时的部分,如果请求顺序优化的得当,必然可以节省一些不必要的寻道时间,从而提高磁盘的访问性能。 假设有下面一个请求序列,每个数字代表磁道的位置: 98,183,37,122,14,124,65,67 初始磁头当前的位置是在第 53 磁道。 接下来,分别对以上的序列,作为每个调度算法的例子,那常见的磁盘调度算法有: 先来先服务算法 最短寻道时间优先算法 扫描算法算法 循环扫描算法 LOOK 与 C-LOOK 算法 先来先服务 先来先服务(First-Come,First-Served,FCFS),顾名思义,先到来的请求,先被服务。 那按照这个序列的话: 98,183,37,122,14,124,65,67 那么,磁盘的写入顺序是从左到右,如下图: 先来先服务 先来先服务算法总共移动了 640 个磁道的距离,这么一看这种算法,比较简单粗暴,但是如果大量进程竞争使用磁盘,请求访问的磁道可能会很分散,那先来先服务算法在性能上就会显得很差,因为寻道时间过长。 最短寻道时间优先 最短寻道时间优先(Shortest Seek First,SSF)算法的工作方式是,优先选择从当前磁头位置所需寻道时间最短的请求,还是以这个序列为例子: 98,183,37,122,14,124,65,67 那么,那么根据距离磁头( 53 位置)最近的请求的算法,具体的请求则会是下列从左到右的顺序: 65,67,37,14,98,122,124,183 最短寻道时间优先 磁头移动的总距离是 236 磁道,相比先来先服务性能提高了不少。 但这个算法可能存在某些请求的饥饿,因为本次例子我们是静态的序列,看不出问题,假设是一个动态的请求,如果后续来的请求都是小于 183 磁道的,那么 183 磁道可能永远不会被响应,于是就产生了饥饿现象,这里产生饥饿的原因是磁头在一小块区域来回移动。 扫描算法 最短寻道时间优先算法会产生饥饿的原因在于:磁头有可能再一个小区域内来回得移动。 为了防止这个问题,可以规定:磁头在一个方向上移动,访问所有未完成的请求,直到磁头到达该方向上的最后的磁道,才调换方向,这就是扫描(Scan)算法。 这种算法也叫做电梯算法,比如电梯保持按一个方向移动,直到在那个方向上没有请求为止,然后改变方向。 还是以这个序列为例子,磁头的初始位置是 53: 98,183,37,122,14,124,65,67 那么,假设扫描调度算先朝磁道号减少的方向移动,具体请求则会是下列从左到右的顺序: 37,14,0,65,67,98,122,124,183 扫描算法 磁头先响应左边的请求,直到到达最左端( 0 磁道)后,才开始反向移动,响应右边的请求。 扫描调度算法性能较好,不会产生饥饿现象,但是存在这样的问题,中间部分的磁道会比较占便宜,中间部分相比其他部分响应的频率会比较多,也就是说每个磁道的响应频率存在差异。 循环扫描算法 扫描算法使得每个磁道响应的频率存在差异,那么要优化这个问题的话,可以总是按相同的方向进行扫描,使得每个磁道的响应频率基本一致。 循环扫描(Circular Scan, CSCAN )规定:只有磁头朝某个特定方向移动时,才处理磁道访问请求,而返回时直接快速移动至最靠边缘的磁道,也就是复位磁头,这个过程是很快的,并且返回中途不处理任何请求,该算法的特点,就是磁道只响应一个方向上的请求。 还是以这个序列为例子,磁头的初始位置是 53: 98,183,37,122,14,124,65,67 那么,假设循环扫描调度算先朝磁道增加的方向移动,具体请求会是下列从左到右的顺序: 65,67,98,122,124,183,199,0,14,37 循环扫描算法 磁头先响应了右边的请求,直到碰到了最右端的磁道 199,就立即回到磁盘的开始处(磁道 0),但这个返回的途中是不响应任何请求的,直到到达最开始的磁道后,才继续顺序响应右边的请求。 循环扫描算法相比于扫描算法,对于各个位置磁道响应频率相对比较平均。 LOOK 与 C-LOOK算法 我们前面说到的扫描算法和循环扫描算法,都是磁头移动到磁盘「最始端或最末端」才开始调换方向。 那这其实是可以优化的,优化的思路就是磁头在移动到「最远的请求」位置,然后立即反向移动。 那针对 SCAN 算法的优化则叫 LOOK 算法,它的工作方式,磁头在每个方向上仅仅移动到最远的请求位置,然后立即反向移动,而不需要移动到磁盘的最始端或最末端,反向移动的途中会响应请求。 LOOK 算法 而针 C-SCAN 算法的优化则叫 C-LOOK,它的工作方式,磁头在每个方向上仅仅移动到最远的请求位置,然后立即反向移动,而不需要移动到磁盘的最始端或最末端,反向移动的途中不会响应请求。 C-LOOK 算法

优秀的个人博客,低调大师

作为程序员你不知道Redis持久化,如何通过面试?

我们都知道Redis是个内存数据库,所有的数据都存储在内存中。一旦服务器上Redis进程退出,数据库中的数据就会丢失。 持久化是做什么事呢?持久化简单的理解就是将内存中的数据做个备份。Redis的持久化有两种方法,即RDB持久化和AOF持久化。本文将会分两部分介绍这两种持久化方法,以及实现原理。 一、RDB持久化 Redis数据持久化是将内存中的数据保存到磁盘里,避免数据意外丢失。RDB持久化会生成一个RDB文件,这个RDB文件是一个经过压缩的二进制文件。通过该文件可以还原出Redis数据库中的数据。RDB的持久化可以手动执行,也可以根据服务器配置项定期自动执行。 下面我们一起学习一下RDB文件是怎么创建的。有两个命令可以创建RDB文件,一个是SAVE,另一个是BGSAVE。 执行SAVE命令会阻塞Redis服务器进程,直到RDB文件创建完成为止,在服务器进程被阻塞期间,服务器不能处理任何命令请求。 执行BGSAVE命令会派生出一个子进程,然后由子进程负责创建RDB文件,服务器父进程继续处理命令请求。 SAVE命令和BGSAVE命令的底层调用的函数都是同一个函数rdbSave,只不过SAVE命令是直接调用这个函数,而BGSAVE会fork()出子进程来调用这个函数。伪代码如下: RDB文件的载入工作是在服务器启动时自动执行的,只要Redis服务器在启动时检测到RDB文件存在,就会自动载入RDB文件。值得一提的是,Redis服务器在载入RDB文件的期间,会一直处于阻塞状态,直到载入工作完成为止。 BGSAVE命令在不阻塞服务器进程的情况下执行,所以Redis允许用户通过设置服务器的save选项来让服务器每隔一段时间自动执行一次BGSAVE命令。 上面条件只要满足其中一个,BGSAVE命令就会被执行: 第一条的意思是:服务器在900秒内对数据库执行过至少1次修改,就会执行BGSAVE命令 第二条的意思是:服务器在300秒内对数据库执行过至少10次修改,就会执行BGSAVE命令 第三条的意思是:服务器在60秒内对数据库执行过至少10000次修改,就会执行BGSAVE命令 二、AOF持久化 除了RDB持久化之外,Redis还提供了AOF持久化功能,两者的实现方式有着很大的不同。RDB持久化是通过保存数据库中的键值对来记录数据库状态,而AOF持久化是通过保存Redis服务器所执行的写命令来记录记录数据库状态。 AOF持久化是如何实现的呢?AOF持久化分文三个步骤:命令追加、文件写入、文件同步。 命令追加:当AOF持久化功能打开时,服务器在执行完一个写命令后,会以一定的格式将被执行的写命令追加到服务器中的aof缓冲区中。aof缓冲区是redisServer结构体维护的一个SDS结构的属性。 文件写入:文件写入是指从Redis的aof缓冲区写入到操作系统的内存缓冲区。这个过程是为了提高文件的写入效率,但是带来的风险是服务器出现故障时,内存缓冲区中的数据会丢失掉。 文件同步:这个过程是将内存缓冲区中的数据写入到硬盘中的AOF文件中 Redis中默认执行的是RDB持久化,如何打开AOF持久化呢?我们先来看看AOF的配置项: ①appendonly:这个参数是AOF的开关,配置成yes可以打开AOF持久化机制。打开AOF机制后 ②appendfsync:我们知道Redis中有个事件循环,Redis在每个事件循环都会将aof缓冲区中的内容写入到操作系统的内存缓冲区。这个参数就是来配置将内存缓冲区中的数据同步到硬盘上的AOF文件中的更新频率,有always、everysec、no三个配置值。 always表示每次执行写入操作,就会立即将内存缓冲区中的内容同步到磁盘中的AOF文件中。这种配置性能比较差,但是可以确保数据不丢失。 everysec表示每秒执行一次将操作系统的内存缓冲区中的数据同步到磁盘的AOF文件中,这个操作由一个线程来负责,性能很高。 no表示由操作系统来控制何时将内存缓冲区中的数据同步到硬盘的AOF文件中。这种操作在服务器出现异常时会丢失一部分数据。 下面说说AOF文件的还原过程,我们知道AOF文件中存储的是所有曾经执行过的写命令,所以服务器只要读入并重新执行一遍AOF文件里保存的写命令,就可以还原服务器关闭之前的数据库内容。 同时为了解决在Redis运行过程中AOF文件越来越大,Redis还提供了AOF重写功能,关于AOF重写原理在此不具体介绍,有兴趣的我们可以私下讨论。 三、RDB和AOF区别和联系,以及同时工作时的情况 ①首先我们总结一下两种方式的区别和联系: RDB持久化:默认开启;全量备份,一次性保存整个数据库;体积小,数据恢复快;服务器异常时可能会丢失部分数据;SAVE操作会阻塞,BGSAVE不阻塞 AOF持久化:默认关闭;增量备份,一次保存一个修改数据库的命令;体积大,数据恢复慢;备份频率可以自己设置;不会出现阻塞 ②当RDB和AOF同时开始时: 如果RDB在执行snapshotting操作,那么redis不会执行AOF rewrite; 如果redis在执行AOF rewrite,那么就不会执行RDB snapshotting 如果RDB在执行snapshotting,此时用户执行BGREWRITEAOF命令,那么等RDB快照生成之后,才会去执行AOF rewrite 同时有RDB snapshot文件和AOF日志文件,那么redis重启的时候,会优先使用AOF进行数据恢复,因为其中的日志更完整

优秀的个人博客,低调大师

面试被问高并发流量控制,我脸都绿了...

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 前言 在实际项目中,曾经遭遇过线上5W+QPS的峰值,也在压测状态下经历过10W+QPS的大流量请求,本篇博客的话题主要就是自己对高并发流量控制的一点思考。 应对大流量的一些思路 首先,我们来说一下什么是大流量? 大流量,我们很可能会冒出:TPS(每秒事务量),QPS(每秒请求量),1W+,5W+,10W+,100W+...。其实并没有一个绝对的数字,如果这个量造成了系统的压力,影响了系统的性能,那么这个量就可以称之为大流量了。 其次,应对大流量的一些常见手段是什么? 缓存:说白了,就是让数据尽早进入缓存,离程序近一点,不要大量频繁的访问DB。降级:如果不是核心链路,那么就把这个服务降级掉。打个比喻,现在的APP都讲究千人千面,拿到数据后,做个性化排序展示,如果在大流量下,这个排序就可以降级掉!关注公众号互联网架构师,回复关键字2T,获取最新架构视频限流:大家都知道,北京地铁早高峰,地铁站都会做一件事情,就是限流了!想法很直接,就是想在一定时间内把请求限制在一定范围内,保证系统不被冲垮,同时尽可能提升系统的吞吐量。 注意到,有些时候,缓存和降级是解决不了问题的,比如,电商的双十一,用户的购买,下单等行为,是涉及到大量写操作,而且是核心链路,无法降级的,这个时候,限流就比较重要了。 那么接下来,我们重点说一下,限流。 限流的常用方式 限流的常用处理手段有:计数器、滑动窗口、漏桶、令牌。 计数器 计数器是一种比较简单的限流算法,用途比较广泛,在接口层面,很多地方使用这种方式限流。在一段时间内,进行计数,与阀值进行比较,到了时间临界点,将计数器清0。 这里需要注意的是,存在一个时间临界点的问题。举个栗子,在12:01:00到12:01:58这段时间内没有用户请求,然后在12:01:59这一瞬时发出100个请求,OK,然后在12:02:00这一瞬时又发出了100个请求。这里你应该能感受到,在这个临界点可能会承受恶意用户的大量请求,甚至超出系统预期的承受。 滑动窗口 由于计数器存在临界点缺陷,后来出现了滑动窗口算法来解决。 滑动窗口原理图滑动窗口的意思是说把固定时间片,进行划分,并且随着时间的流逝,进行移动,这样就巧妙的避开了计数器的临界点问题。也就是说这些固定数量的可以移动的格子,将会进行计数判断阀值,因此格子的数量影响着滑动窗口算法的精度。 漏桶 虽然滑动窗口有效避免了时间临界点的问题,但是依然有时间片的概念,而漏桶算法在这方面比滑动窗口而言,更加先进。有一个固定的桶,进水的速率是不确定的,但是出水的速率是恒定的,当水满的时候是会溢出的。 令牌桶 注意到,漏桶的出水速度是恒定的,那么意味着如果瞬时大流量的话,将有大部分请求被丢弃掉(也就是所谓的溢出)。为了解决这个问题,令牌桶进行了算法改进。 生成令牌的速度是恒定的,而请求去拿令牌是没有速度限制的。这意味,面对瞬时大流量,该算法可以在短时间内请求拿到大量令牌,而且拿令牌的过程并不是消耗很大的事情。(有一点生产令牌,消费令牌的意味) 不论是对于令牌桶拿不到令牌被拒绝,还是漏桶的水满了溢出,都是为了保证大部分流量的正常使用,而牺牲掉了少部分流量,这是合理的,如果因为极少部分流量需要保证的话,那么就可能导致系统达到极限而挂掉,得不偿失。 限流神器:Guava RateLimiter Guava不仅仅在集合、缓存、异步回调等方面功能强大,而且还给我们封装好了限流的API! Guava RateLimiter基于令牌桶算法,我们只需要告诉RateLimiter系统限制的QPS是多少,那么RateLimiter将以这个速度往桶里面放入令牌,然后请求的时候,通过tryAcquire()方法向RateLimiter获取许可(令牌)。 分布式场景下的限流 上面所说的限流的一些方式,都是针对单机而言的,其实大部分的场景,单机的限流已经足够了。分布式下限流的手段常常需要多种技术相结合,比如Nginx+Lua,Redis+Lua等去做。本文主要讨论的是单机的限流,这里就不在详细介绍分布式场景下的限流了。 一句话,让系统的流量,先到队列中排队、限流,不要让流量直接打到系统上。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-07-17本文作者:张丰哲本文来自:“互联网架构师”,了解相关信息可以关注“互联网架构师”

优秀的个人博客,低调大师

Redis Cluster 原理详解,应付面试官就看这一篇!

Redis 缓存作为使用最多的缓存工具被各大厂商争相使用。通常我们会使用单体的 Redis 应用作为缓存服务,为了保证其高可用还会使用主从模式(Master-Slave),又或者是读写分离的设计。但是当缓存数据量增加以后,无法用单体服务器承载缓存服务时,就需要对缓存服务进行扩展。将需要缓存的数据切分成不同的分区,将数据分区放到不同的服务器中,用分布式的缓存来承载高并发的缓存访问。恰好 Redis Cluster 方案刚好支持这部分功能。 今天就来一起看看 Redis Cluster 的核心原理和实践: Redis Cluster 实现数据分区 分布式缓存节点之间的通讯 请求分布式缓存的路由 缓存节点的扩展和收缩 故障发现和恢复 Redis Cluster 实现数据分区 正如开篇中提到的,分布式数据库要解决的就是将整块数据,按照规则分配到多个缓存节点,解决的是单个缓存节点处理数量大的问题。如果要将这些数据进行拆分,并且存放必须有一个算法。例如:哈希算法和哈希一致性算法,这些比较经典的算法。 Redis Cluster 则采用的是虚拟槽分区算法。其中提到了槽(Slot)的概念。这个槽是用来存放缓存信息的单位,在 Redis 中将存储空间分成了 16384 个槽,也就是说 Redis Cluster 槽的范围是 0 -16383(2^4 * 2^10)。 缓存信息通常是用 Key-Value 的方式来存放的,在存储信息的时候,集群会对 Key 进行 CRC16 校验并对 16384 取模(slot = CRC16(key)%16383)。 得到的结果就是 Key-Value 所放入的槽,从而实现自动分割数据到不同的节点上。然后再将这些槽分配到不同的缓存节点中保存。图1:Redis 集群中的数据分片 如图 1 所示,假设有三个缓存节点分别是 1、2、3。Redis Cluster 将存放缓存数据的槽(Slot)分别放入这三个节点中:缓存节点 1 存放的是(0-5000)Slot 的数据。缓存节点 2 存放的是(5001-10000)Slot 的数据。缓存节点 3 存放的是(10000-16383)Slot 的数据。 此时 Redis Client 需要根据一个 Key 获取对应的 Value 的数据,首先通过 CRC16(key)%16383 计算出 Slot 的值,假设计算的结果是 5002。 将这个数据传送给 Redis Cluster,集群接受到以后会到一个对照表中查找这个 Slot=5002 属于那个缓存节点。 发现属于“缓存节点 2”,于是顺着红线的方向调用缓存节点 2 中存放的 Key-Value 的内容并且返回给 Redis Client。 分布式缓存节点之间的通讯 如果说 Redis Cluster 的虚拟槽算法解决的是数据拆分和存放的问题,那么存放缓存数据的节点之间是如何通讯的,就是接下来我们要讨论的。 缓存节点中存放着缓存的数据,在 Redis Cluster 的分布式部署下,缓存节点会被分配到一台或者多台服务器上。图 2:新上线的缓存节点 2 和缓存节点 1 进行通讯 缓存节点的数目也有可能根据缓存数据量和支持的并发进行扩展。如图 2 所示,假设 Redis Cluster 中存在“缓存节点 1”,此时由于业务扩展新增了“缓存节点 2”。 新加入的节点会通过 Gossip 协议向老节点,发出一个“Meet 消息”。收到消息以后“缓存节点 1”,会礼貌地回复一个“Pong 消息”。 此后“缓存节点 2”会定期发送给“缓存节点 1” 一个“Ping 消息”,同样的“缓存节点 1”每次都会回复“Pong 消息”。 上面这个例子说明了,在 Redis Cluster 中缓存节点之间是通过 Gossip 协议进行通讯的。 其实节点之间通讯的目的是为了维护节点之间的元数据信息。这个元数据就是每个节点包含哪些数据,是否出现故障。 节点之间通过 Gossip 协议不断相互交互这些信息,就好像一群人在一起八卦一样,没有多久每个节点就知道其他所有节点的情况了,这个情况就是节点的元数据。 整个传输过程大致分为以下几点:Redis Cluster 的每个缓存节点都会开通一个独立的 TCP 通道,用于和其他节点通讯。有一个节点定时任务,每隔一段时间会从系统中选出“发送节点”。这个“发送节点”按照一定频率,例如:每秒 5 次,随机向最久没有通讯的节点发起 Ping 消息。接受到 Ping 消息的节点会使用 Pong 消息向“发送节点”进行回复。 不断重复上面行为,让所有节点保持通讯。他们之间通讯是通过 Gossip 协议实现的。 从类型上来说其分为了四种,分别是:Meet 消息,用于通知新节点加入。就好像上面例子中提到的新节点上线会给老节点发送 Meet 消息,表示有“新成员”加入。Ping 消息,这个消息使用得最为频繁,该消息中封装了自身节点和其他节点的状态数据,有规律地发给其他节点。Pong 消息,在接受到 Meet 和 Ping 消息以后,也将自己的数据状态发给对方。同时也可以对集群中所有的节点发起广播,告知大家的自身状态。Fail 消息,如果一个节点下线或者挂掉了,会向集群中广播这个消息。图 3:Gossip 协议结构 Gossip 协议的结构如图 3 所示,有其中 type 定义了消息的类型,例如:Meet、Ping、Pong、Fail 等消息。 另外有一个 myslots 的数组定义了节点负责的槽信息。每个节点发送 Gossip 协议给其他节点最重要的就是将该信息告诉其他节点。另外,消息体通过 clusterMsgData 对象传递消息征文。 请求分布式缓存的路由 对内,分布式缓存的节点通过 Gossip 协议互相发送消息,为了保证节点之间了解对方的情况。 那么对外来说,一个 Redis 客户端如何通过分布式节点获取缓存数据,就是分布式缓存路由要解决的问题了。 上文提到了 Gossip 协议会将每个节点管理的槽信息发送给其他节点,其中用到了 unsigned char myslots[CLUSTER_SLOTS/8] 这样一个数组存放每个节点的槽信息。 myslots 属性是一个二进制位数组(bit array),其中 CLUSTER_SLOTS 为 16384。 这个数组的长度为 16384/8=2048 个字节,由于每个字节包含 8 个 bit 位(二进制位),所以共包含 16384 个 bit,也就是 16384 个二进制位。 每个节点用 bit 来标识自己是否拥有某个槽的数据。如图 4 所示,假设这个图表示节点 A 所管理槽的情况。图 4:通过二进制数组存放槽信息 0、1、2 三个数组下标就表示 0、1、2 三个槽,如果对应的二进制值是 1,表示该节点负责存放 0、1、2 三个槽的数据。同理,后面的数组下标位 0 就表示该节点不负责存放对应槽的数据。 用二进制存放的优点是,判断的效率高,例如对于编号为 1 的槽,节点只要判断序列的第二位,时间复杂度为 O(1)。图 5:接受节点把节点槽的对应信息保存在本地 如图 5 所示,当收到发送节点的节点槽信息以后,接受节点会将这些信息保存到本地的 clusterState 的结构中,其中 Slots 的数组就是存放每个槽对应哪些节点信息。图 6:ClusterStatus 结构以及槽与节点的对应 如图 6 所示,ClusterState 中保存的 Slots 数组中每个下标对应一个槽,每个槽信息中对应一个 clusterNode 也就是缓存的节点。 这些节点会对应一个实际存在的 Redis 缓存服务,包括 IP 和 Port 的信息。 Redis Cluster 的通讯机制实际上保证了每个节点都有其他节点和槽数据的对应关系。 Redis 的客户端无论访问集群中的哪个节点都可以路由到对应的节点上,因为每个节点都有一份 ClusterState,它记录了所有槽和节点的对应关系。 下面来看看 Redis 客户端是如何通过路由来调用缓存节点的:图 7:MOVED 重定向请求 如图 7 所示,Redis 客户端通过 CRC16(key)%16383 计算出 Slot 的值,发现需要找“缓存节点 1”读/写数据,但是由于缓存数据迁移或者其他原因导致这个对应的 Slot 的数据被迁移到了“缓存节点 2”上面。 那么这个时候 Redis 客户端就无法从“缓存节点 1”中获取数据了。 但是由于“缓存节点 1”中保存了所有集群中缓存节点的信息,因此它知道这个 Slot 的数据在“缓存节点 2”中保存,因此向 Redis 客户端发送了一个 MOVED 的重定向请求。 这个请求告诉其应该访问的“缓存节点 2”的地址。Redis 客户端拿到这个地址,继续访问“缓存节点 2”并且拿到数据。 上面的例子说明了,数据 Slot 从“缓存节点 1”已经迁移到“缓存节点 2”了,那么客户端可以直接找“缓存节点 2”要数据。 那么如果两个缓存节点正在做节点的数据迁移,此时客户端请求会如何处理呢?图 8:ASK 重定向请求 如图 8 所示,Redis 客户端向“缓存节点 1”发出请求,此时“缓存节点 1”正向“缓存节点 2”迁移数据,如果没有命中对应的 Slot,它会返回客户端一个 ASK 重定向请求并且告诉“缓存节点 2”的地址。 客户端向“缓存节点 2”发送 Asking 命令,询问需要的数据是否在“缓存节点 2”上,“缓存节点 2”接到消息以后返回数据是否存在的结果。 缓存节点的扩展和收缩 作为分布式部署的缓存节点总会遇到缓存扩容和缓存故障的问题。这就会导致缓存节点的上线和下线的问题。 由于每个节点中保存着槽数据,因此当缓存节点数出现变动时,这些槽数据会根据对应的虚拟槽算法被迁移到其他的缓存节点上。图 9:分布式缓存扩容 如图 9 所示,集群中本来存在“缓存节点 1”和“缓存节点 2”,此时“缓存节点 3”上线了并且加入到集群中。 此时根据虚拟槽的算法,“缓存节点 1”和“缓存节点 2”中对应槽的数据会应该新节点的加入被迁移到“缓存节点 3”上面。 针对节点扩容,新建立的节点需要运行在集群模式下,因此新建节点的配置最好与集群内其他节点配置保持一致。 新节点加入到集群的时候,作为孤儿节点是没有和其他节点进行通讯的。因此,其会采用 cluster meet 命令加入到集群中。 在集群中任意节点执行 cluster meet 命令让新节点加入进来。假设新节点是 192.168.1.1 5002,老节点是 192.168.1.1 5003,那么运行以下命令将新节点加入到集群中。192.168.1.1 5003> cluster meet 192.168.1.1 5002 这个是由老节点发起的,有点老成员欢迎新成员加入的意思。新节点刚刚建立没有建立槽对应的数据,也就是说没有缓存任何数据。 如果这个节点是主节点,需要对其进行槽数据的扩容;如果这个节点是从节点,就需要同步主节点上的数据。总之就是要同步数据。图 10:节点迁移槽数据的过程 如图 10 所示,由客户端发起节点之间的槽数据迁移,数据从源节点往目标节点迁移:客户端对目标节点发起准备导入槽数据的命令,让目标节点准备好导入槽数据。这里使用 cluster setslot {slot} importing {sourceNodeId} 命令。之后对源节点发起送命令,让源节点准备迁出对应的槽数据。使用命令 cluster setslot {slot} importing {sourceNodeId}。此时源节点准备迁移数据了,在迁移之前把要迁移的数据获取出来。通过命令 cluster getkeysinslot {slot} {count}。Count 表示迁移的 Slot 的个数。然后在源节点上执行,migrate {targetIP} {targetPort} “” 0 {timeout} keys{keys} 命令,把获取的键通过流水线批量迁移到目标节点。重复 3 和 4 两步不断将数据迁移到目标节点。目标节点获取迁移的数据。完成数据迁移以后目标节点,通过 cluster setslot {slot} node {targetNodeId} 命令通知对应的槽被分配到目标节点,并且广播这个信息给全网的其他主节点,更新自身的槽节点对应表。 既然有缓存服务器的上线操作,那么也有下线的操作。下线操作正好和上线操作相反,将要下线缓存节点的槽数据分配到其他的缓存主节点中。 迁移的过程也与上线操作类似,不同的是下线的时候需要通知全网的其他节点忘记自己,此时通过命令 cluster forget{downNodeId} 通知其他的节点。 当节点收到 forget 命令以后会将这个下线节点放到仅用列表中,那么之后就不用再向这个节点发送 Gossip 的 Ping 消息了。 不过这个仅用表的超时时间是 60 秒,超过了这个时间,依旧还会对这个节点发起 Ping 消息。 不过可以使用 redis-trib.rb del-node{host:port} {donwNodeId} 命令帮助我们完成下线操作。 尤其是下线的节点是主节点的情况下,会安排对应的从节点接替主节点的位置。 故障发现和恢复 前面在谈到缓存节点扩展和收缩是提到,缓存节点收缩时会有一个下线的动作。 有些时候是为了节约资源,或者是计划性的下线,但更多时候是节点出现了故障导致下线。 针对下线故障来说有两种下线的确定方式: 主观下线:当节点 1 向节点 2 例行发送 Ping 消息的时候,如果节点 2 正常工作就会返回 Pong 消息,同时会记录节点 1 的相关信息。 同时接受到 Pong 消息以后节点 1 也会更新最近一次与节点 2 通讯的时间。 如果此时两个节点由于某种原因断开连接,过一段时间以后节点 1 还会主动连接节点 2,如果一直通讯失败,节点 1 中就无法更新与节点 2 最后通讯时间了。 此时节点 1 的定时任务检测到与节点 2 最好通讯的时间超过了 cluster-node-timeout 的时候,就会更新本地节点状态,把节点 2 更新为主观下线。 这里的 cluster-node-timeout 是节点挂掉被发现的超时时间,如果超过这个时间还没有获得节点返回的 Pong 消息就认为该节点挂掉了。 这里的主观下线指的是,节点 1 主观的认为节点 2 没有返回 Pong 消息,因此认为节点 2 下线。 只是节点 1 的主观认为,有可能是节点 1 与节点 2 之间的网络断开了,但是其他的节点依旧可以和节点 2 进行通讯,因此主观下线并不能代表某个节点真的下线了。 客观下线:由于 Redis Cluster 的节点不断地与集群内的节点进行通讯,下线信息也会通过 Gossip 消息传遍所有节点。 因此集群内的节点会不断收到下线报告,当半数以上持有槽的主节点标记了某个节点是主观下线时,便会触发客观下线的流程。 也就是说当集群内的半数以上的主节点,认为某个节点主观下线了,才会启动这个流程。 这个流程有一个前提,就是直针对主节点,如果是从节点就会忽略。也就是说集群中的节点每次接受到其他节点的主观下线是都会做以下的事情。 将主观下线的报告保存到本地的 ClusterNode 的结构中,并且针对主观下线报告的时效性进行检查,如果超过 cluster-node-timeout*2 的时间,就忽略这个报告。 否则就记录报告内容,并且比较被标记下线的主观节点的报告数量大于等于持有槽的主节点数量的时候,将其标记为客观下线。 同时向集群中广播一条 Fail 消息,通知所有的节点将故障节点标记为客观下线,这个消息指包含故障节点的 ID。 此后,群内所有的节点都会标记这个节点为客观下线,通知故障节点的从节点出发故障转移的流程,也就是故障的恢复。 说白了,客观下线就是整个集群中有一半的节点都认为某节点主观下线了,那么这个节点就被标记为客观下线了。 如果某个主节点被认为客观下线了,那么需要从它的从节点中选出一个节点替代主节点的位置。 此时下线主节点的所有从节点都担负着恢复义务,这些从节点会定时监测主节点是否下线。 一旦发现下线会走如下的恢复流程: ①资格检查,每个节点都会检查与主节点断开的时间。如果这个时间超过了 cluster-node-timeout*cluster-slave-validity-factor(从节点有效因子,默认为 10),那么就没有故障转移的资格。 也就是说这个从节点和主节点断开的太久了,很久没有同步主节点的数据了,不适合成为新的主节点,因为成为主节点以后其他的从节点回同步自己的数据。 ②触发选举,通过了上面资格的从节点都可以触发选举。但是出发选举是有先后顺序的,这里按照复制偏移量的大小来判断。 这个偏移量记录了执行命令的字节数。主服务器每次向从服务器传播 N 个字节时就会将自己的复制偏移量+N,从服务在接收到主服务器传送来的 N 个字节的命令时,就将自己的复制偏移量+N。 复制偏移量越大说明从节点延迟越低,也就是该从节点和主节点沟通更加频繁,该从节点上面的数据也会更新一些,因此复制偏移量大的从节点会率先发起选举。 ③发起选举,首先每个主节点会去更新配置纪元(clusterNode.configEpoch),这个值是不断增加的整数。 在节点进行 Ping/Pong 消息交互式也会更新这个值,它们都会将最大的值更新到自己的配置纪元中。 这个值记录了每个节点的版本和整个集群的版本。每当发生重要事情的时候,例如:出现新节点,从节点精选。都会增加全局的配置纪元并且赋给相关的主节点,用来记录这个事件。 说白了更新这个值目的是,保证所有主节点对这件“大事”保持一致。大家都统一成一个配置纪元(一个整数),表示大家都知道这个“大事”了。 更新完配置纪元以后,会想群内发起广播选举的消息(FAILOVER_AUTH_REQUEST)。并且保证每个从节点在一次配置纪元中只能发起一次选举。 ④投票选举,参与投票的只有主节点,从节点没有投票权,超过半数的主节点通过某一个节点成为新的主节点时投票完成。 如果在 cluster-node-timeout*2 的时间内从节点没有获得足够数量的票数,本次选举作废,进行第二轮选举。 这里每个候选的从节点会收到其他主节点投的票。在第2步领先的从节点通常此时会获得更多的票,因为它触发选举的时间更早一些。 获得票的机会更大,也是由于它和原主节点延迟少,理论上数据会更加新一点。 ⑤当满足投票条件的从节点被选出来以后,会触发替换主节点的操作。新的主节点别选出以后,删除原主节点负责的槽数据,把这些槽数据添加到自己节点上。 并且广播让其他的节点都知道这件事情,新的主节点诞生了。 总结 本文通过 Redis Cluster 提供了分布式缓存的方案为出发点,针对此方案中缓存节点的分区方式进行了描述。 虚拟槽的分区算法,将整块数据分配到了不同的缓存节点,通过 Slot 和 Node 的对应关系让数据找到节点的位置。 对于分布式部署的节点,需要通过 Gossip 协议进行 Ping、Pong、Meet、Fail 的通讯,达到互通有无的目的。 当客户端调用缓存节点数据的时候通过 MOVED 和 ASKED 重定向请求找到正确的缓存节点。 并且介绍了在缓存扩容和收缩时需要注意的处理流程,以及数据迁移的方式。 最后,讲述如何发现故障(主观下线和客观下线)以及如何恢复故障(选举节点)的处理流程。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册