首页 文章 精选 留言 我的

精选列表

搜索[计算机组成原理],共10000篇文章
优秀的个人博客,低调大师

基于循环队列的BFS原理及实现

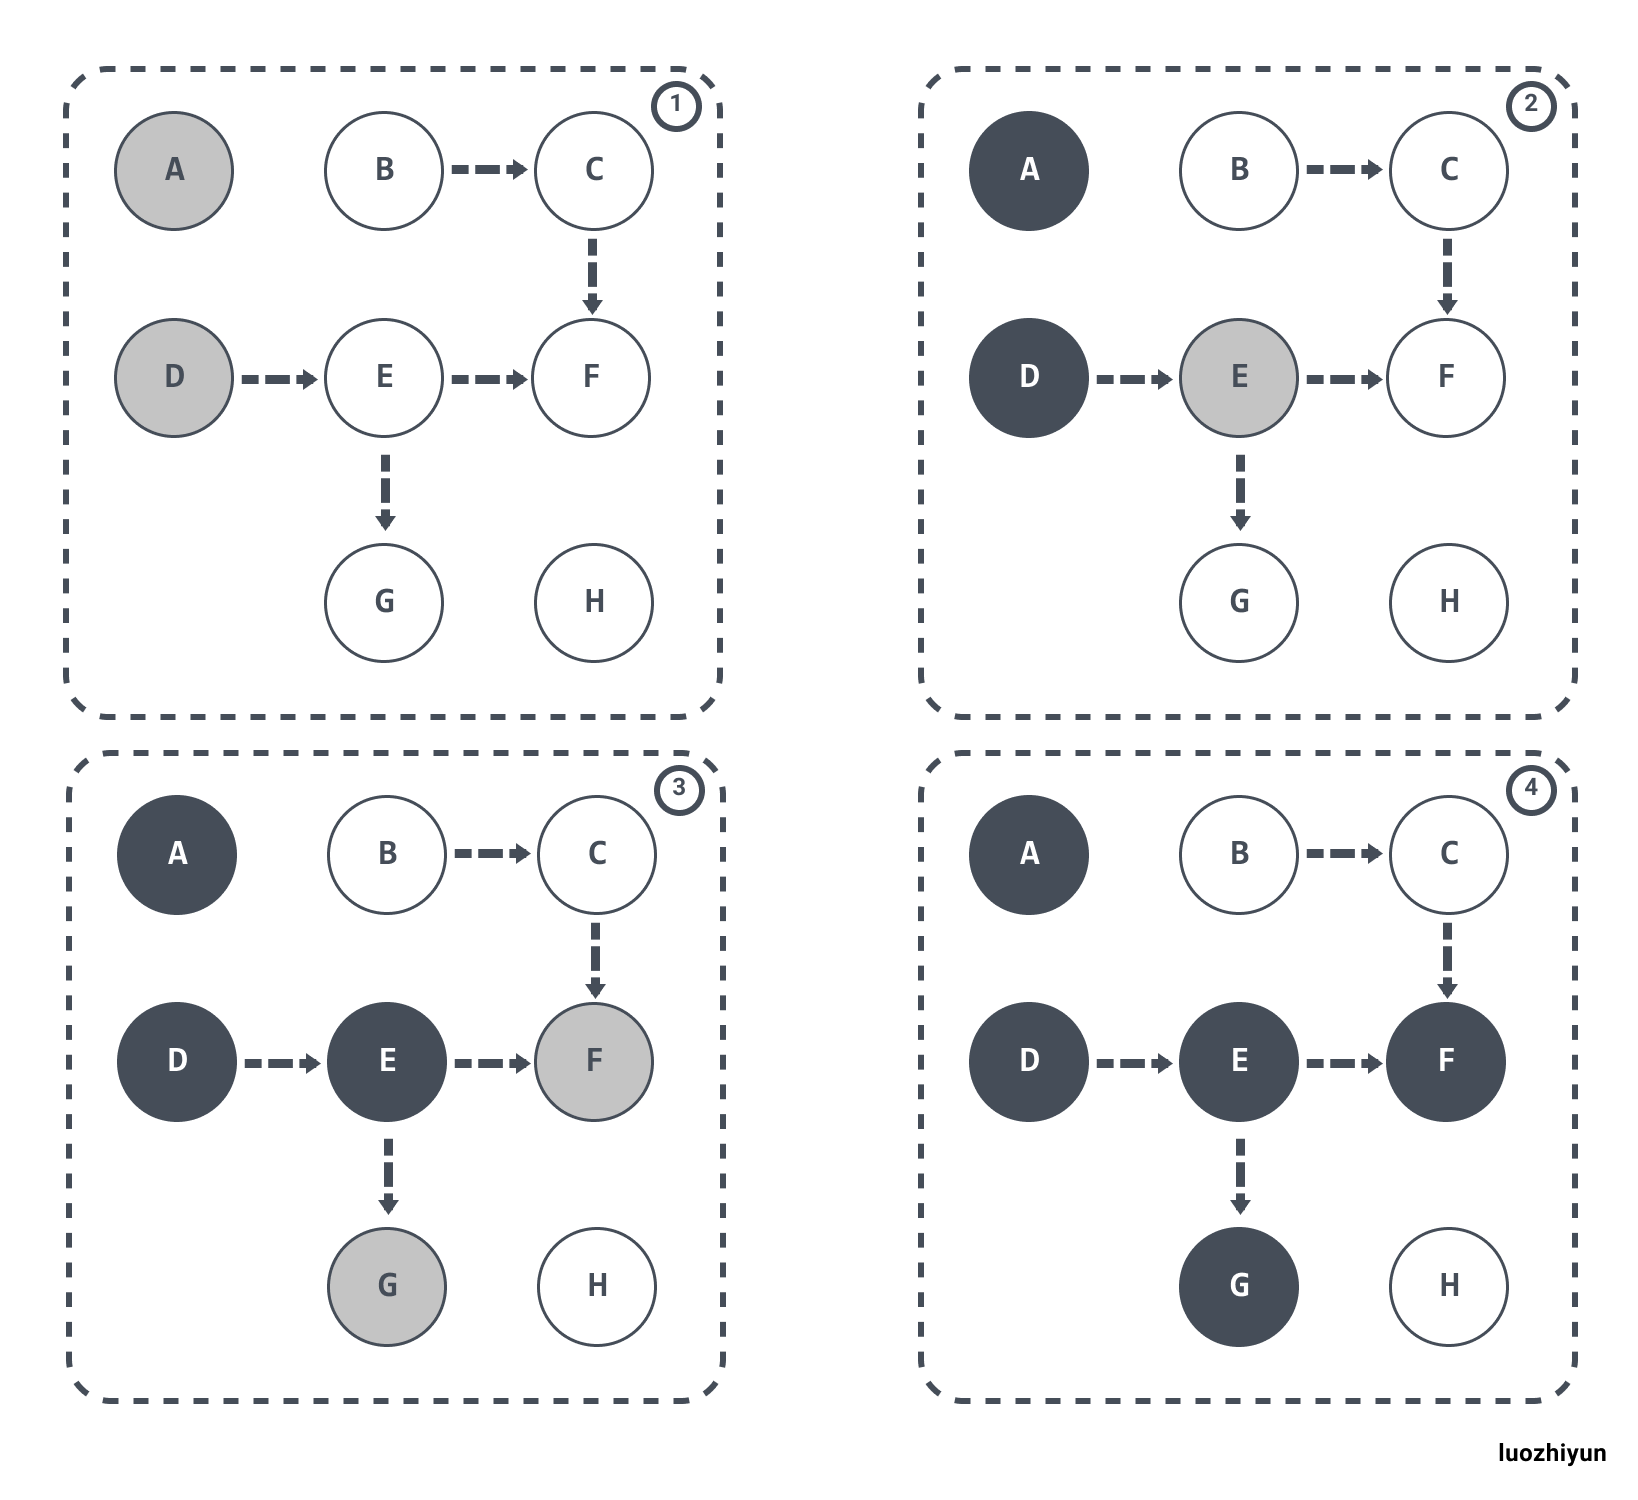
1.故事起源 有一只蚂蚁出去寻找食物,无意中进入了一个迷宫。蚂蚁只能向上、下、左、右4个方向走,迷宫中有墙和水的地方都无法通行。这时蚂蚁犯难了,怎样才能找出到食物的最短路径呢? 2.思考 蚂蚁在起点时,有4个选择,可以向上、下、左、右某一个方向走1步。 如果蚂蚁走过了一段距离,此时也依然只有4个选择。 当然要排除之前走过的地方(不走回头路,走了也只会更长)和无法通过的墙和水。 蚂蚁想,还好我会影分身。如果每一步都分身成4个蚂蚁,向4个方向各走1步,这样最先找到食物的肯定就是最短的路径了(因为每一步都把能走的地方都走完了,肯定找不出更短的路径了)。 而且还能看出,第1步会到达所有到起点距离为1的地方,第2步也会到达所有距离为2的地方。 如此类推,第n步会覆盖所有到起点最短距离为n的地方。 3.问题建模 把迷宫地图放在二维数组中,能通行的地方为0,墙和水的地方为负数。 每一步向4个方向走,可以通过当前坐标(x,y)加上一个方向向量。 这个其实就是宽度优先搜索(BFS)的思想。 4.宽度优先搜索(BFS) 又称广度优先搜索,优先向四周扩展子节点,是最简便的图的搜索算法之一,一般通过队列来实现。 4.1 队列 是一种特殊的线性表,它只允许在表的前端进行删除操作,而在表的后端进行插入操作,即先进先出。 队列一般通过数组实现,对该数组增加一些操作上的限制。 但上面的实现有一些缺陷,当队列满时,也就是tail指针移动到队尾,这时就无法再插入数据,但前面的元素已经出队了,可能还有空缺的位置。 为了能高效利用空间,对该队列增加一点改进,也就是循环队列的产生。 4.2 循环队列 把队列想象成一个首尾相接的环形。 数组实现,需要多预留一个空间。如果head=tail时,无法判断是队空还是队满,所以占用一个空间,通过tail+1与head的关系来判断是否队满。 4.3 队列实现BFS 实现步骤如下: 将起点加入队列。 从队首取出一个节点,通过该节点向4个方向扩展子节点,并依次加入队尾。 重复以上步骤,直至队空或已找到目标位置。 回归迷宫问题,到起点的距离为1,2,3...的点会依次入队。 当head指针遍历到距离为2的点时,向4周扩展距离为3的节点,并继续入队。 5.代码实现 5.1 变量定义 //方向向量 constintdirection[4][2]={{0,1}, {-1,0}, {0,-1}, {1,0}}; constintMAXM=100,MAXN=100,QUEUE_LENGTH=5; //队列中的节点 structNode{ intx,y,distance; Node(){} Node(intxx,intyy,intd):x(xx),y(yy),distance(d){} }; intn,m,step=0,map[MAXM][MAXN],visit[MAXM][MAXN]; Nodestart,target; 5.2 BFS标准模板 voidbfs(){ Nodequeue[QUEUE_LENGTH]; inthead=0,tail=1; queue[0]=Node(start.x,start.y,0); visit[start.x][start.y]=0; while(head!=tail){ intx=queue[head].x; inty=queue[head].y; intdistance=queue[head].distance; head=(head+1)%QUEUE_LENGTH; for(inti=0;i<4;++i){ intdx=x+direction[i][0]; intdy=y+direction[i][1]; if(dx>=0&&dx<m&&dy>=0&&dy<n&&visit[dx][dy]==-1&&map[dx][dy]>=0){ //表示从i方向走过来的,方便后续回溯路径 visit[dx][dy]=i; if(dx==target.x&&dy==target.y){ cout<<"已到目标点,最短距离为"<<distance+1<<endl; step=distance+1; return; } if((tail+1)%QUEUE_LENGTH==head){ cout<<"队列满"<<endl; return; } //新坐标入队 queue[tail]=Node(dx,dy,distance+1); tail=(tail+1)%(QUEUE_LENGTH); } } } } 5.3 路径回溯 voidprintPath(){ intx,y,d,path[MAXM][MAXN]={0}; for(inti=0;i<m;++i){ for(intj=0;j<n;++j){ path[i][j]=-1; } } x=target.x; y=target.y; path[start.x][start.y]=0; //路径回溯 while(!(x==start.x&&y==start.y)){ path[x][y]=step--; d=visit[x][y]; x-=direction[d][0]; y-=direction[d][1]; } //路径打印 for(inti=0;i<m;++i){ for(intj=0;j<n;++j){ if(path[i][j]>=0){ cout<<path[i][j]; }else{ cout<<"-"; } } cout<<endl; } } 5.4 数据输入 intmain(){ cin>>m>>n; for(inti=0;i<m;++i){ for(intj=0;j<n;++j){ cin>>map[i][j]; visit[i][j]=-1; } } cin>>start.x>>start.y>>target.x>>target.y; bfs(); if(step>0)printPath(); return0; } 5.5 测试结果 输入数据: 55 00-100 0000-2 -10-200 000-10 0-2000 1143 输出: 已到目标点,最短距离为5 路径打印: ----- -0--- -1--- -23-- --45- 关注我,涨知识,微信公众号:几何思维 往期精彩回顾 老鼠与毒药 经典逻辑面试题,高楼扔鸡蛋 通过6人介绍可以认识世界上任何一个人?

优秀的个人博客,低调大师

kafka快速实战与原理了解(1)

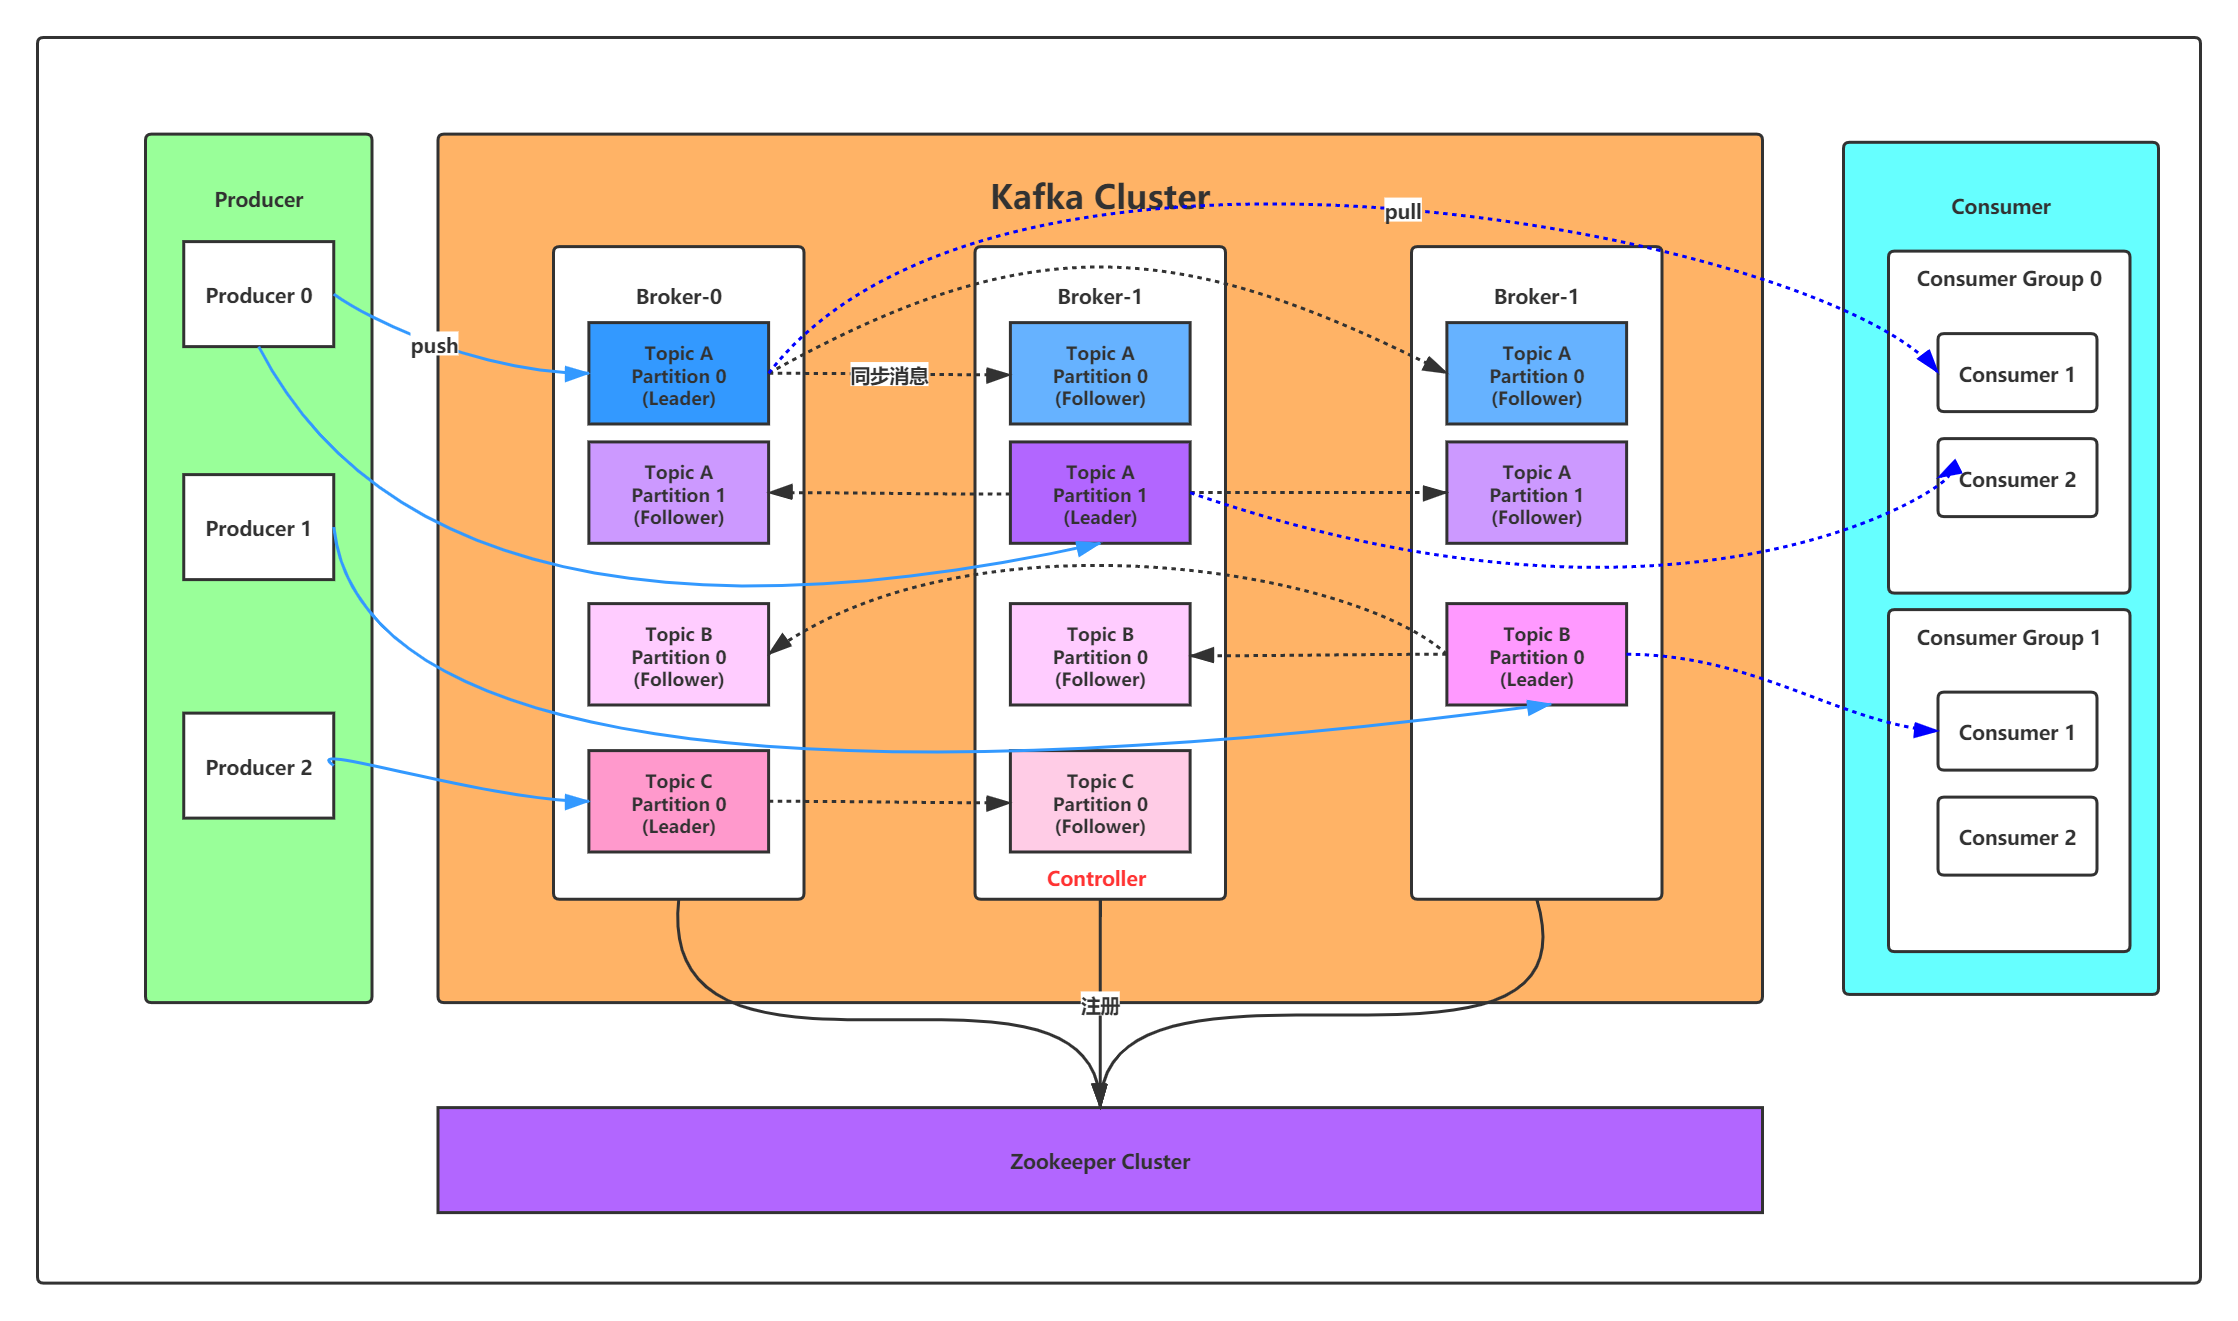
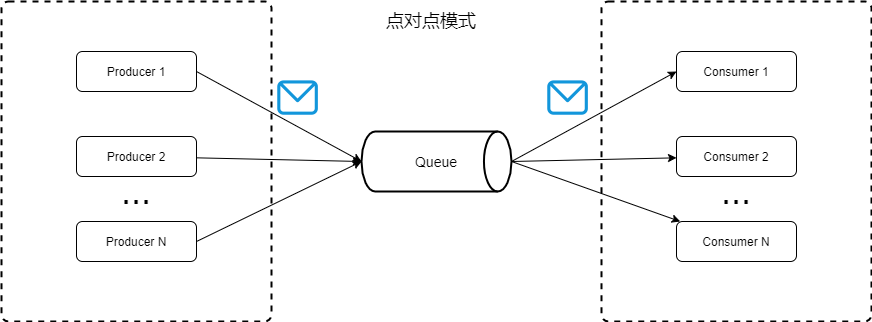
基本介绍 最初由Linkedin公司开发,2010捐给Apache 特性:分布式、分区、多副本 基于zk协调的分布式消息系统 可实时处理大数据量消息 应用场景:基于hadoop的批处理、Spark流失处理、web服务器日志、系统访问日志等 scala语言开发 业务应用场景 日志手机 消息系统 用户行为跟踪 运营指标监控 基本概念 Broker:消息处理节点,可理解为就是一个kafka节点 Topic:对消息进行归类 Producer/Consumer:生产者与消费者 ConsumerGroup:消费组,一条消息可被多个不同消费组消费,同一消费组内,只有一个消费者能消费某条消息 Partition:分区,物理概念,一个Topic可分为多个分区,每个分区内的消息是有序的;个人理解与RocketMQ中的Queue概念相似 基本使用 环境准备:kafka为Scala语言开发,需运行在jvm上,所以需准备JDK环境 kafka依赖zk做协调器,需安装zk 下载kafka,主要修改config/server.properties 关键属性: #broker.id属性在kafka集群中必须要是唯一 broker.id=0 #kafka部署的机器ip和提供服务的端口号 listeners=PLAINTEXT://192.168.65.60:9092 #kafka的消息存储文件 log.dir=/usr/local/data/kafka-logs #kafka连接zookeeper的地址,ZK集群以逗号隔开 zookeeper.connect=192.168.65.60:2181 启动脚本语法:kafka-server-start.sh [-daemon] server.properties 启动后可进入zk查看zk下的节点数据 停止:bin/kafka-server-stop.sh 创建主题 主题默认:分区数为1,副本数为1,最小写成功数为1 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 1 --topic test 主题在生产者发布消息时若不存在,则会自动创建 发送消息 自带bin/kafka-console-producer.sh命令客户端 bin/kafka-console-producer.sh --broker-list 192.168.65.60:9092 --topic test >this is a msg >this is a another msg 消费消息 自带消费消息命令终端:bin/kafka-console-consumer.sh bin/kafka-console-consumer.sh --bootstrap-server 192.168.65.60:9092 --topic test 带参数--from-beginning,表示可消费之前全部消息 带参数--whitelist "test|test-2" 同时消费多个主题 单播与多播 单播:一条消息只让一个消费者消费,类似Queue模式;我们让所有消费者在同一个消费者内即可实现; 多播:一条消息可让多个消费者同时都消费,类似发布订阅模式;我们让每个消费者存在不同消费组即可实现; 其他命令 // 查看消费组组名 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --list // 查看消费组消费偏移量 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --describe --group testGroup current-offset:当前消费组的已消费偏移量 log-end-offset:主题对应分区消息的结束偏移量(HW) lag:当前消费组未消费的消息数 Topic与Log Topic即为一个消息类别名称,同类消息一般发到同一Topic下 每个Topic下对应有多个分区日志文件 分区是一个有序的消息队列,消息被按序添加到commit log文件中 每个消息在一个分区中有唯一的标识,称为offset 不同分区中的消息,其offset可能相同 消息一般不会自动删除,默认被保留约最近7天 消费者基于自己在提交日志中消费的进度(offset)进行工作 offset由消费者自己维护 所以消费者可按序逐条消费commit log消息,也可指定offset来重复或跳过消费某些消息 // 创建2个分区的主题 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 2 --topic test1 查看下topic的情况 bin/kafka-topics.sh --describe --zookeeper 192.168.65.60:2181 --topic test1 leader节点:负责给定分区的所有读写请求 replicas节点:某分区存在的备份,不管是不是leader,甚至中途挂了都会列出 isr:是replicas的子集,只列存活且一同步备份了该分区的节点 消息日志主要存在分区文件夹以log结尾的文件 目前支持对topic分区数据量进行动态扩容,单不支持缩减 思考:为什么需要分区? 日志文件受到机器文件大小限制,分区后则可将不同分区放到集群中的不同机器上,相当于分布式存储;其次为了提高生产消息与消费消息的并行度;

优秀的个人博客,低调大师

ReentrantReadWriteLock读写锁简单原理案例证明

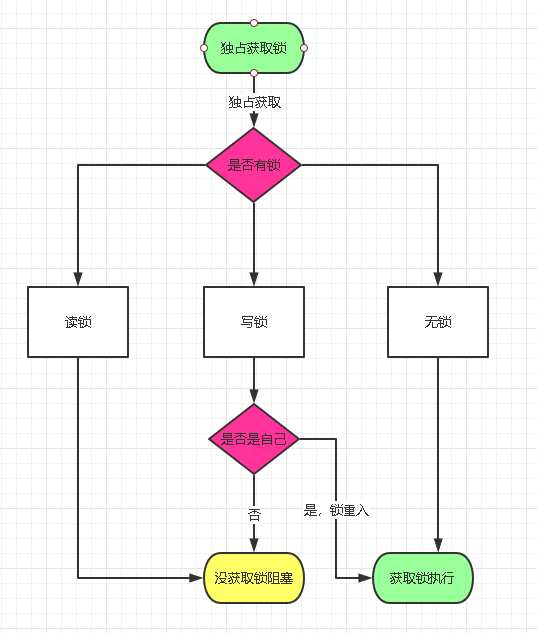
ReentrantReadWriteLock存在原因? 我们知道List的实现类ArrayList,LinkedList都是非线程安全的,Vector类通过用synchronized修饰方法保证了List的多线程非安全问题,但是有个缺点:读写同步,效率低下。于是就出现了CopyOnWriteArrayList,它通过写时复制数组实现了读写分离,提高了多线程对List读的效率,适合多读少些的情况。同理:我们知道ReentrantLock,它是一把独占的锁,是用来控制线程同步的,如果我们用ReentrantLock来实现ArrayList安全,能否达到CopyOnWriteArrayList同样的效果呢? importjava.util.ArrayList; importjava.util.List; importjava.util.concurrent.locks.ReentrantReadWriteLock; /** *@author:jiaolian *@date:Createdin2021-01-2615:49 *@description:ReentrantReadWriteLock多读少写的场景 *@modifiedBy: *公众号:叫练 */ publicclassMultReadTest{ privatestaticclassMyList{ privatefinalReentrantReadWriteLockREENTRANT_READ_WRITE_LOCK=newReentrantReadWriteLock(); privatefinalReentrantReadWriteLock.WriteLockWRITE_LOCK=REENTRANT_READ_WRITE_LOCK.writeLock(); privatefinalReentrantReadWriteLock.ReadLockREAD_LOCK=REENTRANT_READ_WRITE_LOCK.readLock(); privateList<String>list=newArrayList(); //读list publicvoidreadList(){ try{ READ_LOCK.lock(); Thread.sleep(1000); System.out.println(Thread.currentThread().getName()+":"+list.size()); }catch(InterruptedExceptione){ e.printStackTrace(); }finally{ READ_LOCK.unlock(); } } //写list publicvoidwriteList(){ try{ WRITE_LOCK.lock(); Thread.sleep(1000); System.out.println(Thread.currentThread().getName()+":新增1个元素"); list.add("叫练【公众号】"); }catch(InterruptedExceptione){ e.printStackTrace(); }finally{ WRITE_LOCK.unlock(); } } } publicstaticvoidmain(String[]args){ MyListmyList=newMyList(); //读写锁适合多读少写情况 //新建10个读线程,1个写线程 newThread(()->{myList.writeList();},"写线程").start(); for(inti=0;i<10;i++){ newThread(()->{myList.readList();},"读线程"+(i+1)).start(); } } } 上面案例我们用ReentrantReadWriteLock实现了CopyOnWriteArrayList,主线程新建了1个写线程写list,10个读线程读list,程序一共花费2执行完毕,如果用Vector需要花费11秒。在多线程的情况下,通过读写锁操作List,提高了List的读效率,在List读的部分,线程是共享的,在对List写的过程中,在对写的线程是同步的,因此我们可以得出一个结论:读写锁是读读共享,读写同步! 独占获取锁简单流程 如上图,我们简单的梳理下独占获取锁流程。 独占锁获取(上述例子中的WRITE_LOCK写锁),首先判断是否有线程获取了锁,是否有线程获取了锁的判断通过读写锁中通过32位int类型state可以获取,其中低16位表示读锁,高16表示写锁。 有读锁:直接排队阻塞。 有写锁:还需要判断写锁线程是否是自己,如果是自己就是锁重入了,如果不是自己说明已经有其他的线程获取锁正在执行,那么当前线程需要排队阻塞。 无锁:直接获取锁,其他抢占的独占锁线程需要排队阻塞,当前线程执行完毕后释放锁通知下一个排队线程获取锁。 共享获取锁简单流程 如上图,我们简单的梳理下共享锁获取锁流程。 独占锁获取(上述例子中的READ_LOCK读锁),首先判断是否有线程获取了锁。 有读锁:当前线程发现此时读锁状态被占用,说明有线程获取了读锁。该线程通过cas自旋【死循环】获取到读锁为止。 有写锁:还需要判断持有写锁的线程是否是自己,如果是自己而且此时是获取的是读锁会获取锁成功,我们称为锁降级,如果不是自己说明此时有其他线程获取了写锁,那么当前线程需要排队阻塞。 无锁:直接获取锁。 写锁降级 我们说读写互斥,但同一个线程中,先写后读也是允许的,我们称之为锁降级。在面试中共享锁面试频率也比较高,方便理解我们举个简单的案例说明下。 importjava.util.concurrent.locks.ReentrantReadWriteLock; /** *@author:jiaolian *@date:Createdin2021-01-2815:44 *@description:ReentrantReadWriteLock读写锁降级测试 *@modifiedBy: *公众号:叫练 */ publicclassWriteLockLowerTest{ privatestaticfinalReentrantReadWriteLockREENTRANT_READ_WRITE_LOCK=newReentrantReadWriteLock(); privatestaticfinalReentrantReadWriteLock.WriteLockWRITE_LOCK=REENTRANT_READ_WRITE_LOCK.writeLock(); privatestaticfinalReentrantReadWriteLock.ReadLockREAD_LOCK=REENTRANT_READ_WRITE_LOCK.readLock(); publicstaticvoidmain(String[]args){ try{ WRITE_LOCK.lock(); System.out.println("获取写锁"); READ_LOCK.lock(); System.out.println("获取读锁"); }finally{ READ_LOCK.unlock(); System.out.println("释放写锁"); WRITE_LOCK.unlock(); System.out.println("释放读锁"); } } } 如上述代码:程序可以运行完毕,说明锁可以降级。另外说一句,上面的程序先获取读锁再获取写锁,程序是会阻塞的,为什么呢?欢迎小伙伴在留言区写下评论! 总结 今天我们用通俗易懂的文字描述了ReentrantReadWriteLock读写锁。喜欢的请点赞加评论哦!点关注,不迷路,我是叫练【公众号】,边叫边练。期待我们下次再见!

优秀的个人博客,低调大师

MyBatis内置DataSource连接池实现原理

前言 MyBatis是一个流行的ORM框架,它简单易用,支持自定义SQL、存储过程以及高级映射。MyBatis免除了几乎所有的JDBC代码以及设置参数和获取结果集的工作。 作为一款优秀的持久层框架,连接池是必不可少的。本文将分析MyBatis内置的数据源是如何实现连接池功能的(源码基于MyBatis3.4.5)。 JDBC对数据库的操作 回忆一下,我们用原生的JDBC来操作数据库的一般流程: public class JDBCExample { // JDBC driver name and database URL / credentials static final String JDBC_DRIVER = "com.mysql.jdbc.Driver"; static final String DB_URL = "jdbc:mysql://localhost/EMP"; static final String USER = "username"; static final String PASS = "password"; public List<User> queryUsers() { Connection conn = null; Statement stmt = null; ResultSet rs = null; List<User> users = new ArrayList<>(); try { // STEP 1: 注册driver Class.forName(JDBC_DRIVER); // STEP 2: 打开连接 conn = DriverManager.getConnection(DB_URL,USER,PASS); // STEP 3: 执行query stmt = conn.createStatement(); String sql = "SELECT ID, NAME, AGE FROM USER"; rs = stmt.executeQuery(sql); // STEP 4: 获取变量 while(rs.next()) { User user = new User(); user.setId(rs.getInt("ID")); user.setAge(rs.getInt("AGE")); user.setName(rs.getString("NAME")); users.add(user); } return users; } catch(SQLException | ClassNotFoundException e) { e.printStackTrace(); } finally { // STEP 5: 关闭资源 try { if (rs != null) rs.close(); if (stmt != null) stmt.close(); if (conn != null) conn.close(); } catch(SQLException se) { se.printStackTrace(); } } return users; } } 主要的步骤包括: 加载数据库驱动 获取数据库连接 执行SQL语句 从ResultSet获取结果,给Entity赋值 关闭数据库连接等资源 不难发现,当中包含了大段的重复模版代码。而我们所关心的业务逻辑,只有寥寥几行。而且,每执行一次数据库操作都重新建立一个新的连接,用完之后关闭的做法,性能非常低。因为每次打开关闭连接,都会涉及到TCP的三次握手与四次挥手,以及数据库的验证操作。为了优化第二个问题,出现了数据库连接池。 数据库连接池 不管是Connection Pool,Thread Pool还是Channel Pool,所有池的思想都是一致的: 维护一个资源集合 消费者可以从集合中获取资源 消费者使用完资源后,将之放回池中 当然其中肯定会涉及到一些池的大小的维护,池满之后的处理等细节操作。接下来我们来分析一下MyBatis中的连接池是如何实现的。 MyBatis中的连接池实现 如果我们使用MyBatis内置的数据源的化,一般会在XML配置文件里面这样配置: <dataSource type="POOLED"> <property name="driver" value="${driver}"/> <property name="url" value="${url}"/> <property name="username" value="${username}"/> <property name="password" value="${password}"/> </dataSource> 其中dataSource的type配置为POOLED,则MyBatis会使用org.apache.ibatis.datasource.pooled.PooledDataSource作为数据源。下面是PooledDataSource的类变量: // PooledDataSource public class PooledDataSource implements DataSource { // 用来维护连接池的状态 private final PoolState state = new PoolState(this); // 这里用了组合模式,像driver,url,username,password // 之类的配置变量信息存在UnpooledDataSource中 private final UnpooledDataSource dataSource; // 连接池的信息,可定制化配置 protected int poolMaximumActiveConnections = 10; protected int poolMaximumIdleConnections = 5; protected int poolMaximumCheckoutTime = 20000; protected int poolTimeToWait = 20000; protected String poolPingQuery = "NO PING QUERY SET"; protected boolean poolPingEnabled = false; protected int poolPingConnectionsNotUsedFor = 0; private int expectedConnectionTypeCode; } 注意,PooledDataSource将一部分配置信息放在了UnpooledDataSource中,并用了一个PoolState来维护连接池的状态: // UnpooledDataSource // PooledDataSource可以看成是由UnpooledDataSource扩展而来的,所以复用了一些变量 public class UnpooledDataSource implements DataSource { // 包含了如username,password的】等配置信息 private ClassLoader driverClassLoader; private Properties driverProperties; private boolean driverInitialized; private String driver; private String url; private String username; private String password; private boolean autoCommit; private Integer defaultTransactionIsolationLevel; } // PoolState public class PoolState { protected PooledDataSource dataSource; // 空闲连接列表 protected final List<PooledConnection> idleConnections = new ArrayList<PooledConnection>(); // 活跃连接列表 protected final List<PooledConnection> activeConnections = new ArrayList<PooledConnection>(); // 从连接池中获取连接的次数 protected long requestCount = 0; // 请求连接总耗时(ms) protected long accumulatedRequestTime = 0; // 连接执行时间总耗时 protected long accumulatedCheckoutTime = 0; // 执行时间超时的连接数 protected long claimedOverdueConnectionCount = 0; // 总共超时时间 protected long accumulatedCheckoutTimeOfOverdueConnections = 0; // 总共等待时间 protected long accumulatedWaitTime = 0; // 等待次数 protected long hadToWaitCount = 0; // 无效连接数 protected long badConnectionCount = 0; } 获取连接 好了,对类的成员变量有了一个直观的概念之后,我们分析来看连接池是如何实现的。找到获取连接的主方法popConnection(): // PooledDataSource private PooledConnection popConnection(String username, String password) throws SQLException { boolean countedWait = false; PooledConnection conn = null; long t = System.currentTimeMillis(); int localBadConnectionCount = 0; // 需要不断尝试获取连接,所以放在循环里 while (conn == null) { // 为线程安全,加synchronized锁 synchronized (state) { // 检查空间连接列表是不是为空 if (!state.idleConnections.isEmpty()) { // 如果有空闲连接可用,那么直接获取列表第一个连接并将之从列表中删除 conn = state.idleConnections.remove(0); } else { // 无空闲连接可用时,走到这里 if (state.activeConnections.size() < poolMaximumActiveConnections) { // 如果活跃连接数未超出限制,则新建连接 // dataSource.getConnection()的逻辑是初始化driver,从DriverManager获取连接, // 设置autoCommit和IsolationLevel,比较简单,就不分析了 conn = new PooledConnection(dataSource.getConnection(), this); } else { // 连接池已满,取出运行时间最长的连接 // 列表中的连接是按照运行时间排序的,所以第一个元素就是运行时间最长的 PooledConnection oldestActiveConnection = state.activeConnections.get(0); long longestCheckoutTime = oldestActiveConnection.getCheckoutTime(); // 如果运行时间超过超时时间 if (longestCheckoutTime > poolMaximumCheckoutTime) { // 更新一些统计字段 state.claimedOverdueConnectionCount++; state.accumulatedCheckoutTimeOfOverdueConnections += longestCheckoutTime; state.accumulatedCheckoutTime += longestCheckoutTime; // 将超时连接移出 活跃连接列表 state.activeConnections.remove(oldestActiveConnection); // 如果未设置自动提交,则进行回滚操作 if (!oldestActiveConnection.getRealConnection().getAutoCommit()) { oldestActiveConnection.getRealConnection().rollback(); } // 创建一个新的连接,不过需要复用oldestActiveConnection的realConnection, // 实际上并没有创建新的数据库连接 conn = new PooledConnection(oldestActiveConnection.getRealConnection(), this); // 复用oldestActiveConnection 的一些信息,将oldestActiveConnection设置为无效 conn.setCreatedTimestamp(oldestActiveConnection.getCreatedTimestamp()); conn.setLastUsedTimestamp(oldestActiveConnection.getLastUsedTimestamp()); oldestActiveConnection.invalidate(); } else { // 未超时 try { // 记录统计信息 if (!countedWait) { state.hadToWaitCount++; countedWait = true; } long wt = System.currentTimeMillis(); // 调用Object.wait()方法进入等待状态 state.wait(poolTimeToWait); // 记录统计信息 state.accumulatedWaitTime += System.currentTimeMillis() - wt; } catch (InterruptedException e) { break; } } } } if (conn != null) { // 检测连接是否有效,主要会检测PooledConnection.valid字段, // 以及执行SQL ping的语句查看数据库状态,这里不做分析 if (conn.isValid()) { // 如果没有设置自动回滚,执行回滚操作 if (!conn.getRealConnection().getAutoCommit()) { conn.getRealConnection().rollback(); } // 更新一些统计字段 conn.setConnectionTypeCode(assembleConnectionTypeCode(dataSource.getUrl(), username, password)); conn.setCheckoutTimestamp(System.currentTimeMillis()); conn.setLastUsedTimestamp(System.currentTimeMillis()); state.activeConnections.add(conn); state.requestCount++; state.accumulatedRequestTime += System.currentTimeMillis() - t; } else { // 更新无效连接相关的统计字段 state.badConnectionCount++; localBadConnectionCount++; conn = null; if (localBadConnectionCount > (poolMaximumIdleConnections + 3)) { throw new SQLException("PooledDataSource: Could not get a good connection to the database."); } } } } } // 如果没有获取到连接,直接抛出异常 if (conn == null) { throw new SQLException("PooledDataSource: Unknown severe error condition. The connection pool returned a null connection."); } return conn; } 以上就是获取连接的主要逻辑,大致如下: 这里有个疑问,我们外部获取连接用的都是getConnection()方法,而不是popConnection()方法。那么让我们来看看getConnection()是如何实现的: public Connection getConnection() throws SQLException { return popConnection(dataSource.getUsername(), dataSource.getPassword()).getProxyConnection(); } 除了调用popConnection()方法之外,还调用了getProxyConnection(),看名字是包装了一层代理。为什么要这样做呢?这就需要看释放连接的逻辑了。 释放连接 MyBatis用代理模式(如果对此模式不了解的,推荐看一下这篇文章),将数据库连接包装在PooledConnection对象之中: // PooledConnection class PooledConnection implements InvocationHandler { // 关闭连接的方法close(),在代理中拦截此方法来做释放连接的操作 private static final String CLOSE = "close"; private static final Class<?>[] IFACES = new Class<?>[] { Connection.class }; private final int hashCode; // 数据源对象,这里即PooledDataSource private final PooledDataSource dataSource; // 真正的从DriverManager中获取出来的连接 private final Connection realConnection; // realConnection的代理对象 private final Connection proxyConnection; // 一些参数 private long checkoutTimestamp; private long createdTimestamp; private long lastUsedTimestamp; private int connectionTypeCode; private boolean valid; // 构造方法 public PooledConnection(Connection connection, PooledDataSource dataSource) { this.hashCode = connection.hashCode(); this.realConnection = connection; this.dataSource = dataSource; this.createdTimestamp = System.currentTimeMillis(); this.lastUsedTimestamp = System.currentTimeMillis(); this.valid = true; // proxyConnection使用了JDK的动态代理,并将自己(this)作为了InvocationHandler this.proxyConnection = (Connection) Proxy.newProxyInstance(Connection.class.getClassLoader(), IFACES, this); } public Connection getProxyConnection() { return proxyConnection; } } 注意最后的getProxyConnection()方法,发现它果然返回了一个Connection的代理对象。同时,由于PooledConnection实现了InvocationHandler接口,当外部调用代理对象方法时,都会转为调用InvocationHandler.invoke()方法。于是下面主要看invoke()方法是如何实现的: // PooledConnection public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { String methodName = method.getName(); // 如果调用了close()方法,即调用方需要关闭连接 if (CLOSE.hashCode() == methodName.hashCode() && CLOSE.equals(methodName)) { // 转为调用pushConnection()方法 dataSource.pushConnection(this); return null; } else { try { // 如果不是调用的close()方法,则调用realConnection的同名方法 return method.invoke(realConnection, args); } catch (Throwable t) { throw ExceptionUtil.unwrapThrowable(t); } } } 看到这里,出现了闭环。调用方使用完连接之后,如果调用了close()方法,会被上述方法拦截,转为调用dataSource.pushConnection(this)方法,猜测这个方法是用来将连接放回连接池中的。我们来一探究竟: // PooledDataSource protected void pushConnection(PooledConnection conn) throws SQLException { // 与popConnection方法一样,同样也在state上加锁,用来做线程间协作 synchronized (state) { // 从活跃连接中移除此连接 state.activeConnections.remove(conn); if (conn.isValid()) { // 空闲连接未满 if (state.idleConnections.size() < poolMaximumIdleConnections && conn.getConnectionTypeCode() == expectedConnectionTypeCode) { state.accumulatedCheckoutTime += conn.getCheckoutTime(); // 若未设置autoCommit,执行回滚 if (!conn.getRealConnection().getAutoCommit()) { conn.getRealConnection().rollback(); } // 创建新的PooledConnection,并加入到idleConnections列表的末尾 PooledConnection newConn = new PooledConnection(conn.getRealConnection(), this); state.idleConnections.add(newConn); // 复用原连接的时间信息 newConn.setCreatedTimestamp(conn.getCreatedTimestamp()); newConn.setLastUsedTimestamp(conn.getLastUsedTimestamp()); // 将原连接置为无效状态 conn.invalidate(); // 唤醒等待连接的线程 state.notifyAll(); } else { // 空闲连接集合已满 state.accumulatedCheckoutTime += conn.getCheckoutTime(); // 回滚未提交的事务 if (!conn.getRealConnection().getAutoCommit()) { conn.getRealConnection().rollback(); } // 直接将数据库连接关闭 conn.getRealConnection().close(); conn.invalidate(); } } else { state.badConnectionCount++; } } } pushConnection()逻辑比较简单,主要做了两件事情: 将连接从活跃连接列表移除 如果空闲列表已满,则直接将此连接关闭;如果空闲列表未满,则新建PooledConnection并复用Connection对象(所以并没有新的TCP握手挥手的开销),并将此连接放入空闲列表。 到此,PooledDataSource的获取连接与释放连接的操作,在连接池中形成了一个闭环。 总结 本文分析了MyBatis内置的连接池的实现方式。当调用方拿连接时,首先会从池中获取。当调用方关闭连接时,MyBatis使用了代理模式拦截此方法,将该连接放回到池中。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册