首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

Android 属性动画(Property Animation) 完全解析 (上)

转载请标明出处:http://blog.csdn.net/lmj623565791/article/details/38067475 1、概述 Android提 供了几种动画类型:View Animation 、Drawable Animation 、Property Animation 。View Animation相当简单,不过只能支持简单的缩放、平移、旋转、透明度基本的动画,且有一定的局限性。比如:你希望View有一个颜色的切换动画;你 希望可以使用3D旋转动画;你希望当动画停止时,View的位置就是当前的位置;这些View Animation都无法做到。这就是Property Animation产生的原因,本篇博客详细介绍Property Animation的用法。至于Drawable Animation,嗯,略~ 2、相关API Property Animation故名思议就是通过动画的方式改变对象的属性了,我们首先需要了解几个属性: Duration动画的持续时间,默认300ms。 Time interpolation:时间差值,乍一看不知道是什么,但是我说LinearInterpolator、AccelerateDecelerateInterpolator,大家一定知道是干嘛的了,定义动画的变化率。 Repeat count and behavior:重复次数、以及重复模式;可以定义重复多少次;重复时从头开始,还是反向。 Animator sets: 动画集合,你可以定义一组动画,一起执行或者顺序执行。 Frame refresh delay:帧刷新延迟,对于你的动画,多久刷新一次帧;默认为10ms,但最终依赖系统的当前状态;基本不用管。 相关的类 ObjectAnimator 动画的执行类,后面详细介绍 ValueAnimator 动画的执行类,后面详细介绍 AnimatorSet 用于控制一组动画的执行:线性,一起,每个动画的先后执行等。 AnimatorInflater 用户加载属性动画的xml文件 TypeEvaluator 类型估值,主要用于设置动画操作属性的值。 TimeInterpolator 时间插值,上面已经介绍。 总的来说,属性动画就是,动画的执行类来设置动画操作的对象的属性、持续时间,开始和结束的属性值,时间差值等,然后系统会根据设置的参数动态的变化对象的属性。 3、ObjectAnimator实现动画 之所以选择ObjectAnimator为第一个~~是因为,这个实现最简单~~一行代码,秒秒钟实现动画,下面看个例子: 布局文件: [html] view plain copy <RelativeLayoutxmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" android:id="@+id/id_container"> <ImageView android:id="@+id/id_ball" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_centerInParent="true" android:src="@drawable/mv" android:scaleType="centerCrop" android:onClick="rotateyAnimRun" /> </RelativeLayout> 很简单,就一张妹子图片~ Activity代码: [java] view plain copy packagecom.example.zhy_property_animation; importandroid.animation.ObjectAnimator; importandroid.app.Activity; importandroid.os.Bundle; importandroid.view.View; publicclassObjectAnimActivityextendsActivity { @Override protectedvoidonCreate(BundlesavedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.xml_for_anim); } publicvoidrotateyAnimRun(Viewview) { ObjectAnimator// .ofFloat(view,"rotationX",0.0F,360.0F)// .setDuration(500)// .start(); } } 效果: 是不是一行代码就能实现简单的动画~~ 对于ObjectAnimator 1、提供了ofInt、ofFloat、ofObject,这几个方法都是设置动画作用的元素、作用的属性、动画开始、结束、以及中间的任意个属性值。 当对于属性值,只设置一个的时候,会认为当然对象该属性的值为开始(getPropName反射获取),然后设置的值为终点。如果设置两个,则一个为开始、一个为结束~~~ 动画更新的过程中,会不断调用setPropName更新元素的属性,所有使用ObjectAnimator更新某个属性,必须得有getter(设置一个属性值的时候)和setter方法~ 2、如果你操作对象的该属性方法里面,比如上例的setRotationX如果内部没有调用view的重绘,则你需要自己按照下面方式手动调用。 [java] view plain copy anim.addUpdateListener(newAnimatorUpdateListener() { @Override publicvoidonAnimationUpdate(ValueAnimatoranimation) { //view.postInvalidate(); //view.invalidate(); } }); 3、看了上面的例子,因为设置的操作的属性只有一个,那么如果我希望一个动画能够让View既可以缩小、又能够淡出(3个属性scaleX,scaleY,alpha),只使用ObjectAnimator咋弄? 想法是不是很不错,可能会说使用AnimatorSet啊,这一看就是一堆动画塞一起执行,但是我偏偏要用一个ObjectAnimator实例实现呢~下面看代码: [java] view plain copy publicvoidrotateyAnimRun(finalViewview) { ObjectAnimatoranim=ObjectAnimator// .ofFloat(view,"zhy",1.0F,0.0F)// .setDuration(500);// anim.start(); anim.addUpdateListener(newAnimatorUpdateListener() { @Override publicvoidonAnimationUpdate(ValueAnimatoranimation) { floatcVal=(Float)animation.getAnimatedValue(); view.setAlpha(cVal); view.setScaleX(cVal); view.setScaleY(cVal); } }); } 把设置属性的那个字符串,随便写一个该对象没有的属性,就是不管~~咱们只需要它按照时间插值和持续时间计算的那个值,我们自己手动调用~ 效果: 这个例子就是想说明一下,有时候换个思路不要被API所约束,利用部分API提供的功能也能实现好玩的效果~~~ 比如:你想实现抛物线的效果,水平方向100px/s,垂直方向加速度200px/s*s ,咋实现呢~~可以自己用ObjectAnimator试试~ 4、其实还有更简单的方式,实现一个动画更改多个效果:使用propertyValuesHolder [java] view plain copy publicvoidpropertyValuesHolder(Viewview) { PropertyValuesHolderpvhX=PropertyValuesHolder.ofFloat("alpha",1f, 0f,1f); PropertyValuesHolderpvhY=PropertyValuesHolder.ofFloat("scaleX",1f, 0,1f); PropertyValuesHolderpvhZ=PropertyValuesHolder.ofFloat("scaleY",1f, 0,1f); ObjectAnimator.ofPropertyValuesHolder(view,pvhX,pvhY,pvhZ).setDuration(1000).start(); } 4、ValueAnimator实现动画 和ObjectAnimator用法很类似,简单看一下用view垂直移动的动画代码: [java] view plain copy publicvoidverticalRun(Viewview) { ValueAnimatoranimator=ValueAnimator.ofFloat(0,mScreenHeight -mBlueBall.getHeight()); animator.setTarget(mBlueBall); animator.setDuration(1000).start(); } 给你的感觉是不是,坑爹啊,这和ValueAnimator有毛线区别~但是仔细看,你看会发现,没有设置操作的属性~~也就是说,上述代码是没有任何效果的,没有指定属性~ 这就是和ValueAnimator的区别之处:ValueAnimator并没有在属性上做操作,你可能会问这样有啥好处?我岂不是还得手动设置? 好 处:不需要操作的对象的属性一定要有getter和setter方法,你可以自己根据当前动画的计算值,来操作任何属性,记得上例的那个【我希望一个动画 能够让View既可以缩小、又能够淡出(3个属性scaleX,scaleY,alpha)】吗?其实就是这么个用法~ 实例: 布局文件: [html] view plain copy <RelativeLayoutxmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" android:id="@+id/id_container" > <ImageView android:id="@+id/id_ball" android:layout_width="wrap_content" android:layout_height="wrap_content" android:src="@drawable/bol_blue"/> <LinearLayout android:layout_width="fill_parent" android:layout_height="wrap_content" android:layout_alignParentBottom="true" android:orientation="horizontal"> <Button android:layout_width="wrap_content" android:layout_height="wrap_content" android:onClick="verticalRun" android:text="垂直"/> <Button android:layout_width="wrap_content" android:layout_height="wrap_content" android:onClick="paowuxian" android:text="抛物线"/> </LinearLayout> </RelativeLayout> 左上角一个小球,底部两个按钮~我们先看一个自由落体的代码: [java] view plain copy /** *自由落体 *@paramview */ publicvoidverticalRun(Viewview) { ValueAnimatoranimator=ValueAnimator.ofFloat(0,mScreenHeight -mBlueBall.getHeight()); animator.setTarget(mBlueBall); animator.setDuration(1000).start(); //animator.setInterpolator(value) animator.addUpdateListener(newAnimatorUpdateListener() { @Override publicvoidonAnimationUpdate(ValueAnimatoranimation) { mBlueBall.setTranslationY((Float)animation.getAnimatedValue()); } }); } 与ObjectAnimator不同的就是我们自己设置元素属性的更新~虽然多了几行代码,但是貌似提高灵活性~ 下 面再来一个例子,如果我希望小球抛物线运动【实现抛物线的效果,水平方向100px/s,垂直方向加速度200px/s*s】,分析一下,貌似只和时间 有关系,但是根据时间的变化,横向和纵向的移动速率是不同的,我们该咋实现呢?此时就要重写TypeValue的时候了,因为我们在时间变化的同时,需要 返回给对象两个值,x当前位置,y当前位置: 代码: [java] view plain copy /** *抛物线 *@paramview */ publicvoidpaowuxian(Viewview) { ValueAnimatorvalueAnimator=newValueAnimator(); valueAnimator.setDuration(3000); valueAnimator.setObjectValues(newPointF(0,0)); valueAnimator.setInterpolator(newLinearInterpolator()); valueAnimator.setEvaluator(newTypeEvaluator<PointF>() { //fraction=t/duration @Override publicPointFevaluate(floatfraction,PointFstartValue, PointFendValue) { Log.e(TAG,fraction*3+""); //x方向200px/s,则y方向0.5*10*t PointFpoint=newPointF(); point.x=200*fraction*3; point.y=0.5f*200*(fraction*3)*(fraction*3); returnpoint; } }); valueAnimator.start(); valueAnimator.addUpdateListener(newAnimatorUpdateListener() { @Override publicvoidonAnimationUpdate(ValueAnimatoranimation) { PointFpoint=(PointF)animation.getAnimatedValue(); mBlueBall.setX(point.x); mBlueBall.setY(point.y); } }); } 可 以看到,因为ofInt,ofFloat等无法使用,我们自定义了一个TypeValue,每次根据当前时间返回一个PointF对象,(PointF和 Point的区别就是x,y的单位一个是float,一个是int;RectF,Rect也是)PointF中包含了x,y的当前位置~然后我们在监听器 中获取,动态设置属性: 效果图: 有木有两个铁球同时落地的感觉~~对,我应该搞两个球~~ps:物理公式要是错了,就当没看见哈 自定义TypeEvaluator传入的泛型可以根据自己的需求,自己设计个Bean。 好 了,我们已经分别讲解了ValueAnimator和ObjectAnimator实现动画;二者区别;如何利用部分API,自己更新属性实现效果;自定 义TypeEvaluator实现我们的需求;但是我们并没有讲如何设计插值,其实我觉得把,这个插值默认的那一串实现类够用了~~很少,会自己去设计个 超级变态的~嗯~所以:略。 5、监听动画的事件 对于动画,一般都是一些辅助效果,比如我要删除个元素,我可能希望是个淡出的效果,但是最终还是要删掉,并不是你透明度没有了,还占着位置,所以我们需要知道动画如何结束。 所以我们可以添加一个动画的监听: [java] view plain copy publicvoidfadeOut(Viewview) { ObjectAnimatoranim=ObjectAnimator.ofFloat(mBlueBall,"alpha",0.5f); anim.addListener(newAnimatorListener() { @Override publicvoidonAnimationStart(Animatoranimation) { Log.e(TAG,"onAnimationStart"); } @Override publicvoidonAnimationRepeat(Animatoranimation) { //TODOAuto-generatedmethodstub Log.e(TAG,"onAnimationRepeat"); } @Override publicvoidonAnimationEnd(Animatoranimation) { Log.e(TAG,"onAnimationEnd"); ViewGroupparent=(ViewGroup)mBlueBall.getParent(); if(parent!=null) parent.removeView(mBlueBall); } @Override publicvoidonAnimationCancel(Animatoranimation) { //TODOAuto-generatedmethodstub Log.e(TAG,"onAnimationCancel"); } }); anim.start(); } 这样就可以监听动画的开始、结束、被取消、重复等事件~但是有时候会觉得,我只要知道结束就行了,这么长的代码我不能接收,那你可以使用AnimatorListenerAdapter [java] view plain copy anim.addListener(newAnimatorListenerAdapter() { @Override publicvoidonAnimationEnd(Animatoranimation) { Log.e(TAG,"onAnimationEnd"); ViewGroupparent=(ViewGroup)mBlueBall.getParent(); if(parent!=null) parent.removeView(mBlueBall); } }); AnimatorListenerAdapter继承了AnimatorListener接口,然后空实现了所有的方法~ 效果图: animator还有cancel()和end()方法:cancel动画立即停止,停在当前的位置;end动画直接到最终状态。 6、AnimatorSet的使用 实例: 布局文件: [html] view plain copy <RelativeLayoutxmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" android:id="@+id/id_container" > <ImageView android:id="@+id/id_ball" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_centerInParent="true" android:src="@drawable/bol_blue"/> <LinearLayout android:layout_width="fill_parent" android:layout_height="wrap_content" android:layout_alignParentBottom="true" android:orientation="horizontal"> <Button android:layout_width="wrap_content" android:layout_height="wrap_content" android:onClick="togetherRun" android:text="简单的多动画Together"/> <Button android:layout_width="wrap_content" android:layout_height="wrap_content" android:onClick="playWithAfter" android:text="多动画按次序执行"/> </LinearLayout> </RelativeLayout> 继续玩球~ 代码: [java] view plain copy packagecom.example.zhy_property_animation; importandroid.animation.AnimatorSet; importandroid.animation.ObjectAnimator; importandroid.app.Activity; importandroid.os.Bundle; importandroid.view.View; importandroid.view.animation.LinearInterpolator; importandroid.widget.ImageView; publicclassAnimatorSetActivityextendsActivity { privateImageViewmBlueBall; @Override protectedvoidonCreate(BundlesavedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.anim_set); mBlueBall=(ImageView)findViewById(R.id.id_ball); } publicvoidtogetherRun(Viewview) { ObjectAnimatoranim1=ObjectAnimator.ofFloat(mBlueBall,"scaleX", 1.0f,2f); ObjectAnimatoranim2=ObjectAnimator.ofFloat(mBlueBall,"scaleY", 1.0f,2f); AnimatorSetanimSet=newAnimatorSet(); animSet.setDuration(2000); animSet.setInterpolator(newLinearInterpolator()); //两个动画同时执行 animSet.playTogether(anim1,anim2); animSet.start(); } publicvoidplayWithAfter(Viewview) { floatcx=mBlueBall.getX(); ObjectAnimatoranim1=ObjectAnimator.ofFloat(mBlueBall,"scaleX", 1.0f,2f); ObjectAnimatoranim2=ObjectAnimator.ofFloat(mBlueBall,"scaleY", 1.0f,2f); ObjectAnimatoranim3=ObjectAnimator.ofFloat(mBlueBall, "x",cx,0f); ObjectAnimatoranim4=ObjectAnimator.ofFloat(mBlueBall, "x",cx); /** *anim1,anim2,anim3同时执行 *anim4接着执行 */ AnimatorSetanimSet=newAnimatorSet(); animSet.play(anim1).with(anim2); animSet.play(anim2).with(anim3); animSet.play(anim4).after(anim3); animSet.setDuration(1000); animSet.start(); } } 写了两个效果: 第一:使用playTogether两个动画同时执行,当然还有playSequentially依次执行~~ 第二:如果我们有一堆动画,如何使用代码控制顺序,比如1,2同时;3在2后面;4在1之前等~就是效果2了 有一点注意:animSet.play().with();也是支持链式编程的,但是不要想着狂点,比如 animSet.play(anim1).with(anim2).before(anim3).before(anim5); 这样是不行的,系统不会根据你写的这一长串来决定先后的顺序,所以麻烦你按照上面例子的写法,多写几行: 效果图: 好了,由于篇幅~~关于属性动画还有点知识: 1、xml文件创建属性动画 2、布局动画 3、View的animate方法等。 那就考虑写到下一篇了,不过核心的功能就这些了~~ 对了,如果使用11以下的SDK ,请导入nineoldandroids动画库,用法基本完全一致~ 源码点击下载 本文转自 一点点征服 博客园博客,原文链接:http://www.cnblogs.com/ldq2016/p/5534210.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android事件分发机制源码和实例解析

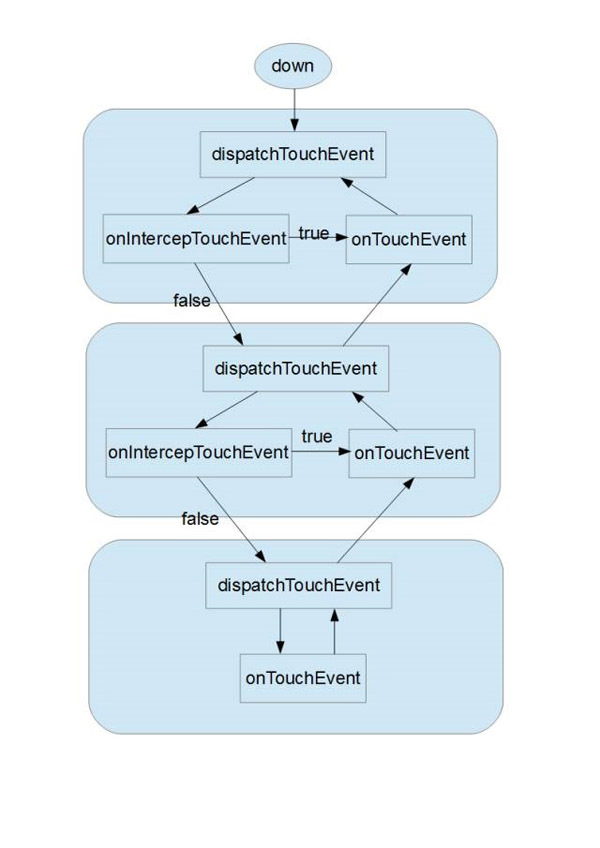
1.事件分发过程的理解 1.1. 概述 1.2. 主要方法 1.3. 核心行为 1.4. 特殊情况 2.案例分析 2.1. 案例1:均不消费 down 事件 2.2. 案例2:View0 消费 down 事件 2.3. 案例3:ViewGroup2nd 消费 down 事件 3.down 事件分发图 1. 事件分发过程的理解 1.1. 概述 事件主要有 down(MotionEvent.ACTION_DOWN),move(MotionEvent.ACTION_MOVE),up(MotionEvent.ACTION_UP)。 基本上的手势均由 down 事件为起点,up 事件为终点,中间可能会有一定数量的move 事件。这三种事件是大部分手势动作的基础。 事件和相关信息(比如坐标)封装成 MotionEvent。 大体的分发过程为:首先传递到 Activity,然后传给了 Activity 依附的 Window,接着由 Window 传给视图的顶层 View 也就是 DecorView,最后由 DecorView 向整个 ViewTree 分发。分发还会有回溯的过程。最后还会回到 Activity 的调用中。 Activity 的分发事件源码 publicbooleandispatchTouchEvent(MotionEventev){if(ev.getAction()==MotionEvent.ACTION_DOWN){ onUserInteraction(); }if(getWindow().superDispatchTouchEvent(ev)){returntrue; }returnonTouchEvent(ev); } 在 getWindow().superDispathTouchEvent 就是用来分发事件到 DecorView 中。如果整个 ViewTree 没有消费事件,会调用 Activity 的 onTouchEvent。 1.2. 主要方法 1.2.1. 概览 主要涉及到的 View 或 ViewGroup 的方法有: dispatchTouchEvent,该方法封装了事件分发的整个过程。是事件分发的 调度者 和 指挥官 。的核心过程均在该方法中。下面的 onInterceptTouchEvent 和 onTouchEvent 的回调的调用就在该方法体中。是否传递事件到 onInterceptTouchEvent 和 onTouchEvent 由 dispatchTouchEvent 决定。 onInterceptTouchEvent,该方法决定了是否拦截事件。只有 ViewGroup 有该回调。返回 true 表示拦截,返回 false 表示不拦截。自定义 View 的时候,可以重载该方法,通过一些特定的逻辑来决定是否拦截事件。如果拦截,接下来会调用该 ViewGroup 的 onTouchEvent 来处理事件。 onTouchEvent,该方法处理了事件,并决定是否继续消费后续事件。该方法调用的前置条件: 该 View 拦截了事件 子 View 都不消费事件 没有子 View 该方法正式处理 MotionEvent。返回 true 表示消费,返回 false 不消费。如果消费,接下来的事件还会传递到该 View 的 dispatchTouchEvent 中;如果不消费,后面的事件不会再传过来。 onTouchListener 的 onTouch 回调,和 onTouchEvent 一样,优先级比 onTouchEvent 高,如果有设置该监听,并且 onTouch 返回 true,就不会再调用 onTouchEvent 了。如果返回 false,事件还是会传递到 onTouchEvent 中。 1.2.2. dispatchTouchEvent 方法中的一些细节处理: 大部分手势的起点为 down 事件,dispatchTouchEvent 如果收到 down 事件,会重新设置一些变量和标记 重置变量和标记的源码 //Handleaninitialdown.if(actionMasked==MotionEvent.ACTION_DOWN){//Throwawayallpreviousstatewhenstartinganewtouchgesture. //Theframeworkmayhavedroppedtheuporcanceleventforthepreviousgesture //duetoanappswitch,ANR,orsomeotherstatechange. cancelAndClearTouchTargets(ev); resetTouchState(); } 实际的源码中,ViewGroup 继承于 View。 当子 View 不消费事件或者 ViewGroup 拦截了事件会传空值到 dispatchTransformedTouchEvent 中,内部会调用 super.dispatchTouchEvent,最终把事件传给 onTouchEvent 进行处理。 dispatchTransformedTouchEvent 关键部分 //Performanynecessarytransformationsanddispatch.if(child==null){ handled=super.dispatchTouchEvent(transformedEvent); }else{finalfloatoffsetX=mScrollX-child.mLeft;finalfloatoffsetY=mScrollY-child.mTop; transformedEvent.offsetLocation(offsetX,offsetY);if(!child.hasIdentityMatrix()){ transformedEvent.transform(child.getInverseMatrix()); } handled=child.dispatchTouchEvent(transformedEvent); } 也就是 dispatchTransformTouchEvent 完成了分发的最后过程: a. 传入的 child 不为空,转化坐标为 child 的坐标系,调用 child.dispatchTouchEvent向 child 分发事件 b. 传入的 child 为空,调用 super.dispatchTouchEvent 分发事件到 onTouchEvent 中 1.2.3 方法的主要关系 对于一个 ViewGroup 来说,几个重要方法的关系如下 几个重要方法关系伪代码 publicbooleandispatchTouchEvent(MotionEvente){booleanconsumed=false;if(onInterceptTouchEvent(e)){ consumed=onTouchEvent(e); }else{for(Viewview:childs){ consumed=view.dispatchTouchEvent(e);if(consumed){break; } }if(!consumed){ consumed=onTouchEvent(e); } } returnconsumed; } 这是事件分发过程的简单描述,具体远比这复杂的多。 1.3. 核心行为 View 或 ViewGroup 有两个核心的行为:拦截(intercept) 和 消费(consume)。这两者是相互独立的,拦截不一定消费。是否要拦截看 onIntercepTouchEvent。是否要消费看 onTouchEvent。 注意:是否拦截还有其他因素影响。如果不是 down 事件,并且 mFirstTouchTarget 为空值,就会直接拦截事件。 在 dispatchTouchEvent 中有这样的代码 拦截的关键源码 //Checkforinterception.finalbooleanintercepted;if(actionMasked==MotionEvent.ACTION_DOWN ||mFirstTouchTarget!=null){finalbooleandisallowIntercept=(mGroupFlags&FLAG_DISALLOW_INTERCEPT)!=0;if(!disallowIntercept){ intercepted=onInterceptTouchEvent(ev); ev.setAction(action);//restoreactionincaseitwaschanged }else{ intercepted=false; } }else{//Therearenotouchtargetsandthisactionisnotaninitialdown //sothisviewgroupcontinuestointercepttouches. intercepted=true; } 从上面的源码可以看出,在不是 down 事件,并且 mFirstTouchTarget 为空的情况下,不会走 onInterceptTouchEvent 而是直接拦截。如果满足了,还会看 FLAG_DISALLOW_INTERCEPT 标记,如果不允许拦截(disallowIntercept 为 true),也不会走onInterceptTouchEvent,直接标记不拦截。 处理调用 onTouchEvent 的源码 booleanresult=false; ... ListenerInfoli=mListenerInfo;if(li!=null&&li.mOnTouchListener!=null &&(mViewFlags&ENABLED_MASK)==ENABLED &&li.mOnTouchListener.onTouch(this,event)){ result=true; }if(!result&&onTouchEvent(event)){ result=true; } 可以看出,在该 View 为 ENABLE 的状态并且有 mTouchListener,会先调用 onTouch。在onTouch 返回 false 时才会继续调用 onTouchEvent。 onTouch 或者 onTouchEvent 的处理结果有: 返回 true,会继续消费后续事件。意味着,后面的事件将会继续传递到该 View 的 dispatchTouchEvent 方法中进行调度。父 View 会为该 View 创建一个 TouchTarget 实例加入链表中,链表的第一项为 mFirstTouchTarget。后续的 move 和 up 事件会直接交给该 View 的 dispatchTouchEvent。 返回 false,不再消费后续事件。意味着,后面的事件将会被父 View 拦截,而不再传递下来。 1.4. 特殊情况 比较特殊的情况有,子 View 可以使用 requestDisallowInterceptTouchEvent 影响去父 View 的分发,可以决定父 View 是否要调用 onInterceptTouchEvent 。比如,requestDisallowInterceptTouchEvent(true),父 View 就不用调用 onInterceptTouchEvent 来判断拦截,而就是不拦截。 该方法可以用来解决手势冲突。比如子 View 先消费了事件,但是后面父 View 也满足了手势触发的条件而拦截事件,导致子 View 手势执行一半后无法继续响应。可以使用 requestDisallowInterceptTouchEvent(true),这样后面的事件,父 View 不会走 onInterceptTouchEvent 回调来判断是否要拦截事件,而是直接把事件继续传下来。 2. 案例分析 下面举三个简单的例子,三个类 ViewGroup1st,ViewGroup2nd 和 View0,层级关系为 <ViewGroup1st> <ViewGroup2nd> <View0/> </ViewGroup2nd></ViewGroup1st> 这三个类有两层 ViewGroup,最底层为 View,这几个例子主要理解 消费 行为,所以不做事件的拦截。 2.1. 案例1:均不消费 down 事件 在触摸屏幕中 View0 的区域后,输出 log 信息如下 12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup1st:dispatchTouchEventbefore12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup1st:onInterceptTouchEventreturn:false12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup2nd:dispatchTouchEventbefore12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup2nd:onInterceptTouchEventreturn:false12-3014:06:03.69431323-31323/lyn.demoD/View0:dispatchTouchEventbefore12-3014:06:03.69431323-31323/lyn.demoD/View0:onTouchEventreturn:false12-3014:06:03.69431323-31323/lyn.demoD/View0:dispatchTouchEventreturn:false12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup2nd:onTouchEventreturn:false12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup2nd:dispatchTouchEventreturn:false12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup1st:onTouchEventreturn:false12-3014:06:03.69431323-31323/lyn.demoD/ViewGroup1st:dispatchTouchEventreturn:false 当 down 事件从 DecorView 开始了分发过程: ViewGroup1st 收到事件,执行 onInterceptTouchEvent 返回 false,不拦截,于是调用 ViewGroup2nd 的 dispatchTouchEvent 向 ViewGroup2nd分发。 ViewGroup2nd 收到事件,dispatchTouchEvent 重复 ViewGroup1st 的分发策略。因为都不拦截,所以调用了 View0 的 dispatchTouchEvent。 View0 收到事件,而 View0 不是 ViewGroup 类型,所以把事件直接交给了 onTouchEvent。 View0 不消费事件,onTouchEvent 返回 false,dispatchTouchEvent 方法因此也返回 false。 ViewGroup2nd 因为 View0 的 dispatchTouchEvent 返回 false,确定了子类不消费事件,于是把事件传递给 onTouchEvent。但本身也不消费事件,所以 onTouchEvent 也返回 false,继续把事件上抛到 ViewGroup1st。 ViewGroup1st 重复了 ViewGroup2nd 的过程。 随后,move 事件不会再往下传了,而是直接被 Activity 拦截。 2.2. 案例2:View0 消费 down 事件 首先是 down 事件的传递,log 如下 12-3014:14:09.3847350-7350/lyn.demoD/ViewGroup1st:dispatchTouchEventbefore12-3014:14:09.3847350-7350/lyn.demoD/ViewGroup1st:onInterceptTouchEventreturn:false12-3014:14:09.3847350-7350/lyn.demoD/ViewGroup2nd:dispatchTouchEventbefore12-3014:14:09.3847350-7350/lyn.demoD/ViewGroup2nd:onInterceptTouchEventreturn:false12-3014:14:09.3847350-7350/lyn.demoD/View0:dispatchTouchEventbefore12-3014:14:09.3847350-7350/lyn.demoD/View0:onTouchEventreturn:true12-3014:14:09.3847350-7350/lyn.demoD/View0:dispatchTouchEventreturn:true12-3014:14:09.3847350-7350/lyn.demoD/ViewGroup2nd:dispatchTouchEventreturn:true12-3014:14:09.3847350-7350/lyn.demoD/ViewGroup1st:dispatchTouchEventreturn:true ViewGroup1st 和 ViewGroup2st 的传递和案例1一样。区别在于 View0 onTouchEvent 返回 true 消费后续事件后,View0 的 dispatchTouchEvent 也返回 true,ViewGroup2nd 和 ViewGroup1st 不执行 onTouchEvent 也直接返回 true 然后稍微移动一下手指,move 事件往下传递 12-3014:14:09.4847350-7350/lyn.demoD/ViewGroup1st:dispatchTouchEventbefore12-3014:14:09.4847350-7350/lyn.demoD/ViewGroup1st:onInterceptTouchEventreturn:false12-3014:14:09.4847350-7350/lyn.demoD/ViewGroup2nd:dispatchTouchEventbefore12-3014:14:09.4847350-7350/lyn.demoD/ViewGroup2nd:onInterceptTouchEventreturn:false12-3014:14:09.4847350-7350/lyn.demoD/View0:dispatchTouchEventbefore12-3014:14:09.4847350-7350/lyn.demoD/View0:onTouchEventreturn:true12-3014:14:09.4847350-7350/lyn.demoD/View0:dispatchTouchEventreturn:true12-3014:14:09.4847350-7350/lyn.demoD/ViewGroup2nd:dispatchTouchEventreturn:true12-3014:14:09.4847350-7350/lyn.demoD/ViewGroup1st:dispatchTouchEventreturn:true 过程和 down 事件的传递一样。因为同样会经过 ViewGroup2nd 的 onInterceptTouchEvent,如果这时候 ViewGroup2nd 有拦截行为,move 事件就不会传到 View0 了。要避免这种情况发生,需要调用 View0 的requestDisallowInterceptTouchEvent,可见 1.4 部分。 2.3. 案例3:ViewGroup2nd 消费 down 事件 首先是 down 事件的传递,log 如下 12-3014:25:30.07418848-18848/lyn.demoD/ViewGroup1st:dispatchTouchEventbefore12-3014:25:30.07418848-18848/lyn.demoD/ViewGroup1st:onInterceptTouchEventreturn:false12-3014:25:30.08418848-18848/lyn.demoD/ViewGroup2nd:dispatchTouchEventbefore12-3014:25:30.08418848-18848/lyn.demoD/ViewGroup2nd:onInterceptTouchEventreturn:false12-3014:25:30.08418848-18848/lyn.demoD/View0:dispatchTouchEventbefore12-3014:25:30.08418848-18848/lyn.demoD/View0:onTouchEventreturn:false12-3014:25:30.08418848-18848/lyn.demoD/View0:dispatchTouchEventreturn:false12-3014:25:30.08418848-18848/lyn.demoD/ViewGroup2nd:onTouchEventreturn:true12-3014:25:30.08418848-18848/lyn.demoD/ViewGroup2nd:dispatchTouchEventreturn:true12-3014:25:30.08418848-18848/lyn.demoD/ViewGroup1st:dispatchTouchEventreturn:true 由于 View0 不消费事件,dispatchTouchEvent 返回 false,所以执行了 ViewGroup2nd 的 onTouchEvent 方法。 ViewGroup2nd 消费事件,onTouchEvent 返回 true,之后 ViewGroup2nd 和 ViewGroup1st 的 dispatchTouchEvent 均返回 true。 动一下手指,move 事件接着传 2-3014:25:30.17418848-18848/lyn.demoD/ViewGroup1st:dispatchTouchEventbefore12-3014:25:30.17418848-18848/lyn.demoD/ViewGroup1st:onInterceptTouchEventreturn:false12-3014:25:30.17418848-18848/lyn.demoD/ViewGroup2nd:dispatchTouchEventbefore12-3014:25:30.17418848-18848/lyn.demoD/ViewGroup2nd:onTouchEventreturn:true12-3014:25:30.17418848-18848/lyn.demoD/ViewGroup2nd:dispatchTouchEventreturn:true12-3014:25:30.17418848-18848/lyn.demoD/ViewGroup1st:dispatchTouchEventreturn:true 这时候,ViewGroup2nd 直接拦截了 move 事件,不再经过 onInterceptTouchEvent,也不再向 View0 分发,而是直接调用 onTouchEvent 进行处理。 3. down 事件分发图 在每个 View 都不拦截 down 事件的情况下,down 事件是这样传递的 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

解析6种常用View 的滑动方法

> View 的滑动是Android 实现自定义控件的基础,实现View 滑动有很多种方法,在这里主要讲解6 种滑动方法,分别是layout()、offsetLeftAndRight()与offsetTopAndBottom()、LayoutParams、动画、scollTo 与scollBy,以及Scroller。 View 的滑动是Android 实现自定义控件的基础,同时在开发中我们也难免会遇到View 的滑动处理。其实不管是哪种滑动方式,其基本思想都是类似的:当点击事件传到View 时,系统记下触摸点的坐标,手指移动时系统记下移动后触摸的坐标并算出偏移量,并通过偏移量来修改View 的坐标。实现View 滑动有很多种方法,在这里主要讲解6 种滑动方法,分别是layout()、offsetLeftAndRight()与offsetTopAndBottom()、LayoutParams、动画、scollTo 与scollBy,以及Scroller。 1 layout()方法 View 进行绘制的时候会调用onLayout()方法来设置显示的位置,因此我们同样也可以通过修改View 的left、top、right、bottom 这4 种属性来控制View 的坐标。首先我们要自定义一个View,在onTouchEvent()方法中获取触摸点的坐标,代码如下所示: public boolean onTouchEvent(MotionEvent event) { //获取手指触摸点的横坐标和纵坐标 int x = (int) event.getX(); int y = (int) event.getY(); switch (event.getAction()) { case MotionEvent.ACTION_DOWN: lastX = x; lastY = y; break; 接下来我们在ACTION_MOVE 事件中计算偏移量,再调用layout()方法重新放置这个自定义View 的位置即可。 case MotionEvent.ACTION_MOVE: //计算移动的距离 int offsetX = x - lastX; int offsetY = y - lastY; //调用layout 方法来重新放置它的位置 layout(getLeft()+offsetX, getTop()+offsetY,getRight()+offsetX , getBottom()+offsetY); break; 在每次移动时都会调用layout()方法对屏幕重新布局,从而达到移动View 的效果。自定义View,CustomView 的全部代码如下所示: public class CustomView extends View { private int lastX; private int lastY; public CustomView(Context context, AttributeSet attrs, int defStyleAttr) { super(context, attrs, defStyleAttr); } public CustomView(Context context, AttributeSet attrs) { super(context, attrs); } public CustomView(Context context) { super(context); } public boolean onTouchEvent(MotionEvent event) { //获取手指触摸点的横坐标和纵坐标 int x = (int) event.getX(); int y = (int) event.getY(); switch (event.getAction()) { case MotionEvent.ACTION_DOWN: lastX = x; lastY = y; break; case MotionEvent.ACTION_MOVE: //计算移动的距离 int offsetX = x - lastX; int offsetY = y - lastY; //调用layout 方法来重新放置它的位置 layout(getLeft()+offsetX, getTop()+offsetY,getRight()+offsetX , getBottom()+offsetY); break; } return true; } } 随后,我们在布局中引用自定义View 就可以了。 <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical"> <com.example.liuwangshu.moonviewslide.CustomView android:id="@+id/customview" android:layout_width="80dp" android:layout_height="80dp" android:layout_margin="50dp" android:background="@android:color/holo_red_light" /> </LinearLayout> 运行程序,效果如图1 所示。图1 中的方块就是我们自定义的CustomView,它会随着我们手指的滑动改变自己的位置。 图1 View 的滑动 2 offsetLeftAndRight()与offsetTopAndBottom() 这两种方法和layout()方法的效果差不多,其使用方式也差不多。我们将ACTION_MOVE中的代码替换成如下代码: case MotionEvent.ACTION_MOVE: //计算移动的距离 int offsetX = x - lastX; int offsetY = y - lastY; //对left 和right 进行偏移 offsetLeftAndRight(offsetX); //对top 和bottom 进行偏移 offsetTopAndBottom(offsetY); break; 3 LayoutParams(改变布局参数) LayoutParams 主要保存了一个View 的布局参数,因此我们可以通过LayoutParams 来改变View 的布局参数从而达到改变View 位置的效果。同样,我们将ACTION_MOVE 中的代码替换成如下代码: LinearLayout.LayoutParams layoutParams= (LinearLayout.LayoutParams)getLayoutParams(); layoutParams.leftMargin = getLeft() + offsetX; layoutParams.topMargin = getTop() + offsetY; setLayoutParams(layoutParams); 因为父控件是LinearLayout,所以我们用了LinearLayout.LayoutParams。如果父控件是RelativeLayout,则要使用RelativeLayout.LayoutParams。除了使用布局的LayoutParams 外,我们还可以用ViewGroup.MarginLayoutParams 来实现: ViewGroup.MarginLayoutParams layoutParams = (ViewGroup.MarginLayoutParams) getLayoutParams(); layoutParams.leftMargin = getLeft() + offsetX; layoutParams.topMargin = getTop() + offsetY; setLayoutParams(layoutParams); 4 动画 可以采用View 动画来移动,在res 目录新建anim 文件夹并创建translate.xml: <?xml version="1.0" encoding="utf-8"?> <set xmlns:android="http://schemas.android.com/apk/res/android"> <translate android:duration="1000" android:fromXDelta="0" android:toXDelta="300" /> </set> 接下来在Java 代码中调用就好了,代码如下所示: mCustomView.setAnimation(AnimationUtils.loadAnimation(this, R.anim.translate)); 运行程序,我们设置的小方块会向右平移300 像素,然后又会回到原来的位置。为了解决这个问题,我们需要在translate.xml 中加上fillAfter="true",代码如下所示。运行代码后会发现,方块向右平移300 像素后就停留在当前位置了。 <?xml version="1.0" encoding="utf-8"?> <set xmlns:android="http://schemas.android.com/apk/res/android" android:fillAfter="true"> <translate android:duration="1000" android:fromXDelta="0" android:toXDelta="300" /> </set> 需要注意的是,View 动画并不能改变View 的位置参数。如果对一个Button 进行如上的平移动画操作,当Button 平移300 像素停留在当前位置时,我们点击这个Button 并不会触发点击事件,但在我们点击这个Button 的原始位置时却触发了点击事件。对于系统来说这个Button 并没有改变原有的位置,所以我们点击其他位置当然不会触发这个Button 的点击事件。在Android3.0 时出现的属性动画解决了上述问题,因为它不仅可以执行动画,还能够改变View 的位置参数。当然,这里使用属性动画移动那就更简单了,我们让CustomView 在1000ms 内沿着X 轴向右平移300 像素,代码如下所示。 ObjectAnimator.ofFloat(mCustomView,"translationX",0,300).setDuration(100 0).start(); 5 scrollTo 与scollBy scrollTo(x,y)表示移动到一个具体的坐标点,而scrollBy(dx,dy)则表示移动的增量为dx、dy。其中,scollBy 最终也是要调用scollTo 的。View.java 的scollBy 和scollTo 的源码如下所示: public void scrollTo(int x, int y) { if (mScrollX != x || mScrollY != y) { int oldX = mScrollX; int oldY = mScrollY; mScrollX = x; mScrollY = y; invalidateParentCaches(); onScrollChanged(mScrollX, mScrollY, oldX, oldY); if (!awakenScrollBars()) { postInvalidateOnAnimation(); } } } public void scrollBy(int x, int y) { scrollTo(mScrollX + x, mScrollY + y); } scollTo、scollBy 移动的是View 的内容,如果在ViewGroup 中使用,则是移动其所有的子View。我们将ACTION_MOVE 中的代码替换成如下代码: ((View)getParent()).scrollBy(-offsetX,-offsetY); 这里若要实现CustomView 随手指移动的效果,就需要将偏移量设置为负值。为什么要设置为负值呢?下面具体讲解一下。假设我们正用放大镜来看报纸,放大镜用来显示字的内容。同样我们可以把放大镜看作我们的手机屏幕,它们都是负责显示内容的;而报纸则可以被看作屏幕下的画布,它们都是用来提供内容的。放大镜外的内容,也就是报纸的内容不会随着放大镜的移动而消失,它一直存在。同样,我们的手机屏幕看不到的视图并不代表其不存在,如图2 所示。 图2 初始情况 画布上有3 个控件,即Button、EditText 和SwichButton。只有Button 在手机屏幕中显示,它的Android 坐标为(60,60) 。现在我们调用scrollBy(50,50),按照字面的意思,这个Button 应该会在屏幕右下侧,可是事实并非如此。如果我们调用scrollBy(50,50),里面的参数都是正值,我们的手机屏幕向X 轴正方向,也就是向右边平移50,然后手机屏幕向Y 轴正方向,也就是向下方平移50,平移后的效果如图3所示。 图3 调用scrollBy(50,50)后 虽然我们设置的数值是正数并且在X 轴和Y 轴的正方向移动,但Button 却向相反方向移动了,这是参考对象不同导致的差异。所以我们用scrollBy 方法的时候要设置负数才会达到自己想要的效果。 6 Scroller 我们在用scollTo/scollBy 方法进行滑动时,这个过程是瞬间完成的,所以用户体验不大好。这里我们可以使用Scroller 来实现有过渡效果的滑动,这个过程不是瞬间完成的,而是在一定的时间间隔内完成的。Scroller 本身是不能实现View 的滑动的,它需要与View 的computeScroll()方法配合才能实现弹性滑动的效果。在这里我们实现CustomView 平滑地向右移动。首先我们要初始化Scroller,代码如下所示: public CustomView(Context context, AttributeSet attrs) { super(context, attrs); mScroller = new Scroller(context); } 接下来重写computeScroll()方法,系统会在绘制View 的时候在draw()方法中调用该方法。在这个方法中,我们调用父类的scrollTo()方法并通过Scroller 来不断获取当前的滚动值,每滑动一小段距离我们就调用invalidate()方法不断地进行重绘,重绘就会调用computeScroll()方法,这样我们通过不断地移动一个小的距离并连贯起来就实现了平滑移动的效果。 @Override public void computeScroll() { super.computeScroll(); if(mScroller.computeScrollOffset()){ ((View) getParent()).scrollTo(mScroller.getCurrX(),mScroller.getCurrY()); invalidate(); } } 我们在CustomView 中写一个smoothScrollTo 方法,调用Scroller 的startScroll()方法,在2000ms 内沿X 轴平移delta 像素,代码如下所示: public void smoothScrollTo(int destX,int destY){ int scrollX=getScrollX(); int delta=destX-scrollX; mScroller.startScroll(scrollX,0,delta,0,2000); invalidate(); } 最后我们在ViewSlideActivity.java 中调用CustomView 的smoothScrollTo()方法。这里我们设定CustomView 沿着X 轴向右平移400 像素。 mCustomView.smoothScrollTo(-400,0); 本文选自《Android进阶之光》,点此链接可在博文视点官网查看此书。 想及时获得更多精彩文章,可在微信中搜索“博文视点”或者扫描下方二维码并关注。

优秀的个人博客,低调大师

产品架构解析

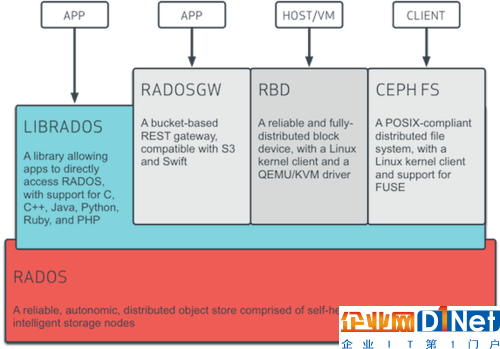
在昨天的文章中,笔者介绍到Ceph的主要目标是提供高可扩展性和提供对象存储、块存储和文件系统的存储机制,是一个高扩展、高容错、高一致的开源分布式存储平台。 那么,Ceph的产品架构究竟是什么样的呢?Ceph的产品生态优势什么样的呢? Ceph架构图 从Ceph的架构图我们可以看到,从下到上,一共分为四个层次:基础存储系统RADOS(Reliable, Autonomic, Distributed Object Store,即可靠的、自动化的、分布式的对象存储);基础库librados;高层应用接口和应用层。 其中,RADOS集群是Ceph项目的核心,所有存储在Ceph系统中的用户数据事实上最终都是由这一层来存储的。RADOS由两个组件组成:OSD(Object Storage Device)和Monitor。同时,Ceph基于RADOS开发了Object Storage、Block Storage、FileSystem。 Ceph生态 Ceph不仅架构清晰,更重要的是相比传统的存储架构,Ceph更注重生态的搭建。从整个Ceph生态系统来看,也可以分为四部分:客户端、元数据服务器、元数据对象存储和集群监视器。 在这个生态中,Ceph Client是Ceph文件系统的用户;CMD(Ceph Metadata Daemon)提供了元数据服务器;COSD(Ceph Object Storage Device)对象存储设备提供了实际存储,负责响应客户端请求返回具体数据的进程;而Ceph Monitor提供了集群管理,可以监管分布式系统的状态一致性问题,维护集群内节点关系图(mon-map osd-map mds-map pg-map)的一致性,一个Ceph集群需要多个Monitor组成的小集群,它们通过Paxos同步数据,用来保存OSD的元数据。 本文转自d1net(转载)

优秀的个人博客,低调大师

云计算新名词解析

云世界里的技术日新月异,新名词一个接着一个让人应接不暇,从虚拟化开始,VMware、HyperV、KVM,到云管理平台VSphere、SystemCenter、OpenStack,再到容器领域的Docker、Kubernetes、Mesos、Swarm,资源管理调度的Yarn、Mesos和今天的微服务Micro Service。这些东东到底是干嘛的?能解决什么问题?它们之间有木有关联性?作为多年来运营商IT的一名架构师,笔者试着从自己的角度解读下云技术的演进与实践。目的不是论证各项技术,而是想把一些碎片化的知识串接起来,让大家知道来龙去脉,在有必要的时候做出选择或去深度研究。 1. 虚拟化与X86 最早有硬件服务器(Server)和软件应用(Application),两者之间夹了个操作系统(OS),让应用程序可以通过它来使用CPU、内存和存储等。从定位来看叫它系统软件更加贴切,以区别于应用软件。 慢慢硬件和OS就绑在一起了,IBM的Aix,HP的HP-UX,Sun的Solaris;微软是个例外,可在不同的PC服务器上跑Windows。这种局面闹得应用也不得不选择自己的营地,一旦落定后要想再迁移可得费老鼻子劲了,用户要花钱花力冒风险,厂家赚的盆满钵溢的。 后来基于统一X86架构的PC服务器越做越好,价格便宜而且有多家产品可选择,再加上出了个开源的OS,Linux,在上面开发应用让您随时可以更换底层的机器,这一局面大大降低了硬件成本。呼啦一下新应用都在X86上开发了,有些企业甚至下了行政命令不许再买小机了。几家硬件巨头也只好随风跟进,但时间一长,利润空间越挤越小,Sun出局了(卖给Oracle了),IBM把X86产品线转给联想了,只有HP还在那儿苦苦地撑着,X86产品线在中国也和紫光合并了。 不过X86在体量和性能上都不如Unix小机,那它怎么能承受的住原来小机上的那些负载呢?工程师们总是有法子的,单机负载不是太大吗?我干脆弄个业务组网,把应用在每台X86上都装一份,然后在前端放个LB(负载均衡器),把原来一台机器上的负载分配到不同的机器上,把负载给均衡了。 您要是专家立马会问那数据怎么办?应用程序要是太大了太重了怎么办?为了好保证数据一致性,数据还得放在同一个库里,所以在一堆X86后面往往都有台仍旧是小机的数据库服务器(它也由此成了瓶颈,后面咱们再说怎么解决它,怎么彻底做到去IOE)。应用太大了启动起来费半天劲怎么办?还是化整为零的办法,用了个一般人看了后懵懵的名字叫“应用服务化”或“容器化”,后面我们也会谈到。 人们追求效率追求成本的努力永不间断。在实际生产中X86的使用率并不高,只有10%左右。刚刚在X86上落定的IT人又再琢磨能不能再优化些,让一台X86当多台机器使用?虚拟化应运而生。 虚拟化是个啥玩意儿?说白了就是夹在硬件和OS之间一个叫做Hypervisor的东西。它可以把一台物理机里的CPU、内存、硬盘存储都抓过来,化整为零重新分配给一个个叫做虚机的“小盒子”。这个概念其实在小机上就存在。每个小盒子具备了一定的硬件资源后,再给它装个OS它就能像台真正的机器一样给应用使用。那个Hypervisor就像个监工,哪个小盒子里的资源要是不够用了,它就动态地多给一些。这是件多好的事儿呀!再加上一帮专门忽悠人的老美给它取了个云里雾里的名字叫“云计算”,弄了个像供水电一样的销售使用模式,这家伙X86+虚拟化一下子就火起来了,风靡了全世界。 2. 云化资源管理 这小盒子一多,多到能有成千上万个,这时候云管理平台就出来了,它要管理的主要对象是虚机集群。这时候知道点云计算的您肯定会举手说OpenStack。 哈哈,您先别急,听我慢慢道来。刚刚从Unix小机解放出来的用户试着走进虚拟世界,但很快发现又有被厂家绑定的危险。虚拟软件的老大VMware自打推出它的Hypervisor之后,很快又推出了它的管理平台VSphere;另一大佬微软比VMware胃口还大,从操作系统Windows、到虚拟软件HyperV,当然忘不了它的管理平台SystemCenter。昂贵的软件使用费逼的用户又一次转向开源社区。一下子虚拟化管理领域热闹非凡,混战到最后剩下的有Eucalyptus(国内叫桉树)、CloudStack和OpenStack几家了。 关于他们的优劣和成败原因的分析,已有很多。三者中,Eucalyptus出身最学术,CloudStack出身商业味最浓,OpenStack介于两者之间。CloudStack 和Eucalyptus一样,最开始并不开源,开源后还留了点尾巴,而且自己控制着商业版本。等发现这种模式玩不转了,卖给了Citrix,全部开源后,发现大家已经都在玩OpenStack了。其实OpenStack发布后直到CloudStack被Citrix再转卖出去为止,它的易用性和稳定性一直和CloudStack有差距。但是架不住OpenStack免费、完全开源、没有商业公司控制。咳,人都贪便宜,不想被束缚。 按道理OpenStack只是个虚机管理工具,可是一旦一家独大之后人们对它的期望也就越来越高,就集万千宠爱于一身。存储要管(Cinder、Swift),网络SDN也要管(Neutron);虚机要管(Nova、Glance),物理机也要管(Ironic),闹不好连遗留下来的小机也得一并纳入;光是硬件资源还不过瘾,中间件、大数据(Sahara) 等也都要拢过来。资源种类多了,资源之间的编排(Heat) 也越做越复杂。以前只是管理和集成,现在要深入到更底层的资源了,还要考虑收费计价(Ceilometer)。竞争对手一个个倒下,看似势头无敌的时候,也就是最危险的时候。这危险一是来自内部,要做那么些功能开源社区跟不上趟了,开发落后于需求,用户不得不自己找一帮高手来开发;二是来自外部,来自它所需要管理的对象:虚机。 3. 容器时代的到来 大家还记得虚机是什么吧!虚机就是物理机上的一个个“盒子”,盒子里装着OS,OS之上是各自的应用。问题就出在这OS上。因为操作系统本身就是一个软件程序,一个很重的系统软件因为它包含了形形色色的各类功能。好多功能应用根本就用不上,譬如Web服务器负责处理网络请求,数据库服务器负责数据库的运行和数据库访问,等等。这些服务器可能永远都用不上OS中显示器、多用户、多进程等功能。这些场景下的虚机和OS的任务很明确,就是提供最好的存储、计算、网络性能。但是OS并没有随着虚拟化而重建,大而全的OS功能越多重启它耗费的时间就越长,也因此拖累了虚机。 这时候两大改造运动开始了,一个是把OS搬到“盒子”外面让大家共享,一个是把OS做轻,去掉那些无用的功能。剩下的“盒子”就是当红子鸡 “Docker” 或容器(其实这两种技术改造路线是相辅相成的)。做轻量级OS比较有名的两个代表(一看公司的名字就知道干嘛的了)一个叫CoreOS,另一个叫Unikernel。最初CoreOS是一家容器化Linux服务器操作系统创业公司,同时,该公司使用自家的Linux系统CoreOS为Docker提供服务,并为Docker作出了巨大的贡献。令人出乎意料的是CoreOS却与Docker分道扬镳,另起炉灶,并开发了类Docker的开源容器Rocket。后来在Linux基金会的调解下,这两家公司互让一步,联手打造开放容器技术项目(OCP)。OCP是一个非营利性组织,它实际上采用了Docker的技术作为开源容器的软件技术标准。既然开源了,CoreOS也就放了Docker一马。做轻OS的另一个厂家Unikernel后来干脆被Docker收购了。自此,Docker成了容器的代名词。 4. 容器集群管理 Docker被应用接受了,逐渐推广了,问题也出来了。问题一是和虚机管理平台一样,容器一多管理上成了问题啦,需要个容器集群管理系统。问题二是容器是轻量级的,用它来承载大块头的应用是不适合的。容器集群管理系统里出了Mesos、Kubernetes和Swarm,这里面谷歌开源出来的Kubernetes被业界公认为是目前最好的工具,但Mesos对集群资源调度及跨集群任务执行有自己的特长而Swarm是Docker公司自己出的Docker管理工具。 Kubernetes是谷歌开源的容器集群管理系统(可以认为是谷歌输给Docker容器之战后采用的另一种战略体现),为封装应用的容器提供资源调度、部署运行、服务发现、扩容缩容等一整套功能。Kubernetes不光光是简单地对Docker的整个生命周期进行管理,它更像个DevOps的PaaS平台,面向应用开发者提供开发、测试和运行Docker的环境;它对外提供的是RESTful的API端口,每个端口对应的是封装了应用的Docker或Docker组合(POD),是将POD打了标签后的服务(Service),或是POD的复制。因为分布式应用出于性能或高可用性的考虑,需要复制多份资源,并且根据负载情况动态伸缩。 相比于Kubernetes,Mesos根本提不上对Docker有什么管理功能。Kubernetes所有的如服务注册、发现,对外提供RESTful接口等PaaS功能都需要由Mesos之外的一个叫Marathon的组件来完成。Mesos本身更注重对底层资源的调度,把每台机器上的CPU、内存、存储聚在一起提供给上层的应用框架使用。每个框架会根据分配到的资源再细分到各个任务或容器上。如果要拿苹果比苹果的话,应该拿Kubernetes和Mesos+Marathon来比较。 5. 集群资源管理与调度 说到这儿有必要把集群资源管理调度搞搞清楚。容器也好,虚机也好,怎样根据底层可使用的物理资源的多少来把它们分配给容器或虚机使用?这就是调度或动态调度。OpenStack 做不好这事,它不能在虚机和资源之间进行调度(VMware的VSphere可以,它有个DRS功能)。Mesos可以,它可以在计算框架和资源之间进行调度;如果计算框架自身具备面向框架内任务的细颗粒度资源调度,而这些任务又是用容器来承载的,那么我们也可以认为Mesos可以在容器与资源之间进行调度(两级调度)。 这种调度的目的就是要提高设备资源的使用率。譬如当你的大数据平台已不再是唯一的Hadoop集群,其它的数据处理框架如Spark、Storm、Kafka等也需要组成集群要你来运行时,你肯定会考虑到资源利用率,运维成本,数据共享等因素。企业一般都希望将所有这些框架部署到一个公共的集群中,让它们共享集群的资源,并对资源进行统一使用,这样,便诞生了资源统一管理与调度平台,其中典型代表就是Mesos和Hadoop生态体系内的Yarn。 首先,资源统一管理和调度平台应该提供一个全局跨域的资源管理器。所有接入的框架要先向该资源管理器申请资源,申请成功之后,再由框架自身的调度器决定将分配到的资源交由哪个任务使用;也就是说,整个大的系统是个双层调度器,第一层是统一管理和调度平台,另一层是框架自身的调度器。 弄清了这一点也就弄清了Mesos和Yarn的各自定位。Mesos是第一层的资源统一管理与调度,它所覆盖的框架集群有大数据类的(Yarn所能支撑的)和非大数据类的(Yarn不能支撑的)。第二层是计算框架自带的调度器如Yarn(或Kubernetes等),对分配到的资源进行再次分配;也就是说,Mesos将大部分调度任务授权给了计算框架。总结来说,Mesos首先完成粗粒度的资源分配,即:将资源分配给框架,然后由框架进行细粒度的资源分配;而Yarn进行细粒度的分配,即:将资源分配给某个任务。 Yarn和Mesos是否单独执行资源调度还没有到下定论的时候,双方也都还在继续演进当中,以支持越来越多的框架。好在Mesos不仅仅是做大数据分布式计算的框架,所以Mesos往往被称为数据中心操作系统,DCOS,是软件定义数据中心的利器。为了让两者能够更好地整合在一起,发挥各自的作用,业界试着用一个叫Myriad的组件来做Y2M或M2Y。不过Myriad的稳定性还有待验证,目前还不能用它来做生产组网。在过渡时期,我们可能不得不考虑由Mesos和Yarn分别组网的情况。 至此,我们可以大致勾勒出来新一代云平台的边际图: - 底层是各类硬件资源,以X86物理机为主,混搭着虚机、小型机、SAN存储、SDS存储、SDN网络等。 - 这些资源统一由OpenStack(或其它云管理软件)云平台来负责管理,管理内容包括自动化部署(OS、虚拟软件等)、可视化监控、IaaS多租户管理、资源组件目录、用户门户等。 - 在这些资源之上我们可以部署Mesos,用它来汇聚底层资源(CPU、内存、存储)并根据需求动态提供给上层的框架(Kubernetes、Hadoop、Spark、Storm、Kafka、MySQL、Redis等)。 - 这些框架如带有自身的资源调度器,可将分配到的资源二次细分到各自的任务或容器中。 6. 应用的服务化与微服务化 在前面谈到容器是轻量级的,用它来承载大块头的应用是不适合的。所以要想通过容器来运行应用必须要对应用进行划小处理。这要比应用迁移至X86上,数据库能不能在虚机上跑之类的云化改造来的更动筋骨一些。传统的企业级应用是单体应用(monolithic application),比如运营商的系统,业务非常复杂,这种巨型系统,首先要关注的是如何根据业务划分子系统。这种划分是一种垂直切分,十几年前开始风行的SOA(Service Oriented Architecture)就是基于这种垂直划分后的子系统的。在SOA体系里,每个子系统都是独立的服务(Service),通过服务接口与外部协作。既然有垂直切分就得有水平切分。传统的企业级应用一般是分层结构,如表现层、应用层和数据层。如果将垂直切分后的子系统按三层架构来设计,我们会得到更细一步的“服务”。这种横竖切割的过程也叫做服务化过程。SOA还同时提供了调用服务的接口协议,XML和WS(Web Service),提供服务之间的通信与整合枢纽:企业服务总线(ESB),服务编排所需要的业务规则流程引擎(BPM)等。 按照 SOA 这种思想和架构原则来改造应用无疑相当于推翻重新开发一遍,在成本上很难接受而且工作过于复杂。 因此大部分企业实践SOA的思路不是划小应用,而是做不同应用系统间的松耦合集成,让系统与系统之间通过服务接口(Service API)和企业服务总线(ESB)进行交互。 应用没有被划小,传统的复杂应用只是通过API将其功能和数据进行了开放,但还装不进轻量级的容器Docker中。实际上应用服务化的目的不是为了使用容器,而是想解决三大问题:一是应用的维护问题,二是应用的开发问题,三是应用的部署问题。 一个简单的应用会随着时间推移逐渐变大。几年后,一个小而简单的应用因为改来改去会变成一个庞然大物。一旦你的应用变成一个庞大而又复杂的怪物,维护开发团队肯定会很痛苦。敏捷开发和快速部署举步维艰,其中最主要的问题就是这个应用太复杂,以至于任何一个程序员都不可能搞懂它。因此,修正bug和添加新功能会变得非常困难,并且很耗时。 我们所要寻求的是加快开发速度和减少变更代价。怎样才能加快开发速度呢?如果我们的开发不是重造轮子,而是每一次做新产品都可以利用已有的东西,那就会好很多。怎样才能减少变更代价呢?如果我们能够理清功能模块之间的关系,合理分层,每次变更只需要修改其中某个部分,甚至不需要修改代码,仅仅是改变参数配置就可以了。 我们先不看软件行业,来看一下建筑行业,他们是怎么盖楼房的呢?施工之前先设计,把整个楼房分解为不同预制件,比如钢筋混凝土的楼板、门窗、石膏隔断墙等,分别在各地生产,最后在现场组装,所以整个搭建过程非常快。之后的维修也是那块坏了,换那块,不用一动就上下一大串、左右一大片。 除去开发和维护方面的问题之外,我们还要解决的是应用部署问题。谁没听说过由于程序员登录生产现场误操作导致整个应用瘫痪,长期无法访问的现象?这些现象反映了很多企业的应用部署还是停留在“大锅饭”阶段。所谓的大锅饭就是包含众多功能的应用软件被部署到生产环境时,基本都是以文件的型式打成一个大软件包,然后被部署到一个应用服务器上,如WebLogic、Tomcat等(也可以把这些应用服务器看成个大容器)。应用服务器可以提供很多基础服务比如HTTP服务器,服务目录或共享库包等。问题出在同一个应用服务器会接受好几个不同应用的部署,使得在扩展性、维护性和资源使用上会有很多磕磕绊绊、互相牵连的事情发生。比如当你改动或新添一个功能后,你需要重新部署你的软件到应用服务器上,要重新启动你的应用服务器。装满沉重应用的它需要很长时间来启动;如果可怜的你因为赶活儿没仔细测试你修改后的软件,应用服务器启动不了或启动一段时间后又趴下了,那你造成的影响不光光是你自己的应用而且连累了应用服务器上所有其它的应用。我敢保证摊上这事儿的你,死的心都有了! 这时候不用我说,你大概也明白了为什么我们要把一个复杂的应用服务化了,也就是说划小了。 划小后的应用成了一项项服务(Service),用Docker容器把每个单项服务和它运行所需要的基础软件环境封装在一起,单独地部署,直接运行在标准的X86硬件资源之上。如果你划小后的应用出了问题,影响范围也只限于它而已。你想增添个新功能,你就加一项容器服务,无需牵一发而动全身。某项服务使用频次高了,不够用了,你就把它的容器多复制几份,前面加个负载均衡机制就解决了系统的容量问题、高并发问题。 这时的我已经不用再过多跟您解释什么是“微服务”了。微服务定义:采用一组服务的方式来构建一个应用,服务独立部署在不同的进程中,不同服务通过一些轻量级交互机制来通信,例如 RPC、HTTP(也就是REST) 等,服务可独立扩展伸缩,每个服务定义了明确的边界,不同的服务甚至可以采用不同的编程语言来实现,由独立的团队来维护。 微服务与SOA有很多相同之处。两者都属于典型的、包含松耦合分布式服务的系统结构。但是两种架构背后的意图是不同的:SOA尝试将应用集成,一般采用中央管理模式(ESB模式)来确保各应用能够交互运作。微服务尝试部署新功能,快速有效地扩展开发团队。它着重于分散管理、代码再利用与自动化执行。 7. 分布式数据库 应用服务化了,采用了分布式架构被部署在X86服务器上了。可数据呢?前面说过三层架构的应用展现层和业务逻辑层都可以做云化改造,唯独后端的数据层还因为数据一致性的问题停留在小型机上,成为了瓶颈(访问量大、扩展性差)。企业的核心数据库系统一般都采用“小型机+高端商用数据库+高端存储阵列”的集中式架构,也就是我们常说的IOE(IBM的小机、Oracle的数据库、EMC的存储)。这些设备价格昂贵不说,主要问题还是在于它只允许纵向(Scale-in)而不是横向扩展(Scale-out)。纵向扩展的意思就是在机器内加配置,加CPU,加内存,加硬盘,加到最后就加不了了;而横向扩展则能让您加机器,加节点;一台不够,两台,两台不够十台、百台、千台,形成了集群,形成了我们所说的分布式架构。这后种形式的扩展优越性不言而喻。那您肯定会说应用都划小了,怎么不把数据库也分了得了? 和应用切分一样,我们也可以对数据库通过一系列垂直和水平切分将数据分布到不同的DB服务器上,然后通过路由中间件访问特定的数据库。然而我们面临的困难首先是网络延时问题。因为原来依靠单机内部的通信现在要搬到外面来,成了机器与机器之间的通信,系统的开销一下子因为网络通信而增大。这种通信的代价会使系统单次提交的时间延迟。延迟提高会导致数据库锁定时间变长,使得性能比单机数据库具有明显差距。 分布式数据库面临的另一个问题是数据一致性问题。一致性就是数据保持一致,在分布式系统中,可以理解为多个节点中数据的值是一致的。而一致性又可以分为强一致性与弱一致性。强一致性就是在任意时刻,所有节点中的数据是一样的。弱一致性又有很多种类型,目前分布式系统中广泛实现的是最终一致性。所谓最终一致性,就是不保证在任意时刻任意节点上的同一份数据都是相同的,但是随着时间的迁移,不同节点上的同一份数据总是在向趋同的方向变化。也可以简单的理解为在一段时间后,节点间的数据会最终达到一致状态。 这些问题恰恰是分布式数据库的短板,就像它的可扩展性和可用性优点一样明显。鱼和熊掌不可兼得。根据著名的CAP理论,在分布式数据库应用中,任何分布式系统只可同时满足CAP其中两点,无法三者兼顾。 - Consistency(一致性), 数据一致更新,所有数据变动都是同步的; - Availability(可用性), 好的响应性能,集群中某些节点宕掉了系统照用; - Partition tolerance(分区容错性) ,可靠性。系统如果不能在时限内达成数据一致性,就意味着发生了分区的情况,必须就当前操作在C和A之间做出选择。 CA 系统是要求高可用并且实时一致性。单点数据库是符合这种架构的。 AP 满足可用性,分区容忍性的系统,通常可能对一致性要求低一些。 CP 系统是要求满足一致性,分区容忍性,通常性能不是特别高。 我们不要将精力浪费在如何设计能满足三者的完美分布式系统,而是应该进行取舍。所以分布式的数据库也应该设计成多样的。比如将分析类型应用所需要的数据迁移至以Hadoop为主的分布式NoSQL数据库,将对实时一致性要求不是很高的一些应用迁移至分布式MySQL数据库等。这里有必要提一下分布式关系型数据库中的路由中间件。 数据库中间件对数据库云化改造或对整个IT架构的分布式改造起着非常重要的作用,它能提供的典型功能有分库分表、读写分离、负载均衡、Failover 等。 跟阿里数据库产品打过交道的人都知道它里面有个叫“头都大了”(TDDL,Taobao Distributed Data Layer)的路由代理,用它可以大大简化前端应用与后端数据库的连接,特别是当应用和数据库都成了分布式的时候,这是种N对N的连接。其实TDDL还并没有全部开源,近两年来有个在开源社区十分火爆的牛X产品叫“我的猫”(MyCat)。MyCat技术原理是它拦截了应用发送过来的SQL语句做特定分析:如分片分析、路由分析、读写分离分析、缓存分析等,然后将此SQL发往后端的数据库节点,并将返回的结果做适当的处理,最终再返回给应用。MyCat发展到目前已经不再是一个单纯的MySQL代理了,它的后端可以支持MySQL、SQL Server、Oracle、DB2、PostgreSQL等主流数据库,也支持MongoDB这种新型NoSQL方式的存储,未来还会支持更多类型的数据库。 从用户角度来看,代理中间件提供的就是一个传统的数据库表,支持标准的SQL语句,对前端业务系统来说,可以大幅降低开发难度,提升开发速度。对整个IT架构来说,因为这个中间件可以拥有一个多种数据库的数据服务,拼在一起可以满足CAP要求。 8. 结束语 X86、虚拟化、容器、分布式数据库、微服务,所有这一切都是为了把我们的IT系统搭建起一个面向服务的架构,一个广义上的SOA。其实前面把SOA简单说成是做应用系统间的集成有失公允。因为当我们开发一个新应用时,也可以按照横竖切分的原则来设计服务的开发,形成一个个应用组件,然后通过ESB开放给开发团队使用。我所在的公司前几年搞过一个叫做uCloud的PaaS项目,其设计理念就是上述思路的体现。在ESB之下,开发集成了十几项技术服务和数据库服务供应用方使用,一个典型的SOA架构。问题出在在这样一个部门各自为政、应用开发以第三方厂家为主的公司,如果没有一个强有力的管理措施要求各方必须使用中央管理的Service API时,结果自然可以想象。这令我不得不想起一个叫康威的老外定的一条规律:软件设计的架构,实际上反应了公司的组织与沟通架构(Conway’ s law: Organizations which design systems [...] are constrained to produce designs which are copies of the communication structures of these organizations.)。 公司的组织与沟通是老板领导意识的最佳表现。所以服务化的成功与否不光光是中心化的SOA或去中心化的微服务选择,更重要的是整个企业的一种战略决策。最近微信群里流传早在2002年,亚马逊创始人兼CEO贝佐斯就在亚马逊强制推行了以下六个原则: 所有团队的程序模块都要以通过Service Interface 方式将其数据与功能开放出来。 团队间的程序模块的信息通信,都要通过这些接口。 除此之外没有其它的通信方式。其它形式一概不允许:不能使用直接链结程序、不能直接读取其他团队的数据库、不能使用共享内存模式、不能使用别人模块的后门、等等;唯一允许的通信方式只能是能过调用 Service Interface。 任何技术都可以使用。比如:HTTP、Corba、Pubsub、自定义的网络协议、等等,都可以,贝佐斯不管这些。 所有的Service Interface,毫无例外,都必须从骨子里到表面上设计成能对外界开放的。也就是说,团队必须做好规划与设计,以便未来把接口开放给全世界的程序员,没有任何例外。 不这样的做的人会被炒鱿鱼。 十几年后的亚马逊已经从一个购书网站发展成了全球最大的云公司,恐怕这也是和它的“服务化”战略决策分不开的。贝佐斯的六原则展示出高度的远见和超强的信念,“不谋万世者,不足谋一时;不谋全局者,不足谋一域。” 从另一方面来看,SOA也好,微服务也好,虚拟化也好,容器也好,如果形不成一个公司的整体战略,达到整个生态系统的共识,那么最好不要大张旗鼓地去搞什么全民皆兵的战役。其结果往往以失败而告终。当然谨慎地在自己的部门领域内做些新技术的尝试性工作也未尝不可,这种创新精神还是值得鼓励的。 革命尚未成功,同志仍需努力。 ====================================分割线================================ 本文转自d1net(转载)

优秀的个人博客,低调大师

《Mahout算法解析与案例实战》一一导读

Preface?前 言 为什么要写这本书2010年以后,世界快速进入了大数据时代,Hadoop成为大数据分析的首选平台和开发标准,无数数据分析软件纷纷向Hadoop靠拢。在Hadoop原有技术基础之上,涌现了Hadoop家族产品,它们正在配合“大数据”概念不断创新,推动科技进步。因此,新一代IT精英也必须顺应潮流,抓住机遇,随着Hadoop一起发展和成长!简而言之,Hadoop是由Apache基金会开发的一个优秀的云计算技术框架,用户在其基础上即使不了解分布式底层细节,也可以开发分布式程序。Hadoop家族成员中的诸多成员进一步利用了这一优势,拓展了云计算的应用领域,降低了相应的软件开发门槛,而Mahout就是其中最难掌握,也是最有竞争力且最值得学习的项目之一。Mahout是一个基于Hadoop的机器学习和数据挖掘的分布式计算框架,

优秀的个人博客,低调大师

容器界大事件:深度解析 containerd

美国时间12月14日,Docker公司宣布将containerd从Docker Engine中分离,并捐赠到一个新的开源社区独立发展和运营,"一个工业标准的容器运行时,注重简单、 健壮性、可移植性"。containerd可以作为daemon程序运行在Linux和Windows上,管理机器上所有容器的生命周期。阿里云,AWS, Google,IBM和Microsoft作为初始成员,会为项目提供贡献和维护人员。 containerd对于很多人来还是很陌生,为什么Docker公司会大张旗鼓地宣布这个开源项目,并得到了业界巨大的反响。 实际上早在16年3月,Docker 1.11的Docker Engine里就包含了containerd,而现在则是把containerd从Docker Engine里彻底剥离出来,作为一个独立的开源项目独立发

优秀的个人博客,低调大师

Spark 动态资源分配(Dynamic Resource Allocation) 解析

前言 最近在使用Spark Streaming程序时,发现如下几个问题: 高峰和低峰Spark Streaming每个周期要处理的数据量相差三倍以上,预分配资源会导致低峰的时候资源的大量浪费。 Spark Streaming 跑的数量多了后,资源占用相当可观。 所以便有了要开发一套针对Spark Streaming 动态资源调整的想法。我在文章最后一个章节给出了一个可能的设计方案。不过要做这件事情,首先我们需要了解现有的Spark 已经实现的 Dynamic Resource Allocation 机制,以及为什么它无法满足现有的需求。 入口 在SparkContext 中可以看到这一行: _executorAllocationManager = if (dynamicAllocationEnabled) { Some(new ExecutorAllocationManager(this, listenerBus, _conf)) } else { None } 通过spark.dynamicAllocation.enabled参数开启后就会启动ExecutorAllocationManager。 这里有我第一个吐槽的点,这么直接new出来,好歹也做个配置,方便第三方开发个新的组件可以集成进去。但是Spark很多地方都是这么搞的,完全没有原来Java社区的风格。 动态调整资源面临的问题 我们先看看,动态资源调整需要解决哪几个问题: Cache问题。如果需要移除的Executor含有RDD cache该如何办? Shuffle问题。 如果需要移除的Executor包含了Shuffle Write先关数据该怎么办? 添加和删除之后都需要告知DAGSchedule进行相关信息更新。 Cache去掉了重算即可。为了防止数据抖动,默认包含有Cache的Executor是不会被删除的,因为默认的Idle时间设置的非常大: private val cachedExecutorIdleTimeoutS = conf.getTimeAsSeconds( "spark.dynamicAllocation.cachedExecutorIdleTimeout", s"${Integer.MAX_VALUE}s") 你可以自己设置从而去掉这个限制。 而对于Shuffle,则需要和Yarn集成,需要配置yarn.nodemanager.aux-services。具体配置方式,大家可以Google。这样Spark Executor就不用保存Shuffle状态了。 触发条件 添加Worker的触发条件是: 有Stage正在运行,并且预估需要的Executors > 现有的 删除Woker的触发条件是: 一定时间内(默认60s)没有task运行的Executor 我们看到触发条件还是比较简单的。这种简单就意味着用户需要根据实际场景,调整各个时间参数,比如到底多久没有运行task的Executor才需要删除。 默认检测时间是100ms: private val intervalMillis: Long = 100 如何实现Container的添加和释放 只有ApplicationMaster才能够向Yarn发布这些动作。而真正的中控是org.apache.spark.ExecutorAllocationManager,所以他们之间需要建立一个通讯机制。对应的方式是在ApplicationMaster有一个private class AMEndpoint(类,比如删除释放容器的动作在里就有: case KillExecutors(executorIds) => logInfo(s"Driver requested to kill executor(s) ${executorIds.mkString(", ")}.") Option(allocator) match { case Some(a) => executorIds.foreach(a.killExecutor) case None => logWarning("Container allocator is not ready to kill executors yet.") } context.reply(true) 而ExecutorAllocationManager则是引用YarnSchedulerBackend实例,该实例持有ApplicationMaster的 RPC引用 private var amEndpoint: Option[RpcEndpointRef] 如何获取调度信息 要触发上面描述的操作,就需要任务的调度信息。这个是通过ExecutorAllocationListener extends SparkListener来完成的。具体是在 ExecutorAllocationMaster的start函数里,会将该Listener实例添加到SparkContext里的listenerBus里,从而实现对DAGSchecude等模块的监听。机制可以参看这篇文章 Spark ListenerBus 和 MetricsSystem 体系分析。 根据上面的分析,我们至少要知道如下三个信息: Executor上是否为空,如果为空,就可以标记为Idle.只要超过一定的时间,就可以删除掉这个Executor. 正在跑的Task有多少 等待调度的Task有多少 这里是以Stage为区分的。分别以三个变量来表示: private val stageIdToNumTasks = new mutable.HashMap[Int, Int] private val stageIdToTaskIndices = new mutable.HashMap[Int, mutable.HashSet[Int]] private val executorIdToTaskIds = new mutable.HashMap[String, mutable.HashSet[Long]] 名字已经很清楚了。值得说的是stageIdToTaskIndices,其实就是stageId 对应的正在运行的task id 集合。 那么怎么计算出等待调度的task数量呢?计算方法如下: stageIdToNumTasks(stageId) - stageIdToTaskIndices(stageId).size 这些都是动态更新变化的,因为有了监听器,所以任务那边有啥变化,这边都会得到通知。 定时扫描器 有了上面的铺垫,我们现在进入核心方法: private def schedule(): Unit = synchronized { val now = clock.getTimeMillis updateAndSyncNumExecutorsTarget(now) removeTimes.retain { case (executorId, expireTime) => val expired = now >= expireTime if (expired) { initializing = false removeExecutor(executorId) } !expired } } 该方法会每隔100ms被调度一次。你可以理解为一个监控线程。 Executor判定为空闲的机制 只要有一个task结束,就会判定有哪些Executor已经没有任务了。然后会被加入待移除列表。在放到removeTimes的时候,会把当前时间now + executorIdleTimeoutS * 1000 作为时间戳存储起来。当调度进程扫描这个到Executor时,会判定时间是不是到了,到了的话就执行实际的remove动作。在这个期间,一旦有task再启动,并且正好运行在这个Executor上,则又会从removeTimes列表中被移除。 那么这个Executor就不会被真实的删除了。 Executor 需要增加的情况 首先,系统会根据下面的公式计算出实际需要的Executors数目: private def maxNumExecutorsNeeded(): Int = { val numRunningOrPendingTasks = listener.totalPendingTasks + listener.totalRunningTasks (numRunningOrPendingTasks + tasksPerExecutor - 1) / tasksPerExecutor } 接着每个计算周期到了之后,会和当前已经有的Executors数:numExecutorsTarget 进行比较。 如果发现 maxNumExecutorsNeeded < numExecutorsTarget 则会发出取消还有没有执行的Container申请。并且重置每次申请的容器数为1,也就是numExecutorsToAdd=1 否则如果发现当前时间now >= addTime(addTime 每次会增加一个sustainedSchedulerBacklogTimeoutS ,避免申请容器过于频繁),则会进行新容器的申请,如果是第一次,则增加一个(numExecutorsToAdd),如果是第二次则增加2个以此按倍数类推。直到maxNumExecutorsNeeded <= numExecutorsTarget ,然后就会重置numExecutorsToAdd。 所以我们会发现,我们并不是一次性就申请足够的资源,而是每隔sustainedSchedulerBacklogTimeoutS次时间,按[1,2,4,8]这种节奏去申请资源的。因为在某个sustainedSchedulerBacklogTimeoutS期间,可能已经有很多任务完成了,其实不需要那么多资源了。而按倍数上升的原因是,防止为了申请到足够的资源时间花费过长。这是一种权衡。 DRA评价 我们发现,DRA(Dynamic Resource Allocation)涉及到的点还是很多的,虽然逻辑比较简单,但是和任务调度密切相关,是一个非常动态的过程。这个设计本身也是面向一个通用的调度方式。 我个人建议如果采用了DRA,可以注意如下几点: 设置一个合理的minExecutors-maxExecutors值 将Executor对应的cpuCore 最好设置为<=3 ,避免Executor数目下降时,等不及新申请到资源,已有的Executor就因为任务过重而导致集群挂掉。 如果程序中有shuffle,例如(reduce,groupBy),建议设置一个合理的并行数,避免杀掉过多的Executors。 对于每个Stage持续时间很短的应用,其实不适合这套机制。这样会频繁增加和杀掉Executors,造成系统颠簸。而Yarn对资源的申请处理速度并不快。 Spark Streaming该使用什么机制动态调整资源 现有的DRA机制其实适合长时的批处理过程中,每个Stage需要的资源量不一样,并且耗时都比较长。Spark Streaming 可以理解为循环的微批处理。而DRA是在每次微批处理起作用,可能还没等DRA反应过来,这个周期就已经过了。 Spark Streaming需要一个从全局一天24小时来考虑。每个调度周期的processing time可能更适合作为增减Executors的标准。同时如果发生delay的话,则可以扩大资源申请的速度。并且,因为是周期性的,释放和新增动作只会发生在一个新的周期的开始,所以他并不会面临现有 DRA的问题,譬如需要通过额外的方式保存Shuffle 状态等。 所以实现起来更加容易。我们可能需要同时监听StreamingContext的一些信息。 具体而言: 每个周期检查上个周期的处理时间 ,设为 preProcessingTime,周期为duration, 一般而言,我们的Spark Streaming程序都会让preProcessingTime < duration。否则会发生delay。 如果 preProcessingTime > 0.8 * duration,则一次性将资源申请到maxExecutors。 如果preProcessingTime < duration,则应该删除的Worker为 removeExecutorNum = currentExecutors * ((duration -preProcessingTime)/duration - 0.2) 其中0.2 为预留的worker数。如果removeExecutorNum如果<=0 则不进行任何操作。 假设duration =10s, preProcessingTime= 5s, currentExecutors=100,则我们理论上认为 只要保留50%的资源即可。但是为了防止延时,我们其实额外保留一些20%资源。也就意味着我们删除30个Executor。 我们并不会一次性将资源都释放掉。假设我们增加一个新的参数spark.streaming.release.num.duration=5,这个参数意味着我们需要花费5个周期释放掉这30个Executor的资源。也就是当前这个周期,我们要释放掉 6个Executor。 接着到下一个周期,重复上面的计算。 直到计算结果 <=0 为止。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册