首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

GPU编程(五): 利用好shared memory

目录 前言 CPU矩阵转置 GPU实现 简单移植 单block tile 利用率计算 shared memory 最后 前言 之前在第三章对比过CPU和GPU, 差距非常大. 这一次来看看GPU自身的优化, 主要是shared memory的用法. CPU矩阵转置 矩阵转置不是什么复杂的事情. 用CPU实现是很简单的: #include <stdio.h> #include <stdlib.h> #include <sys/time.h> #define LOG_ #define N 1024 /* 转置 */ void transposeCPU( float in[], float out[] ) { for ( int j = 0; j < N; j++ ) { for ( int i = 0; i < N; i++ ) { out[j * N + i] = in[i * N + j]; } } } /* 打印矩阵 */ void logM( float m[] ) { for ( int i = 0; i < N; i++ ) { for ( int j = 0; j < N; j++ ) { printf( "%.1f ", m[i * N + j] ); } printf( "\n" ); } } int main() { int size = N * N * sizeof(float); float *in = (float *) malloc( size ); float *out = (float *) malloc( size ); /* 矩阵赋值 */ for ( int i = 0; i < N; ++i ) { for ( int j = 0; j < N; ++j ) { in[i * N + j] = i * N + j; } } struct timeval start, end; double timeuse; int sum = 0; gettimeofday( &start, NULL ); transposeCPU( in, out ); gettimeofday( &end, NULL ); timeuse = end.tv_sec - start.tv_sec + (end.tv_usec - start.tv_usec) / 1000000.0; printf( "Use Time: %fs\n", timeuse ); #ifdef LOG logM( in ); printf( "\n" ); logM( out ); #endif free( in ); free( out ); return(0); } GPU实现 简单移植 如果什么都不考虑, 只是把代码移植到GPU: #include <stdio.h> #include <stdlib.h> #include <sys/time.h> #define N 1024 #define LOG_ /* 转置 */ __global__ void transposeSerial( float in[], float out[] ) { for ( int j = 0; j < N; j++ ) for ( int i = 0; i < N; i++ ) out[j * N + i] = in[i * N + j]; } /* 打印矩阵 */ void logM( float m[] ){...} int main() { int size = N * N * sizeof(float); float *in, *out; cudaMallocManaged( &in, size ); cudaMallocManaged( &out, size ); for ( int i = 0; i < N; ++i ) for ( int j = 0; j < N; ++j ) in[i * N + j] = i * N + j; struct timeval start, end; double timeuse; gettimeofday( &start, NULL ); transposeSerial << < 1, 1 >> > (in, out); cudaDeviceSynchronize(); gettimeofday( &end, NULL ); timeuse = end.tv_sec - start.tv_sec + (end.tv_usec - start.tv_usec) / 1000000.0; printf( "Use Time: %fs\n", timeuse ); #ifdef LOG logM( in ); printf( "\n" ); logM( out ); #endif cudaFree( in ); cudaFree( out ); } 不用想, 这里肯定是还不如单线程的CPU的, 真的是完完全全的资源浪费. 实测下来, 耗时是CPU的20多倍, 大写的丢人. 单block 单block最多可以开1024线程, 这里就开1024线程跑下. /* 转置 */ __global__ void transposeParallelPerRow( float in[], float out[] ) { int i = threadIdx.x; for ( int j = 0; j < N; j++ ) out[j * N + i] = in[i * N + j]; } int main() { ... transposeParallelPerRow << < 1, N >> > (in, out); ... } 效率一下就提升了, 耗时大幅下降. tile 但是的话, 如果可以利用多个block, 把矩阵切成更多的tile, 效率还会进一步提升. /* 转置 */ __global__ void transposeParallelPerElement( float in[], float out[] ) { int i = blockIdx.x * K + threadIdx.x; /* column */ int j = blockIdx.y * K + threadIdx.y; /* row */ out[j * N + i] = in[i * N + j]; } int main() { ... dim3 blocks( N / K, N / K ); dim3 threads( K, K ); ... transposeParallelPerElement << < blocks, threads >> > (in, out); ... } 这些都是GPU的常规操作, 但其实利用率依旧是有限的. 利用率计算 利用率是可以粗略计算的, 比方说, 这里的Memory Clock rate和Memory Bus Width是900Mhz和128-bit, 所以峰值就是14.4GB/s. 之前的最短耗时是0.001681s. 数据量是1024*1024*4(Byte)*2(读写). 所以是4.65GB/s. 利用率就是32%. 如果40%算及格, 这个利用率还是不及格的. shared memory 那该如何提升呢? 问题在于读数据的时候是连着读的, 一个warp读32个数据, 可以同步操作, 但是写的时候就是散开来写的, 有一个很大的步长. 这就导致了效率下降. 所以需要借助shared memory, 由他转置数据, 这样, 写入的时候也是连续高效的了. /* 转置 */ __global__ void transposeParallelPerElementTiled( float in[], float out[] ) { int in_corner_i = blockIdx.x * K, in_corner_j = blockIdx.y * K; int out_corner_i = blockIdx.y * K, out_corner_j = blockIdx.x * K; int x = threadIdx.x, y = threadIdx.y; __shared__ float tile[K][K]; tile[y][x] = in[(in_corner_i + x) + (in_corner_j + y) * N]; __syncthreads(); out[(out_corner_i + x) + (out_corner_j + y) * N] = tile[x][y]; } int main() { ... dim3 blocks( N / K, N / K ); dim3 threads( K, K ); struct timeval start, end; double timeuse; gettimeofday( &start, NULL ); transposeParallelPerElementTiled << < blocks, threads >> > (in, out); ... } 这样利用率就来到了44%, 及格了. 所以这就是依据架构来设计算法, 回顾一下架构图: 最后 但是44%也就是达到了及格线, 也就是说, 还有更深层次的优化工作需要做. 这些内容也就放在后续文章中了, 有意见或者建议评论区见~

优秀的个人博客,低调大师

Java并发编程之ThreadLocal源码分析

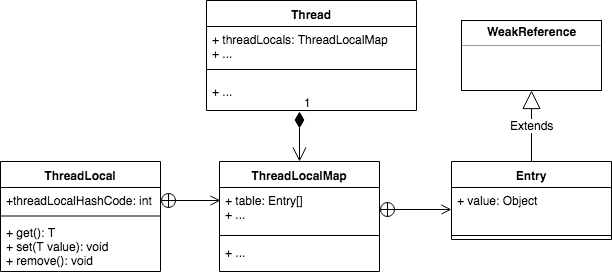
ThreadLocal介绍 ThreadLocal是JDK1.2提供的,作用是给单个线程内的共享变量提供载具。每个线程之间的ThreadLocal里的数据是相互隔离的,并随着线程的消亡而消亡。 使用 ThreadLocal提供了get(),set(T value),remove()3个对外方法。 1.调用get()获取值 2.调用set(T value)设置值 3.调用remove()删除值 使用中的坑 ThreadLocal常被用来做登入状态信息的存储。但是如果当前线程操作完不对状态信息做remove()可能会出现坑。我们拿购买商品举个例子: A用户已经登入,请求购买 ThreadLocal存储A用户信息。 获取ThreadLocal里A用户信息调用去请求购买接口,并返回成功。 A用户线程未被系统回收,待重复利用。 B用户也发起请求购买请求,并重用了A用户使用过的线程,此时B用户并未登入,所以跳过ThreadLocal存储B用户信息的逻辑。 正常情况下B用户会返回需要登入的提示,但此时ThreadLocal存储A用户信息并未被清除,获取A用户信息并调用去请求购买接口,并返回成功。 可以看到B用户使用了A用户的信息去购买了商品,正确的做法应该是每个线程使用结束后去remove()。 ThreadLocal原理 ThreadLocal的UML图如下 调用set方法真正的数据是存在ThreadLocalMap里的,而ThreadLocalMap是线程Thread的成员变量,所以说线程Thread被jvm回收后ThreadLocalMap也会被回收。ThreadLocalMap的实现是采用顺序存储结构哈希表,它跟HashMap不同,每个hash地址只能存一个数据。它key存的是ThreadLocal本身而且它的Entry继承至WeakReference,所以它的key如果没被强引用会在GC的触发的时候回收掉。 set(T value)源码分析 public void set(T value) { //获取当前线程 Thread t = Thread.currentThread(); //根据当前线程获取ThreadLocalMap ThreadLocalMap map = getMap(t); //如果map不为空设置值 if (map != null) map.set(this, value); //如果map为空说明线程中成员变量ThreadLocalMap还没被创建,则创建map else createMap(t, value); } 这个方法主要根据当前线程获取ThreadLocalMap,如果还没初始化则调用createMap(t, value)初始化,反之调用map.set(this, value)设置值。 下面看下getMap(t)的实现 ThreadLocalMap getMap(Thread t) { return t.threadLocals; } 很简单就是获取Thread的成员变量threadLocals 先来看下map为空调用createMap(t, value)去创建ThreadLocalMap的情况: void createMap(Thread t, T firstValue) { t.threadLocals = new ThreadLocalMap(this, firstValue); } createMap(t, value)直接是new的ThreadLocalMap,ThreadLocalMap构造方法如下: ThreadLocalMap(ThreadLocal<?> firstKey, Object firstValue) { //1.创建和初始化table容量 table = new Entry[INITIAL_CAPACITY]; //2.快速hash获取下标地址 int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1); //3.创建Entry,存放第一个数据 table[i] = new Entry(firstKey, firstValue); //4.设置存储个数 size = 1; //5.设置扩容阀值 setThreshold(INITIAL_CAPACITY); } 1.先创建和初始化table容量,table就是存放数据的容器,容器初始容量为16。 2.使用快速hash获取下标地址,这里看下获取firstKey.threadLocalHashCode的代码: private final int threadLocalHashCode = nextHashCode(); private static AtomicInteger nextHashCode = new AtomicInteger(); private static final int HASH_INCREMENT = 0x61c88647; private static int nextHashCode() { return nextHashCode.getAndAdd(HASH_INCREMENT); } nextHashCode()的方法每次创建ThreadLocal都会加HASH_INCREMENT重新计算threadLocalHashCode的值,HASH_INCREMENT这个魔数的选取与斐波那契散列有关为了让哈希码能均匀的分布在2的N次方的数组里,这里指table数组。 3.创建Entry,存放第一个数据,这里以ThreadLocal自己本身key,Entry继承至WeakReference,代码如下: static class Entry extends WeakReference<ThreadLocal<?>> { /** The value associated with this ThreadLocal. */ Object value; Entry(ThreadLocal<?> k, Object v) { super(k); value = v; } } 由于key是弱引用,所以它的key如果没被强引用会在GC的触发的时候回收掉。 4.设置长度为1。 5.设置扩容阀值,看下实现 private void setThreshold(int len) { threshold = len * 2 / 3; } 扩容阀值的计算是容量大小的2/3是,这里结果是10。 下面看下map.set(this, value)实现 private void set(ThreadLocal<?> key, Object value) { //调用set之前已经做过判断,所以table已经初始化了 Entry[] tab = table; //获取tab的长度 int len = tab.length; //1.快速hash获取下标地址 int i = key.threadLocalHashCode & (len-1); //2.用线性探测法解决冲突 for (Entry e = tab[i]; e != null; //取下个下标值 e = tab[i = nextIndex(i, len)]) { ThreadLocal<?> k = e.get(); //3.如果这个key已经存在,重新设置值 if (k == key) { e.value = value; return; } //4.如果key已经过期,则替换这个脏槽 if (k == null) { replaceStaleEntry(key, value, i); return; } } //5.创建Entry tab[i] = new Entry(key, value); //6.存储个数加1 int sz = ++size; //7.清理key已经过期清理的脏槽,如果没脏槽并且存储个数已经大于扩容阀值,则扩容 if (!cleanSomeSlots(i, sz) && sz >= threshold) rehash(); } 1.快速hash获取下标地址。 2.用线性探测法解决冲突,调用nextIndex(i, len)遍历table。我们看下nextIndex(i, len)的源码 private static int nextIndex(int i, int len) { return ((i + 1 < len) ? i + 1 : 0); } 遍历的实现其实设计了一个环,从i开始遍历到达len长度后又开始从0开始。实际上这里用线性探测法解决冲突不会到达len长度,因为在到达之前已经进行了扩容。 3.如果找到的这个key已经存在,重新设置值。 4.如果找到的key已经过期,则替换这个脏槽。 5.创建Entry。 6.存储个数加1。 7.清理key已经过期清理的脏槽,如果未清理到脏槽并且存储个数已经大于扩容阀值,则调用rehash()重hash。 下面来看下replaceStaleEntry(key, value, i)的源码 private void replaceStaleEntry(ThreadLocal<?> key, Object value, int staleSlot) { Entry[] tab = table; int len = tab.length; Entry e; int slotToExpunge = staleSlot; //1.向前查找,找到第一个key过期的脏槽 for (int i = prevIndex(staleSlot, len); (e = tab[i]) != null; i = prevIndex(i, len)) if (e.get() == null) slotToExpunge = i; //2.从staleSlot位置开始向后查找,如果找到key,交换至staleSlot位置的脏槽 for (int i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) { ThreadLocal<?> k = e.get(); //找到key if (k == key) { //交换至staleSlot位置的脏槽 e.value = value; tab[i] = tab[staleSlot]; tab[staleSlot] = e; //如果slotToExpunge == staleSlot,说明前面没有脏槽,直接从i位置开始清理 if (slotToExpunge == staleSlot) slotToExpunge = i; //清理脏槽 cleanSomeSlots(expungeStaleEntry(slotToExpunge), len); return; } //如果slotToExpunge == staleSlot,说明前面没有脏槽,直接从i位置开始清理 if (k == null && slotToExpunge == staleSlot) slotToExpunge = i; } //3.如果没有找到key,则创建一个新的Entry放至staleSlot位置的脏槽 tab[staleSlot].value = null; tab[staleSlot] = new Entry(key, value); //4.如果运行过程中有找到脏槽,清理之 if (slotToExpunge != staleSlot) cleanSomeSlots(expungeStaleEntry(slotToExpunge), len); } 1.从staleSlot位置向前查找,找到第一个key过期的脏槽 2.从staleSlot位置开始向后查找,如果找到key,交换至staleSlot位置的脏槽 3.如果没有找到key,则创建一个新的Entry放至staleSlot位置的脏槽 4.如果运行过程中有找到脏槽,清理之,这里slotToExpunge != staleSlot 成立说明slotToExpunge已经改变说明找到了脏槽。 cleanSomeSlots(expungeStaleEntry(slotToExpunge), len)的作用主要是清理脏槽expungeStaleEntry(slotToExpunge)方法作用的从slotToExpunge位置(包括slotToExpunge)开始清理临近的脏槽。 下面来看下expungeStaleEntry(slotToExpunge)的源码 private int expungeStaleEntry(int staleSlot) { Entry[] tab = table; int len = tab.length; // 1.清理槽 tab[staleSlot].value = null; tab[staleSlot] = null; //存储个数减一 size--; // 2.重hash或清理staleSlot之后的槽,直到空值 Entry e; int i; for (i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) { ThreadLocal<?> k = e.get(); //2.1如果轮询到的k为空,则清理之 if (k == null) { e.value = null; tab[i] = null; size--; } else { //2.2重hash,重新设置hash已经改变的Entry的位置 int h = k.threadLocalHashCode & (len - 1); if (h != i) { tab[i] = null; while (tab[h] != null) h = nextIndex(h, len); tab[h] = e; } } } //3.返回清理遍历的最后位置i return i; } 1.清理staleSlot位置的槽。这里清理的逻辑就是将value设置为null并将整个Entry设置为null,以便后续新Entry覆盖使用。 2.重hash或清理staleSlot之后的槽,直到空值。 2.1 如果轮询到的k为空,则清理之。 2.2 重hash,重新设置hash已经改变的Entry的位置。这里i地址有可能是经过线性探测解决的冲突的方式找到的地址,因为前面的槽已经被清理过所以线性探测解决的冲突方法找到的地址可能已经不是i,所以这边需要重新用线性探测解决的冲突方法查找新地址。 3 .返回清理遍历的最后位置i。 总结下expungeStaleEntry(slotToExpunge)逻辑其实不仅仅清理传的slotToExpunge地址的槽也会清理它临近的槽。 拿到清理遍历的最后位置i后会调用cleanSomeSlots(int i, int n)继续从i开始清理脏槽下面来看下的源码: private boolean cleanSomeSlots(int i, int n) { boolean removed = false; Entry[] tab = table; int len = tab.length; do { //环形遍历 i = nextIndex(i, len); Entry e = tab[i]; //如果是脏槽,则清理之 if (e != null && e.get() == null) { n = len; removed = true; //最终调用expungeStaleEntry(i)去清理 i = expungeStaleEntry(i); } //log2(n)清理次数 } while ( (n >>>= 1) != 0); return removed; } cleanSomeSlots(int i, int n)主要功能就是从i位置开始遍历log2(n)次去清理槽,为什么是log2(n)次官方给的原因是简单,快速。所以这个方法可能不是清理所有的脏槽,而是简单快速的清理几个脏槽。 下面来看下rehash()方法 private void rehash() { //1.清理所有的脏槽 expungeStaleEntries(); //2.如果清理过后存储个数还是大于扩容阀值的3/4,则扩容 if (size >= threshold - threshold / 4) resize(); } 1.调用expungeStaleEntries()清理所有的脏槽。 2.如果清理过后存储个数还是大于扩容阀值的3/4,则扩容。 下面看下expungeStaleEntries()方法源码 private void expungeStaleEntries() { Entry[] tab = table; int len = tab.length; for (int j = 0; j < len; j++) { Entry e = tab[j]; if (e != null && e.get() == null) expungeStaleEntry(j); } } 代码很简单就是遍历所有的table并清理脏槽。 下面看下resize()方法源码 private void resize() { Entry[] oldTab = table; //获取老table容量 int oldLen = oldTab.length; //新table容量扩大2倍 int newLen = oldLen * 2; Entry[] newTab = new Entry[newLen]; int count = 0; //遍历老的table,对所有Entry重hash定位 for (int j = 0; j < oldLen; ++j) { Entry e = oldTab[j]; if (e != null) { ThreadLocal<?> k = e.get(); //如果遇到脏槽,清理之帮助GC if (k == null) { e.value = null; // Help the GC } else { //重hash int h = k.threadLocalHashCode & (newLen - 1); //线性探测法解决冲突 while (newTab[h] != null) h = nextIndex(h, newLen); newTab[h] = e; count++; } } } //重新计算扩容阀值 setThreshold(newLen); //重新设置存储个数 size = count; //重新设置table table = newTab; } resize()实现也比较简单,先创建比原来大2倍的Entry数组,并遍历老的table,对所有Entry重hash定位,如果冲突就是采用线性探测法解决冲突。 get()源码分析 看下get()的源码 public T get() { //获取当前线程 Thread t = Thread.currentThread(); //根据当前线程获取ThreadLocalMap ThreadLocalMap map = getMap(t); //如果不为空获取Entry if (map != null) { ThreadLocalMap.Entry e = map.getEntry(this); if (e != null) { @SuppressWarnings("unchecked") T result = (T)e.value; return result; } } //为空获取初始化的值 return setInitialValue(); } 这个方法主要根据当前线程获取ThreadLocalMap,如果还没初始化则调用setInitialValue()初始化并返回值,反之调用map.getEntry(this)获取值。 先来看下map不为空调用map.getEntry(this)的源码: private Entry getEntry(ThreadLocal<?> key) { //1.快速hash获取hash地址 int i = key.threadLocalHashCode & (table.length - 1); Entry e = table[i]; //2.如果找到Entry,则返回 if (e != null && e.get() == key) return e; //3.如果未快速找到,则去遍历查找 else return getEntryAfterMiss(key, i, e); } 1.快速hash获取hash地址 2.如果找到Entry,则返回 3.如果未快速找到,则调用getEntryAfterMiss(key, i, e)去遍历查找,由于用线性探测法解决冲突, 来看下getEntryAfterMiss(key, i, e)的源码: private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) { Entry[] tab = table; int len = tab.length; //从i位置开始遍历table while (e != null) { ThreadLocal<?> k = e.get(); //如果找到直接返回 if (k == key) return e; //如果是脏槽清理之 if (k == null) expungeStaleEntry(i); //获取下个地址 else i = nextIndex(i, len); e = tab[i]; } return null; } 实现很简单就是从i位置开始遍历table,找到就返回Entry,遍历过程中顺便清理脏槽。 再来看下setInitialValue()的源码: private T setInitialValue() { //1.获取默认初始化值 T value = initialValue(); Thread t = Thread.currentThread(); //2.根据当前线程获取ThreadLocalMap ThreadLocalMap map = getMap(t); //3.不为空,设置值 if (map != null) map.set(this, value); //4.反之初始化map else createMap(t, value); return value; } 1.获取默认初始化值,这里initialValue()是默认返回null的,源码如下: protected T initialValue() { return null; } 这个可以自己实现覆盖原来的方法。 2.根据当前线程获取ThreadLocalMap。 3.不为空,则调用map.set(this, value)设置值。 4.反之则调用createMap(t, value)初始化map。 remove()源码分析 直接看下remove()源码 public void remove() { //1.根据当前线程获取ThreadLocalMap ThreadLocalMap m = getMap(Thread.currentThread()); //2.如果map已经存在则调用m.remove(this)删除值 if (m != null) m.remove(this); } 1.根据当前线程获取ThreadLocalMap 2.如果map已经存在则调用m.remove(this)删除key为本身的Entry 下面来看下m.remove(this)的源码: private void remove(ThreadLocal<?> key) { Entry[] tab = table; int len = tab.length; //快速hash到地址 int i = key.threadLocalHashCode & (len-1); //向后查找 for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { //如果找到 if (e.get() == key) { //清理key e.clear(); //清理脏槽 expungeStaleEntry(i); return; } } } 实现很简单,先快速hash到地址i,然后从这个地址i往后查找key(包括地址i)直到槽为空,如果找到则清理之。

优秀的个人博客,低调大师

Java并发编程之Condition源码分析

Condition介绍 上篇文章讲了ReentrantLock的加锁和释放锁的使用,这篇文章是对ReentrantLock的补充。ReentrantLock#newCondition()可以创建Condition,在ReentrantLock加锁过程中可以利用Condition阻塞当前线程并临时释放锁,待另外线程获取到锁并在逻辑后通知阻塞线程"激活"。Condition常用在基于异步通信的同步机制实现中,比如dubbo中的请求和获取应答结果的实现。 常用方法 Condition中主要的方法有2个 (1)await()方法可以阻塞当前线程,并释放锁。 (2)在获取锁后可以调用signal()通知被await()阻塞的线程"激活"。 这里的await(),signal()必须在ReentrantLock#lock()和ReentrantLock#unlock()之间调用。 Condition实现分析 Condition的实现也是利用AbstractQueuedSynchronizer队列来实现,await()在被调用后先将当前线程加入到等待队列中,然后释放锁,最后阻塞当前线程。signal()在被调用后会先获取等待队列中第一个节点,并将这个节点转化成ReentrantLock中的节点并加入到同步阻塞队列的结尾,这样此节点的上个节点线程释放锁后会激活此节点线程取来获取锁。 await()方法源码分析 await()源码如下 public final void await() throws InterruptedException { //判断是否当前线程是否被中断中断则抛出中断异常 if (Thread.interrupted()) throw new InterruptedException(); //加入等待队列 Node node = addConditionWaiter(); //释放当前线程锁 int savedState = fullyRelease(node); int interruptMode = 0; //判断是否在同步阻塞队列,如果不在一直循环到被加入 while (!isOnSyncQueue(node)) { //阻塞当前线程 LockSupport.park(this); //判断是否被中断 if ((interruptMode = checkInterruptWhileWaiting(node)) != 0) break; } //获取锁,如果获取中被中断则设置中断状态 if (acquireQueued(node, savedState) && interruptMode != THROW_IE) interruptMode = REINTERRUPT; //清除等待队列中被"激活"的节点 if (node.nextWaiter != null) // clean up if cancelled unlinkCancelledWaiters(); //如果当前线程被中断,处理中断逻辑 if (interruptMode != 0) reportInterruptAfterWait(interruptMode); } 主要分以下几步 (1)先判断是否当前线程是否被中断中断则抛出中断异常如果未中断调用addConditionWaiter()加入等待队列 (2)调用fullyRelease(node)释放锁使同步阻塞队列的下个节点线程能获取锁。 (3)调用isOnSyncQueue(node)判断是否在同步阻塞队列,这里的加入同步阻塞队列操作是在另一个线程调用signal()后加入,如果不在同步阻塞队列会进行阻塞直到被激活。 (4)如果被激活然后调用checkInterruptWhileWaiting(node)判断是否被中断并获取中断模式。 (5)继续调用isOnSyncQueue(node)判断是否在同步阻塞队列。 (6)是则调用acquireQueued(node, savedState) 获取锁,这里如果获取不到也会被阻塞,获取不到原因是在第一次调用isOnSyncQueue(node)前,可能另一个线程已经调用signal()后加入到同步阻塞队列,然后调用acquireQueued(node, savedState) 获取不到锁并阻塞。acquireQueued(node, savedState)也会返回当前线程是否被中断,如果被中断设置中断模式。 (7)在激活后调用unlinkCancelledWaiters()清理等待队列的已经被激活的节点。 (8)最后判断当前线程是否被中断,如果被中断则对中断线程做处理。 下面来看下addConditionWaiter()实现 private Node addConditionWaiter() { //获取等待队列尾部节点 Node t = lastWaiter; //如果尾部状态不为CONDITION,如果已经被"激活",清理之,然后重新获取尾部节点 if (t != null && t.waitStatus != Node.CONDITION) { unlinkCancelledWaiters(); t = lastWaiter; } //创建以当前线程为基础的节点,并将节点模式设置成CONDITION Node node = new Node(Thread.currentThread(), Node.CONDITION); //如果尾节点不存在,说明队列为空,将头节点设置成当前节点 if (t == null) firstWaiter = node; //如果尾节点存在,将此节点设置成尾节点的下个节点 else t.nextWaiter = node; //将尾节点设置成当前节点 lastWaiter = node; return node; } addConditionWaiter()的逻辑很简单,就是创建以当前线程为基础的节点并把节点加入等待队列的尾部待其他线程处理。 下面来看下fullyRelease(Node node)实现 final int fullyRelease(Node node) { boolean failed = true; try { //获取阻塞队列中当前线程节点的锁状态值 int savedState = getState(); //释放当前线程节点锁 if (release(savedState)) { failed = false; return savedState; } else { throw new IllegalMonitorStateException(); } } finally { //释放失败讲节点等待状态设置成关闭 if (failed) node.waitStatus = Node.CANCELLED; } } 调用getState()先获取阻塞队列中当前线程节点的锁状态值,这个值可能大于1表示多次重入,然后调用release(savedState)释放所有锁,如果释放成功返回锁状态值。 下面来看下isOnSyncQueue(Node node)实现 final boolean isOnSyncQueue(Node node) { //判断当前节点是否是CONDITION或者前置节点是否为空如果为空直接返回false if (node.waitStatus == Node.CONDITION || node.prev == null) return false; //如果下个节点存在,则在同步阻塞队列中返回true if (node.next != null) // If has successor, it must be on queue return true; //遍历查找当前节点是否在同步阻塞队列中 return findNodeFromTail(node); } private boolean findNodeFromTail(Node node) { Node t = tail; for (;;) { if (t == node) return true; if (t == null) return false; t = t.prev; } } 此方法的功能是查找当前节点是否在同步阻塞队列中,方法先是快速判断,判断不了再进行遍历查找。 (1)第一步先判断次节点是否CONDITION状态或者前置节点是否存在,如果是表明不在队列中返回false,阻塞队列中的状态一般是0或者SIGNAL状态而且如果当前如果当前节点在队列阻塞中且未被激活前置节点一定不为空。 (2)第二步判断节点的下个节点是否存在,如果存在则表明当前当前节点已加入到阻塞队列中。 (3)如果以上2点都没法判断,也有可能刚刚加入到同步阻塞队列中,所以调用findNodeFromTail(Node node)做最后的遍历查找。查找从队列尾部开始查,从尾部开始查的原因是可能刚刚加入到同步阻塞队列中,从尾部能快速定位。 下面看下checkInterruptWhileWaiting(Node node)实现 private int checkInterruptWhileWaiting(Node node) { return Thread.interrupted() ? (transferAfterCancelledWait(node) ? THROW_IE : REINTERRUPT) : 0; } final boolean transferAfterCancelledWait(Node node) { if (compareAndSetWaitStatus(node, Node.CONDITION, 0)) { enq(node); return true; } while (!isOnSyncQueue(node)) Thread.yield(); return false; } 此方法在线程被激活后被调用,主要功能就是判断被激活的线程是否被中断。此方法会返回2种中断状态THROW_IE和REINTERRUPT,THROW_IE是调用signal()前被中断返回,REINTERRUPT在调用signal()后被中断返回。 此方法先判断是否被标记中断,是的话再调用transferAfterCancelledWait(node)取判断是那种中断状态,transferAfterCancelledWait(node)方法分2步 (1)用CAS方式将节点状态改错等待状态改成CONDITION,并加入到同步阻塞队列中返回true (2)如果不能加入到同步阻塞队列就自旋一直等待加入 如果使用await()方法上面2步其实是没什么作用其最后一定会返回false,因为await()被激活只能调用 signal()方法,而signal()方法肯定已经将节点加入到同步阻塞队列中。所以以上逻辑是给await(long time, TimeUnit unit)等带超时激活方法用的。 acquireQueued(node, savedState)方法再上一章节已经讲过这边就不重复了,下面分析下unlinkCancelledWaiters()方法 private void unlinkCancelledWaiters() { //获取等待队列头节点 Node t = firstWaiter; Node trail = null; while (t != null) { //获取下个节点 Node next = t.nextWaiter; //如果状态不为CONDITION说明已经加入阻塞队列需要清理掉 if (t.waitStatus != Node.CONDITION) { t.nextWaiter = null; if (trail == null) firstWaiter = next; else //获取下个节点 trail.nextWaiter = next; if (next == null) lastWaiter = trail; } else trail = t; t = next; } } 此方法就是从头开始查找状态不为CONDITION的节点并清理,状态不为CONDITION节点说明此节点已经加入到阻塞队列,已经不需要维护。 下面来看下reportInterruptAfterWait(interruptMode)方法 private void reportInterruptAfterWait(int interruptMode) throws InterruptedException { //如果是THROW_IE模式直接抛出异常 if (interruptMode == THROW_IE) throw new InterruptedException(); //如果是REINTERRUPT模式标记线程中断由上层处理中断 else if (interruptMode == REINTERRUPT) selfInterrupt(); } 此方法处理中断逻辑。如果是THROW_IE模式直接抛出异常,如果是REINTERRUPT模式标记线程中断由上层处理中断。 signal()方法源码分析 signal()源码如下 public final void signal() { //是否当前线程持有锁 if (!isHeldExclusively()) throw new IllegalMonitorStateException(); Node first = firstWaiter; //通知"激活"头节点线程 if (first != null) doSignal(first); } 先调用isHeldExclusively()判断锁是否被当前线程持有,然后检查等待队列是否为空,不为空就是可以取第一个节点调用doSignal(first)去"激活",这里激活不是真正的激活而只是将节点加入到同步阻塞队列尾部,所以上下文中带""的激活都是这种解释。 下面看下isHeldExclusively()实现 protected final boolean isHeldExclusively() { return getExclusiveOwnerThread() == Thread.currentThread(); } 实现就是比较下当前线程和持有锁的线程是否同一个 下面看下doSignal(first)的实现 private void doSignal(Node first) { do { //头指头后移一位,如果后面的节点为空,则将尾指头也指向空,说明队列为空了 if ( (firstWaiter = first.nextWaiter) == null) lastWaiter = null; //清空头节点的下个节点 first.nextWaiter = null; //如果"激活"失败者取下个继续,直到成功或者遍历完 } while (!transferForSignal(first) && (first = firstWaiter) != null); } 此方法就是取当前头节点一直去尝试"激活",直到成功或者遍历完。 下面来看下transferForSignal(first)方法 final boolean transferForSignal(Node node) { //将CONDITION状态设置成0 if (!compareAndSetWaitStatus(node, Node.CONDITION, 0)) return false; //加入到同步阻塞队列 Node p = enq(node); int ws = p.waitStatus; //状态异常直接激活 if (ws > 0 || !compareAndSetWaitStatus(p, ws, Node.SIGNAL)) LockSupport.unpark(node.thread); return true; } (1)此方法先先将CONDITION状态设置成0,因为如果是CONDITION状态加入到同步阻塞队列,激活的时候是不识别的。 (2)加入到同步阻塞队列的尾部。所以同步阻塞队列中前面如果有多个在排队,调用unlock()不会马上激活此节点。 (3)状态异常直接调用unpark激活,这边按理说如果状态异常情况下激活,await()在调用unlock()被激活后会进行相应的异常处理,但看await()代码没有处理则是正常执行。 这个方法主要就是把节点加入到同步阻塞队列的,真正的激活则是调用unlock()去处理。

优秀的个人博客,低调大师

Java并发编程之ReentrantLock源码分析

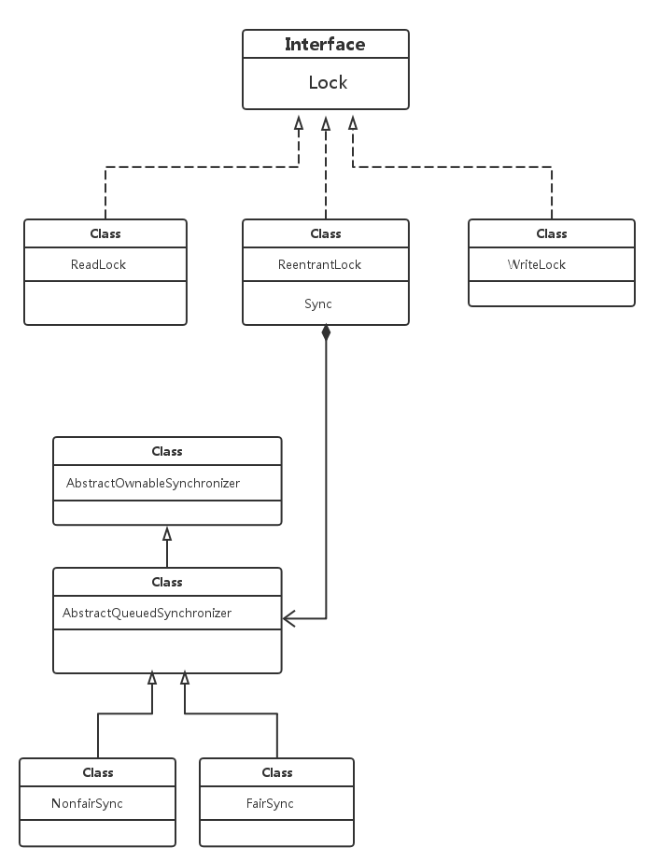
ReentrantLock介绍 从JDK1.5之前,我们都是使用synchronized关键字来对代码块加锁,在JDK1.5引入了ReentrantLock锁。在JDK1.6之前synchronized关键字性能比ReentrantLock锁要差,JDK1.6之后性能基本是持平,但ReentrantLock锁功能要比synchronized关键字功能强大。 特点 synchronized关键字和ReentrantLock锁都是重入锁,可重入锁是指当一个线程获取到锁后,此线程还可继续获得这把锁,在此线程释放这把锁前其他线程则不可获得这边锁。相比synchronized关键字,ReentrantLock锁具有锁获取超时和获取锁响应中断的特点。ReentrantLock锁还分公平锁和非公平锁,公平锁模式是按线程调用加锁的先后排队顺序获取锁,非公平锁模式是已经在排队中的线程按顺序获取锁,但是新来的线程会和排队中的线程进行竞争,并不保证先排先获取锁。 ReentrantLock 源码分析 ReentrantLock实现了java.util.concurrent.locks.Lock接口和java.io.Serializable接口,前者是对实现Java锁的一种规范,后者说明ReentrantLock可以序列化。 ReentrantLock定义了一个成员变量 private final Sync sync; Sync类型是ReentrantLock的内部类,继承至AbstractQueuedSynchronizer ,AbstractQueuedSynchronizer是一个带空头的双向列表,为ReentrantLock的锁排队提供了基础支持。 ReentrantLock的UML关系图如下 下面我们解析下ReentrantLock中几个常用方法。 lock()方法源码分析 lock()是ReentrantLock中最常用的方法,用来对代码块加锁。lock()先是调用Sync的lock()的方法,Sync#lock()实现分为非公平模式和公平模式,我们对这2个模式分别讲解 非公平模式 Sync#lock()非公平模式代码如下: final void lock() { //用CAS方法设置枷锁状态 if (compareAndSetState(0, 1)) setExclusiveOwnerThread(Thread.currentThread()); else //抢锁失败,进入后续逻辑。 acquire(1); } 新来线程先调用compareAndSetState(0, 1)方法用CAS方法设置加锁状态,这里是非公平模式实现要点,这样做主要是为了新来的线程和排队中的线程竞争,排队中的线程激活后也会用CAS方法设置加锁状态,就是看哪个线程线程抢的快,哪个能拿到锁。如果设置加锁状态成功,则设置AbstractQueuedSynchronizer中的全局变量线程为当前当前线程。如果设置加锁状态失败即抢锁失败,则调用acquire(1)进入排队逻辑。 AbstractQueuedSynchronizer#acquire(int arg)实现代码如下: public final void acquire(int arg) { //先调用tryAcquire(arg)再试下能不能获取到锁,无法获取则调用acquireQueued(addWaiter(Node.EXCLUSIVE), arg)进入排队 if (!tryAcquire(arg) && acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 先调用tryAcquire(arg)再试下能不能获取到锁,获取成功则执行结束,无法获取则调用acquireQueued(addWaiter(Node.EXCLUSIVE), arg)进入排队,此方法返回参数为是否中断当前线程,排队过程中如果线程被中断则会返回ture,此时调用selfInterrupt()中断当前线程。 tryAcquire(arg)直接调用了非公平模式nonfairTryAcquire(acquires)方法我们看下实现: final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); //获取锁状态 int c = getState(); //状态未加锁则尝试获取锁 if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } //判断是否是相同线程,如果是则表示当前线程的锁重入了 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 调用getState()方法获取加锁状态,如果为0表示当前未被加锁,尝试CAS设置加锁状态获取锁,如果成功同样设置AbstractQueuedSynchronizer中的全局变量线程为当前当前线程。如果已被加锁,这判断当前线程和加锁线程是否是同一线程,如果是同一线程则将获取锁的状态加1返回获取锁成功,这里就是可重入锁实现的核心,状态的值表示当前线程重入了多少次,之后的释放锁就要释放相同的次数。 接下来我们看下acquireQueued(addWaiter(Node.EXCLUSIVE), arg)方法,acquireQueued主要功能是对当前线程阻塞,阻塞到能被上个获取到锁线程释放为止,addWaiter(Node.EXCLUSIVE)则是将当前线程加入到排队队列中。 我们先来看下addWaiter(Node.EXCLUSIVE)实现 private Node addWaiter(Node mode) { Node node = new Node(Thread.currentThread(), mode); // Try the fast path of enq; backup to full enq on failure Node pred = tail; //CAS快速添加节点到尾部 if (pred != null) { node.prev = pred; if (compareAndSetTail(pred, node)) { pred.next = node; return node; } } //如果尾节点不存在或者添加失败走最大努力添加节点逻辑 enq(node); return node; } private Node enq(final Node node) { for (;;) { Node t = tail; //如果头尾节点为空则创建空节点当头尾节点 if (t == null) { // Must initialize if (compareAndSetHead(new Node())) tail = head; } else { //CAS添加节点到尾部 node.prev = t; if (compareAndSetTail(t, node)) { t.next = node; return t; } } } } 创建已当前线程为基础的节点,先走快速添加到尾部逻辑,获取尾节点如果尾节点存在,将当前节点和尾节点相连,并用CAS方式将当前节点设置为尾节点,这边使用CAS方式考虑了多个线程同时操作尾节点的情况,所以如果尾节点已经变更则快速添加节点操作失败,调用enq(node)方法走最大努力添加节点的逻辑。enq(node)最大努力添加逻辑就是一直添加节点直到添加节点到尾部成功。 下面看下acquireQueued(addWaiter(Node.EXCLUSIVE), arg)的实现 final boolean acquireQueued(final Node node, int arg) { boolean failed = true; try { boolean interrupted = false; for (;;) { final Node p = node.predecessor(); if (p == head && tryAcquire(arg)) { setHead(node); p.next = null; // help GC failed = false; return interrupted; } if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) interrupted = true; } } finally { if (failed) cancelAcquire(node); } } acquireQueued里有个循环,这个循环的主要作用就是在线程激活后重试获取锁直到获取锁。node.predecessor()获取当前线程节点的前一个节点,如果是头节点,则当前线程尝试获取锁,获取锁成功设置当前节点为头节点。如果获取失败或者非头节点则调用shouldParkAfterFailedAcquire(p, node)判断是否需要阻塞等待,如果需要阻塞等待则调用parkAndCheckInterrupt()阻塞当前线程并让出cup资源直到被前一个节点激活,继续循环逻辑。 我们先来看下shouldParkAfterFailedAcquire(p, node)的实现 private static boolean shouldParkAfterFailedAcquire(Node pred, Node node) { int ws = pred.waitStatus; if (ws == Node.SIGNAL) return true; if (ws > 0) { do { node.prev = pred = pred.prev; } while (pred.waitStatus > 0); pred.next = node; } else { compareAndSetWaitStatus(pred, ws, Node.SIGNAL); } return false; } 先获取前个节点的状态,状态分以下4类 static final int CANCELLED = 1; static final int SIGNAL = -1; static final int CONDITION = -2; static final int PROPAGATE = -3; 除了CANCELLED关闭状态是非正常,其他状态均正常状态。判断当前状态是否是SIGNAL正常状态,如果是就返回成功,这样当前线程就可以阻塞安心的等待上个节点的激活。如果状态为CANCELLED关闭状态则删除所有当前节点之前状态为CANCELLED的节点,返回失败让当前线程重试获取锁,如果是初始化0状态则CAS方式设置状态为SIGNAL。 接下来看下阻塞方法parkAndCheckInterrupt() private final boolean parkAndCheckInterrupt() { LockSupport.park(this); return Thread.interrupted(); } 方法很简单调用LockSupport.park(this)阻塞当前线程,这里要讲下方法返回时调用Thread.interrupted()判断当前线程是否被中断,如果被中断的话,当前线程获取到锁后会调用Thread.currentThread().interrupt()中断线程。 公平模式 公平模式和非公平模式大部分代码相同,主要是获取锁的逻辑不同,我们就讲下代码不同的部分 lock()代码如下 final void lock() { acquire(1); } 非公平模式模式先尝试设置状态来获取锁,而公平模式则直接调用acquire(1)去走排队逻辑。 尝试获取锁的方法tryAcquire(int acquires)也不一样代码如下 protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 该方法跟非公平锁基本都一样,只是在获取锁的时候加了hasQueuedPredecessors()判断,这个方法主要判断了当前线程是否在头节点的下个节点,这样保证了获取锁的顺序性。 unlock()方法源码分析 unlock()方法比较简单,直接调用sync.release(1)方法。 release(1)代码如下 public final boolean release(int arg) { if (tryRelease(arg)) { Node h = head; if (h != null && h.waitStatus != 0) unparkSuccessor(h); return true; } return false; } 先尝试释放锁,如果释放产品这判断当前节点是否为0不为0调用unparkSuccessor(h)方法激活下个节点的线程,否则直接返回。这里会有个疑问为什么h.waitStatus为0不去激活下个节点的线程,如果不激活下个节点的线程是否一直阻塞的,答案是否定的。这样做主要是为了释放锁的效率。waitStatus为0是初始化的值,这个值还没被下个节点线程调用shouldParkAfterFailedAcquire(p, node)方法设置成SIGNAL状态,也就说明下个节点线程还没被阻塞,此时如果下个节点线程调用此方法并设置成SIGNAL状态,势必它会重新获取锁,从而获取到锁避免了上述的问题。 下面来看下tryRelease(arg)方法 protected final boolean tryRelease(int releases) { //重入次数减1 int c = getState() - releases //非持有线程抛异常 if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; //如果释放了所有的重入次则清理持有线程为空 if (c == 0) { free = true; setExclusiveOwnerThread(null); } //设置当前剩余的重入次数 setState(c); return free; } 因为锁可重入,因此调用getState()获取状态的值并减去一次重入次数,得到的c就是剩余重入的次数,然后判断当前释放的线程是否是当前占有锁的线程,如果不是抛出异常,否则先判断c是否为0表示当前线程持有的锁是否释放完全,如果是则设置持有锁的线程的变量为空,并设置锁状态为0,否则设置剩余的c到锁的状态。 接下来看下unparkSuccessor(h)的实现 private void unparkSuccessor(Node node) { int ws = node.waitStatus; if (ws < 0) compareAndSetWaitStatus(node, ws, 0); Node s = node.next; if (s == null || s.waitStatus > 0) { s = null; //查找下个正常状态的节点去激活 for (Node t = tail; t != null && t != node; t = t.prev) if (t.waitStatus <= 0) s = t; } if (s != null) //激活线程 LockSupport.unpark(s.thread); } 获取当前节点状态,设置如果当前节点正常情况则设置成0,然后取当前节点的下个节点,如果下个节点状态非正常即CANCELLED状态,则从队列的尾部开始查找查到最靠近当前的节点且状态正常的节点,然后调用LockSupport.unpark(s.thread)通知此节点停止阻塞。这边会有个疑问如果调用LockSupport.unpark(s.thread)方法后,此节点才调用LockSupport.park(this)去阻塞,这样会不会发生此节点永久阻塞的问题,答案是否定的,LockSupport.unpark(s.thread)方法的实现其实是为线程设置了一个信号量,LockSupport.park(this)就算后调,如果线程相同也会收到此信号从而激活线程,这里的实现原理就不展开讲。

优秀的个人博客,低调大师

Java性能优化之编程技巧总结

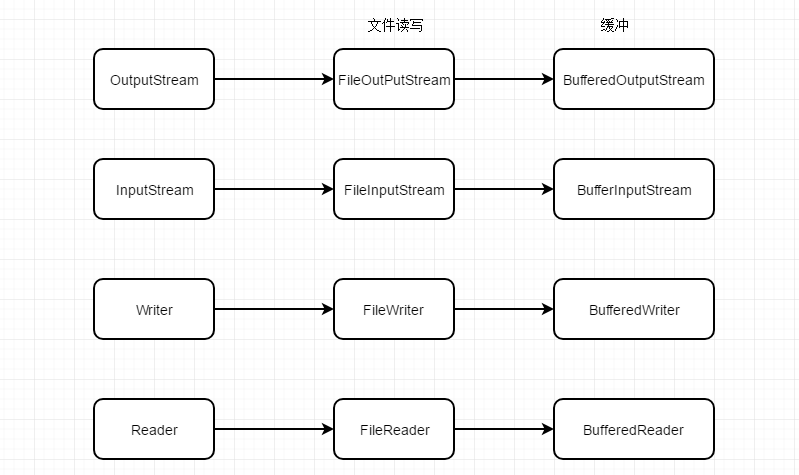
1、慎用异常 在Java软件开发中,经常使用 try-catch 进行错误捕获,但是,try-catch 语句对系统性能而言是非常糟糕的。虽然在一次 try-catch中,无法察觉到它对性能带来的损失,但是,一旦try-catch被应用于循环之中,就会给系统性能带来极大的伤害。 以下是一段将try-catch应用于for循环内的示例 public void test() { int a = 0; try { for (int i = 0; i < 1000000; i++) { a = a + 1; System.out.println(i); } } catch (Exception e) { e.printStackTrace(); } } 这段代码我运行时间是 27211 ms。如果将try-catch移到循环体外,那么就能提升系统性能,如下代码 public void test() { int a = 0; for (int i = 0; i < 1000000; i++) { try { a = a + 1; System.out.println(i); } catch (Exception e) { e.printStackTrace(); } } } 运行耗时 15647 ms。可见tyr-catch对系统性能的影响。 2、使用局部环境 调用方法时传递的参数以及在调用中创建的临时变量都保存在栈(Stack)中,速度较快。其他变量,如静态变量、实例变量等,都在堆(Heap)中创建,速度较慢。 下面是一段测试用例 // private static int a = 0; public static void main(String[] args) { int a = 0; long start = System.currentTimeMillis(); for (int i = 0; i < 1000000; i++) { a = a + 1; System.out.println(i); } System.out.println(System.currentTimeMillis() - start); } 运行结果很明显,使用静态变量耗时15677ms,使用局部变量耗时13509ms。由此可见,局部变量的访问速度高于类的成员变量。 3、位运算代替乘除法 在所有的运算中,位运算是最为高效的。因此,可以尝试使用位运算代替部分算术运算,来提高系统的运行速度。 比如在HashMap的源码中使用了位运算 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16 static final int MAXIMUM_CAPACITY = 1 << 30; 对于整数的乘除运算优化 a*=2 a/=2 用位运算可以写为 a<<=1 a>>=1 4、替换switch 关键字 switch 语句用于多条件判断, switch 语句的功能类似于 if-else 语句,两者性能也差不多。因此,不能说 switch 语句会降低系统的性能。但是,在绝大部分情况下,switch 语句还是有性能提升空间的。 来看下面的例子: public static void main(String[] args) { long start = System.currentTimeMillis(); int re = 0; for (int i = 0;i<1000000;i++){ re = switchInt(i); System.out.println(re); } System.out.println(System.currentTimeMillis() - start+"毫秒");//17860 } public static int switchInt(int z){ int i = z%10+1; switch (i){ case 1:return 3; case 2:return 6; case 3:return 7; case 4:return 8; case 5:return 10; case 6:return 16; case 7:return 18; case 8:return 44; default:return -1; } } 就分支逻辑而言,这种 switch 模式的性能并不差。但是如果换一种新的思路替代switch,实现相同的程序功能,name性能就能有很大的提升空间。 public static void main(String[] args) { long start = System.currentTimeMillis(); int re = 0; int[] sw = new int[]{0,3,6,7,8,10,16,18,44}; for (int i = 0;i<1000000;i++){ re = arrayInt(sw,i); System.out.println(re); } System.out.println(System.currentTimeMillis() - start+"毫秒");//12590 } public static int arrayInt(int[] sw,int z){ int i = z%10+1; if (i>7 || i<1){ return -1; }else { return sw[i]; } } 以上代码使用全新的思路,使用一个连续的数组代替了 switch 语句。因为对数据的随机访问是非常快的,至少好于 switch 的分支判断。通过实验,使用switch的语句耗时17860ms,使用数组的实现只耗时12590ms,提升了5s多。在软件开发中,换一种思路可能会取得更好的效果,比如使用数组替代switch语句就是就是一个很好的例子。 5、一维数组代替二维数组 由于数组的随机访问的性能非常好,许多JDK类库,如ArrayList、Vector等都是使用了数组作为其数组实现。但是,作为软件开发人员也必须知道,一位数组和二维数组的访问速度是不一样的。一位数组的访问速度要优于二维数组。因此,在性能敏感的系统中要使用二维数组的,可以尝试通过可靠地算法,将二维数组转为一维数组再进行处理,以提高系统的响应速度。 6、提取表达式 在软件开发过程中,程序员很容易有意无意让代码做一些“重复劳动”,在大部分情况下,由于计算机的告诉运行,这些“重复劳动”并不会对性能构成太大的威胁,但若将系统性能发挥到极致,提取这些“重复劳动”相当有意义。 来看下面的测试用例: @Test public void test(){ long start = System.currentTimeMillis(); ArrayList list = new ArrayList(); for (int i = 0;i<100000;i++){ System.out.println(list.add(i)); } //以上是为了做准备 for (int i = 0;i<list.size();i++){ System.out.println(list.get(i)); } System.out.println(System.currentTimeMillis() - start);//5444 } 如果我们把list.size()方法提取出来,优化后的代码如下: @Test public void test(){ long start = System.currentTimeMillis(); ArrayList list = new ArrayList(); for (int i = 0;i<100000;i++){ System.out.println(list.add(i)); } //以上是为了做准备 int n = list.size(); for (int i = 0;i<n;i++){ System.out.println(list.get(i)); } System.out.println(System.currentTimeMillis() - start);//3514 } 在我的机器上,前者耗时5444ms,后者耗时3514ms,相差2s左右,可见,提取重复的操作是相当有意义的。 7、展开循环 与前面所介绍的优化技巧略有不同,笔者认为展开循环是一种在极端情况下使用的优化手段,因为展开循环很可能会影响代码的可读性和可维护性,而这两者对软件系统来说也是极为重要的。但是,当性能问题成为系统主要矛盾时,展开循环绝对是一种值得尝试的技术。 8、布尔运算代替位运算 虽然位运算的速度远远高于算术运算,但是在条件判断时,使用位运算替代布尔运算却是非常错误的选择。 在条件判断时,Java会对布尔运算做相当充分的优化。假设有表达式 a,b,c 进行布尔运算“a&&b&&c” ,根据逻辑与的特点,只要在整个布尔表达式中有一项返回false,整个表达式就返回false,因此,当表达式a为false时,该表达式将立即返回 false ,而不会再去计算表达式b 和c。同理,当计算表达式为“a||b||c”时,也是一样。 若使用位运算(按位与”&“、按位或”|“)代替逻辑与和逻辑或,虽然位运算本身没有性能问题,但是位运算总是要将所有的子表达式全部计算完成后,再给出最终结果。因此,从这个角度来说,使用位运算替代布尔运算会使系统进行很多无效计算。 9、使用arrayCopy() 数组复制是一项使用频率很高的功能,JDK中提供了一个高效的API来实现它: 如果在应用程序需要进行数组复制,应该使用这个函数,而不是自己实现。 方法代码: public static native void arraycopy(Object src, int srcPos, Object dest, int destPos, int length); 它的用法是将源数组 src 从索引 srcPos 处复制到目标数组 dest 的 索引destPos处,复制的长度为 length。 System.arraycopy() 方法是 native 方法,通常 native 方法的性能要优于普通的方法。仅出于性能考虑,在软件开发中,尽可能调用 native 方法。 10、使用Buffer进行I/O流操作 除NIO外,使用 Java 进行 I/O操作有两种基本方法: 使用基于InputStream 和 OutputStream 的方式;(字节流) 使用 Writer 和 Reader。(字符流) 无论使用哪种方式进行文件 I/O,如果能合理地使用缓冲,就能有效的提高I/O的性能。 11、使用clone()代替new 在Java中新建对象实例最常用的方法是使用 new 关键字。JDK对 new 的支持非常好,使用 new 关键字创建轻量级对象时,速度非常快。但是,对于重量级对象,由于对象在构造函数中可能会进行一些复杂且耗时的操作,因此,构造函数的执行时间可能会比较长。导致系统短期内无法获得大量的实例。为了解决这个问题,可以使用Object.clone() 方法。 Object.clone() 方法可以绕过构造函数,快速复制一个对象实例。但是,在默认情况下,clone()方法生成的实例只是原对象的浅拷贝。 这里不得不提Java只有值传递了,关于这点,我的理解是基本数据类型引用的是值,普通对象引用的也是值,不过这个普通对象引用的值其实是一个对象的地址。代码示例: int i = 0; int j = i; //i的值是0 User user1 = new User(); User user2 = user1; //user1值是new User()的内存地址 如果需要深拷贝,则需要重新实现 clone() 方法。下面看一下ArrayList实现的clone()方法: public Object clone() { try { ArrayList<?> v = (ArrayList<?>) super.clone(); v.elementData = Arrays.copyOf(elementData, size); v.modCount = 0; return v; } catch (CloneNotSupportedException e) { // this shouldn't happen, since we are Cloneable throw new InternalError(e); } } 在ArrayList的clone()方法中,首先使用 super.clone() 方法生成一份浅拷贝对象。然后拷贝一份新的elementData数组让新的ArrayList去引用。使克隆后的ArrayList对象与原对象持有不同的引用,实现了深拷贝。 12、静态方法替代实例方法 使用 static 关键字描述的方法为静态方法。在Java中,由于实例方法需要维护一张类似虚函数表的结构,以实现对多态的支持。与静态方法相比,实例方法的调用需要更多的资源。因此,对于一些常用的工具类方法,没有对其进行重载的必要,那么将它们声明为 static,便可以加速方法的调用。同时,调用 static 方法不需要生成类的实例。比调用实例方法更为方便、易用。

优秀的个人博客,低调大师

Python编程入门基础语法详解经典

一、基本概念 1.内置的变量类型: Python是有变量类型的,而且会强制检查变量类型。内置的变量类型有如下几种: #浮点 float_number=2.3 #复数 complex_number=1+5j #整型 integer_number=1 #list 序列 sample_list=[2,52,36,'abc'] #嵌套 sample_nest=[(2,4,6),{5:7,9:11,'key':[2,5]},6] #dictionary 字典 sample_dic={"key":value, 5:10} #tuple 只读的序列 sample_tuple=(3,9,"ab") 从上面的示例可以看出,python的变量无需声明,可直接给变量赋值。 2.字符串 python中声明一个字符串通常有三种方法,''、" "和''' ''',这三种方法在声明普通字符串时的效果是完全一样的,区别在于字符串本身中存在引号的情况,举例如下: word='good' sentence="hello world" paragraph='''good noon:"nice to meet you."''' python中单行注释采用#开头。 #!/usr/bin/python # First comment print "Hello, world!"; # second comment 上述内容输出:hello,Python!。注释可以在语句或表达式行末。 多行注释可采用三引号,比如: '''This is a comment. This is a comment, too. This is a comment, too. I said that already.''' 转义符 ''; 自然字符串, 通过在字符串前加r或R。 如 r"this is a line with " 则 会显示,并不是换行。 python允许处理unicode字符串,加前缀u或U, 如 u"this is an unicode string"。 3.Python标识符 在python里,标识符有字母、数字、下划线组成。 在python中,所有标识符可以包括英文、数字以及下划线(_),但不能以数字开头。 python中的标识符是区分大小写的。 以下划线开头的标识符是有特殊意义的。以单下划线开头(_foo)的代表不能直接访问的类属性,需通过类提供的接口进行访问,不能用"from xxx import *"而导入; 以双下划线开头的(__foo)代表类的私有成员;以双下划线开头和结尾的(__foo__)代表python里特殊方法专用的标识,如__init__()代表类的构造函数。 4.Python保留字符 下面的列表显示了在Python中的保留字。这些保留字不能用作常数或变数,或任何其他标识符名称。 所有Python的关键字只包含小写字母。 如果你在学习Python的过程中遇见了很多疑问和难题,可以加-q-u-n227 -435-450里面有软件视频资料免费 5.行和缩进 学习Python与其他语言最大的区别就是,Python的代码块不使用大括号({})来控制类,函数以及其他逻辑判断。python最具特色的就是用缩进来写模块。 缩进的空白数量是可变的,但是所有代码块语句必须包含相同的缩进空白数量,这个必须严格执行。如下所示: ifTrue: print"True" else: print"False" 上述,if与else的缩进空白数量相同。以下代码将会报错: ifTrue: print"Answer" print "True" else: print "Answer" print"False" python中分号;标识一个逻辑行的结束,但是实际中一般每个物理行只写一个逻辑行,可以避免使用分号。这样书写便于阅读。注意:不要混合使用空格和制表符来缩进,因为在跨越不同的平台时无法正常工作。 多个物理行中可以写一个逻辑行,使用行连接符,如下: s="peteris writing this article" 二、运算符与表达式 1. 运算符与其用法 2. 运算符优先级(从低到高) 三.控制流 1. 条件语句 1.1 if语句 例子, 执行if语句内的程序 a=input("a:") b=input("b:") if(a > b): print a, " > ", b if else语句: a=input("a:") b=input("b:") if(a > b): print a, " > ", b else: print a, " < ", b 1.2 if…elif…else语句 例子:根据输入的分数,输出分数等级: score=raw_input("score:") score=int(score) if(score >=90)and(score <=100): print"A" elif(score >=80)and(score < 90): print"B" elif(score >=60)and(score < 80): print "C" else: print "D" raw_input() 读取输入值。 1.3 if语句的嵌套 编写条件语句时,应该尽量避免使用嵌套语句。嵌套语句不便于阅读,而且可能会忽略一些可能性。 x=-1 y=99 if(x >=0): if(x > 0): #嵌套的if语句 y=1 else: y=0 else: y=-1 print "y =", y 1.4 实现switch语句的功能 python中没有switch特殊字,Python可以通过字典实现switch语句的功能。 实现方法分两步。首先,定义一个字典。字典是由键值对组成的集合。其次,调用字典的get()获取相应的表达式。 from__future__importdivision x=1 y=2 operator="/" result={ "+" : x+y, "-" : x-y, "*" : x*y, "/" : x/y } print result.get(operator) 输出为0.5; 另一种使用switch分支语句的方案是创建一个switch类,处理程序的流程。 a) 创建一个switch类,该类继承自Python的祖先类object。调用构造函数init( )初始化需要匹配的字符串,并需要定义两个成员变量value和fall。Value用于存放需要匹配的字符串,fall用于记录是否匹配成功,初始值为false,标识匹配不成功。如果匹配成功,程序往后执行。 b) 定义一个match( )方法,该方法用于用于匹配case子句。这里需要考虑三种情况:首先是匹配成功的情况,其次是匹配失败的默认case子句,最后是case子句中没有使用break中断的情况。 c) 重写__iter__( )方法,定义该方法后才能使switch类用于循环语句中。__iter__( )调用match( )方法进行匹配。通过yield保留字,使函数可以在循环中迭代。此外,调用StopIteration异常中断循环。 d) 编写调用代码,在for…in…循环中使用switch类。 #!/usr/bin/python # -*- coding: UTF-8 -*- classswitch(object): def__init__(self, value): # 初始化需要匹配的值value self.value=value self.fall=False # 如果匹配到的case语句中没有break,则fall为true。 def__iter__(self): yieldself.match # 调用match方法 返回一个生成器 raiseStopIteration # StopIteration 异常来判断for循环是否结束 defmatch(self,*args): # 模拟case子句的方法 ifself.fallornotargs: # 如果fall为true,则继续执行下面的case子句 # 或case子句没有匹配项,则流转到默认分支。 returnTrue elifself.valueinargs: # 匹配成功 self.fall=True returnTrue else: # 匹配失败 returnFalse operator="+" x=1 y=2 forcaseinswitch(operator): # switch只能用于for in循环中 ifcase('+'): print x+y break ifcase('-'): printx-y break ifcase('*'): printx*y break ifcase('/'): printx/y break ifcase(): # 默认分支 print"" 2.while...语句 只要在一个条件为真的情况下,while语句允许你重复执行一块语句。while语句是所谓 循环 语句的一个例子。while语句有一个可选的else从句。 whileTrue: pass else: pass #else语句可选,当while为False时,else语句被执行。 pass是空语句。 3.for 循环 foriinrange(0, 5): print i else: pass # 打印0到4 注:当for循环结束后执行else语句;range(a, b)返回一个序列,从a开始到b为止,但不包括b,range默认步长为1,可以指定步长,range(0,10,2); 四、函数 函数通过def定义。def关键字后跟函数的标识符名称,然后跟一对圆括号,括号之内可以包含一些变量名,该行以冒号结尾;接下来是一块语句,即函数体。 defsumOf(a, b): returna+b 4.1 局部变量 在函数内定义的变量与函数外具有相同名称的其他变量没有任何关系,即变量名称对于函数来说是局部的。这称为变量的作用域。global语句, 为定义在函数外的变量赋值时使用global语句。 deffunc(): globalx print "x is ", x x=1 x=3 func() printx 以上代码,输出的结果为: 3 1 4.2 默认参数 通过使用默认参数可以使函数的一些参数是‘可选的’。 defsay(msg, times=1): print msg*times say("peter") say("peter", 3) 注意:只有在形参表末尾的那些参数可以有默认参数值,即不能在声明函数形参的时候,先声明有默认值的形参而后声明没有默认值的形参,只是因为赋给形参的值是根据位置而赋值的。 4.3 关键参数 如果某个函数有很多参数,而现在只想指定其中的部分,那么可以通过命名为这些参数赋值(称为‘关键参数’)。 优点:不必担心参数的顺序,使函数变的更加简单;假设其他参数都有默认值,可以只给我们想要的那些参数赋值。 deffunc(a, b=2, c=3): print"a is %s, b is %s, c is %s"%(a, b, c) func(1) #输出a is 1, b is 2, c is 3 func(1, 5) #输出a is 1, b is 5, c is 3 func(1, c=10) #输出a is 1, b is 2, c is 10 func(c=20, a=30) #输出a is 30, b is 2, c is 20 4.3 return语句 return语句用来从一个函数返回,即跳出函数。可从函数返回一个值。 没有返回值的return语句等价于return None。None表示没有任何东西的特殊类型。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册