首页 文章 精选 留言 我的

精选列表

搜索[融合分析],共10000篇文章
优秀的个人博客,低调大师

docker-compose 源码分析

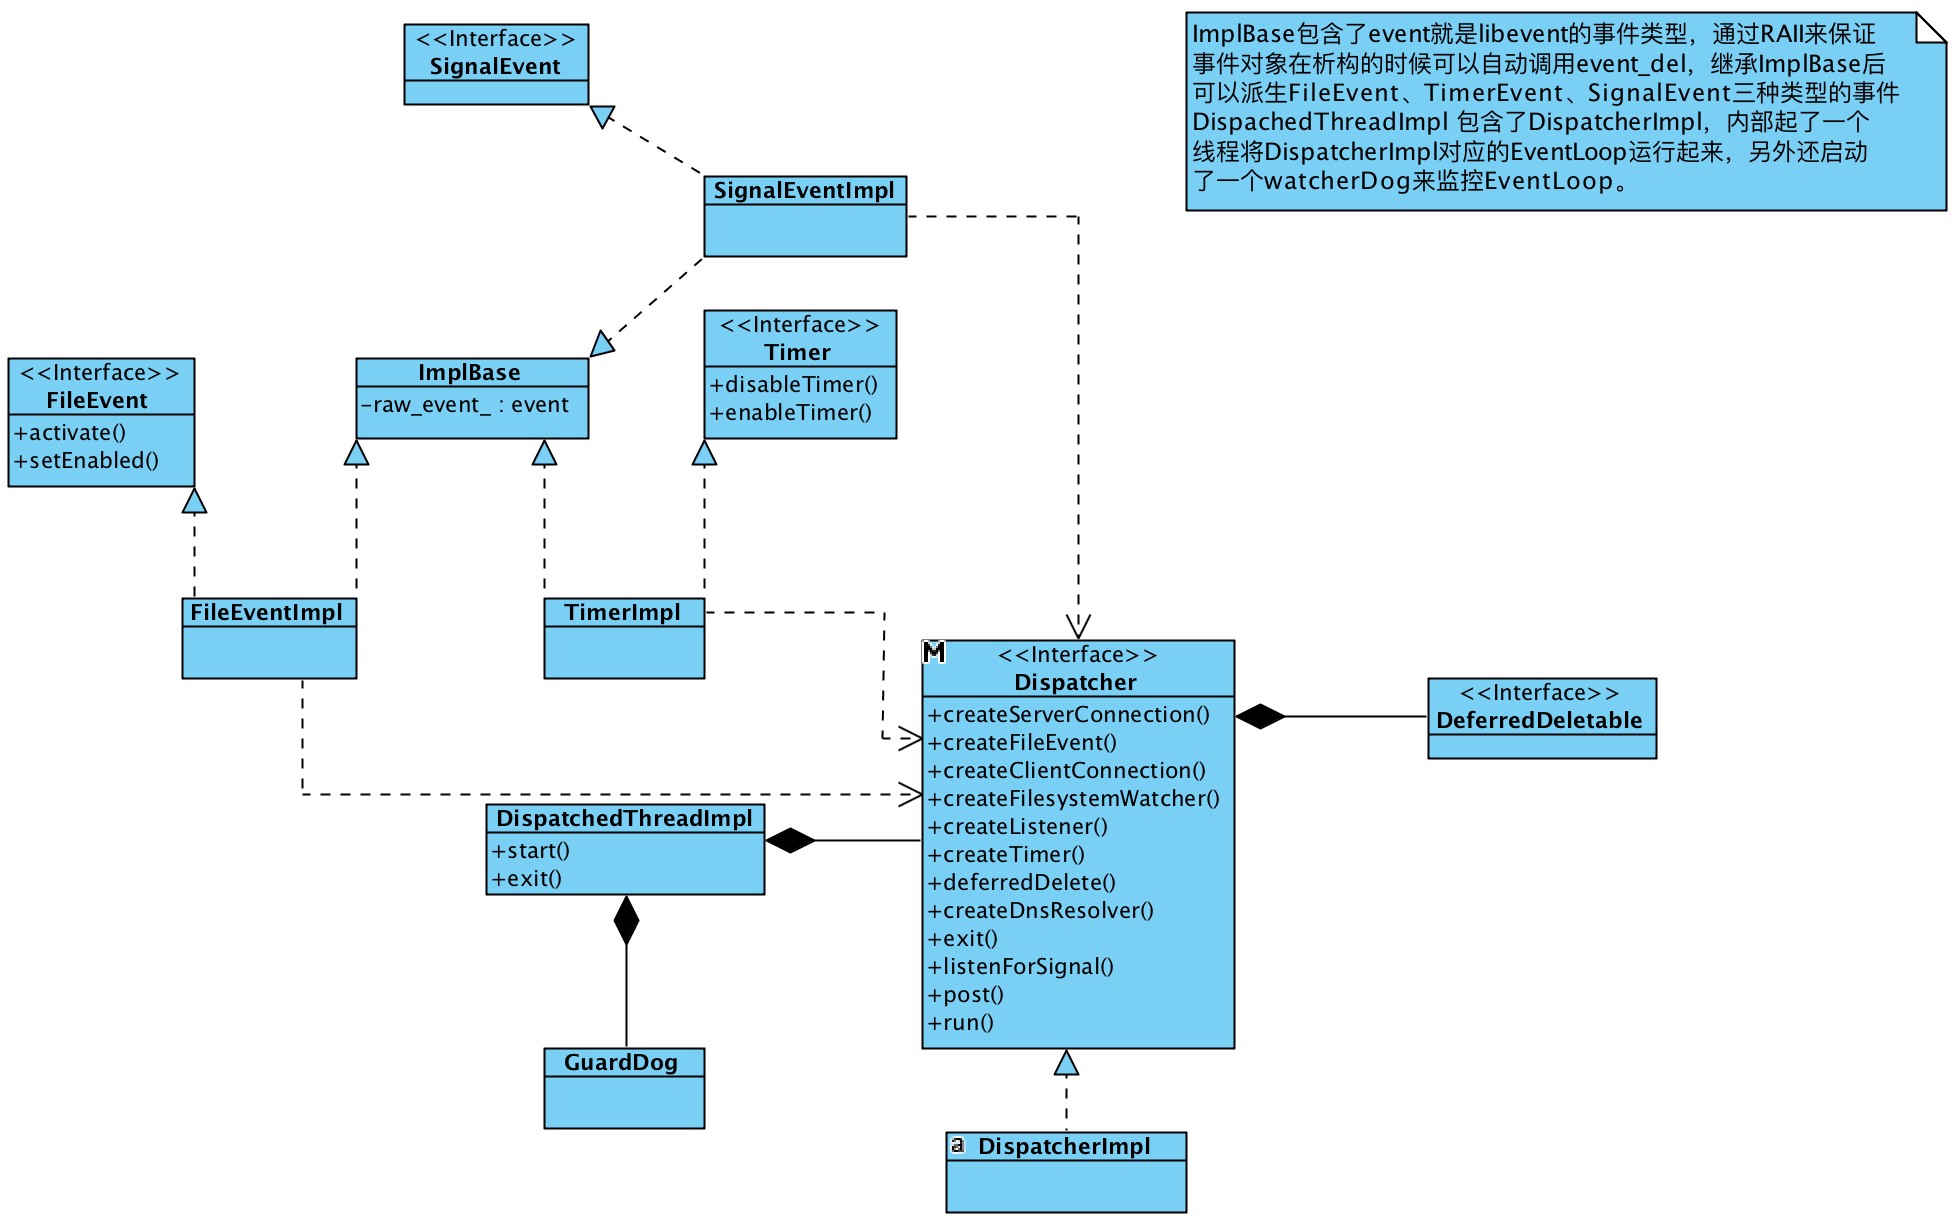
最近搞 devops 相关的内容,将机房的机器集中起来,方便服务部署,算力集中管理等。在 k8s 等都基本搭建完毕之后,闲暇时间学习下 docker-compose 工作原理。 环境准备 下载 compose 源码, 当前最新版本是 1.23.0 $ git clone https://github.com/docker/compose 然后通过 pycharm 导入到项目 架构图 docker-compose 架构图.jpg 在 docker-compose 中使用 docker api 的方式来驱动 dockerd, 如上图所示,所有内容均在 Container 中对 docker 常见操作进行封装。然后在 Project / Service 对象中进行调用 执行流程 执行 docker-compose 命令时,进入到程序主入口 main() 函数 在 main() 函数中调用 dispatch() 函数进行将命令转换为 可执行的对象 a. 构建 DocoptDispatcher 对象, 并解析相关参数置功能基础信息内容 b. 创建 Project 对象,并链接相应的 docker client api c. 创建 TopLevelCommand 对象,并解析相关的参数配置 执行指令内容

优秀的个人博客,低调大师

java 面试题分析

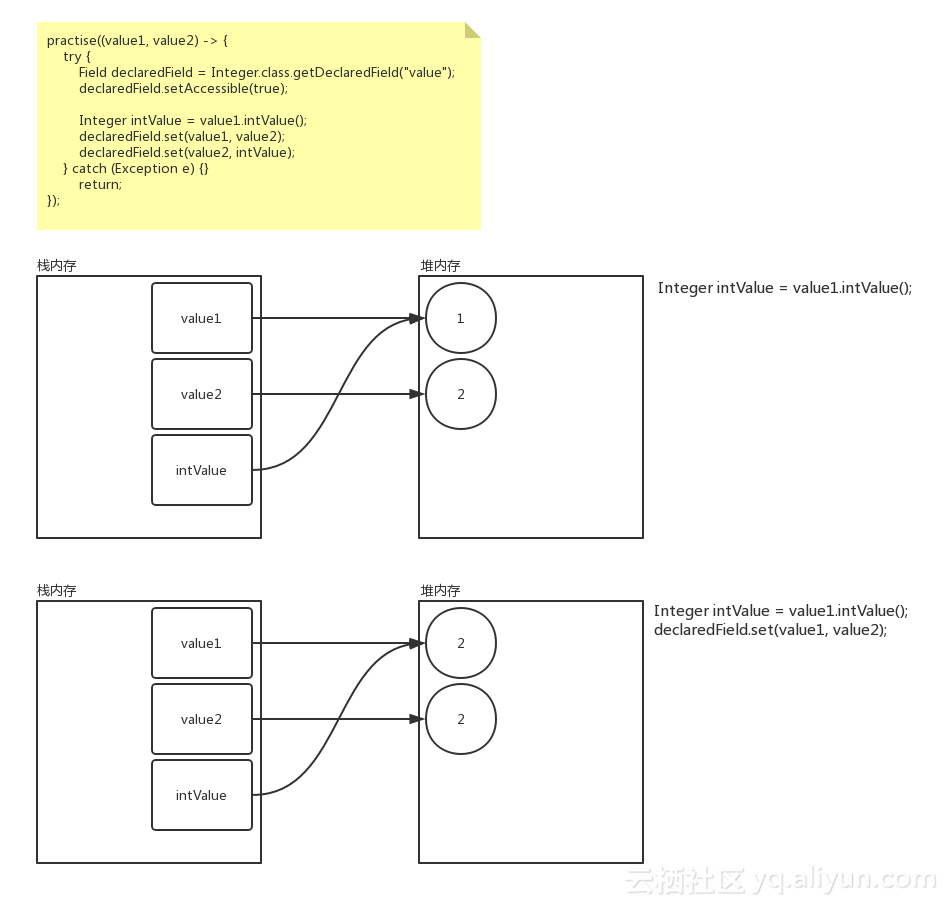
题: 定义两个 Integer 对象传递给一个方法, 方法执行后两个 Integer 的值需要互相转换 public static void practise(MyConsumer<Integer> consumer) { Integer value1 = 1; Integer value2 = 2; System.out.println("start: value1=" + value1 + ", value2=" + value2); consumer.accept(value1, value2); System.out.println("end: value1=" + value1 + ", value2=" + value2); } @FunctionalInterface public interface MyConsumer<T> { void accept (T value1, T value2); } 编程方式一: 传值与传引用的区别 practise((value1, value2) -> { Integer temp = value1; value1 = value2; value2 = temp; return; }); 输入结果: start: value1=1, value2=2 end: value1=1, value2=2 编程方式二: Integer 在 -127 ~ 128 之间的缓存 practise((value1, value2) -> { try { Field declaredField = Integer.class.getDeclaredField("value"); declaredField.setAccessible(true); Integer intValue = value1.intValue(); declaredField.set(value1, value2); declaredField.set(value2, intValue); } catch (Exception e) {} return; }); 输出结果: start: value1=1, value2=2 end: value1=2, value2=2 编程方式三: 清空缓存 practise((value1, value2) -> { try { Field declaredField = Integer.class.getDeclaredField("value"); declaredField.setAccessible(true); Integer intValue = new Integer(value1.intValue()); declaredField.set(value1, value2); declaredField.set(value2, intValue); } catch (Exception e) {} return; }); 输出结果: start: value1=1, value2=2 end: value1=2, value2=1

优秀的个人博客,低调大师

【干货】Kafka 事务特性分析

特性背景 消息事务是指一系列的生产、消费操作可以要么都完成,要么都失败,类似数据库的事务。这个特性在0.10.2的版本是不支持的,从0.11版本开始才支持。华为云DMS率先提供Kafka 1.1.0的专享版服务,支持消息事务特性。 支持事务消息有什么作用?消息事务是实现分布式事务的一种方案,可以确保分布式场景下的数据最终一致性。例如最常用的转账场景,小王 转账到小明,实际操作是小王账户减去相应金额,小明的账户增加相应金额,在分库分表的前提下,2个账户存储在不同的数据库中,这时需要分布式事务才能保证数据库一致性,单个数据库的事务无法保证跨库之间的原子性。如果小王账户先扣钱,再去发送消息到小明所在的数据库去通知增加钱,在没有事务消息的情况下,无论是先扣钱或者先发送通知增加钱,都会有数据不一致的问题,因为无法保证两者的原子性。而有了事务消息,可以保证发送通知与本地事务(扣钱)是一个原子操作,本地事务与发送通知可以同时成功或者同时失败,确保数据一致。 除了数据最终一致性外,还实现了消息Exactly once语义。所谓Exactly once语义是消息传递语义中最难实现的一种,包括At most once:最多一次(不会重复,但是可能丢失数据); At least once:至少投递一次(不会丢失,但是会导致重复)和Exactly once: 刚好一次(不丢不重),也即幂等性。Kafka的幂等性可以保证生产只对一个分区实现Exactl once语义,需要多个分区也实现这个语义,还需要引入消息事务确保原子性。 分布式事务介绍 当前系统架构主流是分布式架构与微服务架构,在这种架构下数据源不是单一的数据库,业务逻辑往往需要在多个数据库中实现原子操作,单个数据库中的强大的本地事务无法保证多节点原子操作。 此时需要分布式事务来确保数据的一致性。目前使用较多的分布式事务解决方案有几种: 1、XA事务:两阶段/三阶段提交 XA是由X/Open组织提出的分布式事务的规范。XA规范主要定义了(全局)事务管理器(Transaction Manager)和(局部)资源管理器(Resource Manager)之间的接口。XA接口是双向的系统接口,在事务管理器(Transaction Manager)以及一个或多个资源管理器(Resource Manager)之间形成通信桥梁。实现XA事务的关键是两阶段和三阶段提交协议。 两阶段提交协议(Two-phase Commit,2PC)经常被用来实现分布式事务。一般分为协调器C和若干事务参与者Si两种角色,这里的事务参与者就是具体的数据库,协调器可以和事务参与者在一台机器上,如下图: 二阶段提交协议主要包括由2个阶段:第一个阶段为准备阶段(prepare),第二阶段为提交阶段。准备阶段由事务协调者向事务参与者发送prepare消息,各个参与者处理本地事务但不提交,然后向事务协调者返回事务状态。 提交阶段根据准备阶段各参与者的执行请求,协调者确定事务是提交或者回滚,向各个参与者发送命令。 二阶段提交协议主要的问题是在提交执行过程中,所有的参与者都需要听从协调者的统一调度,期间处于阻塞状态而不能从事其他操作,这样效率及其低下。特别是当协调者发出提交通知到部分参与者后宕机,其他参与者就会阻塞。 针对二阶段提交存在的问题,三阶段提交协议在prepare与commit阶段之间增加一个pre-commit阶段。Prepare阶段只询问参与者而不做事务,而在pre-commit阶段各个参与者才会执行本地事务但不提交。Commit阶段就是直接提交。这样做可以避免二阶段当协调者迟迟没有发出commit或者rollback通知,参与者在超时后可以自行提交或者回滚,避免阻塞事务(这是因为经过了prepare阶段已经确认了各个参与者是可以执行的,最后第三阶段直接执行即可)。 三阶段提交也存在很多问题,也不能完全保证数据一致,完全一致需要用到Paxos算法。 2、TCC补偿性事务解决方案 TCC分别对应Try、Confirm和Cancel三种操作,含义如下: Try:预留业务资源 Confirm:确认执行业务操作,执行事务 Cancel:取消执行业务操作 TCC解决了跨应用业务操作的原子性问题,在诸如组合支付、账务拆分场景非常实用。TCC实际上把数据库层的二阶段提交上提到了应用层来实现,对于数据库来说是一阶段提交,规避了数据库层的2PC性能低下问题。TCC需要业务提供使用,开发复杂和成本高。 3、事务消息 基于消息中间件的事务消息来完成分布式事务。事务消息可以确保本地执行事务与消息发送是原子的:先发送一条消息到消息中间件,然后执行本地事务,当本地事务成功后再发送提交确认到消息中间件,然后这条消息才能被其他业务消费者所能感知,从而确保原子性。 Kafka消息事务 一、基本概念 为了支持事务,Kafka 0.11.0版本引入以下概念: 1.事务协调者:类似于消费组负载均衡的协调者,每一个实现事务的生产端都被分配到一个事务协调者(Transaction Coordinator)。 2.引入一个内部Kafka Topic作为事务Log:类似于消费管理Offset的Topic,事务Topic本身也是持久化的,日志信息记录事务状态信息,由事务协调者写入。 3.引入控制消息(Control Messages):这些消息是客户端产生的并写入到主题的特殊消息,但对于使用者来说不可见。它们是用来让broker告知消费者之前拉取的消息是否被原子性提交。 4.引入TransactionId:不同生产实例使用同一个TransactionId表示是同一个事务,可以跨Session的数据幂等发送。当具有相同Transaction ID的新的Producer实例被创建且工作时,旧的且拥有相同Transaction ID的Producer将不再工作,避免事务僵死。 5.Producer ID:每个新的Producer在初始化的时候会被分配一个唯一的PID,这个PID对用户是不可见的。主要是为提供幂等性时引入的。 6.Sequence Numbler。(对于每个PID,该Producer发送数据的每个都对应一个从0开始单调递增的Sequence Number。 7.每个生产者增加一个epoch:用于标识同一个事务Id在一次事务中的epoch,每次初始化事务时会递增,从而让服务端可以知道生产者请求是否旧的请求。 8.幂等性:保证发送单个分区的消息只会发送一次,不会出现重复消息。增加一个幂等性的开关enable.idempotence,可以独立与事务使用,即可以只开启幂等但不开启事务。 二、事务流程 如下图所示: 1、查找事务协调者 生产者会首先发起一个查找事务协调者的请求(FindCoordinatorRequest)。协调者会负责分配一个PID给生产者。类似于消费组的协调者。 2、获取produce ID 在知道事务协调者后,生产者需要往协调者发送初始化pid请求(initPidRequest)。这个请求分两种情况: ●不带transactionID 这种情况下直接生成一个新的produce ID即可,返回给客户端 ●带transactionID 这种情况下,kafka根据transactionalId获取对应的PID,这个对应关系是保存在事务日志中(上图2a)。这样可以确保相同的TransactionId返回相同的PID,用于恢复或者终止之前未完成的事务。 3、启动事务 生产者通过调用beginTransaction接口启动事务,此时只是内部的状态记录为事务开始,但是事务协调者认为事务开始只有当生产者开始发送第一条消息才开始。 4、消费和生产配合过程 这一步是消费和生成互相配合完成事务的过程,其中涉及多个请求: ●增加分区到事务请求 当生产者有新分区要写入数据,则会发送AddPartitionToTxnRequest到事务协调者。协调者会处理请求,主要做的事情是更新事务元数据信息,并把信息写入到事务日志中(事务Topic)。 ●生产请求 生产者通过调用send接口发送数据到分区,这些请求新增pid,epoch和sequence number字段。 ●增加消费offset到事务 生产者通过新增的snedOffsets ToTransaction接口,会发送某个分区的Offset信息到事务协调者。协调者会把分区信息增加到事务中。 ●事务提交offset请求 当生产者调用事务提交offset接口后,会发送一个TxnOffsetCommitRequest请求到消费组协调者,消费组协调者会把offset存储在__consumer-offsets Topic中。协调者会根据请求的PID和epoch验证生产者是否允许发起这个请求。 消费offset只有当事务提交后才对外可见。 5、提交或回滚事务 用户通过调用commitTransaction或abortTranssaction方法提交或回滚事务。 ●EndTxnRequest 当生产者完成事务后,客户端需要显式调用结束事务或者回滚事务。前者会使得消息对消费者可见,后者会对生产数据标记为Abort状态,使得消息对消费者不可见。无论是提交或者回滚,都是发送一个EndTnxRequest请求到事务协调者,写入PREPARE_COMMIT或者PREPARE_ABORT信息到事务记录日志中(5.1a)。 ●WriteTxnMarkerRequest 这个请求是事务协调者向事务中每个TopicPartition的Leader发送的。每个Broker收到请求后会写入COMMIT(PID)或者ABORT(PID)控制信息到数据日志中(5.2a)。 这个信息用于告知消费者当前消息是哪个事务,消息是否应该接受或者丢弃。而对于未提交消息,消费者会缓存该事务的消息直到提交或者回滚。 这里要注意,如果事务也涉及到__consumer_offsets,即该事务中有消费数据的操作且将该消费的Offset存于__consumer_offsets中,Transaction Coordinator也需要向该内部Topic的各Partition的Leader发送WriteTxnMarkerRequest从而写入COMMIT(PID)或COMMIT(PID)控制信息(5.2a 左边)。 ●写入最终提交或回滚信息 当提交和回滚信息写入数据日子后,事务协调者会往事务日志中写入最终的提交或者终止信息以表示事务已经完成(图5.3),此时大部分于事务有关系的消息都可以被删除(通过标记后面在日志压缩时会被移除),我们只需要保留事务ID以及其时间戳即可。 接口 示例 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Java进阶-LinkedHashMap 底层分析

众所周知HashMap是一个无序的Map,因为每次根据key的hashcode映射到Entry数组上,所以遍历出来的顺序并不是写入的顺序。 因此 JDK 推出一个基于HashMap但具有顺序的LinkedHashMap来解决有排序需求的场景。 它的底层是继承于HashMap实现的,由一个双向链表所构成。 LinkedHashMap的排序方式有两种: 根据写入顺序排序。 根据访问顺序排序。 其中根据访问顺序排序时,每次get都会将访问的值移动到链表末尾,这样重复操作就能的到一个按照访问顺序排序的链表。 数据结构 1 2 3 4 5 6 7 8 9 10 11 @Test public void test(){ Map<String, Integer> map = new LinkedHashMap<String, Integer>(); map.put("1",1) ; map.put("2",2) ; map.put("3",3) ; map.put("4",4) ; map.put("5",5) ; System.out.println(map.toString()); } 调试可以看到map的组成: 打开源码可以看到: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 /** * The head of the doubly linked list. */ private transient Entry<K,V> header; /** * The iteration ordering method for this linked hash map: <tt>true</tt> * for access-order, <tt>false</tt> for insertion-order. * * @serial */ private final boolean accessOrder; private static class Entry<K,V> extends HashMap.Entry<K,V> { // These fields comprise the doubly linked list used for iteration. Entry<K,V> before, after; Entry(int hash, K key, V value, HashMap.Entry<K,V> next) { super(hash, key, value, next); } } 其中Entry继承于HashMap的Entry,并新增了上下节点的指针,也就形成了双向链表。 还有一个header的成员变量,是这个双向链表的头结点。 上边的 demo 总结成一张图如下: 第一个类似于HashMap的结构,利用Entry中的next指针进行关联。 下边则是LinkedHashMap如何达到有序的关键。 就是利用了头节点和其余的各个节点之间通过Entry中的after和before指针进行关联。 其中还有一个accessOrder成员变量,默认是false,默认按照插入顺序排序,为true时按照访问顺序排序,也可以调用: 1 2 3 4 5 6 public LinkedHashMap(int initialCapacity, float loadFactor, boolean accessOrder) { super(initialCapacity, loadFactor); this.accessOrder = accessOrder; } 这个构造方法可以显示的传入accessOrder。 构造方法 LinkedHashMap的构造方法: 1 2 3 4 public LinkedHashMap() { super(); accessOrder = false; } 其实就是调用的HashMap的构造方法: HashMap实现: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 public HashMap(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; threshold = initialCapacity; //HashMap 只是定义了改方法,具体实现交给了 LinkedHashMap init(); } 可以看到里面有一个空的init(),具体是由LinkedHashMap来实现的: 1 2 3 4 5 @Override void init() { header = new Entry<>(-1, null, null, null); header.before = header.after = header; } 其实也就是对header进行了初始化。 put 方法 看LinkedHashMap的put()方法之前先看看HashMap的put方法: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 public V put(K key, V value) { if (table == EMPTY_TABLE) { inflateTable(threshold); } if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; //空实现,交给 LinkedHashMap 自己实现 e.recordAccess(this); return oldValue; } } modCount++; // LinkedHashMap 对其重写 addEntry(hash, key, value, i); return null; } // LinkedHashMap 对其重写 void addEntry(int hash, K key, V value, int bucketIndex) { if ((size >= threshold) && (null != table[bucketIndex])) { resize(2 * table.length); hash = (null != key) ? hash(key) : 0; bucketIndex = indexFor(hash, table.length); } createEntry(hash, key, value, bucketIndex); } // LinkedHashMap 对其重写 void createEntry(int hash, K key, V value, int bucketIndex) { Entry<K,V> e = table[bucketIndex]; table[bucketIndex] = new Entry<>(hash, key, value, e); size++; } 主体的实现都是借助于HashMap来完成的,只是对其中的recordAccess(), addEntry(), createEntry()进行了重写。 LinkedHashMap的实现: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 //就是判断是否是根据访问顺序排序,如果是则需要将当前这个 Entry 移动到链表的末尾 void recordAccess(HashMap<K,V> m) { LinkedHashMap<K,V> lm = (LinkedHashMap<K,V>)m; if (lm.accessOrder) { lm.modCount++; remove(); addBefore(lm.header); } } //调用了 HashMap 的实现,并判断是否需要删除最少使用的 Entry(默认不删除) void addEntry(int hash, K key, V value, int bucketIndex) { super.addEntry(hash, key, value, bucketIndex); // Remove eldest entry if instructed Entry<K,V> eldest = header.after; if (removeEldestEntry(eldest)) { removeEntryForKey(eldest.key); } } void createEntry(int hash, K key, V value, int bucketIndex) { HashMap.Entry<K,V> old = table[bucketIndex]; Entry<K,V> e = new Entry<>(hash, key, value, old); //就多了这一步,将新增的 Entry 加入到 header 双向链表中 table[bucketIndex] = e; e.addBefore(header); size++; } //写入到双向链表中 private void addBefore(Entry<K,V> existingEntry) { after = existingEntry; before = existingEntry.before; before.after = this; after.before = this; } get 方法 LinkedHashMap 的get()方法也重写了: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 public V get(Object key) { Entry<K,V> e = (Entry<K,V>)getEntry(key); if (e == null) return null; //多了一个判断是否是按照访问顺序排序,是则将当前的 Entry 移动到链表头部。 e.recordAccess(this); return e.value; } void recordAccess(HashMap<K,V> m) { LinkedHashMap<K,V> lm = (LinkedHashMap<K,V>)m; if (lm.accessOrder) { lm.modCount++; //删除 remove(); //添加到头部 addBefore(lm.header); } } clear()清空就要比较简单了: 1 2 3 4 5 //只需要把指针都指向自己即可,原本那些 Entry 没有引用之后就会被 JVM 自动回收。 public void clear() { super.clear(); header.before = header.after = header; } 总结 总的来说LinkedHashMap其实就是对HashMap进行了拓展,使用了双向链表来保证了顺序性。 因为是继承与HashMap的,所以一些HashMap存在的问题LinkedHashMap也会存在,比如不支持并发等。 1、具有1-5工作经验的,面对目前流行的技术不知从何下手,需要突破技术瓶颈的可以加群。 2、在公司待久了,过得很安逸,但跳槽时面试碰壁。需要在短时间内进修、跳槽拿高薪的可以加群。 3、如果没有工作经验,但基础非常扎实,对java工作机制,常用设计思想,常用java开发框架掌握熟练的,可以加群。 4、觉得自己很牛B,一般需求都能搞定。但是所学的知识点没有系统化,很难在技术领域继续突破的可以加群。 5.群号 468947140,点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5yKnHqY 6.阿里Java高级大牛直播讲解知识点,分享知识,知识点都是各位老师多年工作经验的梳理和总结,带着大家全面、科学地建立自己的技术体系和技术认知!

优秀的个人博客,低调大师

Docker Start命令流程分析

首先说明一下在控制台输入docker start命令后的主要流程: postContainersStart (api/server/router/container_routes) ContainerStart (daemon/start.go) GetContainer #根据名字获取景象 validateState #检查container的状态 daemon.containerStart # 进行请求 container.Lock() #上锁 daemon.conditionalMountOnStart #待补充详细过程 daemon.initializeNetworking #(daemon/container_operations) #初始化网络 在这里,网络模式有container,host,default模式 if IsContainer #如果网络模式是container,需要获取需要加入容器的网络配置 if IsHost #如果网络模式是host,hostName设置成主机名字,网络配置与宿主机相同 daemon.createSpec (daemon/oci_linux.go) #应该是设置具体性能配置的,比如cpu速率等 daemon.getLibcontainerdCreateOptions #得到创建容器的选择,应该是启动容器时,需要在容器内执行的命令 daemon.containerd.Create (libcontainerd/client_daemon) #创建啥玩意 daemon.containerd.Start (libcontainerd/client_daemon) #启动啥玩意 container.SetRunning #设置容器的状态为running daemon.setStateCounter #设置daemon的计数 daemon.initHealthMonitor #初始化容器监控 daemon.LogContainerEvent #日志记录容器启动

优秀的个人博客,低调大师

java core dump分析实战

hs_err_pid简介 hs_err_pid<pid>.log是java程序发生core的时候产生的文件,里面有当时出错时jvm的执行情况。 排查方法 头文件解读可以查看问题 头文件包含了简单的信息阐述,里面就core掉的原因 # # An unexpected error has been detected by Java Runtime Environment: # # EXCEPTION_ACCESS_VIOLATION (0xc0000005) at pc=0x69ba3a96, pid=376, tid=1848 # # Java VM: Java HotSpot(TM) Client VM (11.0-b16 mixed mode, sharing windows-x86) # Problematic frame: # C [nvoglnt.dll+0x6a3a96] # 这里的问题是动态库的调用,这个库如果不是java自带的库,而是第三方的库,那么可以查看这个库是否和机型系统想匹配,如果不匹配换匹配的库就好,如果匹配,需要重新安装该库尝试。 # # Out of Memory Error (os_linux_x86.cpp:718), pid=29229, tid=140505843455744 # # JRE version: Java(TM) SE Runtime Environment (7.0_67-b01) (build 1.7.0_67-b01) # Java VM: Java HotSpot(TM) 64-Bit Server VM (24.65-b04 mixed mode linux-amd64 compressed oops) # Failed to write core dump. Core dumps have been disabled. To enable core dumping, try "ulimit -c unlimited" before starting Java again # 这里直接指出了问题的原因是oom,后面还会有物理内存状态,可以用来印证这个错误。 头文件+栈信息 # # An unexpected error has been detected by HotSpot Virtual Machine: # # EXCEPTION_ACCESS_VIOLATION (0xc0000005) at pc=0x009fcf52, pid=4344, tid=5876 # # Java VM: Java HotSpot(TM) Client VM (1.5.0_14-b03 mixed mode) # Problematic frame: # V [jvm.dll+0x9cf52] # 头文件信息告诉我们是jvm.dll这个是jvm自己的库。此时就不能单纯的依靠这个信息来换库解决。 必须看栈信息,一般会有两个模块,一个是Native frames一个是Java frames。 Stack: [0x00030000,0x00070000), sp=0x0006f934, free space=254k Native frames: (J=compiled Java code, j=interpreted, Vv=VM code, C=native code) V [jvm.dll+0x9cf52] C [NativeCode.dll+0x148b] C [NativeCode.dll+0x1253] j com.sy.test.TestNative.sayHello()V+0 j com.sy.test.TestNative.main([Ljava/lang/String;)V+22 v ~StubRoutines::call_stub V [jvm.dll+0x875dd] V [jvm.dll+0xdfd96] V [jvm.dll+0x874ae] V [jvm.dll+0x8e6f1] C [javaw.exe+0x14c5] C [javaw.exe+0x3151] C [kernel32.dll+0x16fd7] Java frames: (J=compiled Java code, j=interpreted, Vv=VM code) j com.sy.test.TestNative.sayHello()V+0 j com.sy.test.TestNative.main([Ljava/lang/String;)V+22 v ~StubRoutines::call_stub 上面的信息,是从java调用到c了,极大的可能是jni的形式,此时需要查看,后面的PATH,LD_LIBRARY_PATH,以及-Djava.library.path查看是否编写了JNI。 场景问题 80%的问题上面的方法都可以推断和解决,下面说说20%的情况 jit问题表征 # JRE version: Java(TM) SE Runtime Environment (8.0_25-b17) (build 1.8.0_25-b17) # Java VM: Java HotSpot(TM) 64-Bit Server VM (25.25-b02 mixed mode linux-amd64 compressed oops) # Problematic frame: # C 0x0000000764928700 Stack: [0x00002b9213782000,0x00002b9213803000], sp=0x00002b92137fe6d0, free space=497k Native frames: (J=compiled Java code, j=interpreted, Vv=VM code, C=native code) C 0x0000000764928700 这种直接就是问题都是寄存器地址的,也没有栈信息的,基本问题在JIT # Problematic frame: # J org.apache.http.impl.cookie.BestMatchSpec.formatCookies(Ljava/util/List;)Ljava/util/List; 上面这种造成core的是java代码引起的,是解释器的问题,基本问题在JIT 纯jvm代码 # JRE version: 6.0_45-b06 # Java VM: Java HotSpot(TM) 64-Bit Server VM (20.45-b01 mixed mode linux-amd64 compressed oops) # Problematic frame: # v ~StubRoutines::jshort_disjoint_arraycopy Stack: [0x00007fecfc9dc000,0x00007fecfca1d000], sp=0x00007fecfca1b4b0, free space=253k Native frames: (J=compiled Java code, j=interpreted, Vv=VM code, C=native code) v ~StubRoutines::jshort_disjoint_arraycopy 上图整体的信息都是jvm的代码,这种情况一般是jvm的bug,可以查jvm的bug列表并且更换jdk 引用案例出处http://bbs.csdn.net/topics/390975171http://blog.csdn.net/zct08/article/details/6333467http://m635674608.iteye.com/blog/2257650

优秀的个人博客,低调大师

ArrayList 序列化分析

0x1 摘要 相信ArrayList是Java开发过程中最常用的集合类之一,底层存储结构是数组,这篇文章不讲解底层数据结构的实现,主要讲解它的序列化机制,大家都知道ArrayList是可以序列化的,但也有一些人不知道具体是怎么序列化的,希望这篇章可以帮到大家。 0x2 ArrayList 类结构图 从类结构图可以看出实现了Serializable接口,说明是可以被序列化的。 0x3 序列化过程详解 在讲解序列过程前,先要清楚ArrayList底层数据结构,摘要中已经提到底层是通过数组实现,下面从源码看一下: /** * The array buffer into which the elements of the ArrayList are stored. * The capacity of the ArrayList is the length of this array buffer. Any * empty ArrayList with elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA * will be expanded to DEFAULT_CAPACITY when the first element is added. */ transient Object[] elementData; // non-private to simplify nested class access elementData成员变量就是用来存储元素,细心的同学可能已经发现,此成员变量用transient关键字修饰,而transient关键字的作用是不需要序列化,存储数据的数组不序列化,那ArrayList是怎么实现数据序列化的呢?继续翻源码会发现存在writeObject、readObject两个方法, /** * Save the state of the <tt>ArrayList</tt> instance to a stream (that * is, serialize it). * * @serialData The length of the array backing the <tt>ArrayList</tt> * instance is emitted (int), followed by all of its elements * (each an <tt>Object</tt>) in the proper order. */ private void writeObject(java.io.ObjectOutputStream s) throws java.io.IOException{ // Write out element count, and any hidden stuff int expectedModCount = modCount; s.defaultWriteObject(); // Write out size as capacity for behavioural compatibility with clone() s.writeInt(size); // Write out all elements in the proper order. for (int i=0; i<size; i++) { s.writeObject(elementData[i]); } if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } } /** * Reconstitute the <tt>ArrayList</tt> instance from a stream (that is, * deserialize it). */ private void readObject(java.io.ObjectInputStream s) throws java.io.IOException, ClassNotFoundException { elementData = EMPTY_ELEMENTDATA; // Read in size, and any hidden stuff s.defaultReadObject(); // Read in capacity s.readInt(); // ignored if (size > 0) { // be like clone(), allocate array based upon size not capacity ensureCapacityInternal(size); Object[] a = elementData; // Read in all elements in the proper order. for (int i=0; i<size; i++) { a[i] = s.readObject(); } } } 从源码上可以看出,从数组中按size大小将元素取出来挨个写入到ObjectOutputStream中,反序列化时首先从ObjectInputStream中取得size大小,再循环取得元素。正常情况下,针对要序列化的对象不需要定义writeObject、readObject方法,采用默认序列化、反序列化方式,如果有特殊需求,则可以在对象中定义writeObject、readObject方法进行扩展,详细实现原理下次写序列化文章时再介绍。那么,ArrayList为什么要采用这种机制呢?上文中已经提到ArrayList底层采用数组存储,当声明一个数组时长度是固定的,在ArrayList中遇到元素个数超过数组大小时会采用自动扩展的方式来加大数组容量,而扩展方法是在原有数组容量的基础上扩大到1.5倍,具体实现可以查看ArrayList#grow方法。这种扩展方法会带来底层数组会存在空值问题,也就是真实数组容量远大于实际元素个数,在这样的前提下,如果直接序列elementData数组会带来不必要的开销,序列化很多空值,从而降低了序列化、反序列化性能,所以通过writeObject、readObject方法来实现序列化实际的元素,从而提升性能。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册