首页 文章 精选 留言 我的

精选列表

搜索[热点技术征文第九期],共10000篇文章
优秀的个人博客,低调大师

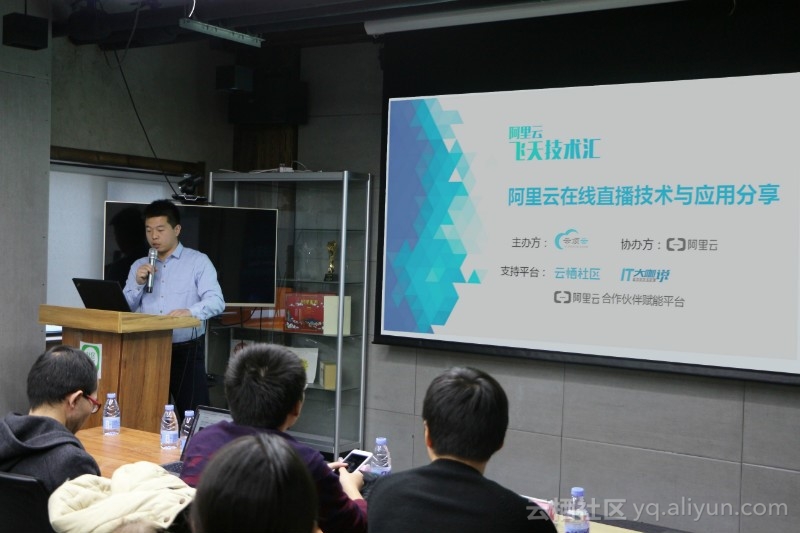
【技术干货】听阿里云CDN安防技术专家金九讲SystemTap使用技巧

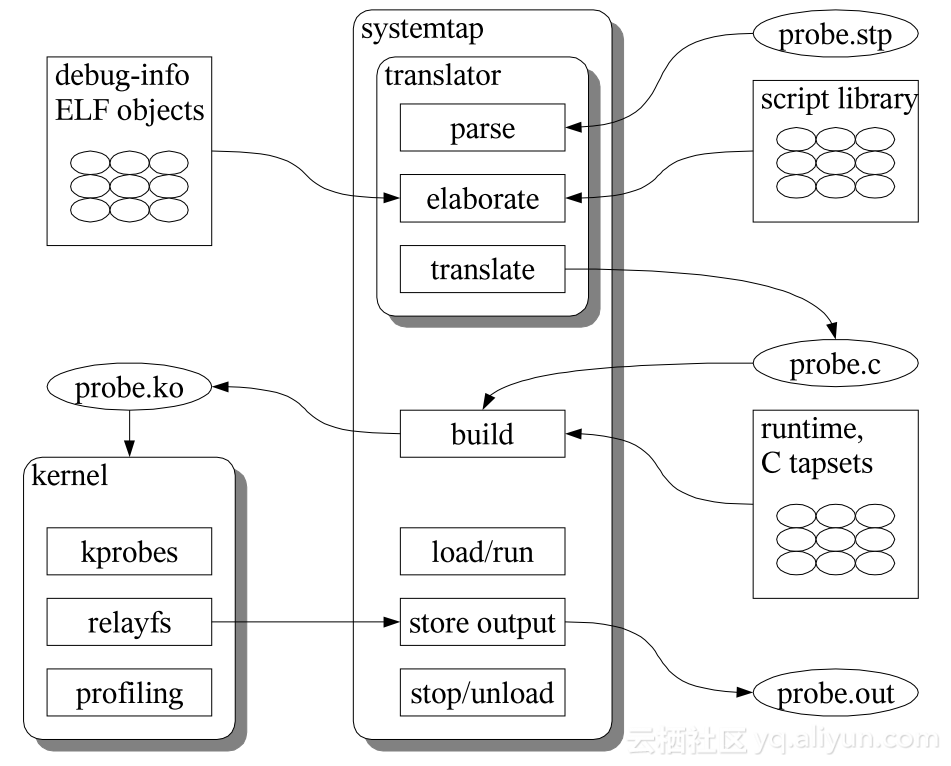
1.简介 SystemTap是一个Linux非常有用的调试(跟踪/探测)工具,常用于Linux 内核或者应用程序的信息采集,比如:获取一个函数里面运行时的变 量、调用堆栈,甚至可以直接修改变量的值,对诊断性能或功能问题非 常有帮助。SystemTap提供非常简单的命令行接口和很简洁的脚本语 言,以及非常丰富的tapset和例子。 2.何时使用 定位(内核)函数位置 查看函数被调用时的调用堆栈、局部变量、参数 查看函数指针变量实际指的是哪个函数 查看代码的执行轨迹(哪些行被执行了) 查看内核或者进程的执行流程 调试内存泄露或者内存重复释放 统计函数调用次数 ...... 3.原理 在网上找了个原理图: SystemTap的处理流程有5个步骤:解析script文件(parse)、细化(elaborate)、script文件翻译成

优秀的个人博客,低调大师

MaaS平台技术栈之Aibrix

Aibrix 是一个开源项目,目标是提供构建可扩展 GenAI 推理基础设施所需的”积木”。它解决的是 LLM 推理上云后的运维问题:模型怎么部署、流量怎么调度、GPU 显存怎么省、资源怎么扩缩容。 ## 1. 为什么不能直接用 Nginx 先把问题定义清楚。LLM 推理服务看起来和其他 HTTP 服务一样:前面挂个网关,后面一排后端 Pod。但把一个请求从网关打到后端,远不止”负载均衡”这么简单。 Aibrix 的官方文档把这类问题归为两个阶段: - **Prefill(预填充)**:一次性处理整个输入 prompt,计算密集,速度快。 - **Decode(解码)**:逐个生成输出 token,受内存带宽限制,速度慢。 一个关键事实是:这两个阶段的运行特征完全不同,而且 KV Cache 把请求变成了”有状态”的。如果网关把一个请求随机打到某个 Pod,而这个 Pod 里没有该请求 prompt 前缀的缓存,那么整个前缀都要重新走一遍 Prefill。这不仅浪费 GPU 算力,还直接拉高了首字延迟(TTFT)。 更麻烦的是,KV Cache 占用的显存远超想象。长上下文模型里,KV Cache 会挤占显存上限,即使最顶级的 GPU 也扛不住。所以社区出现了很多把 KV Cache”换出去”的方案(Dynamo、LMCache、Mooncake 都是这个思路),Aibrix 的 KVCache Offloading 框架也是其中之一。 Aibrix 的整套设计,核心就是应对”有状态、显存敏感、GPU 昂贵”这三个特征。下面按数据面、控制面两条线来拆开讲。 ## 2. 数据面:网关与路由 ### 2.1 网关基于 Envoy Gateway Aibrix 的网关不是自己写代理,而是构建在 **Envoy Gateway** 之上:Envoy 负责高性能转发,Aibrix 以 `external processing`(ext_proc)的方式插入一个网关插件(Gateway Plugin),在请求转发的路径上做路由决策。 网关承担几件事:模型动态发现、请求路由、限流、响应流式转发。 一个值得注意的工程点:**路由是在插件里做的,不是每个请求都去实时查询后端 Pod**。插件会维护一份高频本地缓存,通过周期性拉取 + 订阅的方式拿到各 Pod 的指标,让路由逻辑在热路径上不用阻塞查询,从而能撑到几千 QPS。 网关插件如何作为 Envoy 的 ext_proc 参与流量转发,我在另一篇《Aibrix 是如何利用 Envoy 进行 LLM API 流量转发的》里单独写过,这里不重复。 ### 2.2 路由策略是插拔式的 Aibrix 把路由算法做成了一个 `Router` 接口,内置了多套策略,分为几类: - **通用负载均衡**:`random`、`least-request`、`least-latency`、`least-kv-cache`、`least-gpu-cache`、`throughput`、`power-of-two`(两随机样本取优)。 - **KV Cache 感知**:`prefix-cache`,把请求路由到已缓存其 prompt 前缀 KV Cache 的 Pod;`prefix-cache-preble` 则同时考虑前缀命中率和 Pod 负载。 - **公平性**:`vtc-basic`,平衡按用户的 token 公平性和 Pod 利用率。 - **SLO 感知**:`slo` 系列,根据每个请求的 SLO 来选 Pod。 - **专用**:`pd`(Prefill/Decode 分离路由)、`session-affinity`(会话粘滞)。 策略的选择有明确的优先级,从高到低:config 里模型级 `lockedRoutingStrategy`(锁定后不可被请求覆盖)→ 请求头 `routing-strategy` → 所选 config profile 里的 `routingStrategy` → 启动参数 `ROUTING_ALGORITHM` 环境变量。config profile 可以嵌在模型 Pod 注解里,给每个 profile 配不同的路由策略和 QPS 上限。 想要新增一个算法,只需要实现接口、在 `init()` 里注册,就能通过请求头切换,不需要改框架。 ### 2.3 异构 GPU 推理:成本驱动 不同厂商、不同代际的 GPU 混在一个集群里很常见。异构推理解决两个问题:一是单一型号 GPU 供应紧张买不到,二是想用便宜、慢一点的 GPU 来省钱。 它由三部分组成:**LLM Request Monitoring**(监测历史请求模式)、**Heterogeneous GPU Optimizer**(决定用哪种 GPU、各多少张)、**Request Routing**(把请求路由到最优 GPU)。GPU Optimizer 会基于 profiling 数据做离线的资源分配建议,再交给 K8s 来执行。 需要说明,这个能力在官方文档里明确标注为 **Experimental**。 ### 2.4 语义路由:模型的选择 如果你有一堆模型,想按”问题类型”自动把请求分给不同的模型,Aibrix 提供了一个独立的语义路由器。它本身也是一个 Envoy ext_proc 过滤器,位于网关插件之前。 它会对每个请求做两件事: 1. 提取用户消息内容。 1. 用嵌入(embedding)分类器判断领域,或者用关键字快速命中(比如”step by step”)。 1. 把请求体里的 `model` 字段改写成真正要用的后端模型,必要时注入 system prompt、开启推理模式。 它的判断规则(routing decisions)写成 YAML,落在 ConfigMap 里,每条规则有优先级。这本质上是把”模型选择”从客户端上移到基础设施层。 ### 2.5 Prefill/Decode 分离(PD)路由 这是 Aibrix 在数据面最复杂的路由能力。前面提到 Prefill 和 Decode 特征不同,PD 分离就是把这两个阶段放到**不同的 Pod** 上,各自可以独立调优和扩缩容。它通过两组标签来组织 Pod: - `role-name: prefill|decode`:标识这个 Pod 负责哪个阶段。 - `roleset-name`:把一对 prefill、decode Pod 绑成一个”roleset”。 网关只在 prefill 和 decode 同时都可用时,才使用这个 roleset。KV Cache 通过高速互连从 prefill Pod 传到 decode Pod(GPU 场景用 SHFS,Neuron 场景用 NIXL)。decode Pod 直接把生成的 token 流式返回给客户端。 `pd` 策略下 Pod 的选取是一连串的判断:先按 prompt 长度分桶(bucket),再做 prefill 和 decode 两侧的负载失衡快速判断,最后基于评分策略选最优的 roleset。评分策略里有一种 `conductor`,会估算 prefill 的 TTFT 和 decode 的 token 间延迟(TBT),把 GPU 显存压力(缓存占用超 90% 会罚分)也算进去。 这套机制不只是给 PD 用的,Aibrix 里编排这类多角色部署用的是 **StormService**,一个三层 CRD:`StormService` → `RoleSet` → `Pods`。它支持 Rolling Update / InPlace Update,以及 replica / pooled 两种部署模式,还有 topology policy 用于把 prefill 和 decode Pod 通过亲和性放在同一个节点/可用区,减少跨域传输。这部分属于控制面编排,后面再展开。 ## 3. 控制面:编排、LoRA 与扩缩容 ### 3.1 AI Engine Runtime(引擎运行时) 控制面要和万花筒一样的推理引擎打交道——vLLM、SGLang、TensorRT-LLM 各有各的管理接口。Aibrix 的答案是 **AI Engine Runtime**,一个轻量 sidecar,把引擎的管理操作抽象统一:模型下载、加载/卸载、适配器配置、指标上报。 文档特意强调:这个 runtime 不是 Istio 那种拦截数据流量的 sidecar,数据面流量**不经过它**,它只给控制面提供管理能力。所以这叫”Management Layer”,不是服务网格。 目前它主要服务于 LoRA 部署和多引擎支持。普通场景不一定要装。 ### 3.2 高密度 LoRA:一种”模型”的管理 基础模型(base model)只有一个,但上面可以挂成千上万个 LoRA 适配器。如果为每个 LoRA 单独部署一个 Deployment,显存会浪费到没法看。 Aibrix 的做法是引入 `ModelAdapter` 这个 CRD,由 **Model Adapter Controller** 管理: - 用户提交一个 ModelAdapter,指定 `baseModel`、`podSelector`(选哪些 Pod 能挂)、`artifactURL`(LoRA 权重在哪)。 - Controller 选中匹配且 Readiness 通过的 Pod,把 LoRA 下载并加载到 vLLM 引擎里。 - 加载成功后,Controller 给这个 LoRA 创建一个 Kubernetes Service,让网关能用 adapter 的名字路由到它。 - vLLM 里用 `--max-loras` 控制单个 batch 里最多同时几个 adapter,用 `--max-cpu-loras` 控制 CPU 侧的 LoRA 缓存。 加载失败有重试机制:单 Pod 最多重试 5 次,指数退避(5s 起);某个 Pod 彻底失败了,Controller 会自动切到另一个健康 Pod。所以要求每个 base model 多副本部署,兜底容错。 `replicas` 字段很关键:省略时把 adapter 加载到**所有**匹配 Pod 上(高可用),设为 1 时只放到被调度选中的单个 Pod。 这里有个 K8s 原生设计与 LoRA 场景的冲突:K8s 里一个 Pod 通常只属于一个 Service,但一个 Pod 能挂多个 LoRA。Aibrix 通过自定义 endpoints 的方式,让承载了不同 LoRA 的同一个 Pod 同时属于多个 Service。 ### 3.3 扩缩容:Aibrix Autoscaler Aibrix 的自动扩缩容是个独立的框架,分两大类。 **基于指标(Metrics-based)**。又分三种: - **HPA**:标准 K8s HPA,按 CPU/内存/自定义指标。适合负载平稳的通用场景。 - **KPA**:Knative 风格,双重窗口(stable + panic),突发流量时快速扩容。Aibrix 做了一点增强,自己内部抓指标,不完全依赖 Prometheus 拉取。 - **APA**:Aibrix 自己的 LLM 专用扩缩器,加了波动容忍(fluctuation tolerance),减少扩缩容震荡。 它们消费的指标直接来自服务层,比如 vLLM 暴露的 `request_count`、`token_in_count` / `token_out_count`、`engine_latency_ms`、`kv_cache_size`、`engine_gpu_utilization`。 **基于优化器(Optimizer-based)**。不依赖在线阈值,而是用离线 profiling 数据 + 求解器,提前算出最优的 GPU 数量建议,再交给 K8s 执行。适合:有潮汐规律的调度任务、异构 GPU 的成本/性能优化、SLO 严格需要提前扩容的场景。 扩展方式是在 Deployment 规格里声明用哪种 autoscaler,方便实验不同策略。 ### 3.4 多节点推理与 RayClusterFleet 当模型大到单卡放不下,就需要多节点。Aibrix 复用了 KubeRay 来编排 Ray 集群,但提出了一组新的 CRD:`RayClusterReplicaSet` 和 `RayClusterFleet`(对应 K8s 原生的 ReplicaSet 和 Deployment,只是把”应用实例”从 Pod 换成了 Ray Cluster)。 设计思想是**粗细粒度分工**: - **Ray** 负责应用内部细粒度编排。每个应用实例对应一个 Ray Cluster,用 Ray 的 API 跑分布式计算(比如 vLLM 的 tensor parallel)。 - **Kubernetes** 负责外层粗粒度资源编排:拉起/销毁 Ray Cluster、滚动更新、扩缩容。 这样 K8s operator 不用去管应用内部的角色,能省掉大量复杂度。这套思路还在和 KubeRay 社区对接。 ### 3.5 StormService:服务编排 前面在 PD 路由那里碰到了 StormService,这里展开说。它是一个三层结构的 CRD,专门管理 PD 这类多角色部署的容器生命周期。 - **StormService**:顶层,定义整个服务的规格,记录 replica(RoleSet)数量、统一模板、更新策略。 - **RoleSet**:一组角色的集合,每个角色承担一个职能(prefill / decode)。 - **Pods**:实际执行推理的容器。 更新分两层: - StormService 层:`RollingUpdate`(replica 模式,滚动替换 RoleSet)或 `InPlaceUpdate`(pool 模式,就地更新,不重建 RoleSet)。 - Role 层:`Parallel`(同时更新)、`Sequential`(逐个更新)、`Interleaved`(交错同步推进)。 部署模式则由 `spec.replicas` 自动决定:>1 是 **Replica Mode**(每个 RoleSet 是独立副本),=1 是 **Pooled Mode**(每个 role 独立可扩展,prefill/decode 组成共享资源池)。注意 Pooled Mode 的独立扩缩容目前还不支持,官方是有 Issue 记录的,只能用 RoleSet 里的 replicas 手动调。 `ControllerRevision` 用于版本记录和回滚。Topology policy 用于控制 Pod 亲和性——把 prefill 和 decode Pod 放到同一个拓扑域,减少跨节点/跨可用区的 KV 传输。 ## 4. 显存与缓存:最有价值的部分 ### 4.1 KV Cache 卸载:分层的显存换出去 单节点内置的 KV Cache 有硬伤:容量受显存限制、存储引擎绑定导致无法跨实例共享、难以支撑 KV 迁移和 PD 分离。Aibrix 从 v0.3.0 引入 KVCache Offloading 框架,默认有一层 L1 + 可选一层 L2: - **L1 DRAM 缓存**:默认开启。把 KV Cache 从 GPU 显存换到 CPU 内存,虽然不能跨引擎共享,但能大幅缓解显存压力,性能提升明显。适合”更看重缓存容量而非跨节点共享”的场景。 - **L2 远程缓存**:可选,走分布式 KV Cache 服务(后端的比如字节的 InfiniStore),支持跨多个节点横向扩。这是实现**跨引擎 KV 复用**的基础,多个引擎共享一个分布式缓存,公共 prompt 前缀不用重复计算。 数据面通过 **Offloading Connector** 和推理引擎集成,用优化过的 CUDA kernel 加速 GPU↔CPU 的数据搬运;多层缓存管理器负责在不同存储层之间做负载均衡。驱逐策略可插拔(LRU、S3FIFO 等),后端存储也可插拔(InfiniStore 等)。新增后端只需实现 `Connector` 接口。 ### 4.2 KV Cache 事件同步 前缀路由的前提是网关知道”哪个 Pod 持有哪些前缀的 KV Cache”。Aibrix 用 KV Cache 事件同步来维护这个全局状态: - vLLM 实例通过 ZMQ pub/sub 发布 KV Cache 事件(`BlockStoredEvent`、`BlockRemovedEvent`)。 - 一个 KV Event Manager 订阅这些事件,维护一个 Sync Prefix Cache Indexer 的全局前缀状态。 - 网关路由据此做命中决策。 这个机制对 tokenizer 有严格要求:必须用 remote tokenizer,保证网关和 vLLM 的 token 化一致,否则前后缀对不上。 ### 4.3 ModelClaim:高密度 GPU 运行时池 ModelClaim 是另一个实验功能(文档明确标注 experimental),思路很不一样:与其一个模型一个 Deployment,不如先准备一个”暖”GPU Pod 池,然后多个模型共用这些 Pod。 优点是把几个独立管理的模型引擎塞进同一个暖 Pod 里,通过 kvcached 框架在共置引擎之间做弹性 KV Cache 内存分配,还能把空闲的 vLLM 引擎置为 sleep 模式(查询时唤醒,返回带 `Retry-After` 的 503)。这对于”模型很多、流量都很稀疏”的场景,能省下大量显存。 不过限制也明确:目前每个 claim 只支持一个引擎副本、固定 GPU 拓扑、要求专门的 kvcached runtime 镜像。 ## 5. 异步批处理:Batch API 如果你的任务不需要实时返回,Aibrix 提供了兼容 OpenAI Batch API 的异步批处理能力:上传 JSONL 文件,后台用 K8s Job 处理,之后拉取结果。 链路是:Files API(上传文件)→ Batch API(创建 batch job)→ Kubernetes Job Scheduler(起 worker)→ 存储后端(S3/TOS/MinIO/Redis/本地)。每个请求带 `custom_id` 用于精确对结果。状态流转 `validating → in_progress → finalizing → completed`,失败/取消/过期也有对应状态。纯自托管,用现有基础设施,不按请求计费。 ## 6. 小结 Aibrix 的组件不少,但如果只看主线,它就是两件事: 1. **数据面**:一个构建在 Envoy Gateway 上、路由算法可插拔的 LLM 网关,懂 KV Cache 前缀、懂 PD 分离、懂多模型(含语义路由)选择。 1. **控制面**:一堆 CRD 和 controller,帮你管 LoRA 适配器、管多角色部署(StormService)、管多节点推理(RayClusterFleet)、管 LLM 专用的扩缩容。 最值得研究的其实不是某一块具体功能,而是”KV Cache 是有状态的,网关和调度器要怎么感知它”这一整套工程思路:路由前缀匹配、事件同步、显存分层换出、跨引擎复用,环环相扣。 还有一点要注意:这篇博客里凡是涉及异构 GPU、ModelClaim、Pooled Mode 独立扩缩容的地方,官方文档都标注了实验状态或者有待实现,真上生产前得对着 release notes 确认版本支持范围,别被”看起来很好”冲昏头。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册