首页 文章 精选 留言 我的

精选列表

搜索[游戏解决方案],共10000篇文章
优秀的个人博客,低调大师

云上数据库容灾解决方案

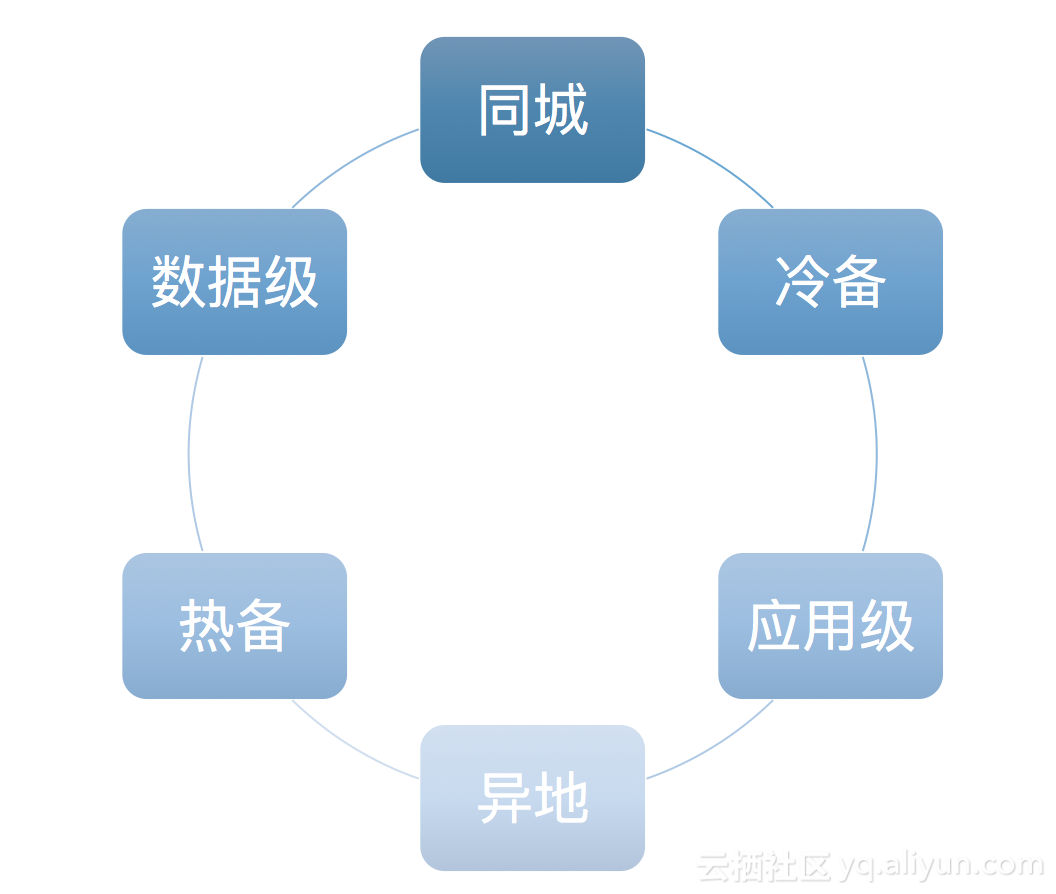
容灾的定义 容灾系统是指在相隔较远的异地,建立两套或多套功能相同的IT系统,互相之间可以进行健康状态监视和功能切换,当一处系统因意外(如火灾、地震等)停止工作时,整个应用系统可以切换到另一处,使得该系统功能可以继续正常工作。容灾技术是系统的高可用性技术的一个组成部分,容灾系统更加强调处理外界环境对系统的影响,特别是灾难性事件对整个IT节点的影响,提供节点级别的系统恢复功能。 目前常见的容灾方案基本上模式比较简单: 1、数据库冷备:每天备份一次数据库,保存在磁带或光盘上; 2、双机本地热备:共享磁盘阵列,阵列做RAID(冗余校验),即一份数据存在不同盘阵上并多存几份,保证坏一个盘不影响数据读写; 3、数据库热备:建立数据库灾备中心,与主库实时进行数据同步,同时应用系统保持文件实时同步,保证引用系统版本最新 容灾的类型 业务场景 数据问题导致需要进行

优秀的个人博客,低调大师

分离式皮肤资源解决方案探索

前言: 在App开发中,通常需要涉及到皮肤/主题的逻辑,以保证程序风格的多样化,保证符合大多数用户的不同口味。而一个优秀的皮肤管理框架不仅有利于开发者优雅的coding,同时需要做到能够动态切换皮肤,动态更换下载皮肤。 本篇内容从公司产品当前主题管理器的设计引入一种新型的皮肤管理方案。以期解决现有多主题编程时的各种难受,同时能够带来更好的皮肤动态性。 正题: 一. 皮肤/主题资源有哪些? 常用的主题资源有:背景色彩,文字色彩,图片背景,控件样式,字体样式,字体大小,控件尺寸,控件margin-padding.等。 二. 常见的皮肤切换方案有哪些? 1. 对于小型APP来说,设计一套功能完善的皮肤管理框架 稍显多余,因此通常都是以系统自带的 styleable主题切换方式为主。 此种方式,优

优秀的个人博客,低调大师

Eclipse无法显示Android设计界面解决方案

我们在使用MyEclipse或Eclipse开发Android程序时,有进点击main.xmlDesign可能显示的不是设计界面,而是view属性界面,如下图所示: 解决办法: 关闭打开的main.xml,左侧导航处右键该main.xml>>“openwith”>>“AndroidLayoutEditor”,打开过程比较慢,稍等会儿即可见到设计界面了。^_^! 如果以上方法还不行,需要我们将布局文件打开后,然后关闭Eclipse/MyEclipse,然后再重新打开,加载时就可以看见布局界面了。 本文转自 pangfc 51CTO博客,原文链接:http://blog.51cto.com/983836259/1394752,如需转载请自行联系原作者

优秀的个人博客,低调大师

ceph之openstack存储解决方案学习路线

ceph分布式存储搭建经历 http://strongit.blog.51cto.com/10020534/1739488 Ceph作为OpenStack后端存储 http://linuxnote.blog.51cto.com/9876511/1789924 eph常用命令 http://linuxnote.blog.51cto.com/9876511/1788361 Ceph使用块设备完整操作流程 http://linuxnote.blog.51cto.com/9876511/1788682 本文转自heavenseahill 51CTO博客,原文链接:http://blog.51cto.com/shower/1973642,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux双机热备解决方案之Heartbeat

拓扑图: 环境描述: 操作系统:CentOS6.3_x64 主:eth0 192.168.10.10 心跳:eth1 192.168.1.10 备:eth0 192.168.10.20 心跳:eth1 192.168.1.20 VTP:192.168.128.5 heartbeat(Linux-HA)的工作原理:heartbeat最核心的包括两个部分,心跳监测部分和资源接管部分,心跳监测可以通过网络链路和串口进行,而且支持冗余链路,它们之间相互发送报文来告诉对方自己当前的状态,如果在指定的时间内未受到对方发送的报文,那么就认为对方失效,这时需启动资源接管模块来接管运 行在对方主机上的资源或者服务。 Heartbeat:(心跳检测)本身是整个集群的基础(cluster messaging layer),负责维护集群各节点的信息以及它们之前通信;只提供主从备份功能,并不能对各个节点进行监控,需要安装ldirectord。 Resource-agent:(资源代理)就是各种的资源的ocf脚本,这些脚本将被LRM调用从而实现各种资源启动、停止、监控等等。 Cluster-glue:相当于一个中间层,可以将heartbeat和crm(pacemaker)联系起来,主要包含2个部分,LRM和STONITH; Ldirectord:负责realserver的健康检查,可以自动将realserver中宕机的机器移除,不再分配请求。 安装依赖包: 1 yum install -y gcc gcc-c++ autoconf libtool pkgconfig glib2-devel libxslt-devel libxml2-devel bzip2 -devel libtool-ltdl-devel libuuid-devel docbook-style-xsl 安装资源接管服务依赖包: 1 yum install -y *Socket6* *libwww-perl* *URI* *MailTools* *HTML-Parser* perl-IO-Socket-* 配置host解析 vi /etc/hosts 192.168.10.10 master 192.168.10.20 slave 软件下载:http://www.linux-ha.org/wiki/Downloads 一、配置主从heartbeat服务器(配置相同) 创建需要的组和用户 1 2 groupadd haclient useradd -g haclient -s /sbin/nologin -M hacluster 1.安装资源接管服务(要先安装资源接管服务,否则安装心跳服务会报错) 1 2 3 4 5 tar zxvf Reusable-Cluster-Components-glue--glue-1.0.9. tar .bz2 cd Reusable-Cluster-Components-glue--glue-1.0.9 . /autogen .sh . /configure make && make install 2.安装心跳服务 1 2 3 4 tar jxvf Heartbeat-3-0-7e3a82377fa8. tar .bz2 cd Heartbeat-3-0-7e3a82377fa8 . /ConfigureMe configure make && make install 报错:./configure: error: Core development headers were not found 解决:./ConfigureMe configure ,如果还解决不了,就是你没有安装Heartbeat服务 报错:gmake[1]: --xinclude: Command not found ,gmake[1]: *** [heartbeat.8] Error 127 解决:yum install libxslt-devel 3.安装中间件服务 1 2 3 4 5 tar jxvf ClusterLabs-resource-agents-v3.9.2-0-ge261943. tar .gz cd ClusterLabs-resource-agents-b735277 . /autogen .sh . /configure make && make install 报错:syntax error near unexpected token `DBUS, 解决:vi configure,注释这行PKG_CHECK_MODULES(DBUS, dbus-1, dbus-glib-1) 二、配置heartbeat 1 2 3 4 5 6 7 8 9 10 /etc/ha .d /ha .cf #定义心跳信息层,用于实现心跳信息传输。 /etc/ha .d /haresources #本地最重要的CRM,这个文件我们使用v1版本的配置文件,很简单。 /etc/ha .d /authkeys #实现两个节点之间传递,对心跳信息进行签名,或者加密,避免篡改;authkeys的权限非常重要,通常是400或者600的,如果设置不对无法启动heartbeat服务。 rm -rf /usr/etc/ha .d ln -s /etc/ha .d /usr/etc cp /usr/share/doc/heartbeat/haresources /etc/ha .d cp /usr/share/doc/heartbeat/authkeys /etc/ha .d cp /usr/share/doc/heartbeat/ha .cf /etc/ha .d chmod 600 /etc/ha .d /authkeys chkconfig heartbeat on 1.修改配置文件 1 2 3 4 5 vi authkeys auth 2 #1 crc 2 sha1 HI! #3 md5 Hello! 1 2 3 4 5 6 7 8 9 10 11 12 13 vi ha.cf logfile /var/log/ha-log logfacility local0 #如果未定义上述日志,默认写入/var/log/message keepalive 2 #心跳间隔 deadtime 30 #死亡阀值 warntime 10 #警告时间 initdead 120 #首次启动heartbeat,等待多久才启动主服务资源 udpport 694 #连接端口 ucast eth1 192.168.1.20 #采用网卡的eth1组织心跳,后跟接口IP auto_failback on #当主节点故障恢复后,自动获取资源并取代从节点 node master #主节点主机名 node slave #备份节点主机名 ping 192.168.1.1 #选择ping节点,ping的越好对HA集群越稳定,建议使用网关 1 2 3 4 vi haresources master IPaddr::192.168.128.5 ldirectord::ldirectord.cf httpd #格式:[主机名] [资源名与虚拟ip] [资源名与脚本] [高可用服务] #每个资源都是一个shell脚本,后面还可以写虚拟IP和资源,heartbeat会使用init脚本来管理系统服务,在范围内搜索脚本并启用 1 2 3 scp -r /etc/ha .d root@slave: /etc/ha .d #配置好的复制到备份服务器上 rm -rf /usr/etc/ha .d ln -s /etc/ha .d /usr/etc 2.配置ldirectord 1 2 3 4 5 6 7 8 9 10 11 12 13 14 cp ClusterLabs-resource-agents-b735277 /ldirectord/ldirectord .cf /etc/ha .d/ vi /etc/ha .d /ldirectord .cf checktimeout=3 checkinterval=1 autoreload= yes quiescent= yes virtual=192.168.128.5:80 real=192.168.1.10:80 gate real=192.168.1.20:80 gate fallback=127.0.0.1:80 gate service=http scheduler=rr protocol=tcp checkport=80 三、测试 1 2 3 4 5 6 service iptables stop #关闭防火墙 setenforce 0 #临时关闭selinux service heartbeat start ifconfig #会显示192.168.0.100绑定在主服务器eth0:0 echo “192.168.10.10″ > /var/www/html/index .html echo “192.168.10.20″ > /var/www/html/index .html hearbeat启动报错: /etc/init.d/heartbeat: line 53: /etc/ha.d/shellfuncs: No such file or directory 解决:这是因为没有装ClusterLabs-resource-agents导致的,装了这个中间件会把shellfuncs自动复制过去,我们可以手动复制过去即可。 cp ClusterLabs-resource-agents-b735277/heartbeat/shellfuncs /etc/ha.d/ http://192.168.128.5 #正常访问到192.168.10.10 模拟down掉192.168.10.10的httpd服务,再刷新页面显示192.168.10.20,说明配置成功! 生产环境中,网站程序数据必须是一致的,可以采用rsync进行同步或使用共享存储(NFS、ISCSI),后台MySQL数据库可以采用双主热备,实现高可用性。 本文转自 李振良OK 51CTO博客,原文链接:http://blog.51cto.com/lizhenliang/1290433,如需转载请自行联系原作者

优秀的个人博客,低调大师

oneproxy出现2103错误代码解决方案

中间件oneproxy 错误收集 通过中间件连接数据库,可以进入,但表显示不出 [root@s106 tmp]# mysql -u test -h 10.0.x.x-P3307 -ptest Use test3306(106)>show tables;ERROR 2103 (HY000): Lost connection to MySQL server during query or no managed connection avaiable! 排查:通过oneproxy管理端 mysql -uadmin -pOneProxy -h127.0.0.1 -P4041/4040 list backend; 显示mysql处于down关闭,状态,到数据库的机器,service mysqld restart重启数据库 再list backend mysql显示up,重新连接库表可以正常访问。 二.可能防火墙原因造成 没放通内网或者外网ip跟端口,注意如果是内网访问的话,那中间件连接后端的数据库也要写成内网ip 本文转自去轻狂书生51CTO博客,原文链接: http://blog.51cto.com/8999a/1975975 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

数据库大型应用解决方案总结

随着互联网应用的广泛普及,海量数据的存储和访问成为了系统设计的瓶颈问题。对于一个大型的互联网应用,每天百万级甚至上亿的PV无疑对数据库造成了相当高的负载。对于系统的稳定性和扩展性造成了极大的问题。 一、负载均衡技术负载均衡集群是由一组相互独立的计算机系统构成,通过常规网络或专用网络进行连接,由路由器衔接在一起,各节点相互协作、共同负载、均衡压力,对客户端来说,整个群集可以视为一台具有超高性能的独立服务器。 1、实现原理 实现数据库的负载均衡技术,首先要有一个可以控制连接数据库的控制端。在这里,它截断了数据库和程序的直接连接,由所有的程序来访问这个中间层,然后再由中间层来访问数据库。这样,我们就可以具体控制访问某个数据库了,然后还可以根据数据库的当前负载采取有效的均衡策略,来调整每次连接到哪个数据库。 2、实现多据库数据同步 对于负载均衡,最重要的就是所有服务器的数据都是实时同步的。这是一个集群所必需的,因为,如果数不据实时、不同步,那么用户从一台服务器读出的数据,就有别于从另一台服务器读出的数据,这是不能允许的。所以必须实现数据库的数据同步。这样,在查询的时候就可以有多个资源,实现均衡。比较常用的方法是Moebius for SQL Server集群,Moebius for SQL Server集群采用将核心程序驻留在每个机器的数据库中的办法,这个核心程序称为Moebius for SQL Server 中间件,主要作用是监测数据库内数据的变化并将变化的数据同步到其他数据库中。数据同步完成后客户端才会得到响应,同步过程是并发完成的,所以同步到多个数据库和同步到一个数据库的时间基本相等;另外同步的过程是在事务的环境下完成的,保证了多份数据在任何时刻数据的一致性。正因为Moebius 中间件宿主在数据库中的创新,让中间件不但能知道数据的变化,而且知道引起数据变化的SQL语句,根据SQL语句的类型智能的采取不同的数据同步的策略以保证数据同步成本的最小化。 数据条数很少,数据内容也不大,则直接同步数据 数据条数很少,但是里面包含大数据类型,比如文本,二进制数据等,则先对数据进行压缩然后再同步,从而减少网络带宽的占用和传输所用的时间。 数据条数很多,此时中间件会拿到造成数据变化的SQL语句, 然后对SQL语句进行解析,分析其执行计划和执行成本,并选择是同步数据还是同步SQL语句到其他的数据库中。此种情况应用在对表结构进行调整或者批量更改数据的时候非常有用。 3、优缺点 (1) 扩展性强:当系统要更高数据库处理速度时,只要简单地增加数据库服务器就 可以得到扩展。 (2) 可维护性:当某节点发生故障时,系统会自动检测故障并转移故障节点的应用,保证数据库的持续工作。 (3) 安全性:因为数据会同步的多台服务器上,可以实现数据集的冗余,通过多份数据来保证安全性。另外它成功地将数据库放到了内网之中,更好地保护了数据库的安全性。 (4) 易用性:对应用来说完全透明,集群暴露出来的就是一个IP (1) 不能够按照Web服务器的处理能力分配负载。 (2) 负载均衡器(控制端)故障,会导致整个数据库系统瘫痪。 二、数据库的读写分离1,实现原理:读写分离简单的说是把对数据库读和写的操作分开对应不同的数据库服务器,这样能有效地减轻数据库压力,也能减轻io压力。主数据库提供写操作,从数据库提供读操作,其实在很多系统中,主要是读的操作。当主数据库进行写操作时,数据要同步到从的数据库,这样才能有效保证数据库完整性。 (ebay的读写比率是260:1,ebay的读写分离) (微软数据库分发) 2,实现方法:在MS Sql server中可以使用发布定义的方式实现数据库复制,实现读写分离,复制是将一组数据从一个数据源拷贝到多个数据源的技术,是将一份数据发布到多个存储站点上的有效方式。使用复制技术,用户可以将一份数据发布到多台服务器上。复制技术可以确保分布在不同地点的数据自动同步更新,从而保证数据的一致性。 SQL SERVER复制技术类型有三种,分别是:快照复制、事务复制、合并复制。SQL SERVER 主要采用出版物、订阅的方式来处理复制。源数据所在的服务器是出版服务器,负责发表数据。出版服务器把要发表的数据的所有改变情况的拷贝复制到分发服务器,分发服务器包含有一个分发数据库,可接收数据的所有改变,并保存这些改变,再把这些改变分发给订阅服务器。 3,优缺点 (1)数据的实时性差:数据不是实时同步到自读服务器上的,当数据写入主服务器后,要在下次同步后才能查询到。 (2)数据量大时同步效率差:单表数据量过大时插入和更新因索引,磁盘IO等问题,性能会变的很差。 (3)同时连接多个(至少两个)数据库:至少要连接到两个数据数据库,实际的读写操作是在程序代码中完成的,容易引起混乱 (4)读具有高性能高可靠性和可伸缩:只读服务器,因为没有写操作,会大大减轻磁盘IO等性能问题,大大提高效率;只读服务器可以采用负载均衡,主数据库发布到多个只读服务器上实现读操作的可伸缩性。 三、数据库拆分(分布式) 通过某种特定的条件,将存放在同一个数据库中的数据分散存放到多个数据库上,实现分布存储,通过路由规则路由访问特定的数据库,这样一来每次访问面对的就不是单台服务器了,而是N台服务器,这样就可以降低单台机器的负载压力。 垂直(纵向)拆分:是指按功能模块拆分,比如分为订单库、商品库、用户库...这种方式多个数据库之间的表结构不同。 水平(横向)拆分:将同一个表的数据进行分块保存到不同的数据库中,这些数据库中的表结构完全相同。 (纵向拆分) (横向拆分) 1,实现原理:使用垂直拆分,主要要看应用类型是否合适这种拆分方式,如系统可以分为,订单系统,商品管理系统,用户管理系统业务系统比较明的,垂直拆分能很好的起到分散数据库压力的作用。业务模块不明晰,耦合(表关联)度比较高的系统不适合使用这种拆分方式。但是垂直拆分方式并不能彻底解决所有压力问题,例如 有一个5000w的订单表,操作起来订单库的压力仍然很大,如我们需要在这个表中增加(insert)一条新的数据,insert完毕后,数据库会针对这张表重新建立索引,5000w行数据建立索引的系统开销还是不容忽视的,反过来,假如我们将这个表分成100个table呢,从table_001一直到 table_100,5000w行数据平均下来,每个子表里边就只有50万行数据,这时候我们向一张只有50w行数据的table中insert数据后建立索引的时间就会呈数量级的下降,极大了提高了DB的运行时效率,提高了DB的并发量,这种拆分就是横向拆分 2,实现方法:垂直拆分,拆分方式实现起来比较简单,根据表名访问不同的数据库就可以了。横向拆分的规则很多,这里总结前人的几点, (1)顺序拆分:如可以按订单的日前按年份才分,2003年的放在db1中,2004年的db2,以此类推。当然也可以按主键标准拆分。 优点:可部分迁移 缺点:数据分布不均,可能2003年的订单有100W,2008年的有500W。 (2)hash取模分: 对user_id进行hash(或者如果user_id是数值型的话直接使用user_id的值也可),然后用一个特定的数字,比如应用中需要将一个数据库切分成4个数据库的话,我们就用4这个数字对user_id的hash值进行取模运算,也就是user_id%4,这样的话每次运算就有四种可能:结果为1的时候对应DB1;结果为2的时候对应DB2;结果为3的时候对应DB3;结果为0的时候对应DB4,这样一来就非常均匀的将数据分配到4个DB中。 优点:数据分布均匀 缺点:数据迁移的时候麻烦;不能按照机器性能分摊数据 。 (3)在认证库中保存数据库配置 就是建立一个DB,这个DB单独保存user_id到DB的映射关系,每次访问数据库的时候都要先查询一次这个数据库,以得到具体的DB信息,然后才能进行我们需要的查询操作。 优点:灵活性强,一对一关系 缺点:每次查询之前都要多一次查询,会造成一定的性能损失。 本文转自glying 51CTO博客,原文链接:http://blog.51cto.com/liying/968632,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册