首页 文章 精选 留言 我的

精选列表

搜索[游戏解决方案],共10000篇文章
优秀的个人博客,低调大师

快速上手物联网解决方案(5)—— DataV

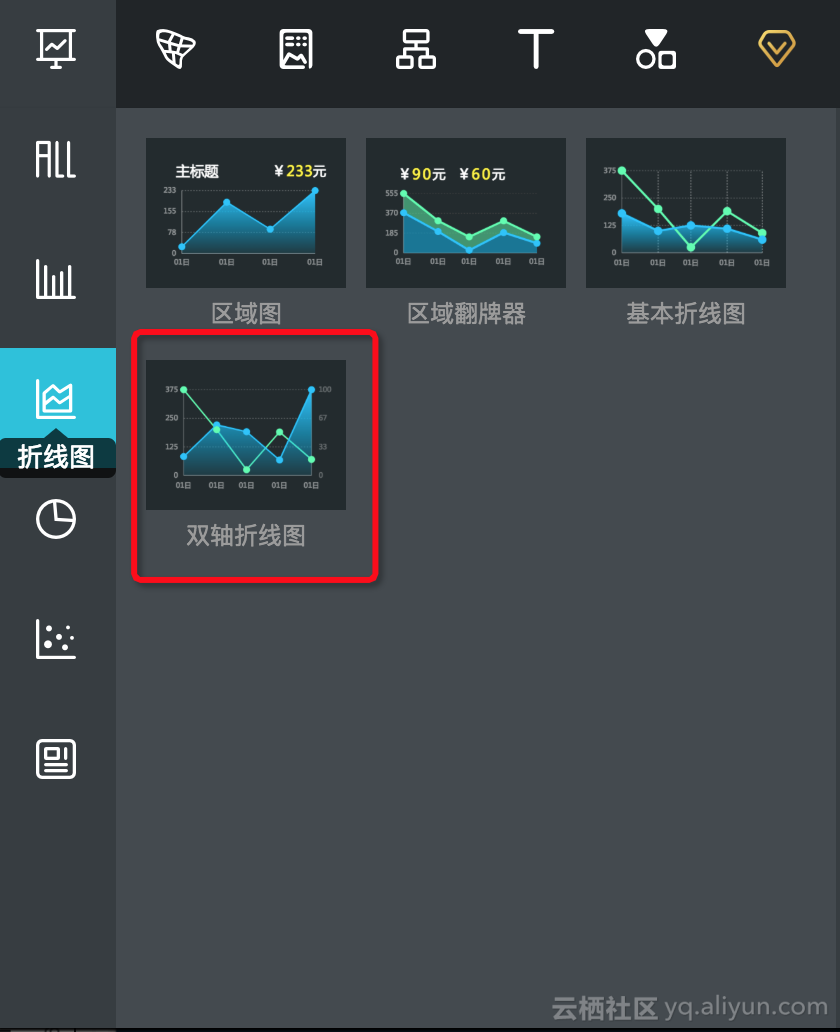
DataV 是阿里云推出的一款数据可视化工具,可以帮助非专业的工程师通过图形化的界面轻松搭建具有专业水准的可视化应用,让更多的人看到数据可视化的魅力。 本实例我们就利用 DataV 读取前文『表格存储』中的物联网设备数据,制作一份折线图。 首先,开通 DataV 服务,请注意本服务需付费使用,也是本系列教程唯一预付费才可使用的产品。(目前仅企业版支持『表格存储』数据源) 开通服务后,我们可以看到非常多的模板,本实例的场景比较简单,因此选择新增可视化 —— 空白模板,从上方组件中拖入『双轴折线图』组件: 点击刚添加的『双轴折线图』 —— 数据,我们先接入数据源,选择 TableStore,新增配置。 配置项这里做个说明:AK 就是 Accesskey,鼠标移动到阿里云任意产品的控制台界面移至右上角即会出现,点击进入即可获取,千万注意保密! 外网

优秀的个人博客,低调大师

企业混合云Active Directory架构解决方案

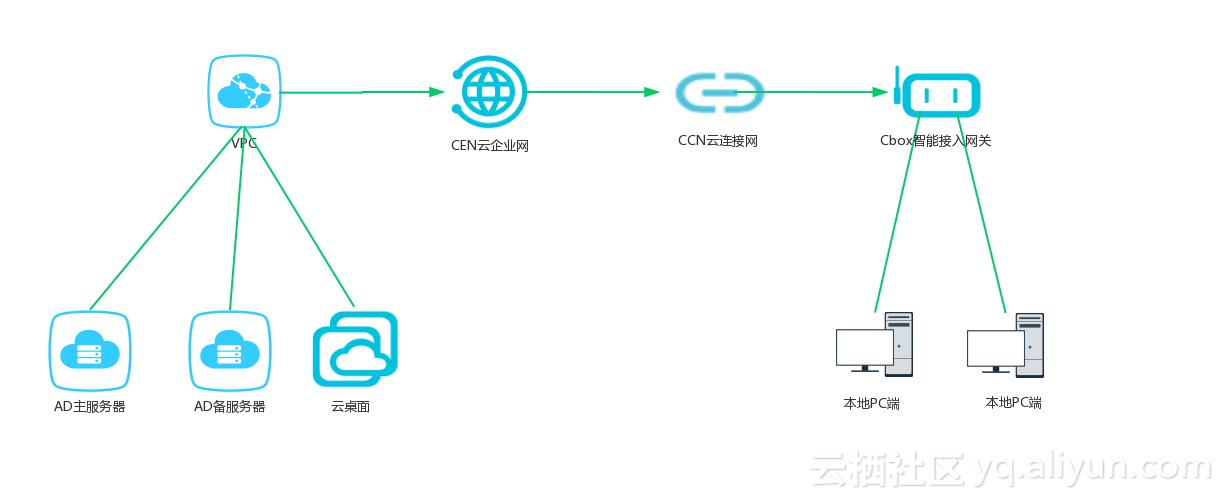
一.背景信息: A公司,想在阿里云服务器上搭建一套Active Directory用于提供统一高效管理的服务(批量管理用户,部署应用,统一管理),并想实现云桌面和PC端的相互通信,并想将线下的PC端全部加入到云上AD域中,实现统一应用的管理。 二.架构设计图: 三.准备材料: ECS服务器(用于部署主备AD),云桌面,云企业网,云连接网,智能接入网关,PC端。 四.最佳实践: 4.1创建专有网络 4.2在不同可用区下创建对应的ECS实例(为了容灾起见,将两台服务器分配至不同的可用区) 4.3部署主AD——具体操作步骤 在开始搜索栏中搜索“dcpromo” 并运行“dcpromo”命令 4.4部署主AD证书服务--操作步骤 4.5备域AD服务安装——具体操作步骤 4.5.1 在使用系统准备工具时,会出现以下两种情况,如出现第一种情况“尝试使用Sysprep处理计算时出现错误” 直接重启即可! 第二种情况: 4.5.2 运行"ncpa.cpl"命令,打开网络连接中心,右击”本地连接”打开属性,按照图中的步骤将DNS配置为主AD域的内网IP地址 4.5.3 运行“dcpromo”命令打开AD域服务安装向导,按照下列操作步骤进行逐一配置。 4.6配置备AD证书服务 4.7购买部署云桌面 4.7.1 登陆云桌面的控制台,选择购买的对应类型,可参考如下步骤。 4.7.2 查看目前的主备AD的IP地址,用于云桌面的环境设置 4.7.3 根据主备AD的IP地址完成以下云桌面环境的设置 4.7.4 购买创建云桌面 4.7.5 在控制台中远程输入对应的账号及密码登陆到创建的云桌面中。 4.7.6 登陆以后,查看当前是否成功加入到创建的AD中。 4.7.7 测试云桌面是否和ECS能相互通信。 4.8云桌面的一些具体功能操作步骤(附图) 4.8.1 云桌面内网OSS访问策略测试 4.8.2云桌面快照测试 4.8.3 云桌面本地管理员密码修改 4.9 配置Cbox+CCN+CEN 购买完智能接入网关以后会自动创建一个sag实例,然后需要自行创建ccn云连接网实例,把sag挂载到ccn下。 4.9.1创建配置绑定云连接网( 点我进入传送门~) 4.9.2 如需要和云上vpcecs互通,则还需要创建云企业网cen实例( 点我进入传送门~) 4.9.3 配置线下的智能接入网关Cbox,并进行测试(已测试云上和云下内网可以互通) 4.10 在云桌面控制台中修改云桌面网络策略,如下图增加一条规则为:入方向 0.0.0.0/0 允许 的规则,并立即生效! 4.11 最后,使用本地PC端进行通信测试 4.11.1使用本地PC尝试ping云桌面的主机,看是否可以进行通信。 4.11.2 可以使用windows 自带的远程连接工具去连接云桌面 4.11.3 可以将本地的Pc直接添加到对应的AD中

优秀的个人博客,低调大师

java.lang.NullPointerException错误的解决方案

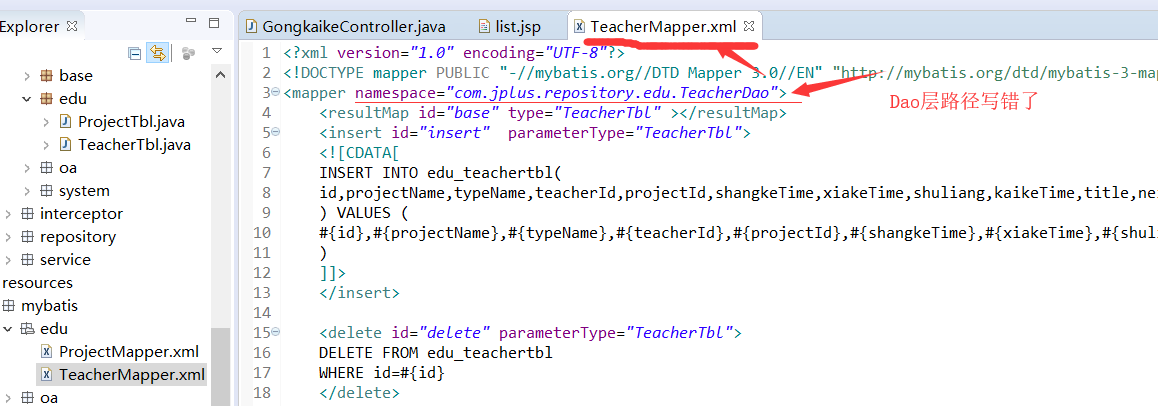
java.lang.NullPointerException空指针异常是像我一样新手很容易出现的问题,这个问题一般情况都是不细心的时候出现的,开始正文如下: 1、业务层面的错误: a、没有写非空验证:if(list.size()>0 && !"".equal(list)); b、service方法引用注解的,有可能没有写注解(这个问题以前没有用代码模板工具经常出现); 2、sql方法层面的错误: a、mapper文件的dao路径引用路径写错,如下图(仅供参考) b、sql语句写错,(这个问题你在写sql语句的时候应该跑一下看看有没有错误,我觉得对于像我一样的萌新很有必要); ==================分割线============================== 这是我第一次写博客,谢谢大家参考和评论,本人萌新一枚,写博客仅是给自己记录问题和提供给大家分享、参考,再次谢谢大家!!!!!(勿喷)

优秀的个人博客,低调大师

前端模块化开发解决方案详解

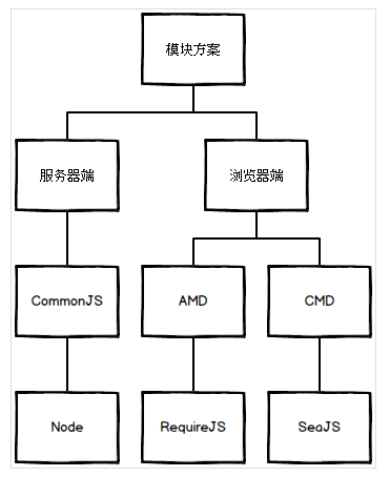
一、模块化开发方案 前端发展到今天,已经有不少模块化的方案,比如 CommonJS(常用在服务器端,同步的,如nodejs) AMD(常用在浏览器端,异步的,如requirejs)(Asynchronous Module Definition) CMD(常用在浏览器端,异步的,如seajs) UMD(AMD&& CommonJS) 这些模块化规范的核心价值都是让JavaScript的模块化开发变得简单和自然。 服务器端模块 在服务器端,所有的模块都存放在本地硬盘,可以同步加载完成,等待时间就是硬盘的读取时间。 浏览器端模块: 在浏览器端,所有的模块都放在服务器端,同步加载,等待时间取决于网速的快慢,可能要等很长时间,浏览器处于"假死"状态。因此,浏览器端的模块,不能采用"同步加载"(synchronous),只能采用"异步加载"(asynchronous)。 二、CommonJs CommonJs 是服务器端模块的规范,Node.js采用了这个规范。 CommonJS 加载模块是同步的,所以只有加载完成才能执行后面的操作。 像Node.js主要用于服务器的编程,加载的模块文件一般都已经存在本地硬盘,所以加载起来比较快,不用考虑异步加载的方式,所以CommonJS规范比较适用。 CommonJS模块的特点如下: 所有代码都运行在模块作用域,不会污染全局作用域。 模块可以多次加载,但是只会在第一次加载时运行一次,然后运行结果就被缓存了,以后再加载,就直接读取缓存结果。 模块加载的顺序,按照其在代码中出现的顺序。 CommonJS语法 1、定义模块

优秀的个人博客,低调大师

Java并发编程与高并发解决方案

基本概念 并发:同时拥有两个或者多个线程,如果程序在单核处理器上运行,多个线程将交替地换入或者换出内存,这些线程是同时“存在”的,每个线程都处于执行过程中的某个状态,高速切换感觉同时执行。如果运行多核处理器上,此时,程序中的每个线程将分配到一个处理器核上,因此可以真正的同时运行。 高并发:高并发(High Cuncurrency)是互联网分布式系统架构设计中必须考虑的因素之一,它通常是指,通过设计保证系统能够 同时并发处理 很多请求。 其实当我们讨论并发时主要关注的是以下几点: 多线程操作相同的资源 保证线程安全 合理分配和使用资源 而在讨论高并发是关注的是以下几点: 服务器能同时处理很多个请求 提高程序性能 比如在12306抢票,淘宝双11等都需要考虑高并发 cup多级缓存 在单核时代处理器做出的乱序优化不会导致执行结果远离预期目标,但在多核环境下却并非如此。在多核时代,由多核cpu同时执行指令,同时还引入的l1、l2等缓存机制,每个核都有自己的缓存,就导致了逻辑顺序上后写入的数据未必真的最后写入。如果我们不做任何防护措施,就会出现处理器得出的结果和我们逻辑得出的结果大不相同。 比如:我们在一个cpu核心上执行写入操作,并在最后写入一个标记来表示该操作已经写入好了。然后从另外一个核上通过判断这个标记来确定所需要的数据是否已经就绪,这种做法就存在一定风险:标记位先被写入但数据操作并未完成。导致另外一个核使用了错误数据。 Java内存模型(Java Memory Model,JMM) 内存模型可以理解为在特定的操作协议下,对特定的内存或者高速缓存进行读写访问的过程抽象,不同架构下的物理机拥有不一样的内存模型,Java虚拟机也有自己的内存模型,即Java内存模型(Java Memory Model, JMM)。在C/C++语言中直接使用物理硬件和操作系统内存模型,导致不同平台下并发访问出错。而JMM的出现,能够屏蔽掉各种硬件和操作系统的内存访问差异,实现平台一致性,是的Java程序能够“一次编写,到处运行”。 Java线程之间的通信由Java内存模型(本文简称为JMM)控制,JMM决定一个线程对共享变量的写入何时对另一个线程可见。 堆内存(Heap): 存放实例域, 静态域, 数组元素. 在线程间共享. 栈内存(Stack): 存放局部变量, 方法定义参数和异常处理器参数. 线程A和线程B要进行通信,必须先将数据刷新到主内存,线程B再从主内存读取线程A更新过的变量。 比如多个线程同时修改一个变量:线程A 先从主内存中获取共享变量(a=2),然后在自己本地内存中计算(a+2),然后写入到主内存。 但此时B也从主内存获取(a=2),在本地内存改变(a+2).写入到主内存。 在计算过程中两个线程间的数据是不可见的,此时就会出现结果不正确情况。 主内存和工作内存 Java内存模型的主要目标是定义程序中各个变量的访问规则,即在虚拟机中将变量存储到内存和从内存中取出变量这样底层细节。此处的变量与Java编程时所说的变量不一样,指包括了实例字段、静态字段和构成数组对象的元素,但是不包括局部变量与方法参数,后者是线程私有的,不会被共享。 Java内存模型中规定了所有的变量都存储在主内存中,每条线程还有自己的工作内存(可以与前面讲的处理器的高速缓存类比),线程的工作内存中保存了该线程使用到的变量到主内存副本拷贝,线程对变量的所有操作(读取、赋值)都必须在工作内存中进行,而不能直接读写主内存中的变量。不同线程之间无法直接访问对方工作内存中的变量,线程间变量值的传递均需要在主内存来完成,线程、主内存和工作内存的交互关系如下图所示,和上图很类似。 注意:这里的主内存、工作内存与Java内存区域的Java堆、栈、方法区不是同一层次内存划分,这两者基本上没有关系。 内存交互操作 由上面的交互关系可知,关于主内存与工作内存之间的具体交互协议,即一个变量如何从主内存拷贝到工作内存、如何从工作内存同步到主内存之间的实现细节,Java内存模型定义了以下八种操作来完成: lock(锁定):作用于主内存的变量,把一个变量标识为一条线程独占状态。 unlock(解锁):作用于主内存变量,把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定。 read(读取):作用于主内存变量,把一个变量值从主内存传输到线程的工作内存中,以便随后的load动作使用 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存的变量,把工作内存中的一个变量值传递给执行引擎,每当虚拟机遇到一个需要使用变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存的变量,它把一个从执行引擎接收到的值赋值给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,把工作内存中的一个变量的值传送到主内存中,以便随后的write的操作。 write(写入):作用于主内存的变量,它把store操作从工作内存中一个变量的值传送到主内存的变量中。 如果要把一个变量从主内存中复制到工作内存,就需要按顺寻地执行read和load操作,如果把变量从工作内存中同步回主内存中,就要按顺序地执行store和write操作。Java内存模型只要求上述两个操作必须按顺序执行,而没有保证必须是连续执行。也就是read和load之间,store和write之间是可以插入其他指令的,如对主内存中的变量a、b进行访问时,可能的顺序是read a,read b,load b, load a。 Java内存模型还规定了在执行上述八种基本操作时,必须满足如下规则: 不允许read和load、store和write操作之一单独出现 不允许一个线程丢弃它的最近assign的操作,即变量在工作内存中改变了之后必须同步到主内存中。 不允许一个线程无原因地(没有发生过任何assign操作)把数据从工作内存同步回主内存中。 一个新的变量只能在主内存中诞生,不允许在工作内存中直接使用一个未被初始化(load或assign)的变量。即就是对一个变量实施use和store操作之前,必须先执行过了assign和load操作。 一个变量在同一时刻只允许一条线程对其进行lock操作,lock和unlock必须成对出现 如果对一个变量执行lock操作,将会清空工作内存中此变量的值,在执行引擎使用这个变量前需要重新执行load或assign操作初始化变量的值 如果一个变量事先没有被lock操作锁定,则不允许对它执行unlock操作;也不允许去unlock一个被其他线程锁定的变量。 对一个变量执行unlock操作之前,必须先把此变量同步到主内存中(执行store和write操作)。 这8种内存访问操作很繁琐,后文会使用一个等效判断原则,即先行发生(happens-before)原则来确定一个内存访问在并发环境下是否安全。 并发的优势和风险 活跃性问题 死锁:哲学家吃饭 饥饿:餐厅排队吃饭,一个窗口很多人排对象,好多人不自觉插队,导致抢不到饭的人饿死 对应到代码中:线程优先级 活锁:两个人对面过河,有两座桥,相互礼让,走另外一个桥,但重复相遇导致谁也过不去 饥饿与公平:高优先级的线程吞噬所有cpu时间片,导致其他线程被永远堵塞在一个等待队列同步块的状态 等待的线程永远不会被唤醒也会引发饥饿问题 如何避免饥饿问题出现? 性能问题 多线程并不一定绝对提供程序效率,要看具体的场景。 例子一: 单核单处理器,开一个线程跑循环输出10万条打印信息,开100个线程输出10万条打印信息.后者比前者慢,因为输出端是临界资源,线程抢占的时间大,单线程则无需抢占 例子二: 网络服务器处理,每个请求开一个线程,请求的处理时间极短,迅速返回,一次提交10万个请求,则有10万次线程创建和销毁对应于一个工作线程处理这10万条请求后者比前者肯定快 注意:多线程并不会提供cpu的执行速度,只是提高了cpu的利用率


优秀的个人博客,低调大师

实现Java热部署的几种解决方案

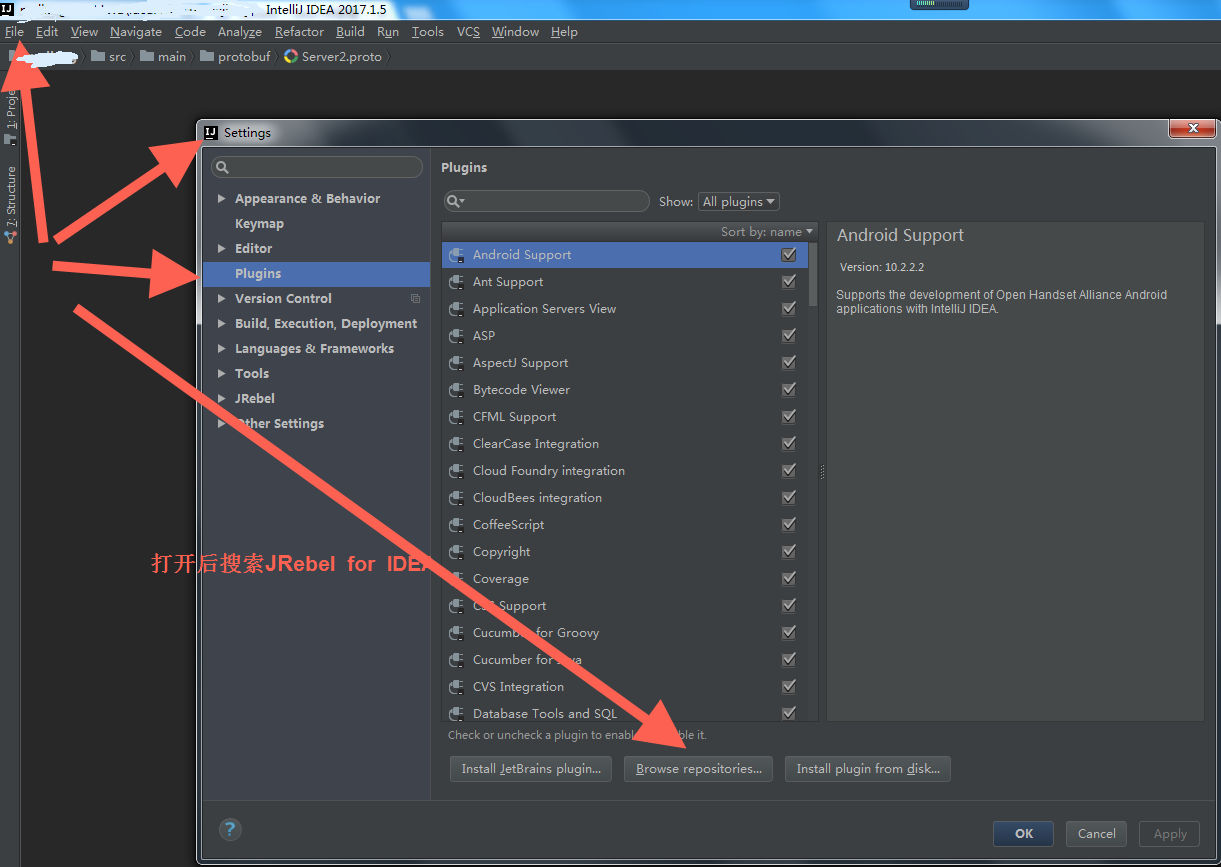
百度百科:热部署,就是应用正在运行的时候就可以升级软件,而不需要重新启动应用。 spring-loaded 依赖 <dependency> <groupId>org.springframework</groupId> <artifactId>springloaded</artifactId> <version>1.2.5.RELEASE</version> </dependency> ps:据说此方法还需要手动编译(Ctrl + Shift + F9),请亲测! spring-boot-devtools 依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-devtools</artifactId> <optional>true</optional><!-- 表示依赖不会传递,之后依赖该module的项目如需继续使用,则需要再次引入 --> </dependency> JRebel 安装插件 安装插件 安装插件 激活JRebel 激活JRebel 启动运行 启动运行 若不起效 不起效 不起效 全局配置 全局配置 全局配置 对比 方式 效果 spring-loaded 需手动编译 spring-boot-devtools 会重新加载整个应用 JRebel 只加载修改类(当有错误时不会)。无需手动编译,不会重新加载整个应用 参考文章 SpringBoot初始教程之热部署(五)JRebel无限制版IntelliJ IDEA 热部署插件 JRebel 安装激活及使用intellij idea 热部署 jrebel 详细配置

优秀的个人博客,低调大师

讯飞语音JavaWeb语音合成解决方案

在线语音合成 将文字信息转化为声音信息,给应用配上“嘴巴”。我们提供了众多极具特色的发音人(音库)供您选择。其合成音在音色、自然度等方面的表现均接近甚至超过了人声。这种语音合成体验,达到了真正可商用的标准 讯飞的语音合成还是很牛P的,不但有基础发音人,还有精品发音人、特色发音人、明星发音人,当然你如果有特殊要求还可以定制。 这里我们选择基础发音人做简单的JavaWeb集成测试,因为其他选项还要申请,想想还是算了,等流程走通再说。 平台环境 JDK1.7、Tomcat8、Eclipse、讯飞JDK、win+ffmpeg(测试)、Linux+Docker+ffmpeg(生产) 说明:讲真,Win平台下ffmpeg安装使用还是很轻松的,直接下载压缩包免安装,JAVA直接调用执行命令即可。Linux下各种依赖编译能把你的小机器跑死,并且还各种编译错误,然后就果断使用了Docker,唯一头疼的是,这个环境真干净,各种命令不支持,当然这也是Docker的优点。 流程图 Web集成 讯飞为我们提供了简单的SDK,科大讯飞MSC开发指南-Java。当然,前提你要有一个讯飞的账号,注册、创建应用什么的这里就不赘述了,只要最后能获取到一个APP_ID就可以。 Win+ffmpeg(测试) 讯飞语音合成需要动态链接库支持,根据自己的系统把msc64.dll或者msc32.dll放到指定的目录,可以使用System.getProperty("java.library.path")查看,放置到任意目录即可。 根据自己的系统下载对应的ffmpeg,解压即可,直接调用bin目录下的ffmpeg.exe即可。- Linux+Docker+ffmpeg(生产) 获取ffmpeg镜像 docker pull jrottenberg/ffmpeg 创建并运行容器 docker run -it --name app_ffmpeg -p 8080:8080 -v /home/app_ffmpeg/:/mnt/app/ --entrypoint='bash' jrottenberg/ffmpeg 注意:Docker容器中,各种yum、wget以及vim是不存在的,所以大都数配置通过宿机获取然后同步复制到容器中。 安装配置JDK 甲骨文给弄的必须认证下载了,这里我们自行下载并手动上传到/home/app_ffmpeg目录下。 # 复制配置文件到宿机 docker cp 4f131c866092:/etc/profile /home/app_ffmpeg/ 编辑profile,追加以下配置 #set java environment JAVA_HOME=/mnt/app/jdk1.7.0_80 JRE_HOME=/mnt/app/jdk1.7.0_80/jre CLASS_PATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib PATH=$PATH:$JAVA_HOME/bin:$JRE_HOME/bin export JAVA_HOME JRE_HOME CLASS_PATH PATH # 复制配置文件到容器 docker cp /home/app_ffmpeg/profile 4f131c866092:/etc/ 进入容器,生效配置 # 进入容器 docker exec -it app_ffmpeg bash # 使配置生效 source /etc/profile # 检查JDK是否安装成功 java -version 安装配置Tomcat 如果tomcat启动卡主不动 找到jdk1.x.x_xx/jre/lib/security/java.security文件,在文件中找到securerandom.source这个设置项,将其改为: securerandom.source=file:/dev/./urandom 如果tomcat输出中文乱码 locale locale -a LANG=C.UTF-8 (有的是zh_CN.UTF-8,不过我在本地没发现这种编码) source /etc/profile 配置讯飞动态库 根据自己的系统版本,分别把libmsc32.so 或者 libmsc64.so 上传到/lib/ 和 /lib64/ 目录。 开源项目 https://gitee.com/52itstyle/xufei_msc 演示地址 http://xunfei.52itstyle.com/xufei_msc/

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册