首页 文章 精选 留言 我的

精选列表

搜索[搜索增强],共10000篇文章
优秀的个人博客,低调大师

mapreduce实现搜索引擎简单的倒排索引

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq1010885678/article/details/44458825 使用hadoop版本为2.2.0 倒排索引简单的可以理解为全文检索某个词 例如:在a.txt 和b.txt两篇文章分别中查找统计hello这个单词出现的次数,出现次数越多,和关键词的吻合度就越高 现有a.txt内容如下: hello tom hello jerry hello kitty hello world hello tom b.txt内容如下: hello jerry hello tom hello world 在hadoop平台上编写mr代码分析统计各个单词在两个文本中出现的次数 其实也只是WordCount程序的改版而已~ 将两个文本上传到hdfs根目录的ii文件夹下(mr直接读取ii文件夹,会读取所有没有以_(下划线)开头的文件) 编写mr代码 首先分析,map输入的格式为 该行偏移量 该行文本 如: 0 hello 我们知道,map的输出之后会根据相同的key来进行合并 而每个单词都不是唯一的,它可能在两个文本中都出现,使用单词作为key的话无法分辨出该单词属于哪个文本 而使用文本名字作为key的话,那么将达到我们原来的目的,因为map的输出就会变成a.txt->单词..单词..单词 这显然不是我们想要的结果 所以map输出的格式应该为 单个单词->所在文本 1 如: hello->a.txt 1 这里用->作为单词和所在文本的分隔 这样就可以在根据key进行合并的时候不会影响到我们的结果 map代码如下: public static class MyMapper extends Mapper<LongWritable, Text, Text, Text> { private Text k = new Text(); private Text v = new Text(); protected void map( LongWritable key, Text value, org.apache.hadoop.mapreduce.Mapper<LongWritable, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { String[] data = value.toString().split(" "); //FileSplit类从context上下文中得到,可以获得当前读取的文件的路径 FileSplit fileSplit = (FileSplit) context.getInputSplit(); //文件路径为hdfs://hadoop:9000/ii/a.txt //根据/分割取最后一块即可得到当前的文件名 String[] fileNames = fileSplit.getPath().toString().split("/"); String fileName = fileNames[fileNames.length - 1]; for (String d : data) { k.set(d + "->" + fileName); v.set("1"); context.write(k, v); } }; } 在map执行完毕之后 我们需要一个combiner来帮助完成一些工作 注意,combiner的输入格式和输出格式是一致的,也就是map的输出格式,否则会出错 再次分析,根据key合并value之后的键值对是这个样子的: (hello->a.txt,{1,1,1,1,1}) combiner要做的工作就是讲values统计累加 并将key的单词和文本分隔开,将文本名和统计之后的values组合在一起形成新的value 如: (hello,a.txt->5) 为什么要这么做? 因为在combiner执行完毕之后 还会根据key进行一次value的合并,跟map之后的是一样的 将key相同的value组成一个values集合 如此一来,在经过combiner执行之后,到达reduce的输入就变成了 (hello,{a.txt->5,b.txt->3}) 这样的格式,然后在reduce中循环将values输出不就是我们想要的结果了吗~ combiner代码如下: public static class MyCombiner extends Reducer<Text, Text, Text, Text> { private Text k = new Text(); private Text v = new Text(); protected void reduce( Text key, java.lang.Iterable<Text> values, org.apache.hadoop.mapreduce.Reducer<Text, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { //分割文件名和单词 String[] wordAndPath = key.toString().split("->"); //统计出现次数 int counts = 0; for (Text t : values) { counts += Integer.parseInt(t.toString()); } //组成新的key-value输出 k.set(wordAndPath[0]); v.set(wordAndPath[1] + "->" + counts); context.write(k, v); }; } 接下来reduce的工作就简单了 代码如下: public static class MyReducer extends Reducer<Text, Text, Text, Text> { private Text v = new Text(); protected void reduce( Text key, java.lang.Iterable<Text> values, org.apache.hadoop.mapreduce.Reducer<Text, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { String res = ""; for (Text text : values) { res += text.toString() + "\r"; } v.set(res); context.write(key, v); }; } main方法代码: public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); FileSystem fs = FileSystem.get(conf); Path inPath = new Path("hdfs://hadoop:9000" + args[0]); Path outPath = new Path("hdfs://hadoop:9000" + args[1]); if (fs.exists(outPath)) { fs.delete(outPath, true); } Job job = Job.getInstance(conf); job.setJarByClass(InverseIndex.class); FileInputFormat.setInputPaths(job, inPath); job.setInputFormatClass(TextInputFormat.class); job.setMapperClass(MyMapper.class); job.setMapOutputKeyClass(Text.class); job.setMapOutputValueClass(Text.class); job.setCombinerClass(MyCombiner.class); job.setReducerClass(MyReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(Text.class); FileOutputFormat.setOutputPath(job, outPath); job.setOutputFormatClass(TextOutputFormat.class); job.waitForCompletion(true); } 在hadoop上运行jar包执行结果如图: 初学hadoop,仅作笔记之用,其中如有错误望请告知^-^


优秀的个人博客,低调大师

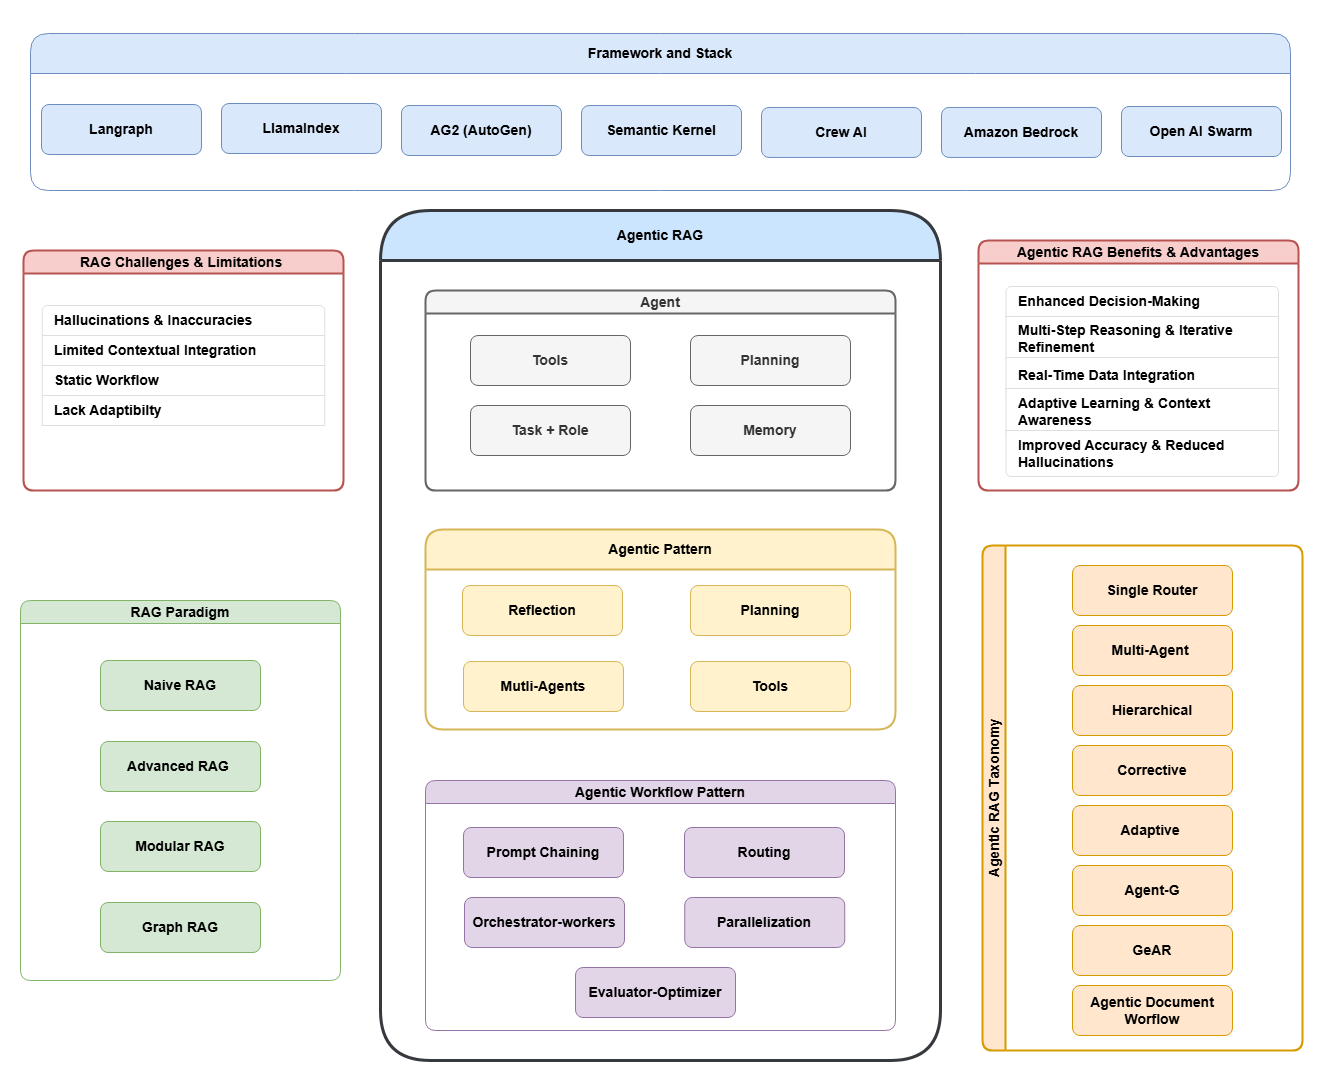
构建基于 MCP 与 GraphRAG 的 LLM智能体:从协议到知识增强

大语言模型(LLM)正从单纯的文本生成器演变为能够自主决策、调用工具的智能体(Agent)。然而,实际应用中仍面临两大瓶颈:一是工具调用接口的碎片化,每个外部服务(数据库、API、本地文件)都需要定制化接入;二是知识检索的浅层化,传统向量检索(RAG)无法有效捕捉实体间的复杂关系,导致多跳推理时信息缺失或错误。

优秀的个人博客,低调大师

. | 双图表示增强Transformer模型的分子性质预测

准确预测分子性质是化学、材料科学和药物研发中的核心问题,其性能高度依赖于分子表示方式。近年来,Transformer模型凭借全局自注意力机制逐渐应用于分子学习,但如何充分编码原子、化学键、拓扑结构及立体几何信息,仍然是限制模型性能的重要因素。研究人员提出了一种名为Dual Graph Transformer(DGT)的新型深度学习框架,通过同时构建原子图和键图两种互补表示,在自注意力机制中联合建模原子特征、键特征、图拓扑、环结构以及三维立体信息,实现更加完整的分子表示。

优秀的个人博客,低调大师

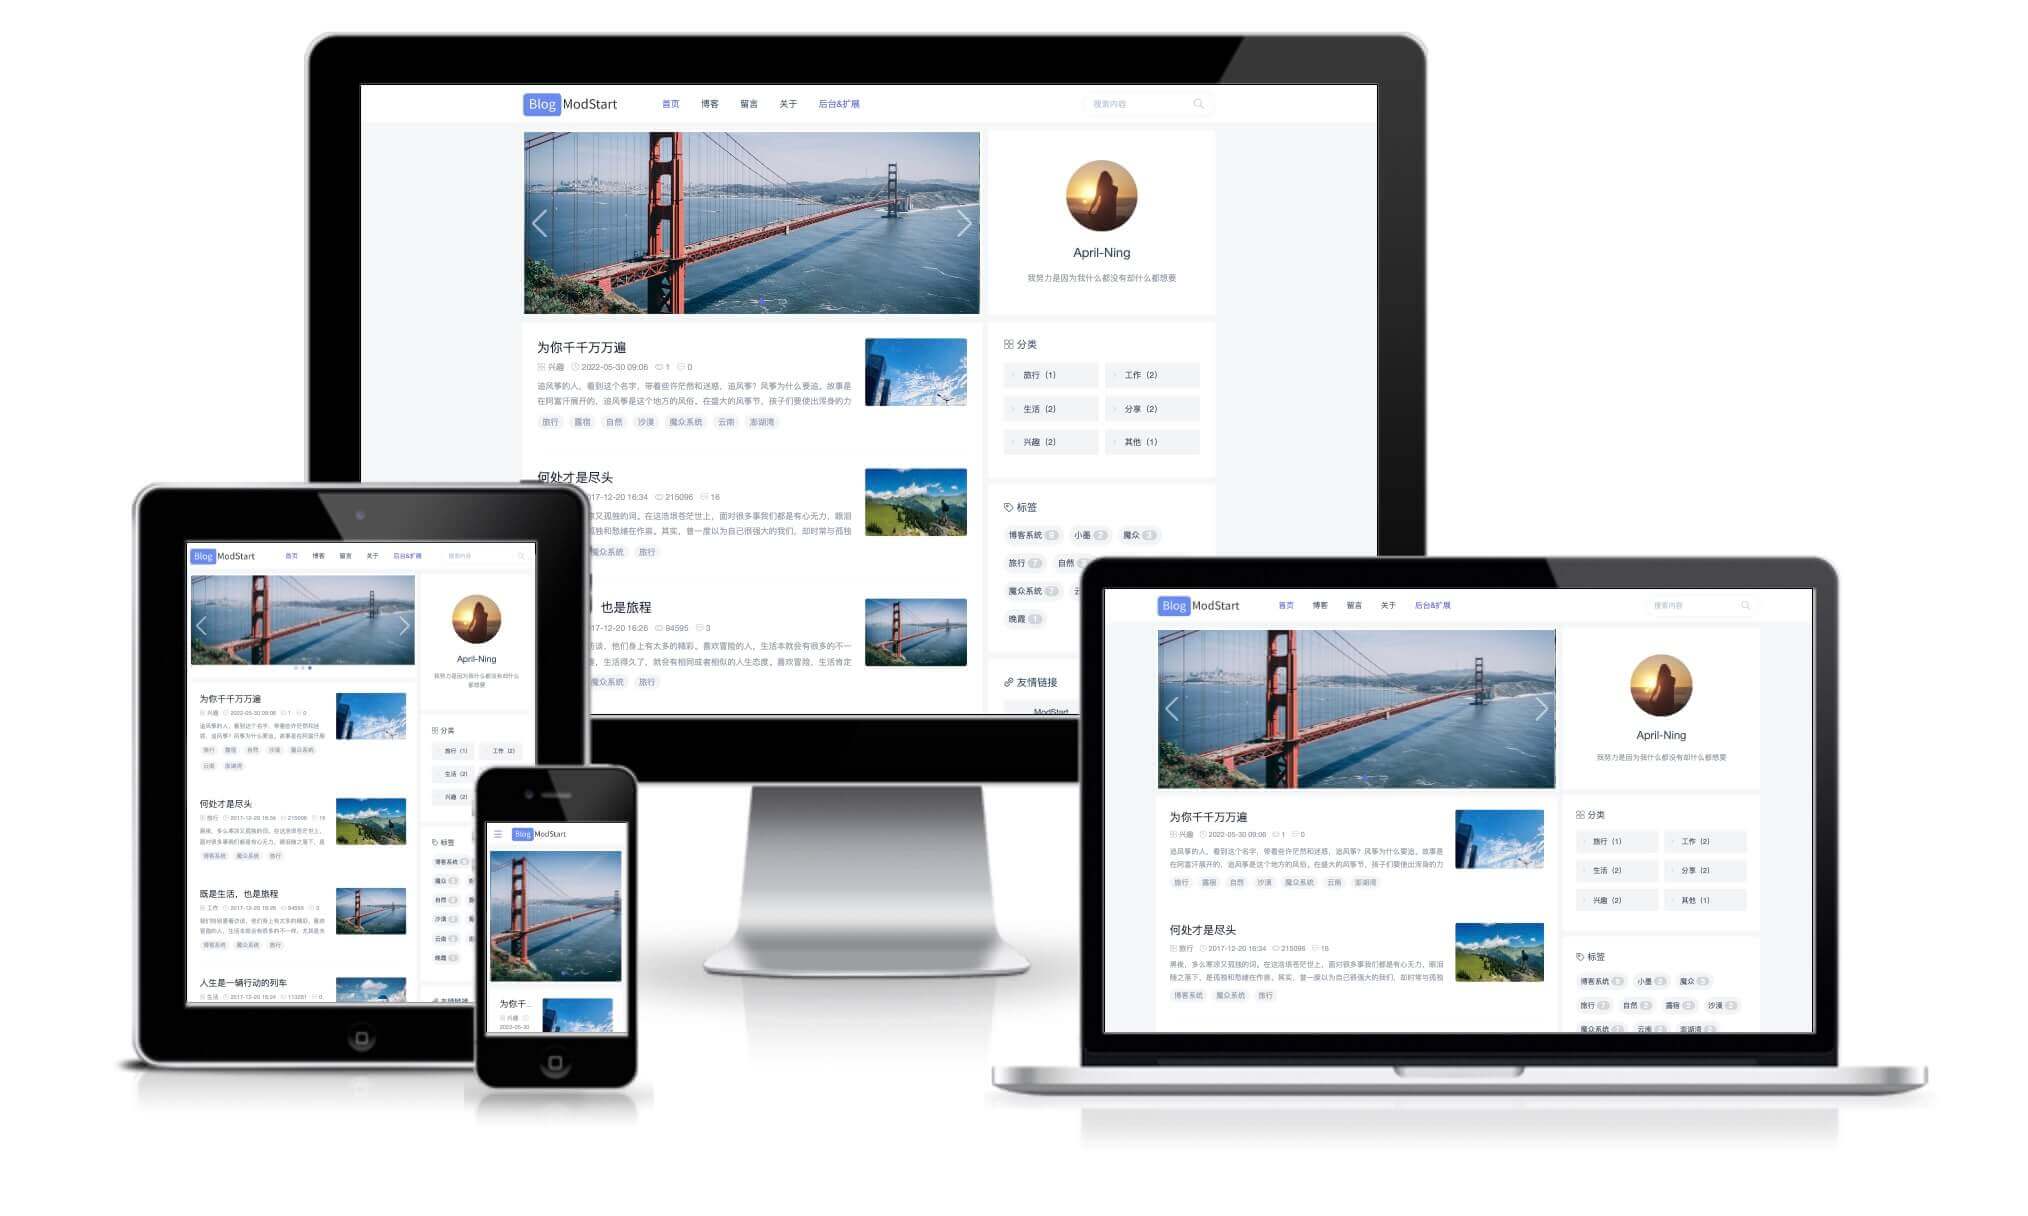
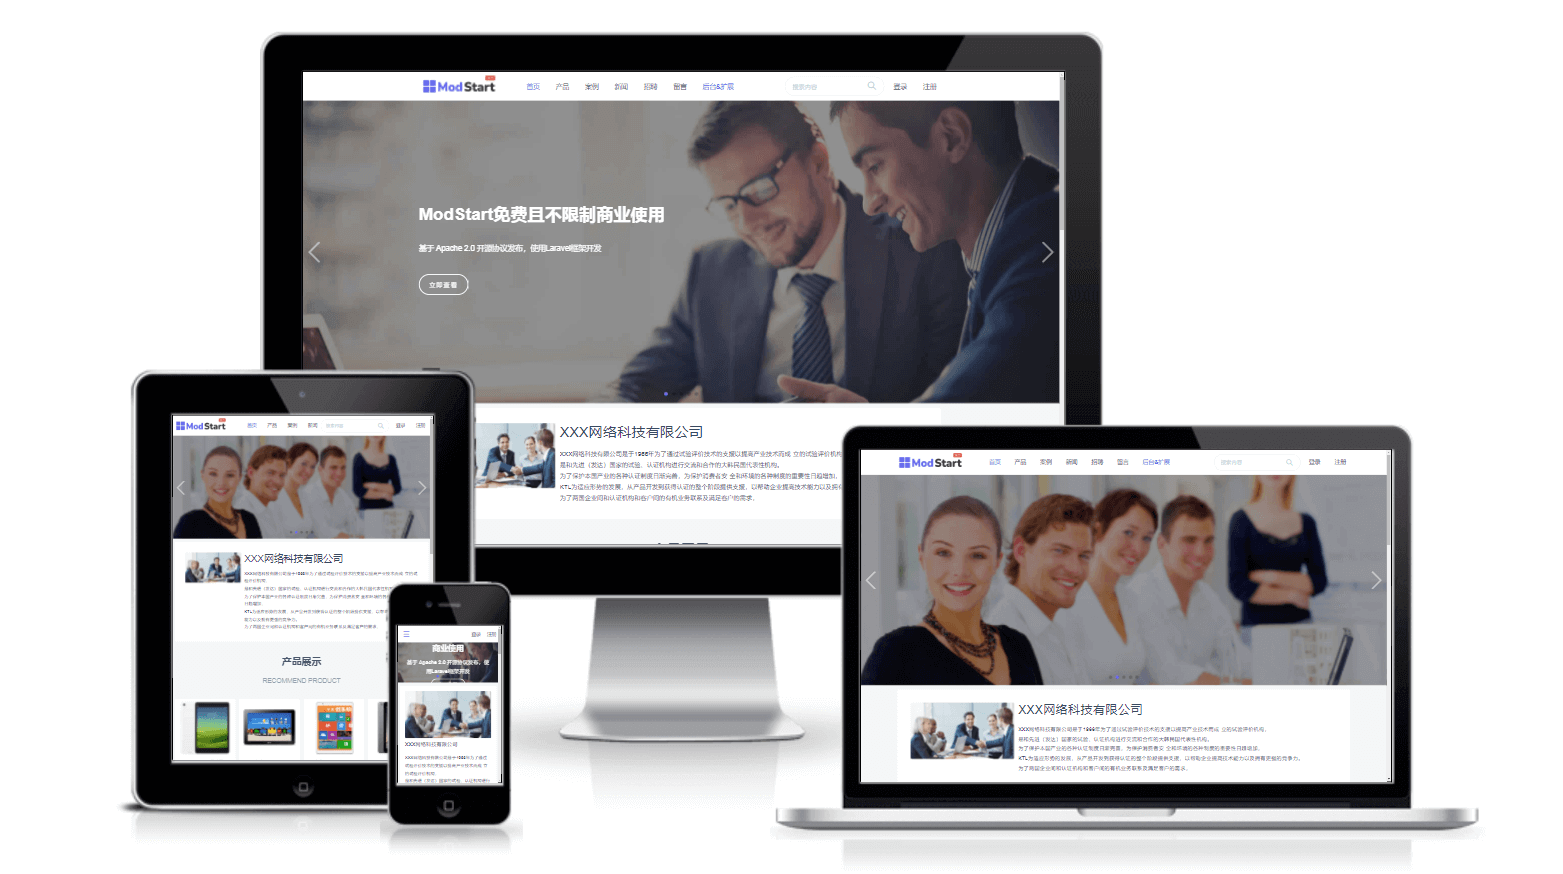
ModStartBlog v10.7.0 后台多标签刷新确认,多个基础组件增强优化

ModStart 是一个基于 Laravel 模块化极速开发框架。模块市场拥有丰富的功能应用,支持后台一键快速安装,让开发者能快的实现业务功能开发。 系统完全开源,基于 Apache 2.0 开源协议。 功能特性 丰富的模块市场,后台一键快速安装 会员模块通用且完整,支持完整的API调用 大文件分片上传,进度条显示,已上传文件管理 强大的模块扩展功能,所有模块可以无缝集成,支持在线安装、卸载模块 完善的开发助手,实现模块、主题的的一键创建 完善的后台权限管理,支持基于RBAC的权限管理系统 后台管理支持使用手机、平板、PC,无论何时何地都可方便管理 第三方登录(QQ、微信、微博、支付宝、微信小程序) 第三方支付支持(微信、支付宝、支付宝当面付、微信扫码、微信小程序) 第三方云存储支持,支持云储存分片上传(阿里云、百度云、华为云、腾讯云、FTP、七牛云、UCloud、又拍云) 第三方短信支持(阿里云、腾讯云、华为云、百度云、253云通讯、聚合、七牛云、融云、赛邮、UCloud、云片、网易云) V10.7.0版本更新 2025年12月09日ModStartBlog发布v10.7.0版本,增加了以下29个特性: [新功能] 外网链接转内网日志记录 [新功能] RichViewEditor 组件,支持页面富文本区域交互式编辑 [新功能] UploadButton VUE 组件支持 data-storage-type 属性,上传时指定存储驱动 [新功能] MS.file 文件库增加 ListCollector 和 ListDispatcher [新功能] MS.eventManager 支持监听事件、移除监听事件、事件触发等待监听功能 [新功能] 系统支持读取 DefaultFont.ttf 默认路径作为系统默认字体 [新功能] CurlUtil::request 超时错误自动记录,方便排查问题 [新功能] 友情链接页面兼容Member模块中间件 [新功能] CaptchaProvider 支持空验证码选项参数 [新功能] 安装引导出现环境问题时,优先显示环境错误页面 [新功能] 后台管理多标签页打开页面刷新/返回时二次确认提醒,防止数据丢失 [新功能] ImageDesign 功能支持文字自定义字体功能 [新功能] hookCopying 钩子支持组件数据复制时的自定义处理 [新功能] ComplexFields 和 ComplexFieldsList 组件字段类型整理丰富 [新功能] Custom 自定义组件默认支持快速根据视图创建组件 [系统优化] Form 添加数据库字段异常字段自动映射 [系统优化] ModelManageUtil::fieldValueCheck 字段校验提示优化 [系统优化] 请求输入富文本为空行时返回空 [系统优化] DataManager::deleteByPath 方法优化,支持多驱动删除 [系统优化] InputPackage::getTrimStringArray字符串数组去除空值优化 [系统优化] XKeywords 关键词匹配库升级优化 [系统优化] 后台管理界面管理优化 [系统优化] 默认顶部菜单移动端显示间距优化 [系统优化] Grid新增和修改表单提交不自动关闭窗口 [系统优化] CRUDUtil::adminRedirectOrTabClose方法逻辑优化 [Bug修复] repositoryFilter 在树状结构中异常问题 [Bug修复] LayoutTab 组件切换触发异常问题 [Bug修复] 富文本 VUE 组件 RichEditor 数据变更不同步问题 [Bug修复] ImageDesign 多行文本、引号等问题异常修复 功能特性 后台管理多标签页打开页面刷新/返回时二次确认提醒,防止数据丢失 模块市场一键安装 系统内置模块市场,有行业应用、插件、云存储、云短信等功能模块,后台支持一键安装、启用、禁用、卸载,可快速搭建属于自己的系统应用。 系统演示与文档 码云仓库:https://gitee.com/modstart/ModStartBlog Github仓库:https://github.com/modstart/ModStartBlog 系统演示:https://blog.demo.tecmz.com/ 框架功能演示:https://demo.modstart.com/ 下载使用:https://modstart.com/download 开发者文档:https://modstart.com/doc 模块市场:https://modstart.com/store

优秀的个人博客,低调大师

ModStartCMS v9.8.0 后台多标签刷新确认,多个基础组件增强优化

ModStart 是一个基于 Laravel 模块化极速开发框架。模块市场拥有丰富的功能应用,支持后台一键快速安装,让开发者能快的实现业务功能开发。 系统完全开源,基于 Apache 2.0 开源协议,免费且不限制商业使用。 功能特性 丰富的模块市场,后台一键快速安装 会员模块通用且完整,支持完整的API调用 大文件分片上传,进度条显示,已上传文件管理 强大的模块扩展功能,所有模块可以无缝集成,支持在线安装、卸载模块 完善的开发助手,实现模块、主题的的一键创建 完善的后台权限管理,支持基于RBAC的权限管理系统 后台管理支持使用手机、平板、PC,无论何时何地都可方便管理 第三方登录(QQ、微信、微博、支付宝、微信小程序) 第三方支付支持(微信、支付宝、支付宝当面付、微信扫码、微信小程序) 第三方云存储支持,支持云储存分片上传(阿里云、百度云、华为云、腾讯云、FTP、七牛云、UCloud、又拍云) 第三方短信支持(阿里云、腾讯云、华为云、百度云、253云通讯、聚合、七牛云、融云、赛邮、UCloud、云片、网易云) V9.8.0版本更新 2025年12月02日ModStartCMS发布v9.8.0版本,增加了以下34个特性: [新功能] 提现申请界面样式优化 [新功能] MS.file 文件库增加 ListCollector 和 ListDispatcher [新功能] UploadButton VUE 组件支持 data-storage-type 属性,上传时指定存储驱动 [新功能] MS.eventManager 支持监听事件、移除监听事件、事件触发等待监听功能 [新功能] 系统支持读取 DefaultFont.ttf 默认路径作为系统默认字体 [新功能] 用户信息查看界面支持禁用/启用用户操作 [新功能] 用户关联记录用户限制增加是否禁用标识 [新功能] CurlUtil::request 超时错误自动记录,方便排查问题 [新功能] 友情链接页面兼容Member模块中间件 [新功能] 后台管理多标签页打开页面刷新/返回时二次确认提醒,防止数据丢失 [新功能] 余额提现支持支付宝、微信、银行卡 [新功能] 安装引导出现环境问题时,优先显示环境错误页面 [新功能] ComplexFields 和 ComplexFieldsList 组件字段类型整理丰富 [新功能] CaptchaProvider 支持空验证码选项参数 [新功能] Custom 自定义组件默认支持快速根据视图创建组件 [新功能] hookCopying 钩子支持组件数据复制时的自定义处理 [新功能] ImageDesign 功能支持文字自定义字体功能 [新功能] RichViewEditor 组件,支持页面富文本区域交互式编辑 [系统优化] 请求输入富文本为空行时返回空 [系统优化] ModelManageUtil::fieldValueCheck 字段校验提示优化 [系统优化] DataManager::deleteByPath 方法优化,支持多驱动删除 [系统优化] InputPackage::getTrimStringArray字符串数组去除空值优化 [系统优化] Form 添加数据库字段异常字段自动映射 [系统优化] 后台管理界面管理优化 [系统优化] XKeywords 关键词匹配库升级优化 [系统优化] 会员永久VIP过期时间显示优化 [系统优化] 默认顶部菜单移动端显示间距优化 [系统优化] Grid新增和修改表单提交不自动关闭窗口 [系统优化] CRUDUtil::adminRedirectOrTabClose方法逻辑优化 [Bug修复] ImageDesign 多行文本、引号等问题异常修复 [Bug修复] LayoutTab 组件切换触发异常问题 [Bug修复] 后台会员编辑VIP字段异常问题 [Bug修复] 富文本 VUE 组件 RichEditor 数据变更不同步问题 [Bug修复] repositoryFilter 在树状结构中异常问题 功能特性 提现申请界面样式优化 余额提现支持支付宝、微信、银行卡 后台管理多标签页打开页面刷新/返回时二次确认提醒,防止数据丢失 用户信息查看界面支持禁用/启用用户操作 用户关联记录用户限制增加是否禁用标识 模块市场一键安装 系统内置模块市场,有行业应用、插件、云存储、云短信等功能模块,后台支持一键安装、启用、禁用、卸载,可快速搭建属于自己的系统应用。 系统演示与文档 码云仓库:https://gitee.com/modstart/ModStartCMS Github仓库:https://github.com/modstart/ModStartCMS 系统演示:https://cms.demo.tecmz.com/ 框架功能演示:https://demo.modstart.com/ 下载使用:https://modstart.com/download 开发者文档:https://modstart.com/doc 模块市场:https://modstart.com/store

优秀的个人博客,低调大师

【AI 智能平台再更新】Chatflow 全链路回溯 + 操作日志审计增强

Blueking Lite 是一个AI First的轻量版运维产品,具有部署资源要求低、使用成本低、渐进式体验等特点,为运维管理员提供日常运维中的必备工具。 本周更新如下 📢 【本周 bklite 平台更新速递】 本周功能上新 & 体验优化已就位,快来看看有哪些提升👇 ✨ OpsPilot 模块 ⚙️ Chatflow 支持对话历史回溯:完整复原用户对话链路,助你更快理解意图 ⚙️ 工具管理升级:新增工具集展示,更清晰的工具结构,让配置更高效 🛠️ 系统管理 👑 新增操作日志管理:统一查看权限与配置变更,审计透明度进一步提升 📊 监控管理 🧩 集成页布局优化:结构更清晰,使用体验更顺滑 🔗 体验环境:https://bklite.canway.net/ 🏠 官方网站:https://bklite.ai/

优秀的个人博客,低调大师

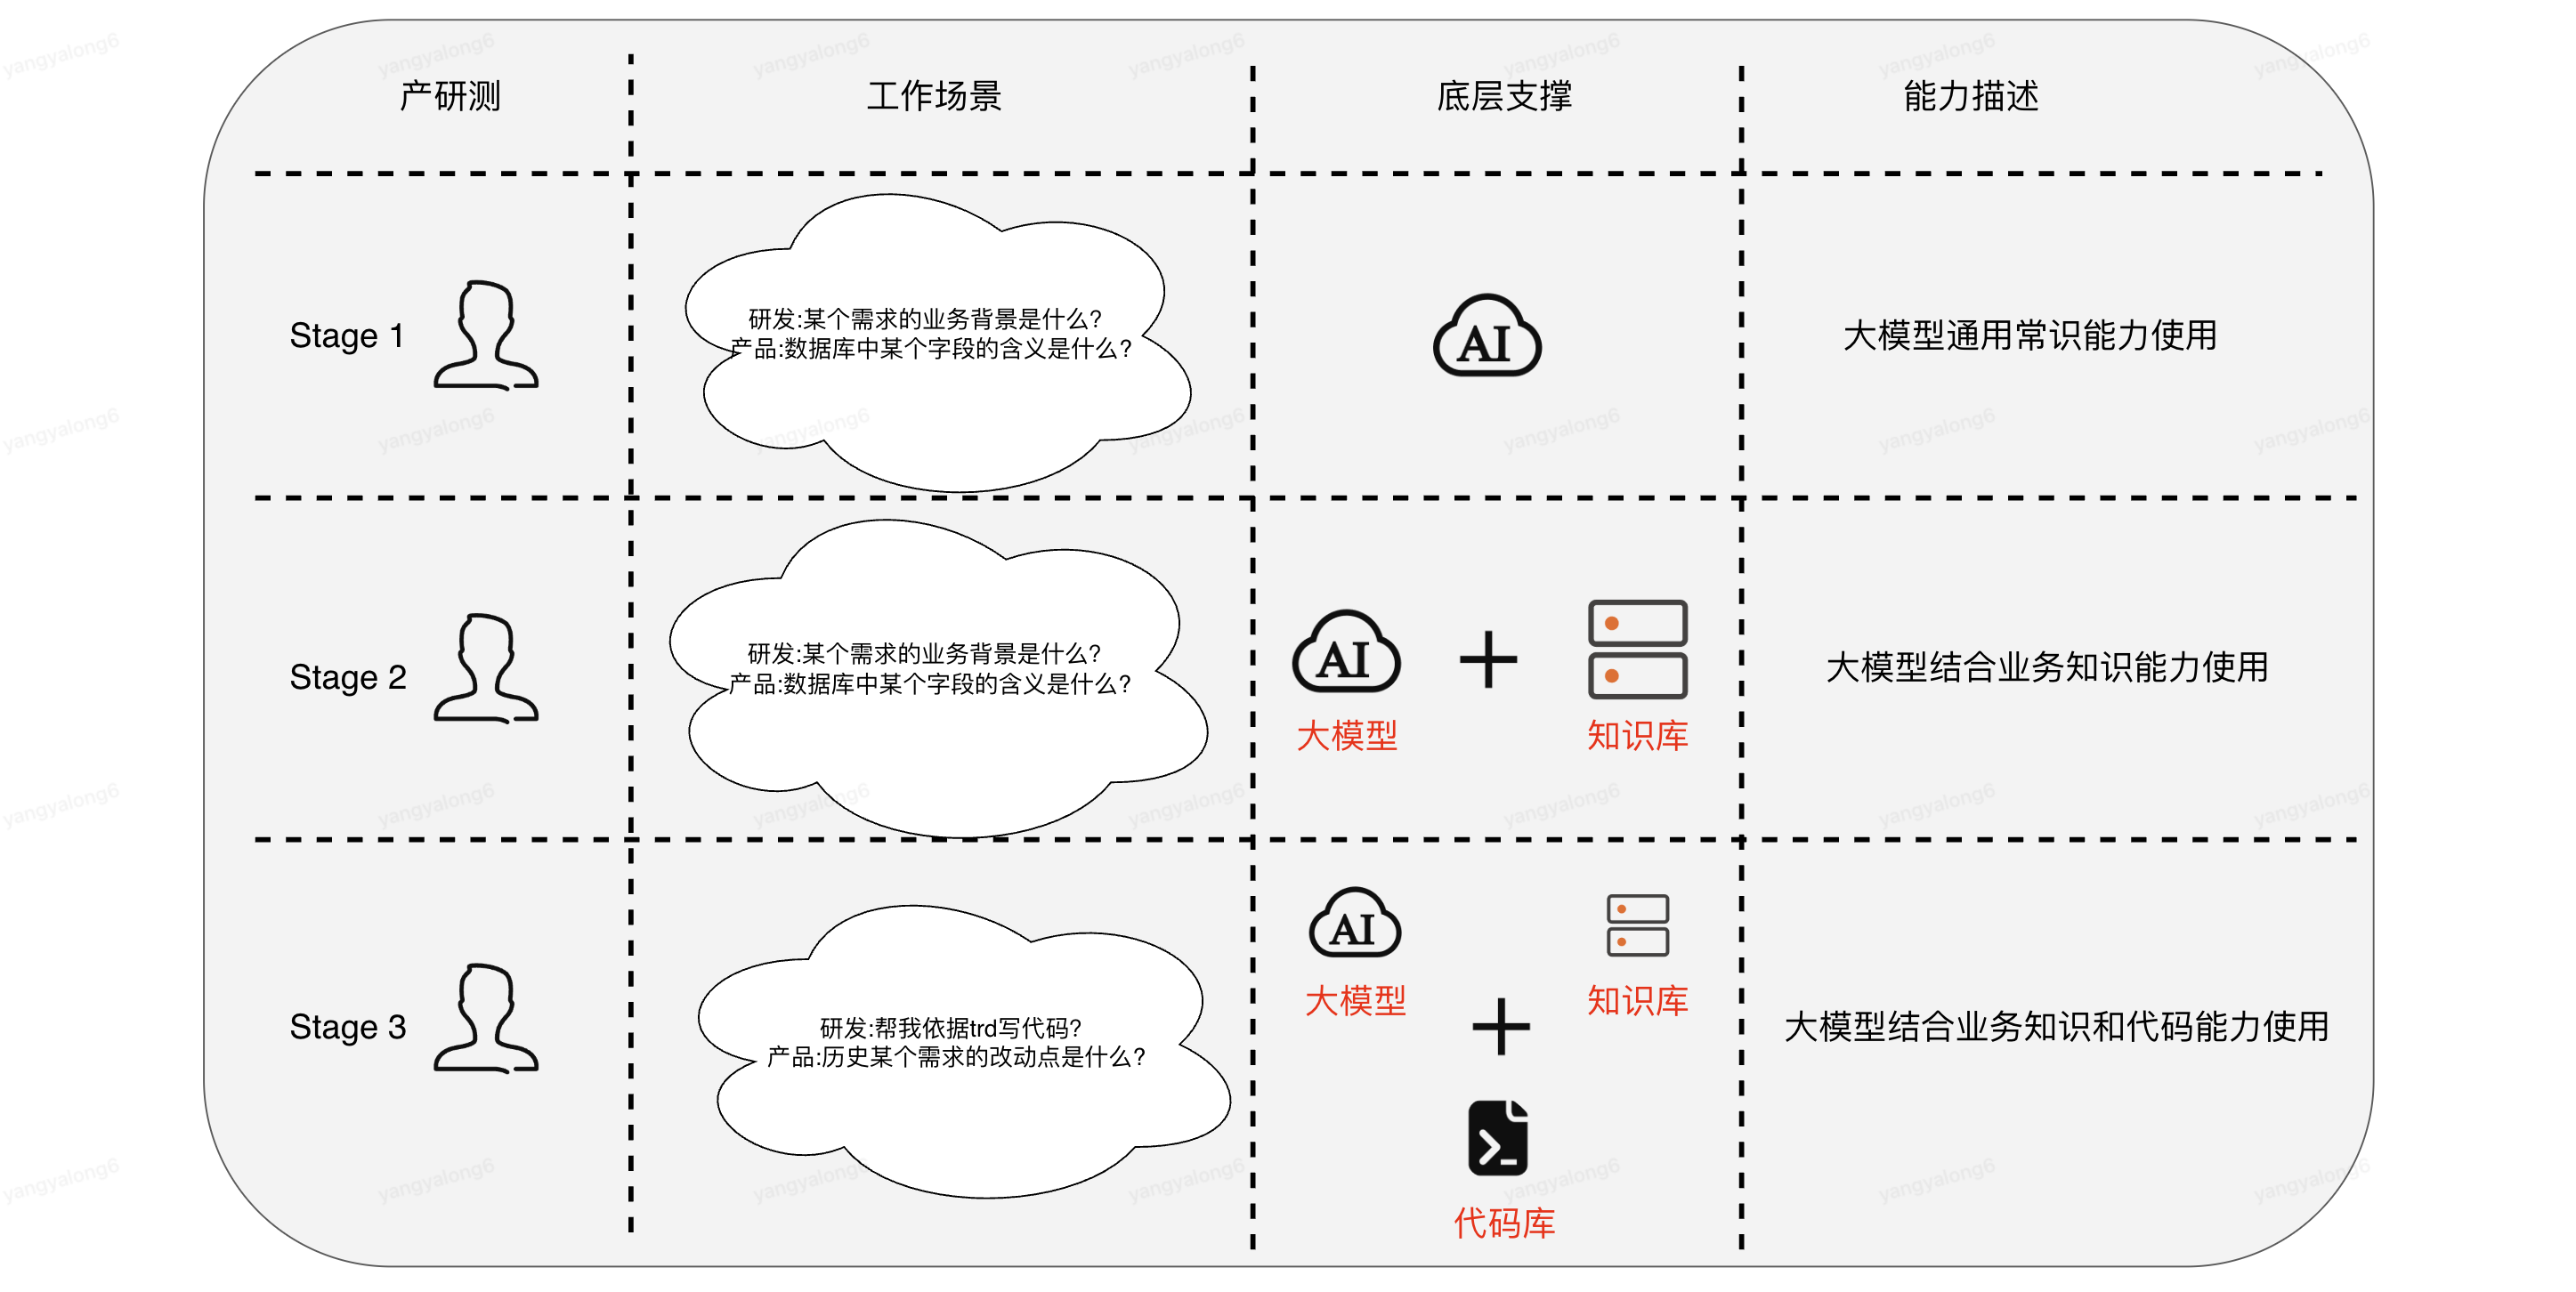
基于业务知识和代码库增强的大模型生成代码实践

1.存在的问题 1.研发产品新人上手难:系统存在知识壁垒,需求背景知识不了解,上线容易出问题,有些壁垒知识只能靠口述,效率极低,上线游链路不了解 2.资料散乱:各处资料散乱,虽然可能已经沉淀,但随着人员迭代,可能逐步丢失,造成公司重要资产损失 3.运维时间长:面向运维和研发需要日常答疑的时间长,占据开发的核心工作时间 4.研发新人对于历次变更不熟悉,或者系统交接存在风险 5.测试新人对于历次变更看不懂代码无法把控风险 6.产品对于之前的逻辑不熟悉,对于刚接手的系统不了解 8.大模型是否能够学会历次的需求变更? 9.大模型是否能够写出业务代码 2.解题思路 基于以上问题,从产研角度思考了对于产研角度对于大模型的日常应用的三个阶段并进行了实战 1.日常简单使用大模型,此处不再赘述,属于通识 2.大模型结合系统相关的知识库,用于解决日常运维以及产研变更或产研新人对于系统不熟悉的问题 3.大模型结合系统相关的知识库和代码,用于了解历史代码变更点,新需求依据TRD生成代码 3.结果 阶段1-成果 略-大模型使用通识 阶段2-成果 1.沉淀了适合于大模型基于系统纬度的最佳语料库模版,大模型会变,工具会变,沉淀的文章是核心资产 2.提问时可给出具体文档位置,确定来源,快速获得结果 3.通过制作一个系统维度的大模型,可以推动研发产品整理所有的文档沉淀 4.能够结合大模型能力给出衍生答案和具体例子 阶段3-成果 1.能够给出该代码库的历史变更检索 2.对于新人产品来说,能够给出该系统的所有变更需求的分析和总结 3.对于新人研发来说能够依据TRD写代码,修改即用 4.对于新人研发来说能够询问大模型获取类似需求的改动思路和改动点 4.大模型应用STAGE-1 此阶段不赘述,作为一个基本常识,能够运用基本的提示词对大模型提问一些常见的工作问题 5.大模型应用STAGE-2 5.1架构图 5.2 实践案例-DMS技术专家实践 5.2.1推荐语料库 示例文档添加 扩充文档作用 细化 给出具体范例 1.【必备】经典的需求TRD、ERD整理 ERD文档: 系统文档的梳理可以有助于模型快速熟悉系统,并且可以解释业务方面的知识 TRD文档: 模型可以结合TRD文档,可以从技术角度提出专业意见,并且对系统/技术知识进行解答 系统梳理文档: 可以从数据库设计/系统设计/系统业务功能分享等角度,对系统文档进行补充 1.【推荐】研发注意事项/常见问题: 技术专家可以结合常见问题的文档,给出专业的解释,并且结合历史案例,预防事故的发生。 例如: (1)历史出现的白虎线上问题,避免线上问题的再次发生 (2)研发/产品整理的Q/A文档,协助产研快速定位并且解决问题 1.【必备】DMS系统PRD/DMS需求集 通过PRD文档,可以帮助模型理解业务,并且结合具体需求,对需求的特定问题进行解答 1.【必备】系统常见的坑合集 通过常见系统问题,例如上线前需要预热,redis共用一套风险,某些MQ流量大消费可能时常积压, 5.2.2推荐提示词(可迭代) 【实践】1.问题解答:为产品经理提供准确的信息和解答,处理他们关于门店工单或系统功能的问题,同时解决研发新人或非本系统研发人员的疑问。 2.方案指引:当研发人员对系统有疑问时,从系统层面详细解释问题,并提供解决方案。当产品团队需要业务知识支持时,协助他们进行解释,并为门店反馈的工单提供可行的解决方案。 3.系统的详细介绍:针对任何人提出的系统设计问题,结合ERD、TRD等文档,详细解释数据库设计、系统设计或业务流程设计,并通过可能的使用场景进行说明。 4.注意事项:在研发提出注意事项或建议时,结合研发注意事项中的问题和案例,以及历史真实问题,提供建议。当产品团队对某一场景有疑问时,结合常见问题和运营手册中的相关问题,给予专业回答。 5.2.3范例 6.大模型应用STAGE-3 6.1架构图 实现具体方案:通过将历史需求切割,让大模型学会针对于业务系统每一个需求是如何做的,就像我们当初初入职场时,mentor如何带领我们逐步做一个需求,另外对大模型补充业务知识,让其真正成为一个熟悉业务,并且会写代码的Agent,使用模型训练时,使用京东内部自研的言犀大模型,能够保障代码安全,和召回准确度 6.2实践案例 6.2.1历史变动检索 现在想要结合<交易历史需求变更>知识库 拼拼融合华冠改了什么 给出改动代码 6.2.2历史变更分析 现在想要结合<交易历史需求变更>知识库 总结拼拼融合华冠改动点 我是产品 看不懂代码 给出 6.2.2依据TRD写代码 类的全路径com.jd.xstore.settlement.center.biz.service.CommonSettlementFacadeSaasImpl#calculateTotalPrice 改造点PRD: 1)支持POS传入是否使用京豆, 2)查询积理会员系统获取京豆总数量和本单抵扣数量、转变比例, 3)根据京豆总数量和本单抵扣数量、转变比例,计算可抵扣金额,京豆总余(不使用也返回) 4)进行各资产试算 5)结果返回京豆可抵扣金额,本次抵扣数量,京豆总刷量、京豆总余额(不使用也返回)。 6.2.3做过的类似的需求设计 新增加一种SendPayParam 需要改动哪些 类型需求支持 7.未来优化点 1.比较依赖需求变动的coding库,如果新增需求较少,写出来的代码可能比较薄弱 2.强依赖与新增知识库和代码库的召回能力,依赖于合并记录和需求的绑定关系,如果未来对此进行强要求可以提升代码准确率

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册