首页 文章 精选 留言 我的

精选列表

搜索[字节级],共10000篇文章
优秀的个人博客,低调大师

2019怎样进行大数据的入门级学习?

大数据方向的工作目前分为三个主要方向: 01.大数据工程师 02.数据分析师 03.大数据科学家 04.其他(数据挖掘本质算是机器学习,不过和数据相关,也可以理解为大数据的一个方向吧) 由于本人目前是是大数据工程师的角色,我就这个方向做一些介绍 本回答目录: 一、大数据工程师的技能要求 二、大数据学习路径 三、学习资源推荐(书籍、博客、网站) 一、大数据工程师的技能要求 总结如下: 必须技能10条: 01.Java高级(虚拟机、并发) 02.Linux 基本操作 03.Hadoop(此处为侠义概念单指HDFS+MapReduce+Yarn ) 04.HBase(JavaAPI操作+Phoenix ) 05.Hive(Hql基本操作和原理理解) 06.Kafka 07.Storm 08.Scala需要 09.Python 10.Spark (Core+sparksql+Spark streaming ) 高阶技能6条: 11.机器学习算法以及mahout库加MLlib 12.R语言 13.Lambda 架构 14.Kappa架构 15.Kylin 16.Aluxio 二、学习路径 由于本人是从Java开发通过大概3个月的自学转到大数据开发的。大数据学习扣qun:74零零加4一3八yi1所以我主要分享一下自己的学习路劲。 第一阶段: 01.Linux学习(跟鸟哥学就ok了) 02.Java 高级学习(《深入理解Java虚拟机》、《Java高并发实战》) 第二阶段: 03.Hadoop (董西成的书) 04.HBase(《HBase权威指南》) 05.Hive(《Hive开发指南》) 06.Scala(《快学Scala》) 07.Spark (《Spark 快速大数据分析》) 08.Python (跟着廖雪峰的博客学习就ok了) 第三阶段: 对应技能需求,到网上多搜集一些资料就ok了, 我把最重要的事情(要学什么告诉你了), 剩下的就是你去搜集对应的资料学习就ok了 当然如果你觉得自己看书效率太慢,你可以网上搜集一些课程,跟着课程走也OK 。这个完全根据自己情况决定。如果看书效率不高就很网课,相反的话就自己看书。 三,学习资源推荐: 01.Apache 官网 02.Stackoverflow 04.github 03.Cloudra官网 04.Databrick官网 05.过往的记忆(技术博客) 06.CSDN,51CTO 07.至于书籍当当一搜会有很多,其实内容都差不多。 最后但却很重要一点:要多关注技术动向,持续学习。 标签:大数据PythonPython入门机器学习编程语言

优秀的个人博客,低调大师

Spark 灰度发布在十万级节点上的实践

CI 介绍 持续集成是指,及时地将最新开发的且经过测试的代码集成到主干分支中。 Continuous Integration 持续集成的优点 ●快速发现错误 每次更新都及时集成到主干分支中,并进行测试,可以快速发现错误,方便定位错误 ●避免子分支大幅偏离主干分支 主干在不断更新,如果不经常集成,会产生后期集成难度变大,甚至难以集成,并造成不同开发人员间不必要的重复开发 ●为快速迭代提供保障持续集成为后文介绍的持续发布与持续部署提供了保证 Spark CI 实践 目前主流的代码管理工具有,Github、Gitlab等。本文所介绍的内容中,所有代码均托管于私有的 Gitlab 中。 鉴于 Jenkins 几乎是 CI 事实上的标准,本文介绍的 Spark CI CD & CD 实践均基于 Jenkins 与 Gitlab。 S

优秀的个人博客,低调大师

ThinkSNSPlus V1.9-V2.0升级指南

ThinkSNSPlus最新体验demo:请于官网下载/安装最新版或点击在线咨询 WARNING 当你选择从指定版本升级到指定版本的时候,请务必先停止 Web 服务。 请你先确认你的版本已经是 1.9.* 版本,这里的*可以是 1.9 的任意修复版本。 #更新代码 预计耗时:1 小时 这是你自我操作的步骤,确认将你的 1.9 版本代码升级到 2.0 版本,如果你做过一些自定义修改可能会出现代码冲突,你需要解决。 #升级依赖 预计耗时:3 分钟 进入 Plus 程序目录,执行: 这个过程根据你的网速决定快慢。 #清理缓存 预计耗时:1 分钟 不管你是否使用 Laravel 命令进行过程序优化,我们仍然建议你执行下面的命令: #升级数据库 预计耗时:10 分钟 上述数据表修改完成后进入 Plus 目录,执行下面的命令: 至此,你的数据库已升级完成。 #设置新的存储系统 预计耗时:10 分钟 现在,打开你的 Web 服务,然后在浏览器进入后台,然后从左边侧栏中找到「存储设置」,目前新的存储仅支持本地和阿里云 OSS 点击顶部菜单中的「文件系统」进行对应设置,设置完成后点击「频道设置」公开频道选择你使用的存储系统。 接下来,点击「基础设置」页面有三处设置,设置完成后接口可正常使用,如果不设置那么接口不会允许任何上传请求。 图片设置推荐宽高范围是20 - 4000以兼容云存储。 #清理缓存 预计耗时:1 分钟 到了这一步,你已经将程序成功升级到 2.0 版本了,现在我们清理下历史数据缓存即可: 所有我们的产品体验都在我们的官网“免费体验”页面可以找到:http://www.thinksns.com/experience.html APP端体验,下载新版本的朋友们,请先卸载老版本,否则无法使用;iphone手机安装demo前请点击设置-通用-设备管理-信任(企业应用) ThinkSNS(简称TS),一款全平台综合性社交系统,为国内外大中小企业和创业者提供社会化软件研发及技术解决方案,目前最新系统为ThinkSNS V4及ThinkSNS+两个并行系统。感谢大家一致对Ts团队和产品的支持,2018我们在路上。 最新官方活动:ThinkSNS+ V2.0贺中秋 9月20日权威发布 8.8折限时抢购 http://www.thinksns.com/reader/252.html ThinkSNS拥有50多个功能模块,全方位覆盖SNS系统所需,微博(朋友圈)、即时聊天、直播、论坛、资讯、CMS、活动、频道、圈子、问答、打赏等主流社交功能应有尽有。价格梯度多样,根据您的项目需求灵活选型运用,支持深度灵活二次开发。

优秀的个人博客,低调大师

设计一个百万级的消息推送系统

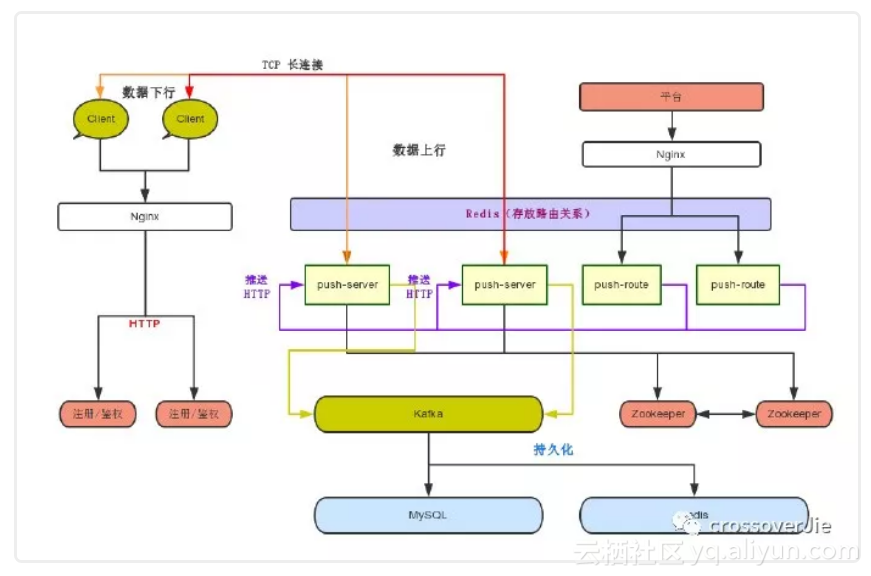
前言 首先迟到的祝大家中秋快乐。 最近一周多没有更新了。其实我一直想憋一个大招,分享一些大家感兴趣的干货。 鉴于最近我个人的工作内容,于是利用这三天小长假憋了一个出来(其实是玩了两天)。 先简单说下本次的主题,由于我最近做的是物联网相关的开发工作,其中就不免会遇到和设备的交互。 最主要的工作就是要有一个系统来支持设备的接入、向设备推送消息;同时还得满足大量设备接入的需求。 所以本次分享的内容不但可以满足物联网领域同时还支持以下场景: 基于WEB的聊天系统(点对点、群聊)。 WEB应用中需求服务端推送的场景。 基于 SDK 的消息推送平台。 技术选型 要满足大量的连接数、同时支持双全工通信,并且性能也得有保障。 在 Java 技术栈中进行选型首先自然是排除掉了传统 IO。 那就只有选 NIO 了,在这个层面其实选择也不多,考虑到社区、资料维护等方面最终选择了 Netty。 最终的架构图如下: 现在看着蒙没关系,下文一一介绍。 协议解析 既然是一个消息系统,那自然得和客户端定义好双方的协议格式。 常见和简单的是 HTTP 协议,但我们的需求中有一项需要是双全工的交互方式,同时 HTTP 更多的是服务于浏览器。我们需要的是一个更加精简的协议,减少许多不必要的数据传输。 因此我觉得最好是在满足业务需求的情况下定制自己的私有协议,在我这个场景下其实有标准的物联网协议。 如果是其他场景可以借鉴现在流行的 RPC 框架定制私有协议,使得双方通信更加高效。 不过根据这段时间的经验来看,不管是哪种方式都得在协议中预留安全相关的位置。 协议相关的内容就不过讨论了,更多介绍具体的应用。 简单实现 首先考虑如何实现功能,再来思考百万连接的情况。 注册鉴权 在做真正的消息上、下行之前首先要考虑的就是鉴权问题。 就像你使用微信一样,第一步怎么也得是登录吧,不能无论是谁都可以直接连接到平台。 所以第一步得是注册才行。 如上面架构图中的 注册/鉴权 模块。通常来说都需要客户端通过 HTTP 请求传递一个唯一标识,后台鉴权通过之后会响应一个 token,并将这个 token 和客户端的关系维护到 Redis 或者是 DB 中。 客户端将这个 token 也保存到本地,今后的每一次请求都得带上这个 token。一旦这个 token 过期,客户端需要再次请求获取 token。 鉴权通过之后客户端会直接通过 TCP长连接到图中的 push-server 模块。 这个模块就是真正处理消息的上、下行。 保存通道关系 在连接接入之后,真正处理业务之前需要将当前的客户端和 Channel 的关系维护起来。 假设客户端的唯一标识是手机号码,那就需要把手机号码和当前的 Channel 维护到一个 Map 中。 这点和之前 SpringBoot 整合长连接心跳机制 类似。 同时为了可以通过 Channel 获取到客户端唯一标识(手机号码),还需要在 Channel 中设置对应的属性: public static void putClientId(Channel channel, String clientId) { channel.attr(CLIENT_ID).set(clientId); } 获取时手机号码时: public static String getClientId(Channel channel) { return (String)getAttribute(channel, CLIENT_ID); } 这样当我们客户端下线的时便可以记录相关日志: String telNo = NettyAttrUtil.getClientId(ctx.channel()); NettySocketHolder.remove(telNo); log.info("客户端下线,TelNo=" + telNo); 这里有一点需要注意:存放客户端与 Channel 关系的 Map 最好是预设好大小(避免经常扩容),因为它将是使用最为频繁同时也是占用内存最大的一个对象。 消息上行 接下来则是真正的业务数据上传,通常来说第一步是需要判断上传消息输入什么业务类型。 在聊天场景中,有可能上传的是文本、图片、视频等内容。 所以我们得进行区分,来做不同的处理;这就和客户端协商的协议有关了。 可以利用消息头中的某个字段进行区分。 更简单的就是一个JSON消息,拿出一个字段用于区分不同消息。 不管是哪种只有可以区分出来即可。 消息解析与业务解耦 消息可以解析之后便是处理业务,比如可以是写入数据库、调用其他接口等。 我们都知道在 Netty 中处理消息一般是在 channelRead() 方法中。 在这里可以解析消息,区分类型。 但如果我们的业务逻辑也写在里面,那这里的内容将是巨多无比。 甚至我们分为好几个开发来处理不同的业务,这样将会出现许多冲突、难以维护等问题。 所以非常有必要将消息解析与业务处理完全分离开来。 这时面向接口编程就发挥作用了。 这里的核心代码和 「造个轮子」——cicada(轻量级 WEB 框架) 是一致的。 都是先定义一个接口用于处理业务逻辑,然后在解析消息之后通过反射创建具体的对象执行其中的 处理函数即可。 这样不同的业务、不同的开发人员只需要实现这个接口同时实现自己的业务逻辑即可。 伪代码如下: 想要了解 cicada 的具体实现请点击这里: https://github.com/TogetherOS/cicada 上行还有一点需要注意;由于是基于长连接,所以客户端需要定期发送心跳包用于维护本次连接。同时服务端也会有相应的检查,N 个时间间隔没有收到消息之后将会主动断开连接节省资源。 这点使用一个 IdleStateHandler 就可实现,更多内容可以查看 Netty(一) SpringBoot 整合长连接心跳机制。 消息下行 有了上行自然也有下行。比如在聊天的场景中,有两个客户端连上了 push-server,他们直接需要点对点通信。 这时的流程是: A 将消息发送给服务器。 服务器收到消息之后,得知消息是要发送给 B,需要在内存中找到 B 的 Channel。 通过 B 的 Channel 将 A 的消息转发下去。 这就是一个下行的流程。 甚至管理员需要给所有在线用户发送系统通知也是类似: 遍历保存通道关系的 Map,挨个发送消息即可。这也是之前需要存放到 Map 中的主要原因。 伪代码如下: 具体可以参考: https://github.com/crossoverJie/netty-action/ 分布式方案 单机版的实现了,现在着重讲讲如何实现百万连接。 百万连接其实只是一个形容词,更多的是想表达如何来实现一个分布式的方案,可以灵活的水平拓展从而能支持更多的连接。 再做这个事前首先得搞清楚我们单机版的能支持多少连接。影响这个的因素就比较多了。 服务器自身配置。内存、CPU、网卡、Linux 支持的最大文件打开数等。 应用自身配置,因为 Netty 本身需要依赖于堆外内存,但是 JVM 本身也是需要占用一部分内存的,比如存放通道关系的大Map。这点需要结合自身情况进行调整。 结合以上的情况可以测试出单个节点能支持的最大连接数。 单机无论怎么优化都是有上限的,这也是分布式主要解决的问题。 架构介绍 在将具体实现之前首先得讲讲上文贴出的整体架构图。 先从左边开始。 上文提到的 注册鉴权 模块也是集群部署的,通过前置的 Nginx 进行负载。之前也提过了它主要的目的是来做鉴权并返回一个 token 给客户端。 但是 push-server 集群之后它又多了一个作用。那就是得返回一台可供当前客户端使用的 push-server。 右侧的 平台 一般指管理平台,它可以查看当前的实时在线数、给指定客户端推送消息等。 推送消息则需要经过一个推送路由( push-server)找到真正的推送节点。 其余的中间件如:Redis、Zookeeper、Kafka、MySQL 都是为了这些功能所准备的,具体看下面的实现。 注册发现 首先第一个问题则是 注册发现, push-server 变为多台之后如何给客户端选择一台可用的节点是第一个需要解决的。 这块的内容其实已经在 分布式(一) 搞定服务注册与发现 中详细讲过了。 所有的 push-server 在启动时候需要将自身的信息注册到 Zookeeper 中。 注册鉴权 模块会订阅 Zookeeper 中的节点,从而可以获取最新的服务列表。结构如下: 以下是一些伪代码: 应用启动注册 Zookeeper。 对于 注册鉴权模块来说只需要订阅这个 Zookeeper 节点: 路由策略 既然能获取到所有的服务列表,那如何选择一台刚好合适的 push-server 给客户端使用呢? 这个过程重点要考虑以下几点: 尽量保证各个节点的连接均匀。 增删节点是否要做 Rebalance。 首先保证均衡有以下几种算法: 轮询。挨个将各个节点分配给客户端。但会出现新增节点分配不均匀的情况。 Hash 取模的方式。类似于 HashMap,但也会出现轮询的问题。当然也可以像 HashMap 那样做一次 Rebalance,让所有的客户端重新连接。不过这样会导致所有的连接出现中断重连,代价有点大。 由于 Hash 取模方式的问题带来了一致性Hash算法,但依然会有一部分的客户端需要 Rebalance。 权重。可以手动调整各个节点的负载情况,甚至可以做成自动的,基于监控当某些节点负载较高就自动调低权重,负载较低的可以提高权重。 还有一个问题是: 当我们在重启部分应用进行升级时,在该节点上的客户端怎么处理? 由于我们有心跳机制,当心跳不通之后就可以认为该节点出现问题了。那就得重新请求 注册鉴权模块获取一个可用的节点。在弱网情况下同样适用。 如果这时客户端正在发送消息,则需要将消息保存到本地等待获取到新的节点之后再次发送。 有状态连接 在这样的场景中不像是 HTTP 那样是无状态的,我们得明确的知道各个客户端和连接的关系。 在上文的单机版中我们将这个关系保存到本地的缓存中,但在分布式环境中显然行不通了。 比如在平台向客户端推送消息的时候,它得首先知道这个客户端的通道保存在哪台节点上。 借助我们以前的经验,这样的问题自然得引入一个第三方中间件用来存放这个关系。 也就是架构图中的存放 路由关系的Redis,在客户端接入 push-server 时需要将当前客户端唯一标识和服务节点的 ip+port 存进 Redis。 同时在客户端下线时候得在 Redis 中删掉这个连接关系。 这样在理想情况下各个节点内存中的 map 关系加起来应该正好等于 Redis 中的数据。 伪代码如下: 这里存放路由关系的时候会有并发问题,最好是换为一个 lua 脚本。 推送路由 设想这样一个场景:管理员需要给最近注册的客户端推送一个系统消息会怎么做? 结合架构图 假设这批客户端有 10W 个,首先我们需要将这批号码通过 平台下的 Nginx 下发到一个推送路由中。 为了提高效率甚至可以将这批号码再次分散到每个 push-route 中。 拿到具体号码之后再根据号码的数量启动多线程的方式去之前的路由 Redis 中获取客户端所对应的 push-server。 再通过 HTTP 的方式调用 push-server 进行真正的消息下发(Netty 也很好的支持 HTTP 协议)。 推送成功之后需要将结果更新到数据库中,不在线的客户端可以根据业务再次推送等。 消息流转 也许有些场景对于客户端上行的消息非常看重,需要做持久化,并且消息量非常大。 在 push-sever 做业务显然不合适,这时完全可以选择 Kafka 来解耦。 将所有上行的数据直接往 Kafka 里丢后就不管了。 再由消费程序将数据取出写入数据库中即可。 其实这块内容也很值得讨论,可以先看这篇了解下:强如 Disruptor 也发生内存溢出? 后续谈到 Kafka 再做详细介绍。 分布式问题 分布式解决了性能问题但却带来了其他麻烦。 应用监控 比如如何知道线上几十个 push-server 节点的健康状况? 这时就得监控系统发挥作用了,我们需要知道各个节点当前的内存使用情况、GC。 以及操作系统本身的内存使用,毕竟 Netty 大量使用了堆外内存。 同时需要监控各个节点当前的在线数,以及 Redis 中的在线数。理论上这两个数应该是相等的。 这样也可以知道系统的使用情况,可以灵活的维护这些节点数量。 日志处理 日志记录也变得异常重要了,比如哪天反馈有个客户端一直连不上,你得知道问题出在哪里。 最好是给每次请求都加上一个 traceID 记录日志,这样就可以通过这个日志在各个节点中查看到底是卡在了哪里。 以及 ELK 这些工具都得用起来才行。 总结 本次是结合我日常经验得出的,有些坑可能在工作中并没有踩到,所有还会有一些遗漏的地方。 就目前来看想做一个稳定的推送系统其实是比较麻烦的,其中涉及到的点非常多,只有真正做过之后才会知道。 原文发布时间为:2018-09-25 本文作者:crossoverJie 本文来自云栖社区合作伙伴“crossoverJie”,了解相关信息可以关注“crossoverJie”。

优秀的个人博客,低调大师

C# DataGridView下DataGridViewComboBoxColumn二级联动

效果: 代码: using System; using System.Collections.Generic; using System.ComponentModel; using System.Data; using System.Drawing; using System.Text; using System.Windows.Forms; namespace DataGridViewDownComboBoxDemo { public partial class Form1 : Form { //级联的列 DataGridViewComboBoxColumn columns3 = null; public Form1() { InitializeComponent(); this.dataGridView1.DataError += delegate (object sender, DataGridViewDataErrorEventArgs e) { }; } /// <summary> /// 绑定GRIDVIEW /// </summary> public void GetData() { //第二列 DataGridViewComboBoxColumn columns2 = new DataGridViewComboBoxColumn(); columns2.Name = "col2"; columns2.DataPropertyName = "Type"; //从数据源绑定列,这一列就是那个值 columns2.HeaderText = "货区"; string[] strTmp = new string[] { "货区A", "货区B", "货区C" , "货区D", "货区E", "货区F" }; DgvCombobox(ref columns2, strTmp);//此方法是定义的关键 //第三列 columns3 = new DataGridViewComboBoxColumn(); columns3.Name = "col3"; columns3.HeaderText = "货架"; //生成gridview数据源 DataTable dt = new DataTable(); dt.Columns.Add(new DataColumn("序号")); dt.Columns.Add(new DataColumn("物资名称")); dt.Columns.Add(new DataColumn("物资编号")); for (int i = 0; i < 20; i++) { DataRow dr = dt.NewRow(); dr[0] = i+1; dr[1] = "戴尔笔记本"; dr[2] = "00000"+(i+1).ToString(); dt.Rows.Add(dr); } this.dataGridView1.DataSource = dt; //gridview添加列 dataGridView1.Columns.AddRange(new DataGridViewColumn[] { columns2, columns3 }); } /// <summary> /// 绑定第二列 /// </summary> /// <param name="column"></param> /// <param name="strTmp"></param> public void DgvCombobox(ref DataGridViewComboBoxColumn column, string[] strTmp) { DataTable dt = new DataTable(); DataColumn dc = new DataColumn("tmp", typeof(string)); dt.Columns.Add(dc); dt.Columns.Add(new DataColumn("ID", typeof(string))); DataRow dr; for (int i = 0; i < strTmp.Length; i++) { dr = dt.NewRow(); dr["tmp"] = strTmp[i]; dr["id"] = i; dt.Rows.Add(dr); } //为combobox绑定生成的表 column.DataSource = dt; //combobox列的数据源,绑定为生成的表 column.DisplayMember = "tmp";//要显示的名称,表的文字例 column.ValueMember = dt.Columns[1].ToString();//文字对应的值,此列将和columns2.DataPropertyName 属性的值对应来显示选中的值 } private void Form1_Load(object sender, EventArgs e) { this.GetData(); } //添加委托事件 private void dataGridView1_EditingControlShowing(object sender, DataGridViewEditingControlShowingEventArgs e) { if (this.dataGridView1.CurrentCell.OwningColumn.Name == "col2") { ((ComboBox)e.Control).SelectedIndexChanged += new EventHandler(ComboBox_SelectedIndexChanged); } } private void ComboBox_SelectedIndexChanged(object sender, EventArgs e) { if (this.dataGridView1.CurrentCell.OwningColumn.Name == "col2") { string str = ((ComboBox)sender).Text.ToString(); //绑定第二个COMBOX DataTable dt = new DataTable(); dt.Columns.Add(new DataColumn("id")); dt.Columns.Add(new DataColumn("text")); for (int i = 0; i < 20; i++) { DataRow dr = dt.NewRow(); dr[0] = str + i; dr[1] = str + i; dt.Rows.Add(dr); } ((DataGridViewComboBoxCell)this.dataGridView1.CurrentRow.Cells[4]).DataSource = dt; ((DataGridViewComboBoxCell)this.dataGridView1.CurrentRow.Cells[4]).DisplayMember = "text"; ((DataGridViewComboBoxCell)this.dataGridView1.CurrentRow.Cells[4]).ValueMember = "id"; ((ComboBox)sender).SelectedIndexChanged -= new EventHandler(ComboBox_SelectedIndexChanged); } } } } 提示:此demo不需要链接数据库,只要在自己的窗体上创建一个datagridview命名为datagridview1即可。 datagridview1的EditMode设为EditOnEnter可实现点击一次就出下拉列表。

优秀的个人博客,低调大师

nginx匹配规则说明以及匹配的优先级

location 匹配规则 语法规则 location [=|~|~*|^~] /uri/ { … } 模式 含义 location = /uri = 表示精确匹配,只有完全匹配上才能生效 location ^~ /uri ^~ 开头对URL路径进行前缀匹配,并且在正则之前。 location ~ pattern 开头表示区分大小写的正则匹配 location ~* pattern 开头表示不区分大小写的正则匹配 location /uri 不带任何修饰符,也表示前缀匹配,但是在正则匹配之后 location / 通用匹配,任何未匹配到其它location的请求都会匹配到,相当于switch中的default 前缀匹配时,Nginx 不对 url 做编码,因此请求为 /static/20%/aa,可以被规则^~ /static/ /aa匹配到(注意是空格) 多个 location 配置的情况下匹配顺序为(参考资料而来,还未实际验证,试试就知道了,不必拘泥,仅供参考): 首先精确匹配 = 其次前缀匹配 ^~ 其次是按文件中顺序的正则匹配 然后匹配不带任何修饰的前缀匹配。 最后是交给 / 通用匹配 当有匹配成功时候,停止匹配,按当前匹配规则处理请求 注意:前缀匹配,如果有包含关系时,按最大匹配原则进行匹配。比如在前缀匹配:location /dir01与location /dir01/dir02,如有请求http://localhost/dir01/dir02/file 将最终匹配到location /dir01/dir02 例子,有如下匹配规则: location = / { echo "规则A"; } location = /login { echo "规则B"; } location ^~ /static/ { echo "规则C"; } location ^~ /static/files { echo "规则X"; } location ~ \.(gif|jpg|png|js|css)$ { echo "规则D"; } location ~* \.png$ { echo "规则E"; } location /img { echo "规则Y"; } location / { echo "规则F"; } 那么产生的效果如下: 访问根目录 /,比如 http://localhost/ 将匹配 规则A 访问http://localhost/login将匹配 规则B,http://localhost/register则匹配 规则F 访问 http://localhost/static/a.html 将匹配 规则C 访问http://localhost/static/files/a.exe将匹配 规则X,虽然 规则C也能匹配到,但因为最大匹配* 原则,最终选中了 规则X。你可以测试下,去掉规则 X ,则当前 URL 会匹配上 规则C。 访问 http://localhost/a.gif, http://localhost/b.jpg将匹配 规则D 和 规则 E ,但是 规则 D 顺序* 优先,规则 E 不起作用,而http://localhost/static/c.png 则优先匹配到 规则 C 访问http://localhost/a.PNG则匹配 规则 E ,而不会匹配 规则 D ,因为 规则 E不区分大小写。 访问 http://localhost/img/a.gif 会匹配上 规则D,虽然 规则Y 也可以匹配上,但是因为正则匹配优先,而忽略了 规则Y。 访问 http://localhost/img/a.tiff会匹配上规则Y。 访问http://localhost/category/id/1111 则最终匹配到规则 F ,因为以上规则都不匹配,这个时候应该是 Nginx 转发请求给后端应用服务器,比如 FastCGI(php),tomcat(jsp),Nginx 作为反向代理服务器存在。 所以实际使用中,笔者觉得至少有三个匹配规则定义,如下: # 直接匹配网站根,通过域名访问网站首页比较频繁,使用这个会加速处理,官网如是说。 # 这里是直接转发给后端应用服务器了,也可以是一个静态首页 # 第一个必选规则 location = / { proxy_pass http://tomcat:8080/index } # 第二个必选规则是处理静态文件请求,这是 nginx 作为 http 服务器的强项 # 有两种配置模式,目录匹配或后缀匹配,任选其一或搭配使用 location ^~ /static/ { root /webroot/static/; } location ~* \.(gif|jpg|jpeg|png|css|js|ico)$ { root /webroot/res/; } # 第三个规则就是通用规则,用来转发动态请求到后端应用服务器 # 非静态文件请求就默认是动态请求,自己根据实际把握 # 毕竟目前的一些框架的流行,带.php、.jsp后缀的情况很少了 location / { proxy_pass http://tomcat:8080/ } rewrite 语法 last – 基本上都用这个 Flag break – 中止 Rewirte,不再继续匹配 redirect – 返回临时重定向的 HTTP 状态 302 permanent – 返回永久重定向的 HTTP 状态 301 1、下面是可以用来判断的表达式: -f 和 !-f 用来判断是否存在文件 -d 和 !-d 用来判断是否存在目录 -e 和 !-e 用来判断是否存在文件或目录 -x 和 !-x 用来判断文件是否可执行 2、下面是可以用作判断的全局变量 例:http://localhost:88/test1/test2/test.php?k=v $host:localhost $server_port:88 $request_uri:/test1/test2/test.php?k=v $document_uri:/test1/test2/test.php $document_root:D:\nginx/html $request_filename:D:\nginx/html/test1/test2/test.php redirect 语法 server { listen 80; server_name start.igrow.cn; index index.html index.php; root html; if ($http_host !~ "^star\.igrow\.cn$") { rewrite ^(.*) http://star.igrow.cn$1 redirect; } } 防盗链 location ~* \.(gif|jpg|swf)$ { valid_referers none blocked start.igrow.cn sta.igrow.cn; if ($invalid_referer) { rewrite ^/ http://$host/logo.png; } } 根据文件类型设置过期时间 location ~* \.(js|css|jpg|jpeg|gif|png|swf)$ { if (-f $request_filename) { expires 1h; break; } } 禁止访问某个目录 location ~* \.(txt|doc)${ root /data/www/wwwroot/linuxtone/test; deny all; } 完整demo upstream appzuul { server 192.168.*.*:18600; server 192.168.*.*:18600; } server { listen 80; server_name a.cooper.com b.cooper.com; rewrite ^/(.*)$ https://a.cooper.com/$1 permanent; } server { listen 443 ssl; server_name a.cooper.com b.cooper.com; root /opt/web_html/auth.100credit.com; index login index.html index.htm login.html applicationMasterPage.html; ssl_certificate /opt/nginx-1.4.7/conf/ssl/100credit.com.crt; ssl_certificate_key /opt/nginx-1.4.7/conf/ssl/100credit.com.key; ssl_prefer_server_ciphers on; ssl_protocols SSLv3 TLSv1; ssl_ciphers ALL:!ADH:!EXPORT56:RC4+RSA:+HIGH:+MEDIUM:+LOW:+SSLv2:+EXP; access_log logs/a.cooper.com_access.log; error_log logs/a.cooper.com_error.log; error_page 404 /view/404.html; #重定向首页 location ~ /base/{ rewrite ^/base/login\.html /#/login permanent; } #前端目录调整 location ^~ /v/ { rewrite ^/v/(.*)$ /$1 permanent; } # 静态资源配置方式一 location / { root /opt/web_html/apiservice.100credit.com; index index.html; try_files $uri $uri/ /index.html; } # 静态资源配置方式二 # location ~ .*\.(html|htm|gif|jpg|jpeg|bmp|png|ico|js|css|json|md|woff)$ # { # root /opt/web_html/auth.100credit.com; # index index.html index.htm applicationMasterPage.html; # } location ^~ /api/ { proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header REMOTE-HOST $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_pass http://appzuul; } location ^~ /zuul/api/ { proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header REMOTE-HOST $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_pass http://appzuul; } }

优秀的个人博客,低调大师

cisco2960升级ios并更新配置

1、配置IP地址好上传iOS和config.text文件 Switch#conf t Switch(config)#int vlan 1 Switch(config)#ip add 172.16.1.1 255.255.0.0 Switch(config)#no shut Switch(config)#end Switch#ping 172.16.1.2 //电脑上配置的IP,要和上面的地址在一个网段 //ping通后说明网络没问题了,可以上传iOS和配置文件了 //把网线插入交换机的任意口,因为默认都在vlan1里 2、上传iOS和配置文件 Switch#copy tftp: flash: 提示输入远程主机172.16.1.2 提示输入要传的文件名(要注意带上后缀)c2960-lanbasek9-mz.122-50.SE5.bin 提示目的地文件名c2960-lanbasek9-mz.122-50.SE5.bin 传输开始,同上在把config.text文件也上传 3、修改引导镜像 Switch#config t Switch(config)#boot system flash: c2960-lanbasek9-mz.122-50.SE5.bin Switch(config)#end Switch#wr Switch#reload 重启后进入查看是否启动新iOS,show version 确认后,copy flash:config.text system:running-config Wr保存,至此升级和跟新配置完毕,在Ciscows-2960-24tt-L上通过 本文转自 古老 51CTO博客,原文链接:http://blog.51cto.com/yzmlinux/1620399,如需转载请自行联系原作者

优秀的个人博客,低调大师

玩转树莓派——企业级树莓派管理:SCCM

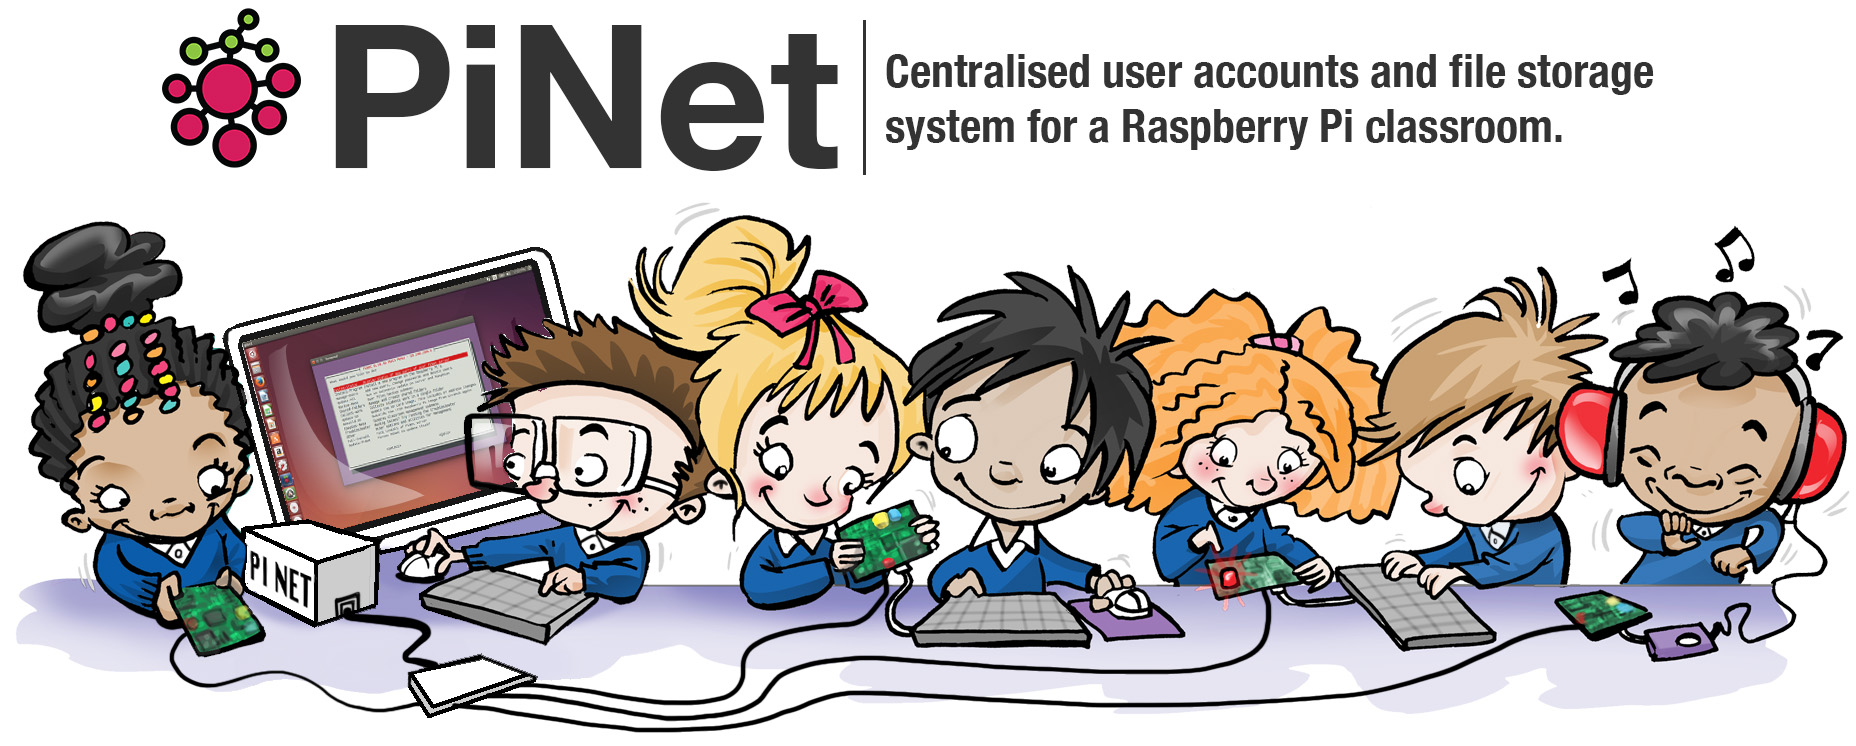
System Center, Configuration Manager, Device Management, Raspberry Pi, CSP 这篇随笔由树莓派而起,却穿越时空,让我想起故人故事。并纵横万里,牵扯到设备管理…… 树莓派是个开源硬件,初衷为了让更多的孩子以很低的成本来学习计算机,学习编程,了解世界。在教室这种环境,或者使用树莓派当瘦客户机的环境,因为需要大批量配置树莓派,所以一个配置系统是必不可少的。 所以在树莓派的官网上有项目叫PINET,地址在:http://pinet.org.uk/。可以连接到服务器进行集中的系统启动。至于商业化的,ThinLinx有其自己做的TMS系统来集中管理树莓派。http://www.thinlinx.com/tms.html 以上两种都是针对Raspbian的Linux系统,如果运行了Windows 10 IoT Core的树莓派,如何进行管理和制备呢?作为操作系统老牌厂商,Microsoft自然不会让其缺失太久。答案就是如同少林一般博大精深的SCCM(哈哈)。当然,少林现在遍布天下,正如可以使用SCCM+InTune 云服务(哈哈哈)。 严格来说,Windows 10 IoT Core和1%日薄西山的Windows 10 Mobile、MR日出东方的Holographic一样,同属运行Windows 10系统的设备,在UWP大一统的框架下,很多特性和配置与我正在写字的Windows 10二合一笔记本没啥太大区别。由此,对Windows 10 IoT Core的管理近乎等同于对Windows 10 Mobile的管理。 对移动设备的管理,一般首先需要双向验证管理服务器和移动设备的身份,这样可避免身份伪造或中间人攻击。我们已经知道SCCM可以向各类设备例如Windows、Windows Phone、Windows Mobile、iPhone、iPad、Mac OS X和Android推送合规配置,因此使用SCCM来做证书分发也不是一件困难的事情。 而SCCM大多针对在线设备,如何在系统初始化阶段就完成这些配置呢?对于传统的方式我们有OSD/MDT等操作系统部署方式,而对于移动设备我们可以使用WICD(Windows Imageing and Configuration Designer),包含在Windows Assessment and Deployment Kit中(即常说的Windows ADK或WADK)。 对于预定义的配置,可以直接修改安装镜像,也可以制作“制备包”(Provisioning Package)。以导入CA证书信任为例,可以将SCCM生成的Profile导入到WICD向导,生成一个制备安装包。 完成后,导出制备安装包*.ppkg文件,回到运行Windows 10 IoT Core的树莓派,复制到C:\Windows\Provisioning\Packages目录,重启树莓派即可自动执行配置。 上述配置的官方页面在:https://developer.microsoft.com/zh-cn/windows/iot/docs/management 当然,我们不可能只做一个CA证书分发就结束了,能做的事情很多,可以通过CSP(Configuration Service Provider)来完成。是不是听着很耳熟?这里有我很多年前写的两篇随笔: CSP-开篇简介 CSP-SCCM管理Mobile Device 那一年,北京奥运,时光如水,岁月如歌。 不感慨了,有时间写一篇介绍CSP吧。 本文转自HaoHu 51CTO博客,原文链接:http://blog.51cto.com/haohu/1858797,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册