测试人员必备:推荐一款智能测试数据清理AI Skill,支持db、redis、mq等
 > **导读**:前两篇我们推荐了让测试"跑起来"的 api-test-executor、让失败脚本"自己修好"的 api-failure-diagnoser。但跑完、修完之后,环境里堆满了测试数据。 > 今天给大家分享一款**一键清空**测试数据的 skill——**api-testdata-cleaner**。 ## 问题背景 先问大家一个问题:**你的测试环境,有多久没"打扫"过了?** 大概率是这样的—— 1. 1. 商品列表里堆满了"test 商品 001"、"测试商品 abc"; 1. 2. 用户管理里一堆"newuser_001"、"测试账号 xxx"; 1. 3. 订单表里几千条测试订单,查询都变慢了; 1. 4. 想跑同一个用例第二次,因为账号重复直接失败; 1. 5. 多人协作时,并发执行相互污染数据; 1. 6. 手动清理,又怕误删核心配置数据; 1. 7. 不清吧,Flaky Test 越来越多,自动化可信度下降; 1. 8. 最后只能"删库重来",但又影响其他人测试…… 行业统计,**数据污染占 Flaky Test 成因的 60% 以上**——这是接口自动化"随机失败"的头号元凶。 如果以上场景你中了三条以上,那么今天这款 skill,你一定要了解——**api-testdata-cleaner**,一款能让测试数据"一键净空"的 Agent Skill。 ## 一、它是什么? **api-testdata-cleaner 是接口自动化测试的数据清理专家**,你可以把它理解成测试环境的"智能清洁工"。 它的核心定位非常克制——**只做一件事**: **安全、精准、全场景地清理测试产生的脏数据**,实现"执行前数据准备、执行中数据隔离、执行后数据清理"的全流程自动化,让环境始终处于"干净、可控、可复用"的状态。 听起来简单?但它从源头解决了接口自动化"随机失败"的问题。 ## 二、5 大核心卖点 ### ① 三层清理覆盖:DB + Redis + 文件,一个不落 这是它最核心的能力。 测试产生的脏数据,不止数据库一种。api-testdata-cleaner 覆盖三层: |**清理层**|**清理内容**|**清理方式**| | --- | --- | --- | |**数据库(MySQL)**|测试账号、商品、分类、订单等|按主键批量删除、按条件软删除| |**缓存(Redis)**|登录 Token、验证码、临时会话|按 Key 前缀批量删除| |**本地文件**|测试日志、报文、临时数据文件|按目录扫描清理| **为什么三层都要清?** 因为只清数据库,残留的 Redis Token 可能导致登录态错乱;只清缓存,堆积的日志文件可能拖慢环境——**脏数据在哪,它就清到哪**。 ### ② 无损清理:白名单保护,核心数据不误删 这是它最让人放心的能力。 自动清理最怕的是什么?**误删核心数据**。api-testdata-cleaner 用"数据归属标记 + 白名单保护"双重机制,确保只清理测试产生的临时数据: **白名单保护范围**: - • 系统内置的 admin 管理员账号(常驻账号,永不清理) - • 人工预先录入、具备明确业务规则的正式数据 - • 基础配置数据、常驻测试账号 **测试数据识别特征**: - • 内容多存在重复 - • 名称、字段中普遍包含 "test"、"测试" 等标识字样 - • 有明确的"数据归属"标记(来自哪次执行) **存疑处理**:判定测试数据时如果有不确定的,会**主动找人工确认再执行删除**,绝不莽撞行事。 ### ③ 业务适配:不是"删库式"清理 这是它最专业的能力。 普通的清理工具,往往是"DELETE FROM 表"的一刀切——简单粗暴,但会破坏业务关联。api-testdata-cleaner 支持按业务模块定制清理规则: |**业务模块**|**差异化清理规则**| | --- | --- | |**订单模块**|删除测试订单 + 还原库存| |**用户模块**|注销测试用户 + 清空用户购物车| |**商品模块**|删除测试商品 + 清理关联分类| |**购物车**|清空测试账号的购物车记录| **为什么要做业务适配?** 以电商场景为例:如果只删订单不清库存,库存数据会越来越乱;如果只删用户不清购物车,会留下大量孤儿数据——**真正的清理,要顺着业务逻辑走,而不是简单的"删库"**。 ### ④ 生产环境强制拦截:数据安全的最后一道防线 这是它最硬核的能力。 数据清理最怕的是什么?**在生产环境执行了 DELETE**。 api-testdata-cleaner 内置强制拦截机制: - • **严格区分环境**:dev / test / prod 三套环境配置隔离 - • **生产环境强制终止**:识别到 prod 环境,直接终止执行 + 抛出警告 - • **日志全留痕**:每一步操作都保留记录,方便审计追溯 这是**数据安全的最后一道防线**——哪怕配置错了、参数传错了,也不会对生产环境造成任何破坏。 ### ⑤ 独立通用:一份能力,全场景适配 这是它最被低估的设计哲学。 为什么把数据清理独立成 Skill,而不是嵌入到执行或修复 Skill 里? 因为数据清理是**通用能力**,使用场景非常多: - • 执行完测试 → 自动清理 - • 手动排查 Flaky Test → 单独清理 - • CI 每日回归前 → 定时清理 - • 脚本修复重测前 → 重置环境 - • 新人入职熟悉环境 → 按需清理 **如果逻辑写死在执行/修复 Skill 里,这些场景都无法单独调用,只能重复编写代码。** 独立成 Skill 的好处是——**一份能力、全场景适配**,无论何时何地需要清理,一个命令搞定。 ## 三、5 个典型使用场景 **场景一:日常测试后的数据清理** 一轮测试跑完,环境里堆满了测试数据: ```javascript /api-testdata-cleaner 清理数据库中重复的测试数据 ``` 它会自动连接测试环境数据库,几秒钟完成清理,并生成清理报告——**全程无人工介入**。 **场景二:Flaky Test 排查前的环境重置** 某个用例"有时过、有时不过",怀疑是数据污染: ```javascript /api-testdata-cleaner 清理用户模块和订单模块的测试数据 ``` 精准清理指定模块,回到"干净状态"再跑一遍——**快速定位是否是数据问题**。 **场景三:CI 每日回归前的环境初始化** 每天凌晨定时回归,需要先重置环境: ```javascript claude -p "调用 api-testdata-cleaner 技能,参数: env_type=test, clean_scope=all, clean_target=all" \ --permission-mode bypassPermissions \ --output-format json ``` 清理完成后,再触发 api-test-executor 跑全量回归——**保证每次回归的数据基线一致**。 **场景四:脚本修复重测前的数据隔离** 修完一个因为账号重复失败的脚本,想立刻重测: ```javascript /api-testdata-cleaner 清理用户模块测试数据,保留调试日志 ``` 通过 `keep_debug_data=true`,清理脏数据但保留调试日志——**既隔离数据,又方便复盘**。 **场景五:按模块精细化清理** 只想清某个模块,不动其他数据: ```javascript /api-testdata-cleaner 只清理购物车模块的测试数据 ``` 支持按模块精细化控制(user / cart / order / address / all)——**灵活适配各种场景**。 ## 四、实战效果:几秒钟干完半天的活 这是AI 进化社中一个非常典型的实战场景。 **起因**:调用 api-test-executor 执行测试、使用 api-failure-diagnoser 处理脚本故障后,环境中留存了大量测试数据——商品管理里有冗余的测试商品、商品分类里有大量测试分类、用户管理里出现大量测试用户。 比如商品管理中,存在大量冗余的测试商品数据: 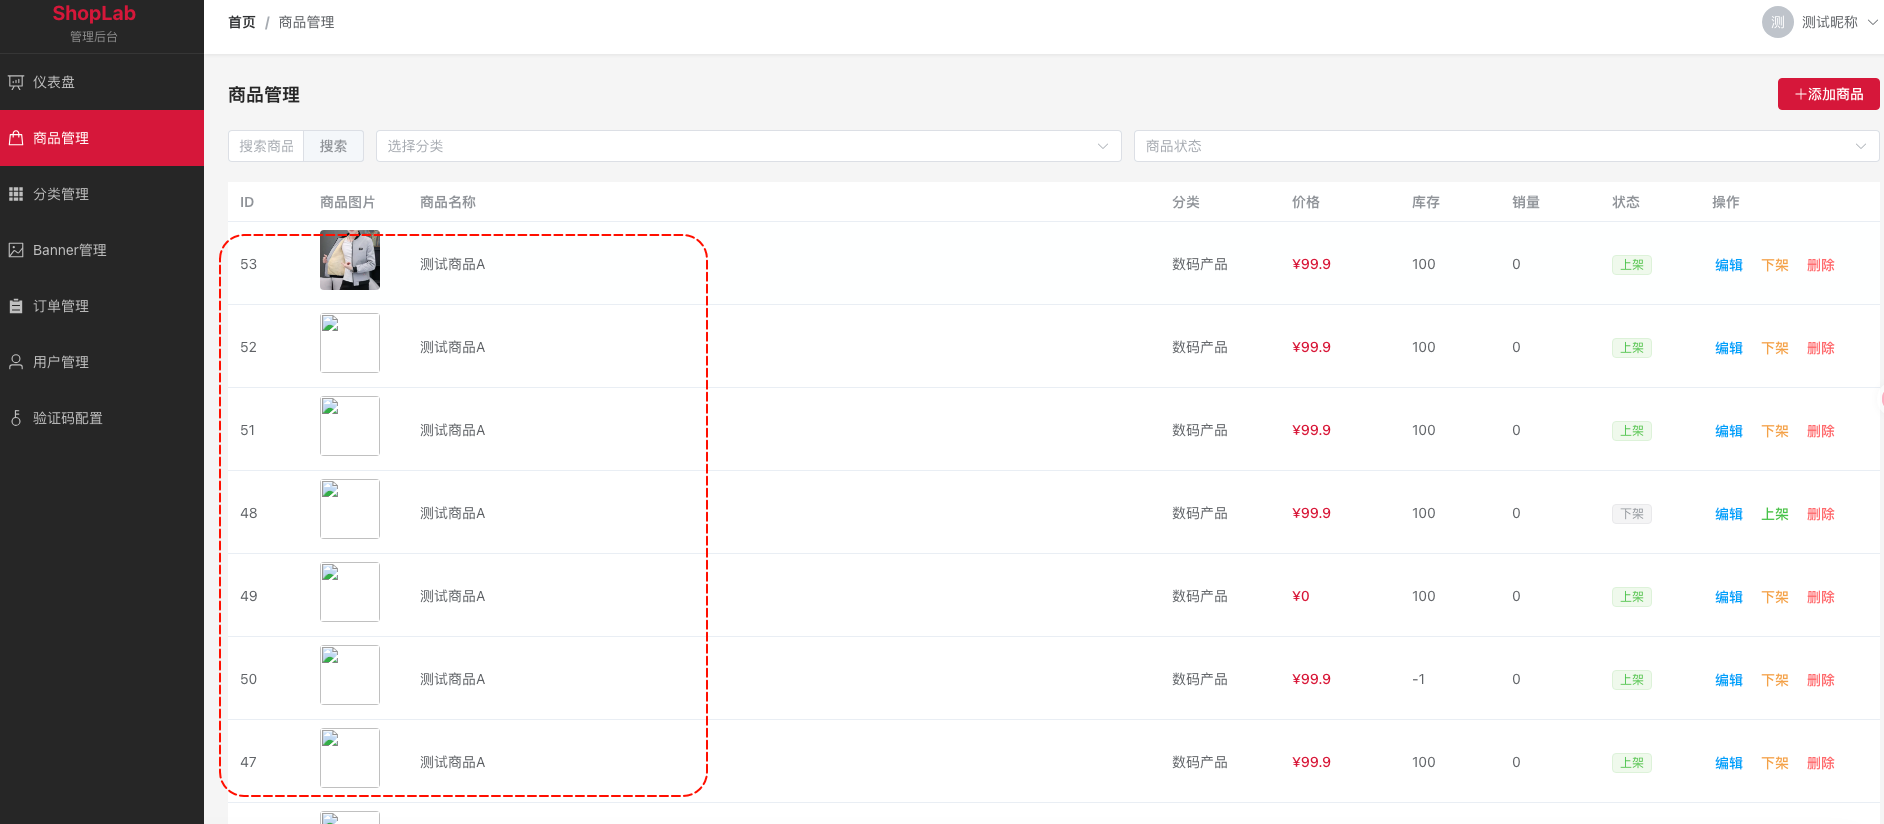 商品分类中,存在大量的测试分类数据: 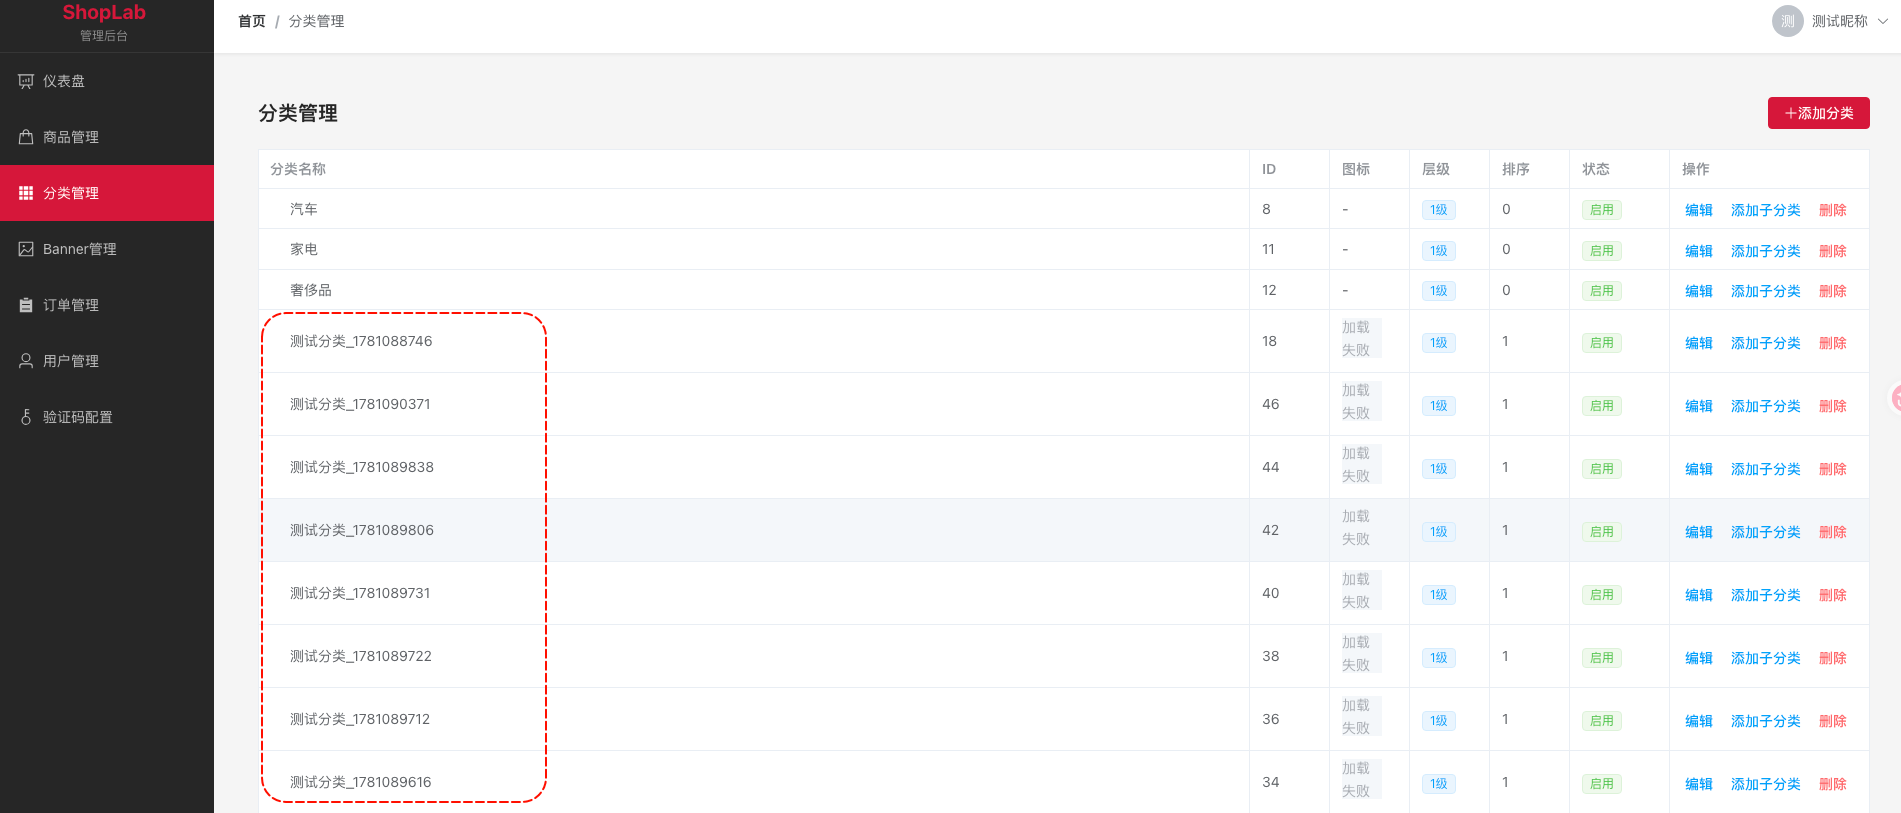 用户管理中出现大量的测试用户数据: 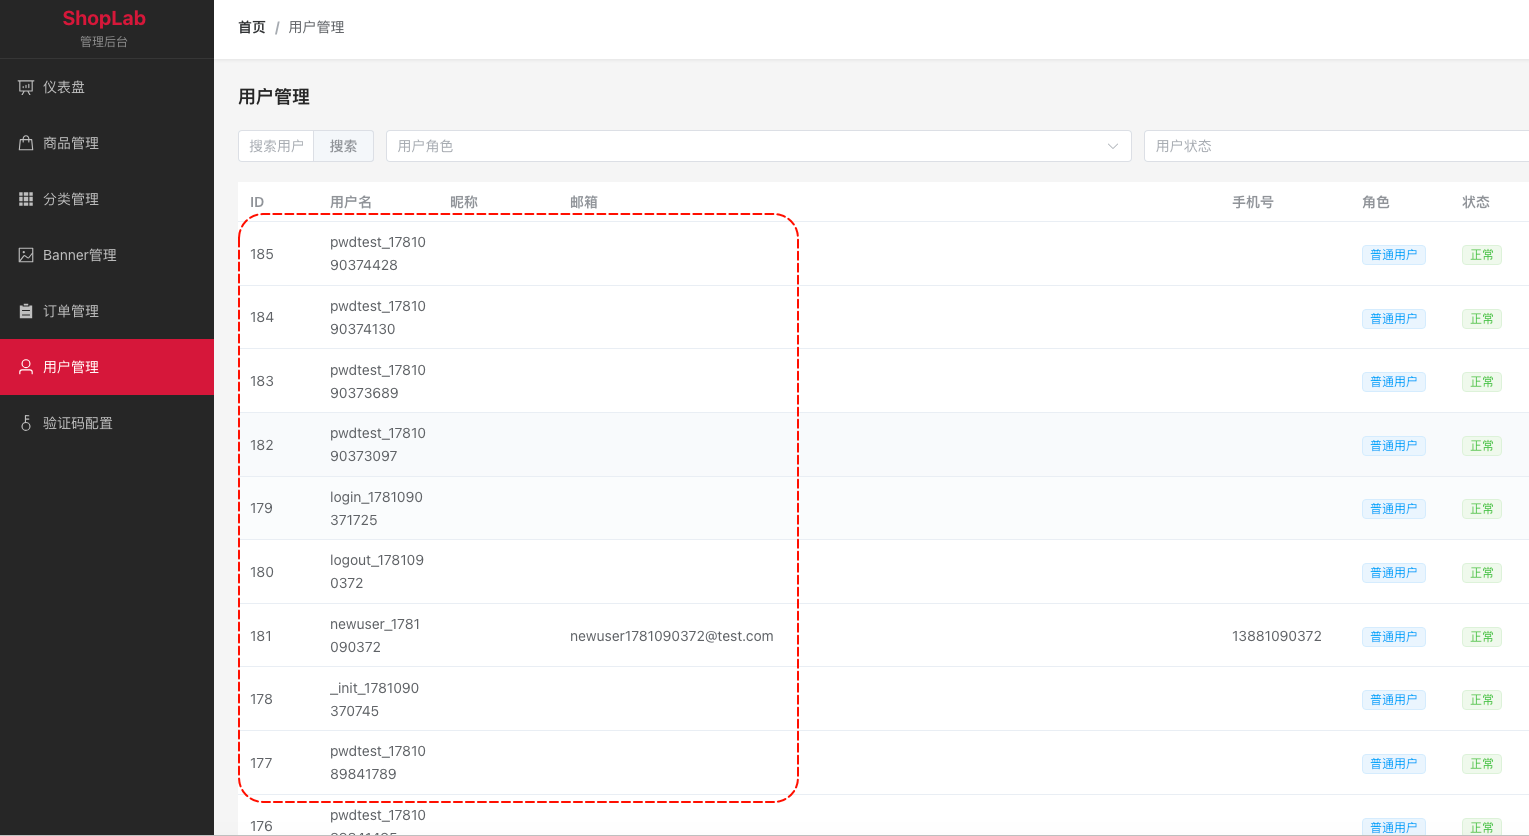 为避免数据堆积、防止数据污染,我希望在每轮接口测试执行和校验完毕后,能自动清理这些测试数据。 但如此同时,会面临一个方案实现决择,针对这个需求,我们应该是选择在现有技能上做改造,还是新建一个专门负责数据清理的独立Skill技能? > **先说结论**:优先考虑新增一个独立的技能,比如 `api-testdata-cleaner`(测试数据自动清理技能),如果有需要,还可以通过**调用链联动**,在接口执行、故障修复完成后自动触发清理; 为什么?原因其实很简单,我们可以先对比一下这两个方案的优劣区别。 方案一:在现有 Skill 中嵌入清理逻辑 如果在现有 Skill 中嵌入清理逻辑,也就是把数据库、缓存、临时账号 / 订单 / 购物车等数据清理代码,直接写到 `api-test-executor` 或 `api-failure-diagnoser` 内部。虽然实现简单,短期开发成本低,单次执行也不需要额外调用其它技能,但: - • 违反了单一职责原则,我们前面所有的skill技能设计,都遵循一个原则:**一个 Skill 只做一件事**: - • `api-test-executor`:只负责**用例调度、接口执行、结果收集**; - • `api-failure-diagnoser`:只负责**故障诊断、脚本修复**; 如果强行嵌入数据清理,会让单个技能职责臃肿,代码耦合严重,后续维护、修改逻辑时容易牵一发而动全身。 - • 复用性极差,测试数据清理是**通用能力**: - • 单条用例调试需要清数据; - • 全量回归前需要初始化环境; - • 定时任务执行前需要重置; - • 问题排查前也需要清理脏数据。 如果逻辑写死在执行 / 修复技能里,其他场景无法单独调用清理能力,只能重复编写代码,产生冗余。 - • **灵活性不足,无法按需控制**,实际测试中存在差异化需求: - • 部分场景:执行完**必须立刻清数据**(常规回归); - • 部分场景:执行完**保留数据用于问题排查**(故障复盘、BUG 定位); - • 部分场景:只清理某一个模块数据(如仅清空购物车,保留用户账号)。 内嵌逻辑只能 “一刀切”,无法灵活配置 方案二:新增独立 api-testdata-cleaner 数据清理 Skill 开发一个独立通用的数据清理技能,可以让其专门负责**数据库、Redis、临时文件、测试账号、业务临时单据(订单 / 购物车 / 优惠券)** 等全量 / 指定范围测试数据清理、环境重置工作。 虽然需要额外开发一个新 Skill,短期多一点开发工作量,但**长期收益远大于成本**,具体表现在几方面: - • **循单一职责,架构更标准**: - • 延续前期拆分 Skill 的设计思路,各司其职:执行 → 诊断修复 → 数据清理,链路清晰,每个模块功能纯粹,更符合企业级自动化工程规范。 - • **高复用,全场景适配**,该技能可**独立调用**,也可被其他技能联动调用: - • 场景 1:接口执行完成后 → 自动调用清理; - • 场景 2:手动排查数据污染问题 → 单独执行清理 Skill; - • 场景 3:CI 流水线每日回归前 → 先执行清理,再跑用例; - • 场景 4:脚本修复完成重测前 → 先重置环境数据。 - • **配置灵活,支持精细化管控**,可在 Skill 入参中定义规则,按需清理: - • 支持全局清理 / 按业务模块清理(用户 / 订单 / 购物车分离清理); - • 支持 “执行后自动清理” / “手动触发清理” 两种模式; - • 支持 “调试模式保留数据” / “正式回归强制清理” 开关。 - • **可独立迭代扩展** 后续新增数据表、缓存、第三方临时数据,只需要更新 `api-data-cleaner` 这一个技能,不用改动整条链路的核心代码,迭代成本极低。 测试验证效果 用口语化的方式,直接输入要清理的内容和范围 ```javascript /api-testdata-cleaner 清理数据库中重复的测试数据 ``` 接收到提示词后,会先连接当前测试环境(被测项目的环境配置),校验环境信息是否连接成功,然后开始执行数据库测试数据清理操作。 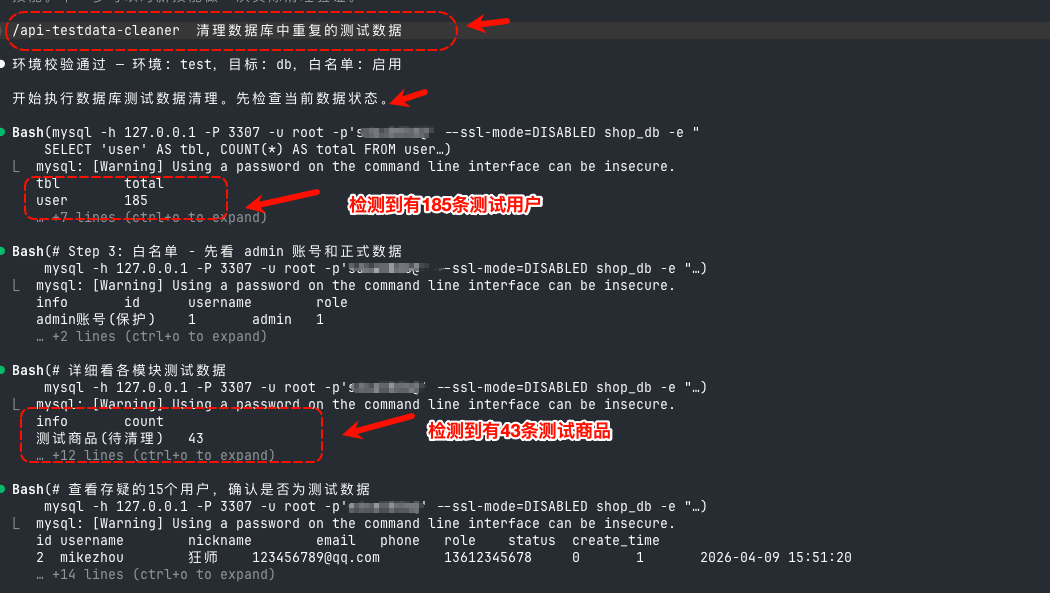 最终效果,我还是挺满意的,该删除的测试数据全部都删除了,之前由我人工创建的数据也全部保留下来了(没有被误删),而且整个操作几乎是在几秒钟内完成,期间没有任何人工介入的动作。 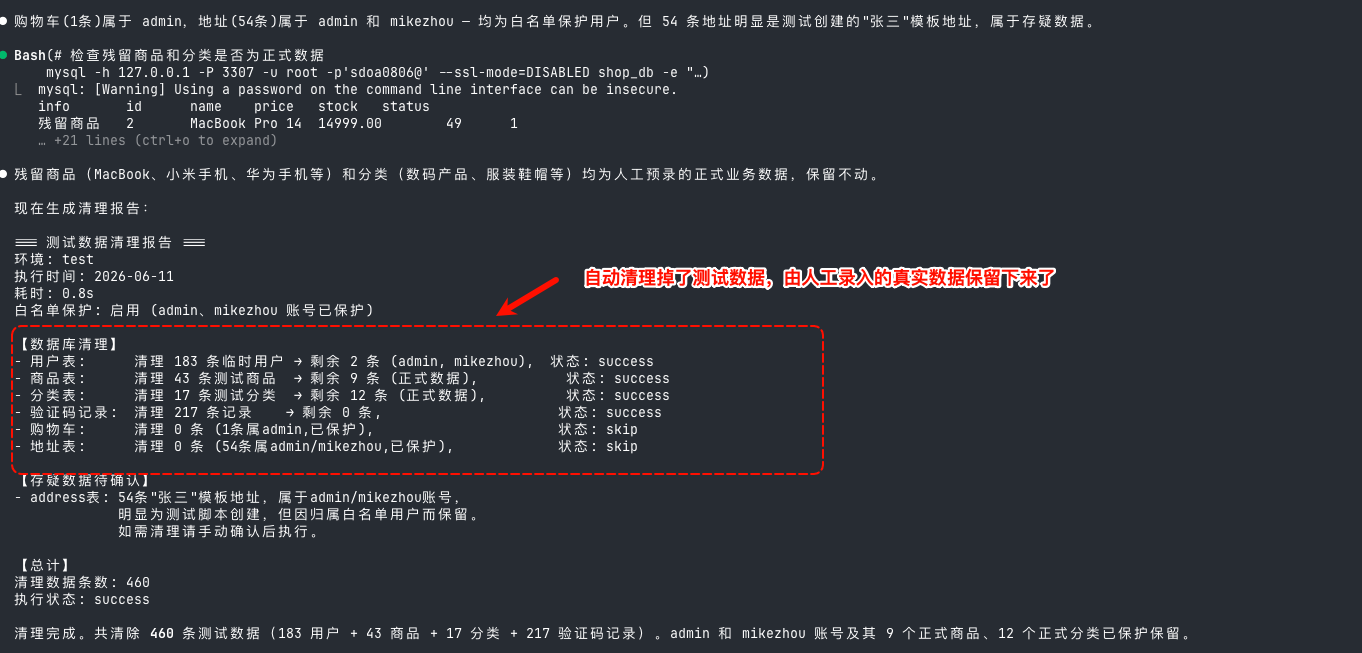 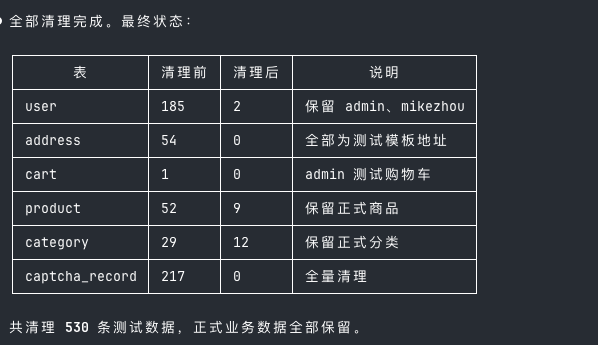 除了控制台显示清理结果外,还会单独生成一份markdown格式的数据清理报告,方便后续留存: 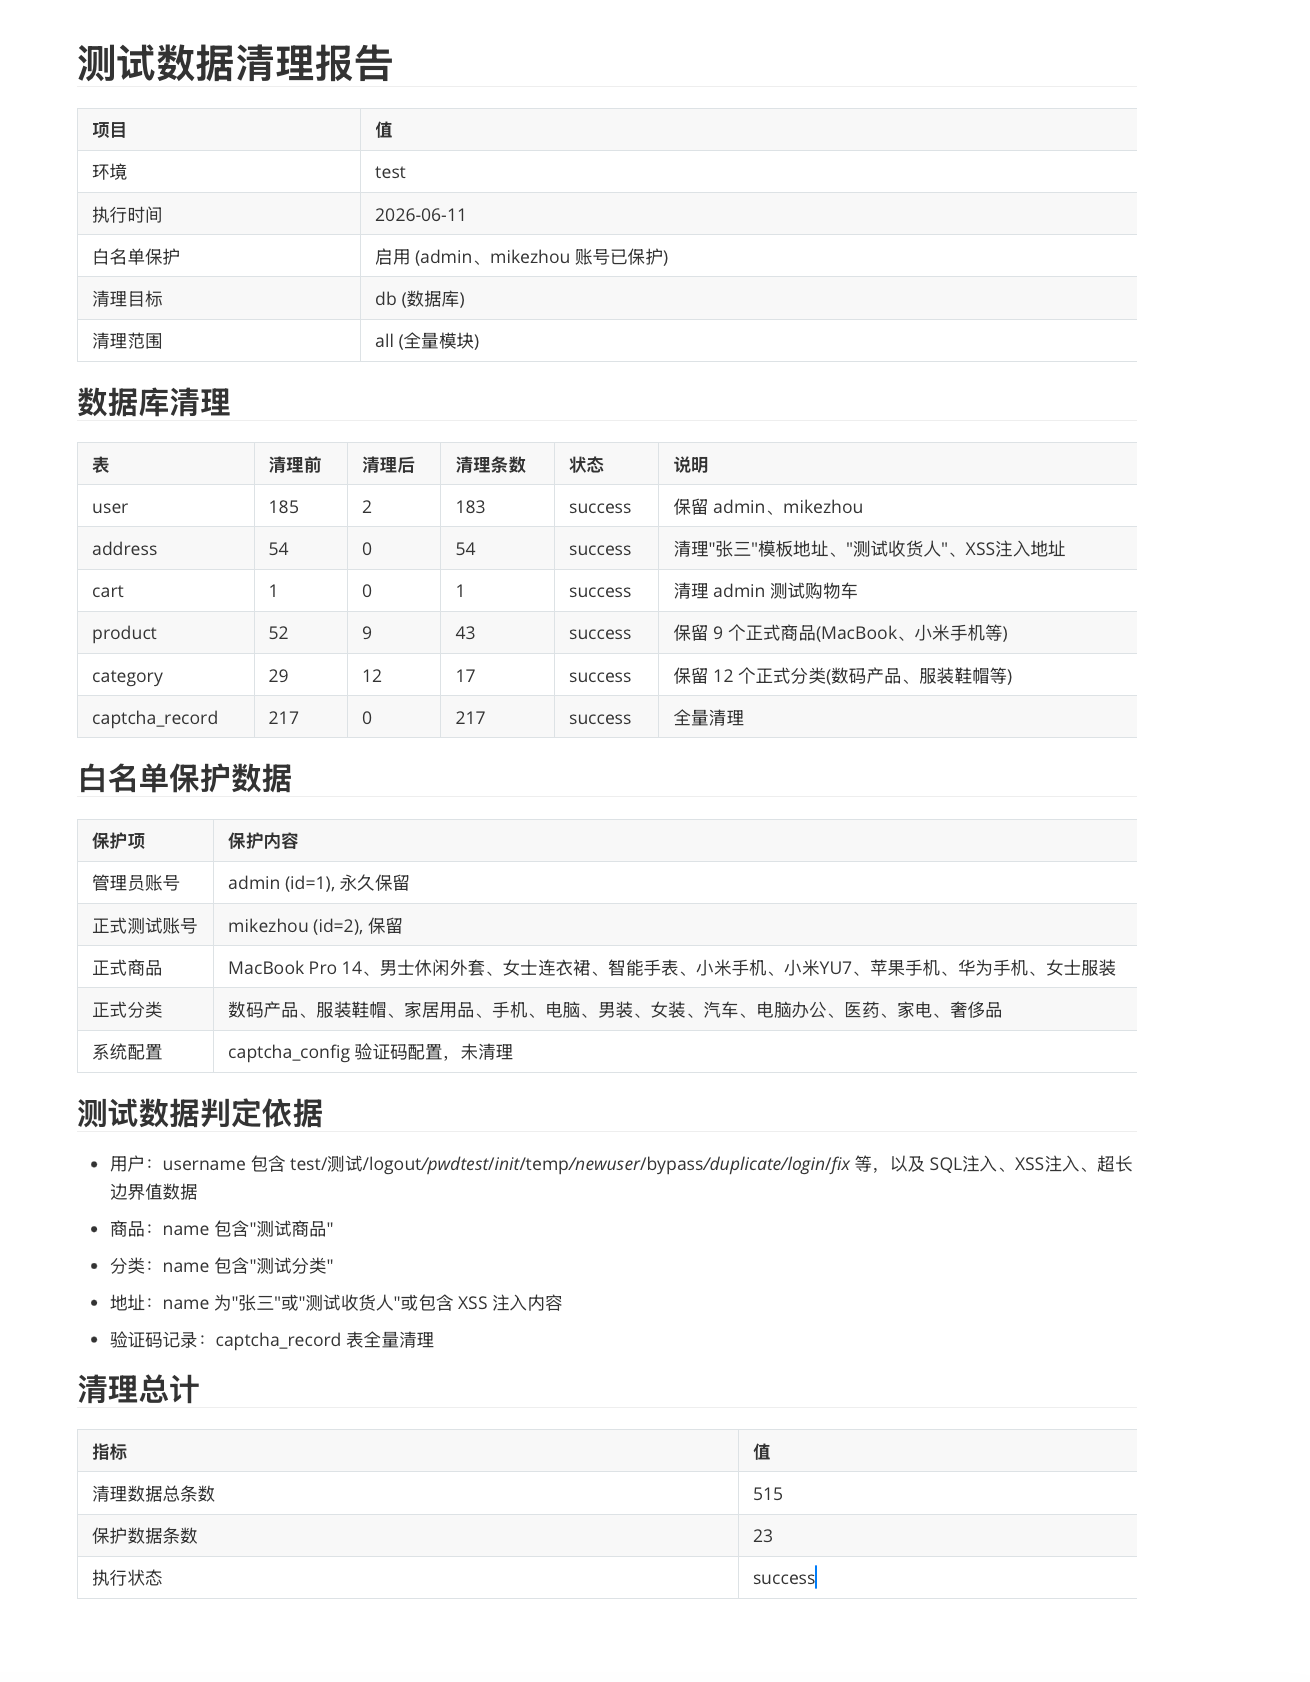 数据清理完成后,我们打开被测项目前端页面,在前端页面上,比之前干净多了(页面上所有的测试数据全部被清理掉了) 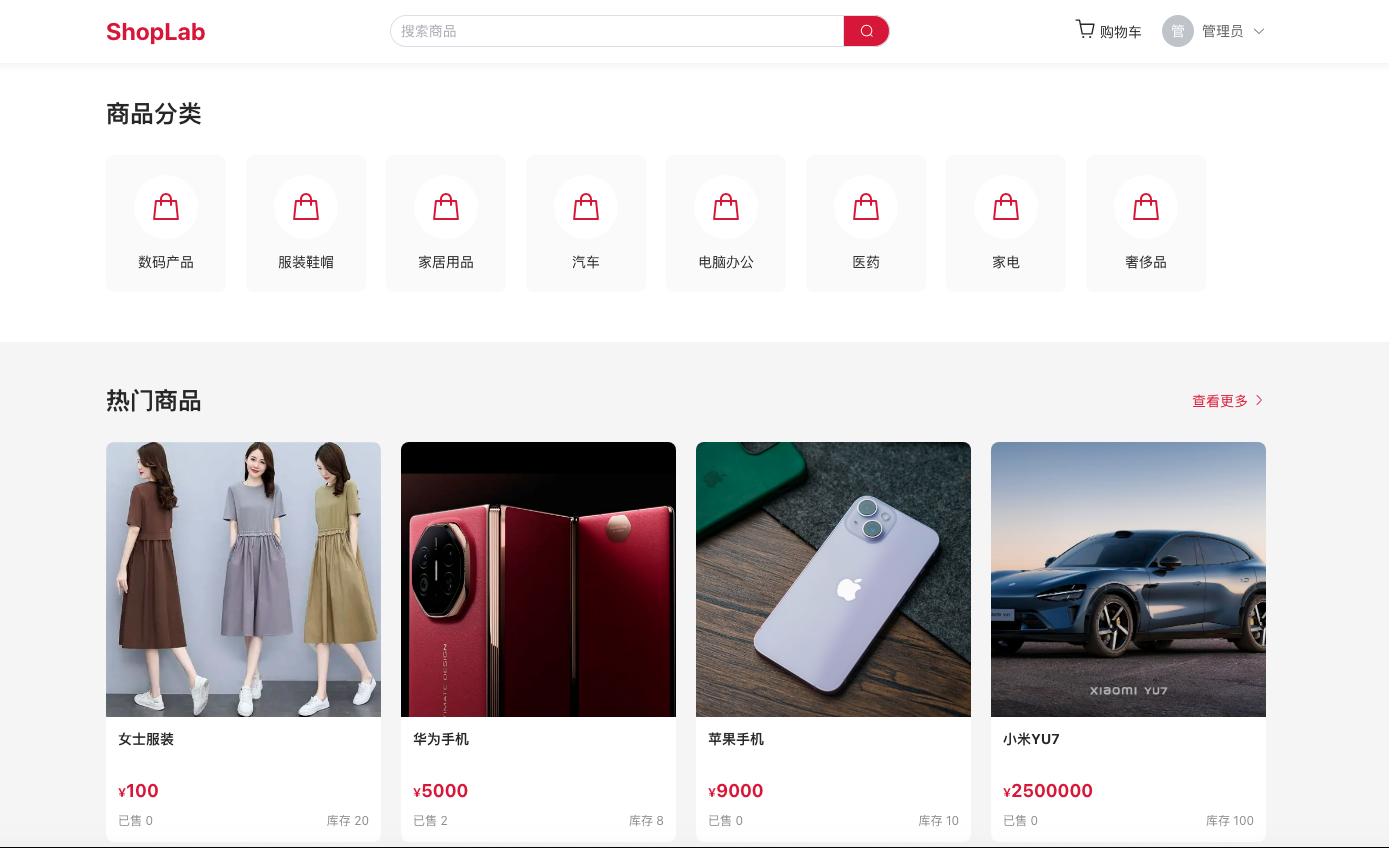 **执行过程**: 1. 1. 自动连接测试环境数据库,校验环境信息 1. 2. 识别测试数据特征(含 test、测试等标识) 1. 3. 应用白名单保护规则 1. 4. 分模块执行清理 1. 5. 生成清理报告 **最终效果**: - • ✅ 该删除的测试数据全部删除 - • ✅ 人工创建的数据全部保留(没有被误删) - • ✅ 整个操作几秒钟完成 - • ✅ 全程无人工介入 - • ✅ 单独生成 markdown 格式的数据清理报告,方便留存 > **温馨提醒**:如果在新开会话中调用,需要提供被测项目的路径,这样它才能读取到项目配置文件。在连续会话中,它会自动继承上下文的项目路径。 ## 五、适合谁用? **强烈推荐**: - • **接口自动化测试工程师**:日常清理脏数据、解决 Flaky Test - • **测试开发工程师**:搭建团队环境管理能力、CI 流水线 - • **全栈测试工程师**:希望降低环境维护门槛 - • **测试团队负责人**:希望提升环境稳定性、降低 Flaky Test 困扰 **特别适合**: - • Flaky Test 频发、数据污染严重的团队(立竿见影) - • 多人协作、共享测试环境的团队(避免数据互相污染) - • CI/CD 流水线需要定时重置环境的团队 - • 测试数据量大、手动清理成本高的团队 **不太适合**: - • 还没有自动化测试的团队(没数据可清) - • 测试环境与生产环境共用的团队(建议先做好环境隔离) ## 六、如何获取和安装? `api-testdata-cleaner` GitHub 仓库地址: ```javascript git clone git@github.com:xxx/skills.git ``` **安装到 WorkBuddy**: ```javascript cp -r skills/api-testdata-cleaner ~/.workbuddy/skills/ ``` **安装到 Claude Code**: ```javascript cp -r skills/api-testdata-cleaner ~/.claude/skills/ ``` 安装完成后,在你的 AI 工具里直接说: > "/api-testdata-cleaner 清理数据库中重复的测试数据" 就可以开始用了。 > **小贴士**:建议把它和 api-test-executor、api-report-generator 串起来用——通过 `api-pipeline-scheduler` 一键编排「执行 → 清理 → 报告」全流程。 ## 写在最后 测试行业有个共识:**"Flaky Test 是自动化最大的敌人。"** 而 Flaky Test 最大的源头,就是数据污染(占比 60% 以上)。 api-testdata-cleaner 解决的就是这个源头——**让测试环境始终干净、可控、可复用**。 它不会替代你的环境管理规范,不会替代你的数据隔离策略,更不会替代你对生产环境的敬畏。它只是把你从**手动 DELETE、担心误删、反复重置环境**的焦虑中解放出来,让你把精力聚焦在更有价值的事情上——**测试策略优化、Flaky 根因深度分析、自动化体系持续改进**。 需要强调的是:**数据清理涉及生产安全,任何自动化能力都必须建立严格的保护机制**。白名单、环境拦截、日志留痕——这三道防线,缺一不可。 **而这,正是 AI 赋能测试的真正意义**——不是替代人,而是让人更安心。 如果你也厌倦了每天手动清理测试数据,强烈推荐试试这款 skill。