首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10011篇文章
优秀的个人博客,低调大师

负载均衡SLB百问FAQ

介绍 阿里云负载均衡SLB(Server Load Balancer)是对多台云服务器(ECS)进行流量分发的云服务。负载均衡可以通过流量分发扩展应用系统对外的服务能力,通过消除单点故障提升应用系统的可用性。 阿里云SLB采用全冗余设计,无单点,支持同城容灾。搭配DNS可实现跨地域容灾,可用性高达99.95%。和传统硬件负载均衡相比,使用阿里云SLB成本可下降60%。基于LVS的四层负载均衡具备接近于实时防御的能力。结合云盾,可提供5G以下的防DDOS攻击能力。采用Tengine作为负载均衡基础模块的七层负载均衡具备多维度的CC攻击防御能力。 本文为大家整理了关于负载均衡SLB的系列问题供大家查阅参考。 负载均衡常见问题负载均衡支持哪些调度算法?https://yq.aliyun.com/ask/58892 公网负载均衡和私网负载均衡的区别是什么?https://yq.aliyun.com/ask/58895 是否可以修改负载均衡实例类型?https://yq.aliyun.com/ask/58896 负载均衡分配的IP是否为独占?https://yq.aliyun.com/ask/58900 负载均衡是否支持端口跳转?https://yq.aliyun.com/ask/58901 ping负载均衡的IP和ping负载均衡后端ECS的IP有什么区别?https://yq.aliyun.com/ask/58902 负载均衡是否依赖外网带宽?https://yq.aliyun.com/ask/58904 禁用公网网卡是否影响负载均衡服务?https://yq.aliyun.com/ask/58905 为什么负载均衡服务地址会连接访问超时?https://yq.aliyun.com/ask/58915 负载均衡各监听连接超时时间是多少?https://yq.aliyun.com/ask/58914 负载均衡均衡的是什么?https://yq.aliyun.com/ask/58907 如何避免负载均衡服务本身的故障问题?https://yq.aliyun.com/ask/58906 负载均衡监控数据与实际账单数据为什么不同?https://yq.aliyun.com/ask/58913 为什么调用API修改带宽失败?https://yq.aliyun.com/ask/58912 如何查询负载均衡带宽和流量使用情况?https://yq.aliyun.com/ask/58911 为什么负载均衡压缩失败?https://yq.aliyun.com/ask/58910 为什么每个连接达不到带宽峰值?https://yq.aliyun.com/ask/58909 为什么请求不均衡?https://yq.aliyun.com/ask/58908 后端服务器ECS常见问题 ECS设置权重的作用是什么?https://yq.aliyun.com/ask/58925 同一组ECS可建多个网站并同时用负载均衡吗?https://yq.aliyun.com/ask/58924 使用负载均衡服务,ECS是否需要进行特殊配置?https://yq.aliyun.com/ask/58923 为什么有10或100开头的IP在频繁访问ECS?https://yq.aliyun.com/ask/58922 ECS在接入负载均衡服务前添加了白名单,对负载均衡服务有影响么?https://yq.aliyun.com/ask/58921 后端ECS为什么访问不了负载均衡服务?https://yq.aliyun.com/ask/58920 可以使用不同地域的ECS实例作为后端服务器么?https://yq.aliyun.com/ask/58919 后端ECS的操作系统是否可以不同?https://yq.aliyun.com/ask/58918 负载均衡运行中是否可调整ECS数量?https://yq.aliyun.com/ask/58917 负载均衡实例最多支持添加多少ECS实例?https://yq.aliyun.com/ask/58916 后端ECS访问使用HTTP1.0是否支持chunked transfer传输编码?https://yq.aliyun.com/ask/58927 ECS上没有配置压缩,为什么从负载均衡返回的响应(response)却被压缩了?https://yq.aliyun.com/ask/58926 健康检查常见问题 为如何对负载均衡健康检查异常报错进行排查?https://yq.aliyun.com/ask/58943 为什么业务本身没有异常但是监控检查显示异常?https://yq.aliyun.com/ask/58942 负载均衡服务TCP端口健康检查成功,为什么在后端业务日中出现网络连接异常信息?https://yq.aliyun.com/ask/58941 负载均衡因后端数据库故障导致健康检查失败,如何处理?https://yq.aliyun.com/ask/58940 为什么负载均衡后端服务器频繁收到UA为KeepAliveClient的请求?https://yq.aliyun.com/ask/58939 健康检查是否会消耗系统资源?https://yq.aliyun.com/ask/58938 出现502 Bad Gateway错误提示并且健康检查提示异常,为什么?https://yq.aliyun.com/ask/58937 为什么健康检查监控频率与web日志记录不一致?https://yq.aliyun.com/ask/58936 HTTP监听向后端ECS执行健康检查的IP地址是多少?https://yq.aliyun.com/ask/58934 HTTP监听向后端ECS执行健康检查使用的方法是什么?https://yq.aliyun.com/ask/58933 ECS权重设置为0对健康检查有什么影响?https://yq.aliyun.com/ask/58932 TCP监听服务如何选择健康检查方式?https://yq.aliyun.com/ask/58931 是否可以关闭健康检查?https://yq.aliyun.com/ask/58930 健康检查的参数配置是否有相对合理的推荐值?https://yq.aliyun.com/ask/58929 健康检查的原理是什么?https://yq.aliyun.com/ask/58928 HTTPS/HTTP监听常见问题 为什么HTTP监听访问正常但HTTPS监听打开网址不加载样式?https://yq.aliyun.com/ask/58947 为什么访问域名发现在HTTP的header头部多了一个字段Transfer-Encoding: chunked?https://yq.aliyun.com/ask/58946 为什么请求经过七层负载均衡转发后,后端ECS在响应头中的某些参数会被删除?https://yq.aliyun.com/ask/58944 HTTP/HTTPS监听是否支持WebSocket/SSL WebSocket的应用协议?https://yq.aliyun.com/ask/58970 一个请求通过负载均衡到达后端服务器,如果客户端在未收到后端服务器的回复前主动断开和负载均衡的连接,负载均衡会同时断开和后端服务器的连接么?https://yq.aliyun.com/ask/58969 后端服务器ECS能否获取客户端访问HTTP/HTTPS监听的协议版本?https://yq.aliyun.com/ask/58966 HTTP/HTTPS监听访问后端ECS服务器HTTP协议的版本是什么?https://yq.aliyun.com/ask/58964 为什么直接访问ECS可以正常使用的一些功能但通过负载均衡HTTP监听访问后不正常了?https://yq.aliyun.com/ask/58963 使用负载均衡HTTP监听访问后端ECS和直接访问后端ECS有什么不同?https://yq.aliyun.com/ask/58962 HTTPS页面为什么在浏览器地址栏提示不安全?https://yq.aliyun.com/ask/58961 HTTP协议访问如何跳转HTTPS协议?https://yq.aliyun.com/ask/58960 HTTPS监听是否支持SNI?https://yq.aliyun.com/ask/58959 HTTPS监听可以上传包含DH PARAMETERS字段的证书么?https://yq.aliyun.com/ask/58958 HTTPS session ticket的保持时间是多久?https://yq.aliyun.com/ask/58957 为什么HTTPS协议实际产生的流量会比账单流量多一些?https://yq.aliyun.com/ask/58956 负载均衡HTTPS支持哪些SSL协议版本?https://yq.aliyun.com/ask/58955 一个监听可绑定多少个HTTPS证书?https://yq.aliyun.com/ask/58954 添加证书时,为什么报错KeyEncryption?https://yq.aliyun.com/ask/58953 一个账号可以上传多少个证书?https://yq.aliyun.com/ask/58952 负载均衡上如何使用pfx格式的证书?https://yq.aliyun.com/ask/58951 负载均衡是否支持keytool创建的证书?https://yq.aliyun.com/ask/58950 负载均衡支持哪些类型的证书?https://yq.aliyun.com/ask/58949 HTTPS监听使用什么端口?https://yq.aliyun.com/ask/58948 负载均衡支持域名、URL转发功能适用于那些场景?https://yq.aliyun.com/ask/58990 每个监听可以添加多少条转发规则?https://yq.aliyun.com/ask/58992 如何实现负载均衡按域名、URL转发?https://yq.aliyun.com/ask/58991 可以同时设置实例维度上的“后端服务器”、监听维度上的“虚拟服务器组”和“域名、URL转发规则”吗?https://yq.aliyun.com/ask/58993 如果同时添加了“后端服务器”、“虚拟服务器组”和“域名、URL转发规则”,那么其判断的顺序是怎么样的?https://yq.aliyun.com/ask/58994 会话保持常见问题 会话保持的作用是什么?https://yq.aliyun.com/ask/58995 如何开启会话保持?https://yq.aliyun.com/ask/58996 负载均衡支持什么类型的会话保持?https://yq.aliyun.com/ask/58997 会话保持可设置哪种类型的cookie?https://yq.aliyun.com/ask/58998 是否支持针对不同的域名配置不同的会话保持规则?https://yq.aliyun.com/ask/59049 cookie的超时时间应设置为多少?https://yq.aliyun.com/ask/59050 如何查看会话保持字串?https://yq.aliyun.com/ask/59051 为什么有时候会话保持失败?https://yq.aliyun.com/ask/59052 如何使用Linux curl测试负载均衡会话保持?https://yq.aliyun.com/ask/59053 计费常见问题 负载均衡如何计费?https://yq.aliyun.com/ask/59054 负载均衡是否对入流量计费?https://yq.aliyun.com/ask/59055 健康检查产生的流量是否会被计费?https://yq.aliyun.com/ask/59056 ECS加入负载均衡后端服务器资源池是否影响其计费?https://yq.aliyun.com/ask/59057 攻击流量是否会被计费?https://yq.aliyun.com/ask/59058 载均衡实例的所有后端ECS都停止,或者没有挂载ECS,是否会被计费?https://yq.aliyun.com/ask/59059

优秀的个人博客,低调大师

MaxCompute百问集锦(持续更新)

大数据计算服务(MaxCompute,原名 ODPS,https://www.aliyun.com/product/odps)是一种快速、完全托管的 GB/TB/PB 级数据仓库解决方案。MaxCompute 向用户提供了完善的数据导入方案以及多种经典的分布式计算模型,能够更快速的解决用户海量数据计算问题,有效降低企业成本,并保障数据安全。同时,大数据开发套件和MaxCompute关系紧密,大数据开发套件为 MaxCompute 提供了一站式的数据同步,任务开发,数据工作流开发,数据管理和数据运维等功能,可以参见大数据开发套件简介来对其进行深入了解。本文为大家整理了关于MaxCompute的系列问题供大家查阅参考。 产品咨询 MaxCompute是什么,怎么用?https://yq.aliyun.com/ask/52394 MaxCom

优秀的个人博客,低调大师

某小公司:MySQL连环问

大家好,我是yes。 MySQL 面试题开始要更新啦! 请接招。 你们公司数据库有备份的吧? 我:有的,因为单点故障的情况不可避免,所以我们公司有主从。面试官:那你知道主备、主从、主主有什么区别? 主备就是:主机和备机。 备机是不干活的,也就是不对外提供服务,只是默默地在同步主机的数据,然后等着某一天主机挂了之后,它取而代之! 至于切换的话主要有两种方式: 人工切换,得知主机挂了之后手动把备机切成主机,缺点就是慢。 利用 keepalived 或者自己写个脚本来作监控,然后自动切换。 主从就是主机和从机。 从机和备机的区别在于,它是对外提供服务的,一般而言主从就是读写分离,写请求指派到主机,读请求指派到从机。 主主就是两个都是主机 一般情况下都不会有主主的架构。 当同时有两个写请求达到分别打到两个主库同一张表的时候,则会同时创建一条记录,这条记录的 ID 是一样的,这样数据同步之后其中有一条就会被覆盖了,这会出问题的。 为什么要读写分离啊? 读写分离就是读操作和写操作从以前的一台服务器上剥离开来,将主库压力分担一些到从库。 本质上是因为访问量太大,主库的压力过大,单机数据库无法支撑并发读写。 然后一般而言读的次数远高于写,因此将读操作分发到从库上,这就是常见的读写分离。 读写分离还有个操作就是主库不建查询的索引,从库建查询的索引。 因为索引是需要维护的,比如你插入一条数据,不仅要在聚簇索引上面插入,对应的二级索引也得插入,修改也是一样的。 所以将读操作分到从库了之后,可以在主库把查询要用的索引删了,减少写操作对主库的影响。 你们读写分离是用中间件的还是代码封装的? 代码封装。 讲白了就是代码层面抽出一个中间层,由中间层来实现读写分离和数据库连接。 就是搞了个代理类,对外暴露正常的读写接口,里面封装了逻辑,将读操作指向从库的数据源,写操作指向主库的数据源。 优点:简单,并且可以根据业务定制化变化,随心所欲。 缺点:如果数据库宕机了,发生主从切换了之后,就得修改配置重启。如果系统是多语言的话,需要为每个语言都实现一个中间层代码,重复开发。 中间件 一般而言是独立部署的系统,客户端与这个中间件的交互是通过 SQL 协议的。 所以在客户端看来连接的就是一个数据库,通过 SQL 协议交互也可以屏蔽多语言的差异。 缺点就是整体架构多了一个系统需要维护,并且可能成为性能瓶颈,毕竟交互都需要经过它中转。 常见的开源数据库中间件有:官方的MySQL-Proxy、360的Atlas、Mycat 等。 MySQL 主从同步机制你知道吗? 主从同步主要依赖的就是 binlog,MySQL 默认是异步复制,具体流程如下: 主库: 接受到提交事务请求 更新数据 将数据写到binlog中 给客户端响应 推送binlog到从库中 从库: 由 I/O 线程将同步过来的 binlog 写入到 relay log 中。 由 SQL 线程从 relay log 重放事件,更新数据 给主库返回响应。 用一句话概括一下:主库提交事务会写binlog,会由一个 dump 线程推送给从库,从库接受之后会有一个I/O线程将其写到 relay log 中,慢慢消化,由 SQL 线程来重放更新数据。 异步复制有数据丢失风险,例如数据还未同步到从库,主库就给客户端响应,然后主库挂了,此时从库晋升为主库的话数据是缺失的。 所以有同步复制,主库需要将 binlog 复制到所有从库,等所有从库响应了之后才会给客户端响应,这样的话性能很差,一般不会选择同步复制。 MySQL 5.7 之后搞了个半同步复制,有个参数可以选择“成功同步几个从库就返回响应。” 比如一共有 3 个从库,我参数配置 1,那么只要有一个从库响应说复制成功了,主库就直接返回响应给客户端,不会等待其他两个从库。 这样的话性能就比较好,并且数据可靠性也增强了,只有当那个从库和主库同时都挂了,才会缺失数据。 主从同步延迟怎么处理啊? 从上图的流程就可以得知,延迟是必然存在的。 延迟过大的话就有可能出现一个用户刚注册,然后登陆报该用户不存在的.... 因为数据是写到主库中的,查询走从库有可能还未来同步完毕,导致查不到这个用户。 这就非常不友好了。 常见解决方式有以下几种: 二次查询。如果从库查不到数据,则再去主库查一遍,由 API 封装即可,算是一个兜底策略,比较简单。不过等于读的压力又转移到主库身上了,如果有不法分子估计搞一下必定查不到的查询,这就难受了。 强制将写之后立马读的操作转移到主库上。这种属于代码写死了,比如一些写入之后立马查询的操作,就绑定在一起,写死都走主库。不推荐,太僵硬了。 关键业务读写都走主库,非关键还是读写分离。比如上面我举例的用户注册这种,可以读写主库,这样就不会有登陆报该用户不存在的问题,这种访问量频次应该也不会很多,所以看业务适当调整此类接口。 最后 暂时就更新到这儿了~ 本来MySQL面试题挺早之前就要开始写的,后来构思着就感觉索引那块有点想法,所以就先写故事去了~ 就是这两篇: 我叫小M,立志建立MySQL帝国。 我是小M,老板不当人子 故事是连贯的,还没完结,面试题也同步更新,排的满满当当~ 对了,如果有遇到关于 MySQL 刁钻的面试题,可以联系我,也可以直接留言,我会收录并尽力解答 。 欢迎关注我的公众号【yes的练级攻略】,更多硬核文章等你来读。 我是yes,从一点点到亿点点,我们下篇见~ 本文分享自微信公众号 - yes的练级攻略(yes_java)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

关于 Kubernetes 规划的灵魂 n 问

作者 | 易立阿里云资深技术专家 导读:Kubernetes 已经成为企业新一代云 IT 架构的重要基础设施,但是在企业部署和运维 Kubernetes 集群的过程中,依然充满了复杂性和困扰。 阿里云容器服务自从 2015 年上线后,目前托管着上万的 K8s 集群来支撑全球各地的客户。我们对客户在规划集群过程中经常会遇见的问题,进行一些分析解答。试图缓解大家的“选择恐惧症”。 如何选择Worker 节点实例规格? 裸金属还是虚拟机? 在 Dimanti 2019 年的容器调查报告中,对专有云用户选择裸金属服务器来运行容器的主要原因进行了分析。 选择裸金属服务器的最主要原因(超过 55%)是:传统虚拟化技术 I/O 损耗较大;对于 I/O 密集型应用,裸金属相比传统虚拟机有更好的性能表现; 此外近 36% 的客户认为:裸金属服务器可以降低成本

优秀的个人博客,低调大师

BAT技术面dubbo还能这么问?

1、为什么要用 Dubbo? 随着服务化的进一步发展,服务越来越多,服务之间的调用和依赖关系也越来越复杂,诞生了面向服务的架构体系(SOA),也因此衍生出了一系列相应的技术,如对服务提供、服务调用、连接处理、通信协议、序列化方式、服务发现、服务路由、日志输出等行为进行封装的服务框架。就这样为分布式系统的服务治理框架就出现了,Dubbo 也就这样产生了。 2、Dubbo 的整体架构设计有哪些分层? 接口服务层(Service): 该层与业务逻辑相关,根据 provider 和 consumer 的业务设计对应的接口和实现配置层(Config): 对外配置接口,以 ServiceConfig 和 ReferenceConfig 为中心服务代理层(Proxy): 服务接口透明代理,生成服务的客户端 Stub 和 服务端的Skeleton,以 ServiceProxy 为中心,扩展接口为 ProxyFactory服务注册层(Registry): 封装服务地址的注册和发现,以服务 URL 为中心,扩展接口为 RegistryFactory、Registry、RegistryService路由层(Cluster): 封装多个提供者的路由和负载均衡,并桥接注册中心,以 Invoker为中心,扩展接口为 Cluster、Directory、Router 和 LoadBlancce监控层(Monitor):RPC 调用次数和调用时间监控,以 Statistics 为中心,扩展接口为 MonitorFactory、Monitor 和 MonitorService远程调用层(Protocal): 封装 RPC 调用,以 Invocation 和 Result 为中心,扩展接口为 Protocal、Invoker 和 Exporter信息交换层(Exchange): 封装请求响应模式,同步转异步。以 Request 和Response 为中心,扩展接口为 Exchanger、ExchangeChannel、ExchangeClient 和 ExchangeServer网络传输层(Transport): 抽象 mina 和 netty 为统一接口,以 Message 为中心,扩展接口为 Channel、Transporter、Client、Server 和 Codec数据序列化层(Serialize): 可复用的一些工具,扩展接口为 Serialization、ObjectInput、ObjectOutput 和 ThreadPool3、默认使用的是什么通信框架,还有别的选择吗? 默认也推荐使用 netty 框架,还有 mina。 4、服务调用是阻塞的吗? 默认是阻塞的,可以异步调用,没有返回值的可以这么做。Dubbo 是基于 NIO 的非阻塞实现并行调用,客户端不需要启动多线程即可完成并行调用多个远程服务,相对多线程开销较小,异步调用会返回一个 Future 对象。 5、一般使用什么注册中心?还有别的选择吗? 推荐使用 Zookeeper 作为注册中心,还有 Redis、Multicast、Simple 注册中心,但不推荐。 6、默认使用什么序列化框架,你知道的还有哪些? 推荐使用 Hessian 序列化,还有 Duddo、FastJson、Java 自带序列化。 7、服务提供者能实现失效踢出是什么原理? 服务失效踢出基于 zookeeper 的临时节点原理。 8、服务上线怎么不影响旧版本? 采用多版本开发,不影响旧版本。 9、如何解决服务调用链过长的问题? 可以结合 zipkin 实现分布式服务追踪。 10、说说核心的配置有哪些? 11、Dubbo 推荐用什么协议? 12、同一个服务多个注册的情况下可以直连某一个服务吗? 13、画一画服务注册与发现的流程图? 14、Dubbo 集群容错有几种方案? 15、Dubbo 服务降级,失败重试怎么做? 16、Dubbo 使用过程中都遇到了些什么问题? 17、Dubbo Monitor 实现原理? 18、Dubbo 用到哪些设计模式? 19、Dubbo 配置文件是如何加载到 Spring 中的? 20、Dubbo SPI 和 Java SPI 区别? 21、Dubbo 支持分布式事务吗? 22、Dubbo 可以对结果进行缓存吗? 23、服务上线怎么兼容旧版本? 24、Dubbo 必须依赖的包有哪些? 25、Dubbo telnet 命令能做什么? 26、Dubbo 支持服务降级吗? 27、Dubbo 如何优雅停机? 28、Dubbo 和 Dubbox 之间的区别? 29、Dubbo 和 Spring Cloud 的区别? 30、你还了解别的分布式框架吗? 需要其余问题答案的关注gzh“程序员小x”私信领取哦!另外喜欢这篇文章的可以给笔者点个赞,关注一下,每天都会分享Java相关文章!还有不定时的福利赠送,包括整理的学习资料,面试题,源码等~~

优秀的个人博客,低调大师

BAT面试必问HashMap源码分析

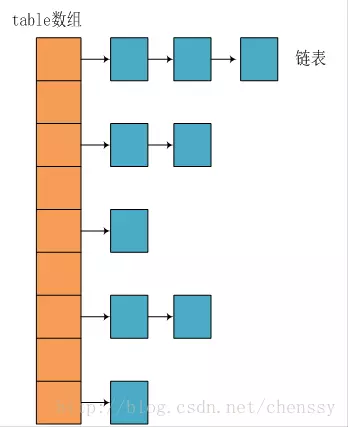
HashMap 简介 HashMap 主要用来存放键值对,它基于哈希表的Map接口实现,是常用的Java集合之一。 JDK1.8 之前 HashMap 由 数组+链表 组成的,数组是 HashMap 的主体,链表则是主要为了解决哈希冲突而存在的(“拉链法”解决冲突).JDK1.8 以后在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)时,将链表转化为红黑树,以减少搜索时间。 底层数据结构分析 JDK1.8之前 JDK1.8 之前 HashMap 底层是数组和链表结合在一起使用也就是链表散列。HashMap 通过 key 的 hashCode 经过扰动函数处理过后得到 hash 值,然后通过(n - 1) & hash判断当前元素存放的位置(这里的 n 指的是数组的长度),如果当前位置存在元素的话,就判断该元素与要存入的元素的 hash 值以及 key 是否相同,如果相同的话,直接覆盖,不相同就通过拉链法解决冲突。 所谓扰动函数指的就是 HashMap 的 hash 方法。使用 hash 方法也就是扰动函数是为了防止一些实现比较差的 hashCode() 方法 换句话说使用扰动函数之后可以减少碰撞。 JDK 1.8 HashMap 的 hash 方法源码: JDK 1.8 的 hash方法 相比于 JDK 1.7 hash 方法更加简化,但是原理不变。 1 2 3 4 5 6 7 static final int hash(Object key) { int h; // key.hashCode():返回散列值也就是hashcode // ^ :按位异或 // >>>:无符号右移,忽略符号位,空位都以0补齐 return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } 对比一下 JDK1.7的 HashMap 的 hash 方法源码. 1 2 3 4 5 6 7 8 static int hash(int h) { // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 相比于 JDK1.8 的 hash 方法 ,JDK 1.7 的 hash 方法的性能会稍差一点点,因为毕竟扰动了 4 次。 所谓“拉链法”就是:将链表和数组相结合。也就是说创建一个链表数组,数组中每一格就是一个链表。若遇到哈希冲突,则将冲突的值加到链表中即可。 JDK1.8之后 相比于之前的版本,jdk1.8在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为8)时,将链表转化为红黑树,以减少搜索时间。 类的属性: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable { // 序列号 private static final long serialVersionUID = 362498820763181265L; // 默认的初始容量是16 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // 最大容量 static final int MAXIMUM_CAPACITY = 1 << 30; // 默认的填充因子 static final float DEFAULT_LOAD_FACTOR = 0.75f; // 当桶(bucket)上的结点数大于这个值时会转成红黑树 static final int TREEIFY_THRESHOLD = 8; // 当桶(bucket)上的结点数小于这个值时树转链表 static final int UNTREEIFY_THRESHOLD = 6; // 桶中结构转化为红黑树对应的table的最小大小 static final int MIN_TREEIFY_CAPACITY = 64; // 存储元素的数组,总是2的幂次倍 transient Node<k,v>[] table; // 存放具体元素的集 transient Set<map.entry<k,v>> entrySet; // 存放元素的个数,注意这个不等于数组的长度。 transient int size; // 每次扩容和更改map结构的计数器 transient int modCount; // 临界值 当实际大小(容量*填充因子)超过临界值时,会进行扩容 int threshold; // 填充因子 final float loadFactor; } loadFactor加载因子 loadFactor加载因子是控制数组存放数据的疏密程度,loadFactor越趋近于1,那么 数组中存放的数据(entry)也就越多,也就越密,也就是会让链表的长度增加,load Factor越小,也就是趋近于0, loadFactor太大导致查找元素效率低,太小导致数组的利用率低,存放的数据会很分散。loadFactor的默认值为0.75f是官方给出的一个比较好的临界值。 threshold threshold = capacity * loadFactor,当Size>=threshold的时候,那么就要考虑对数组的扩增了,也就是说,这个的意思就是衡量数组是否需要扩增的一个标准。 Node节点类源码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 // 继承自 Map.Entry<K,V> static class Node<K,V> implements Map.Entry<K,V> { final int hash;// 哈希值,存放元素到hashmap中时用来与其他元素hash值比较 final K key;//键 V value;//值 // 指向下一个节点 Node<K,V> next; Node(int hash, K key, V value, Node<K,V> next) { this.hash = hash; this.key = key; this.value = value; this.next = next; } public final K getKey() { return key; } public final V getValue() { return value; } public final String toString() { return key + "=" + value; } // 重写hashCode()方法 public final int hashCode() { return Objects.hashCode(key) ^ Objects.hashCode(value); } public final V setValue(V newValue) { V oldValue = value; value = newValue; return oldValue; } // 重写 equals() 方法 public final boolean equals(Object o) { if (o == this) return true; if (o instanceof Map.Entry) { Map.Entry<?,?> e = (Map.Entry<?,?>)o; if (Objects.equals(key, e.getKey()) && Objects.equals(value, e.getValue())) return true; } return false; } } 树节点类源码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> { TreeNode<K,V> parent; // 父 TreeNode<K,V> left; // 左 TreeNode<K,V> right; // 右 TreeNode<K,V> prev; // needed to unlink next upon deletion boolean red; // 判断颜色 TreeNode(int hash, K key, V val, Node<K,V> next) { super(hash, key, val, next); } // 返回根节点 final TreeNode<K,V> root() { for (TreeNode<K,V> r = this, p;;) { if ((p = r.parent) == null) return r; r = p; } HashMap源码分析 构造方法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 // 默认构造函数。 public More ...HashMap() { this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted } // 包含另一个“Map”的构造函数 public More ...HashMap(Map<? extends K, ? extends V> m) { this.loadFactor = DEFAULT_LOAD_FACTOR; putMapEntries(m, false);//下面会分析到这个方法 } // 指定“容量大小”的构造函数 public More ...HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } // 指定“容量大小”和“加载因子”的构造函数 public More ...HashMap(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; this.threshold = tableSizeFor(initialCapacity); } putMapEntries方法: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) { int s = m.size(); if (s > 0) { // 判断table是否已经初始化 if (table == null) { // pre-size // 未初始化,s为m的实际元素个数 float ft = ((float)s / loadFactor) + 1.0F; int t = ((ft < (float)MAXIMUM_CAPACITY) ? (int)ft : MAXIMUM_CAPACITY); // 计算得到的t大于阈值,则初始化阈值 if (t > threshold) threshold = tableSizeFor(t); } // 已初始化,并且m元素个数大于阈值,进行扩容处理 else if (s > threshold) resize(); // 将m中的所有元素添加至HashMap中 for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) { K key = e.getKey(); V value = e.getValue(); putVal(hash(key), key, value, false, evict); } } } put方法 HashMap只提供了put用于添加元素,putVal方法只是给put方法调用的一个方法,并没有提供给用户使用。 对putVal方法添加元素的分析如下: ①如果定位到的数组位置没有元素 就直接插入。 ②如果定位到的数组位置有元素就和要插入的 key 比较,如果key相同就直接覆盖,如果 key 不相同,就判断 p 是否是一个树节点,如果是就调用e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value)将元素添加进入。如果不是就遍历链表插入。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; // table未初始化或者长度为0,进行扩容 if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; // (n - 1) & hash 确定元素存放在哪个桶中,桶为空,新生成结点放入桶中(此时,这个结点是放在数组中) if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); // 桶中已经存在元素 else { Node<K,V> e; K k; // 比较桶中第一个元素(数组中的结点)的hash值相等,key相等 if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) // 将第一个元素赋值给e,用e来记录 e = p; // hash值不相等,即key不相等;为红黑树结点 else if (p instanceof TreeNode) // 放入树中 e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); // 为链表结点 else { // 在链表最末插入结点 for (int binCount = 0; ; ++binCount) { // 到达链表的尾部 if ((e = p.next) == null) { // 在尾部插入新结点 p.next = newNode(hash, key, value, null); // 结点数量达到阈值,转化为红黑树 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); // 跳出循环 break; } // 判断链表中结点的key值与插入的元素的key值是否相等 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) // 相等,跳出循环 break; // 用于遍历桶中的链表,与前面的e = p.next组合,可以遍历链表 p = e; } } // 表示在桶中找到key值、hash值与插入元素相等的结点 if (e != null) { // 记录e的value V oldValue = e.value; // onlyIfAbsent为false或者旧值为null if (!onlyIfAbsent || oldValue == null) //用新值替换旧值 e.value = value; // 访问后回调 afterNodeAccess(e); // 返回旧值 return oldValue; } } // 结构性修改 ++modCount; // 实际大小大于阈值则扩容 if (++size > threshold) resize(); // 插入后回调 afterNodeInsertion(evict); return null; } 我们再来对比一下 JDK1.7 put方法的代码 对于put方法的分析如下: ①如果定位到的数组位置没有元素 就直接插入。 ②如果定位到的数组位置有元素,遍历以这个元素为头结点的链表,依次和插入的key比较,如果key相同就直接覆盖,不同就采用头插法插入元素。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 public V put(K key, V value) if (table == EMPTY_TABLE) { inflateTable(threshold); } if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { // 先遍历 Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(hash, key, value, i); // 再插入 return null; } get方法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 public V get(Object key) { Node<K,V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } final Node<K,V> getNode(int hash, Object key) { Node<K,V>[] tab; Node<K,V> first, e; int n; K k; if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) { // 数组元素相等 if (first.hash == hash && // always check first node ((k = first.key) == key || (key != null && key.equals(k)))) return first; // 桶中不止一个节点 if ((e = first.next) != null) { // 在树中get if (first instanceof TreeNode) return ((TreeNode<K,V>)first).getTreeNode(hash, key); // 在链表中get do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) return e; } while ((e = e.next) != null); } } return null; } resize方法 进行扩容,会伴随着一次重新hash分配,并且会遍历hash表中所有的元素,是非常耗时的。在编写程序中,要尽量避免resize。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 final Node<K,V>[] resize() { Node<K,V>[] oldTab = table; int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; if (oldCap > 0) { // 超过最大值就不再扩充了,就只好随你碰撞去吧 if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; } // 没超过最大值,就扩充为原来的2倍 else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) newThr = oldThr << 1; // double threshold } else if (oldThr > 0) // initial capacity was placed in threshold newCap = oldThr; else { signifies using defaults newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } // 计算新的resize上限 if (newThr == 0) { float ft = (float)newCap * loadFactor; newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE); } threshold = newThr; @SuppressWarnings({"rawtypes","unchecked"}) Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; table = newTab; if (oldTab != null) { // 把每个bucket都移动到新的buckets中 for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) newTab[e.hash & (newCap - 1)] = e; else if (e instanceof TreeNode) ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); else { Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; // 原索引 if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } // 原索引+oldCap else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); // 原索引放到bucket里 if (loTail != null) { loTail.next = null; newTab[j] = loHead; } // 原索引+oldCap放到bucket里 if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } } } } } return newTab; } HashMap常用方法测试 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 package map; import java.util.Collection; import java.util.HashMap; import java.util.Set; public class HashMapDemo { public static void main(String[] args) { HashMap<String, String> map = new HashMap<String, String>(); // 键不能重复,值可以重复 map.put("san", "张三"); map.put("si", "李四"); map.put("wu", "王五"); map.put("wang", "老王"); map.put("wang", "老王2");// 老王被覆盖 map.put("lao", "老王"); System.out.println("-------直接输出hashmap:-------"); System.out.println(map); /** * 遍历HashMap */ // 1.获取Map中的所有键 System.out.println("-------foreach获取Map中所有的键:------"); Set<String> keys = map.keySet(); for (String key : keys) { System.out.print(key+" "); } System.out.println();//换行 // 2.获取Map中所有值 System.out.println("-------foreach获取Map中所有的值:------"); Collection<String> values = map.values(); for (String value : values) { System.out.print(value+" "); } System.out.println();//换行 // 3.得到key的值的同时得到key所对应的值 System.out.println("-------得到key的值的同时得到key所对应的值:-------"); Set<String> keys2 = map.keySet(); for (String key : keys2) { System.out.print(key + ":" + map.get(key)+" "); } /** * 另外一种不常用的遍历方式 */ // 当我调用put(key,value)方法的时候,首先会把key和value封装到 // Entry这个静态内部类对象中,把Entry对象再添加到数组中,所以我们想获取 // map中的所有键值对,我们只要获取数组中的所有Entry对象,接下来 // 调用Entry对象中的getKey()和getValue()方法就能获取键值对了 Set<java.util.Map.Entry<String, String>> entrys = map.entrySet(); for (java.util.Map.Entry<String, String> entry : entrys) { System.out.println(entry.getKey() + "--" + entry.getValue()); } /** * HashMap其他常用方法 */ System.out.println("after map.size():"+map.size()); System.out.println("after map.isEmpty():"+map.isEmpty()); System.out.println(map.remove("san")); System.out.println("after map.remove():"+map); System.out.println("after map.get(si):"+map.get("si")); System.out.println("after map.containsKey(si):"+map.containsKey("si")); System.out.println("after containsValue(李四):"+map.containsValue("李四")); System.out.println(map.replace("si", "李四2")); System.out.println("after map.replace(si, 李四2):"+map); } }

优秀的个人博客,低调大师

Android 面试常问七道题

1、Android的四大组件以及作用 Activity:Activity是Android程序与用户交互的窗口,是Android构造块中最基本的一种,它需要为保持各界面的状态,做很多持久化的事情,妥善管理生命周期以及一些跳转逻辑。service:后台服务于Activity,封装有一个完整的功能逻辑实现,接受上层指令,完成相关的动作,定义好需要接受的Intent提供同步和异步的接口。Content Provider:是Android提供的第三方应用数据的访问方案,对外提供数据,屏蔽内部数据的存储细节,向外提供统一的借口模型,大大简化上层应用对数据的整合提供了更方便的途径。BroadCast Receiver:接受一种或者多种Intent作触发事件,接受相关消息,做一些简单处理,转换成一条Notification,统一了Android的事件广播模型。 2、描述下Activity的生命周期? Activity的生命周期方法有:onCreate()、onStart()、onReStart()、onResume()、onPause()、onStop()、onDestory();可见生命周期:从onStart()直到系统调用onStop()前台生命周期:从onResume()直到系统调用onPause()屏幕旋转时的Activity生命周期:不设置Activity的android:configChanges时,切屏会重新调用各个生命周期,切横屏时会执行一次,切竖屏时会执行两次;设置Activity的android:configChanges="orientation"时,切屏还是会重新调用各个生命周期,切横、竖屏时只会执行一次;设置Activity的android:configChanges="orientation|keyboardHidden"时,切屏不会重新调用各个生命周期,只会执行onConfigurationChanged方法。 3、ListView优化有哪几种方式? 1、ListView中item的布局至关重要,必须尽可能的减少使用的控件,布局。2、RelativeLayout是绝对的利器,通过它可以减少布局的层次。3、同时要尽可能的复用控件,这样可以减少ListView的内存使用,减少滑动时GC次数。4、ListView的背景色与cacheColorHint设置相同颜色,可以提高滑动时的渲染性能。5、getView方法中不能做复杂的逻辑计算,特别是数据库操作,否则会严重影响滑动时的性能。 4、解释下Handler的运行机制? Message,理解为线程间交流的信息Handler,是Message的主要处理者,负责Message的发送和执行处理Message Queue,用来存放通过Handler发布的消息,按照先进先出执行Looper ,是每条线程里的Message Queue的管家 Handler一般在主线程中创建,子线程通过处理器对象的sendMessage发消息到MessageQueue(消息队列)里,主线程中已经包含了一个Looper(轮循器),Looper是死循环的,会一直轮询消息队列,看是否有Message(消息) ,如果有,轮询器会把消息对象传给Handler(消息处理器),然后调用handlerMessage处理该消息,进而更新UI。 5、什么是ANR?如何避免ANR异常? ANR:Application Not Responding。在Android中,活动管理器和窗口管理器这两个系统服务负责监视应用程序的响应,当用户操作的在5s内应用程序没能做出反应,BroadcastReceiver在10秒内没有执行完毕,就会出现应用程序无响应对话框,就是ANR。避免方法:Activity应该在它的关键生命周期方法(如onCreate()和onResume())里尽可能少的去做创建操作。潜在的耗时操作,例如网络或数据库操作,或者高耗时的计算如改变位图尺寸,应该在子线程里(或者异步方式)来完成。主线程应该为子线程提供一个Handler,以便完成时能够提交给主线程。 6、Android中三种动画,特点和区别是什么? Android 中的动画有帧动画,补间动画,属性动画。帧动画:一张张图片不断的切换,形成动画效果,类似小时候的电影。很多应用的loading是采用这种方式。补间动画:是对某个View进行一系列的动画的操作,包括淡入淡出(Alpha),缩放(Scale),平移(Translate),旋转(Rotate)四种模式。属性动画:属性动画不再仅仅是一种视觉效果了,而是一种不断地对值进行操作的机制,并将值赋到指定对象的指定属性上,可以是任意对象的任意属性。 7、注册广播有几种方式,有何优缺点? 第一种:在清单文件中声明,添加 第二种使用代码进行注册:IntentFilter filter = new IntentFilter("android.provider.Telephony.SMS_RECEIVED");IncomingSMSReceiver receiver = new IncomgSMSReceiver();registerReceiver(receiver.filter); 两种注册类型的区别是:1)第一种不是常驻型广播,也就是说广播跟随程序的生命周期。2)第二种是常驻型,也就是说当应用程序关闭后,如果有信息广播来,程序也会被系统调用自动运行。 8、总结 最近,群里好多人都在讨论面试题,这边趁此机会简单列举一些当初我去面试时常问到的一些Android题,刚好有的同学需要。同时,我也自己总结一下,当初面试被问到的几个题目,也为以后想跳槽到更好的岗位,提前做一些准备。最后,这里奉上自己很喜欢的两份简历模板,有需要的同学,微信公众号后台回复 "简历模板" 。 推荐阅读:福利篇:学习编程视频免费领取传感器实现仿微信摇一摇功能Retrofit常见注解全解析

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册